Как я дал незнакомцам root-консоль на своём сервере: тренажёр инцидентов на gVisor
Я сделал бесплатный тренажёр, где дежурство можно прожить до того, как оно случится на проде: приходит алерт, у вас настоящая консоль Linux со сломанным сервисом, и нужно найти причину и починить. Называется он Prod is Down.
Я 4 года работаю системным администратором. Самое запомнившееся дежурство случилось в первый же месяц: в три часа ночи лёг один из наших сервисов, алерты сыпались один за другим, а я смотрел в консоль и не понимал, с чего начать. Логи? top? Перезапустить всё подряд? Сервис я тогда поднял через час и скорее везением, а настоящую причину — забитый логами диск — нашёл только утром.
Потом я не раз видел то же самое у других: человек знает команды, но под давлением алертов не умеет искать причину. На курсах разбирают команды по одной, а навык расследования появляется только после настоящих инцидентов. Устраивать инциденты на проде ради обучения никто не даст.
Так появилась идея — место, где сервер ломается по-настоящему, но без последствий: можно ошибиться, сбросить всё и попробовать снова.
Сейчас в тренажёре 13 кейсов: обучающий кейс 0 и 12 инцидентов — упавший PostgreSQL, OOM Killer, забитый диск, истёкший сертификат, 502 от nginx, кончившиеся inode, DNS, лимит открытых файлов, сбитое время и другие. Ничего устанавливать не нужно, консоль открывается в браузере; кейс 0 проходится без регистрации.
В статье расскажу не столько про тренажёр, сколько про инженерные задачи внутри: как дать незнакомым людям root-консоль на своём сервере и не пожалеть, как проверить, что игрок действительно починил сервис, и на что я наступил с gVisor.
Как выглядит кейс
Каждый кейс устроен как маленькое дежурство, и порядок везде один:
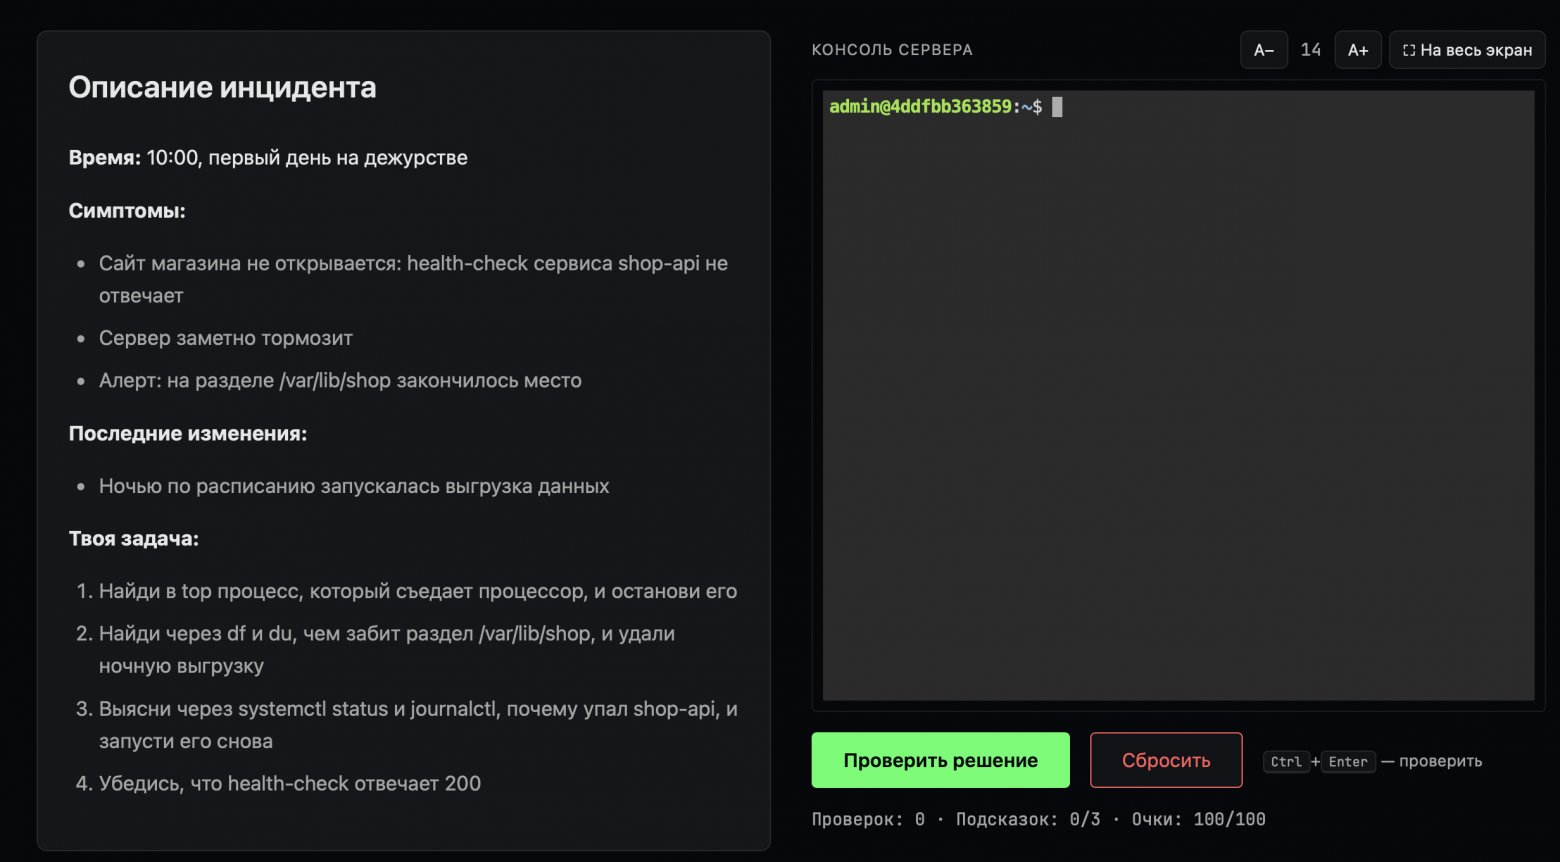
Брифинг. Симптомы («сайт отдаёт 502»), что недавно меняли («ночью выкатили релиз 4.2») и задача. Пока игрок читает, инцидент развивается: сервер несколько секунд «ломается», и метрики успевают собрать алерты.
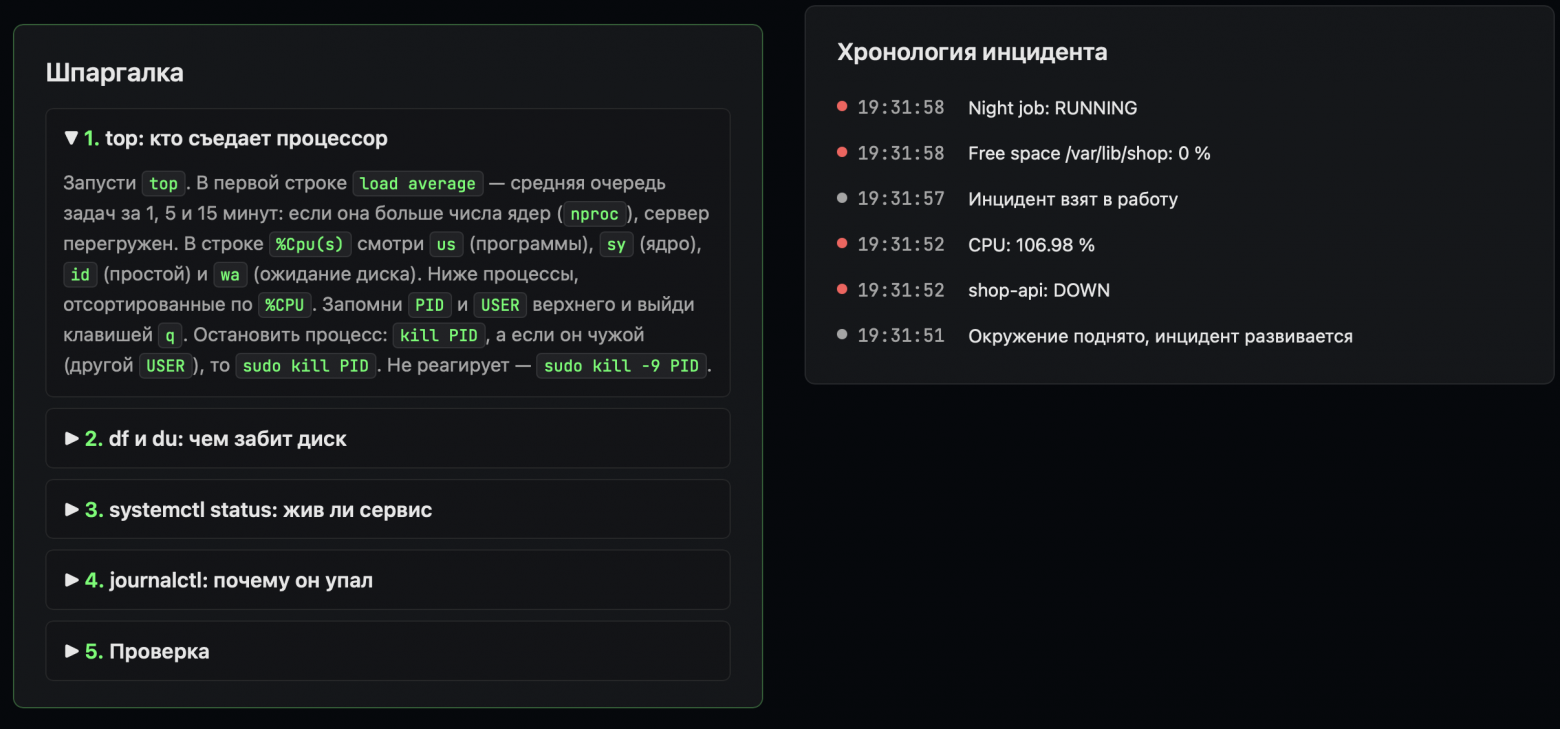
Взять инцидент в работу. Запускается таймер, открывается консоль сервера, а рядом — панель метрик с обновлением раз в 3 секунды и хронология инцидента.
Расследование. Обычные инструменты:
top,df,journalctl,systemctl status,ss, конфиги. Если игрок застрял, есть три подсказки: направление (−5 очков), где искать (−10), конкретная команда (−20).Проверка. Кнопка «Проверить решение» запускает в контейнере скрипт, который смотрит на сервис глазами пользователя: отвечает ли health-check, принимает ли база запросы, не остался ли виновник.
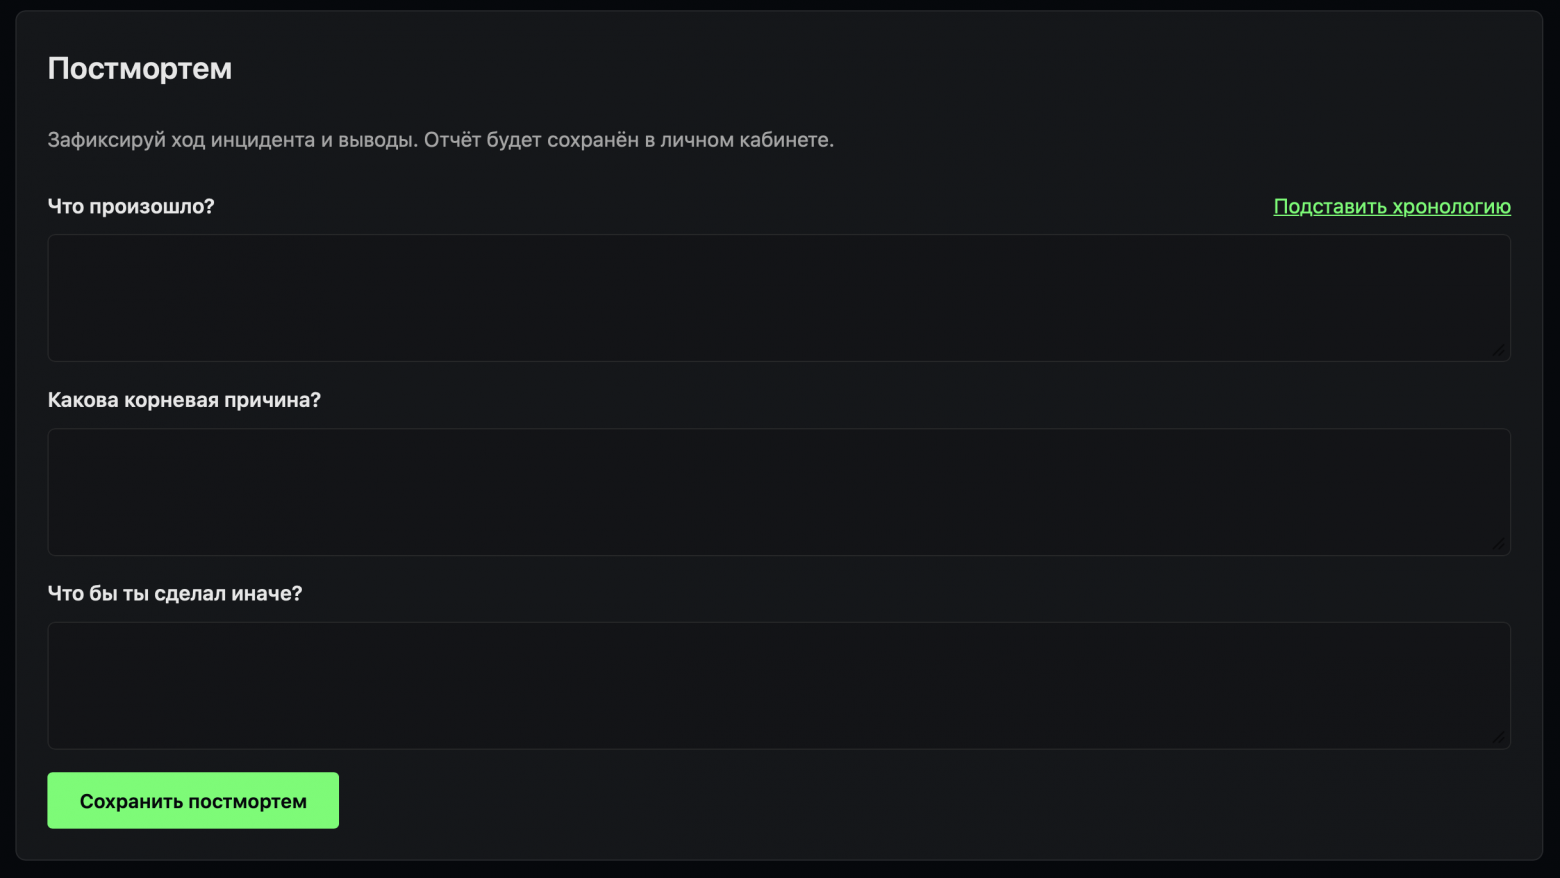
Разбор. После решения — что было на самом деле, как это чинят опытные SRE и как не допустить в проде. Можно написать постмортем: что произошло, корневая причина, что бы сделал иначе.
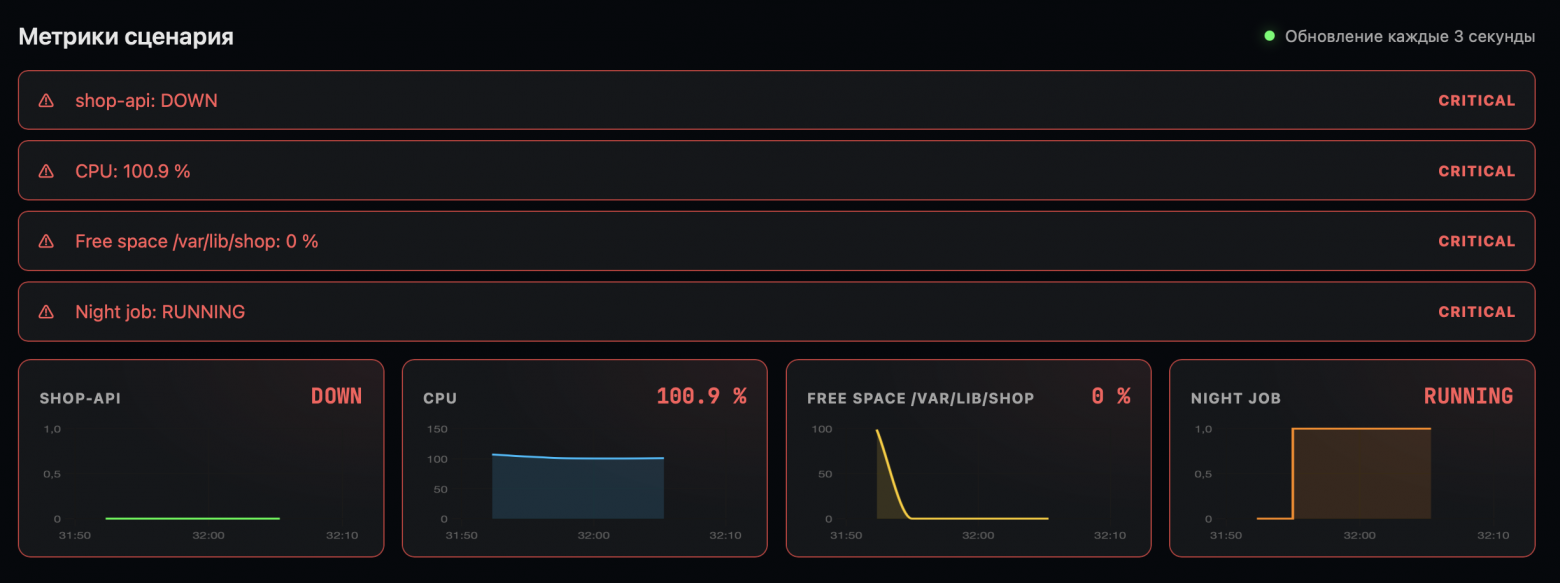
У каждого кейса три варианта поломки, вариант выбирается случайно на каждый запуск. В кейсе про 502 это может быть рассинхрон портов nginx и приложения, сокет с правами 0600 или опечатка в переменной окружения, из-за которой приложение падает при старте. Симптом один, причины разные — заученная из прошлого прохождения команда не поможет.
Root-консоль для незнакомцев
Игрок получает sudo в контейнере на моём сервере, и я исхожу из того, что кто-то обязательно попробует его сломать. Защита состоит из нескольких слоёв, и ни один из них не считается достаточным сам по себе.
Собственное ядро. Контейнеры игроков работают под gVisor (runsc): системные вызовы игрока принимает не ядро сервера, а ядро-прослойка gVisor в пользовательском пространстве. Дыра в ядре Linux или в runc уже не даёт прямого выхода на сервер. Два флага понадобились: --allow-suid, иначе не работает sudo, и --overlay2=none — о нём в разделе про грабли.
Сеть без выхода. У каждого запуска своя Docker-сеть с internal=True: в интернет из неё не выйти, до соседних игроков не достучаться. В сеть подключено только веб-приложение, которое проксирует терминал (ttyd) в браузер. Отдельное правило firewall закрывает для контейнеров SSH самого сервера. Заодно сервер нельзя превратить в майнер или источник спама.
Лимиты на контейнер.
512 МБ памяти без свопа, одно ядро, 256 процессов — fork-бомба упирается в лимит
все capabilities сняты, возвращены только нужные сценариям (
CHOWN,SETUID,KILL,SYS_PTRACEи ещё несколько)при нехватке процессора веб-приложение получает время раньше контейнеров (
cpu_shares1024 против 256)логи контейнера — не больше 5 МБ: сценарии специально шумят
окружение удаляется после 10 минут бездействия и в любом случае через час
не больше 2 окружений на игрока и 10 новых с одного IP за 10 минут
Диск. Самое неожиданное: --storage-opt size на overlayfs молча не работает, и dd if=/dev/zero спокойно забивает диск сервера. Поэтому за местом следит сторож: он смотрит SizeRw контейнеров и удаляет те, что записали больше 1 ГБ, а при свободном месте меньше 2 ГБ новые окружения не запускаются. SizeRw считает занятые блоки, так что ловит и dd, и fallocate.
[embed: node/b28eb289-eb4d]
Браузер видит только сайт, а контейнер — только веб-приложение, которое проксирует терминал. Интернет и SSH сервера из сети запуска недоступны.
Как отличить починку от обмана
Проверка решения идёт внутри контейнера, где у игрока root, поэтому верить там нельзя ничему. Заменить curlскриптом, который всегда печатает 200, — дело минуты. Вот что из этого выросло.
Проверять результат, а не действия. check.sh не смотрит, какие команды вводил игрок. Он спрашивает сервис так же, как спросил бы пользователь или мониторинг: health-check через nginx, SELECT 1 в базу, статус кластера. Иногда ещё — что исправлена причина: в кейсе с PostgreSQL сервис должен подняться, а конфиг архивации — остаться на месте.
Скрипт проверки не живёт в контейнере. Его текст берётся из репозитория на сервере и передаётся аргументом /usr/bin/bash -c в docker exec. Подправить файл проверки игроку негде.
Подменённые программы — отказ в проверке. Перед запуском check.sh сервер смотрит docker diffконтейнера. Изменилось что-то в /usr, /bin, /sbin, /lib, /etc/sudoers, /etc/ld.so.preload или в файлах, на которые опирается проверка конкретного кейса, — проверка не запускается, игрок видит «сбрось кейс и реши заново». Честному решению туда лезть не нужно ни в одном кейсе.
Параметры поломки запечатаны. Вариант поломки лежит в контейнере в /etc/scenario, и в момент, когда игрок берёт инцидент, сервер запоминает его sha256. Подправил параметры, чтобы «поломки не было», — отпечаток не совпадёт, и проверка откажет.
Перед запуском я прогнал все 39 вариантов кейсов до конца (запуск → проверка не проходит → команда из последней подсказки → проверка проходит) и несколько попыток сжульничать — они отклоняются.
systemctl без systemd
Инциденты на реальных серверах расследуют через systemctl status и journalctl -u, а настоящего systemd в контейнере нет: он не PID 1, и ему не хватает прав. Запускать systemd в привилегированном контейнере для чужих людей я не стал. Вместо этого написал эмулятор на Python — один файл примерно на 1300 строк, который работает и как systemctl, и как journalctl, и как менеджер сервисов.
Чтобы опыт переносился на настоящие серверы, эмулятор повторяет поведение systemd в местах, где люди обычно ошибаются:
юниты — обычные файлы в
/etc/systemd/systemс drop-in в*.service.d/; изменения вступают в силу только послеdaemon-reload, а до негоstatusпредупреждает, что файл изменился на дискеRestart=иRestartSec=— упавший сервис перезапускается по кругу, и это видно в журналеEnvironmentFile=,User=,ExecStartPre=,LimitNOFILE=— на них построены кейсы про опечатку в конфиге и про «Too many open files»start,stop,restart,reload,enable,kill,is-active,show,catиjournalctl -uс привычным выводом
Варианты, которые нельзя заучить. Команда из чужого прохождения не должна сработать у вас. Поэтому в манифесте каждого кейса по три варианта поломки, и при запуске выбирается случайный. Его параметры приходят в контейнер переменными PD_*; entrypoint ломает по ним сервер и удаляет их из окружения до запуска терминала, чтобы ответ нельзя было подсмотреть через env. Те же параметры подставляются в подсказки и в разбор, так что третья подсказка всегда про вашу поломку, а не про чужую.
Грабли gVisor
Все 13 кейсов сначала работали на обычном runc, и при переезде на gVisor сломались три из них и две вещи в самой платформе. gVisor — не ядро Linux, а его реализация с нуля, и края у неё есть.
Что сломалось | Почему | Что сделал |
|---|---|---|
| по умолчанию gVisor держит записи в корневую ФС в своём оверлее, в памяти песочницы |
|
| без флага gVisor игнорирует setuid-бит |
|
dnsmasq в кейсе про DNS не запускался | gVisor поддерживает не все группы netlink, а dnsmasq подписывается на лишние | маленькая библиотека на C через |
в кейсе про inode они не кончались | внутренний tmpfs gVisor не соблюдает | раздел монтирует сам Docker на сервере как tmpfs-том и удаляет вместе с контейнером |
в кейсе про OOM Killer метрика | gVisor не считает её в | оставил как есть: решению не мешает |
После переезда все кейсы снова проходятся от начала до конца — и на runc, и на runsc.
Первые игроки и мои ошибки
Первые дни показали, что техническая часть работает, а люди теряются совсем не там, где я ждал.
Кнопка за краем экрана. Обучающий кейс 0 открыли несколько гостей, окружение у всех поднялось за 6 секунд — и никто не нажал «Взять инцидент в работу». Возможно, дело в телефоне: там эта кнопка оказывалась примерно на втором экране, под брифингом. Теперь она закреплена внизу экрана.
45 проверок и ни одной подсказки. Один игрок за 5 минут нажал «Проверить решение» 45 раз и 6 раз сбросил окружение. Подсказки лежали в боковой колонке, и, похоже, в азарте он их просто не заметил. Теперь после каждых трёх неудачных проверок прямо под кнопкой появляется «Застрял? Открой подсказку».
Слепая зона до первого кейса. Я считал запуски кейсов, но не заходы на сайт, и не знал, сколько человек уходит с главной, ничего не открыв. Теперь сайт считает просмотры сводными числами за день: страница, источник, телефон или компьютер — без cookie и без IP.
С телефона играть неудобно. Набирать команды на телефонной клавиатуре — мучение, а заходят по ссылкам из соцсетей часто именно с телефона. Кейс 0 можно пройти и там, а перед остальными сайт предлагает скопировать ссылку и открыть её на компьютере.
Что дальше
Ближайшие планы — новые кейсы и регулярность:
кейсы 13 и 14 про каскадный и распределённый сбой, где сломан не один сервис, а цепочка
«инцидент недели»: один кейс для всех и общая таблица времени
улучшать и масштабировать сервис: очередь на окружения и больше мощности, чтобы никто не видел «сервер перегружен»
Кейс 0 открыт без регистрации — если захотите проверить себя
Буду рад любой обратной связи в комментариях:
где застряли и какая подсказка не помогла
какой инцидент из вашей практики стоит превратить в кейс
как обмануть проверку, если найдёте способ
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.