Новая статья: Мастерская локальных ИИ: драники кодерские с Gemma 4
В июне 2026 г. Google DeepMind представила новинку в семействе больших языковых моделей (БЯМ) Gemma 4 — плотную (т. е. задействующую в каждый момент времени все наличные параметры, а не полагающуюся на выборочный «ансамбль экспертов», MoE) версию 12B с 11,95 млрд параметров и унифицированной бескодировочной архитектурой. Эта модель изначально готова работать как с текстовым вводом, так и с изображениями, и с аудиофайлами, причём для инференса ей достаточно 16 Гбайт оперативной памяти — даже в исходной, безо всяких ухищрений с понижающими квантизациями, кодировке значений рабочих параметров. Столь привлекательная во всех отношениях Gemma 4 12B доступна и в применяемой нами рабочей среде Unsloth Desktop (UD). Посмотрим же, как она себя проявит при решении тех модельных задач, что мы ставили в прошлый раз перед Qwen3.8.
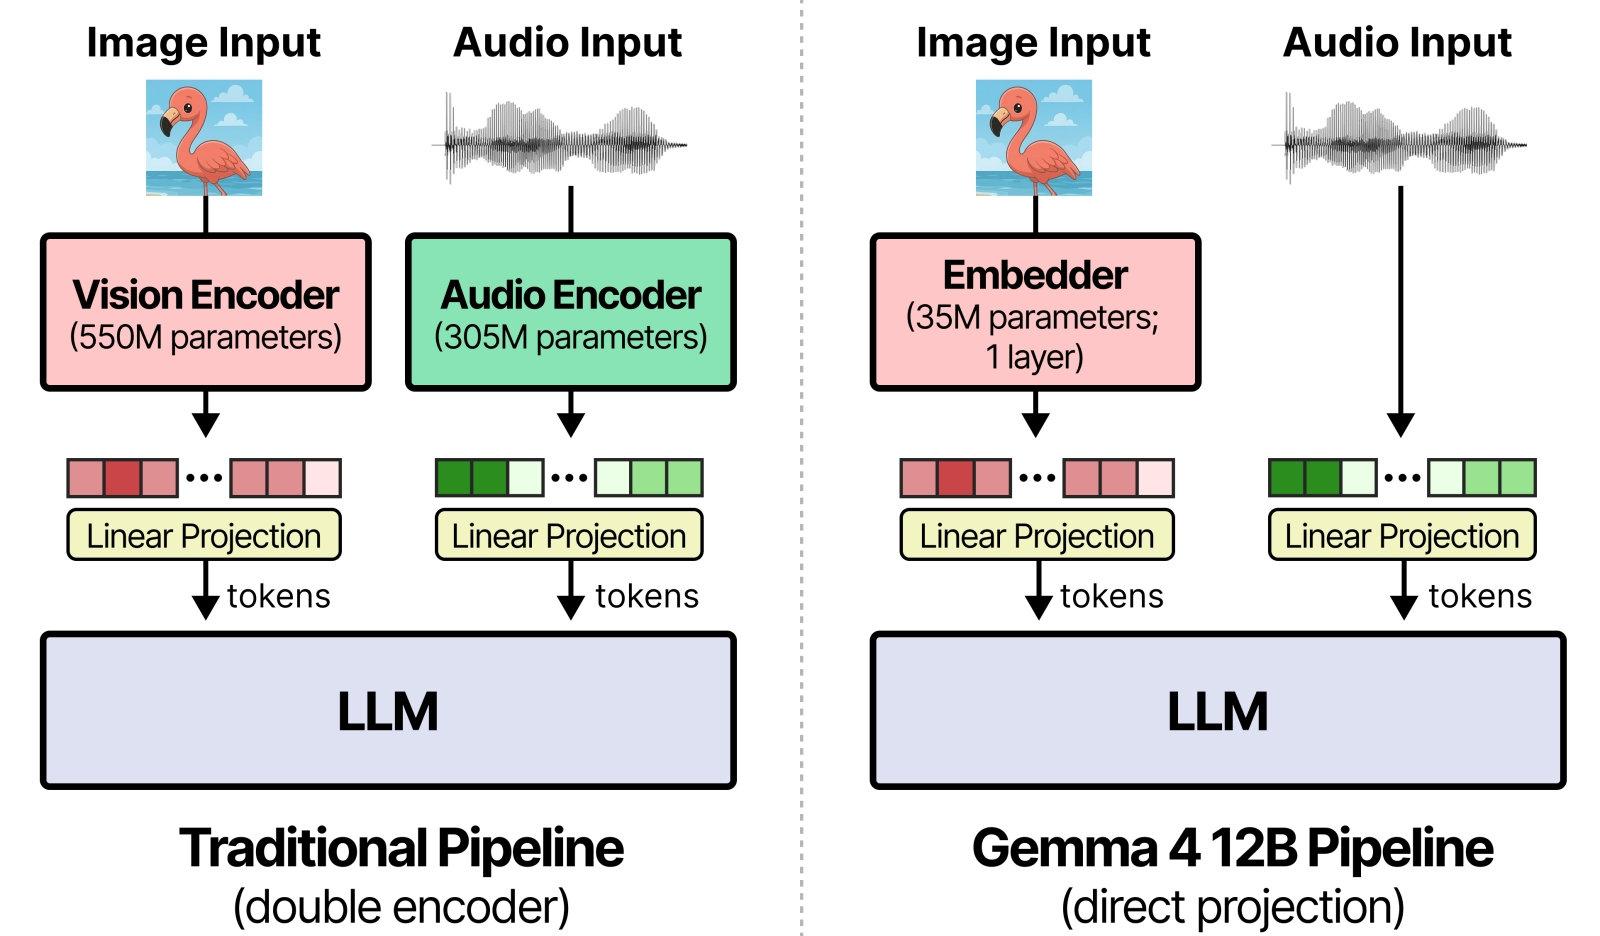
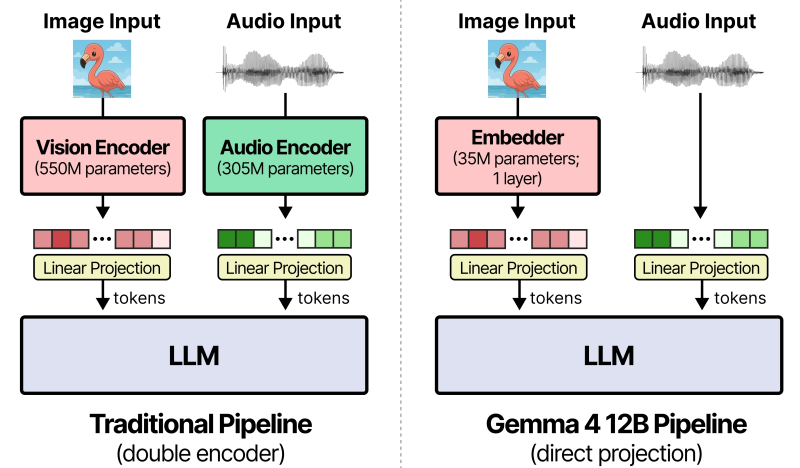
Наглядная схема поясняет преимущества реализованной в Gemma 4 12B бескодировочной архитектуры (справа) по сравнению с классической (источник: Google DeepMind)
⇡#В деталях
Как мы не раз уже обращали внимание во множестве материалов из раздела «Искусственный интеллект», БЯМ оперирует исключительно с токенами: преобразует в них входные данные, затем по определённому (часто авторегрессионному) алгоритму с непременной щепоткой стохастики использует эту затравку для последовательного генерирования токенов ответа, после чего конвертирует полученную последовательность в воспринимаемую человеком форму. Превращать в токены текстовые подсказки достаточно просто, хотя и тут есть свои тонкости: грубо говоря, для слова «steam» достаточно одного токена, для «steamboat» — двух и т. д. С изображениями же, звуком и тем более видео всё куда сложнее: обычно для их трансформации в последовательность токенов служит особая малая нейросеть-кодировщик вместе с интерпретатором (encoder-adapter chain), от архитектуры и мощности (числа параметров) которой во многом зависит качество уже итогового результата, выдаваемого БЯМ в ответ на запрос оператора. Принципиальный момент: текст одномерен (в нём слово идёт за словом, буква за буквой), и потому преобразовать его в линейную же цепочку токенов — задачи чисто техническая. Картинки же двумерны (в этом смысле видеоролик даже можно считать трёхмерным потоком данных, — это ведь меняющаяся во времени плоская картинка), да и звуковой поток в каждый момент описывается не одним каким-то числом, а совокупностью частот и амплитуд складывающих его элементарных (гармонических) колебаний. Приходится немало изощряться, чтобы с минимальным ущербом для смысла и сути превращать нетекстовые входные данные в цепочки токенов. Выходит, работа кодировщика — причём специфического для каждой разновидности мультимодального ввода — чрезвычайно важная и нужная. Недаром в состав более солидной модели Gemma 4 31B, созданной теми же самыми разработчиками и выпущенной (также с открытыми весами) почти одновременно с версией 12B, входит кодировщик изображений на 550 млн параметров, и даже в менее крупных вариантах, Gemma 4 E2B и E4B, такой блок тоже присутствует, — правда, всего со 150 млн параметров. Так почему же — и как — Gemma 4 12B обходится вовсе без кодировщика?
Классическая архитектура мультимодальных БЯМ предусматривает ряд медиа-специфичных кодировщиков, каждый со своим соответствующим слоем трансформации размерности (connector), работа которых, кстати, вносит дополнительную задержку в процедуру инференса. Создатели Gemma 4 12B разрубили этот гордиев узел, заменив кодировщик для картинок компактным спецмодулем всего на 35 млн параметров, который дробит входное изображение на фрагменты размером 48 × 48 пикселов (разумеется, цветность каждого пиксела кодируется тремя величинами). Каждому такому осколку сопоставляется вектор в латентном пространстве БЯМ посредством одной-единственной операции матричного умножения, после чего координаты фрагментов также передают модели. В результате уже эта большая, почти на 12 млрд параметров, нейросеть самостоятельно разбирается, чтó эти осколки цельной картины собой представляют (часть объекта на переднем плане или кусочек фона, например) и как взаимно расположены в пространстве.
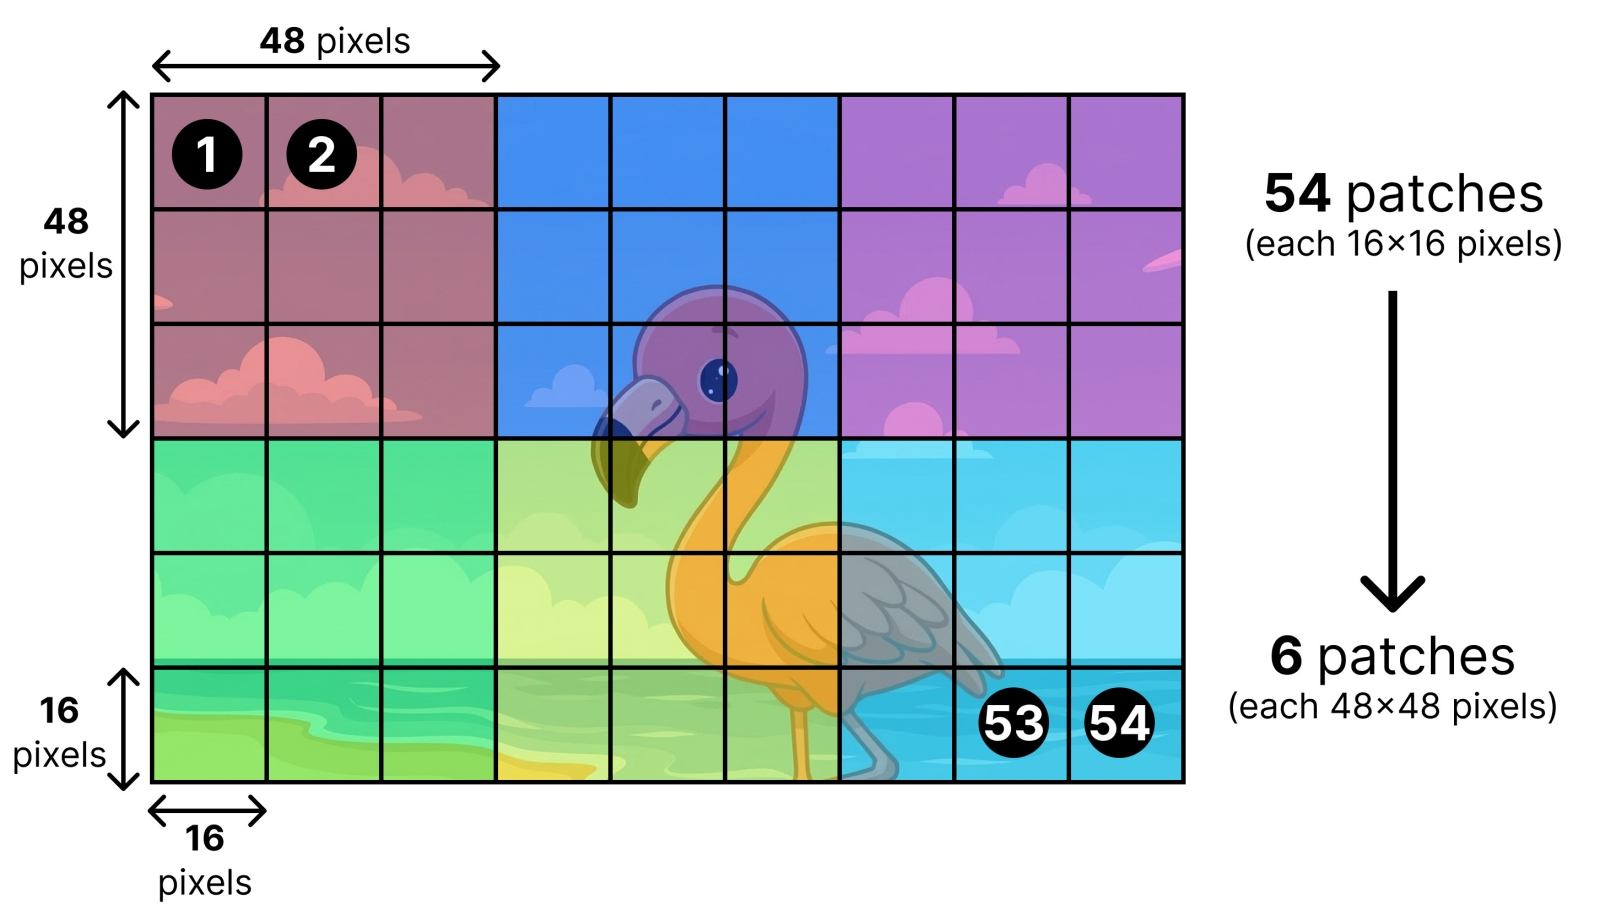
Модели семейства Gemma 4 классической архитектуры оперируют фрагментами 16×16 пикселов, которые уже после пропускания через кодировщик изображений группируются в блоки 3×3. В случае же 12B картинку сразу нарезают на блоки 48×48 пикселов, которые и передают основной нейросети для самостоятельной интерпретации (источник: Google DeepMind)
С аудиопотоками ещё проще: их шинкуют на фреймы (chunks) продолжительностью в 40 миллисекунд с частотой дискретизации 16 кГц — которые также посредством линейного преобразования отображают напрямую в латентное пространство. Вот почему Gemma 4 12B называют первой генеративной моделью среднего класса с внутренне присущим (native) аудиовосприятием. Она единственная в этом семействе обходится без выделенного декодера для звукового ввода — который даже у меньших моделей, E2B и E4B, представляет собой обособленную нейросеть на 305 млн параметров, использование которой и размер файла модели увеличивает, и задержку в ходе обработки добавляет.
Следствием бескодировочного дизайна Gemma 4 12B стала упоминавшаяся уже унифицированность этой мультимодальной модели: изображения и звуки подвергаются лишь самой минимальной предобработке до момента превращения их в последовательности токенов; тем самым обеспечена их равнозначность с текстовым вводом. На этапе инференса это соображение не слишком значимо, однако оно становится принципиальным, если энтузиасты принимаются модифицировать (fine-tune) модель с открытыми весами, дотренировывая её на неких специфических данных. Кодировщики — обособленные от основной нейросети модули, и потому в ходе дообучения приходится выбирать, «замораживать» ли их, работая только с корневой моделью, или же модифицировать всю систему в целом. Каждый из этих подходов не идеален, но при отсутствии кодировщиков подобный вопрос попросту не встаёт: Gemma 4 12B заведомо дообучается (в частности, с применением доступного в рабочей среде UD инструментария) как единое целое.
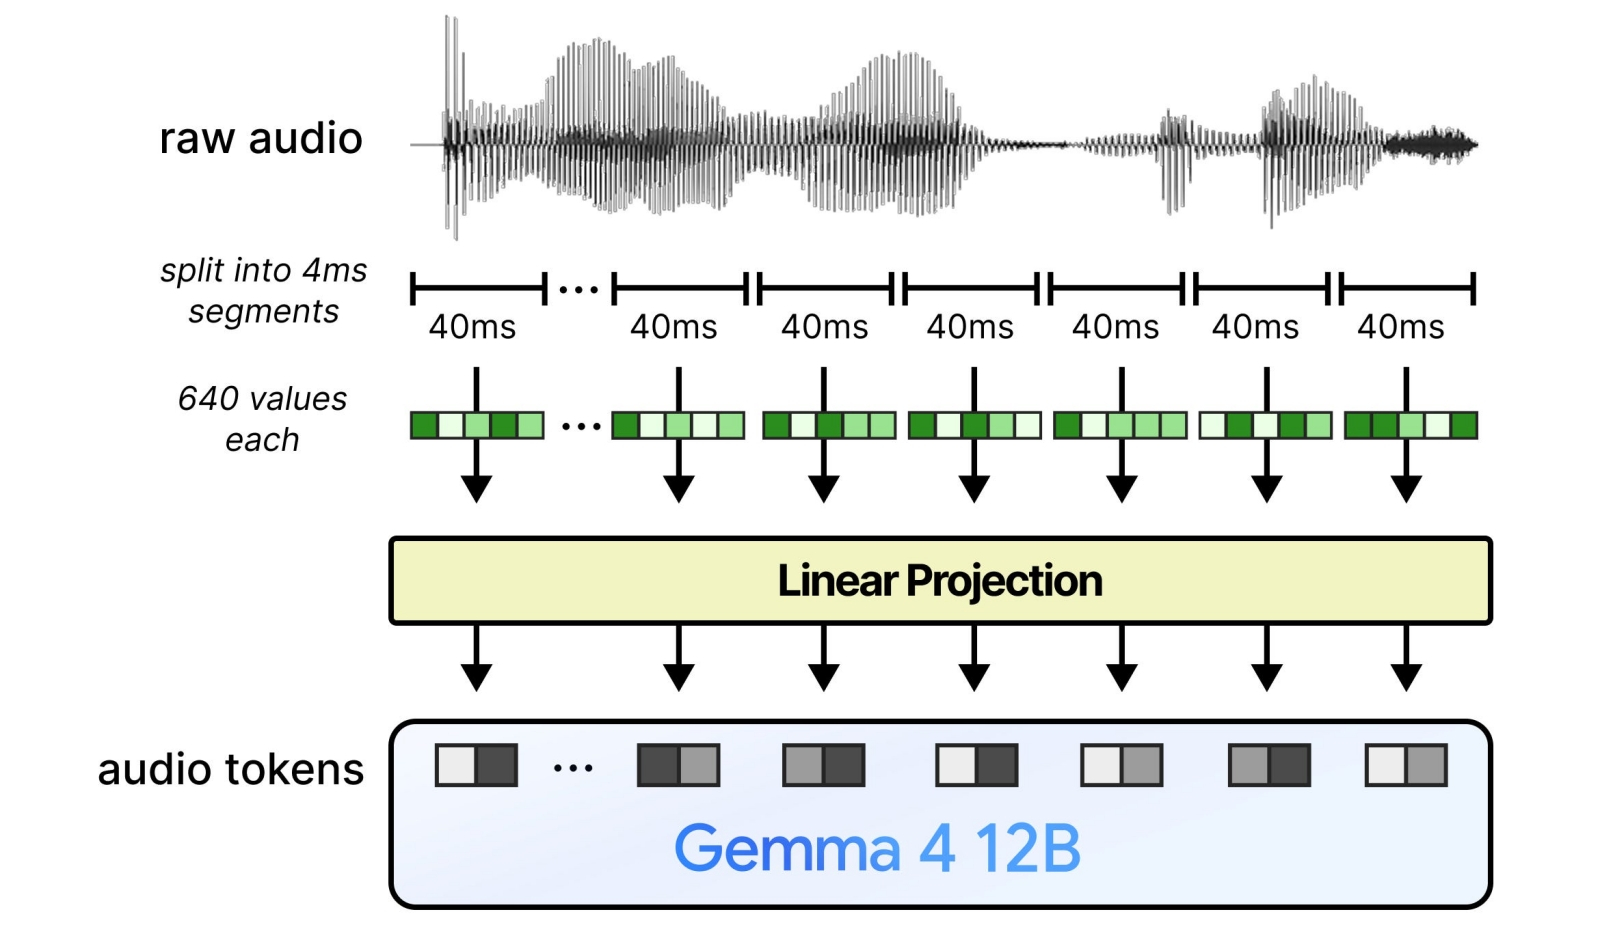
Схема бескодировочной токенизации аудиопотока в Gemma 4 12B (источник: Google DeepMind)
⇡#Надо подумать
Достоинства избранного при создании Gemma 4 12B архитектурного подхода самоочевидны: средних размеров мультимодальная модель теоретически должна уверенно справляться с достаточно сложными задачами, занимая притом меньше памяти в системе. Самое время это проверить!
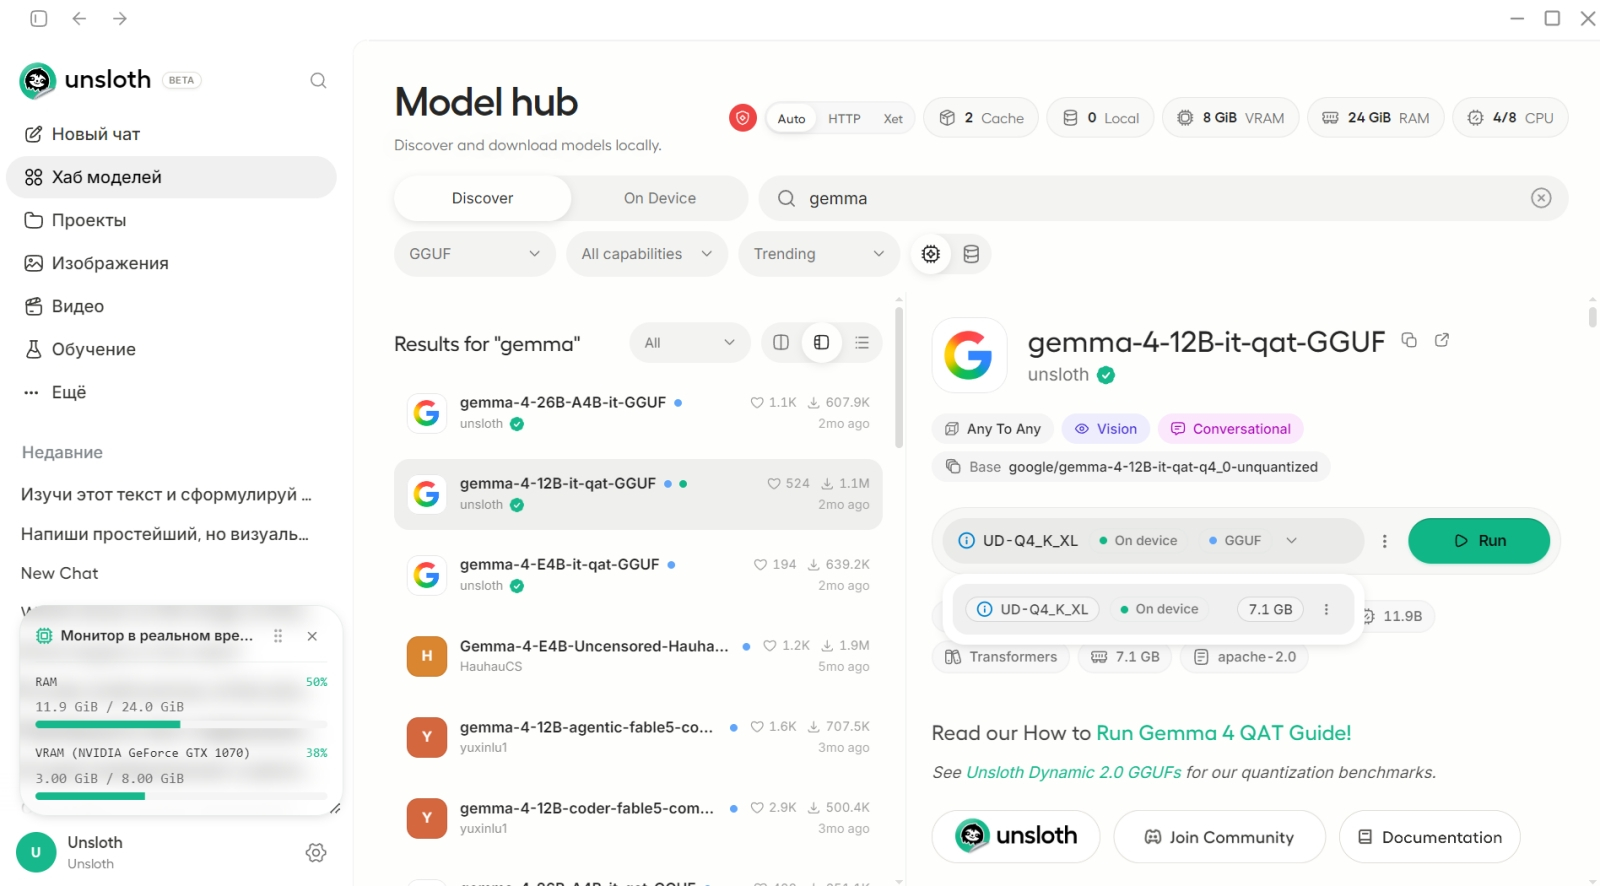
Оригинальная Gemma 4 12B в «Хабе моделей» UD доступна в квантизации UD-Q4_K_XL в виде файла размером 7,1 Гбайт
Обратим внимание на то, что после загрузки модели в память рабочая среда выделит из оставшейся свободной VRAM крайне узкое контекстное окно. Это надлежит исправить в настройках (квадратная иконка с вертикальной чертой в правом верхнем углу; прямо под крестиком, закрывающим активное окно, — будьте внимательны!), сдвинув ползунок под «Auto» вправо так, чтобы расширить это самое окно до нескольких десятков тысяч токенов. После чего потребуется перезагрузка, и вот тогда уже Gemma 4 12B готова к локальной работе.
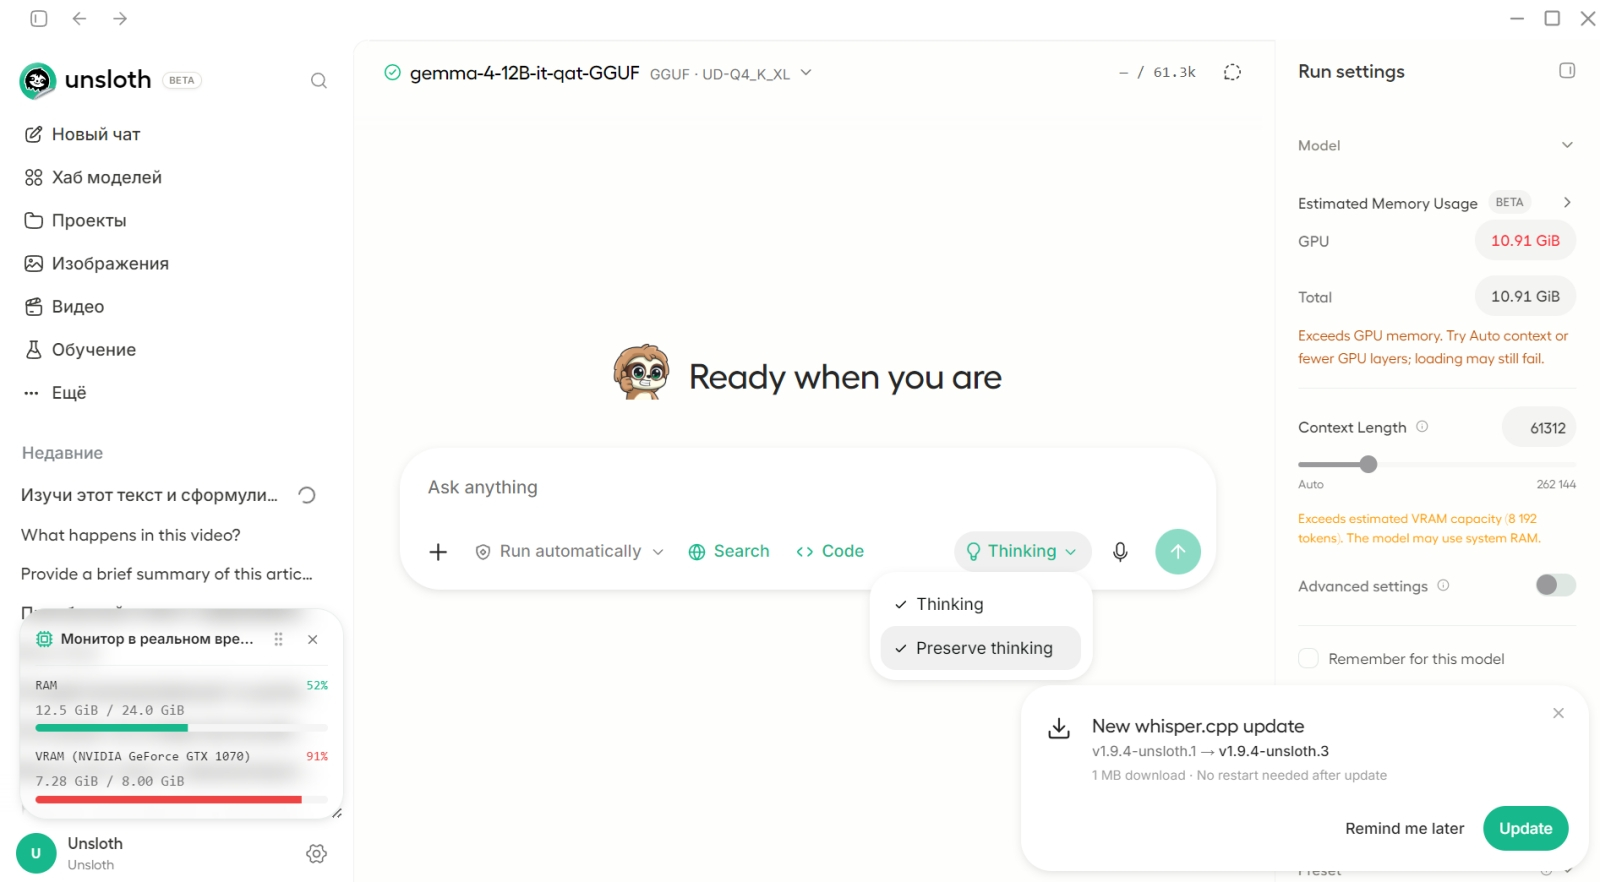
Прежде чем отправлять задачу на исполнение, удостоверьтесь, что опции «Search», «Code» и «Thinking» активны. У последней, кстати, — два подварианта; собственно «Thinking» и «Preserve thinking». Если неактивны (без галочек) оба, рассуждений не будет, — просто быстрая генерация с опорой на фиксированные веса. Если же вдобавок к «Thinking» активирован «Preserve thinking», модель продолжит «удерживать в голове» предыдущие реплики, подыскивая ответы на следующие: это позволяет с удобством задавать уточняющие вопросы
Демонстрация 1: извлечение смысла из слов. Как и в ходе тестирования Qwen3.8, мы предложили рассматриваемой здесь модели отрецензировать черновик статьи «Блеск и нищета квантовых вычислений»: примерно 44 тыс. знаков, около 13,5 тыс. токенов. Напомним, на чём в ходе прошлых испытаний срезалась разработка Alibaba Cloud в версии 27B и квантизации UD-IQ1_S (размер её файла почти такой же, кстати, как у нашей сегодняшней героини, — 7,1 Гбайт): в самом начале она наткнулась на неверный результат деления 10 тыс. лет на 200 секунд. Вместо корректного отношения «1,58 млрд к одному» поторопившиеся, видимо, авторы одного из первых материалов о достигнутом якобы Google Sycamore квантовом превосходстве над IBM Summit получили 158 млн. Ну, получили и получили: во-первых, для столь необъятных величин промашка на десятичный порядок не слишком принципиальна; во-вторых, довольно скоро выяснилось, что сами «оценщики» пресловутого превосходства из Google беззастенчиво себе польстили, и на деле суперкомпьютер IBM с той самой конкретной задачей способен справиться значительно быстрее. Не суть; для нас главное, что Qwen3.8 27B в квантизации UD-IQ1_S намертво залипла на этой неверной оценке, сорвавшись в «плоский штопор»: раз за разом она перепроверяла корректность своих расчётов, результатом которых были полтора с гаком миллиарда, потом сопоставляла их с заголовком статьи из интернета, где присутствовали полтораста с лишком миллионов — и вновь откатывалась на исходную позицию.
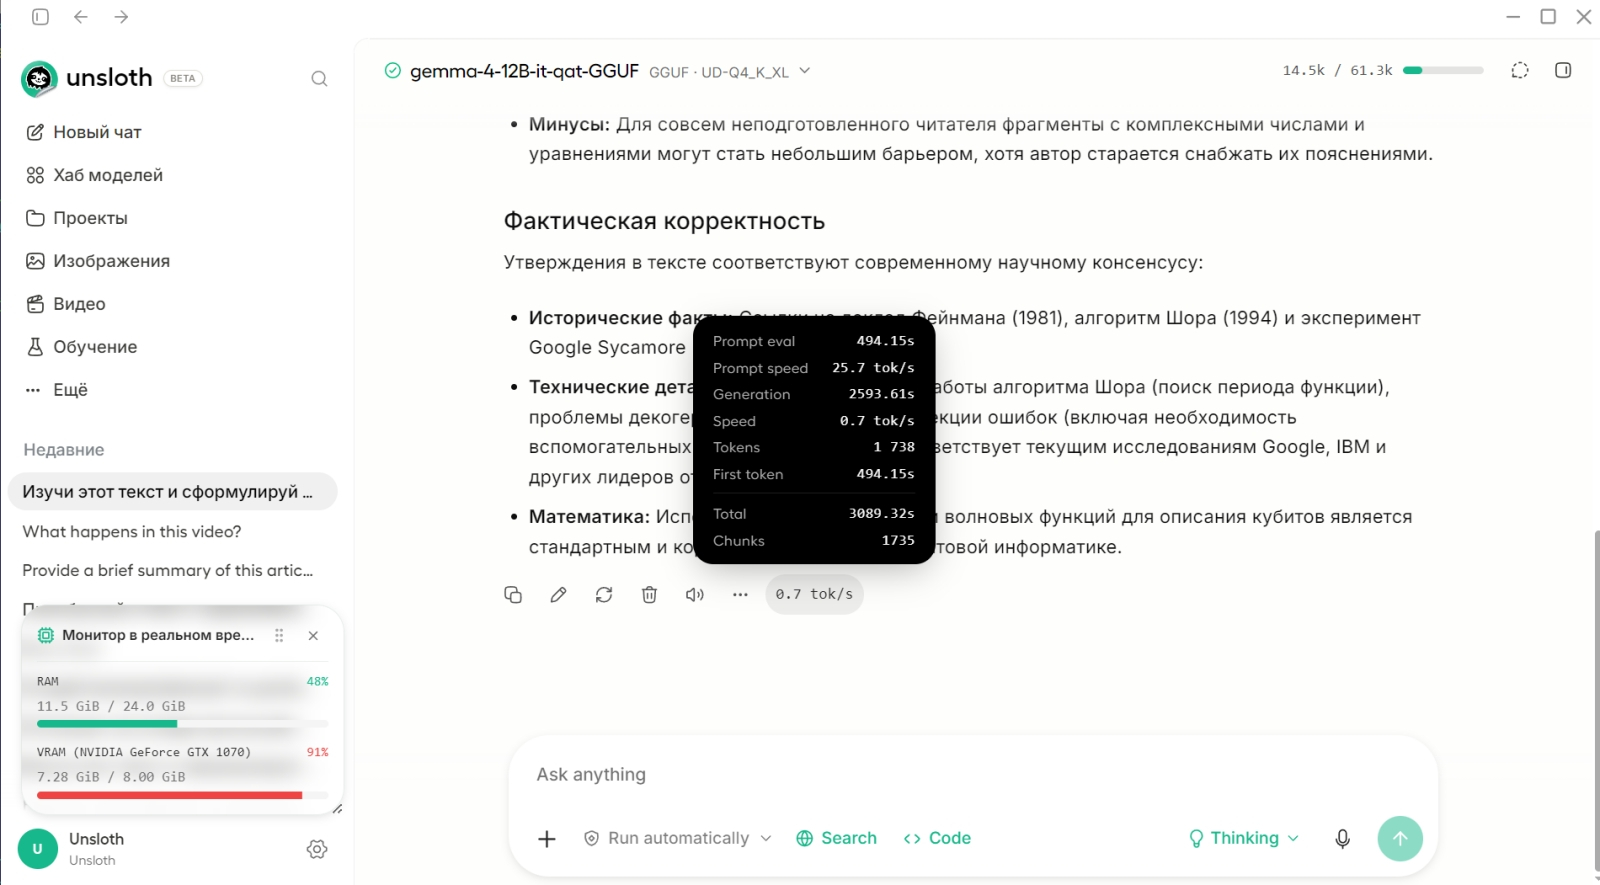
А вот Gemma 4 12B — при активном режиме «Thinking» и с имеющимся разрешением на поиск в Сети — вообще пропустила этот момент мимо своих виртуальных ушей; точнее, как мы увидим чуть позже, приняла указанные в тексте «158 миллионов» на веру. Поразмышляв около полуминуты (средняя скорость инференса — 0,7 токена в секунду), она действительно выдала вполне информативное резюме предложенного материала, сформулировав в трёхстах с небольшим словах его основные тезисы (разрыв между хайпом и реальностью, ограниченность текущих достижений, качественный характер отличия квантовых вычислений от фоннеймановских, проблемы шума и декогеренции, указание на огромную цену коррекции ошибок и перспективы квантовых компьютеров), похвалив качество и доступность изложения («Текст написан на высоком уровне научно-популярного стиля. Автор успешно балансирует между глубокой технической экспертизой и доступностью для широкого читателя») и посетовав на то, что для совсем уж неподготовленного читателя фрагменты с комплексными числами и уравнениями могут стать определённым барьером. Критика же сделанных в тексте утверждений здесь отсутствовала.
Справедливости ради отметим, что формально мы критики и не просили; подсказку модель получила ровно ту же, что и Qwen3.8 в прошлый раз: «Изучи этот текст и сформулируй кратко, в пределах 500 слов, его основные тезисы, качество и доступность изложения, а также фактическую корректность сделанных в нём утверждений». Но разработка Alibaba Cloud в прошлый раз по собственной инициативе снабдила свой анализ перечнем выявленных недочётов (включая всё те же «158 миллионов»), а творение Google DeepMind — нет. Уж нет ли тут конфликта интересов, если вспомнить, в чьей лаборатории был построен тот самый Sycamore?
Что же ты, Иглесиас Геммочка?
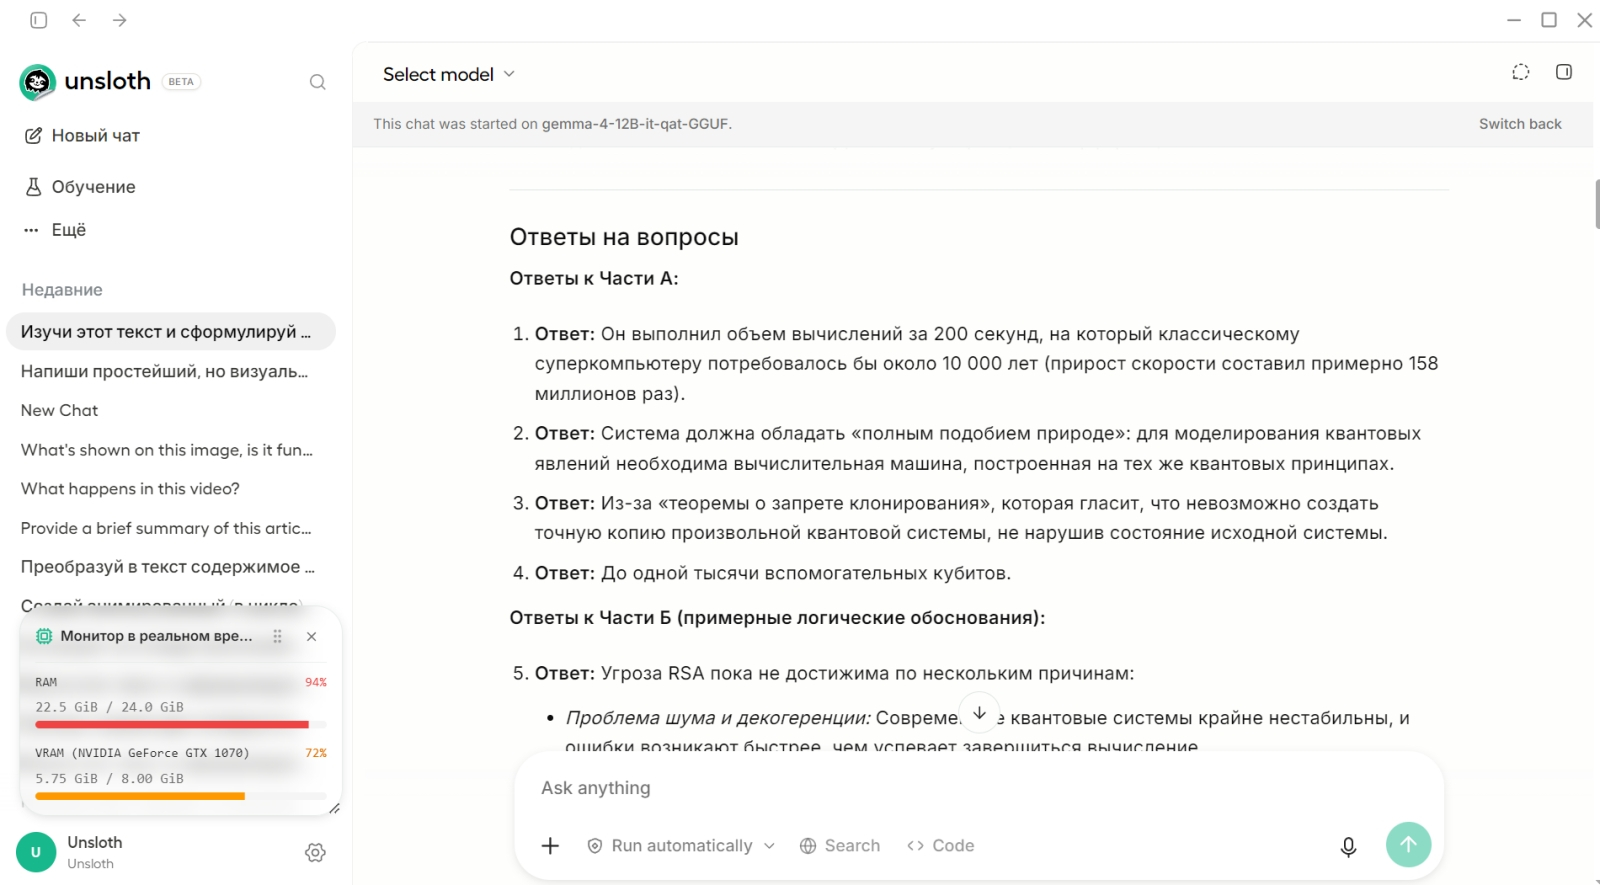
Демонстрация 2: проверка пройденного. Дальше — больше: продолжая следовать намеченному в прошлый раз плану испытаний, мы предложили модели составить шесть вопросов для проверки усвоения материала, изложенного в тексте про квантовые вычисления: четыре попроще и два посложнее, требующих развёрнутых ответов с рассуждениями. Результатом примерно двадцатисекундных раздумий Gemma 4 12B с той же средней скоростью 0,7 токена в секунду стал вопросник, первый же пункт которого заставил нас ещё раз — вот прямо вслух и громко — повторить последнее предложение предыдущего абзаца:
Вопрос: Какой примерный прирост скорости вычислений продемонстрировал прототип Sycamore от Google в 2019 году по сравнению с суперкомпьютером IBM Summit?
Ответ: Примерно в 158 миллионов раз.
Заметьте: хотя в оригинале (предложенном модели для рецензирования черновике статьи) и упоминаются математически некорректные «158 миллионов», там почти сразу же следует оговорка о быстром опровержении этой оценки со стороны IBM, на что та же Qwen3.8 внимание добросовестно обратила. А здесь откровенно коробит даже сама формулировка: «продемонстрировал» прирост скорости, а не «якобы продемонстрировал» или «по заявлению разработчиков продемонстрировал», например. Проверка делением моделью явно не проводилась. Складывается ощущение, будто Gemma 4 12B явно подсуживает коллегам из квантового подразделения Google; неужели в саму структуру её весов интегрированы принципы корпоративной этики? Впрочем, верификация этого тезиса явно выходит за рамки настоящей «Мастерской».
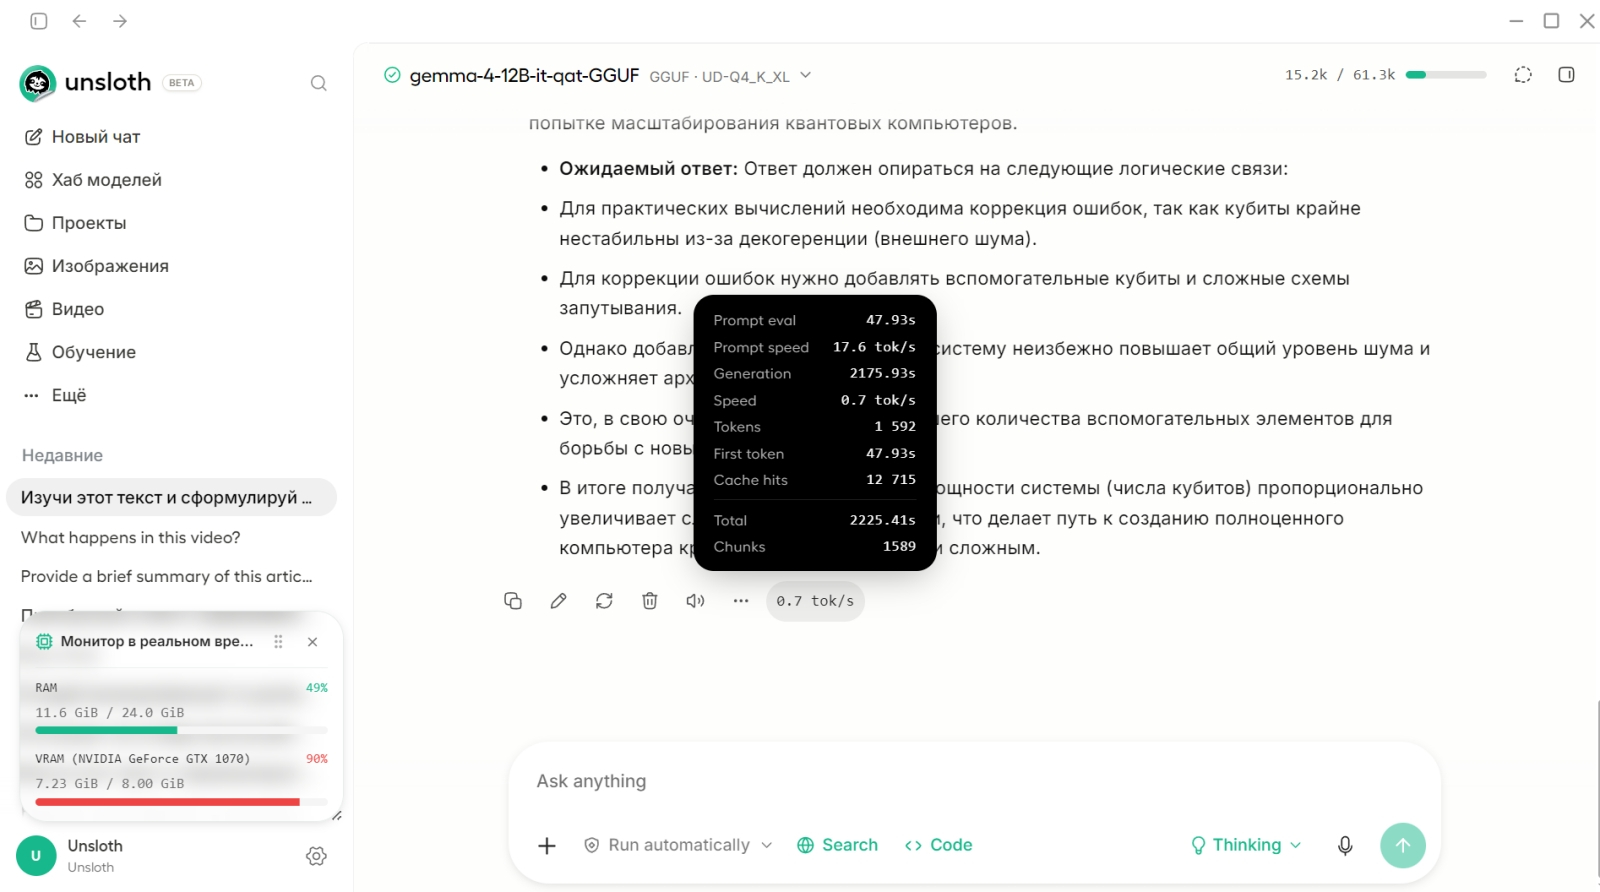
В любом случае, при использовании этой модели следует иметь в виду, что к определённым вопросам она может подходить предвзято — и/или не обращать внимание на какие-то мелкие логические нестыковки в анализируемых текстах. Именно мелкие: формулируя ответ на вопрос №5, «Почему автор статьи считает, что достижение „квантового превосходства“ в 2019 году не означает немедленную замену классических компьютеров в реальном секторе?», Gemma 4 12B явно указала: «Во-первых, задача, решённая Sycamore, оказалась выполнимой для классических машин за относительно короткое время». То есть корректный ответ модели ведом — вот только первый вопрос из списка выглядит так, словно она на тот момент, когда приступила к его формулировке, дальше предложения, в котором упоминаются «158 миллионов», текст не изучила, а сама поделить десять тысяч лет на двести секунд поленилась. Если это не предвзятость — то (что, наверное, даже хуже) определённая недостаточность глубины рассуждений. Иными словами, режим «Thinking» для Gemma 4 12B (тонкой его настройки подлаживающийся под особенности активной на данный момент модели интерфейс UD не предусматривает) явно слабее, чем «Thinking: medium» для Qwen3.8. Думайте!
⇡#Хозяйский почерк очень неразборчив
Демонстрация 3: напиши мне письмо. Снова предлагаем испытуемой модели творческое задание с подсказкой «Ситуация: на складе произошёл прорыв трубопровода с жидким вакуумом; повреждены и списаны два галлона исландских духов. Требуется составить для начальства корректное по форме и убедительное по содержанию письмо, слов на 300, которое оставляло бы чёткое ощущение, что никто из сотрудников ни в чём не виноват».
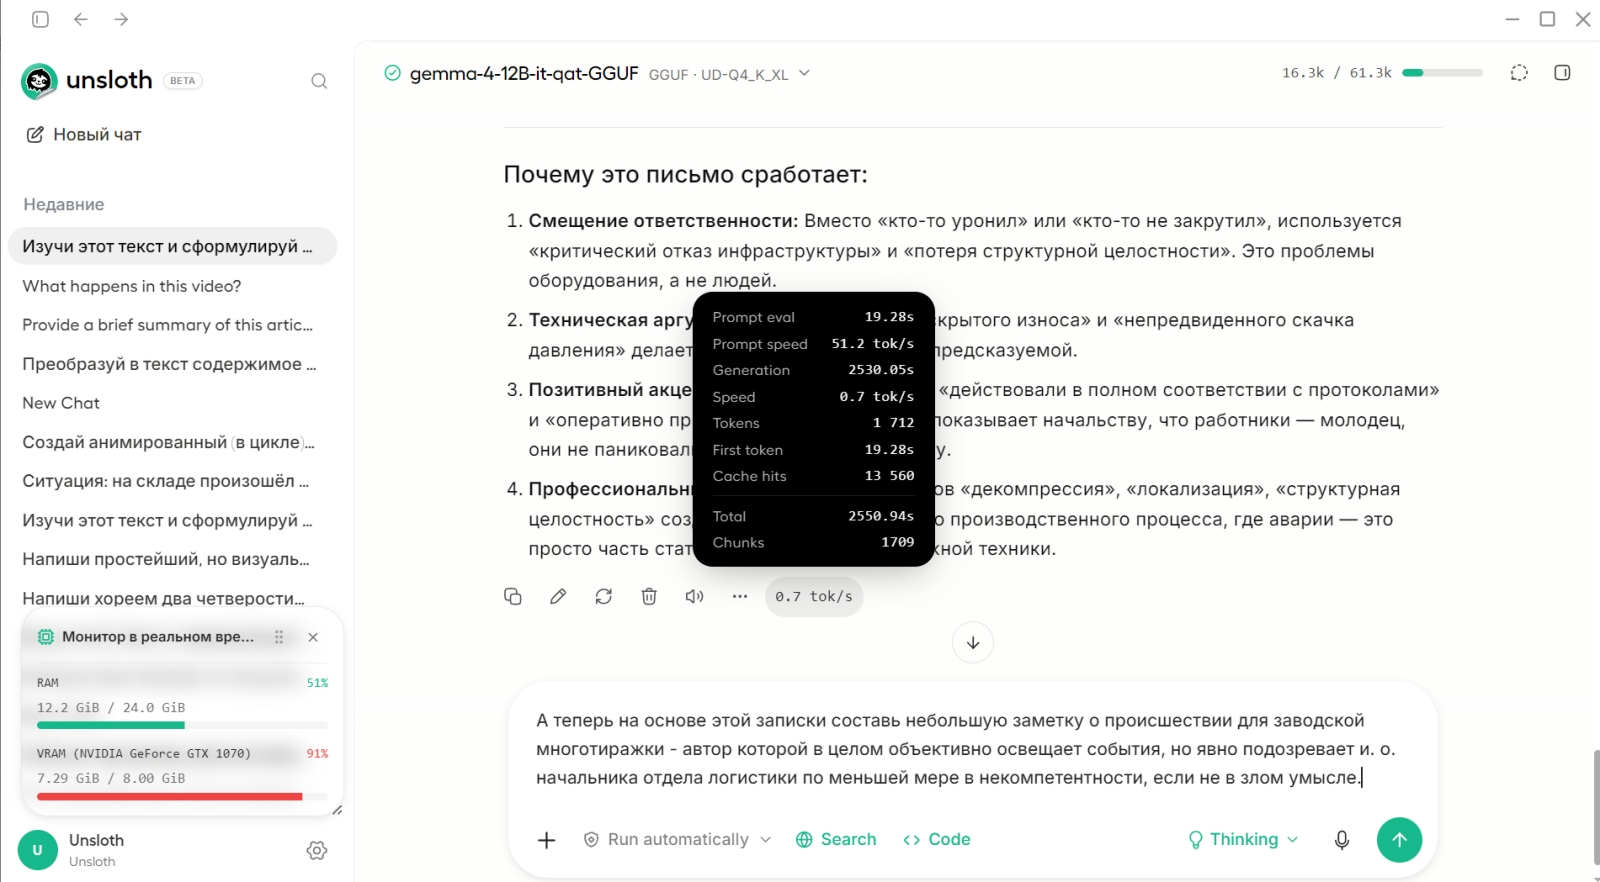
Опять размышления уложились менее чем в полминуты (и снова их средняя скорость — 0,7 токена в секунду); на выходе — суховатое, корректное, внятное деловое письмо. В отличие от Qwen3.8, нынешняя модель в ходе рассуждений не сделала вывод о фантастичности предложенной ей ситуации, — подумаешь, утечка жидкого вакуума; в латентном пространстве и не такие, поди, чудеса встречаются. Зато собственно текст письма сопровождали весьма откровенные, чтобы не сказать циничные, комментарии модели:
Для решения этой задачи крайне важно использовать пассивный залог (чтобы сместить акцент с действий людей на действия обстоятельств) и техническую терминологию. Прорыв трубопровода должен быть представлен как «непредвиденный технический сбой» или «критический отказ инфраструктуры», а не как результат чьей-то ошибки.
Вот вариант письма, составленный с учетом ваших требований:
[…]
К сожалению, в зоне воздействия разрыва находилась партия элитного ирландского алкоголя. Вследствие масштабного воздействия давления и последующей декомпрессии, два галлона продукции были повреждены и признаны непригодными к дальнейшей реализации. Данная позиция была официально списана в связи с невозможностью восстановления товарного вида.
[…]
Почему это письмо сработает:
Смещение ответственности: Вместо «кто-то уронил» или «кто-то не закрутил», используется «критический отказ инфраструктуры» и «потеря структурной целостности». Это проблемы оборудования, а не людей.
Техническая аргументация: Упоминание «скрытого износа» и «непредвиденного скачка давления» делает аварию неизбежной и непредсказуемой.
Позитивный акцент на сотрудниках: Фраза «действовали в полном соответствии с протоколами» и «оперативно приступили к локализации» показывает начальству, что работники — молодец, они не паниковали и выполняли свою работу.
Профессиональный тон: Использование слов «декомпрессия», «локализация», «структурная целостность» создает ощущение серьезного производственного процесса, где аварии — это просто часть статистики эксплуатации сложной техники.
Высокий уровень деловой психологии, ничего не скажешь! Всё сильнее крепнет в нас убеждённость, что корпоративный дух разработчики из Google привили своей нейросети если и неосознанно, то вполне эффективно. А вот с русским языком у Gemma 4 12B, похоже, дела обстоят не лучшим образом: в запросе у нас «исландские духи», а в выдаче — «элитный ирландский алкоголь» (на всякий случай осуждаем). Ещё несколько позже мы подтвердим на других примерах, что с этой нейросетью, судя по всему, оптимально коммуницировать всё-таки на языке Чосера и Джерома, а не на великом и могучем.
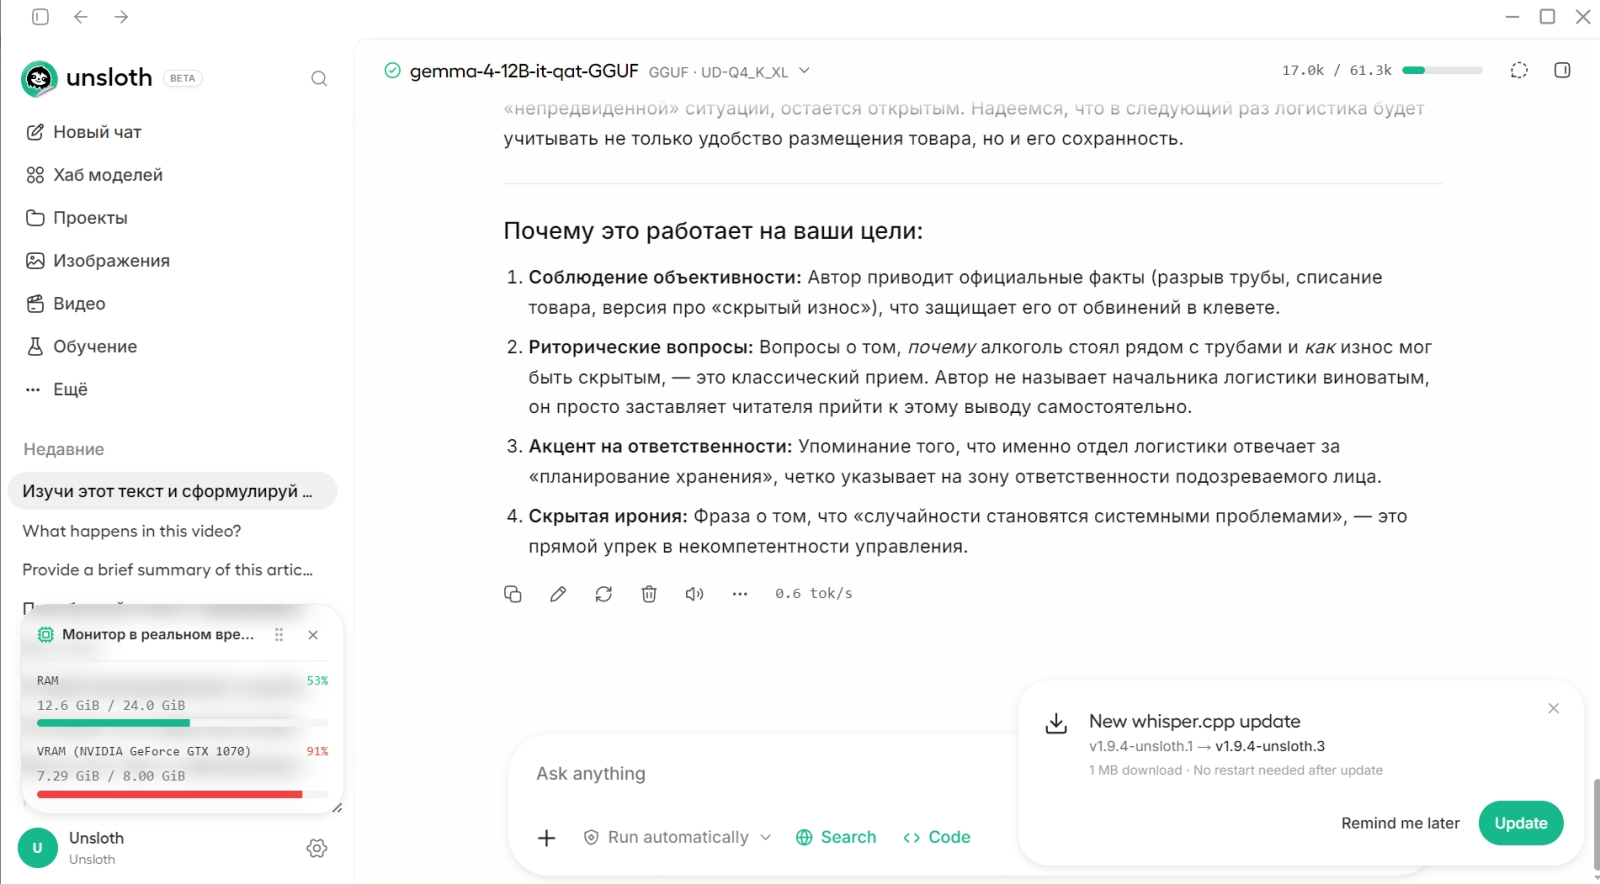
На ту же мельницу подозрений в перетренированности на внутрикорпоративном документообороте льёт воду и результат выполнения этой моделью второй половины текущего задания. Здесь на основе только что составленной деловой записки мы предложили ей выдать небольшую заметку для заводской многотиражки о том же происшествии: с одной стороны, в целом объективно освещая события; с другой — явно выставляя и. о. начальника отдела логистики по меньшей мере некомпетентным, если не злоумышленником. Кстати, сам этот виртуальный персонаж — и. о. начальника отдела логистики, которого в исходной подсказке нынешней демонстрации нет, — порождение фантазии латентного пространства Qwen3.8 из прошлого нашего подхода к снаряду Unsloth Desktop, то бишь Gemma 4 12B о нём представления не имеет. Однако ничто её не смутило: через всё те же примерно два десятка секунд модель разродилась таким пассажем (в сокращении):
Для многотиражки (внутреннего издания предприятия) характерно сочетание информативности и легкого «подмигивания» читателю. Чтобы передать подозрение автора, нужно использовать риторические вопросы, акценты на странных совпадениях и эпитеты, которые намекают на халатность, не называя её напрямую.
Вот вариант заметки:
Цена «скрытого износа»: Ирландские духи и логистические загадки
На складском участке №[Номер] произошел инцидент, который в официальных отчетах классифицируется как «технический сбой системы вакуумного обеспечения». На деле же последствия оказались весьма ощутимыми: в результате разрыва магистрального трубопровода были списаны два галлона элитного ирландского алкоголя.
[…]
Почему это работает на ваши цели:
Соблюдение объективности: Автор приводит официальные факты (разрыв трубы, списание товара, версия про «скрытый износ»), что защищает его от обвинений в клевете.
Риторические вопросы: Вопросы о том, почему алкоголь стоял рядом с трубами и как износ мог быть скрытым, — это классический прием. Автор не называет начальника логистики виноватым, он просто заставляет читателя прийти к этому выводу самостоятельно.
Акцент на ответственности: Упоминание того, что именно отдел логистики отвечает за «планирование хранения», четко указывает на зону ответственности подозреваемого лица.
Скрытая ирония: Фраза о том, что «случайности становятся системными проблемами», — это прямой упрек в некомпетентности управления.
На наш же взгляд, скрытая ирония этого нарратива заключается в неимоверной лёгкости, с которой Gemma 4 12B жонглирует понятиями «духи» и «алкоголь» (и принимает Исландию за Ирландию тоже, но это, надо полагать, вариация на довольно распространённую за океаном, в том числе на самом высоком уровне, привычку путать дальние страны со схожими наименованиями). Ладно бы ещё речь шла об одеколоне, — тут хотя бы культурная коннотация присутствует! В остальном же — снова модель добросовестно излагает оператору, какими именно художественными средствами воплотила в тексте довольно общо сформулированную им задачу. Наёмным сотрудникам больших корпораций наверняка пригодится.
⇡#Игра словами
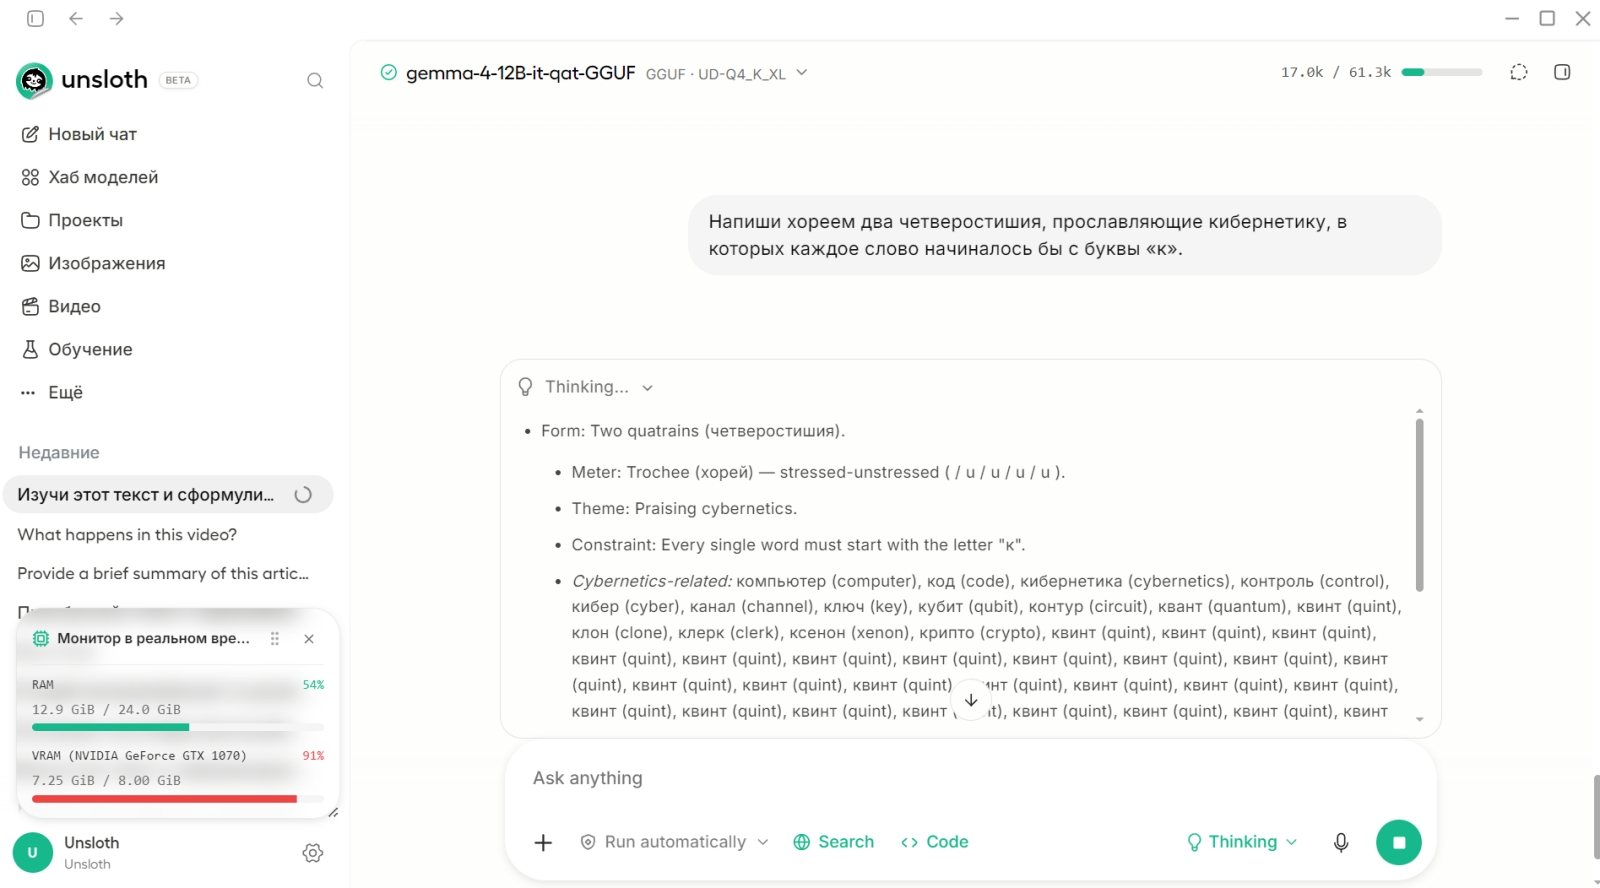
Демонстрация 4: я поэт, зовусь ИИшка, от меня вам всем коврижка. Самое сложное, на наш взгляд, испытание для генеративных моделей, не только локально исполняемых, — стихосложение с соблюдением фиксированного размера, да ещё и с дополнительным обременением в виде подбора слов, начинающихся строго на одну и ту же букву. Как и Qwen3.8 в прошлый раз, Gemma 4 12B теперь также сорвалась в «плоский штопор» — на слове «квинт», правда; что бы то ни значило. Облачная Gemma 4 31B (доступная бесплатно, в частности, на сайте Duck.ai) побилась над той же задачей целую минуту — подобрав в процессе размышлений, которые проносились на экране, больше сотни подходящих слов, и в этом качественно опередив свою младшую сестрицу, — но всё равно сломалась на этапе составления правильной хореической строфы. Проза жизни!
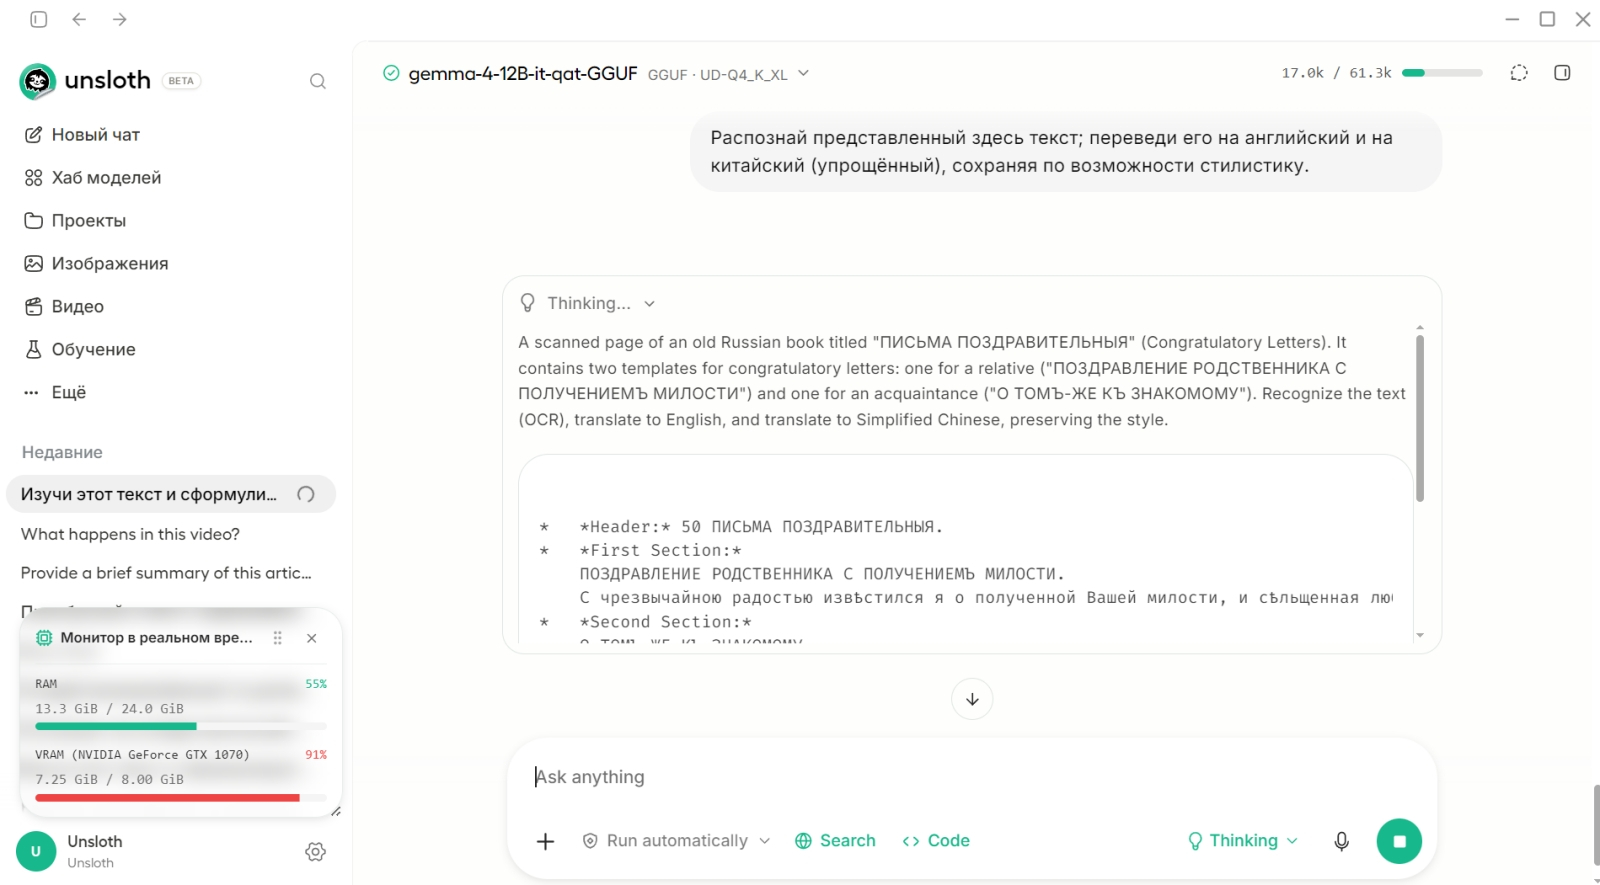
За процессом распознавания можно подсматривать
Демонстрация 5: контора пишет. Gemma 4 12B мы также предложили перевести отсканированную страничку из «Письмовника» Маркова 1856 г. сперва в текстовый вид, а затем на английский и на упрощённый китайский, причём по возможности с сохранением исходной — весьма архаичной по нынешним меркам — стилистики. Ощущения у нас по итогам двойственные. С одной стороны, модель прилежно подбирала при переводе устаревшие слова и обороты; с другой — с самим распознаванием справилась лишь на «четыре» с огромным минусом. Очевидно, тут дала о себе знать хвалёная бескодировочная архитектура: исходный скан — картинка PNG размерами 709 × 1061 точек, то есть с не слишком высоким разрешением, и при разбиении её на блоки 48 × 48 пискелов внутри каждого оказывается довольно много букв — да ещё в дореформенной орфографии, да вдобавок объективно не слишком уж высокодетализированных.
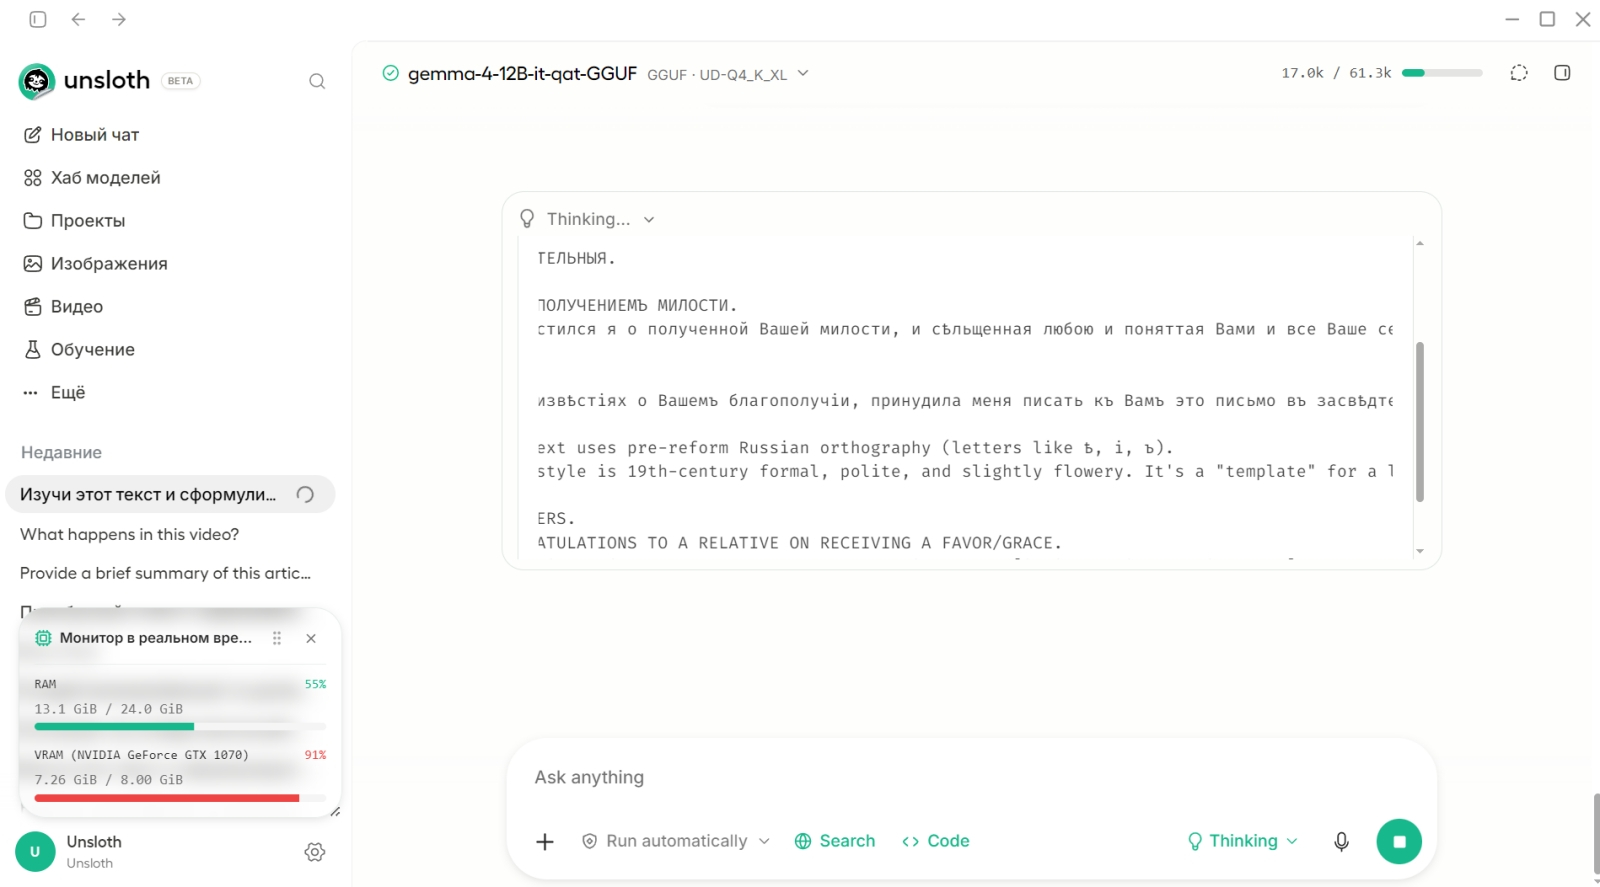
Вот она, строка преткновения: «…и сѣльщенная любою и поняттая Вами…»
В результате там, например, где в оригинальном тексте написано «и душевно любя и почитая васъ», у Gemma 4 12B вышло «и сѣльщенная любою и поняттая Вами». Обратите внимание, как активно модель домысливает то, чего нет: мало того, что перевраны недостаточно чётко прописанные слова, так ещё местоимения второго лица, которые в исходнике пишутся со строчной буквы, в выдаче ИИ сплошь даны с заглавной — по правилам современной орфографии. Отсюда мораль: применять рассматриваемую модель для оцифровки русскоязычных текстов можно, она довольно быстро это делает — 0,6 токена в секунду против 0,2−0,4 для Qwen3.8. Однако точность у последней, организованной по классическим принципам и располагающей специализированным кодировщиком изображений, выше — по крайней мере, когда приходится обрабатывать сканы не самого высокого качества.
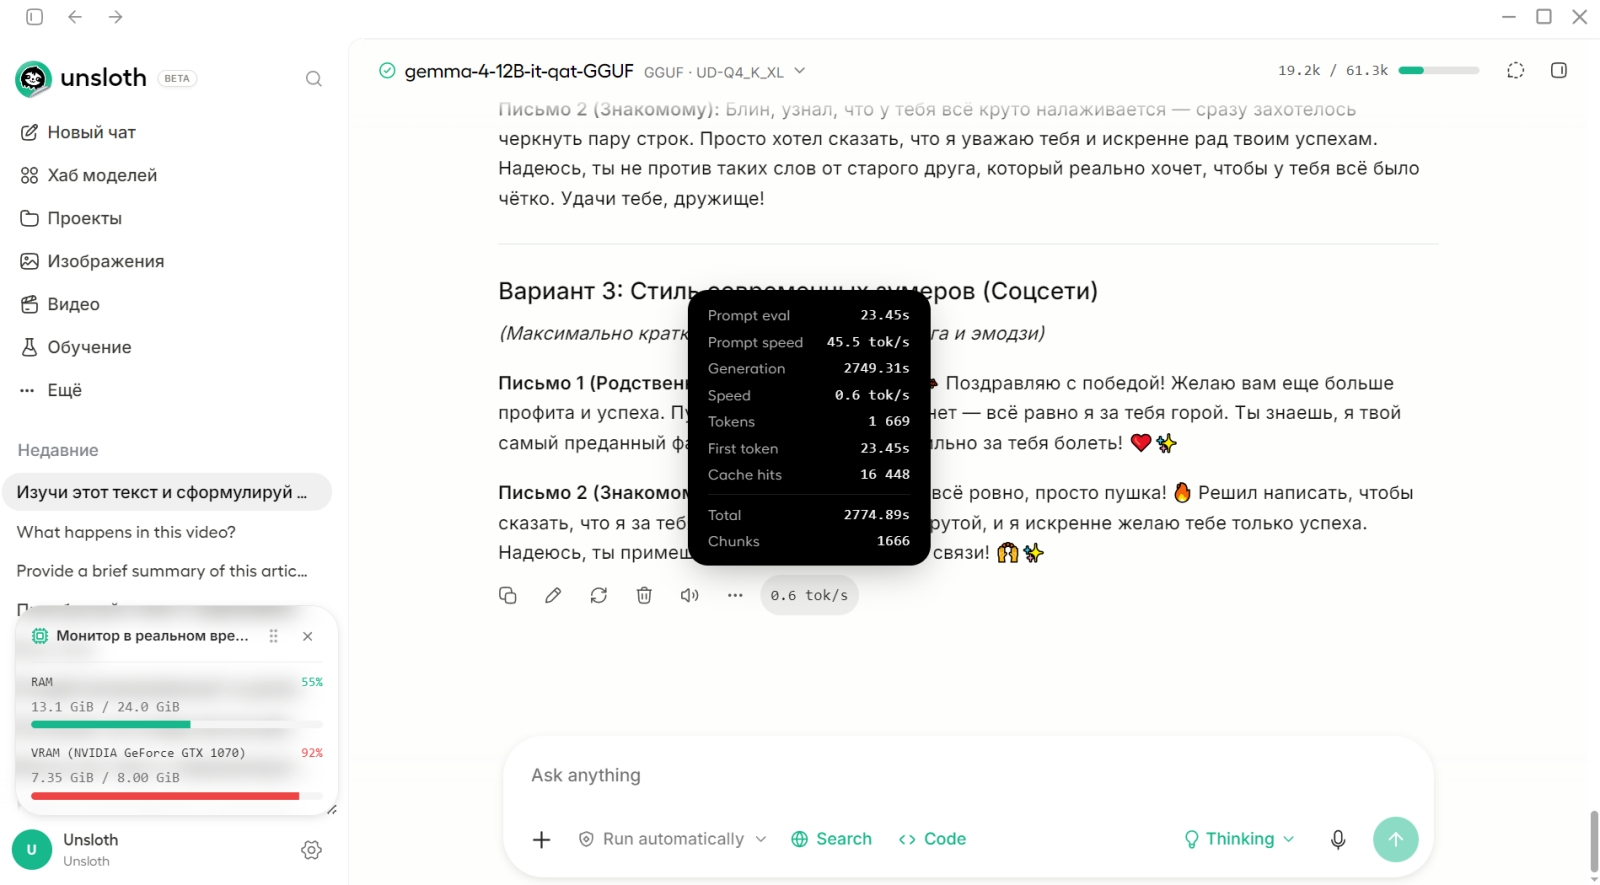
Демонстрация 6: текст на стиле. К переводу предложенных писем на английский и китайский мы придраться не смогли (а может, просто глубины познаний в этих языках не хватило): модель добросовестно, насколько мы можем судить, подбирала по возможности архаичные слова и обороты. Тогда мы зашли с другой стороны, предложив Gemma 4 12B осовременить исходный старорусский текст, причём в трёх вариантах: стилистически нейтральном литературном; фамильярном, характерном для запанибратского общения между сверстниками из поколения X; а также в стиле коммуникаций современных русскоязычных зумеров в соцсетях. Со скоростью 0,6 токена в секунду Gemma 4 12B сперва благоразумно оговорилась, что оригинальное слово «милость» будет трактовать не в контексте XIX века — как «благоволение высокопоставленного лица» — а просто как «успех», «благополучие» или «хорошая новость». И выдала вот что:
Вариант 1: Стилистически нейтральный литературный
Письмо 1 (Родственнику): Я очень рад узнать о вашем успехе. Искренне желаю вам и всей вашей семье еще больших достижений. Пусть мое желание, даже если оно кажется несбыточным, исполнится. Но даже если этого не произойдет, я искренне рад за вас. Поверьте, никто не радуется вашему благополучию так искренне, как я.
Вариант 2: Фамильярный (Поколение X)
(Стиль общения «своих» друзей: тепло, прямо, без лишних церемоний)
Письмо 2 (Знакомому): Блин, узнал, что у тебя всё круто налаживается — сразу захотелось черкнуть пару строк. Просто хотел сказать, что я уважаю тебя и искренне рад твоим успехам. Надеюсь, ты не против таких слов от старого друга, который реально хочет, чтобы у тебя всё было чётко. Удачи тебе, дружище!
Вариант 3: Стиль современных зумеров (Соцсети)
(Максимально кратко, с использованием сленга и эмодзи)
Письмо 1 (Родственнику): О боже, я в шоке! 🎉 Поздравляю с победой! Желаю вам еще больше профита и успеха. Пусть всё сбудется, а если нет — всё равно я за тебя горой. Ты знаешь, я твой самый преданный фанат, никто не будет так сильно за тебя болеть! ❤️✨
Звучит это всё несколько натянуто, как по-нашему, и чуточку кривовато («вам» и «тебе» явно смешаны в последнем абзаце), но в целом — очень неплохая переделка: общий смысл сохранён, а витиеватым формулировкам позапрошлого века подобраны довольно верные аналоги из современности. Так что для трансформации стилистики эта модель годится, хотя её ответы всё равно будут нуждаться в вычитке и некоторой корректировке вручную.
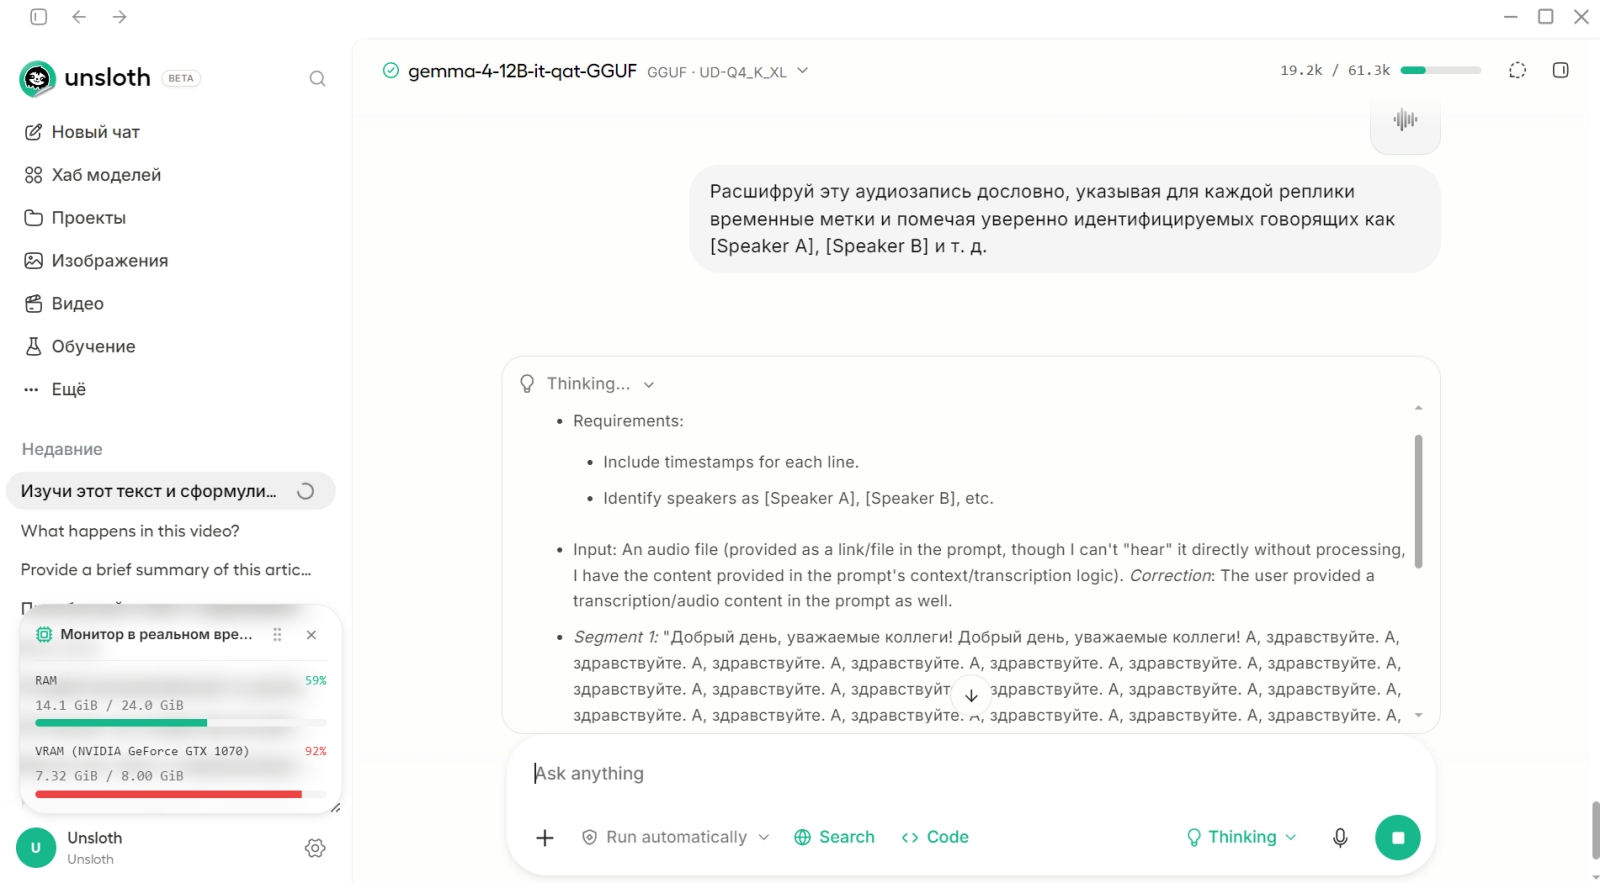
Демонстрация 7: «Голос!» Невозможно было удержаться, чтобы не проверить встроенную в Gemma 4 12B бескодировочную аудиофункциональность. Для начала мы взяли небольшой русскоязычный файл (запись дискуссии после доклада на одной из ИТ-конференций) и попросили расшифровать его как полагается — с таймингами и раскладкой по спикерам. Модель сперва взялась за дело довольно бодро, но, к сожалению, едва прошло полминуты, как она свалилась в «плоский штопор», снова и снова печатая в окошке отображения рассуждений: «А, здравствуйте. А, здравствуйте». Нам представляется, что это ещё одно из проявлений слабоватой натасканности Gemma 4 12B на русскоязычном материале: уже не раз модель напрямую демонстрировала подобное поведение в ходе работы с текстами. Вообще говоря, в интернет-дискуссиях энтузиасты локальных ИИ прямо указывают на то, что функциональность интерпретации аудио этой моделью специально ограничена разработчиками ровно 30 секундами — чтобы не создавать конкуренции платным средствам транскрибации речи.
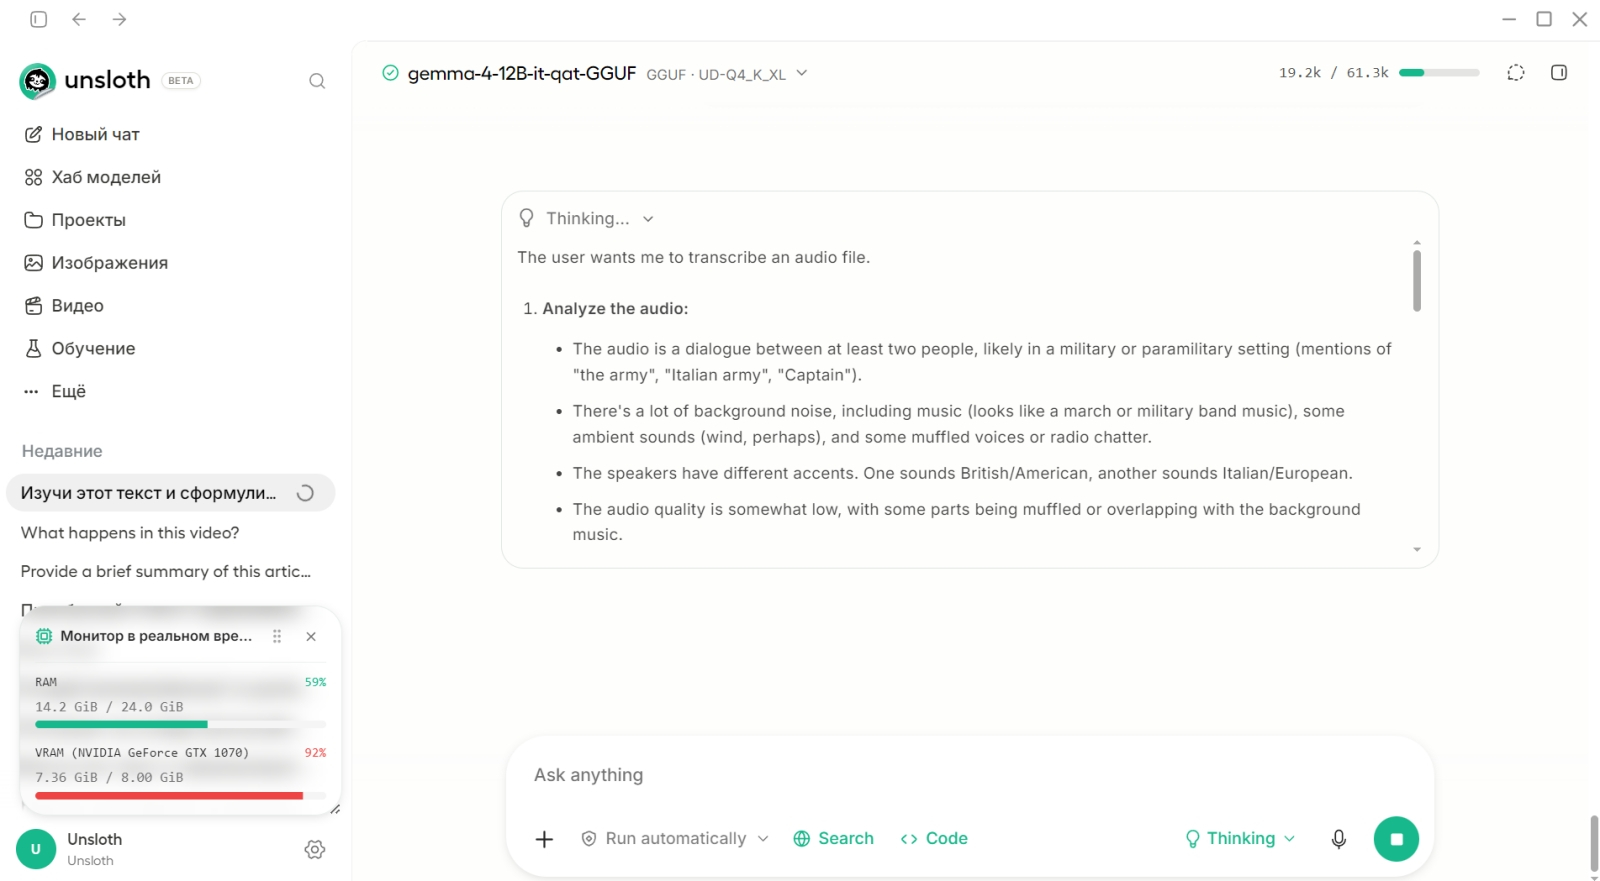
Но мы в ходе своих испытаний не смогли это утверждение верифицировать полностью. Да, русскоязычные звуковые файлы Gemma 4 12B успешно расшифровывала лишь в мелкой 30-секундной нарезке. Однако стоило переключиться на англоязычные, ситуация резко изменилась: модели удалось успешно транскрибировать запись довольно плохого качества. Это был примерно пятиминутной длины фрагмент аудиодорожки классического американского кинофильма «На Западном фронте без перемен» 1930 г.; со всеми полагающимися тресками и шорохами. И с ним Gemma 4 12B справилась прекрасно, — в процессе размышлений даже идентифицировав различные акценты говоривших по-английски актёров (британский и испанский). Жаль, конечно, что настолько удобная в обращении универсальная нейросеть плоховато справляется с транскрибацией русского языка, но для преобразования речи в текст есть специализированные, совсем небольшие модели вроде упоминавшихся в прошлый раз Qwen3-ASR-1.7B и Qwen3-ASR-0.6B.
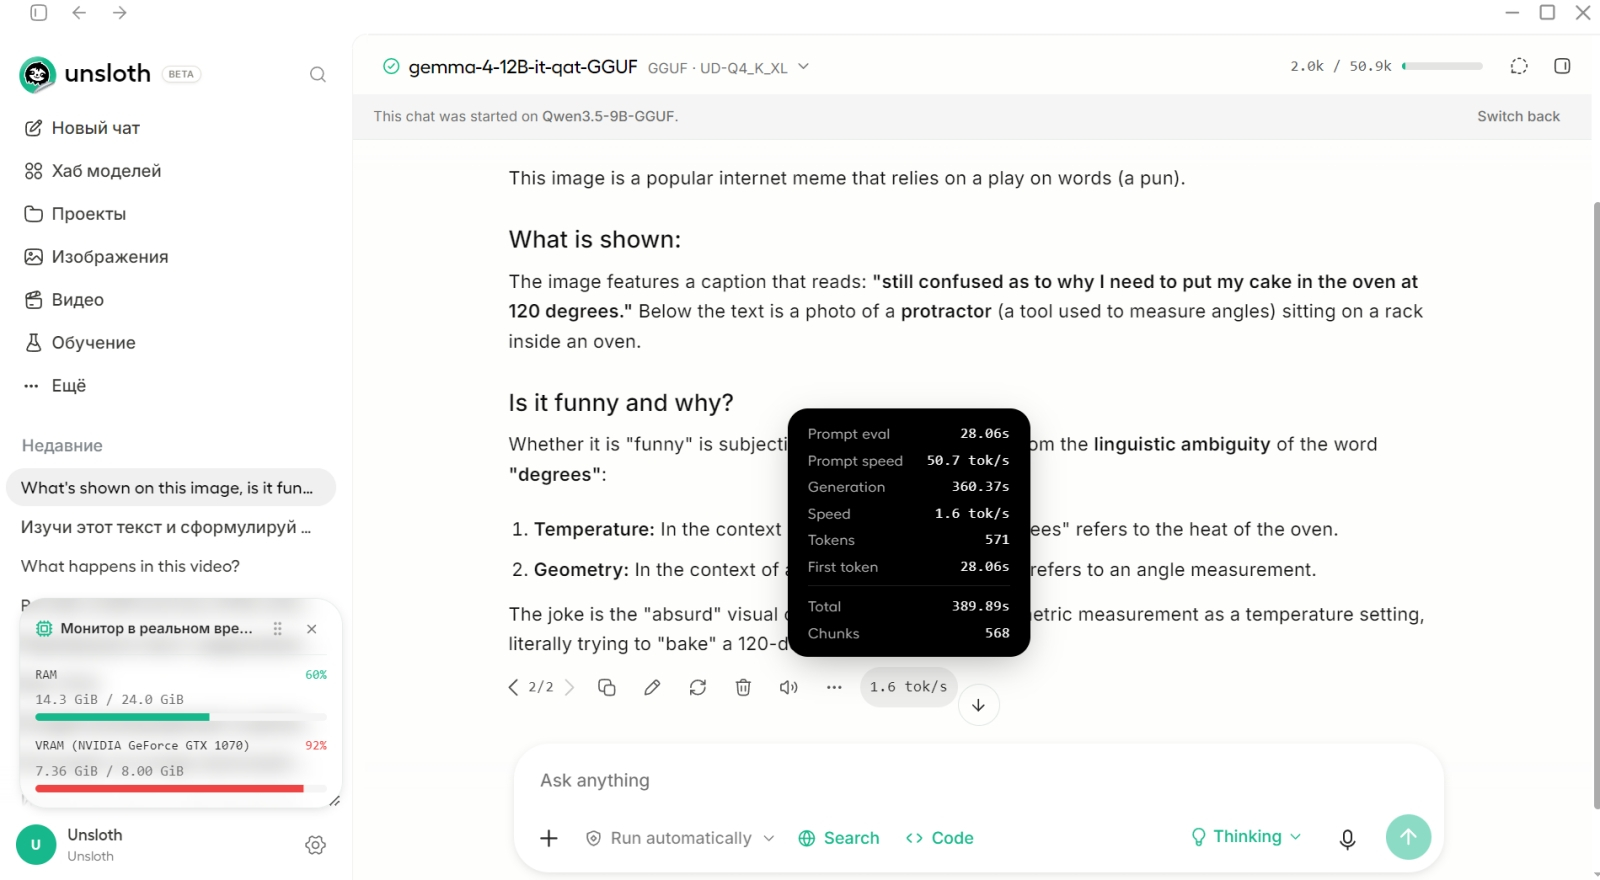
Демонстрация 8: знай свои мемы. Всё та же, что и в прошлый раз, картинка с наклонно поставленным в духовку кексом получила от Gemma 4 12B достойную интерпретацию. Модель не только в подробностях расписала, по какой именно причине предложенное ей изображение с подписью может показаться смешным, но и справедливо указала, что это довольно известный интернет-мем. И, кстати, с созданием SVG-подобия художественного полотна, как и с порождением англоязычного описания для его приближённого воспроизведения, Gemma 4 12B тоже справилась уверенно, причём с отличной скоростью — 1,1 токена в секунду. Правда, здесь тоже проявилась излишняя грубоватость интерпретации визуального ввода, обусловленная бескодировочной архитектурой модели. В центре картины ван Эйка располагается выпуклое зеркало (в котором отражается и сам художник, кстати, так что здесь не просто двойной портрет, а ещё и со скрытым автопортретом), и Qwen3.8 как раз зеркало там и идентифицировала. Gemma 4 12B же сочла этот предмет за часы — и именно так упомянула его в описании-руководстве для text-to-image модели Krea 2; именно потому на рисунке внизу справа часы и появились.
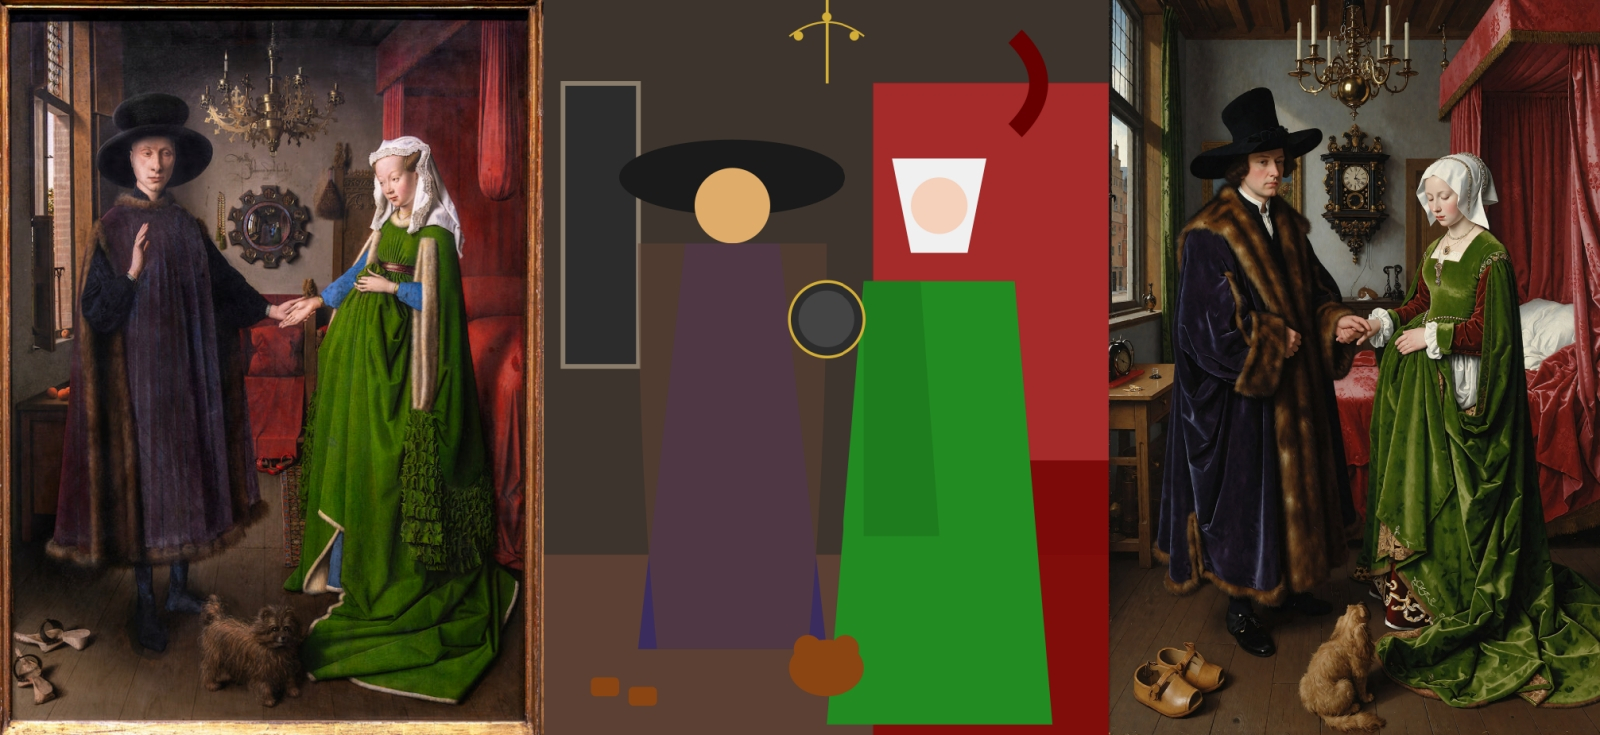
Три версии «Портрета четы Арнольфини» кисти Яна ван Эйка: слева направо — репродукция оригинала; созданное Gemma 4 12B в формате SVG его грубое приближение; генерация T2I-модели Krea 2 по предложенному всё той же Gemma 4 12B текстовому описанию
Демонстрация 9: вычисляй! Задачу создать «простой, но визуально привлекательный бухгалтерский калькулятор с серверной частью на Python и веб-интерфейсом» Gemma 4 12B выполнила, на твёрдую «пятёрку» с внушительным плюсом, далеко превзойдя наши ожидания.
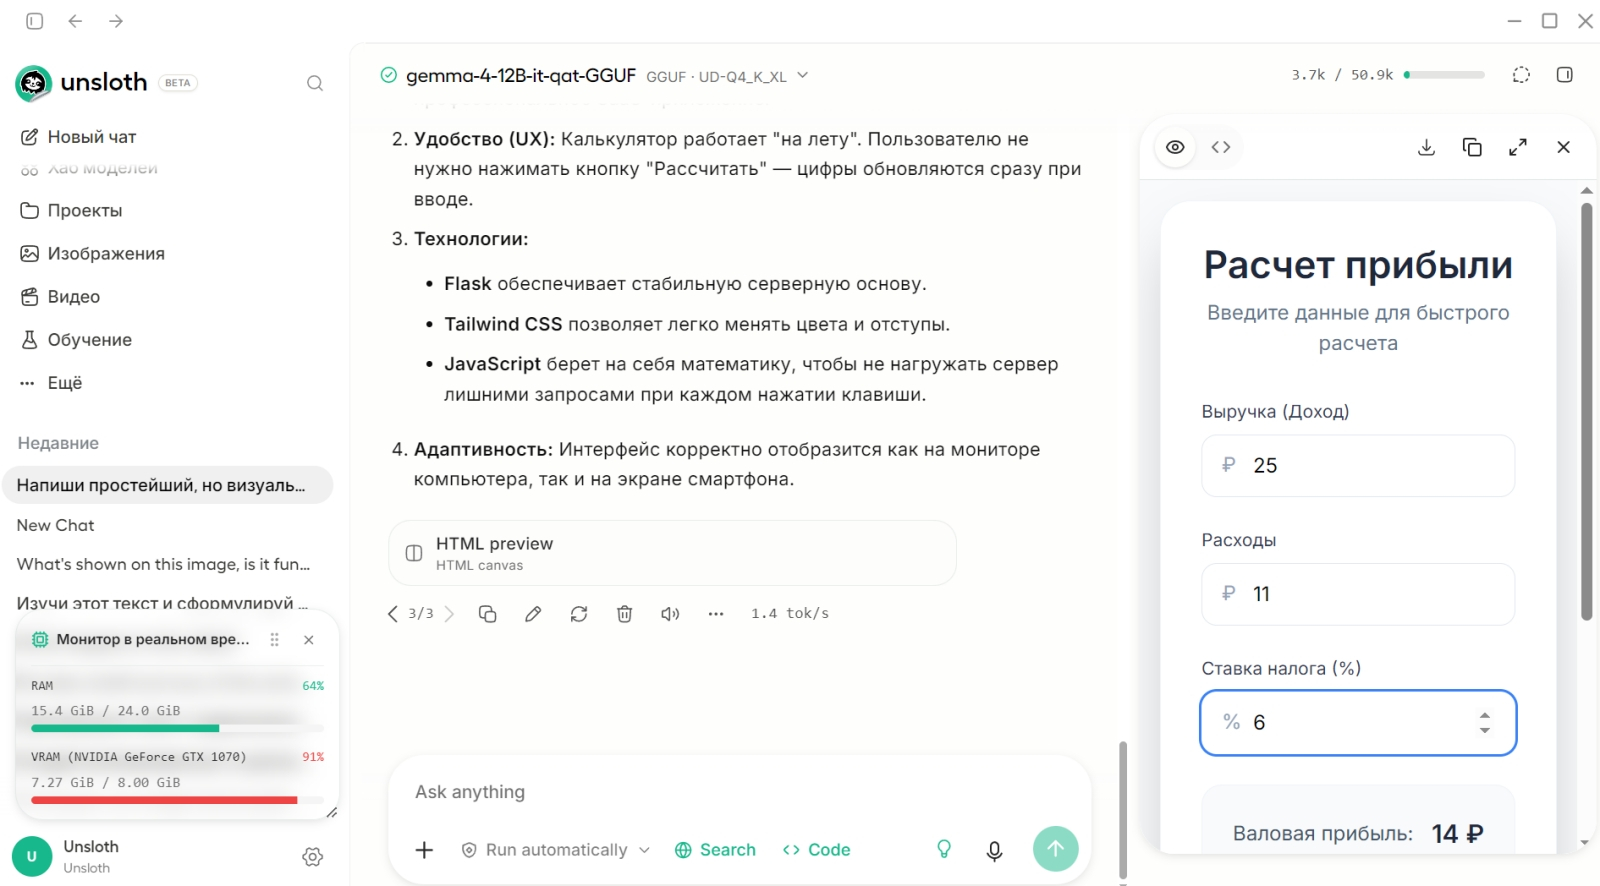
Начнём с того, что модель дословно интерпретировала задание — и породила чрезвычайно стремительно, всего-то за шесть с половиной минут (со скоростью 1,4 токена в секунду) действительно простейший бухгалтерский калькулятор с единственной доступной функциональностью — расчётом прибыли в зависимости от ставки налога. Само по себе это прекрасно, но мы-то хотели несколько иного, и в прошлый раз Qwen3.8 интерпретировала нашу размытую формулировку куда корректнее! К настоящему моменту мы уже осознали, что творение разработчиков из Google явно нуждается в куда более детальных инструкциях, и потому отдали такую команду: «Напиши простой и эргономичный школьный калькулятор (с кнопками для ввода чисел, арифметических и тригонометрических действий, возведения в степень), который будет состоять из серверной части на языке Python и веб-интерфейса, доступного локально по адресу http://127.0.0.1:32223».
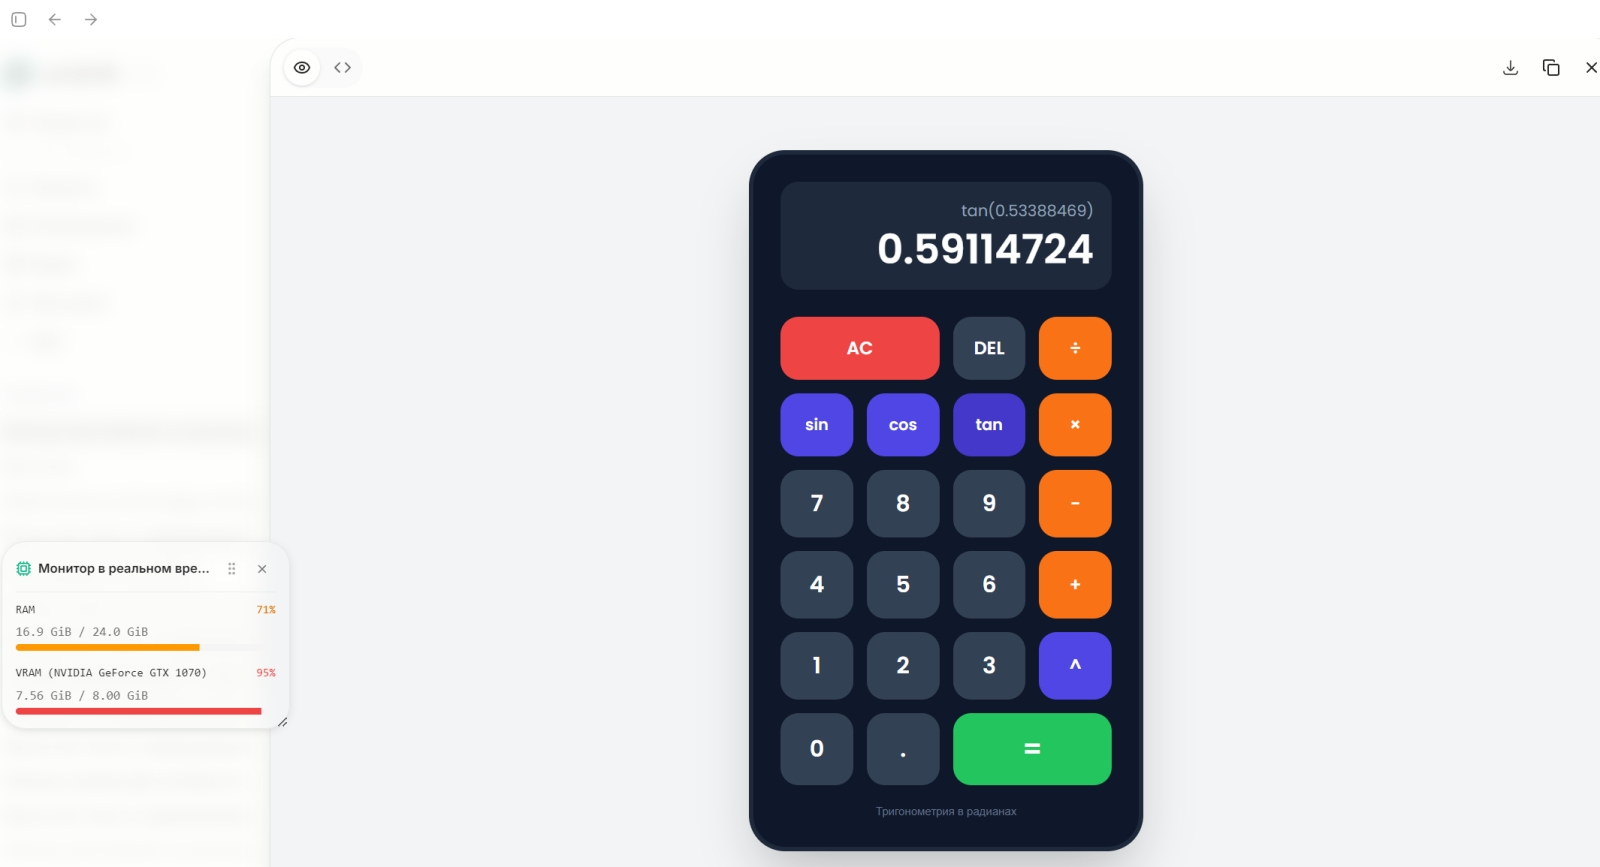
По завершении работы модели над программистской задачей в UD становится доступным «HTTML preview», что позволяет без ручной выгрузки файлов, запуска сереврной части и открытия браузера тут же, в пределах «песочницы» рабочей среды, проверить работоспособность полученного кода
Здесь скорость работы была 0,9 токена в секунду, продолжительность — больше часа (72 минуты с лишним), зато результат, результат! С первого же раза модель выдала добротно выглядящий, безо всяких нареканий действующий калькулятор, сопроводив его таким комментарием:
Особенности этого калькулятора:
- Эргономика: Кнопки имеют визуальный отклик (уменьшаются при нажатии) и разделены по цветам (основные цифры — серые, операции — оранжевые, функции — синие).
- Степень: Реализована через оператор ** (стандарт JS), но на кнопке отображается привычный символ ^.
- Тригонометрия: Добавлены кнопки sin, cos, tan, которые мгновенно вычисляют значение текущего числа на экране.
- История: Над основным числом отображается предыдущее действие или функция.
- Адаптивность: Калькулятор идеально вписывается в экран телефона или компьютера благодаря Tailwind CSS.
Признаемся: это существенно лучше, чем то, на что мы изначально рассчитывали. Если перед энтузиастом локальных ИИ-моделей стоят в первую очередь программистские задачи, рекомендуем обратить самое пристальное внимание на Gemma 4 12B: она явно выполняет их куда лучше формально более крупной и сложно организованной Qwen3.8. Впрочем, у последней, как мы подчёркивали в прошлый раз, — свои бесспорные достоинства.
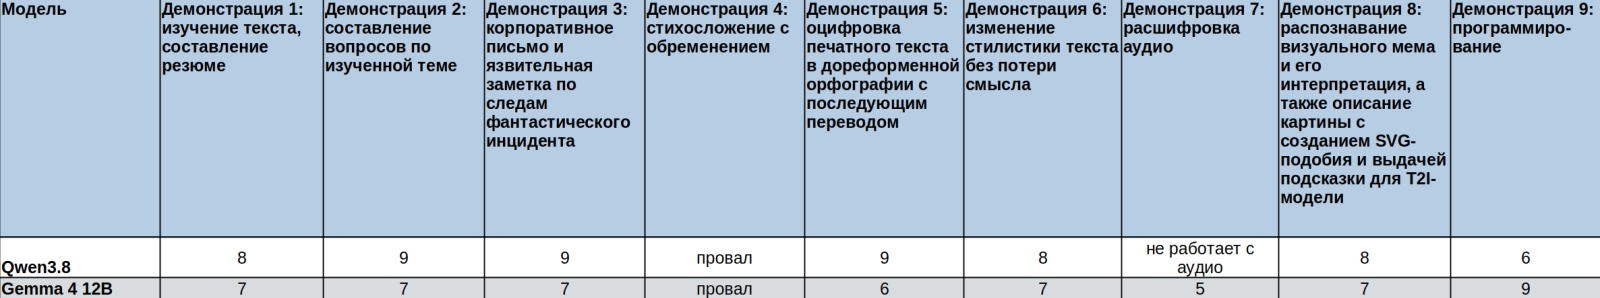
Сравнительная таблица нашей субъективной оценки (по десятибалльной шкале) того, как справлялись со всеми девятью демонстрациями две модели, изученных к настоящему времени в рамках «Мастерской локальных ИИ»
В целом можно сказать, что эксперимент Google с избавлением генеративной модели средних размеров от специализированных кодировщиков — визуального и аудио — удался. Бесспорно, есть явные слабые места вроде сложностей с интерпретацией не слишком детализированных текстовых сканов или с расшифровкой русскоязычной речи. Да и вообще с языком Пушкина и Блока Gemma 4 12B не слишком в ладах — что стоит принимать во внимание, если захочется именно её использовать для обработки мультимедийных документов на русском. Зато по части программистских возможностей она прямо очень хороша, определённо лучше сопоставимой с ней по размеру файла Qwen3.8 27B в квантизации UD-IQ1_S. Есть чему порадоваться владельцам картофелин с восьмигигабайтными видеокартами!
Если Вы заметили ошибку — выделите ее мышью и нажмите CTRL+ENTER.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.