Проверка позиций сайта через API: три месяца я снимал «Яндекс», а отвечал Google
Я снимаю позиции статей, которые выходят не на моём сайте, а на чужих площадках: в отраслевых медиа, блогах, сообществах. Вебмастер и Search Console тут не помогают, они показывают позиции только по домену, который ты подтвердил как свой. Поэтому проверка позиций сайта у меня устроена по-простому: платный API отдаёт органическую выдачу по запросу, скрипт ищет в ней URL статьи и пишет место в базу.
Три месяца, с 7 июля по 13 октября 2026 года, скрипт исправно работал, и за это время в базе накопилось 42 477 строк замеров, и в отчётах они назывались «позиции сайта в Яндексе». 13 октября оказалось, что все они сняты с Google.
Ниже как это получилось, как я теперь проверяю, какой поисковик на самом деле отвечает, и что поменялось в выводах, когда те же ключи сняли в Яндексе.
Один символ в адресе
У провайдера выдачи два адреса с одинаковым форматом ответа:
было с 07.07.2026

XMLRIVERSEARCHURL = "https://xmlriver.com/search/xml"         # это Google

стало 13.10.2026

XMLRIVERSEARCHURL = "https://xmlriver.com/search_yandex/xml"  # это Яндекс
Оба возвращают один и тот же XML с группами, URL и заголовками, поэтому парсер не заметил подмены. Смоук-тест при подключении проверял три вещи: ответ приходит, позиции есть, страницы листаются. Вопрос, из какого поисковика эти позиции, тест не задавал, и я тоже.
Заметил я это случайно, когда руками открыл выдачу Яндекса по одному из ключей и сравнил первую десятку с тем, что лежало в базе. Почти ничего не совпало.
Почему одной замены адреса недостаточно
Если просто поменять строку в адресе, скрипт молча начнёт терять первую десятку. У гугловского адреса страницы нумеруются с единицы, у яндексовского с нуля: page=0 отдаёт позиции 1-10, page=1 уже 11-20. Скрипт, который начинает с page=1, получает валидный ответ с позициями 11-20 и считает их первыми.
Ещё три отличия всплыли в первый же день:
параметр groupby=100 яндексовский адрес не понимает и всё равно отдаёт по 10 результатов на страницу, так что для глубины 30 нужно три запроса, а не один;
в ответе есть поле contenttype, и рекламу с колдунщиками надо отфильтровывать, иначе они займут места органики;
отвечает он заметно дольше, и таймаут в 20 секунд, которого хватало раньше, обрывал замер на первой десятке. Сейчас стоит 90.
for pagenum in range(0, pagesfordepth(maxresults)):  # с нуля, не с единицы

params = {"user": user, "key": key, "query": query, "lr": 225, "page": page_num}

root, error = await fetch_page(client, params)

...

for g in root.findall(".//group"):

doc = g.find("doc")

if (doc.findtext("contenttype") or "organic").strip().lower() != "organic":

continue

...
Старые снимки я не удалил, а перенёс в таблицы с суффиксом _google. Так новые замеры не склеятся со старыми в одну «динамику», а старые остались для сравнения:
CUTOFF = "2026-10-13 14:19:21"

for table, ts in TABLES.items():

archive = f"{table}_google"

conn.execute(f"CREATE TABLE IF NOT EXISTS {archive} AS SELECT * FROM {table} WHERE 0")

conn.execute(f"INSERT INTO {archive} SELECT * FROM {table} WHERE {ts} <= ? "

f"AND id NOT IN (SELECT id FROM {archive})", (CUTOFF,))

conn.execute(f"DELETE FROM {table} WHERE {ts} <= ? "

f"AND id IN (SELECT id FROM {archive})", (CUTOFF,))
Насколько разные две выдачи
У меня есть снимки топ-20 по 128 ключам, которые попали в обе базы. Ключи из одной тематики: открытие малого бизнеса, франшизы, производство одежды. Регион для Яндекса вся Россия.
Совпадение я считал по коэффициенту Жаккара: размер пересечения двух множеств, делённый на размер объединения.
def jaccard(a, b):

return len(a & b) / len(a | b) if a | b else 0.0

for k in common:

y, g = top(YANDEX, k), top(GOOGLE, k)

domj.append(jaccard({d for , d in y}, {d for _, d in g}))

urlj.append(jaccard({u for , u,  in y}, {u for , u, _ in g}))
Результат:
| Что сравниваю | Значение |
| Доля общих доменов в топ-20, средняя | 0,28 |
| Доля общих URL в топ-20, средняя | 0,14 |
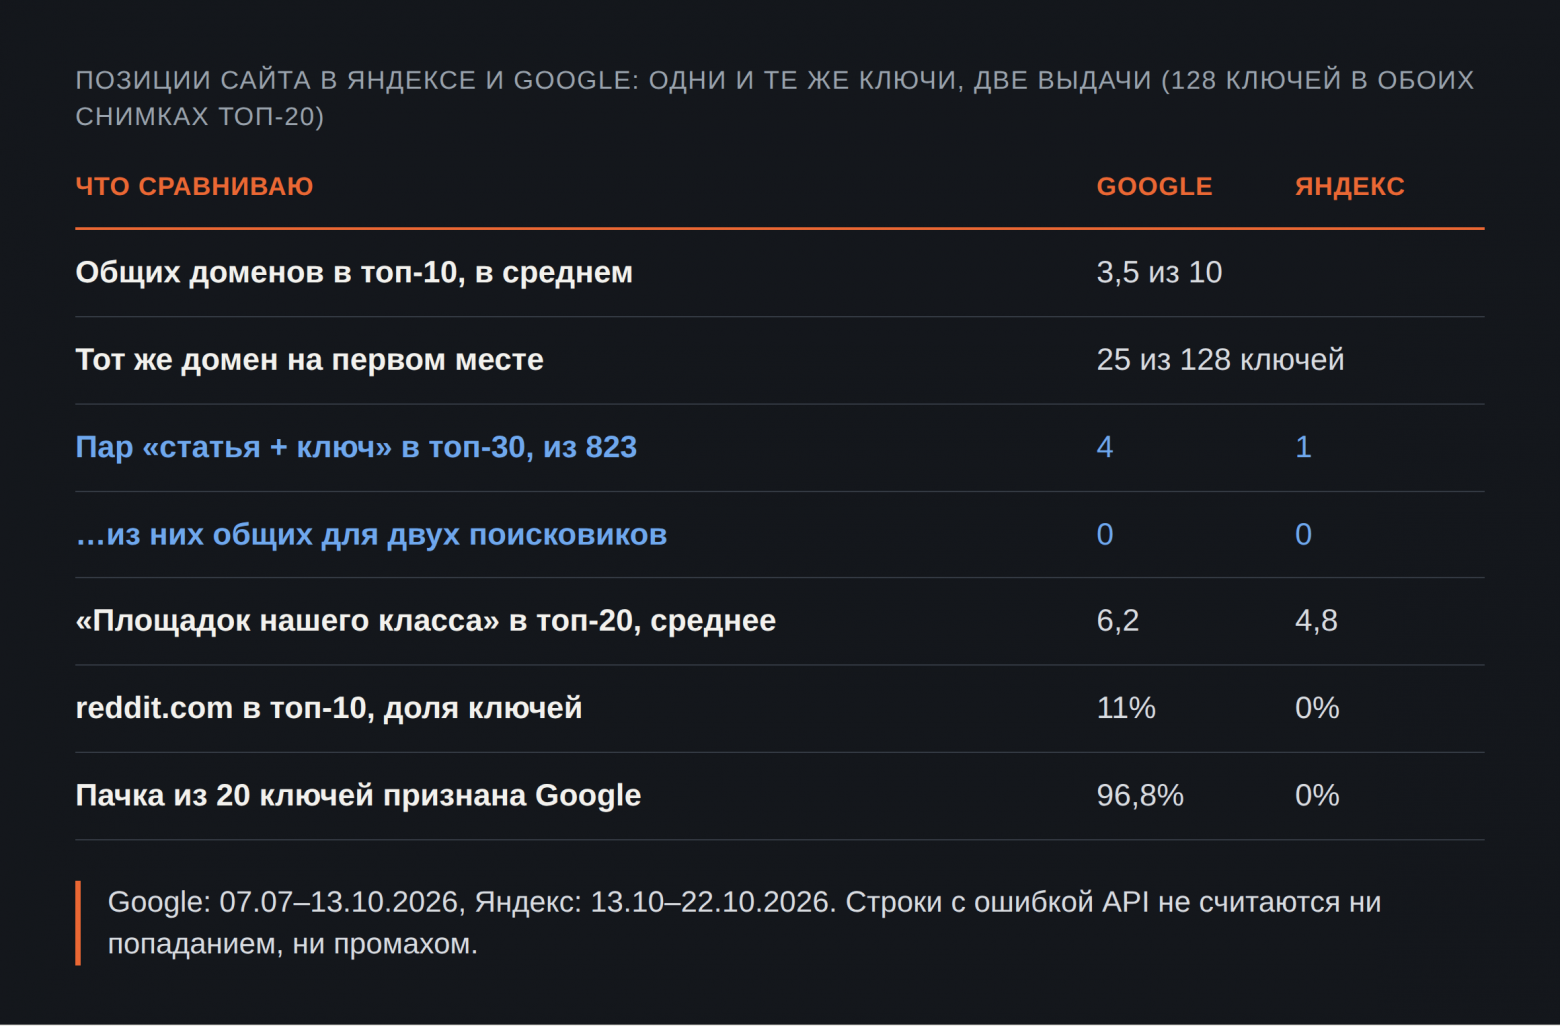
| Общих доменов в топ-10, в среднем | 3,5 из 10 |
| Один и тот же домен на первом месте | 25 ключей из 128 |
То есть по одному и тому же запросу два поисковика показывают в первой десятке в среднем три-четыре общих сайта, а конкретные страницы совпадают ещё реже. Позиция конкретной статьи в одном поисковике почти ничего не говорит о её позиции в другом.
Как понять, какой поисковик тебе отвечает
Первая идея была искать в выдаче сервисы Яндекса. Она не работает: поддомены yandex.ru есть в топ-10 Google по 18% моих ключей, в Яндексе по 26%. Разница есть, но по одному ответу её не увидеть.
Лучше работают домены, которых в одной из выдач нет вовсе. Доля ключей, у которых домен попал в топ-10:
| Домен | Google, 389 ключей | Яндекс, 136 ключей |
| reddit.com | 11% | 0% |
| wikipedia.org | 4% | 0% |
| youtube.com | 15% | 7% |
| avito.ru | 1% | 12% |
| vc.ru | 4% | 7% |
Reddit и Википедия за неделю яндексовских замеров не появились в топ-10 ни разу, а в Google встречаются регулярно. По одному ключу это ничего не доказывает: маркер есть только у каждого седьмого-восьмого запроса. По пачке ключей уже доказывает:
GOOGLE_MARKERS = ("reddit.com", "wikipedia.org")

def lookslikegoogle(table, keywords):

marks = " OR ".join("domain = ? OR domain LIKE ?" for  in GOOGLEMARKERS)

args = [x for m in GOOGLE_MARKERS for x in (m, "%." + m)]

q = (f"SELECT 1 FROM {table} WHERE position <= 10 "

f"AND keyword IN ({','.join('?' * len(keywords))}) AND ({marks}) LIMIT 1")

return db.execute(q, (keywords, args)).fetchone() is not None
Я прогнал её на 1000 случайных пачек из каждой базы:
| Размер пачки | Google признан Google | Яндекс признан Google |
| 5 ключей | 53,4% | 0% |
| 10 ключей | 79,3% | 0% |
| 20 ключей | 96,8% | 0% |
Двадцати ключей хватает, чтобы почти наверняка увидеть, что тебе отвечает Google. Обратное не так надёжно: у пачки из пяти ключей Google почти в половине случаев остаётся без маркеров, так что их отсутствие ещё ничего не доказывает. Самая дешёвая проверка всё равно ручная: открыть выдачу в браузере по двум-трём запросам и сравнить первую тройку.
Отдельно о том, что я храню. В таблице снимков есть поле source, и в обеих базах в нём написано xmlriver. Это имя провайдера, а не поисковика. Если бы в каждой строке с первого дня писался поисковик, ошибка была бы видна в любом отчёте.
Что поменялось в выводах
Ради этого раздела всё и затевалось, потому что на гугловских цифрах были приняты решения.
«Единственная площадка с поисковым следом» оказалась одной статьёй. По сводке за три месяца одна площадка давала почти все попадания: 37 из 51 по всей базе. Когда я разложил их по статьям, оказалось, что все 37 приходятся на одну статью и один ключ, где она держалась в Google со второго по шестое место: попала в топ в 37 замерах из 45. В Яндексе по тому же ключу её нет в топ-30. Ещё у двух площадок было 9 и 4 попадания, и тоже по одной-две статьи на каждую.
Пары «статья + ключ», замеренные в обоих поисковиках. Таких 823, по 211 статьям на 26 площадках. В топ-30 Google попали 4 пары, в топ-30 Яндекса одна. И эта одна на втором месте в Яндексе по ключу, где Google не нашёл её ни в одном из 14 замеров, так что общих попаданий у двух поисковиков нет ни одного.
Оценка «площадок нашего класса в топ-20». По каждому ключу я считаю, сколько в первых двадцати результатах сайтов, куда можно опубликоваться внешнему автору: медиа с авторскими колонками, блог-платформы, форумы. Если ноль, выдачу держат магазины и справочники, и под такой ключ писать ради поиска бессмысленно. Сравнение по 127 ключам:
| Показатель | Google | Яндекс |
| Среднее «наших в топ-20» | 6,2 | 4,8 |
| Медиана | 7 | 5 |
| Ключей с нулём | 9 | 10 |
В Яндексе оценка ниже у 79 ключей, выше у 29, у 19 не изменилась. Решение «ноль, на поиск не рассчитываем» поменялось у 11 ключей: у пяти был ноль и стал не ноль, у шести наоборот. Крайние случаи: «как открыть свое производство с нуля» упало с 11 до 1, «оборудование для бренда одежды» выросло с 0 до 5.
Где этот метод соврал
Яндекс у меня замерен один раз, Google десятки раз. У гугловской пары в среднем 34 замера за три месяца, у яндексовской 1,1. 46% строк в яндексовской таблице это ошибки API, из них 898 значат «на счету закончились деньги». Одиночный замер ловит случайное колебание выдачи, и отсутствие статьи в топ-30 Яндекса по одному снимку слабее, чем её присутствие в топ-6 Google в 37 снимках из 45.
Снимки сделаны в разное время. Топ-20 Google снят с конца августа по конец сентября, Яндекса в октябре. Выдача меняется и сама по себе, а контрольного замера «Google против самого себя через месяц» у меня нет. Какая часть из 0,28 объясняется поисковиком, а какая месяцем разницы, я не знаю. Подозреваю, что большая часть всё-таки поисковиком, но доказать не могу.
NULL в поле позиции значит две разные вещи. В гугловской таблице 25% строк, 10 794 штуки, это ошибки API: деньги, обновление сервиса, занятые каналы. Позиция у них пустая, как у честного «не нашли». Если считать отчёт по полю position и забыть про error, площадки получают тысячи несуществующих промахов. Все цифры выше посчитаны только по строкам без ошибки.
Оценка «нашего класса» зависит от моего списка доменов. Какой сайт пускает внешних авторов, решал я сам. Другой список даст другие числа, хотя направление сдвига между поисковиками вряд ли поменяется.
Границы, за которые выводы не выходят
Ключи из одной узкой тематики. На запросах про электронику или медицину доли совпадения и маркеры могут быть совсем другими.
Регион один, вся Россия. В Москве и Новосибирске выдача Яндекса отличается.
Маркеры reddit и Википедии работают для русскоязычной коммерческой выдачи. Для информационных запросов Википедия в Яндексе бывает в топе, так что функцию надо перепроверять на своих ключах.
Что я теперь проверяю при подключении любого API выдачи
Один и тот же запрос через API и руками в браузере, первая тройка должна совпасть.
С какого номера начинаются страницы: ответ на первую страницу должен содержать позицию 1.
Пачка из двадцати ключей через функцию с маркерами.
В каждой строке снимка хранится поисковик, а не только провайдер.
Ошибка API хранится отдельно от «не нашли» и не попадает в отчёт как промах.
Источник данных и дата снятия
Снимки органической выдачи через платный API: Google с 7 июля по 13 октября 2026 года (42 477 строк позиций, топ-20 по 389 ключам), Яндекс с 13 по 22 октября 2026 года (2072 строки позиций, топ-20 по 136 ключам). Регион 225, вся Россия. Скрипт сравнения и полный вывод прогона от 27 октября 2026 года я сохранил, цифры в тексте взяты из него без округлений сверх показанных.
Главный вывод для себя я сделал простой: три месяца я принимал решения о площадках по данным не того поисковика, и проверить это можно было одним ручным запросом в первый же день.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.