Как мы учили нейросеть распознавать дипфейки и объяснять свой вердикт
Сегодня генеративный ИИ меняет жизнь даже тех людей, кто не знает, что такое «генеративный ИИ». И не всегда эти изменения во благо. Например, мошенники уже научились применять генеративные аудиомодели, чтобы обманывать доверчивых граждан, имитируя голоса их близких и уговаривая расстаться с крупными суммами денег. А это значит, что создание методов надежного обнаружения речевых дипфейков (Speech Deepfake Detection, SDD) — это уже больше, чем просто академическая задача.
К сожалению, существующие SDD зачастую недостаточно универсальны: они плохо адаптируются к новым аудиодоменам и типам генераторов. Но, что самое неприятное, им недостает интерпретируемости — то есть способности объяснить, почему аудио является подлинным или поддельным, предоставляя при этом понятные человеку признаки.
Озаботившись этим вопросом, мы коллегами из AIRI, МФТИ, МТУСИ и ВШЭ придумали новый подход к обнаружению речевых дипфейков, который объединяет возможности больших аудиоязыковых моделей с пошаговым рассуждением, полученным на основе набора данных с человеческой разметкой. Метод получил название HIR‑SDD и съездил постером в Австралию на Interspeech в конце сентября (статью можно посмотреть здесь).
Ниже расскажу, как устроен наш подход, что дали эксперименты и почему, если фраза «я не слышу признаков синтеза» еще не означает, что на записи точно живой человек.
Что мы имеем в виду, когда говорим про объяснения нейросети, почему она считает голос настоящим или поддельным, через признаки, которые человек способен услышать сам? Это такие, понятные людям признаки, как, скажем, отметить телевизор на фоне или неестественную, отрывистую речь. Вот два реальных примера из нашей статьи в переводе на русский.
Пример 1. Настоящая речь
Человеческая разметка: «Настоящая запись для голосового помощника. Слышен окружающий шум: телевизор на фоне».
Ответ модели: «Речь звучит подлинно: естественная интонация, индивидуальные особенности произношения звуков, ровный темп речи и фоновый шум, похожий на звук телевизора».
В этом примере модель правильно определила настоящую речь и упомянула тот же фоновый звук, что и человек.
Пример 2. Дипфейк
Человеческая разметка: «Монотонная речь. Из контекста не совсем понятно, какая интонация предполагалась».
Ответ модели: «Голос звучит роботизированно, речь неестественная и отрывистая».
Модель правильно определила подделку. Здесь у человека и модели частично совпали выбранные категории признаков: необычная интонация и нетипичное звучание голоса. Оба примера дают объяснения, которые можно сопоставить с записью: повторно послушать фон, интонацию и характер звучания речи.
Именно такие человековоспринимаемые объяснения мы и хотели научиться получать. Для обучения использовали человеческую разметку: комментарии к записям и отмеченные слушателями признаки. Модель училась выдавать похожие по содержанию объяснения своего вердикта, описывая, что в аудио звучит естественно, а что вызывает подозрение.
Для этого мы собрали человеческие комментарии к 41 тысяче аудиозаписей и дообучили модель, которая воспринимает звук. Когда добавили объяснения, качество распознавания снизилось, но следующий этап обучения помог его поднять. А вот вопрос о качестве самих объяснений оказался сложнее.
Зачем детектору вообще что‑то объяснять
Обычный детектор получает запись и оценивает числом (обычно от нуля до единицы), настоящая это речь или синтезированная. Для автоматической проверки такой ответ удобен. Но если система ошиблась, по одному числу трудно понять, что произошло. Представим, что настоящую запись отклонили из‑за непривычного тембра, шума или манеры говорить. Разработчику полезно знать, на какие свойства звука указала модель. Иначе остается только перебирать примеры и искать общую закономерность.
С новыми генераторами возникает другая проблема. Признаки, по которым детектор узнавал старый синтезатор, могут исчезнуть. Хороший результат на знакомых данных тогда плохо переносится на новые записи. Поэтому в нашей работе есть две отдельные задачи: научить систему выдавать объяснение, которое человек сможет сопоставить со звуком, и проверить, приводит ли такой способ обучения к улучшению качества детекции дипфейков.
Для объяснений мы использовали аудиоязыковую модель (Large Audio Language Model, LALM/ALLM): большую языковую модель, которая принимает не только текст, но и звук. Она может сопоставлять аудио с инструкцией и отвечать обычными предложениями. Но умение работать со звуком еще не означает, что модель хорошо распознает дипфейки. Исходные аудиоязыковые модели / LALM показывают очень слабые результаты без специального дообучения: как при прямом запросе, так и при добавлении нескольких примеров в инструкцию. Поэтому нам предстояло научить модель и самому распознаванию, и объяснению ответа через слышимые признаки.
Сначала пришлось спросить людей
Нам были нужны примеры вида «запись, решение, объяснение». Обычной метки «настоящая речь» или «дипфейк» недостаточно, если мы хотим учить модель описывать паузы, произношение и интонацию.
Мы собрали русские и английские записи из нескольких открытых источников и дополнили их синтезированной речью. Участники разметки слушали запись, выбирали класс и объясняли решение своими словами. Для предполагаемой подделки они также отмечали подходящие причины из списка. В нем было 14 вариантов: необычная интонация, неестественные паузы, ошибки в ударениях, слишком быстрая речь, необычное звучание голоса и другие признаки.
Нас интересовали и объяснения настоящей речи. Например, человек мог отметить естественные изменения темпа, дыхание или интонацию, связанную со смыслом фразы. При этом ответ «звучит нормально» не подходил: требовалось описать, что именно создает такое впечатление.
Аннотацией мы называем ответ участника разметки на одну запись: выбранный класс и сопровождающие его поля. Текстовый комментарий составляет часть этого ответа. После отбора осталось следующее:
Что считали | Сколько получилось |
Аудиозаписи | 41 414 |
Из них синтезированные | 32 045 |
Из них с настоящей речью | 9 369 |
Аннотации к записям | 124 410 |
Непустые текстовые комментарии | 120 258 |
Участники разметки | 37 |
Аннотаций больше, чем записей, потому что одну запись описывали несколько человек. Это полезно: один слушатель замечает паузу, другой обращает внимание на ударение, третий описывает голос в целом. По распределению ответов чаще всего участники выбирали необычное звучание голоса. Часто встречались также необычная интонация и однообразная манера речи.
Но частота упоминания признака еще не говорит о его надежности: люди могут сходиться во впечатлении и при этом ошибаться. Поэтому мы фильтровали разметку. Исключали участников с долей правильных решений ниже 75%, вручную просматривали на адекватность и вариативнсоть от 30 до 50 аннотаций каждого участника и дополнительно убирали «плохих» разметчиков, а также удаляли примеры с неверно предсказанным классом.
В среднем исходный человеческий комментарий содержал 12 слов. Для человека фразы «монотонно, паузы странные» может хватить. Для обучения модели нам нужен был более единообразный формат. Поэтому мы перевели комментарии на английский и обработали их языковой моделью Qwen-32B. Модель преобразовывала исходную разметку в связные текстовые объяснения. На случайной выборке из 100 записей проверили, сохраняется ли соответствие человеческим комментариям.
Таким образом, обучающие объяснения основаны на человеческих наблюдениях, но их окончательная формулировка прошла через языковую модель. Отдельно мы сохранили категории причин. Их можно сравнивать между человеком и моделью независимо от того, какими словами написано объяснение.
Как устроена наша модель HIR‑SDD
В экспериментах мы использовали SALMONN-7B. Это открытая модель для работы с речью, звуками, языком и музыкой. Вот тут описание исходной модели. Упрощенно она работает так: два звуковых модуля превращают запись в числовые представления, связующий модуль подготавливает их для языковой модели, а та получает эти представления вместе с текстовой инструкцией и генерирует ответ.
Для нашей задачи мы сравнили два режима дообучения с учителем. В первом модель училась выдавать только вердикт. Во втором она должна была сформировать три части ответа: текстовое объяснение, список категорий причин и итоговый класс.
Структуру можно представить ниже:
Объяснение: какие свойства записи модель считает существенными.
Причины: соответствующие категории из списка разметки.
Вердикт: настоящая речь или дипфейк.
Такое разделение позволяет проверять ответ на нескольких уровнях. Модель может правильно выбрать класс, но назвать другие причины. Или описать признаки настоящей речи и при этом объявить запись поддельной.
Для дообучения применяли LoRA, Low‑Rank Adaptation, низкоранговую адаптацию. Этот метод позволяет обучать относительно небольшие добавленные матрицы вместо изменения всех параметров языковой модели. Аудиозаписи обрезали или дополняли до десяти секунд.
Как связать объяснение со звуком
Языковая модель умеет писать правдоподобно. На запрос о дипфейке она может выдать знакомый набор слов про роботизированный голос, неестественные паузы, монотонную интонацию и тому подобное. Сам факт появления этих слов еще ничего не говорит о конкретной записи. Чтобы усилить привязку объяснения к звуку, мы использовали контролируемые изменения аудио: добавляли шум, маскировали участки записи и меняли громкость. Так в сигнале появлялись заранее известные изменения, на которые можно опираться при обучении.
Следующим шагом стало обучение с подкреплением методом GRPO, Group Relative Policy Optimization. Для одной записи мы получали шесть вариантов ответа и сравнивали их по награде. Награда состояла из трех частей:
За что давали награду | Вес в общей оценке |
Правильный итоговый класс | 0,7 |
Соблюдение структуры ответа | 0,2 |
Качество объяснения по оценке другой модели | 0,1 |
Качество объяснения оценивала Qwen2.5–32B. Она проверяла полноту, соответствие задаче, согласованность с итоговым ответом и полезность текста. Наибольший вес получал правильный класс: красиво написанное объяснение не должно было перекрывать ошибку в основном решении. При этом оценка другой языковой модели остается приближенным способом проверки.
Что получилось с распознаванием
Основную проверку проводили на 20 000 записей из оценочной части ASVspoof 5: 15 943 подделках и 4 057 записях настоящей речи. В обучающей и проверочных частях этого набора используются разные генераторы. Такой тест позволяет проверить перенос на незнакомые способы синтеза, хотя не охватывает все возможные условия записи.
Из‑за неравного числа классов одной доли правильных ответов недостаточно. Если всегда говорить «дипфейк», получится почти 80% правильных ответов, хотя модель вообще не умеет узнавать настоящую речь. Поэтому мы смотрим и на сбалансированную точность. Для нее отдельно считают долю верных ответов на настоящих записях и на подделках, затем берут среднее этих двух чисел. У модели, которая всегда отвечает «дипфейк», этот показатель будет равен 50%.
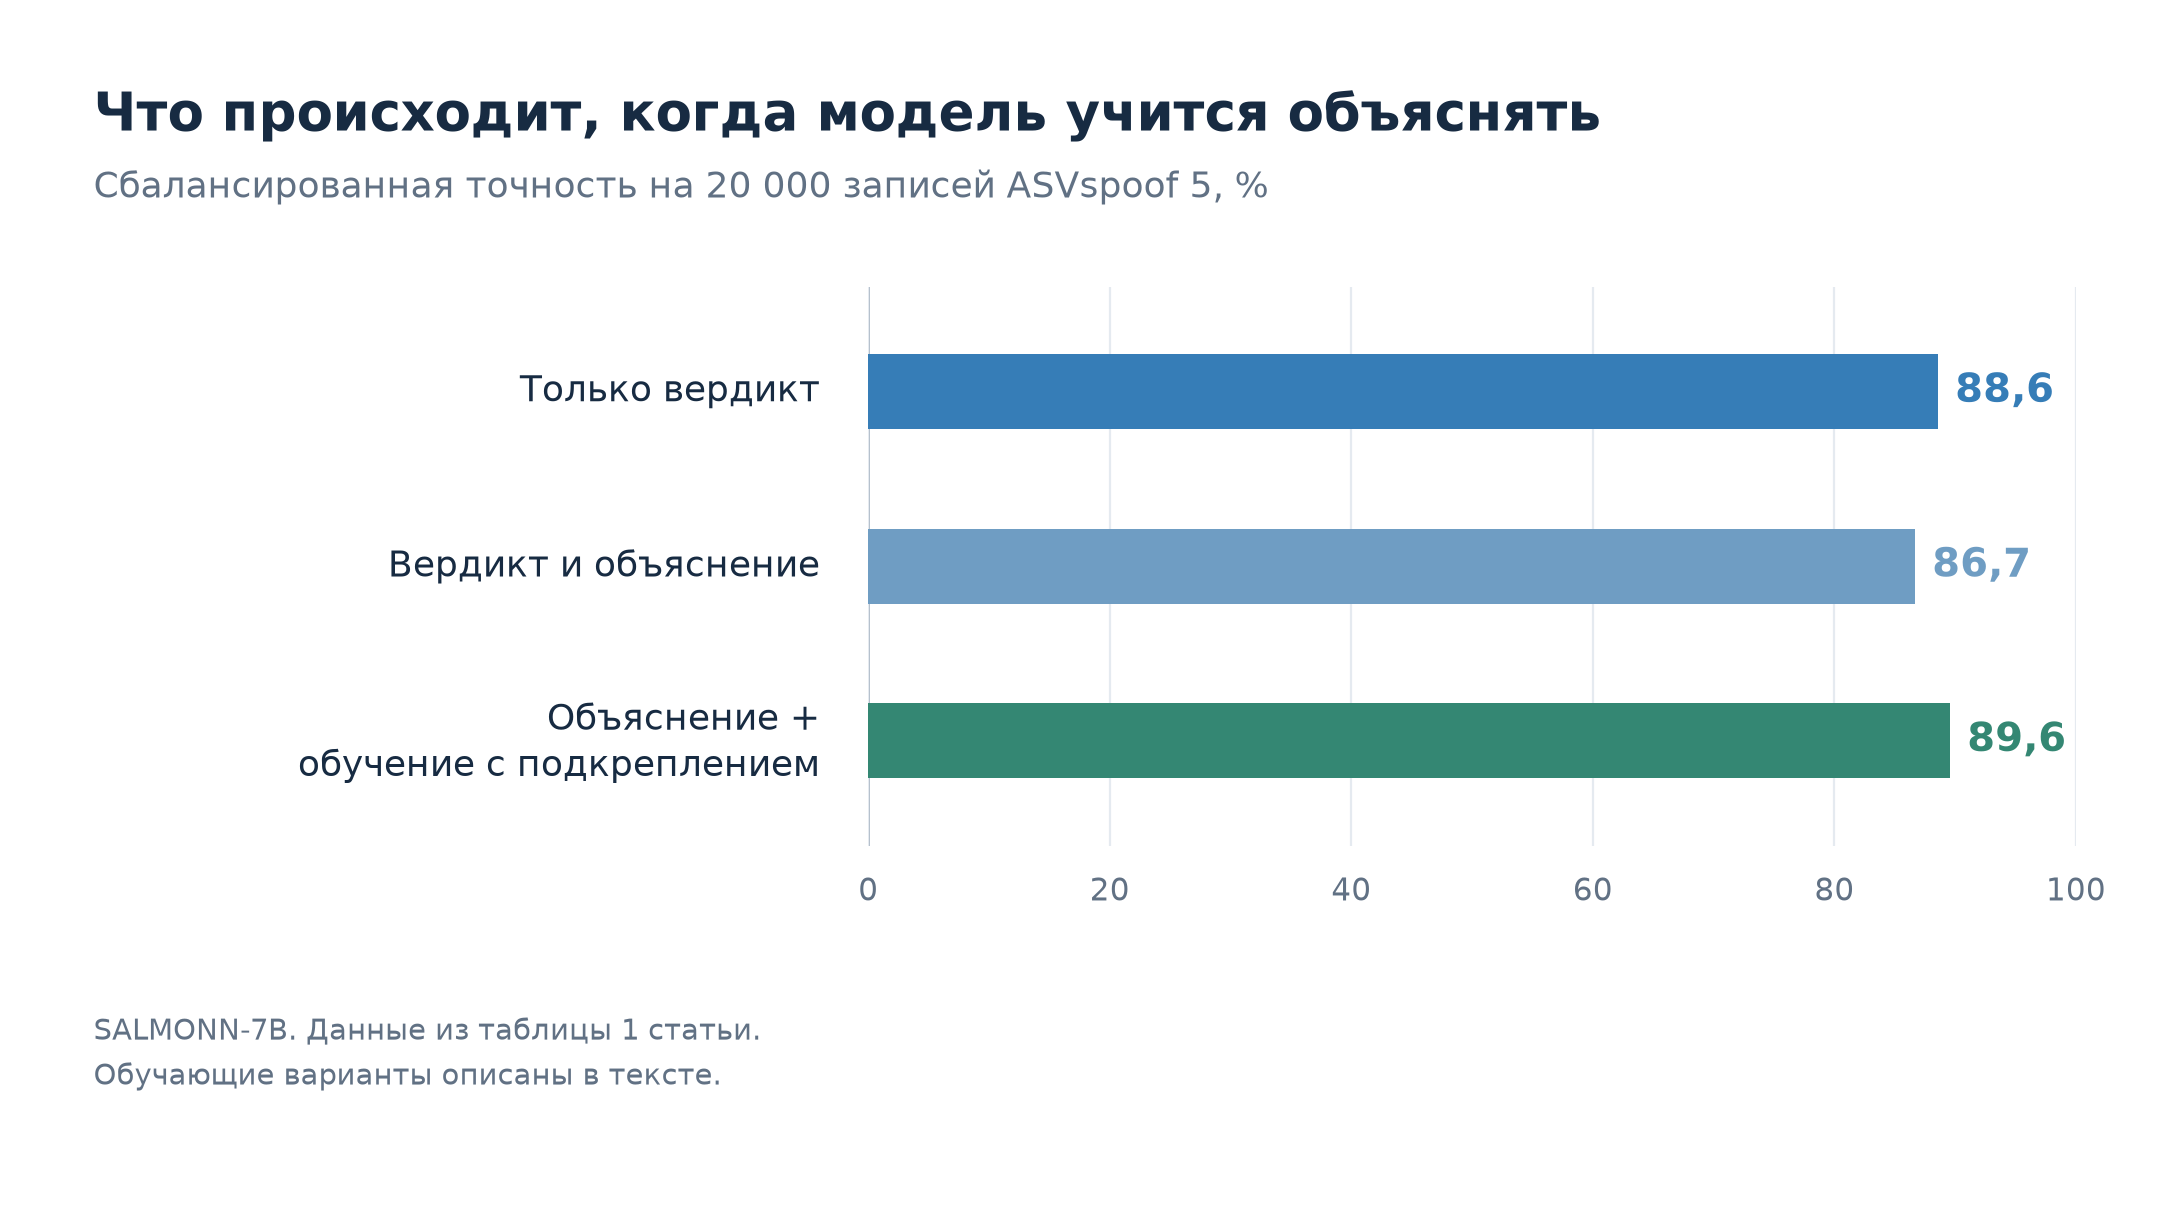
Вот три варианта обучения одной и той же модели. В первых двух использовался наш набор с человеческой разметкой: без объяснений и с ними. В третьем добавлялся GRPO этап обучения на дополнительном наборе.
Вариант SALMONN-7B | Доля правильных ответов | Сбалансированная точность |
Только вердикт | 94,5% | 88,6% |
Вердикт и объяснение | 92,9% | 86,7% |
Объяснение и последующее обучение с подкреплением | 93,6% | 89,6% |
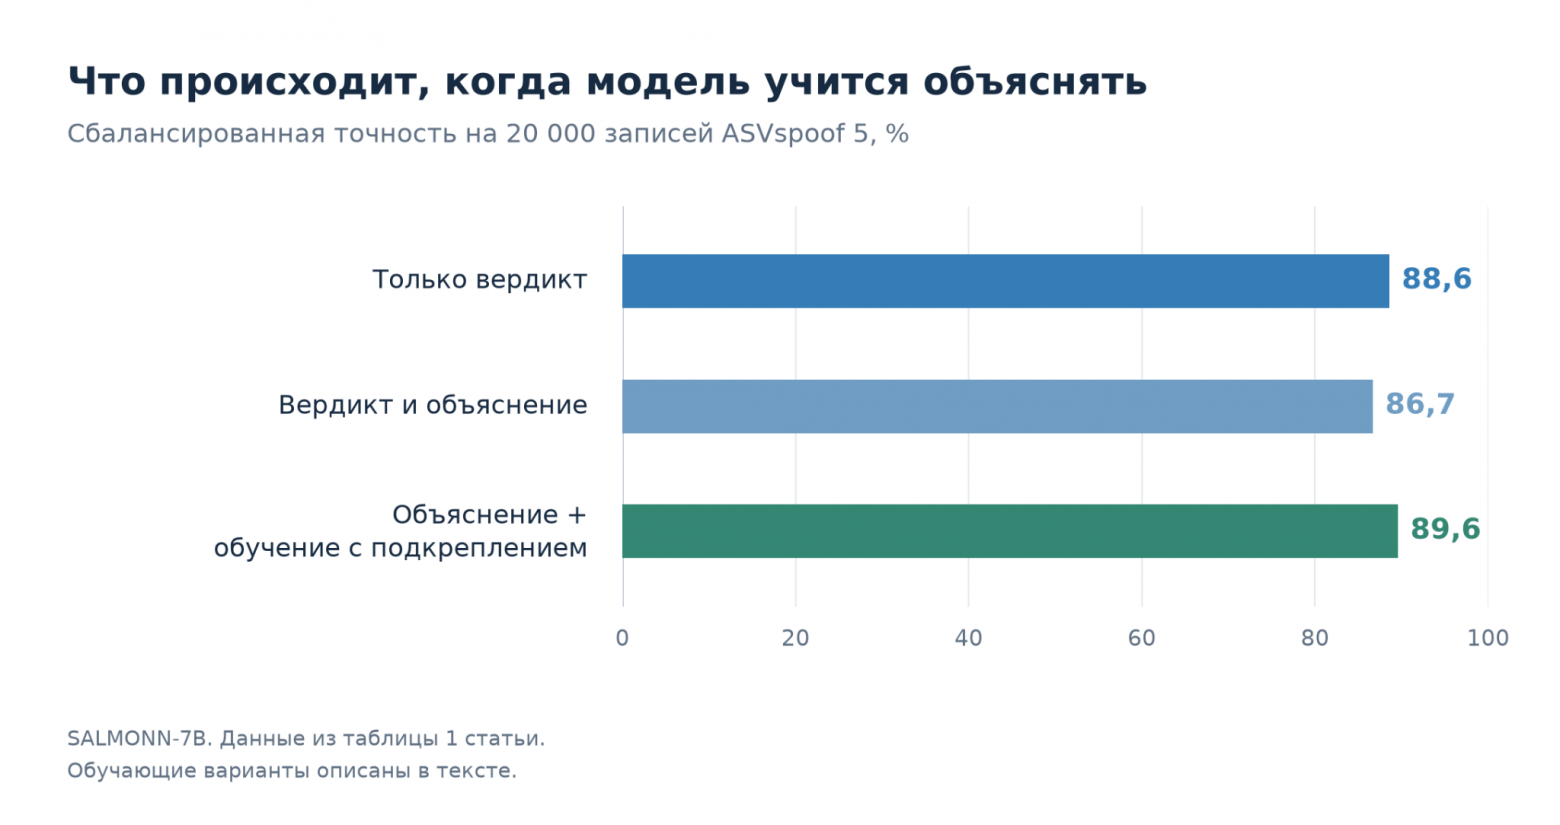
Добавление объяснений при дообучении с учителем снизило оба показателя. Последующее обучение с подкреплением повысило сбалансированную точность с 86,7 до 89,6%, то есть на 2,9 процентного пункта. Это лучший результат по этой метрике среди вариантов, представленных в основной таблице статьи.
Но по обычной доле правильных ответов впереди осталась модель, которая выдает только вердикт: 94,5 против 93,6%. Поэтому было бы неправдой сказать, что добавив объяснения, мы улучшили всё. Мы получили модель с текстовыми объяснениями и конкурентным качеством распознавания, но выигрыш зависит от того, какой показатель сравнивать.
Также мы сравнились с хорошей обычной (conventional) моделью Wav2Vec2-AASIST на основе self‑supervised‑learning аудио энкодера Wav2Vec2 и графовой нейросети AASIST, созданной специально для детекции аудио дипфейков. Лучшая сбалансированная точность базовой модели — 84.0%, так что хоть какой‑то явный положительный эффект от использования LALM есть. Базовая модель заметно меньше, чем наша LALM (300+ млн против 7+ млрд параметров), поэтому заметно более выгодна для инференса.
Даже после нашего дообучения результаты пока далеки от идеала. Особенно трудно распознавать качественные дипфейки от незнакомых генераторов: модель по‑прежнему может принимать их за настоящую речь. Поэтому повышение качества распознавания, прежде всего на новых способах синтеза и в новых условиях записи, остается одной из главных задач дальнейшей работы.
Что изменилось в объяснениях
По отдельным примерам объяснения выглядели содержательнее, хотя убедительно подтвердить улучшение измерениями не удалось.
Сначала мы сравнили категории причин, которые выбирают модель и люди. Для этого использовали индекс Жаккара: число общих категорий делится на число всех разных категорий в двух ответах. Если списки полностью совпадают, результат равен единице. Если общих категорий нет, нулю. Например, человек отметил темп и интонацию, модель отметила темп и паузы. Общая категория одна, разных категорий три. Индекс Жаккара равен одной трети.
До дополнительного обучения индекс составлял 0,6264, после него — 0,6468. В статье мы оцениваем это изменение как фактически несущественное с учетом шума в разметке. Сами люди тоже расходятся: среднее попарное совпадение их наборов причин на тестовой части составляет 0,78.
Связные объяснения отдельно оценивала модель GPT-5.1. Мы провели пять прогонов оценки на 1 000 примеров. Средний балл вырос с 5,12 до 5,74 из 10, но мы также считаем, что он незначителен. По отдельным ответам мы наблюдали более разнообразные и содержательные описания после привязки к звуку и обучения с подкреплением, однако автоматические оценки не дают основания утверждать, что качество объяснений надежно улучшилось.
Саму привязку объяснений к звуку тоже нужно улучшать. Если модель пишет о паузе, шуме или необычной интонации, эти признаки должны действительно присутствовать в записи. Нам еще предстоит научиться надежнее отличать такое описание от правдоподобной фразы, которая подходит ко множеству записей. Это отдельная задача наряду с улучшением распознавания дипфейков. В идеале, требуются проверка людьми/человеческая аннотация результатов предсказаний.
Где объяснение помогает и где вводит в заблуждение
В примере из начала статьи и человек, и модель упоминают телевизор на фоне. Текстовое объяснение воспроизводит конкретное человеческое наблюдение, поэтому проверяющему понятно, на что обратить внимание при повторном прослушивании. В другом примере модель указывает на необычное произношение слова Europe. Это тоже проверяемое утверждение: можно открыть запись и послушать именно это слово. Такие объяснения полезны для разбора ошибок, так как они дают проверяющему конкретную зацепку. При этом наличие телевизора на фоне не доказывает, что голос настоящий, а непривычное произношение не доказывает синтез.
Одна из главных трудностей в наших экспериментах связана с качественной речью от современных генераторов, которых модель не видела при обучении. Она может описать такую подделку как настоящую: отметить естественный голос, правдоподобный темп и хорошую интонацию. Объяснение выглядит разумно, но итоговый класс неверен. Из этого следует ограничение всего подхода: отсутствие замеченных дефектов не подтверждает происхождение записи. В будущем нам надо научить нашу систему различать эти два вывода, а также предусмотреть отдельный надежный режим отказа от ответа. Более того, встречается ошибка другого рода: подлинное аудио модель распознает как сфальсифицированное, и это тоже стоит учитывать.
Что не сработало
Несколько результатов полезно вынести отдельно, особенно если вы собираетесь повторять похожее обучение.
Увеличение обучающей выборки не улучшило качество. Мы проверяли два обучающих набора отдельно и вместе. Их объединение не дало ожидаемой прибавки для LALM. Для базовой модели ситуация отличается. Само увеличение числа примеров не гарантирует, что модель лучше перенесет знания на новые данные.
Предварительное обучение только на вердиктах не помогло последующему обучению по объяснениям. Для нашей постановки последовательность «сначала классификатор, потом объяснения» не оказалась удачным приемом.
Привязка к звуку не дала заметного улучшения классификации сама по себе. В наблюдаемых ответах стало больше разнообразия, но из этого нельзя автоматически выводить рост надежности детектора.
Кроме того, использованная аудиоязыковая модель была чувствительна к переобучению. Выбор момента остановки и режима дообучения оказался существенной частью задачи. В общем, мы не сводим полученные результаты к универсальному рецепту для любой модели и любого набора звука.
Что можно использовать дальше
У этой работы есть два результата, которые можно развивать независимо. Первый: набор человеческих наблюдений о настоящей и синтезированной речи. Второй: способ обучить аудиоязыковую модель выдавать вердикт вместе с объяснением и списком причин. Мы опубликовали код обучения и проверки, обработанный набор объяснений и исходную человеческую разметку.
Дальнейшая работа может включать в себя более серьезную проверку качества распознавания и соответствия объяснения звуку. Для этого хотелось бы дополнить автоматические оценки проверкой людьми: нескольким независимым слушателям дать запись и объяснение модели, попросить проверить каждое утверждение и, где возможно, указать соответствующий фрагмент. Так можно оценить, действительно ли слышны названные признаки, даже если итоговый вердикт оказался правильным.
Наконец, нас интересует еще одна штука. Какой ответ был бы полезнее вам при проверке подозрительной записи: вероятность подделки, короткий список слышимых признаков или указание конкретных фрагментов для повторного прослушивания? Последний вариант мы в этой работе еще не проверяли.
Как видите, работы в данном направлении еще много, хотя сама задача борьбы с голосовыми дипфейками имеет важную общественную значимость. Поэтому мы приглашаем наших коллег активнее развивать методы SDD и всегда открыты к сотрудничеству!
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.