Cron запустил задачу дважды: как flock не даёт наложиться двум копиям скрипта
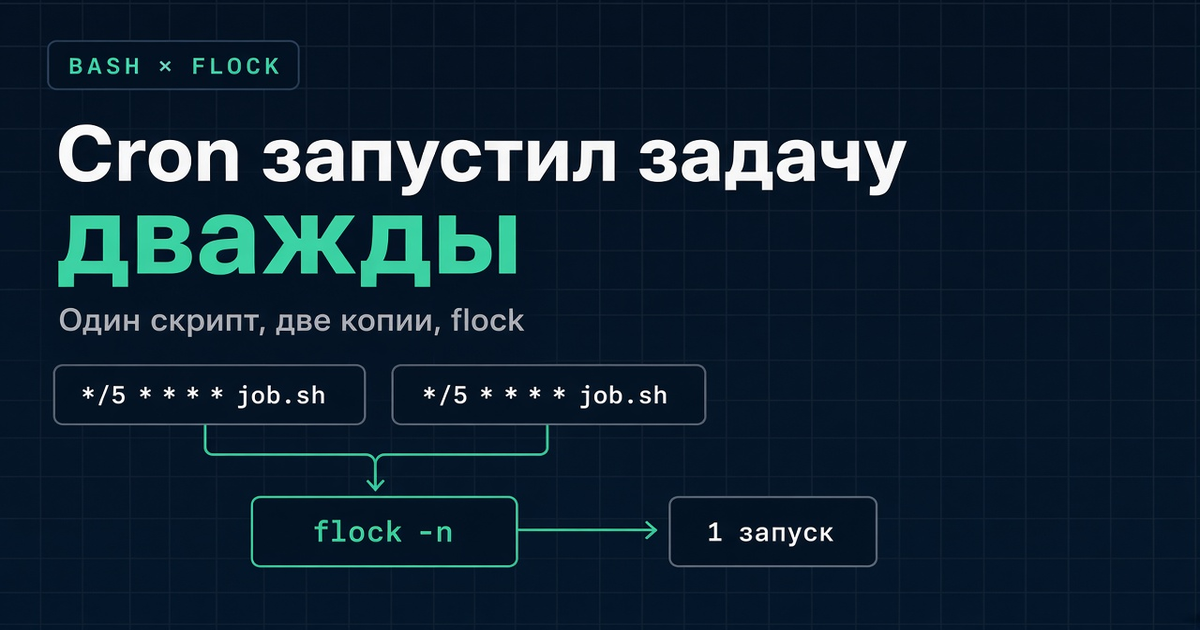
Задача в crontab стоит каждые пять минут. Обычно она укладывается в две. Ночью база отвечала дольше, запуск ещё не закончился — и cron спокойно стартовал следующий. В логе два START с разницей в доли секунды, два одинаковых отчёта, два конкурирующих UPDATE. Никакого «бага cron»: расписание сработало ровно так, как написано.
Ниже воспроизведём это на обычном Linux, закроем гонку через flock из util-linux, сравним режимы «пропустить» и «подождать», и покажем тот же приём из Python через fcntl.flock. Весь вывод — с локального стенда: Bash 5.2, util-linux 2.41.5, Python 3.13.
Что именно ломается
cron не знает и не обязан знать, жив ли предыдущий процесс. Для него каждая строка crontab — независимый запуск по времени. Если интервал короче длительности работы, или работа иногда растягивается, появятся параллельные копии.
Проверка «есть ли pid-файл?» не спасает сама по себе: между test -f и записью нового pid два процесса могут пройти проверку одновременно. Нужна атомарная блокировка на уровне ядра, а не договорённость «сначала посмотрим в файл».
Учебный скрипт
Один файл, три режима. Сохраните как job.sh и сделайте исполняемым. Логи и lock-файл лежат рядом со скриптом. Никаких внешних пакетов.
#!/usr/bin/env bash
set -euo pipefail
ROOT="$(cd "$(dirname "$0")" && pwd)"
LOG="$ROOT/job.log"
LOCK="$ROOT/job.lock"

stamp() { date '+%H:%M:%S.%3N'; }

run_body() {
  echo "[$(stamp)] START pid=$$" | tee -a "$LOG"
  echo "$$" >> "$ROOT/runs.txt"
  sleep 1.5
  echo "[$(stamp)] END   pid=$$" | tee -a "$LOG"
}

mode="${1:-plain}"
case "$mode" in
  plain)
    run_body
    ;;
  flock-n)
    exec 9>"$LOCK"
    if ! flock -n 9; then
      echo "[$(stamp)] SKIP pid=$$ (lock busy)" | tee -a "$LOG"
      exit 0
    fi
    run_body
    ;;
  flock-wait)
    exec 9>"$LOCK"
    flock 9
    run_body
    ;;
  *)
    echo "usage: $0 plain|flock-n|flock-wait" >&2
    exit 2
    ;;
esac
sleep 1.5 имитирует работу. В реальной задаче здесь бэкап, сверка, выгрузка — что угодно дольше интервала crontab.
Запускаем две копии почти одновременно:
./job.sh plain & ./job.sh plain & wait
cat job.log
На стенде получилось:
[19:16:48.486] START pid=374253
[19:16:48.486] START pid=374254
[19:16:49.989] END   pid=374254
[19:16:49.989] END   pid=374253
Оба старта в одну миллисекунду. В runs.txt две строки. Это и есть «cron запустил дважды», только без ожидания пяти минут.
Исправление: flock -n и выход
Режим flock-n открывает lock-файл на дескрипторе 9 и берёт эксклюзивную блокировку без ожидания (-n / --nonblock). Если файл уже занят — пишем SKIP и выходим с кодом 0, чтобы cron не считал это аварией задачи.
./job.sh flock-n & ./job.sh flock-n & wait
cat job.log
[19:16:49.999] START pid=374328
[19:16:49.999] SKIP pid=374327 (lock busy)
[19:16:51.501] END   pid=374328
В runs.txt одна строка. Второй процесс увидел занятый lock и не вошёл в тело задачи.
Важно: блокировка держится на открытом файловом дескрипторе, а не на «имени файла как строке». Пока процесс жив и дескриптор открыт, второй flock -n на тот же inode получит отказ. Когда процесс завершится, ядро снимет блокировку само — отдельный flock -u в конце скрипта для этого сценария не обязателен.
Когда лучше ждать, а не пропускать
Иногда пропуск вреден: отчёт должен выполниться, просто не параллельно. Тогда берём блокирующий flock без -n:
./job.sh flock-wait & ./job.sh flock-wait & wait
cat job.log
[19:16:51.511] START pid=374360
[19:16:53.015] END   pid=374360
[19:16:53.017] START pid=374361
[19:16:54.521] END   pid=374361
Два запуска, но строго подряд. Суммарное время около трёх секунд вместо полутора. Для cron это значит: если задача регулярно не укладывается в интервал, очередь будет расти. Пропуск (-n) в таких случаях честнее, чем бесконечное накопление отставания.
Одна строка в crontab
Тот же эффект без правки скрипта — через обёртку flock из util-linux:
*/5 * * * * flock -n /var/lock/my-job.lock -c '/opt/jobs/job.sh plain'
На стенде первый вызов взял lock и отработал, второй сразу вернул код 1:
second_exit=1
[19:16:54.532] START pid=374423
[19:16:56.035] END   pid=374423
Код 1 — штатный ответ flock -n, когда lock занят (это не падение вашего скрипта: до -c дело не дошло). Если мониторинг crontab реагирует на ненулевой код, либо пишите обёртку как в режиме flock-n выше (там мы сами решаем exit 0), либо задайте код конфликту через -E:
flock -n -E 0 /var/lock/my-job.lock -c '/opt/jobs/job.sh plain'
Тогда «занято» тоже завершится нулём. Выбирайте осознанно: нулевой код при пропуске удобен для cron, но прячет факт пропуска от алерта «задача не стартовала».
Путь к flock в crontab лучше указывать абсолютный, если PATH у cron урезан. Lock-файл кладите на локальную файловую систему того хоста, где крутится задача.
Тот же приём из Python
Если воркер уже на Python, блокировку можно взять через fcntl.flock — это тот же механизм advisory locks ядра Linux, что использует утилита flock.
import fcntl
import os
import time
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path

lock_path = Path('py.lock')
lock_path.write_bytes(b'')

def worker(i: int) -> str:
    fd = os.open(lock_path, os.O_RDWR)
    try:
        fcntl.flock(fd, fcntl.LOCK_EX | fcntl.LOCK_NB)
        time.sleep(0.4)
        fcntl.flock(fd, fcntl.LOCK_UN)
        return f'ok-{i}'
    except BlockingIOError:
        return f'skip-{i}'
    finally:
        os.close(fd)

with ThreadPoolExecutor(max_workers=8) as ex:
    outs = list(ex.map(worker, range(8)))

print(outs)
На стенде:
['skip-0', 'ok-1', 'skip-2', 'skip-3', 'skip-4', 'skip-5', 'skip-6', 'skip-7']
Один ok, семь skip. Кто именно успел первым — зависит от планировщика; гарантия только в том, что эксклюзивный non-blocking lock получает не больше одного участника.
Для долгой задачи обычно держат lock на всё время работы и отпускают в finally. Не смешивайте без нужды «короткий lock вокруг проверки» и «долгую работу снаружи»: снова получите окно между проверкой и действием.
Что flock не обещает
Это advisory lock. Процесс, который не вызывает flock/fcntl, спокойно прочитает и перезапишет те же данные. Защита работает только между участниками договора.
Сеть и NFS. Поведение блокировок на сетевых ФС зависит от сервера, клиента и версии. Для cron-задачи lock-файл должен жить на локальном диске той машины, где запускается процесс. Общий NFS-путь «на всякий случай» — плохая идея, пока вы отдельно не проверили семантику lock на своём стеке.
Несколько серверов. flock на локальном файле не синхронизирует два хоста. Если одна и та же crontab крутится на трёх нодах, нужен распределённый механизм (блокировка в БД, аренда в etcd/Consul, очередь с одним потребителем) — это уже другая задача.
Удаление lock-файла. Снять блокировку чужого процесса, удалив путь, нельзя: блокировка привязана к открытому дескриптору. Новый файл с тем же именем — другой inode; старый процесс продолжит держать свой lock, а новый может получить «свой» файл. На практике lock-файл создают один раз и не удаляют в горячем пути.
systemd timer. У unit-файла есть RefuseManualStart, но важнее Type= и запрет параллельного запуска через flock или через сам unit (systemctl не стартует второй instance того же oneshot, пока живёт предыдущий — при правильной схеме). Если остаётесь на cron, flock остаётся самым коротким щитом.
Как проверить у себя за минуту
Поставьте в crontab интервал короче
sleepвнутри задачи, либо запустите две копии вручную, как выше.Убедитесь, что без lock в логе два
START.Добавьте
flock -n(в скрипт или в строку crontab).Повторите: один
START, одинSKIPили ненулевой код обёртки.Решите заранее: пропуск или ожидание. Для отчётов «раз в N минут» обычно нужен пропуск; для цепочки «обязательно догнать» — ожидание плюс алерт на длительность.
Вопрос в зал
У вас cron-задачи защищены от наложений? Если да — чем именно: flock, pid-файл, уникальный индекс в БД, systemd, очередь? И был ли случай, когда защита была, а дубль всё равно прошёл — из-за NFS, второго хоста или «умного» удаления lock-файла?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.