Читаем DataMatrix с конвейера: открытое сравнение четырёх библиотек на 1368 синтетических кадрах
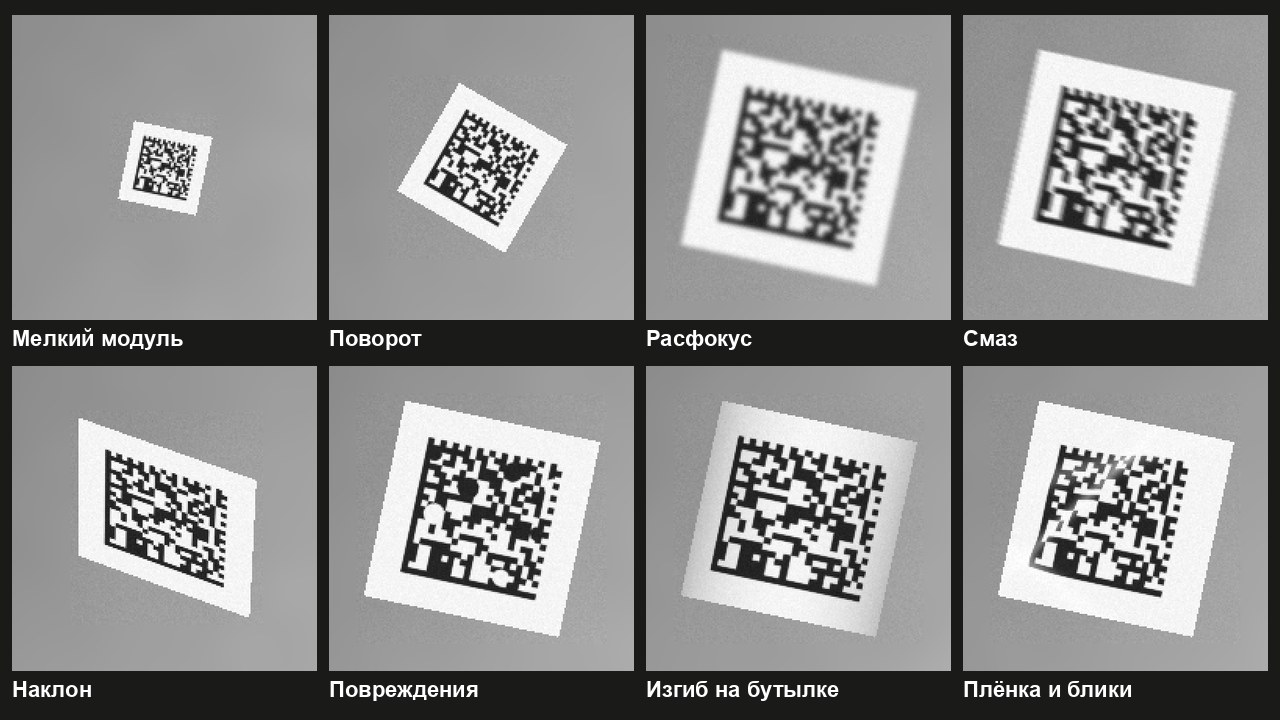
На производстве код «Честного знака» читает камера над лентой, и символ на кадре мелкий — 2–3 пикселя на модуль, повёрнутый, смазанный, на изогнутом боку бутылки. Мы сравнили, как с такими кадрами справляются ZXing, zxing-cpp, libdmtx и наша библиотека dmr. Кадры, ожидаемые строки и скрипты замера выложены — любую цифру можно проверить.
Коротко. На 1368 синтетических кадрах dmr прочитал 82 %, zxing-cpp — 70 %, libdmtx — 65 %, ZXing (Java) — 3 %, и ложных чтений нет ни у одной из четырёх библиотек. dmr надёжно читает от 1,4 пикселя на модуль, а при 2,5 пикселя на модуль — под любым углом поворота; zxing-cpp — от 2 пикселей, а при 2,5 пикселя — до 20° поворота. Зато zxing-cpp примерно в 2,5 раза быстрее: медиана 1,9 мс против 5,0 мс на прочитанный кадр на одном ядре. Есть и условия, где соперники читают больше dmr, — их мы разбираем ниже.
Зачем мы это мерили
С 2019 года в России маркируют всё больше товаров: лекарства, молочную продукцию, воду, обувь, шины. Код «Честного знака» — это GS1 DataMatrix, и на производстве его нужно прочитать с каждой упаковки, которая едет по ленте. Камера висит над конвейером, коробка проезжает за доли секунды, этикетка может быть повёрнута как угодно, чуть смазана, на изогнутом боку бутылки или под плёнкой. И главное — символ на кадре мелкий: часто 2–3 пикселя на модуль.
Мы делаем библиотеку чтения DataMatrix dmr (libscanner.com) именно для таких кадров. Когда пришло время её показывать, встал вопрос: как она выглядит рядом с тем, чем обычно читают DataMatrix в открытом мире? Под рукой у каждого разработчика три библиотеки. ZXing (Java) — классика, на ней построено множество мобильных сканеров. zxing-cpp — её порт на C++, быстрее и заметно доработанный. libdmtx — специализированная библиотека только для DataMatrix.
Коммерческие SDK в сравнение не вошли: лицензии большинства из них запрещают публиковать результаты замеров без согласия производителя.
Почему синтетика
Первое сравнение мы сделали на кадрах с двух реальных производственных линий. Но опубликовать такие кадры нельзя: на них действующие коды маркировки конкретных упаковок и названия препаратов. Без кадров сравнение не проверить — а непроверяемый бенчмарк от автора одной из библиотек стоит немного.
Синтетика снимает эту проблему. Истина известна: мы сами закодировали каждую строку и знаем, что должно прочитаться, поэтому ложное чтение определяется однозначно. Кадры можно выложить целиком — коды на них не настоящие. А условия управляемы: можно менять ровно одну вещь — расфокус, наклон, повреждение — и смотреть, где у каждой библиотеки предел.
Цена — синтетика не равна реальности. Мы старались сделать кадры похожими на конвейерные, но выводы о конкретной линии всё равно нужно проверять на её кадрах.
Как устроен набор
Каждый кадр — 720×540, серый, как у монохромной промышленной камеры. На кадре один код на белой этикетке, этикетка лежит на сером фоне с неравномерным освещением. В номинале на модуль приходится 4 пикселя, этикетка повёрнута на случайный угол от 0 до 360°, контраст печати 0,85, шум σ = 3 уровня яркости.
Дальше меняется одно условие за раз, остальные остаются номинальными. Условий 16: размер модуля, поворот, расфокус, смаз, шум, контраст печати, сжатие JPEG, наклон плоскости к камере, растискивание краски, повреждения, повреждения у символа без дополнения, изгиб этикетки на цилиндре, волна, мятая бумага, плёнка со складками и бликами, инверсия (светлые модули на тёмном).
На каждое значение условия — 12 кадров: символы 16×16, 22×22 и 40×40 по очереди, у каждого свои случайные данные на 60–85 % ёмкости, как у настоящих кодов. Всего 1368 кадров.
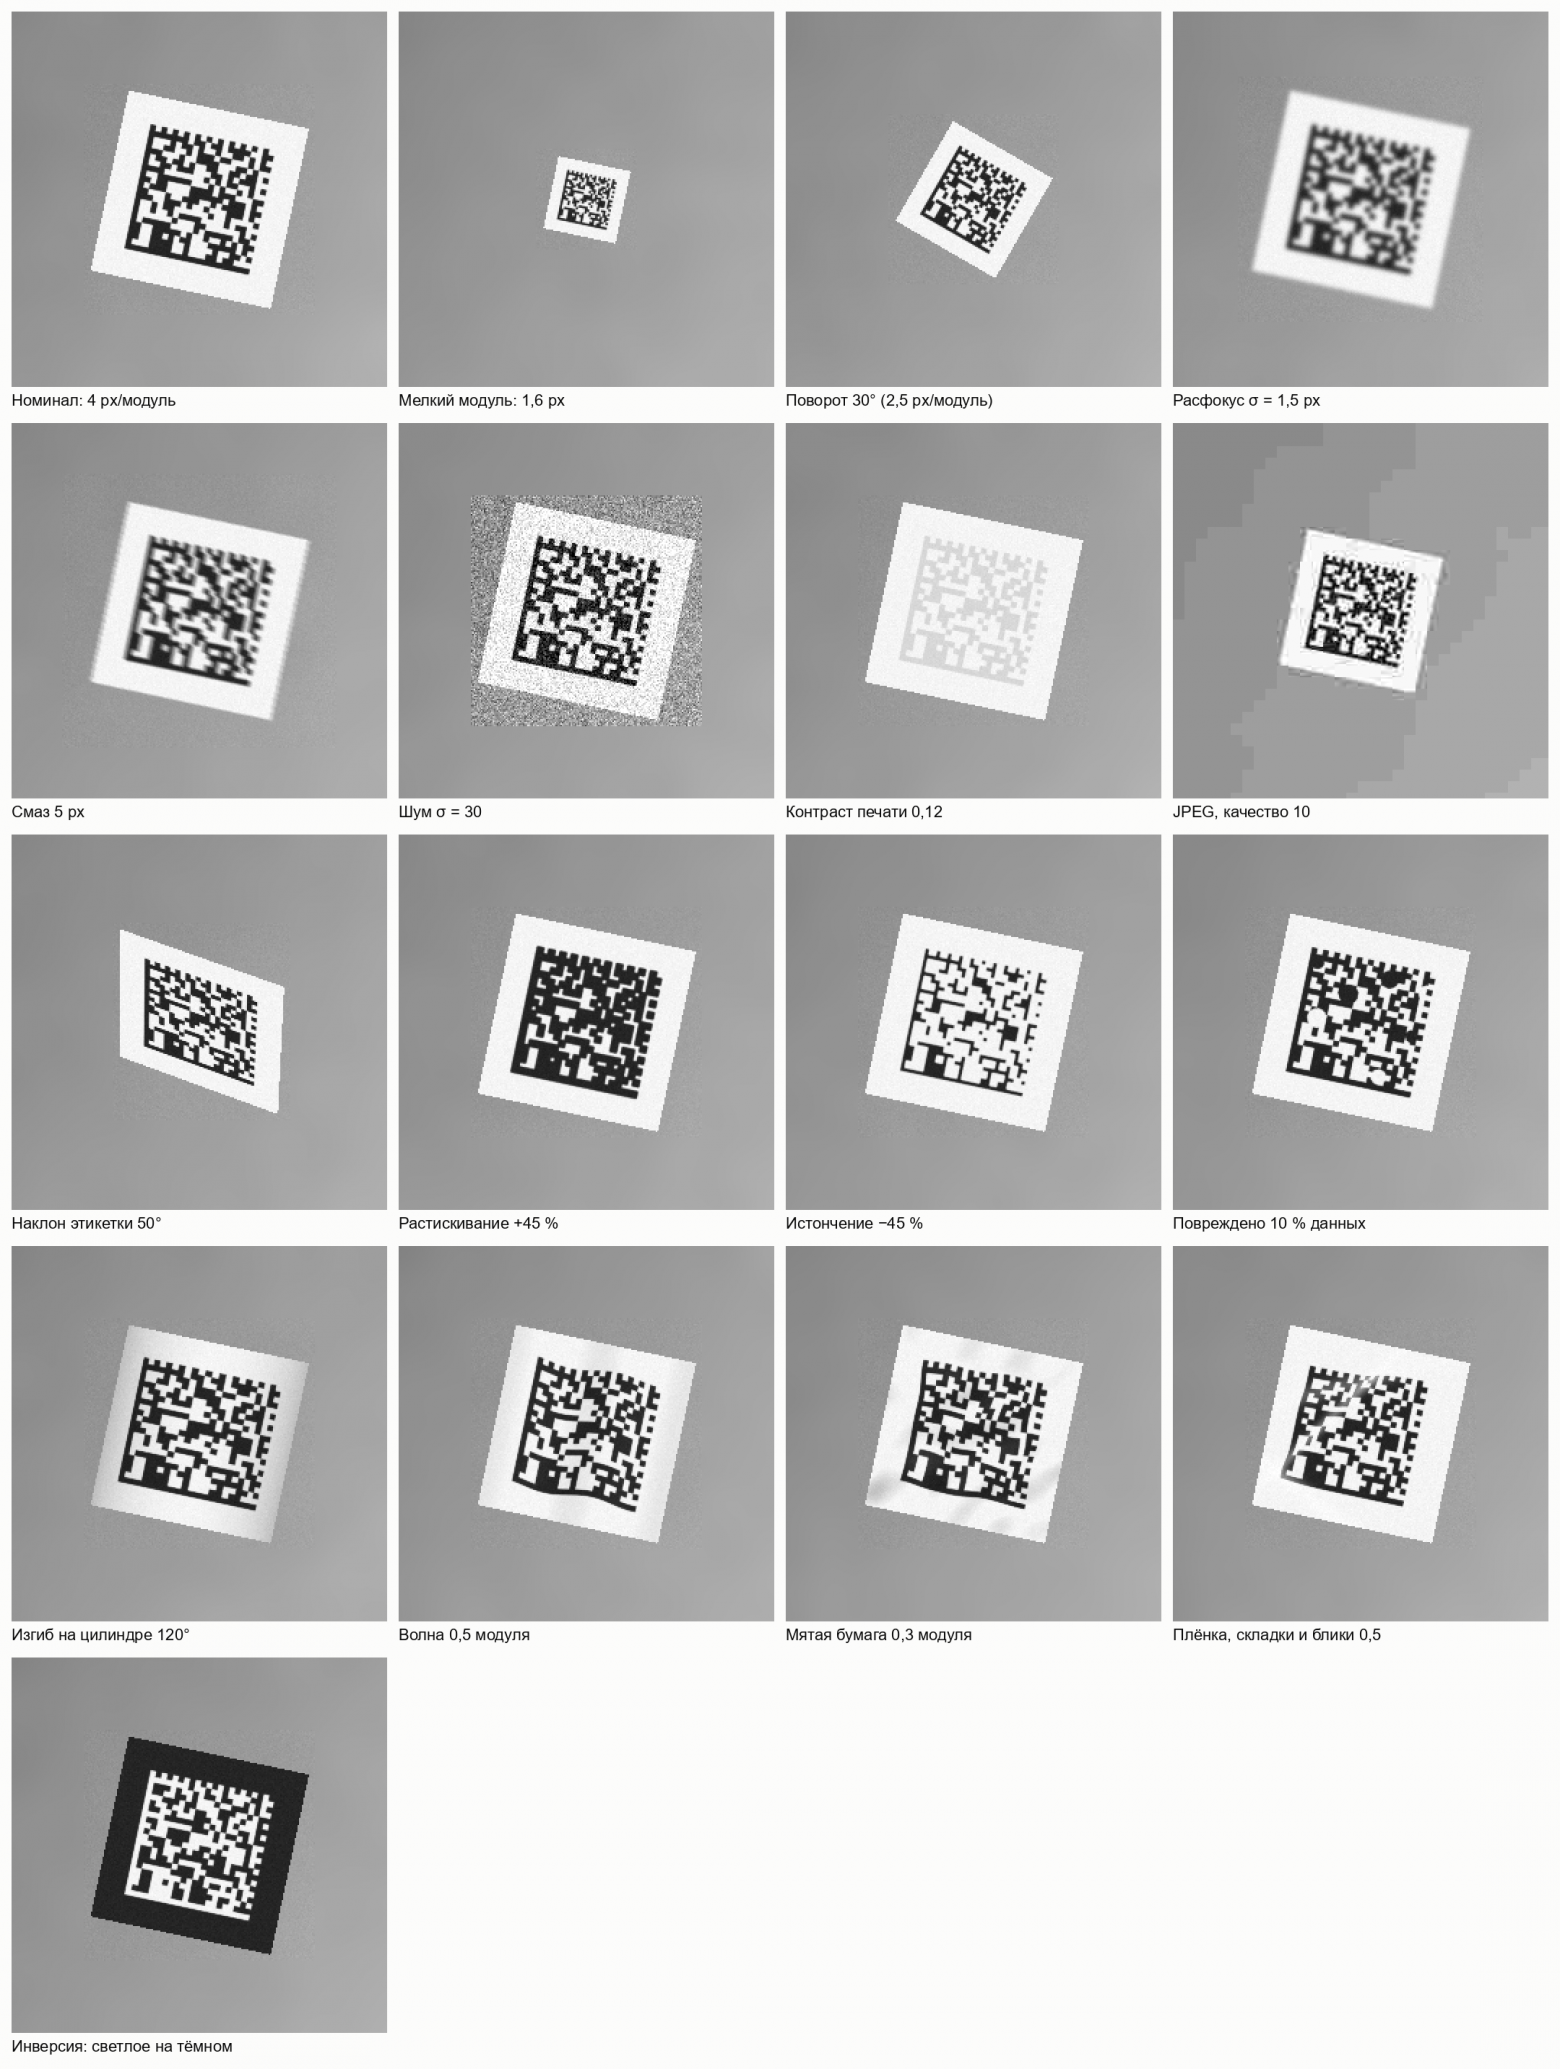
Так выглядят условия набора: один и тот же символ 22×22, фрагмент кадра, увеличенный вдвое без сглаживания — видно настоящее разрешение, с которым работает ридер.
Не подыгрываем ли мы сее генератором? Символы сделаны нашим же генератором, поэтому первое, что мы проверили, — что они стандартные. На 96 номинальных кадрах без искажений dmr и libdmtx читают все 96, zxing-cpp — 95. ZXing читает 8: при 4 пикселях на модуль он символ почти не находит (об этом ниже). Символы — обычный ECC 200.
Как мерили
Условия для всех четырёх библиотек одинаковые. На вход каждая получает один и тот же 8-битный серый буфер в памяти — те же байты; декодирование PNG и JPEG в замер не входит. Каждая работает в своём процессе, закреплённом за одним производительным ядром, в один поток; dmr для этого собран однопоточным.
Настройки — лучшие «из коробки» и одинаковые для всех кадров. У zxing-cpp включены try_rotate, try_invert и try_downscale, у ZXing — TRY_HARDER, ALSO_INVERTED и HybridBinarizer. libdmtx работает с настройками по умолчанию и пределом 3 с на кадр, dmr — по умолчанию, и каждый кадр читается независимо.
Кадр считается прочитанным, если строка совпала с закодированной; ложное чтение — когда выдана другая непустая строка.
Версии: dmr 1.0.7, zxing-cpp 3.1.1, ZXing 3.5.4, libdmtx 0.7.8. Процессор — Intel Core i5-1335U, Windows 10; частота процессора записывалась во время каждого прогона.
Результаты
Общий итог
Библиотека | Прочитано из 1368 | Ложных чтений | Медиана времени на кадр |
|---|---|---|---|
dmr 1.0.7 | 1126 (82,3 %) | 0 | 5,7 мс |
zxing-cpp 3.1.1 | 955 (69,8 %) | 0 | 1,9 мс |
libdmtx 0.7.8 | 892 (65,2 %) | 0 | 12,1 мс |
ZXing 3.5.4 (Java) | 43 (3,1 %) | 0 | 0,8 мс |
Доля «прочитано из всех кадров» сама по себе мало что значит: она зависит от того, какие значения условий мы взяли. Важнее, где у каждой библиотеки кончается надёжное чтение.
Где предел у каждой библиотеки
Худшее значение условия, при котором библиотека ещё читает не меньше 90 % кадров:
Условие | dmr | zxing-cpp | libdmtx |
|---|---|---|---|
Размер модуля, пикселей | 1,4 | 2,0 | 2,5 |
Поворот в плоскости (при 2,5 px/модуль) | любой | до 20° | до 30° |
Расфокус σ, пикселей | 1,8 | 1,5 | 1,2 |
Смаз, пикселей | 6 | 4 | 5 |
Шум σ, уровней яркости | 30 | 30 | 10 |
Контраст печати | 0,05 | 0,12 | 0,12 |
Сжатие JPEG, качество | 5 | 5 | 10 |
Наклон плоскости к камере | 60° | 60° | 50° |
Растискивание (доля модуля) | −55 … +70 % | −30 … +30 % | −30 … +30 % |
Повреждение области данных | 10 % | 5 % | 5 % |
То же у символа без дополнения | 5 % | 5 % | 5 % |
Изгиб этикетки на цилиндре (дуга) | 180° | 150° | 60° |
Волна, модулей | 0,5 | 0,25 | 0 (только плоская) |
Мятая бумага, модулей | 0,15 | 0,15 | 0 (только плоская) |
Плёнка со складками и бликами, модулей | 0,25 | 0,25 | 0,25 |
Инверсия (светлые модули на тёмном) | да | да | да |
Значения dmr для поворота, контраста 0,05, JPEG 5, растискивания и изгиба 180° — край проверенного диапазона: дальше мы не проверяли, настоящий предел может быть дальше. ZXing (Java) в таблицу не вошёл: он не набирает 90 % ни в одной точке ни по одному условию — даже на номинальных кадрах.
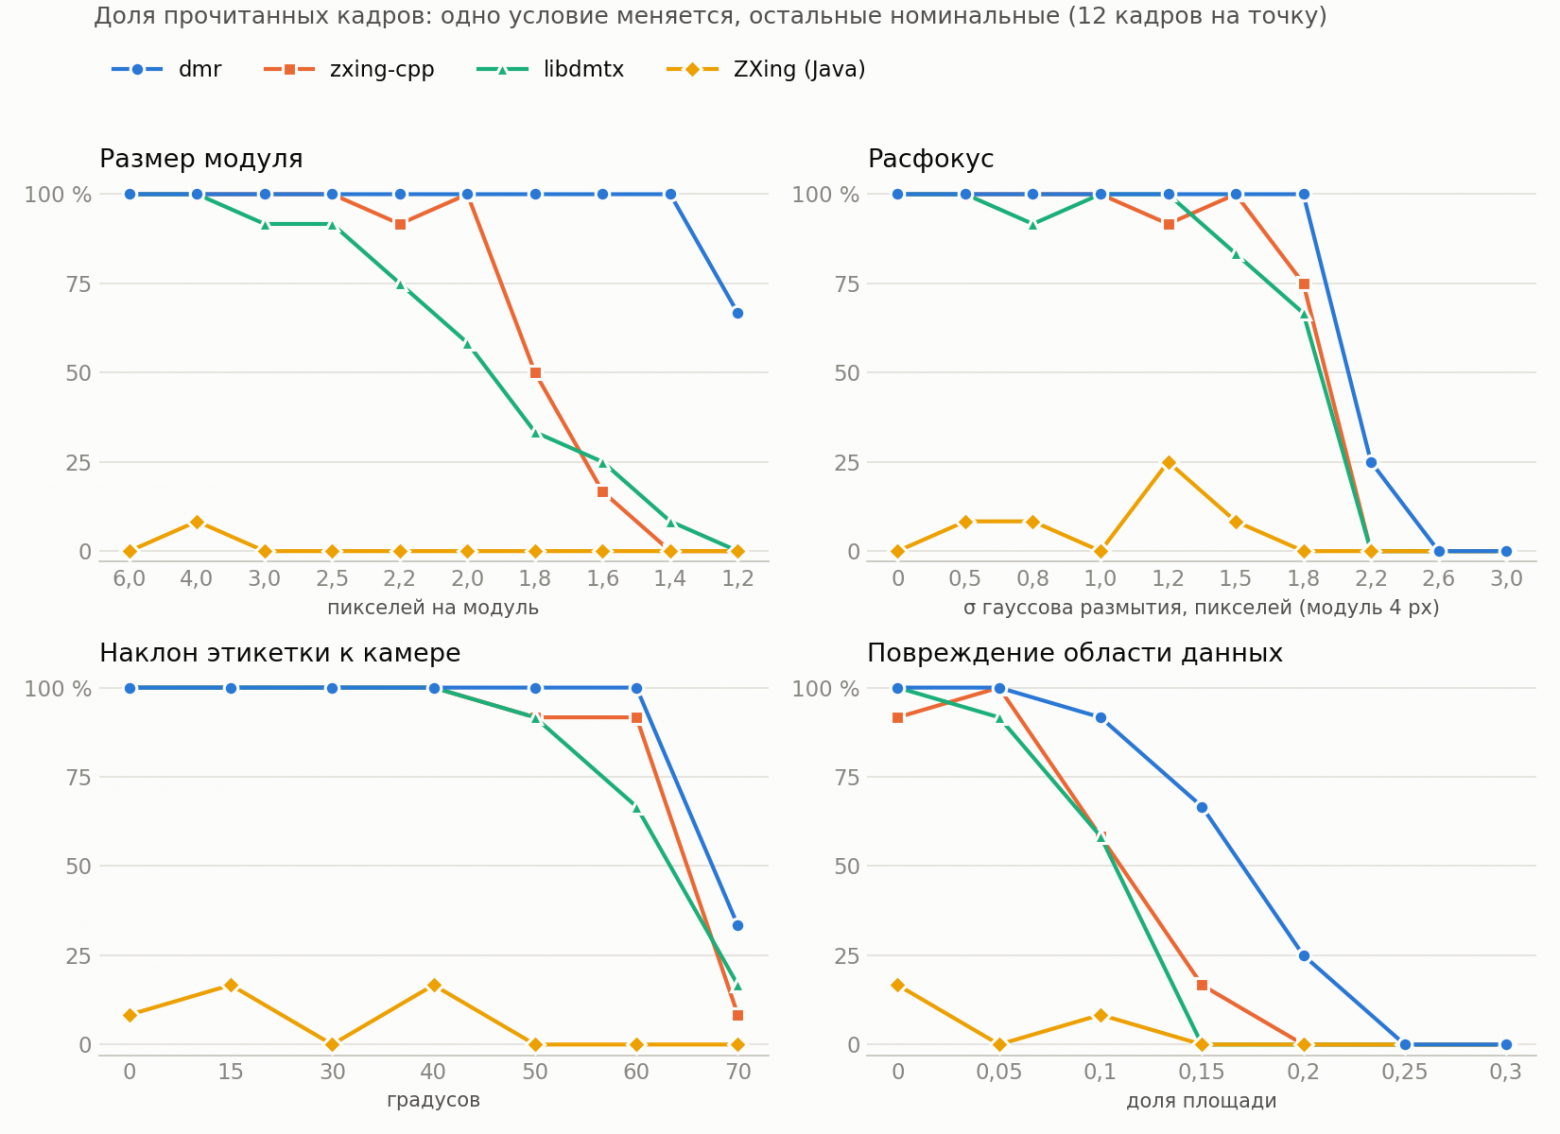
Доля прочитанных кадров для четырёх условий: размер модуля, расфокус, наклон, повреждения. Одно условие меняется, остальные номинальные; 12 кадров на точку.
Что видно
Мелкий модуль и поворот — главное различие. Для конвейера это самое важное: камера одна, этикеток много, символ занимает на кадре сотню пикселей. dmr надёжно читает от 1,4 пикселя на модуль, zxing-cpp — от 2, libdmtx — от 2,5. А при 2,5 пикселя на модуль zxing-cpp уверенно читает символ, только пока он повёрнут не больше чем на 20°, libdmtx — на 30°; dmr — под любым углом.
Печать и поверхность. Бледная печать (контраст до 0,05), растискивание краски в обе стороны, повреждения до 10 % площади, изгиб этикетки на бутылке — здесь dmr держится дольше остальных. Под плёнкой и на мятой бумаге — наравне с zxing-cpp.
Где dmr не лучший. Из 1368 кадров 12 читает кто-то из соперников, но не dmr; обратных — 126. Эти 12 собраны в двух местах.
Очень сильный шум (σ = 60 — вдвое сильнее, чем на картинке «Шум σ = 30» выше). Здесь трудно всем: zxing-cpp не читает ни одного кадра из 12, dmr — 3, libdmtx — 6. При шуме σ = 80 не читает никто.
Символ, заполненный данными «под завязку», с повреждением 10 % площади. zxing-cpp и libdmtx прочитали по 6 кадров из 12, dmr — 3. Здесь dmr отстаёт сознательно, и это стоит объяснить.
В каждом DataMatrix, кроме самих данных, записаны проверочные байты: по ним ридер находит и исправляет испорченные модули. У исправления есть обратная сторона. Если испорчено слишком много, математика может «исправить» символ не в исходную строку, а в другую — тоже формально правильную. Это ложное чтение, и для производства оно хуже любого отказа: непрочитанную коробку снимет контроль, а коробка с чужим кодом уйдёт дальше.
Обычно у ридера есть способ себя перепроверить. Если данных меньше, чем вмещает символ, свободное место заполняется стандартными служебными байтами — заполнителями. Их значения заранее известны, и если после исправления они на месте, значит, исправление сошлось к правильной строке. Когда данные занимают символ целиком, заполнителей нет и сверяться не с чем. Тогда dmr принимает исправление, только если после него остаётся запас нетронутых проверочных байтов, которые подтверждают ответ. На сильно повреждённом символе такого запаса не хватает — и dmr отвечает «не прочитал», а не рискует ответить неверно.
ZXing на мелком модуле не видит символ. Это не ошибка стенда: мы закодировали символ самим ZXing, нарисовали его без шума и без поворота — ZXing 3.5.4 с теми же настройками находит его от 5 пикселей на модуль. На конвейерных кадрах модуль меньше, поэтому ZXing там почти бесполезен. Его короткое время на кадр — это время, за которое он сдаётся.
libdmtx упирается во время. На кадрах, которые она не читает, она думает до предела в 3 секунды; на прочитанных — медиана 5,5 мс, наравне с dmr.
Ложные чтения
Ни одного ложного чтения ни у одной библиотеки — на всех 1368 кадрах никто не выдал строку, отличную от закодированной. Для промышленного применения это важнее доли прочитанного: непрочитанную коробку отбракует контроль, а прочитанную неверно — нет.
Время
Медиана на прочитанных кадрах: zxing-cpp — 1,9 мс, dmr — 5,0 мс, libdmtx — 5,5 мс, ZXing — 1,1 мс (одно ядро, один поток). zxing-cpp быстрее dmr примерно в 2,5 раза — на кадрах, которые читают оба. dmr тратит это время на то, чего другие не делают: несколько гипотез о геометрии и масштабе, уточнение сетки модулей. На конвейере 5 мс на кадр — запас в десятки раз: коробка обычно проезжает под камерой за сотни миллисекунд.
Время снято на одном ядре ноутбука; сравнивать стоит библиотеки между собой, а не с другими машинами. dmr по умолчанию работает в несколько потоков — здесь для честности он ограничен одним.
Почему мелкий модуль — это трудно
При 2 пикселях на модуль символ 22×22 занимает на кадре около 50 пикселей. Каждый модуль — это пара пикселей, причём на границе модуля пиксель захватывает половину соседнего. Бинаризация склеивает соседние модули, сплошные линии рамки при повороте превращаются в лесенку, а классические детекторы ищут символ по признакам, которые на таком масштабе просто не видны. ZXing, например, не находит символ меньше примерно 5 пикселей на модуль — даже идеальный.
Вот что делает dmr, коротко.
Два независимых детектора. Первый ищет область высокой двумерной текстуры — так выглядит любой DataMatrix. Но так же выглядит мелкий текст на этикетке и бликующий металл направляющих конвейера: на наших кадрах рельс конвеера обгонял код по «текстурности». Второй детектор спрашивает другое: где на кадре две перпендикулярные сплошные линии равной длины с общим концом? Это L-образная рамка — определяющий признак DataMatrix, и ни текст, ни рельс её не дают. Кандидаты обоих детекторов проходят через одну и ту же проверку кодом Рида — Соломона, поэтому лишний источник кандидатов не может ухудшить результат — только добавить попытки.
Сетка модулей не от четырёх углов. Этикетка лежит на коробке, на бутылке, под плёнкой — её края в кадре не прямые. Сетка, построенная по четырём углам (даже с перспективой), к середине стороны съезжает на модуль, а при 2 пикселях на модуль это уже чужой модуль. Поэтому границы символа трассируются по каждой строке развёртки, символ режется на регионы, а точки внутри региона интерполируются по его четырём граничным кривым. Положение модулей вдоль стороны берётся из чередующейся тактовой дорожки — она даёт переход на каждой границе модуля.
Несколько гипотез, одна проверка. Порог бинаризации, масштаб выпрямления, размер символа, уточнение сетки — у трудного кадра правильный вариант заранее не известен. dmr пробует гипотезы в порядке «отдачи» (сначала те, что чаще срабатывают на настоящих кадрах) и останавливается на первой, которую подтвердила проверка. На лёгком кадре это одна попытка, на трудном — десятки. Отсюда и разница во времени с zxing-cpp.
Строгая приёмка. Код Рида — Соломона умеет не только исправлять ошибки, но и сходиться к чужому, неправильному кодовому слову, если ошибок слишком много. Поэтому dmr принимает исправление только со «свидетелями» — частью проверочных синдромов, которые остались непотраченными и подтверждают ответ. Символ без дополнения (данные во всю ёмкость) таких свидетелей имеет меньше, поэтому для него dmr осторожнее — это видно в таблице на строке «повреждения без дополнения». Пустой результат (однородная сетка формально тоже кодовое слово) не принимается вовсе. Итог — ни одного ложного чтения на 1368 синтетических кадрах и почти на 13 тысячах кадров с линий, на которых мы проверяем каждую версию.
Подсказка размера по потоку. На конвейере камера видит одну и ту же этикетку много раз подряд. Размер символа, подтверждённый несколькими кадрами, dmr пробует первым на следующих — это экономит перебор. Смена этикетки обходится одним кадром: подсказка гаснет при промахе. В этом сравнении подсказка выключена — каждый кадр читается независимо.
Ограничения этого сравнения
Синтетика — не реальная линия: освещение, оптика и печать у каждой линии свои. Символы и условия придуманы нами, а dmr разрабатывался под похожие кадры, так что это его «домашнее поле». Поэтому мы выкладываем всё — кадры, ожидаемые строки, генератор и скрипты замера: каждый может проверить результат и добавить свои условия.
Время снято на одном ноутбуке, и абсолютные значения зависят от процессора и его нагрева. Коммерческие SDK не сравниваются: этого не разрешают их лицензии.
Как повторить
Всё лежит в открытом репозитории libscanner/datamatrix-benchmark. Кадры (1368 PNG, 60 МБ) и ожидаемые строки — архивом в разделе Releases под лицензией CC0, их можно брать для своих сравнений. Там же программы замера для всех четырёх библиотек, сценарий прогона, сводки и сырые результаты каждой библиотеки по каждому кадру, а ещё генератор набора: условия в нём описаны списком, и добавить своё — несколько строк.
После установки зависимостей (Windows, MSYS2, Python, Java) повтор — две команды:
python synthetic\png_to_pgm.py
powershell -ExecutionPolicy Bypass -File synthetic\run_synth.ps1 -DmrPrefix <распакованный архив dmr>
Подробно — в README репозитория.
Попробовать dmr на своих кадрах можно одной командой:
pip install libscanner-dmr
или прямо в браузере — libscanner.com/scan. Примеры на C++, C и Python — в репозитории библиотеки.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.