Большинство ответов поиска готовы ещё до того, как пришёл запрос
Пока покупатель печатает «платье в пол», самая тяжёлая часть работы в поиске Wildberries уже сделана. Для абсолютного большинства запросов нужный набор товаров собран заранее. Остаётся найти этот набор и подстроить его под конкретного человека. Как мы к этому пришли и почему это работает, расскажем по порядку.
Пойдём за одним запросом и будем останавливаться там, где напрашивается вопрос. На каждый такой вопрос сначала попробуем самый простой ответ и посмотрим, где он ломается: из этих поломок и вырастает наше решение.
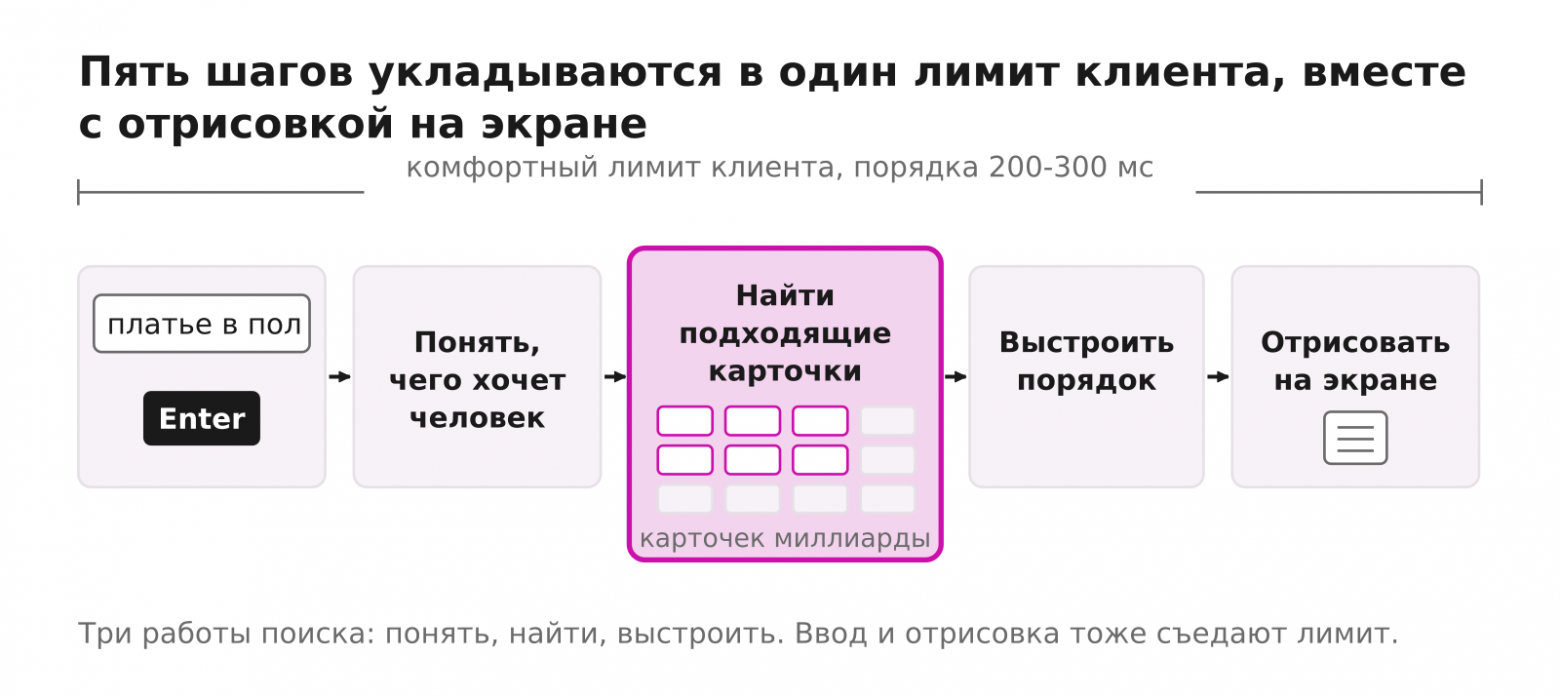
Покупатель нажал Enter и дальше ждёт результат. Сколько ему ждать, определяем мы сами, и держим этот лимит максимально комфортным для клиента: порядка 200-300 миллисекунд на всё, включая отрисовку страницы в браузере или в мобильном приложении. Это очень быстро, примерно столько длится одно моргание.
В предыдущей статье мы описали условия задачи: весь путь клиента, данные продавца, цену каждой секунды задержки. Её можно читать отдельно. Здесь нам нужен один вопрос: как быстро найти кандидатов, когда карточек миллиарды?
Что происходит после Enter?
Если разобрать работу поиска на крупные части, их окажется три: понять, чего человек хочет, найти подходящие карточки и выстроить их в удобном для него порядке. Подходящие карточки называют кандидатами: они прошли первый отбор и претендуют на место в выдаче.
Первую задачу — понять клиента — мы разберём в отдельных статьях: на архитектуру всего поиска она влияет слабее остальных. Нас сейчас интересует вторая задача — поиск кандидатов. Она крайне непроста, и от неё зависит в том числе ранжирование: если нужная карточка не попала в кандидаты, никакая умная модель её уже не поднимет. А карточек в индексе миллиарды, и перед экраном ждёт живой человек.
Представьте библиотеку с миллиардами книг и читателя у стойки, которому нужную книгу надо найти почти мгновенно. Библиотекарь не может обойти все полки: ему нужен способ сразу понять, куда идти. Вся статья о том, как такую библиотеку устроить.
Таких поисковых запросов десятки и сотни миллионов в сутки. Нагрузка при этом неровная: она меняется на порядок между утром и вечером, буднем и распродажей. Систему приходится строить под пики, а не под среднее.
Голые миллисекунды тут не главное: важнее, чтобы абсолютное большинство клиентов вписывалось в свой комфортный лимит. Когда это перестаёт получаться, падает конверсия, и падает заметно.
Важна и свежесть: новый товар, цена и остаток должны попадать в выдачу быстро, иначе мы теряем продажи или принимаем заказ на товар, которого уже нет.
Цифры о нашем поиске в статье даны по порядку величины: нам важны масштаб и соотношения, а не точные значения.
Начнём с самого простого. Представим, что каталог небольшой. Тогда он целиком помещается на одной машине, как первые фотографии в вашем новом смартфоне. Ассортимент растёт, и однажды места перестаёт хватать. Выхода два: взять машину мощнее или вынести часть данных на другую машину, а потом и на ещё одну, и так далее. Разберём оба сценария, начнём с первого.
Покупаем машину побольше, и там всё разместим?
Единой машины, в которую мы поместимся, нет. Если покупать машину побольше, рано или поздно упрёшься в потолок: самые большие серийные серверы (AWS U7i, HPE Superdome Flex, IBM Power E1080) вмещают лишь десятки терабайт, а каталог продолжает расти. Расширяться за счёт всё более мощных машин можно, но цена такого роста обгоняет рост памяти: за каждый добавленный терабайт приходится платить всё больше.
Есть и менее заметная цена, которой нет в прайс-листе. Внутри любой машины данные идут к процессору по лесенке уровней: от быстрой памяти до сети и диска. У каждой ступеньки своя цена обращения. Вот как это выглядит:
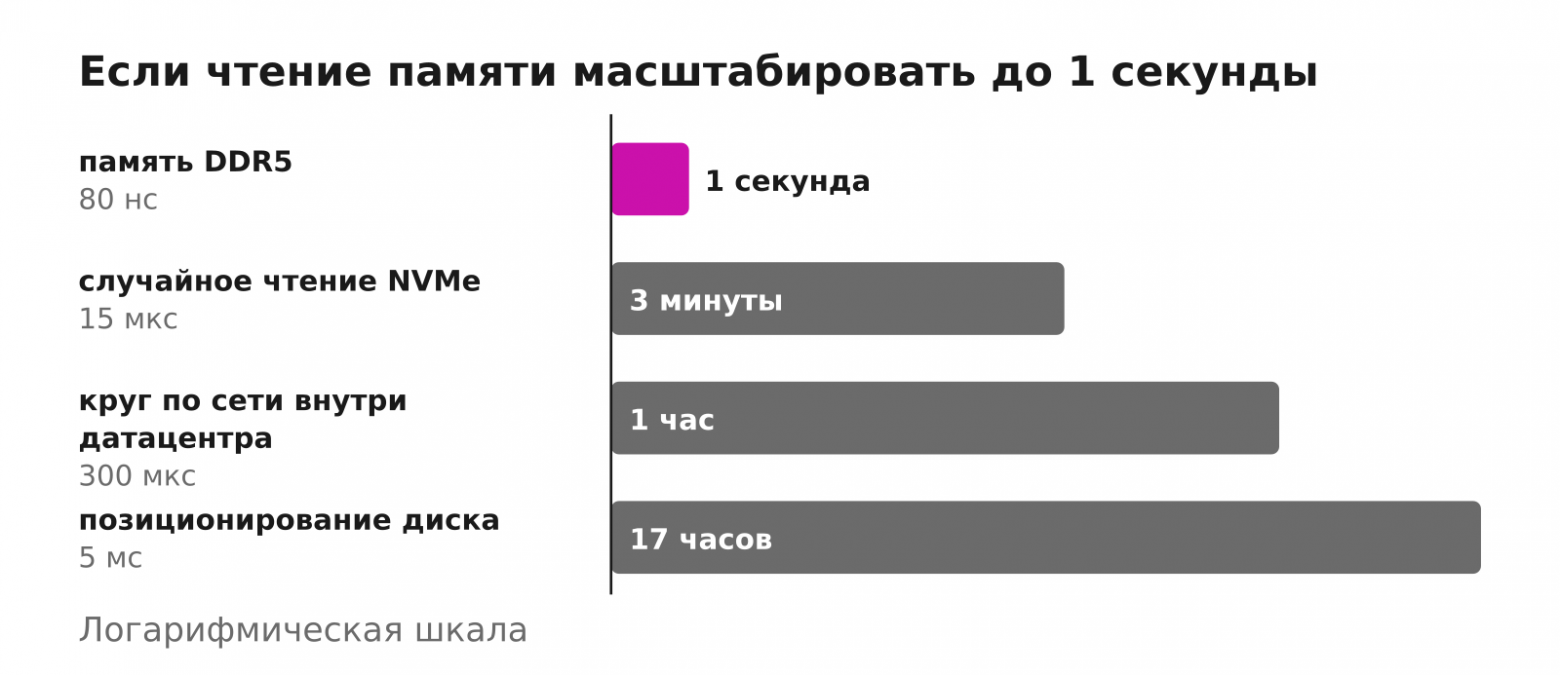
Значения на картинке — порядки величин из известной подборки «Latency Numbers Every Programmer Should Know», ссылка на неё в конце. Важны не сами цифры, а расстояния между ступеньками: каждая следующая находится дальше от процессора и обходится дороже предыдущей, а от памяти до сети разница составляет несколько тысяч раз. Это как разница между книгой на вашей собственной полке и книгой, которую надо ждать из другого города. На этой лесенке стоит всё остальное, о чём пойдёт речь.
Может показаться, что суперкомпьютер от этого избавляет. Но он остаётся тем же самым компьютером, просто с большим числом процессоров и памяти в одном корпусе, и от этой лесенки не избавлен.
Из лесенки следует простое правило: чем дальше данные от процессора, тем дороже каждое обращение к ним. Поэтому считать выгодно там, где нужные для решения данные уже лежат, и не возить их с места на место без нужды. Это правило нам ещё не раз пригодится.
Что происходит, когда индекс лежит на сотне машин?
Сразу оговорюсь: всё, о чём пойдёт речь дальше, начинается только при очень большом ассортименте. Пока каталог небольшой, хватает нескольких машин, веер по ним не страшен (что это за веер, расскажу чуть ниже), и классический поиск работает хорошо. Проблемы начинаются там, где машин сотни.
Итак, данные приходится делить между машинами. В классическом поиске делят индекс: структуру, которая по слову запроса быстро находит подходящие карточки. Он похож на предметный указатель в конце книги: по слову сразу видно, на каких страницах искать.
Индекс режут на части, шарды, и раскладывают по N машинам. Раскладывают двумя основными способами: либо стараются поделить поровну, либо складывают новые карточки во всё более новые шарды, чтобы старые карточки не переезжали при появлении новых.
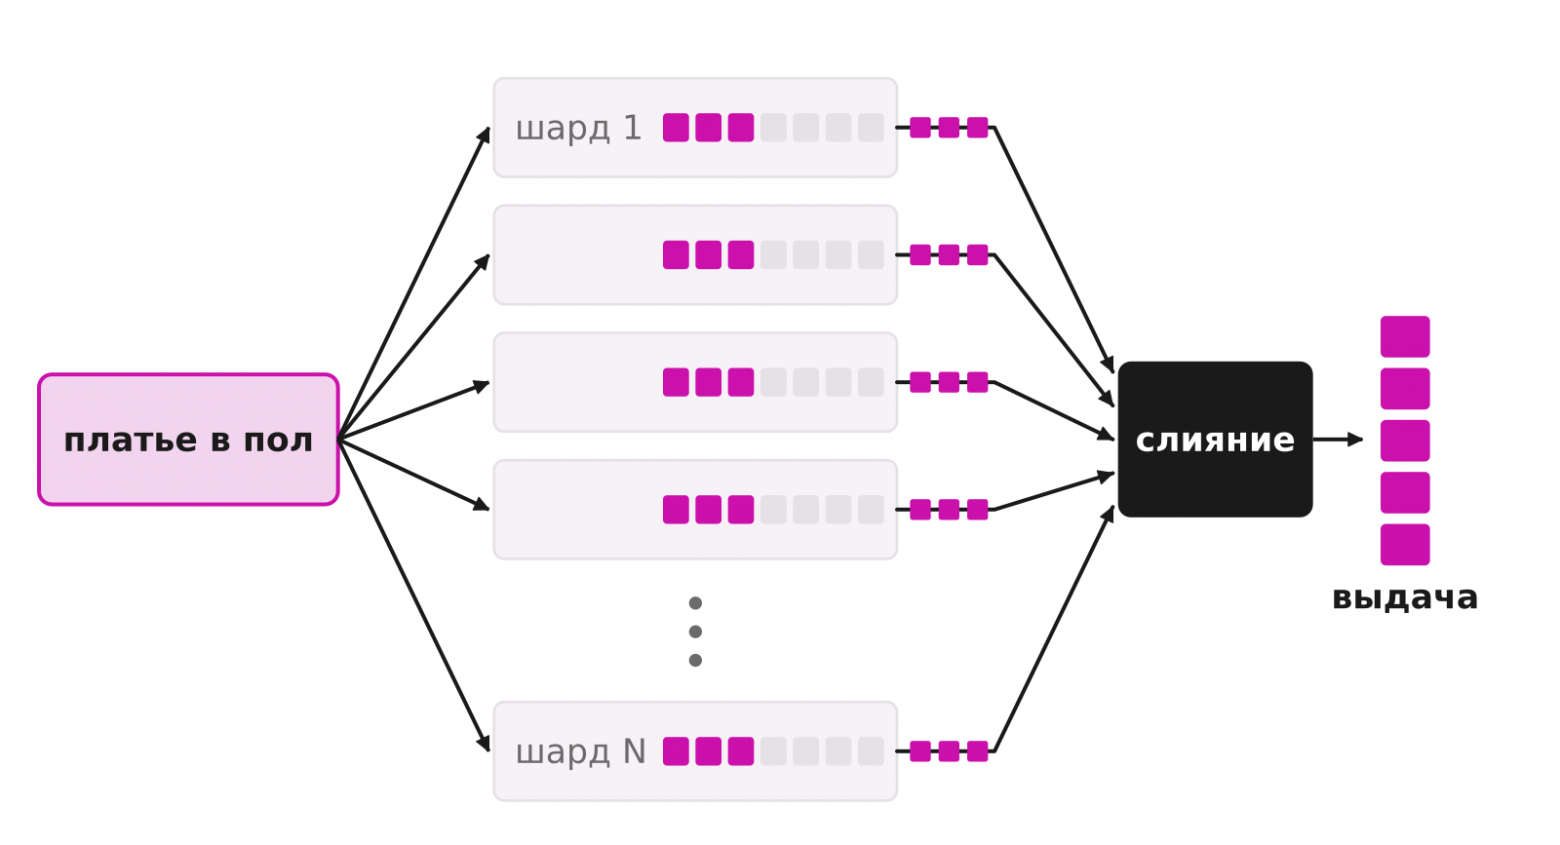
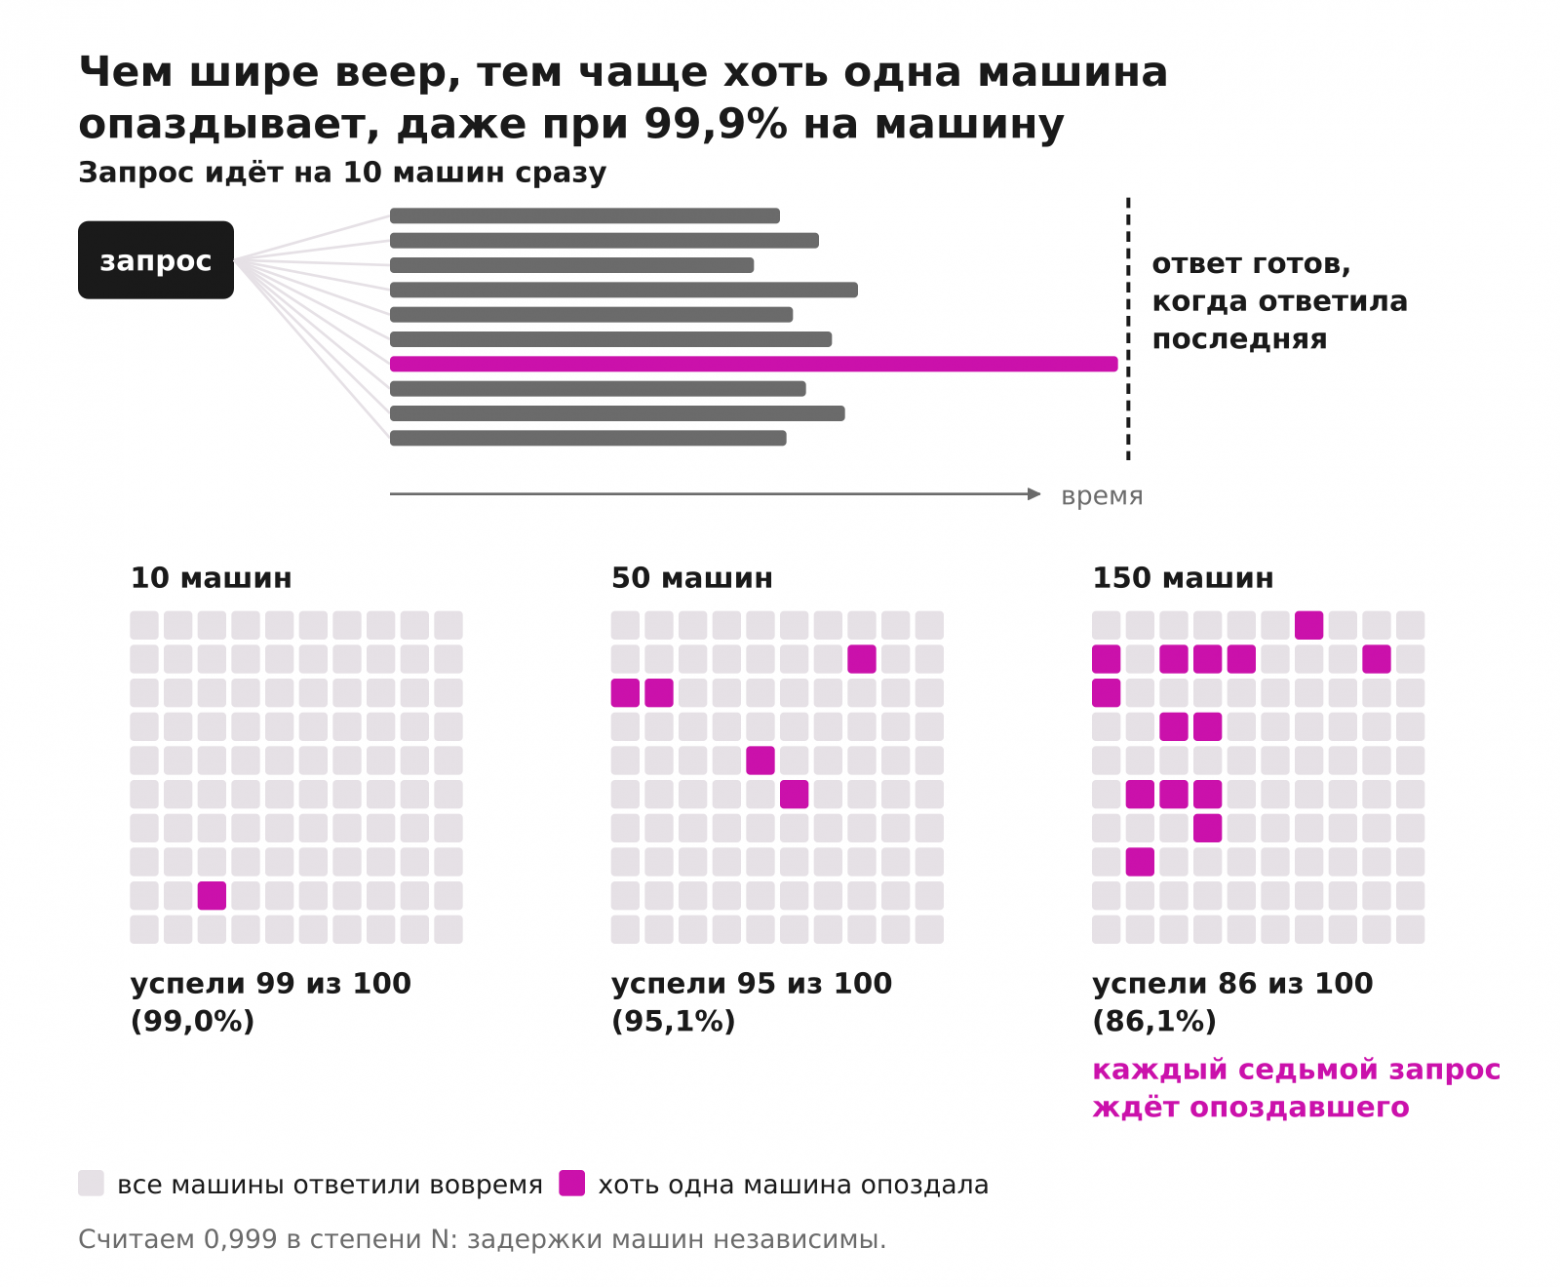
Удобно представить шард как один том многотомной энциклопедии со своим указателем. Наше «платье в пол» не знает, в каком томе лежат нужные платья, поэтому уходит во все N томов сразу, как если бы библиотекарь разослал помощников по всем залам. Такая рассылка называется веером, по-английски fan-out.
Каждая машина находит у себя своих кандидатов, и дальше их, казалось бы, надо целиком передать в общий узел. Но по одному запросу на шарде могут оказаться миллионы карточек, и гонять их по сети на каждый запрос слишком дорого. К тому же покупателю мы в итоге покажем чаще всего от одной до ста карточек, так что миллионы ему не нужны. Поэтому вводится лимит: каждая машина присылает только лидеров своего тома.
Лидеров сливают в один список на отдельной машине и упорядочивают уже под этого покупателя. На одной машине расчёт был бы один, а теперь их N, и каждый приходится дожидаться. Чем шире веер, тем больше сетевых обращений и вычислений приходится на каждый запрос.
Парк машин ещё надо кормить свежими данными. Индекс нередко обновляют целиком, и время полной переиндексации становится метрикой, за которой следят чуть ли не так же внимательно, как за задержкой ответа: пока она идёт, часть изменений каталога в выдачу не попадает.
Есть и вторая беда, менее очевидная. Ответ готов, когда ответила последняя машина, поэтому один тормоз держит всю выдачу. Эту проблему подробно описали Джефф Дин и Луис Андре Баррозо в статье «The Tail at Scale» (Communications of the ACM, 2013).
Это как с гостями за ужином: садиться за стол можно, когда пришёл последний. Иногда кто-то задерживается, и гости начинают без него. А потом выясняется, что опоздавший и был виновником торжества: без него выдача получается неполной, а лучший товар мог лежать как раз на той машине.
Посчитаем, насколько это серьёзно. Пусть каждая машина укладывается в срок в 99,9% случаев, это очень хороший результат. Тогда вероятность того, что в срок уложатся все N машин сразу, равна 0,999 в степени N (расчёт для независимых задержек). При веере на 10 машин это 99,0%, на 50 машинах 95,1%, на 150 машинах 86,1%.
Иначе говоря, на ста пятидесяти машинах каждый седьмой запрос ждёт опоздавшего, и это при очень хорошей машине. Чем шире веер, тем чаще запрос упирается в самую медленную из них, и тем сильнее это бьёт по комфортному лимиту клиента.
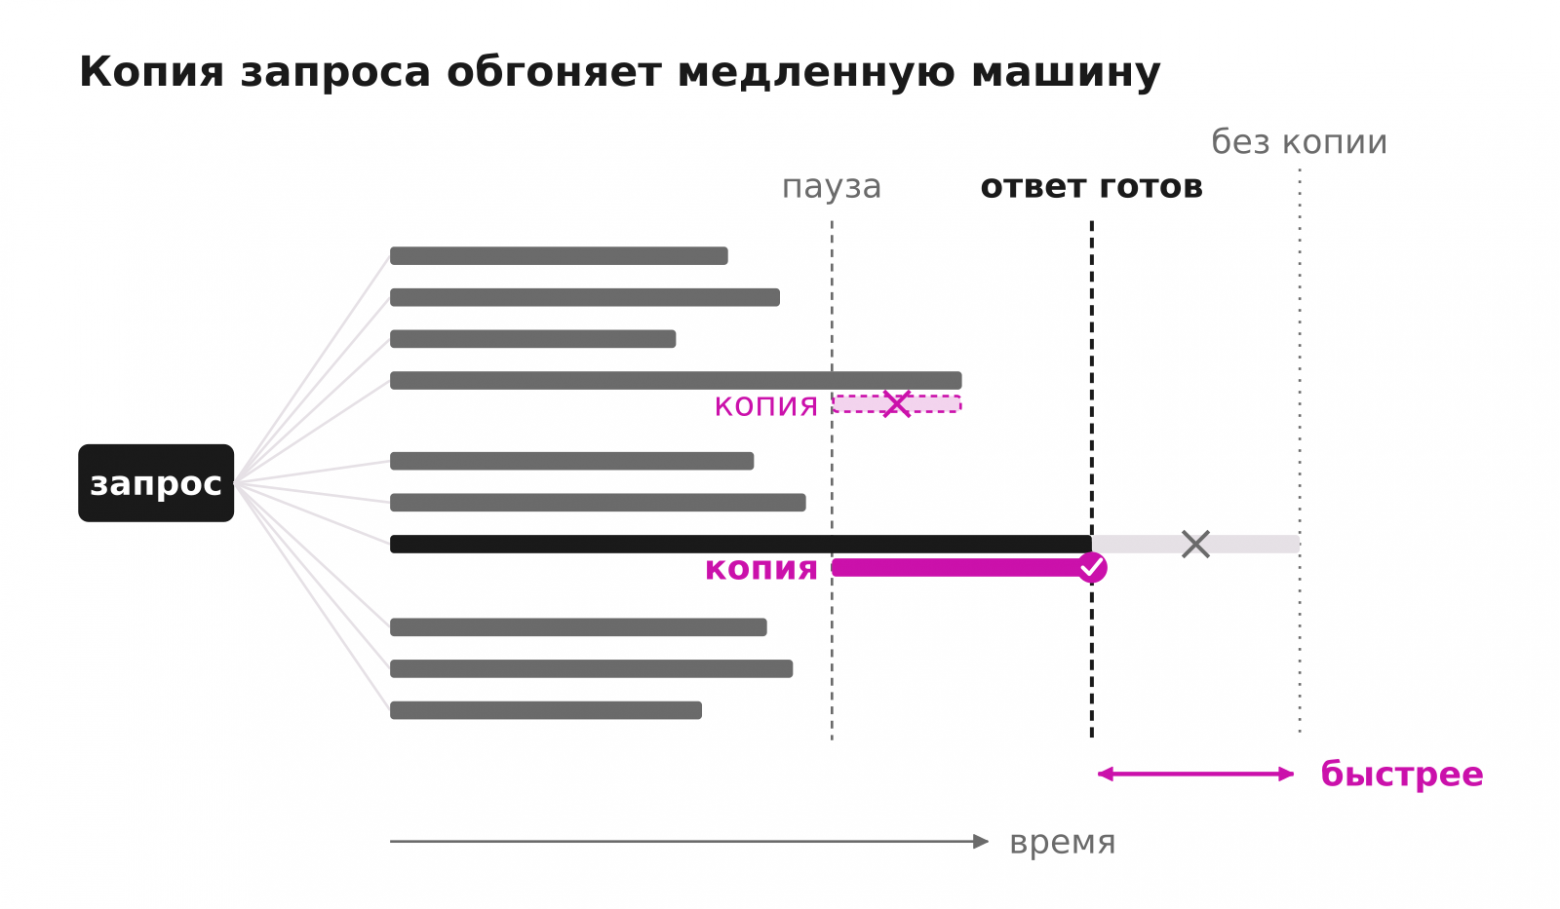
Защититься от этого можно хеджированием. Идея простая: если машина молчит дольше обычного, шлём тот же запрос её копии (реплике) и берём ответ, который пришёл первым. На картинке видно, когда запускается копия: после паузы, на другой машине. Она обгоняет медленную, и ответ готов раньше. Копия, запущенная зря, потому что оригинал всё-таки ответил сам, помечена крестиком.
Платим за это запросами и временем: запросов к машинам становится больше (в тесте авторов «The Tail at Scale» на 2%, при паузе в 95-й перцентиль примерно до 5%), а задержавшийся ответ всё равно ждёт паузу и ответ копии. Есть и крайняя мера: отдать выдачу без опоздавших шардов, то есть заплатить полнотой.
Веер и хвост можно смягчить, но цена остаётся. Сильнее всего помогло бы вообще не опрашивать все N машин на каждый запрос. Классический поиск, где индекс разложен по машинам и каждый запрос считается заново, платит за веер каждый раз. Хочется не считать заново то, что уже считали.
Нельзя ли просто закешировать готовые ответы?
Можно, и это первое, что приходит в голову. Тысячу одинаковых запросов считаем один раз и тысячу раз отдаём одну и ту же выдачу. Для нагрузки это было бы прекрасно: вся работа делается один раз.
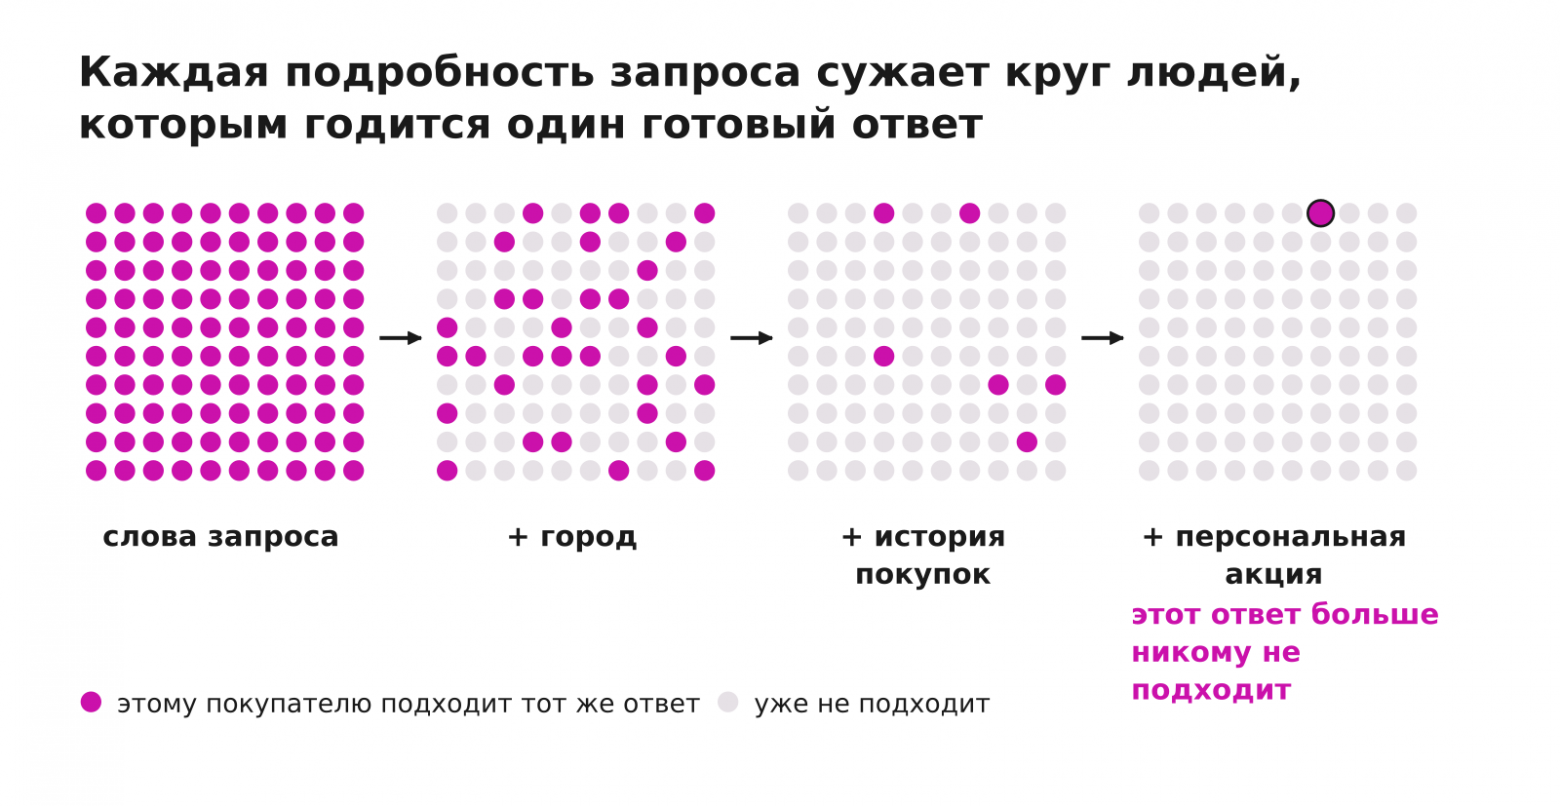
Идея спотыкается об одно обстоятельство: слово «запрос» в поиске значит две вещи сразу. Это текст, который набрали, и сам покупатель, который его набрал. Город доставки, история покупок и персональные акции входят в запрос так же, как слова в строке.
«Платье в пол» набирают многие. Но «платье в пол» от покупателя из Казани, с его историей покупок и сегодняшней персональной скидкой, набирает один человек. Каждая переменная по отдельности безобидна: город, история, скидка. А вместе они сжимают группу людей, которым годится один готовый ответ, до единиц.
В пределе запрос конкретного человека в конкретную минуту уникален, и готовый ответ целиком почти никому больше не подойдёт. Значит, кешировать ответ целиком нельзя. Но, возможно, получится кешировать его часть?
Что делать, если ответ целиком не закешировать?
Целиком запоминать нечего, зато кое-что от покупателя не зависит: список кандидатов. Пусть каждая машина отдаёт кандидатов с запасом, а выбирает среди них слой ранжирования выше. Там уже знают покупателя, и персонализации есть где развернуться.
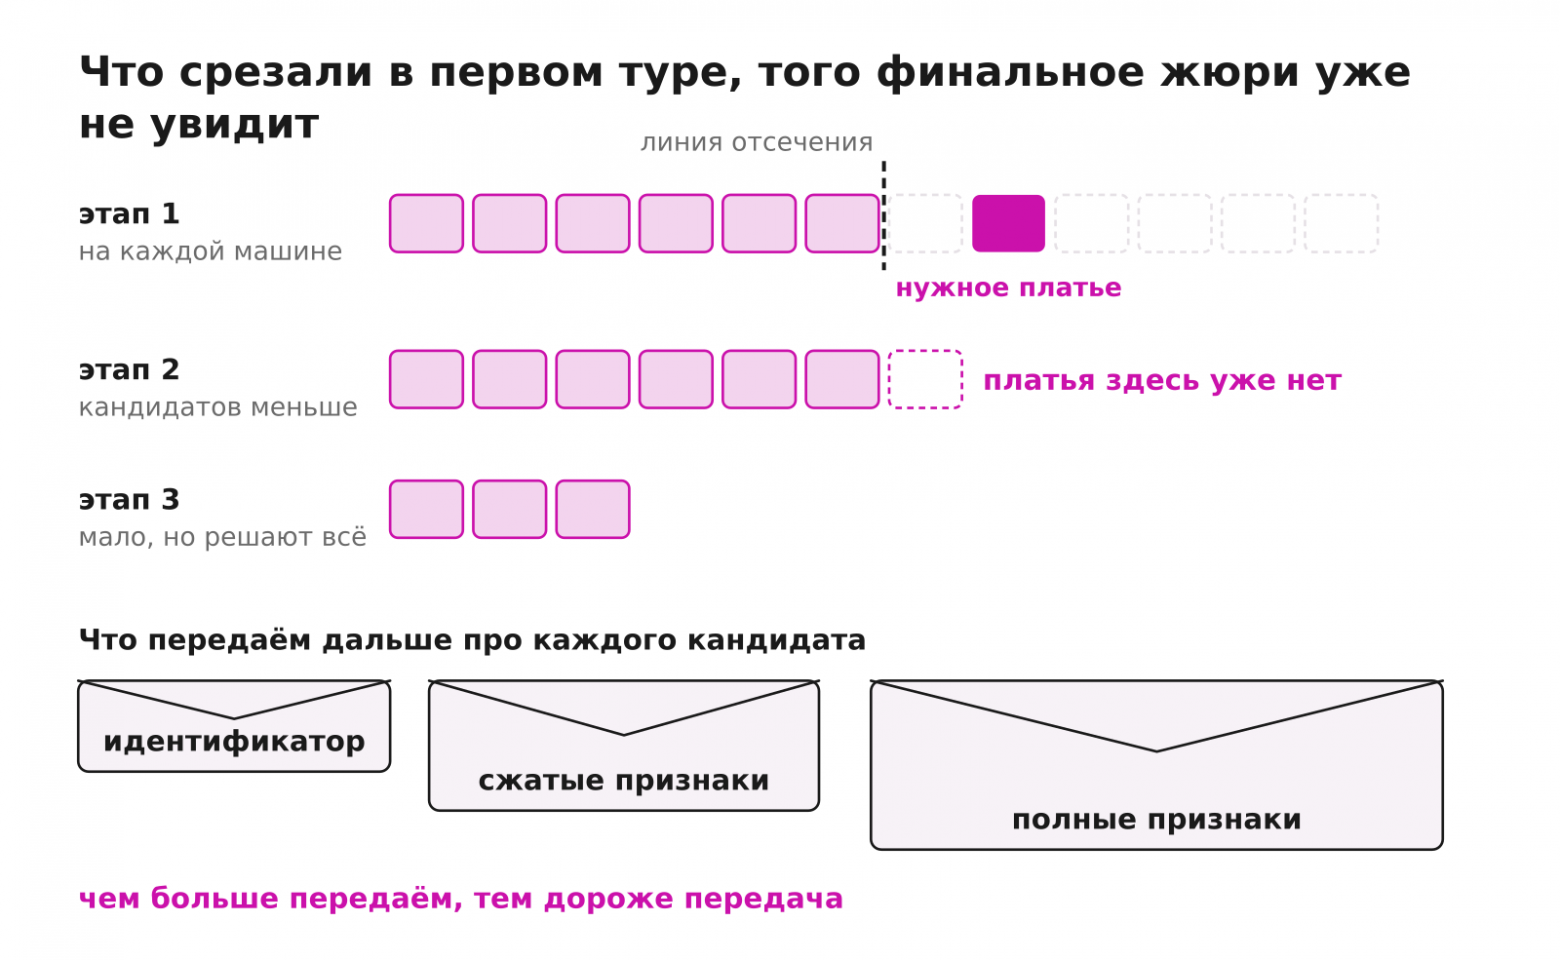
Так возникает многоэтапный отбор, обычное дело для поисковых систем. Сначала идёт широкий и дешёвый отбор, потом всё более узкое и дорогое ранжирование. С этапа на этап кандидатов становится на порядок меньше, а на каждого оставшегося тратят в разы больше времени: дорогую модель нельзя запускать на миллионах карточек, зато на сотне можно.
Похоже на конкурс с отборочными турами: в первом смотрят быстро и многих, в финале долго и немногих. Ловушка сидит в первом туре. Он идёт на каждой машине отдельно и простой моделью, чтобы не разориться. Если на машине оказалось много сильных конкурентов по запросу, подходящее платье вылетит, и финальное жюри его не увидит, каким бы умным оно ни было.
Эта беда возникает при довольно большом ассортименте, и компании идут здесь на сознательную деградацию качества, иначе в лимит не уложиться.
Для меня главное в том, что качество тут зависит от данных, то есть от везения, а от алгоритмов меньше. От того, сколько одних платьев сейчас на площадке, может сильно поменяться качество ранжирования других, тех самых, что вылетели в первом туре. Алгоритм тот же, а результат другой.
Итак, многоэтапный отбор снимает часть нагрузки, но переносит риск в первый тур. Остаётся вопрос, что передавать жюри. Можно один номер товара: дёшево, но судить нечего. Можно досье со всеми признаками: судить есть что, но сеть заплатит за каждую строчку досье. Выбор здесь всегда в том, за что платить: за слепоту жюри или за трафик по сети.
Персонализацию можно разложить и на несколько запросов сразу: отдельно популярные платья, отдельно популярные в городе покупателя, отдельно из его личных рекомендаций, а потом смешать три выдачи. С многоэтапным отбором это сочетается, но управляется плохо.
Покажу на примере, почему. Пусть идеальное платье стоит в каждом из трёх списков сто первым, а каждый список берёт первую сотню. Платье не попало ни в один, хотя в каждом было в шаге от отсечения. В масштабе площадки такие потери складываются в недополученные продажи.
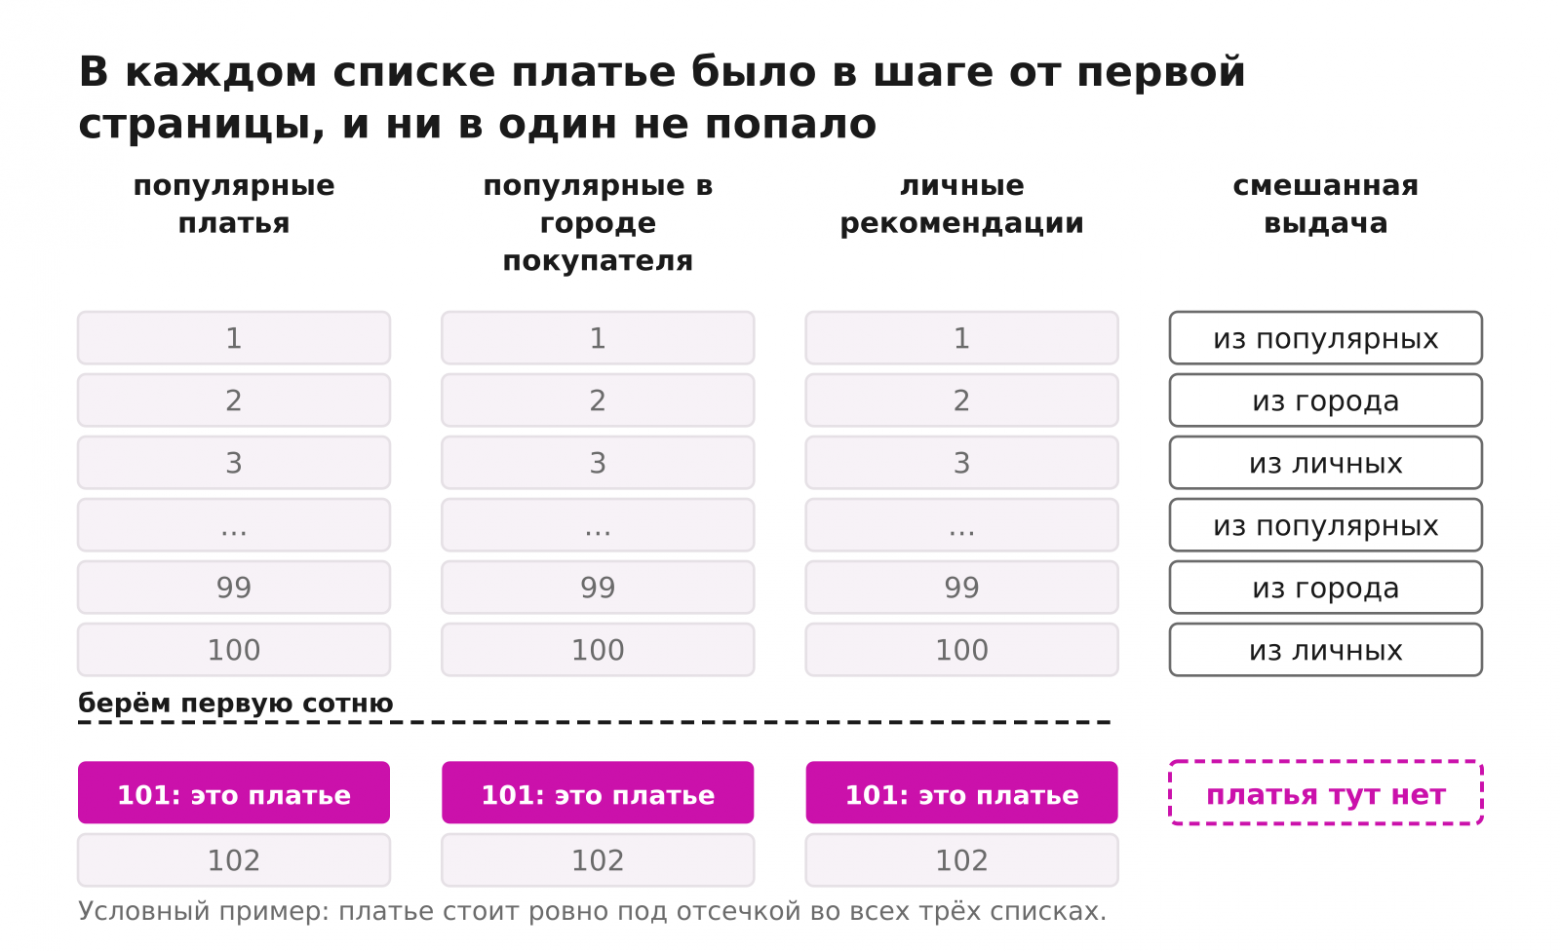
Тут та же болезнь, что и в первом туре: чем больше ассортимент, тем чаще платья теряются на границе своего окна.
Все эти приёмы работают с тем, что уже лежит на машинах, и меняют только способ опроса или слияния. Саму раскладку данных они не трогают. А если изменить именно её?
Попробуем избежать веера и сложим похожие товары рядом?
Положим платья к платьям, а смартфоны к смартфонам. Небольшая модель, классификатор, читает запрос и говорит, на какую полку идти. Что именно человек хочет найти, в поиске называют интентом. «Платье в пол», «длинное платье» и «макси-платье» написаны по-разному, а смысл, то есть интент, у них один.
Раскладка по категориям делает отсечение честным. При случайной раскладке платье лежит на одном шарде с холодильниками и смартфонами и в локальном отборе борется с товарами, с которыми покупатель его никогда не сравнит. На шарде с платьями соревнуются только платья, поэтому лидеры получаются осмысленными.
На маркетплейсе такая раскладка естественна: запрос почти всегда намекает на категорию. Машин для опроса становится меньше, но веер остаётся. Запрос «одежда zara» пойдёт веером по всем шардам с одеждой, и таких запросов много.
Для товарного поиска такой подход описывали и в Amazon: небольшая нейросеть выбирает шарды, куда отправить запрос, и остальные не опрашиваются. Итак, раскладка по категориям улучшает отбор и сокращает веер, но не убирает его совсем.
Что можно сделать до того, как покупатель нажал Enter?
Представим, что библиотекаря десять раз за утро спросили, что почитать про Древний Рим. На одиннадцатый раз он не идёт в хранилище: нужная стопка уже лежит на стойке. Появилась новинка, он положит её сверху. Поиск может делать то же самое.
Возьмём шард с платьями. Тысячи покупателей печатают «платье в пол», «длинное платье», «макси платье», и почти всем нужен один набор карточек в примерно том же порядке. Цена и остаток у большинства карточек не изменились, а шард считает релевантность каждой заново, от начала до конца. Получается, что одна и та же работа выполняется тысячи раз подряд.
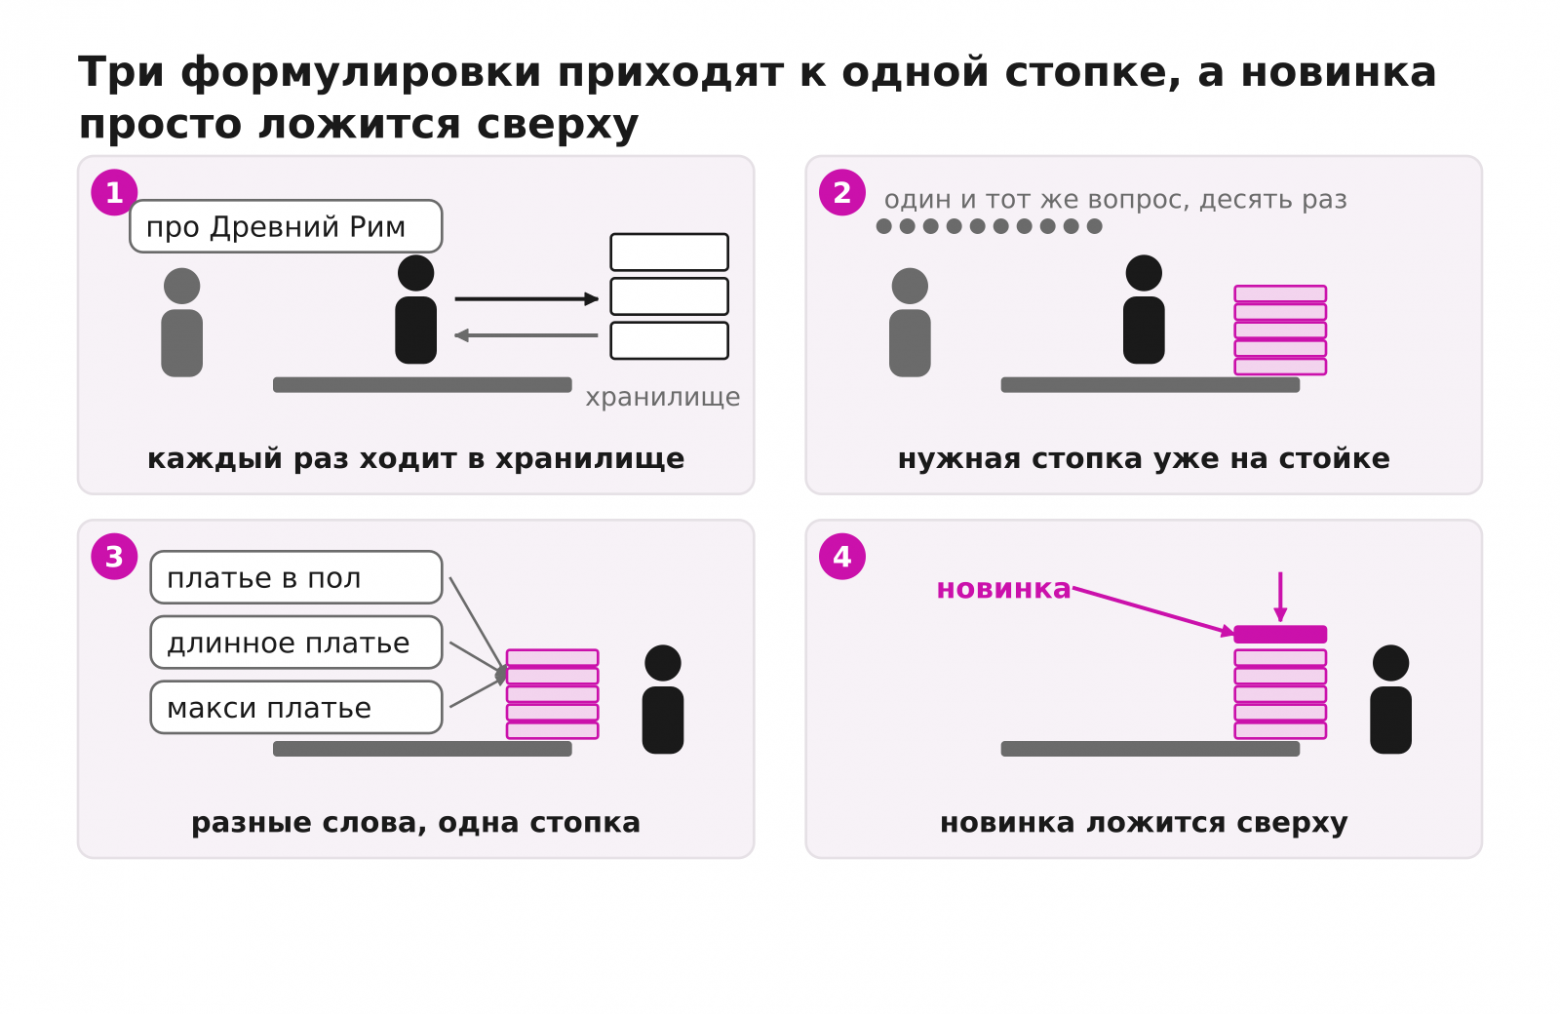
Часть этой работы от момента запроса не зависит. Какие карточки подходят под интент, можно посчитать один раз и держать готовым. В момент запроса остаётся учесть то, что меняется у конкретного человека и прямо сейчас. Вопрос меняется: вместо «как быстрее опросить нужные машины» мы спрашиваем «что из этой работы можно снять с момента запроса и сделать заранее».
Какова природа этих стопок?
Прежде чем идти дальше, посмотрим на запросы: сколько их бывает и как они себя ведут. От этого зависит, сколько готовых наборов придётся держать, а значит, сработает ли вся идея.
Если собирать набор под каждую карточку, мы упрёмся в те же миллиарды. Но собирается он под интент, а желаний у людей гораздо меньше, чем способов их записать. Текстов запроса не счесть: опечатки, порядок слов, лишние пробелы. Интентов за этими текстами несопоставимо меньше, и они складываются в довольно стабильный корпус.
У маркетплейса он может быть большим: при миллиардах карточек и широчайшем ассортименте подготовленных подборок у нас около шести миллионов. Это значение почти не меняется со временем, а ассортимент растёт в разы.
Наборов на два порядка меньше, чем карточек.
Я помню ещё своё изумление, когда впервые взял базу поисковых запросов и попробовал «сжать» до однородных сущностей: сжатие было колоссальным.
От общего поисковика нас отличает смысловое пространство. На маркетплейсе ищут товары и услуги, а общий поисковик ищет ещё и документы, и статьи, и информацию, поэтому у него пространство шире. Новые строки запросов появляются постоянно: у Google около 15% запросов за сутки новые. Но у нас эти строки сильно ужимаются в смыслы: «платье женское» и «женское платье» для нас один запрос, а для общего поисковика это могут быть два разных. Поэтому мы считаем не строки, а интенты.
Теперь представим, что каталог удвоился. Новые платья попадут в уже существующие интенты: «платье в пол», «макси платье», «вечернее платье».
Желание купить платье в пол не рождается заново вместе с каждой карточкой.
Новый интент появляется, когда появляется новая потребность: новая модель телефона, новый тренд. Такие интенты прибавляются понемногу. Пока классификатор не научился их узнавать, запросы идут через гибрид и онлайн, о них ниже.
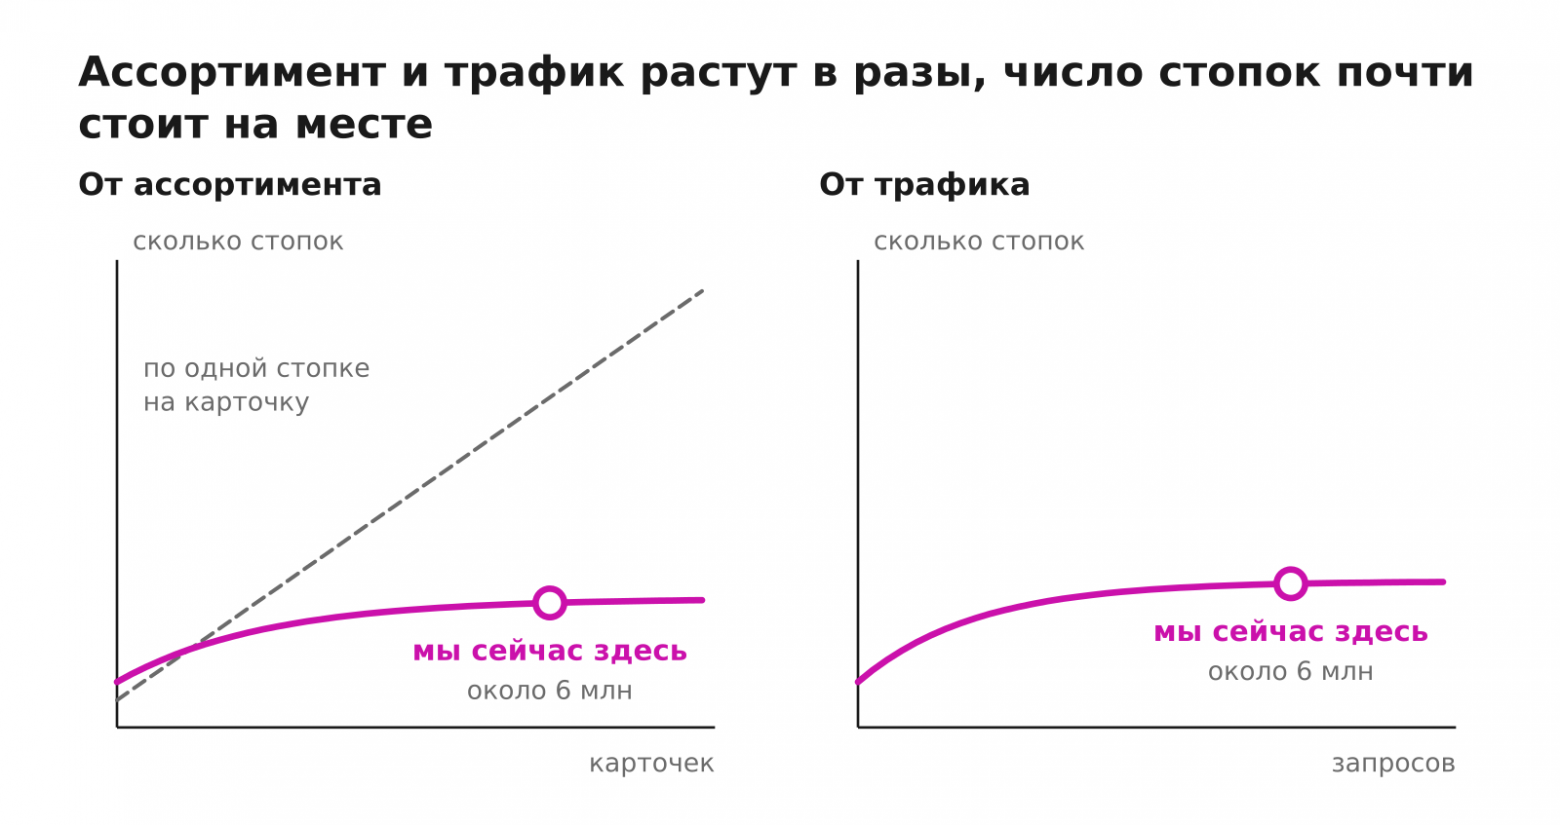
Корпус интентов стабилен, а каталог растёт, поэтому работу по интентам можно сделать один раз и надолго. На этом наблюдении держится всё дальнейшее.
А если довести идею до предела?
До сих пор мы думали о том, как поделить товары между машинами. Попробуем перевернуть подход и довести идею до предела, и сразу изменятся три вещи.
Первое: инвертируется раскладка. Раньше мы делили товары на части, и каждый товар лежал в одной части. Теперь мы собираем стопки под интенты, поэтому один и тот же товар может лежать в нескольких стопках сразу. «Платье в пол» и «макси платье» делят одну стопку, а то же платье может лежать ещё и в стопке «вечернее платье». На одном шарде таких стопок много, и родственные лежат рядом: платья к платьям, чтобы товары ложились плотно. Другая одежда или другой тип платья могут лежать на другом шарде.
Второе: появляются вычисления. Чтобы товар попал в нужный набор, надо посчитать, куда его класть. Эти вычисления идут до запроса клиента, не на самом шарде, а во внешней системе, и лимит времени для ответа клиенту не съедают.
Третье: в офлайн уезжает не только раскладка. Многие расчёты, которые раньше делались онлайн, можно вынести в офлайн. Мы перестаём делать одно и то же повторно на каждом запросе, а это особенно важно, когда трафик большой: чем больше запросов, тем больше одинаковой работы удаётся сэкономить.
Офлайновая работа не ограничена по времени, поэтому её можно доверить умным алгоритмам и тяжёлым моделям, которые в онлайне просто не поместились бы в лимит. Так разговор о том, как поделить товары, перешёл в разговор о ранжировании: раз мы всё равно считаем заранее, можно считать лучше.
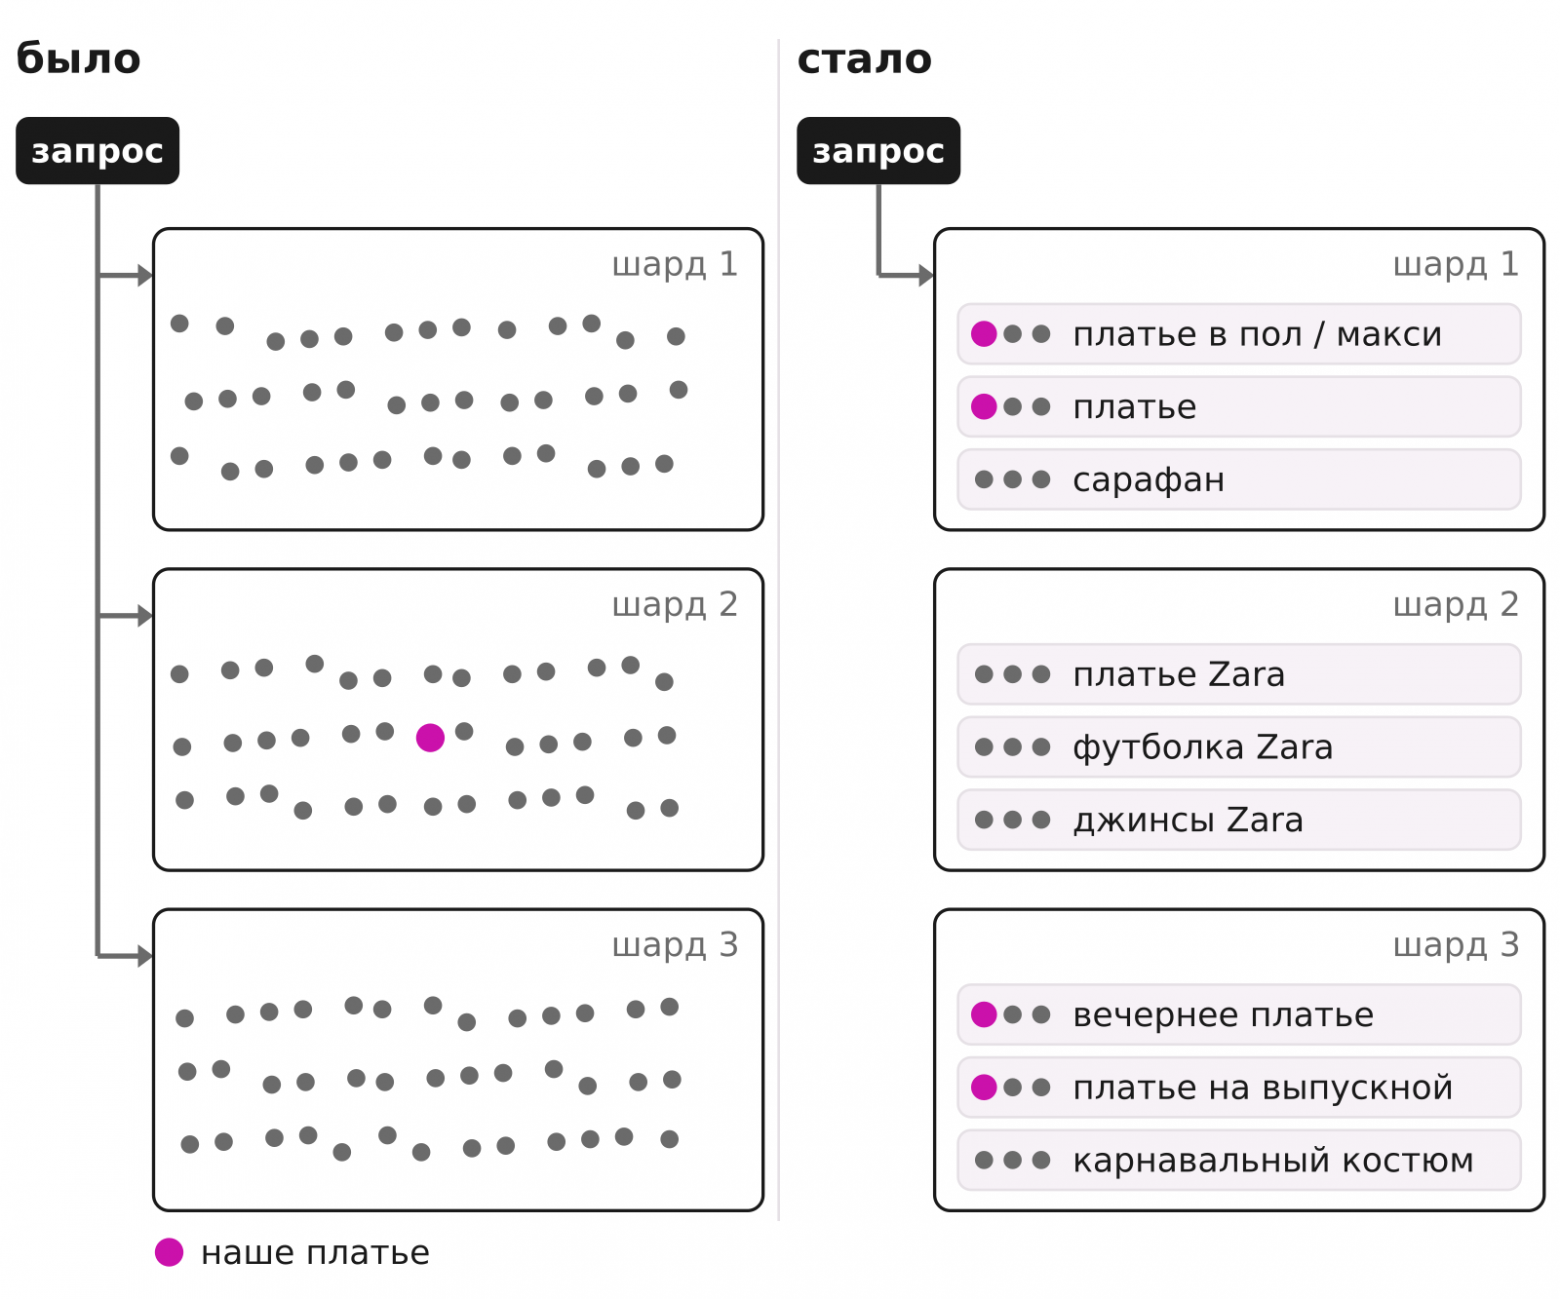
Для большей части запросов можно заранее собрать весь список кандидатов и там же определить, насколько каждый товар подходит под запрос. Окончательно этот список не отсортирован: порядок выстраивается позже, под конкретного покупателя.
Определить, насколько товар подходит под запрос, как раз непросто. Качество контента у нас бывает очень разным: мы даём трибуну всем селлерам и не выбираем один лучший товар, хотя умеем и так. Раз в такой модели лучший товар никто не назначает, релевантность приходится оценивать. Здесь офлайн развязывает руки: на оценку можно потратить больше времени и больше информации, включая тяжёлые модели, которым в онлайне не хватило бы лимита.
Готовый набор лежит в памяти, и в момент запроса остаётся понять интент и попасть на ту машину, где он живёт.
Это не то же самое, что кеш. Кеш запоминает ответ, который уже кто-то спросил, а набор строится заранее, не дожидаясь, пока запрос повторится. Его не торопит лимит клиента, поэтому считать можно дорого.
Все формулировки одного интента делят один набор, поэтому покрыта и редкая формулировка частого интента. Даже если конкретную фразу до этого никто не набирал, её интент уже известен, а набор для него готов.
Сейчас на нашем трафике около 95% запросов обслуживаются из заранее собранных наборов. Примерно двум третям из них набор отдаётся почти как есть, остальным нужен допоиск внутри набора в момент запроса. На онлайн по всем шардам идёт 5%. Для готовых наборов сетевого веера нет: запрос попадает на одну машину.
Эти 5% по-прежнему обрабатывает классический поиск, с веером. У них есть своё приятное свойство: в редком запросе и товаров в выдаче мало, поэтому беды, о которых шла речь выше, тут не так критичны.
Система не ходит за остатками и ценами в сторонние сервисы и на диск, а для тех самых 95% запросов нет и похода за кандидатами по сети. Выдача при этом остаётся живой: порядок внутри набора выстраивается под покупателя, а цены и остатки в памяти узла всегда актуальные. Поэтому персонализация, сломавшая кеширование целого ответа, здесь работает: от покупателя не зависящее мы собрали заранее, а зависящее учитываем в момент запроса.
Наборы живут в памяти, и это наш выбор. Данные нужны близко к точке вычислений: цены и рекламные ставки меняются постоянно, персонализации нужно из чего выбирать, и выбирать есть из чего только тогда, когда набор большой. Поэтому подборки бывают крупными, в десятки и сотни тысяч товаров.
Данные здесь горячие и нужны сразу и ранжированию, и клиенту: цены, остатки, признаки товара. Они быстро обновляются и прилетают в ту же память по быстрой шине данных, так что во время запроса за ними не надо ходить ни на диск, ни в сторонние сервисы.
Что остаётся делать после Enter?
Вернёмся к нашему «платью в пол». Набор для него лежит в памяти одного узла, и дорога запросу короткая: понять интент, попасть на нужную машину и упорядочить набор под покупателя.
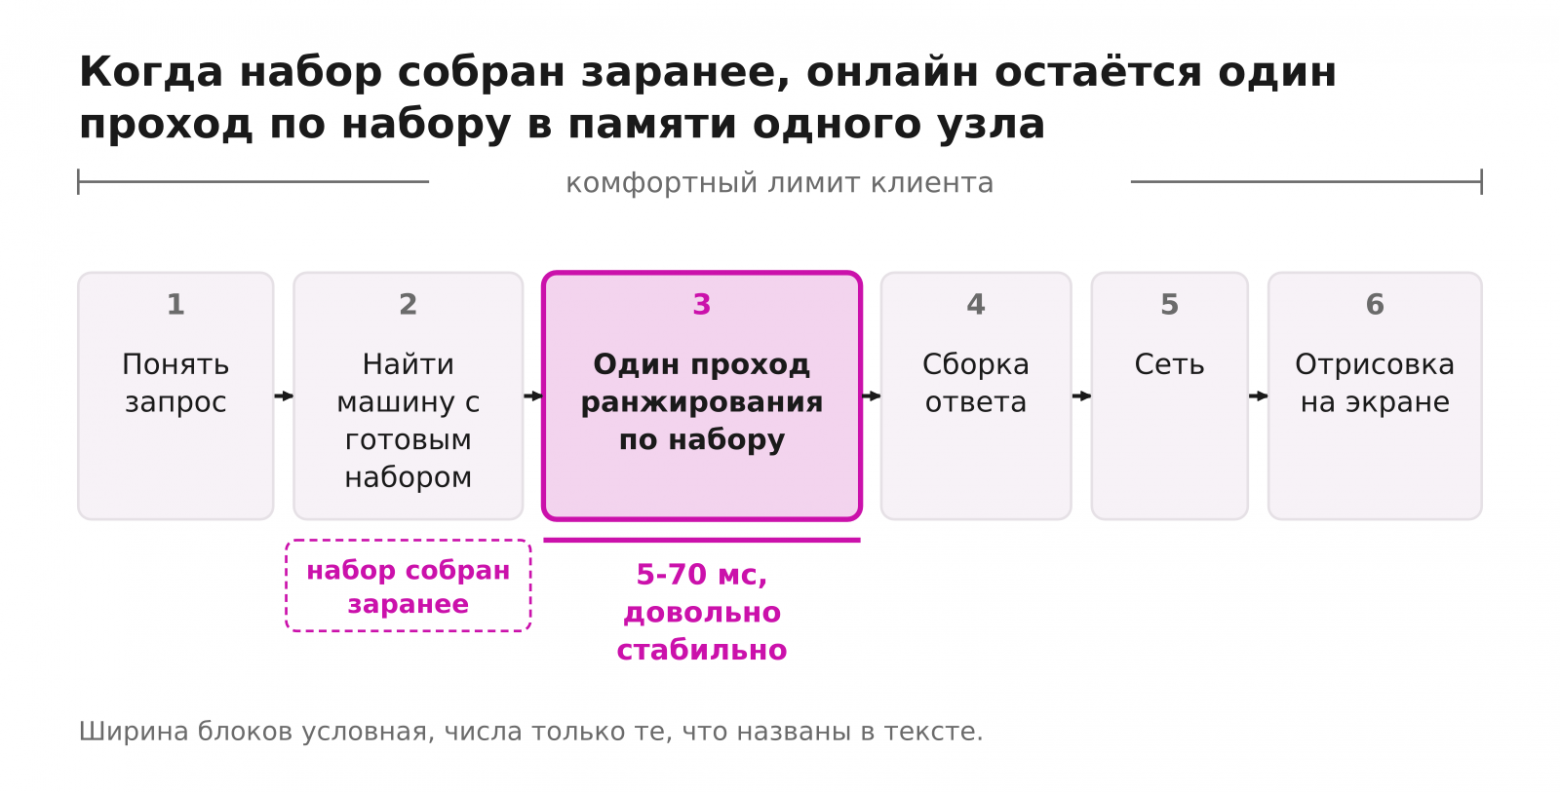
Порядок выставляет модель градиентного бустинга CatBoost (она собирает множество небольших деревьев решений в одну модель): за один проход она оценивает каждую карточку набора. Это занимает 5-70 миллисекунд. Время определяется размером набора, а не каталога: набор целиком лежит в памяти одного узла, а его размер упирается в эту память, поэтому рост каталога сам по себе проход не удлиняет. Остальное время запроса уходит на понимание запроса, сборку ответа, сеть и отрисовку.
Тяжёлые признаки лежат рядом с набором, собирать их по сети не нужно. Цены, остатки и сигналы покупателя в узле есть всегда, они обновляются асинхронно, потоком изменений. Это правило из лесенки: считаем там, где лежат данные, и несём данные туда, где считаем.
В многоэтапном отборе каждый запрос по очереди оплачивает каждый этап. Здесь счёт за эти этапы оплачен заранее, до прихода запроса.
Так у нас появились три ручки, которыми можно управлять системой. Первая — размер набора: потолок задаёт память узла, который отдаёт набор целиком. Вторая — число наборов: потолок задаёт число интентов. Третья — куда отправить запрос: потолок задаёт точность классификатора, который выбирает нужный набор.
Расположим запросы по частоте, от самых частых к самым редким. Как в магазине: хлеб и молоко лежат у входа, редкий товар выносят со склада по требованию. Самые частые запросы живут в предрасчёте целиком, трафика хватает, чтобы набор многократно окупился.
Дальше идёт гибрид. Библиотекарь собрал стопку на всю тему целиком, а под конкретного читателя доотбирает из неё на месте. На самом редком краю остаётся полный онлайн-поиск: под редкий запрос готовый набор собирать нет смысла.
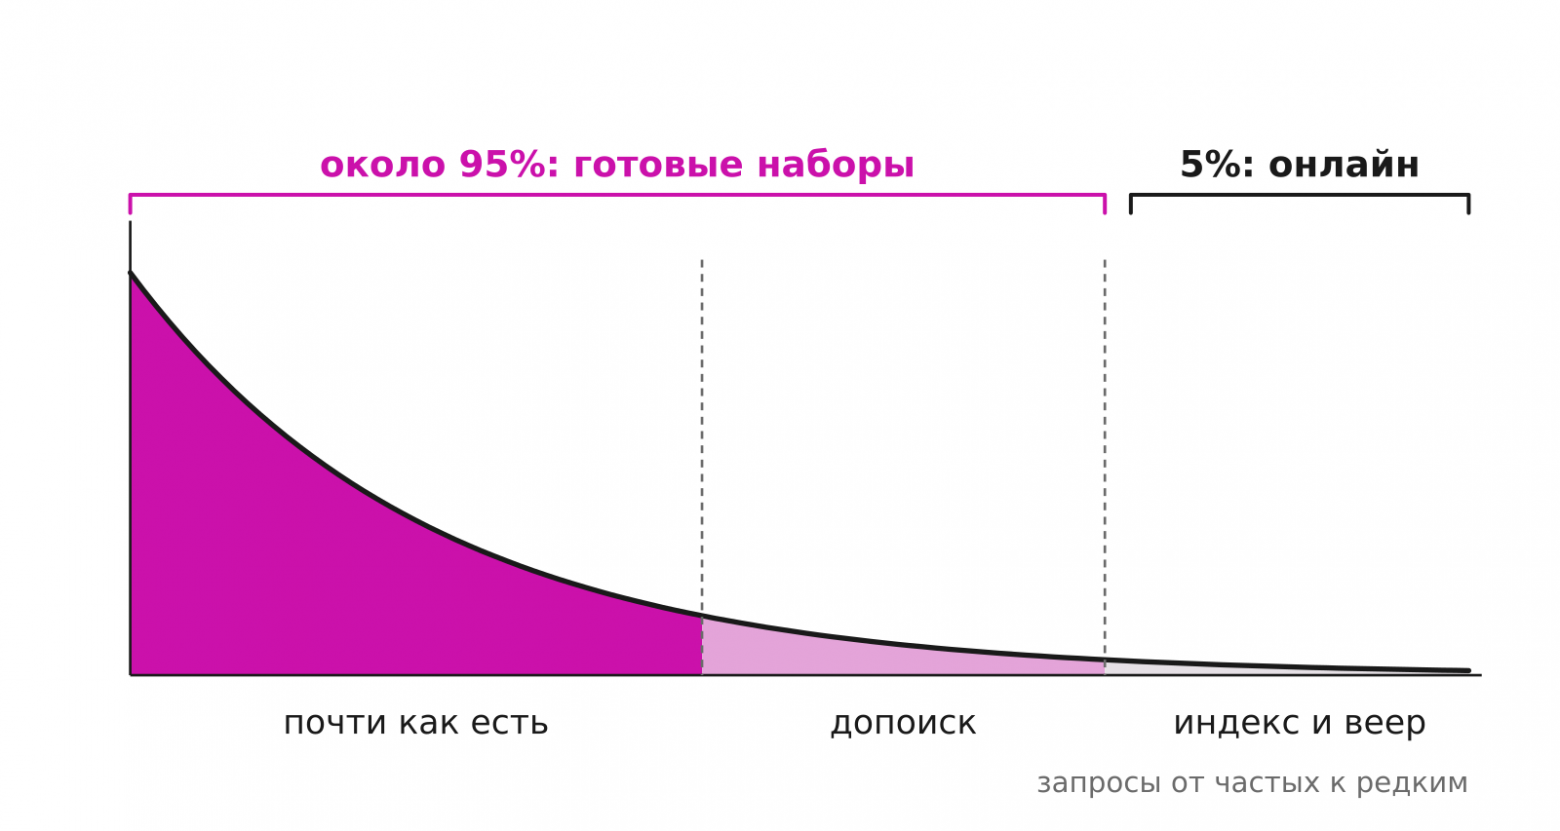
Два понятия легко спутать. Полный онлайн-поиск устроен как в начале статьи: индекс по машинам, веер, ответ из того, что успели вернуть шарды. Сюда идут только запросы без готового набора.
Досчёт при запросе устроен иначе: короткий список расчётов поверх уже готовой подборки: сначала отбор из неё по словам запроса, потом точная цена, остаток на конкретном складе и живая ставка продвижения. По объёму это несравнимо с поиском по каталогу, и в лимит времени оно укладывается, даже когда трафик резко подскакивает.
Хвост запросов, который идёт в онлайн, мы прямо сейчас доводим: с текущим ассортиментом там остаётся довольно лакомый кусок качества ранжирования. Кроме того, у нас есть степень свободы: какую часть запросов обрабатывать готовыми наборами, какую гибридом, а какую онлайн. По сути мы меняем память на CPU и сеть, но только тогда, когда это улучшает качество онлайн-поиска. В такой архитектуре мы сами управляем балансом.
Чем мы за это платим?
Разработкой. Мы развиваем два поиска одновременно: офлайновый, который собирает наборы, и онлайновый, который отвечает на запросы без готового набора. Это две разные системы со своими моделями, своими метриками и своими ошибками, и каждой нужна своя команда.
Поддержкой. Пересчёт наборов, хранение их в памяти, быстрый откат неудачного набора требуют отдельной инженерной работы. Готового решения под такую схему нет, мы написали всё сами и собрали под это команду классных специалистов.
Пока каталог небольшой, эта цена не окупается, и классический поиск проще.
Что это дало
Горизонтально масштабируемая система. Чтобы понять, чем это хорошо, вспомним классику. Там индекс разрезан на части по разным машинам, и каждый запрос обязан спросить каждую часть. Каталог вырос, мы добавили машину, и теперь каждый запрос ждёт ещё и её. Получается, что рост каталога удорожает вообще все запросы.
У нас иначе. Запрос идёт к готовому набору, а набор целиком лежит на одной машине. Каталог вырос? Наборы стали крупнее или их стало больше, мы разложили их по новым машинам, а запросы к старым этого даже не заметили. Трафик вырос? Поставили больше копий тех же узлов. И в том и в другом случае цена одного запроса остаётся прежней: она зависит от размера набора, а набор по построению помещается в память одной машины.
Эффективная актуализация данных. Свежесть у нас определяется потоком изменений данных, а не потоком запросов. Мы обновляем данные по мере их изменения, поэтому «заранее посчитанное» не значит «несвежее». Цены и остатки в памяти узла всегда актуальны. Новый товар попадает в подборку сразу, как только алгоритм его обработал: ждать полной переиндексации и подмены индекса не нужно.
В классическом поиске всё иначе: переиндексация идёт по расписанию, раз в несколько дней или несколько раз в сутки. А у нас новый продавец и новый тренд попадают в выдачу отдельным быстрым путём. Полный пересчёт подборок раз в сутки остаётся: он подчищает неточности и учитывает связи внутри подборки.
Свобода в офлайн-ранжировании. С ростом ассортимента качество контента в среднем падает, и разобраться в нём алгоритмам всё труднее. Онлайн-поиску для этого нужны всё более тяжёлые модели, а лимит клиента остаётся прежним. Офлайну лимит клиента не мешает, поэтому мы выбираем стек и модели под качество, а не под миллисекунды, и улучшаем ранжирование, не решая заодно задачу скорости.
Хвосту запросов, который уходит в онлайн, этой свободы не хватает, поэтому его мы и доводим отдельно.
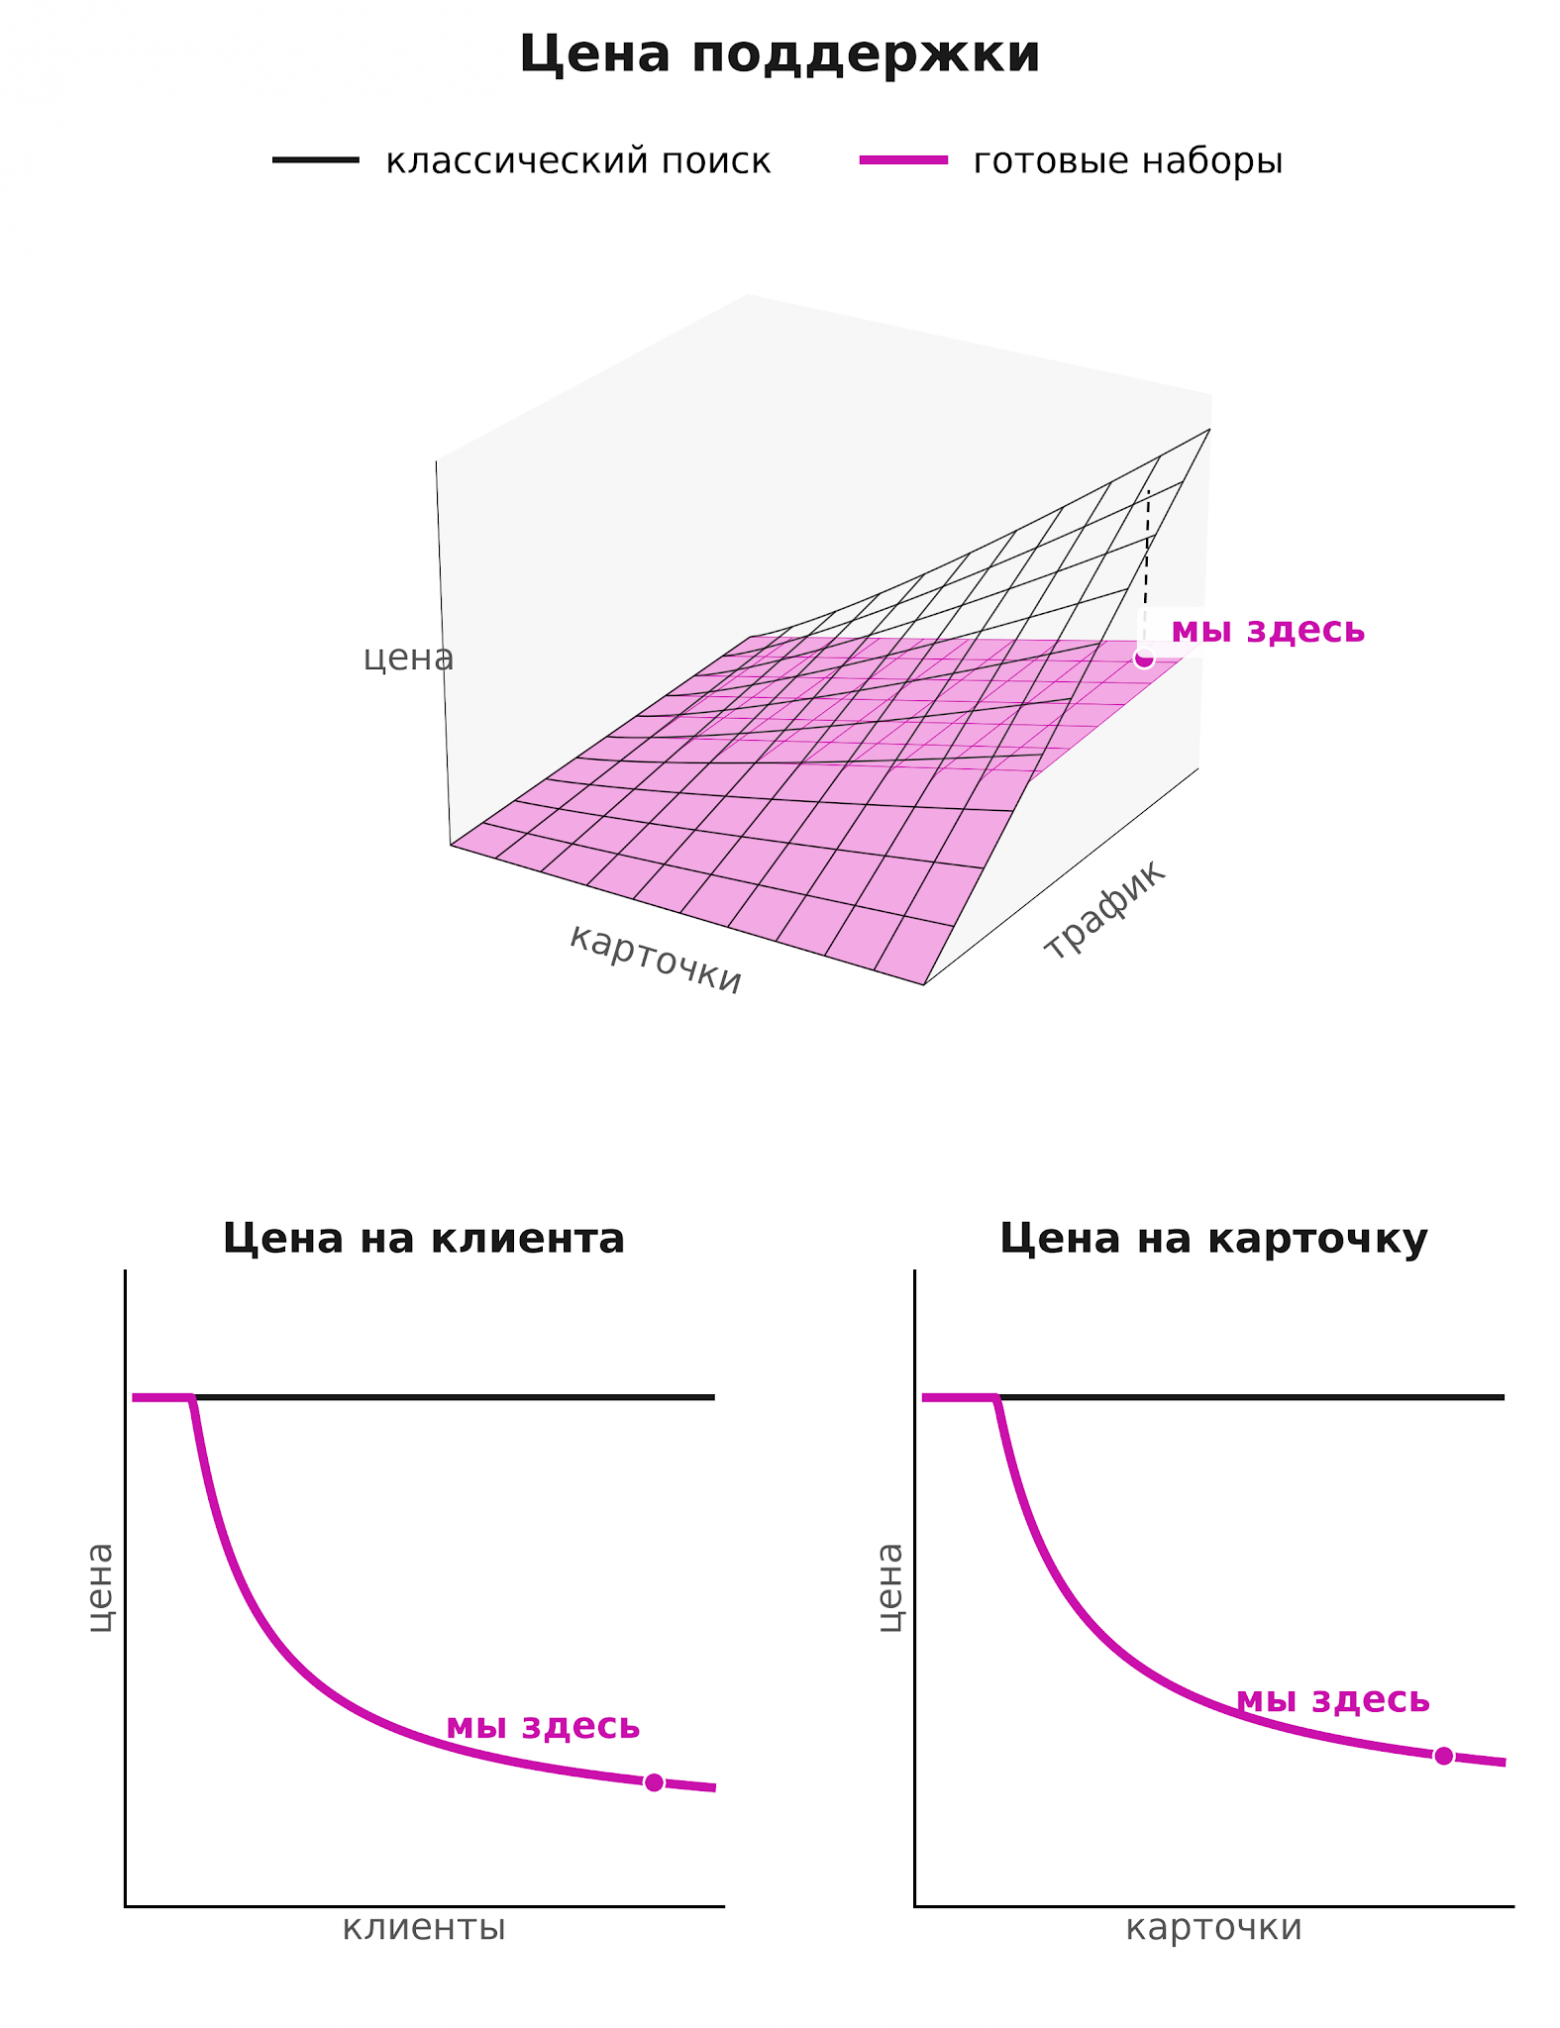
Чем больше масштаб, тем дешевле. Классический поиск каждого читателя отправляет бегать по всем томам, и каждый запрос оплачивает весь веер. Предрасчёт платит иначе. Стоимость сборки пропорциональна числу наборов, умноженному на размер набора, и от числа читателей не зависит: книги раскладываются по стопкам по мере появления, а раз в сутки идёт полная реинвентаризация. Сам запрос стоит один проход ранжирования по набору.
Пока трафика и товаров мало, разницы нет: наборы можно просто выключить и работать тем же классическим поиском, по той же цене. Дальше пути расходятся.
С ростом трафика фиксированный счёт за сборку делится на всё больше клиентов, и цена на клиента падает. У классики она не падает, потому что каждый новый клиент приносит запросы с полным веером. С ростом каталога у классики дорожает каждый запрос, ведь шардов в веере становится больше, а у готового набора цена запроса остаётся прежней. Мы сейчас далеко правее точки, где пути расходятся, и по трафику, и по каталогу.
Каждая мысль по отдельности очевидна: делить индекс по машинам, кешировать повторы, класть похожие товары рядом, считать заранее. Неочевидной оказалась арифметика на стороне запросов. Карточек в каталоге миллиарды, а общих интентов порядка миллионов: наборов на два порядка меньше, и разница измеряется сотнями раз. Каталог и трафик будут расти и дальше, а новые интенты прибавляются медленнее. Пока разрыв остаётся таким, почти всю работу над ответом можно сделать до того, как покупатель начнёт печатать.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.