Что может быть не так с VMware, даже если все работает
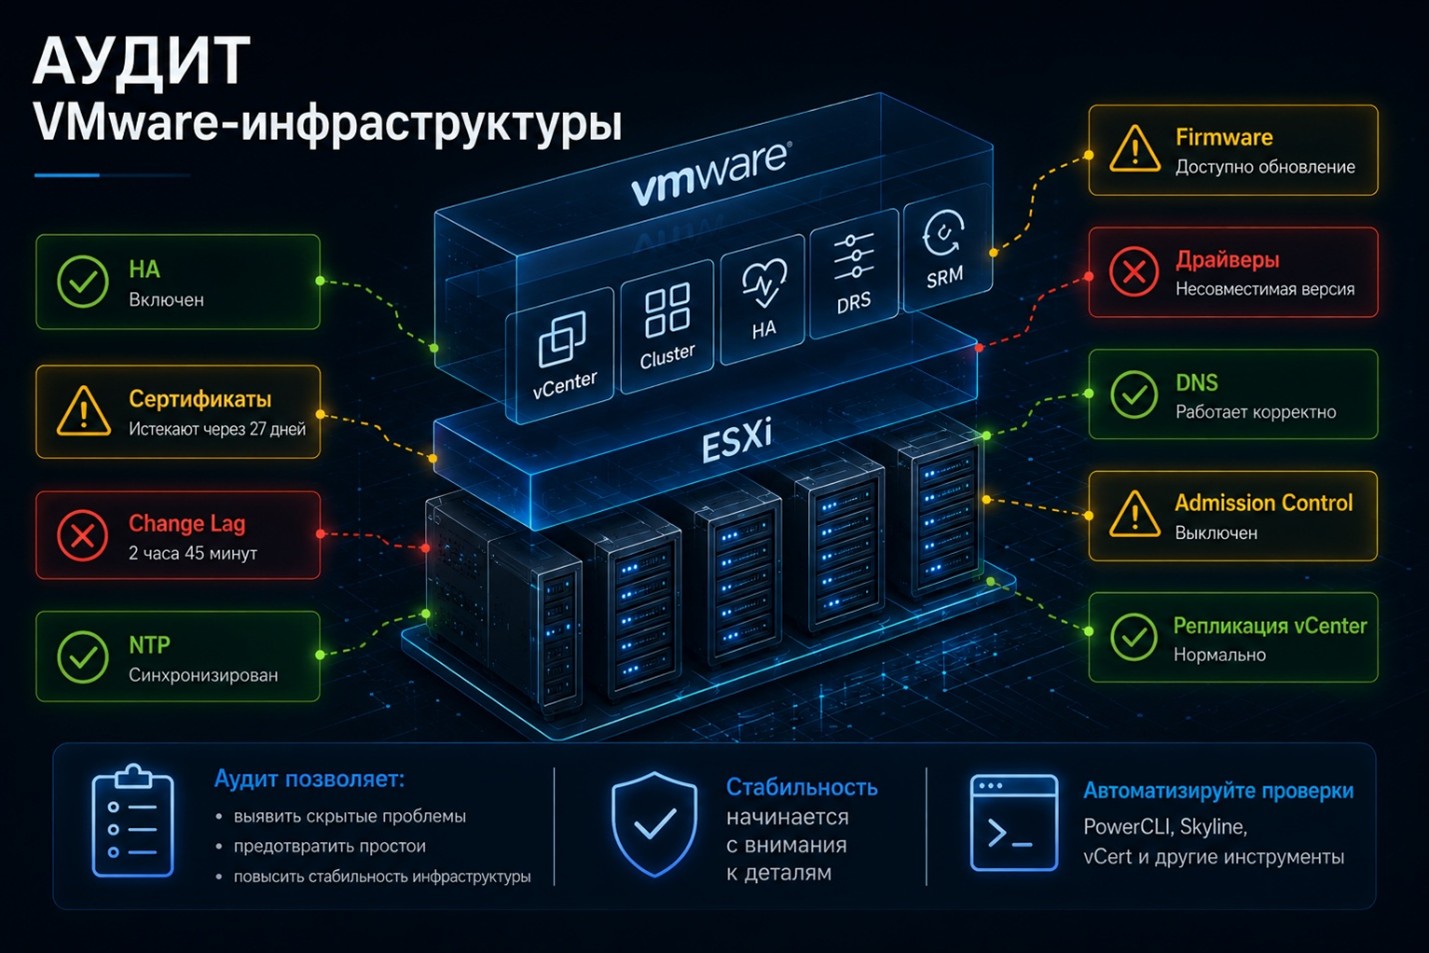
Сегодня с решениями VMware многие придерживаются принципа «работает - не трогай». Рабочий подход, но только не для критичной инфраструктуры. Потому что риски могут накапливаться сами по себе: истекают сертификаты, заполняются файловые системы, нарушается синхронизация времени. Добавьте к этому обычный человеческий фактор:
• временно отключили HA и забыли включить обратно;
• изменили настройки кластера и не задокументировали это;
• устранили аварию, но не вернули систему в исходное состояние.
По отдельности такие изменения редко приводят к серьезным последствиям. Но именно их сочетание становится причиной сбоев или даже полной остановки инфраструктуры. За годы эксплуатации (30+лет в сервисе ИТ) мы убедились: большинство серьезных аварий не возникают внезапно. Им почти всегда предшествуют небольшие отклонения, которые месяцами остаются незамеченными. Количество по-прежнему переходит в качество (с).
Мы бы звучали очень самоуверенно, если бы предложили универсальный стандарт аудита. Но чек-лист, который позволяет обнаружить большинство отклонений задолго до того, как они превратятся в реальную проблему, за годы работы с крупными и сложными заказчиками, у нас появился.
Пользуйтесь!
Итак ключевая мысль: Аудит – это не проверка ради проверки, а поиск ранних признаков будущих проблем (с) отчасти авторство принадлежит Конфуцию.
Level 1 — железо
Для наглядности давайте представим нашу инфраструктуры как многоуровневую схему:
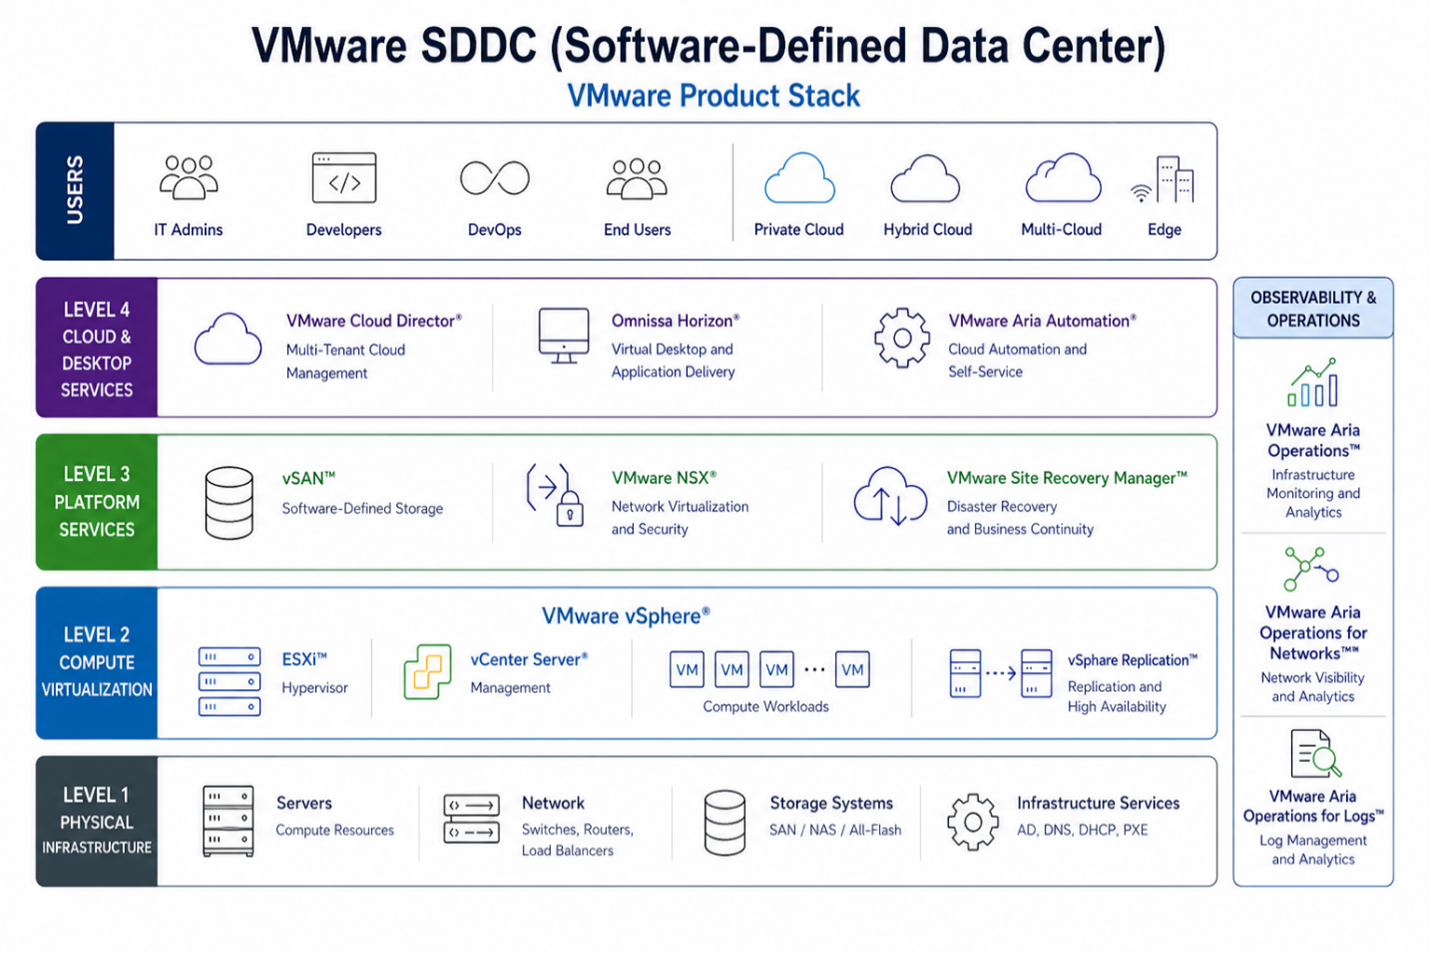
Мы всегда начинаем с проверки совместимости оборудования с версией VMware: мы должны понять, можем ли ожидать хоть какой-то стабильности от платформы, которая построена из неподдерживаемого оборудования. Нелишним будет убедиться в наличии мониторинга, который оповестит, если оборудование вышло из строя.
Еще один важный момент в контексте железа — обновление его микрокодов. Убедитесь в совместимости компонент ПО с аппаратной частью — процессы обновления программных и аппаратных компонент нередко существуют отдельно друг от друга. А мы знаем: все сбои тут непременно приведут к проблемам на более высоких уровнях.
Level 2 – базовая виртуализация
Поднимаемся на уровень выше:
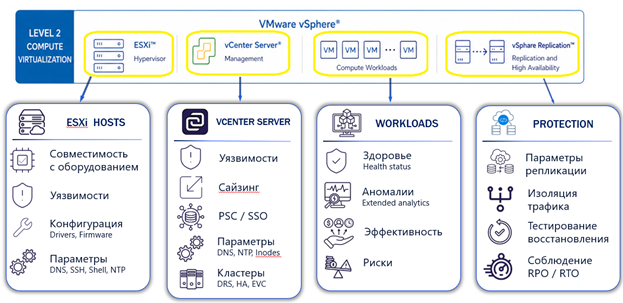
Начнем с ESXi-хостов:
Проверяем совместимость версии VMware и используемого оборудования на этом уровне.
Смотрим на наличие уязвимостей в используемой версии. В этом нам помогут материалы вендора.
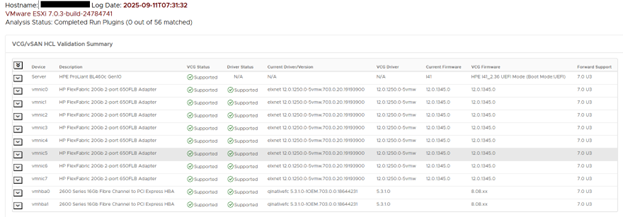
Теперь проверяем совместимости драйверов и прошивок на ESXi хостах — это одна из наиболее важных и одновременно трудоемких процедур*. Мы используем для этого PowerCLI, но есть множество других способов для проверок. Запоминаем — сначала фиксируем недочет, а уже после аудита беремся за исправления. Теперь возвращаемся к проверке. В этот момент определяем одно из следующих состояний для каждого из хостов — для ориентира:
Версии драйверов и прошивок для каждого из PCI-устройств актуальны и соответствуют последним рекомендованным матрицей совместимости — идеальный вариант.
Версии драйверов и прошивок совместимы между собой, но есть более актуальные версии — приемлемый сценарий, если в работе устройств не наблюдается ошибок или в Release Notes нет явных рекомендаций по обновлению.
Версии драйверов и прошивок несовместимы — требуется обновление драйвера или прошивки (или обоих компонент) для приведения конфигурации к совместимому сочетанию.
PCI-устройство отсутствует в матрице совместимости — не рекомендуется держать продуктивные нагрузки на хостах, которые попали в эту категорию, так как нет гарантий, что используемое оборудование будет работать стабильно.
* Кейс: в контексте ESXi мы писали об инциденте в VMware NSX-T, где при использовании Bridge между Overlay-сегментом (GENEVE) и физической сетью периодически пропадала связность между виртуальными машинами. В ходе диагностики выяснилось, что проблема проявлялась из-за некорректного формирования записей в Host Kernel Entry, из-за чего трафик начинал отправляться через Edge Transport Node вместо прямой передачи по GENEVE. После анализа дампов и сравнения поведения разных хостов мы обнаружили, что первопричиной оказался не NSX и не сетевое оборудование, а ошибка в драйвере сетевой карты ESXi, исправленная в более новой версии драйвера.
4. Параметры сервисов на ESXi-хостах. SSH и Shell рекомендуется держать в выключенном состоянии и иметь настроенные таймеры отключения из соображений безопасности. DNS и NTP рассматриваем как ключевые с точки зрения стабильности работы системы.
Теперь идем к vCenter Server:
Так как VC — элемент управления инфраструктурой, в первую очередь смотрим на наличие уязвимостей в используемой версии. VC не так сильно привязан к аппаратным составляющим, а значит уязвимости можно устранить без особых проблем.
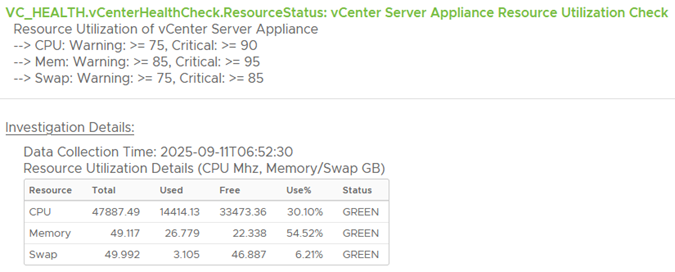
Корректность сайзинга. Нередко бывают сценарии, когда VC был развернут в конфигурации Small или Medium, но со временем хостов или ВМ стало больше, чем предполагает выбранный изначально форм-фактор. Соответственно, нагрузка на БД возрастает, диск переполняется, сервисы начинают падать. На этом шаге проверяем количество выделенных ресурсов, метрики по утилизации ресурсов со стороны VC, уровни логирования и сбора статистики и достаточность свободного пространства на партициях VC. Наши метрики:
утилизация CPU: Warning > 75%, Critical > 90%
утилизация RAM: Warning > 85%, Critical > 95%
использование SWAP: Warning > 75%, Critical > 85%
Если какой-то из показателей превышает даже первый трешхолд, это обязательно скажется на работе VC в период интенсивной нагрузки.
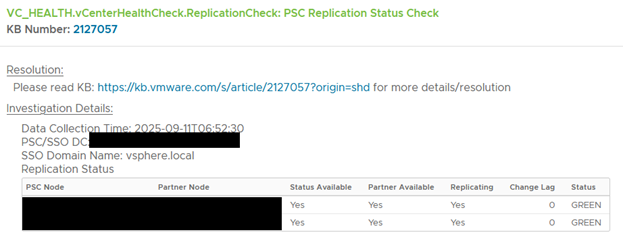
3. Проверяем функционал PSС на VC. Сюда входит проверка всех сертификатов (VECS, STS, LDAPs и других). Сертификаты стоит помечать как требующие замены, если срок их валидности менее 90 дней. Проверка Lookup Service в отношении дублируемых Endpoint или некорректных параметров SSL Trust Anchor поможет убедиться, что проблемы взаимодействия сервисов отсутствуют. Состояние БД VMDIR и статус репликации всегда должны показывать результаты:
VMdir State: Normal (3).
Partner Change Lag: 0.
Если эти метрики отличаются от указанных, проблемы уже начались.
Кейс. У заказчиков мы неоднократно сталкивались с проблемами репликации между узлами vCenter в Enhanced Linked Mode. Постоянно растущий параметр Change Lag указывал на отставание одной из реплик VMDIR, из-за чего изменения в SSO-домене распространялись не полностью: на отдельных vCenter могли оставаться старые пароли, отсутствовали сведения о новых узлах или возникали проблемы с запуском сервисов после перехода базы в режим Read-only. Такие симптомы долгое время могут оставаться незаметными, поэтому контроль Change Lag во время регулярного аудита позволяет выявить проблему до того, как она приведет к отказу сервисов или нарушениям работы ELM.
4. Обязательно проверяйте настройки NTP и корректность работы DNS. Напомним, записи VC должны быть созданы как в зоне прямого, так и в зоне обратного просмотра на DNS-сервере.
5. Оцените параметры кластера. На этом этапе стоит убедиться, что включены и корректно настроены основные механизмы обеспечения отказоустойчивости и балансировки нагрузки. В первую очередь это DRS, который автоматически распределяет виртуальные машины между хостами, обеспечивая достаточность вычислительных ресурсов.
! Если в кластере используется HA (что настоятельно рекомендуется для продуктивных нагрузок), проверьте, включен ли Admission Control. Именно этот механизм резервирует необходимые ресурсы и гарантирует возможность автоматического перезапуска виртуальных машин при отказе одного или нескольких хостов.
!! Если кластер построен на оборудовании разных поколений или с различными моделями процессоров, убедитесь, что настроен EVC. Без него миграция виртуальных машин между хостами может работать некорректно или оказаться недоступной, что существенно снижает эффективность DRS.Также практика показывает, что на стабильность работы положительно влияет однородность кластера. Использование одинаковых моделей серверов, идентичных версий ESXi, драйверов, микрокодов и прошивок снижает вероятность труднодиагностируемых проблем и упрощает поддержку.
Дополнительно можно оценить Health Status самих виртуальных машин. Но для более удобного сбора и анализа этой информации может потребоваться дополнительное ПО, например, Aria Operations (aka vRealize Operations Manager).
!!!Если в инфраструктуре используются дополнительные средства отказоустойчивости, такие как vSphere Replication или VMware SRM, то обратите внимание и зафиксируйте для себя следующие моменты:
Статусы репликации ВМ. Не возникают ли в какие-то моменты ошибки по репликациям.
На стороне vSphere крайне рекомендуется изолировать трафик репликации от других типов трафика.
Проходит ли штатно восстановление на recovery-сайте? Корректно ли там заведены все ресурсы для восстановления продуктивных нагрузок (например, сети)?
Укладывается ли фактическое время восстановления в требуемые показатели RPO и RTO?
Инструментарий аудитора
Начнем с PowerCLI-скриптов, которые мы упоминали выше. С их помощью мы получаем огромное количество информации по объектам инфраструктуры и можем структурировать ее в удобном формате.
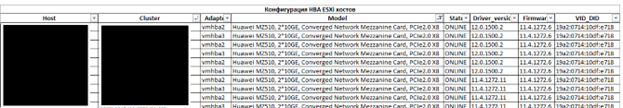
Skyline Health Diagnostics — умеет опрашивать vSphere и vSAN, анализировать данные, выдавать отчеты по состоянию хостов и VC. Правда, такие вещи как совместимость драйверов и прошивок мы рекомендуем перепроверить.
Для наглядности приводим еще один скриншот, чтобы было понятнее, о чем последние метрики (Change Lag):
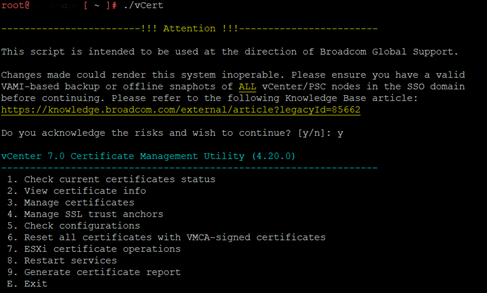
CLI-утилиты, которые предоставляет вендор, — VDT (VCF Diagnostic Tool), vCert, LSDoctor и прочие.
Послесловие
На этом технический аудит завершен, но сама работа не заканчивается.
Задача аудита – не просто проверить настройки, а вовремя обнаружить признаки деградации инфраструктуры.
Бонус – рекомендации из практики:
Не исправляйте проблемы по мере их обнаружения. Сначала зафиксируйте все находки, затем оцените их влияние, составьте план устранения и только после этого приступайте к изменениям. Иначе аудит легко превратится в бесконечную серию исправлений, а часть проблем так и останется незамеченной. Более того, изменения, внесенные в процессе проверки, могут сами повлиять на результаты оставшихся этапов аудита.
Аудит должен быть цикличным. Проводите его каждые 3–6 месяцев. Это позволит избежать ситуаций, при которых однажды утром вы увидите ошибку 503 вместо привычного интерфейса vSphere Client. И это не только наш опыт: регулярный аудит действительно позволяет заметно сократить количество нештатных ситуаций. Здесь нужна красивая цифра, подтверждающая пользу аудита, но, к сожалению, срабатывает «парадокс предотвращения» – если проблему удалось предотвратить, то ее как бы и не было и она не попадает в отчеты. Зрелые ИТ-команды ценят такую профилактику и спокойствие.
Кстати, вот здесь рассказали об аудите в другом формате. Поделитесь в комментариях, про аудит какого продукта стоит написать отдельно.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.