Gachinetes: 300 хундрет бакс, честная борьба за ресурсы и Билли в сердце (никакой пошлятины, только полезные фичи)
Ладно, это было неизбежно. Кстати, официальные конформанс‑тесты от CNCF 462/462.
Правило было одно: каждое слово из мема должно закрывать настоящую дыру Kubernetes и работать на настоящем кластере. Борьба стала войной контроллеров за одно поле, safeword — мгновенным отзывом повышенных прав, а «Rest in peace» — удалением, которое можно отменить.
Получился Gachinetes. Это кластер, который помнит каждую версию каждого объекта и может перемотать сам себя к любой точке времени, как кассету. Рефери в нём видит, когда два контроллера по очереди перетирают одно поле, а целый неймспейс поднимается из мёртвых одной командой. Работающий под переезжает на другую ноду, не теряя ни одного числа в памяти. По ходу дела выяснилось, что живая миграция в Kubernetes упирается совсем не туда, куда все смотрят, а скромный автоскейлер нашёл в основе дистрибутива ошибку, из‑за которой у кластера тихо не работало вытеснение подов.
Сначала о меме, чтобы не было недоразумений. Гачимучи вырос из американских борцовских роликов конца девяностых, которые японские, а потом русскоязычные зрители превратили в бесконечный ремикс: «Boss of this gym», «Three hundred bucks», «Deep dark fantasies», «Fuck you», «Sorry for what?». Главный его герой, Билли Херрингтон, знал о своей интернет‑славе и относился к ней с юмором.
Исходники лежат в github.com/tym83/gachinetes под лицензией Apache 2.0.
Что умеет Gachinetes ♂
Мем | В меме | В Gachinetes |
|---|---|---|
Борьба в раздевалке | Любой спор решается борьбой, кто победил — тот и прав | Рефери ловит контроллеры, которые по очереди перетирают одно поле (Argo CD против HPA за |
Пояс чемпиона | Титул держит один, пока его не отберут |
|
Boss of this gym | Победитель главный в зале |
|
Rest in peace | Мем живёт после смерти героя | Удалённое не умирает: кладбище, история каждого объекта и |
Кассета VHS | Ролики девяностых, заезженные до дыр | Кластер перематывается как кассета: ◀◀ и ▶▶ по всей истории, призраки удалённого, «что было в 13:00» |
Oh shit, I'm sorry / Sorry for what? | Извинения посреди мордобоя |
|
Deep dark fantasies | Фантазии, которые не выносят на свет | Изменение проигрывается в тайной копии кластера с настоящими контроллерами и планировщиком; понравилось — |
Three hundred bucks | Всё по фиксированному тарифу | Прайс на ядро, память и GPU, бюджет неймспейса в деньгах; под, который пробьёт бюджет, не пустят |
Tag team | На ринг выходят напарники вместе | Группа подов встаёт целиком или никак: 60 GPU из 64 больше не простаивают в ожидании четырёх |
Весовые категории | Тяжёлые с лёгкими не дерутся | Супертяжёлый под держит ноду один, к нему никто не подсаживается |
Boy next door | Соседский парень | Под ставится на ноду к тем, с кем он разговаривает (собеседники в аннотации |
Протеин | Без него массу не набрать | Тёплые места под тяжёлые поды и заранее скачанные образы: GPU‑нагрузка стартует сразу |
Safeword | Стоп‑слово, после которого всё прекращается | Права выдаются контрактом на срок; |
Страхующий | Стоит рядом, когда берёшь опасный вес | Опасную роль или удаление неймспейса одобряет второй человек, и не тот, кто просит |
Dungeon Master | Подземелье Вана Даркхолма | Подозрительный под не убивают, а уводят в подземелье: без трафика и контроллера, целым для разбора |
Leather | Кожаная экипировка | Жёсткие умолчания: в неймспейсе с меткой поды не лезут к хосту |
Раздевалка | Шкафчики в зале | Секрет открыт только своим сервис‑аккаунтам |
Тренер | Прогрессивная нагрузка, рекорды, разгрузочная неделя | Запросы подов растут под нагрузкой и снижаются, когда вес не нужен, без перезапуска пода |
Спарринг | Тренировочный бой | Хаос по расписанию: убили под и засекли, за сколько сервис встал |
Аники | Старший брат, добрый наставник | При деплое один раз и по‑доброму говорит, что навредит нагрузке: |
Выездной матч | Бой на чужой площадке | Если дома места нет, поды играют в другом кластере и возвращаются, когда место появилось |
Get your ass back here | Ушёл — верните обратно | Живая миграция: под переезжает на другую ноду с памятью и считает дальше с того же числа |
Раунды | Бой идёт раундами | Долгая задача сохраняется по расписанию и после падения продолжает с последнего раунда, а не с нуля |
gachiBASS, gachiHYPER, gachiGASM | Эмоуты Twitch | Чат кластера: деградация, восстановление, успешный релиз |
Зачем это всё
Это очередной эксперимент из серии, в которой я проверяю, насколько Kubernetes пластичен. Я уже переносил его управляющий слой в Google Таблицы (Sheeternetes), делал татароязычный форк вместе с документацией и консолью (Tatarnetes), собирал дистрибутив на языке 1С, который проводит документы (Assnetes). Каждый раз меня интересовало одно и то же: где у Kubernetes жёсткое ядро, а где просто привычка, которую можно заменить чем угодно.
Я подумал, что если взять гачи‑ЛОР целиком и попробовать представить, что та или иная его часть делала бы в кластере, то можно было бы получить карту дыр, которые все видят и с которыми все смирились. Дальше оставалось эти дыры закрыть.
Работа делится на три слоя. Первый — язык: имена объектов, командная строка, события и интерфейс говорят терминами из гачи. Второй — надстройки: контроллеры, вебхуки и веб‑приложение, которые ставятся на любой кластер. Третий — ядро: хранилище, apiserver, планировщик и то, как нода запускает контейнеры. Ядро я менял не через форк Kubernetes, а с помощью дистрибутива kuberoot. В нём своё хранилище с API etcd, свой загрузчик ноды и свой набор служб, и Gachinetes собран как ещё один его вариант: тот же kuberoot, но со своим планировщиком, своими службами и своим ядром Linux.
Всё делалось на тестовом кластере в Cozystack на серверах Hetzner: управляющий слой целиком в одном поде для быстрых сценариев и три виртуальные машины с настоящим Gachinetes для того, что требует реальных нод.
Что выяснилось на практике. Значок ♂ нельзя использовать в именах API: группы ресурсов в Kubernetes — это DNS‑имена, а DNS такие символы не пропускает. Поэтому все группы живут под скучным gachinetes.dev, а ♂ встречается только в тексте, который читает человек. Это была первая и последняя уступка здравому смыслу.
Кассета: кластер, который помнит
Начну с самой большой дыры. Kubernetes хранит состояние в etcd, а etcd регулярно сжимает историю: старые версии объектов выбрасываются, чтобы база не росла бесконечно. Пока объект жив, вы видите его текущую версию. Удалили по ошибке ConfigMap — его нет нигде, кроме бэкапа, если он вообще был. Удалили неймспейс — вместе с ним ушли все Deployment, Secret и роли внутри, и восстанавливать это руками придётся долго. На вопрос «каким был кластер в 13:00, до того как всё сломалось?» Kubernetes не отвечает в принципе.
В kuberoot уже было собственное хранилище, которое говорит с apiserver на языке etcd и проходит его тесты совместимости. Внутри оно, как и etcd, держит версии каждого ключа. Я сделал так, чтобы при сжатии версии не стирались, а переезжали в архив. Для apiserver ничего не изменилось: прочитать сжатую ревизию через API etcd он по‑прежнему не может, и на этом отказе держатся тесты совместимости. Но рядом появился отдельный вход, через который историю можно читать. Время каждой ревизии берётся из журнала консенсуса, то есть из момента, когда запись была предложена кластеру, поэтому все участники одинаково отвечают на вопрос «что было в 13:00».
Это и есть кассета. Поверх неё работает команда gachictl:
gachictl get configmaps -n shop --at 15m     # неймспейс, каким он был 15 минут назад
gachictl rewind -n shop --to 13:00Z          # что изменилось с тех пор
gachictl history deployment/web -n shop      # все версии одного объекта
gachictl graveyard -n shop                   # что удалили
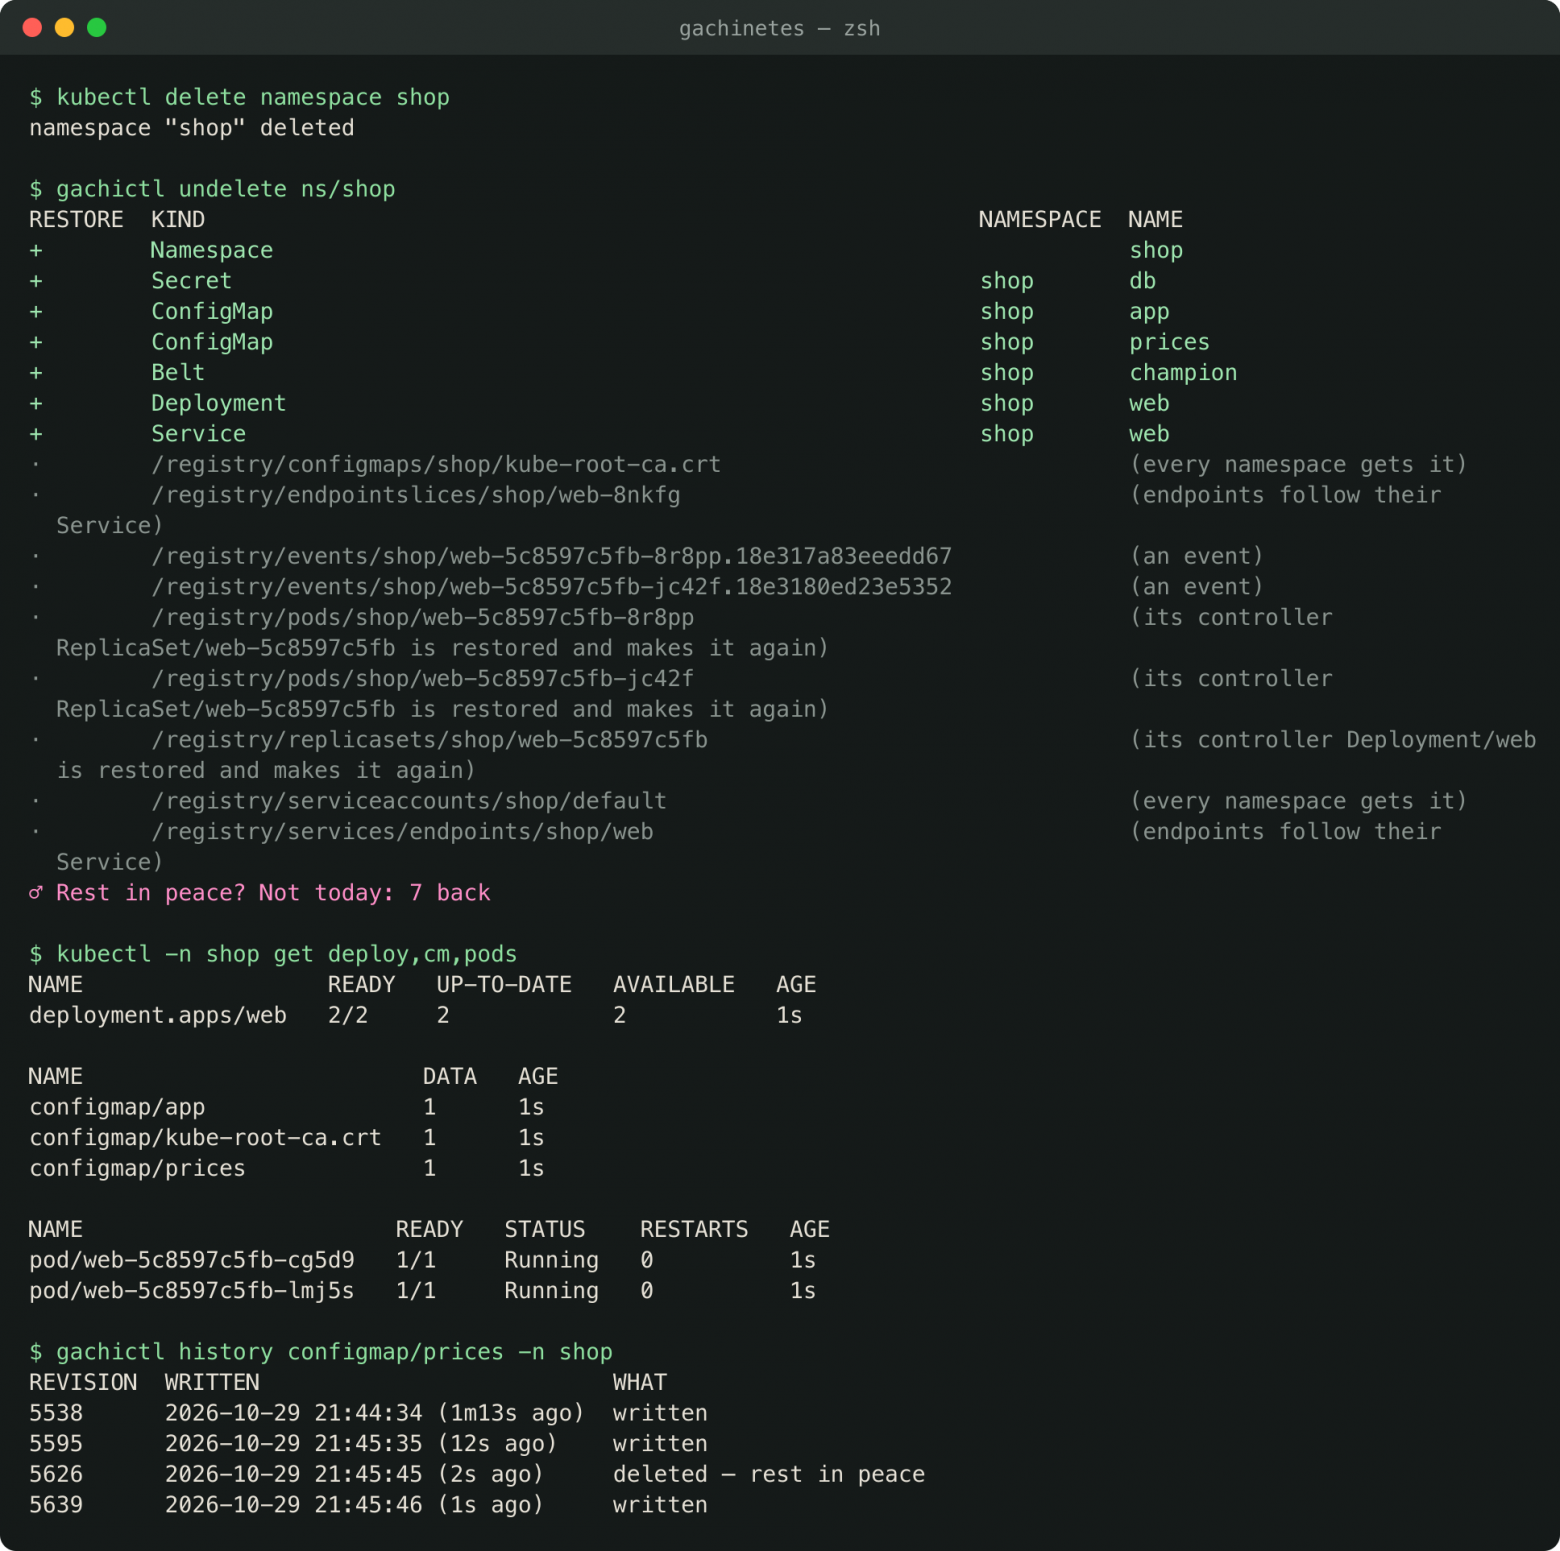
gachictl undelete ns/shop                    # rest in peace? not today
Самое интересное оказалось в undelete целого неймспейса. Вернуть объекты в произвольном порядке нельзя: Deployment без неймспейса не создать, объект пользовательского типа без его CRD тоже. Поэтому восстановление идёт по порядку владения: сначала неймспейс и определения типов, потом владельцы, потом зависимые, а ссылки на владельцев переписываются на их новые UID. То, что кластер пересоздаёт сам, не трогается: поды ReplicaSet, события, токены сервис‑аккаунтов, корневой сертификат неймспейса. Если вернуть и их, получатся дубли, с которыми контроллеры будут бороться. Борьба в этом дистрибутиве — отдельная тема.
Первая версия сервиса кассеты оказалась дырой. Он слушал порт на ноде и отдавал историю без проверки того, кто её спрашивает. В истории лежат Secret, и kuberoot шифрует их в хранилище, а кассете, чтобы быть полезной, их нужно расшифровывать: удалённый по ошибке Secret — как раз то, что больнее всего потерять. Получалось, что любой, кто дотянется до ноды, может читать все секреты кластера за всё время. Я переделал сервис в расширение API Kubernetes. Теперь apiserver сам пускает к нему запросы со своим сертификатом, каждый запрос проходит проверку прав, а Secret без отдельного права на них приходят пустыми. Ключи шифрования сервис берёт из того же файла, что и apiserver.
Попутно нашлась ошибка в самом хранилище kuberoot. Снимок базы не заканчивался контрольной суммой, как у etcd, и стандартная утилита etcdctl snapshot save на нём просто падала. Её чинил отдельный запрос в kuberoot. Мем ещё не появился ни разу, а дистрибутив уже стал лучше.
Кассета VHS
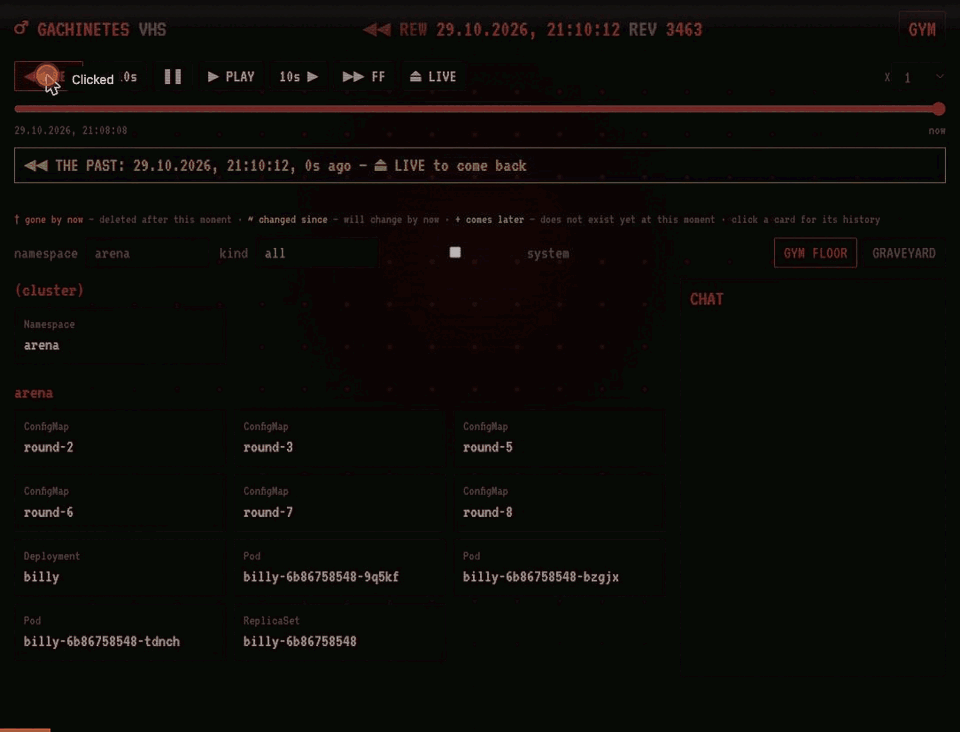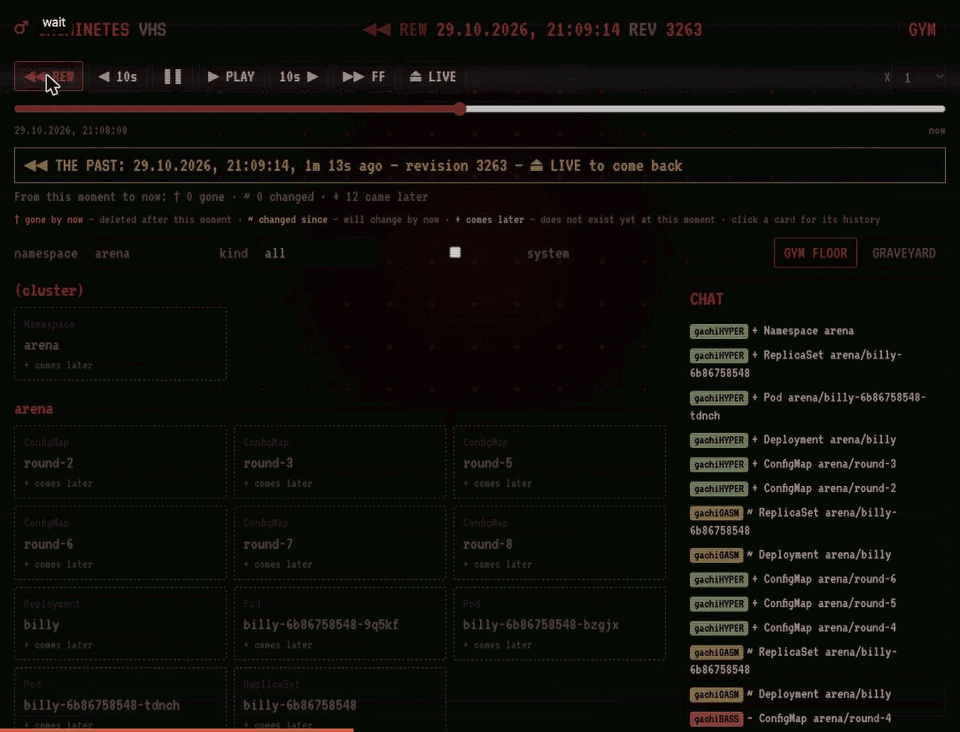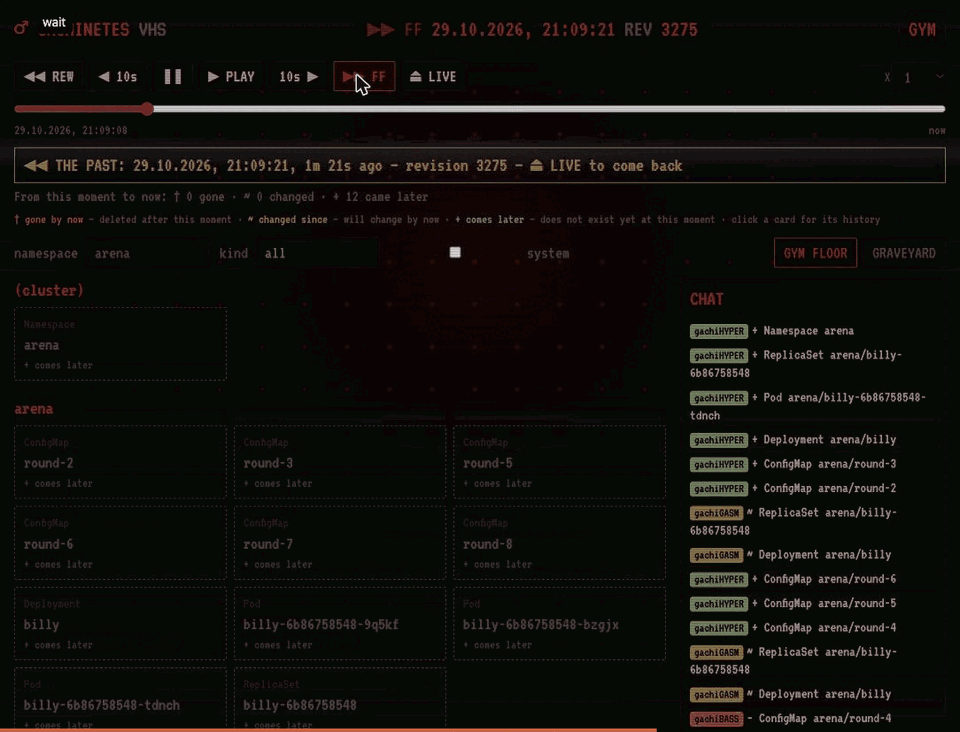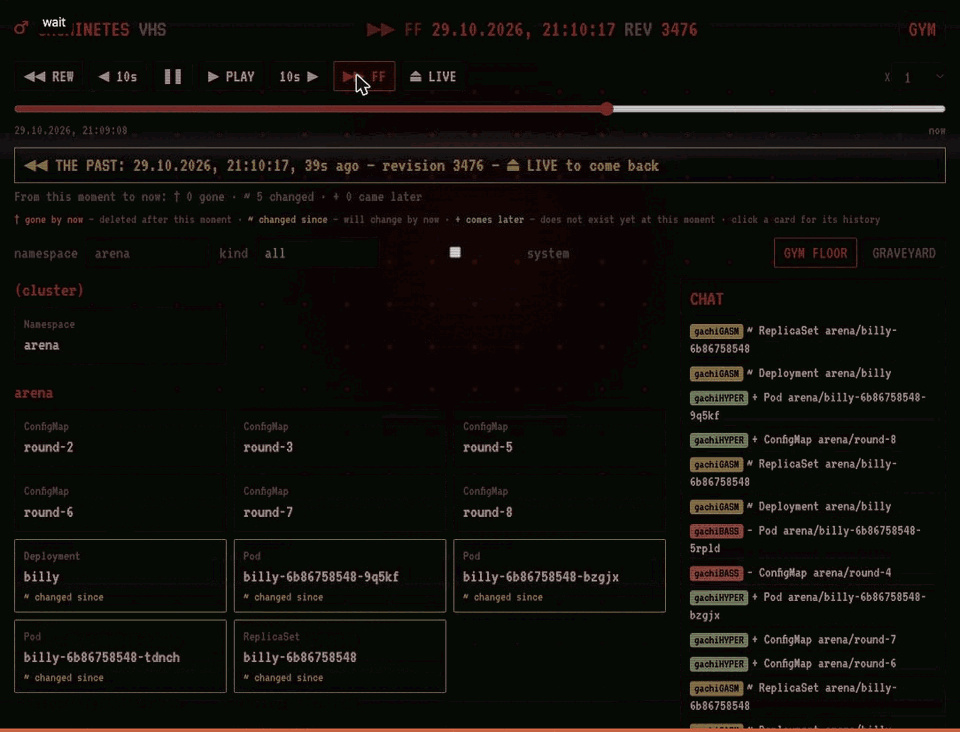
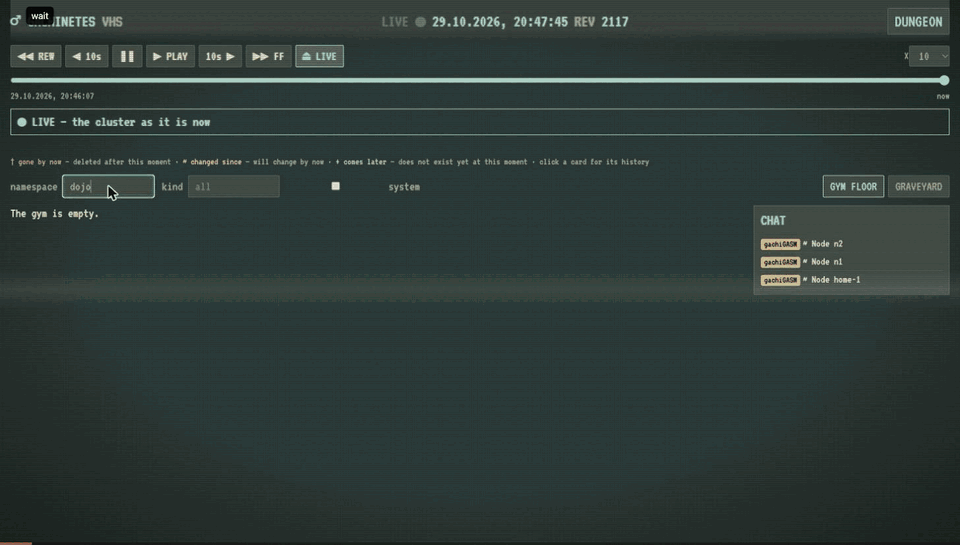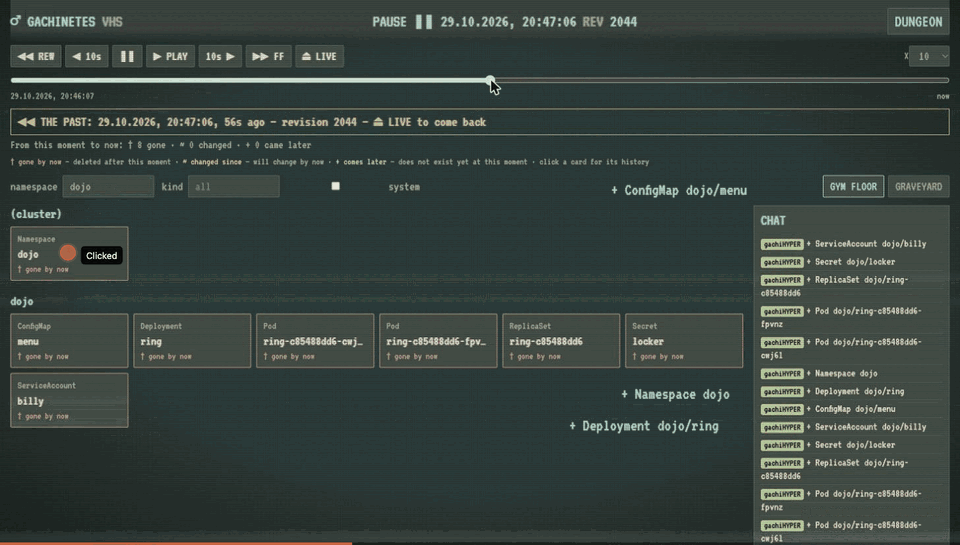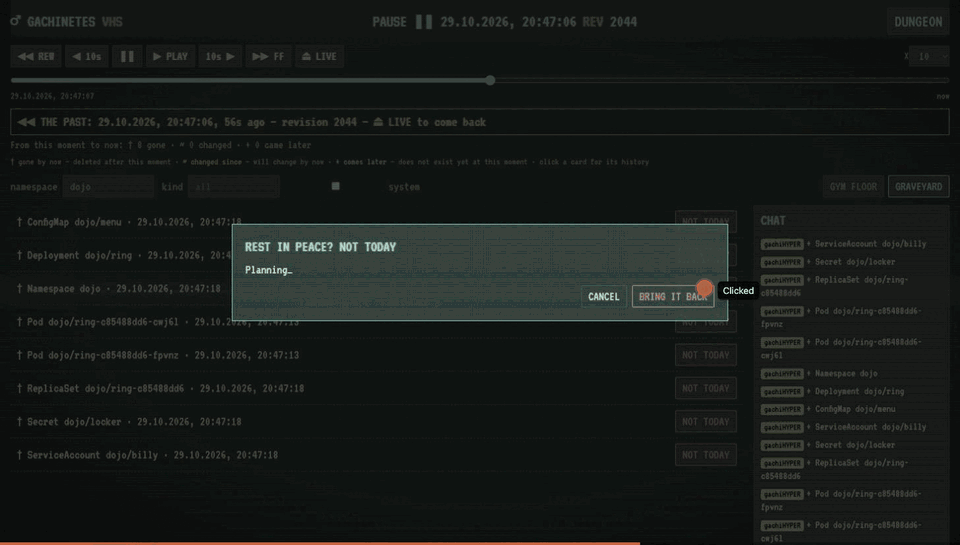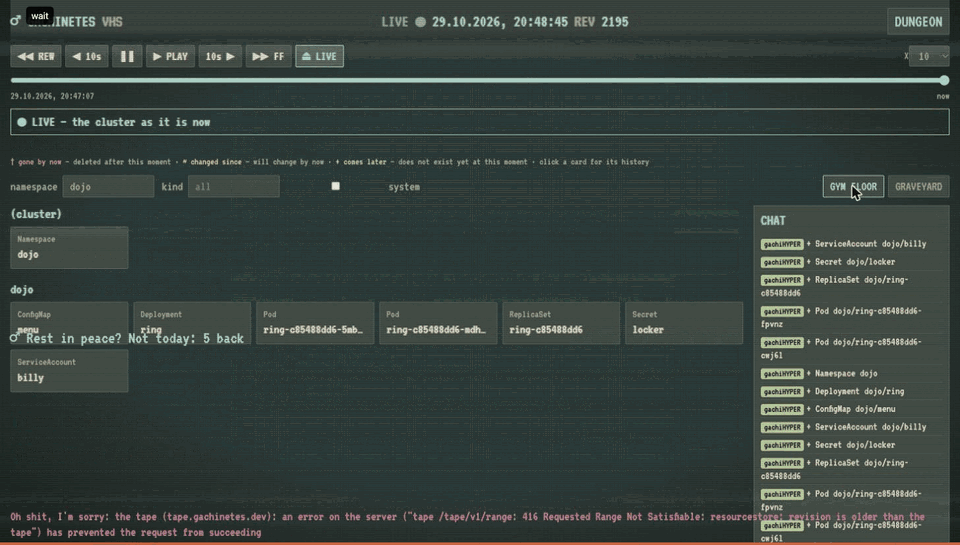
У кассеты должен быть магнитофон. gachictl vhs открывает в браузере интерфейс видеокассеты девяностых: строчная развёртка, таймкод в углу, экранное меню и кнопки, которые действительно перематывают кластер. Нажимаете ◀◀ REW — время бежит назад, пока не нажмёте стоп, как на настоящем магнитофоне. Удалённые объекты возвращаются полупрозрачными призраками, изменённые подсвечиваются, а то, чего в этот момент ещё не было, гаснет. Сверху висит плашка, на какой момент вы смотрите и сколько с тех пор ушло, изменилось и появилось. На любой призрак можно кликнуть и вернуть кнопкой «Rest in peace? Not today».
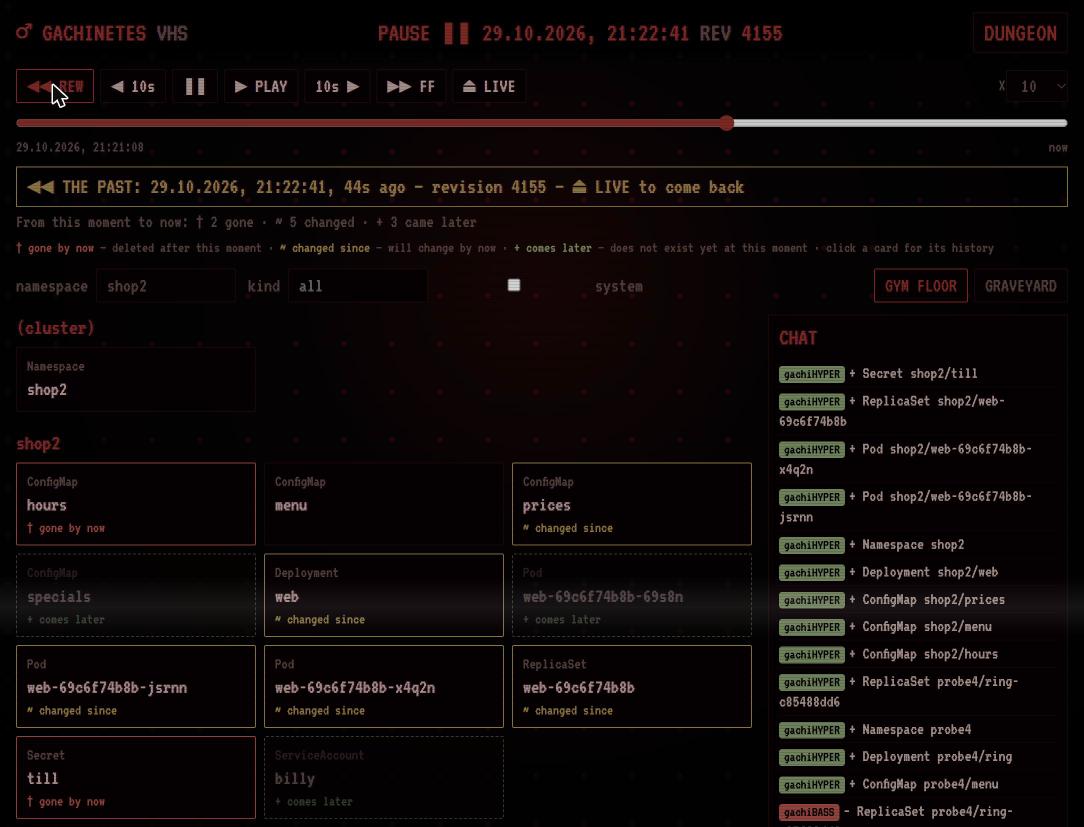
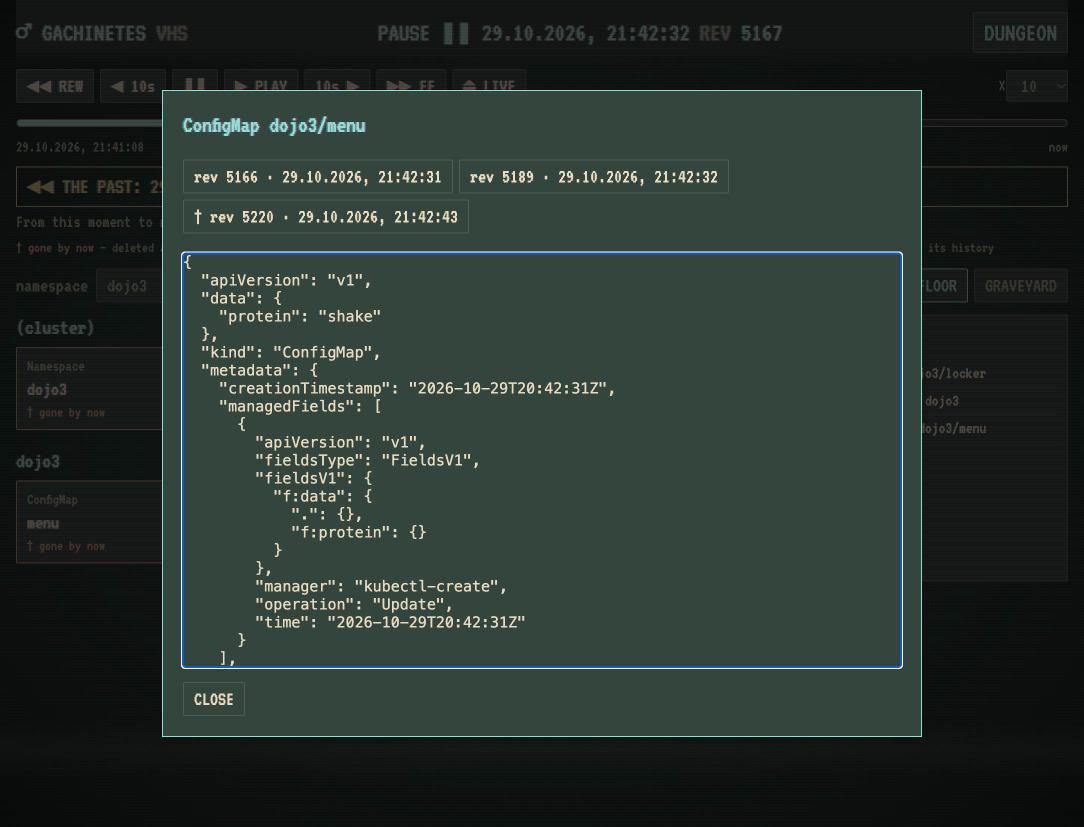
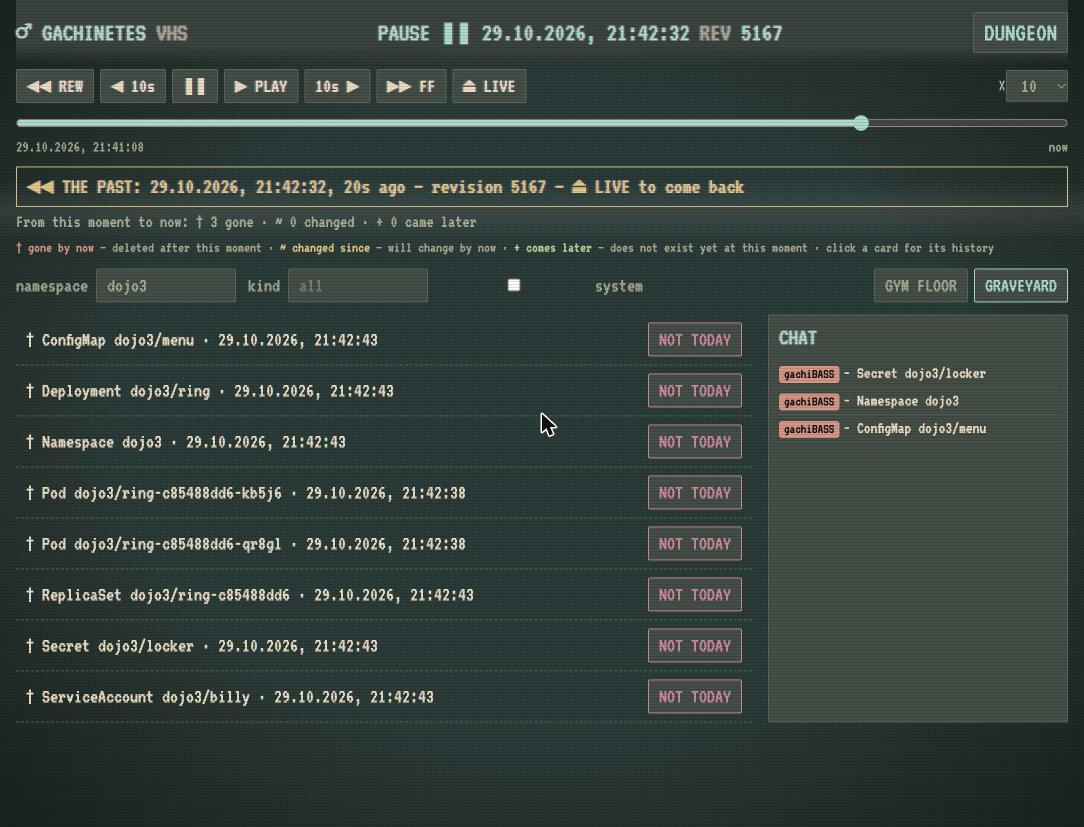
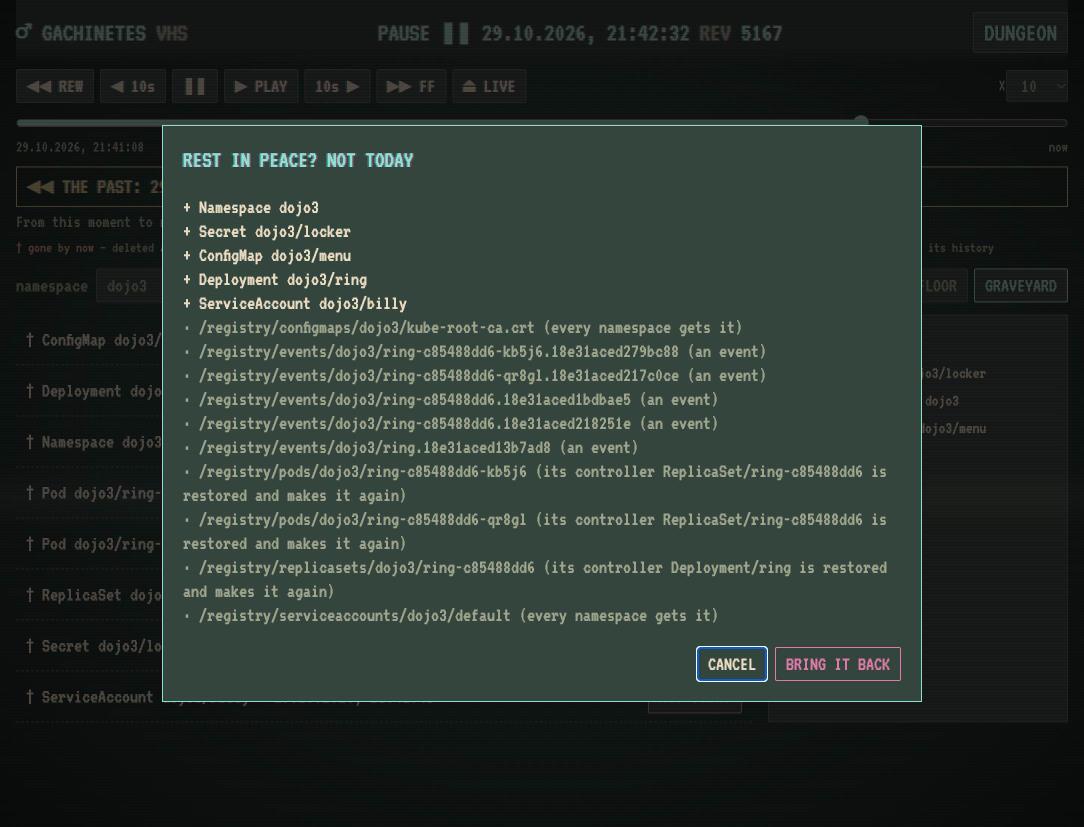
События кластера летят по экрану, как комментарии на Niconico, а справа идёт чат, где алерты пишутся эмоутами: gachiBASS — что‑то деградировало, gachiHYPER — восстановилось, gachiGASM — релиз прошёл. Тем две. Зал похож на ролик, который заездили на видеопрокате до выцветших бирюзовых тонов. Подземелье — почти чёрный экран под красной лампой.
Борьба и пояса
Следующая боль знакома всем, кто использовал в одном кластере GitOps и автоскейлер. Argo CD выставляет replicas: 3, потому что так написано в Git. HPA через минуту ставит семь, потому что пришла нагрузка. Argo видит расхождение и возвращает три. Так они могут перетягивать поле сутками, и Kubernetes это никак не замечает: каждая запись по отдельности законна.
Но по сути, каждая запись в Kubernetes несёт в managedFields имя менеджера, который её сделал, а по разнице версий видно, какое поле поменялось. gachi-referee смотрит на все записи и, если одно поле переходит из рук в руки несколько раз за окно, объявляет бой: создаёт объект Bout и пишет на спорный объект событие.
$ gachictl bouts
PHASE  OBJECT                   FIELD          FIGHT                LAST
Over   Deployment.apps gym/war  spec.replicas  argocd ×3 vs hpa ×3  2026-10-29T18:15:32Z
Найти бой полезно, а запретить его ещё полезнее. Для этого есть пояса. BeltPolicy говорит: поле spec.replicas у этого Deployment принадлежит HPA. Любой другой менеджер, который попробует его записать, бросает вызов, и рефери его отклоняет с понятным объяснением, кому принадлежит пояс и к кому идти. Для полей, где запрет слишком жёсток, пояс можно поставить в режим предупреждения.
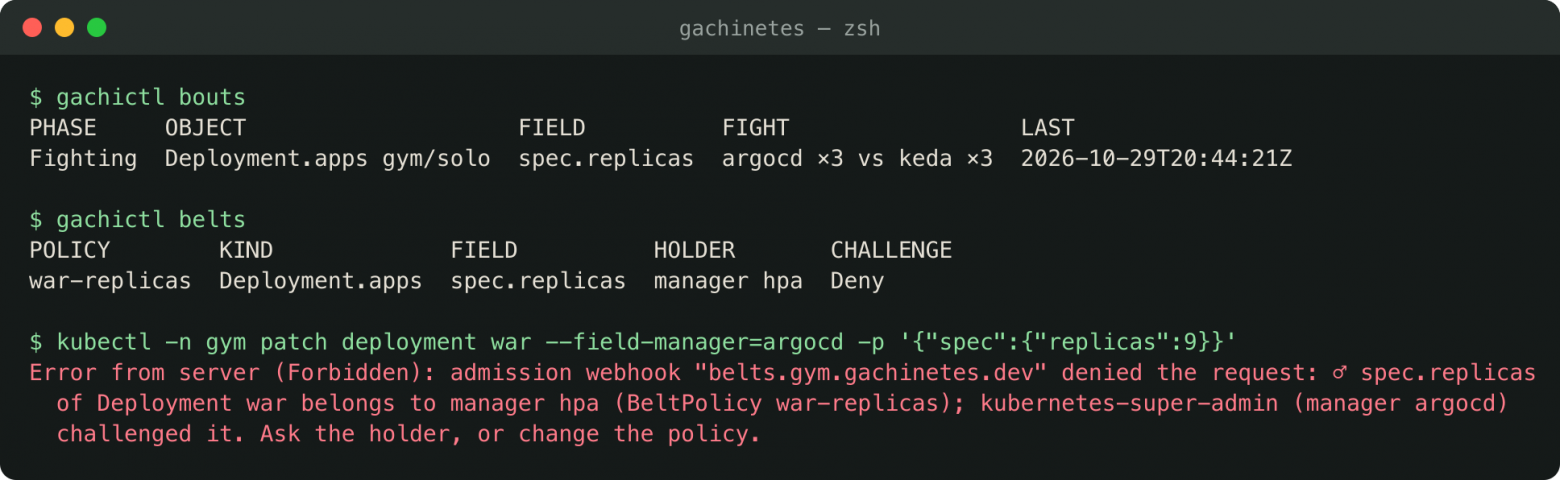
Здесь пришлось решить, что важнее: пояса или живой кластер. Рефери проверяет записи через вебхук, и если он упадёт, а вебхук будет требовать ответа, кластер перестанет принимать изменения. Поэтому рефери сам настраивает свой вебхук и делает его открытым: упавший рефери пропускает записи, а поднявшись, снова начинает судить. Это проверяется отдельным сценарием, и на нём, кстати, нашлась гонка в самом тесте. Сразу после перезапуска рефери apiserver ещё помнит его старый сертификат, поэтому первая попытка проходит мимо судьи.
И последнее в этой части — «Sorry for what?». Команда gachictl why объясняет, что не так с объектом: его условия, какой владелец его породил и после какой правки, и какие бои вокруг него идут.
$ gachictl why deployment/war -n gym
Sorry for what?

Deployment gym/war is not well.
  ✗ Available=False MinimumReplicasUnavailable: Deployment does not have minimum availability.
  ✗ Wrestling: ♂ spec.replicas is fought over: argocd ×3 vs hpa ×3, 5 changes of hands.
Deep dark fantasies
kubectl apply --dry-run=server проверяет один объект, но никто не знает, что после применения сделают контроллеры, планировщик и автоскейлеры. Сколько подов пересоздастся, где они встанут, кому не хватит места?
Фантазия отвечает на это. gachi-fantasy берёт кассету в нужный момент, хоть сейчас, хоть вчера, и поднимает рядом копию управляющего слоя: своё хранилище, свой apiserver, настоящие контроллеры и настоящий планировщик. Вместо нод работает имитатор, который ведёт себя как ноды, но ничего не запускает. Копия засевается сырыми записями кассеты, поэтому объекты переезжают целиком, с UID, статусами и ссылками на владельцев. Потом в неё применяется изменение, фантазия ждёт, пока кластер успокоится, и пишет отчёт: что появилось, что изменилось, что ушло, где встали поды и кто остался без места.
Если результат устраивает, --merge применяет то же изменение к настоящему кластеру. Но только если кластер не ушёл вперёд: когда хоть один затронутый объект изменился после ветвления, слияние отказывается, и фантазию надо проиграть заново.
Поднять копию apiserver на одном адресе с настоящим оказалось неожиданно неудобно. Стандартный инструмент выпуска сертификатов отказывается выпускать сертификат apiserver на адрес 127.0.0.1, поэтому сертификаты выпускаются кодом. А apiserver копии не стартует на этом адресе, пока сам пытается публиковать свой эндпоинт, и эту публикацию пришлось выключить. Вебхуки настоящего кластера в копии тоже выключены: иначе фантазия ходила бы в настоящие сервисы.
Планировщик, деньги и протеин
В Gachinetes вместо kube‑scheduler работает gachi-scheduler. Это тот же планировщик Kubernetes с тремя дополнительными правилами.
Весовые категории расширяют классы QoS. Помимо обычных появляется супертяжёлый вес — под, которому нужна нода целиком, например под обучение на всех GPU машины. Супертяжёлый держит ноду один, и никто к нему не подсаживается.
Tag team — это группа подов, которая выходит на ринг целиком или никак. Распределённое обучение на 64 GPU бесполезно, если встали 60 подов, а оставшиеся 4 ждут места: занятые 60 GPU простаивают. Здесь нашлась тонкость. Под, который не пустили, потому что напарники ещё не пришли, сам в очередь планировщика не возвращается, и первый пришедший напарник ждал таймаута. Помогло то же, что в похожих планировщиках для групп: ждущий под сам будит своих напарников.
Boy next door ставит разговорчивых соседей рядом. Если сервисы много говорят друг с другом, им лучше стоять на одной ноде или в одной зоне: меньше задержка и меньше счёт за межзональный трафик.
Three hundred bucks превращает ресурсы в деньги. PriceList говорит, сколько стоит час ядра, гигабайта памяти и GPU, а Budget — сколько неймспейс может тратить в месяц. Под, который вывел бы неймспейс за бюджет, отклоняется, а gachictl bill показывает счёт:
$ gachictl bill
NAMESPACE  PODS  A MONTH  BUDGET
cheap      3     $87.60   $100.00
dream      7     $379.60  —
team       2     $46.72   —
TOTAL            $519.76
Протеин держит мощность тёплой. Образы для обучения моделей весят гигабайты, а GPU‑нода подключается минутами. ProteinShake расставляет заглушки с самым низким приоритетом, которые занимают место под тяжёлые поды, и заранее тянет нужные образы на ноды. Настоящий под вытесняет заглушку штатными средствами планировщика и встаёт на уже прогретое место. Изобретать тут ничего не пришлось: вытеснение по приоритету в Kubernetes уже есть, ему просто никто не давал такой работы.
Контракты, safeword и подземелье
Повышенные права в Kubernetes обычно выдают навсегда и забывают забрать. Отозвать токен сервис‑аккаунта тоже почти невозможно. В Gachinetes повышение — это контракт: роль, срок, причина и, для опасных ролей, страхующий.
gachictl contract fix-db --role cluster-admin --for 1h --reason "ночной инцидент" --spotter
Главный риск здесь — сделать из контрактов дыру для повышения прав, поэтому правила жёсткие. Одобрить контракт может только тот, кто сам вправе выдать эту роль, и не тот, кто её просит. Без страхующего контракт работает, только если просящий и так мог выдать роль самому себе. Тогда контракт ничего не добавляет к его правам, только ограничивает их сроком.
Safeword — это эпоха доверия. gachictl safeword сдвигает её, и все привязки по контрактам снимаются за секунды. Kubernetes проверяет права на каждом запросе, поэтому следующий же запрос по отозванному контракту получит отказ. Уже открытую сессию exec это не разрывает: права проверяются при входе в неё, а не на каждом нажатии клавиши.
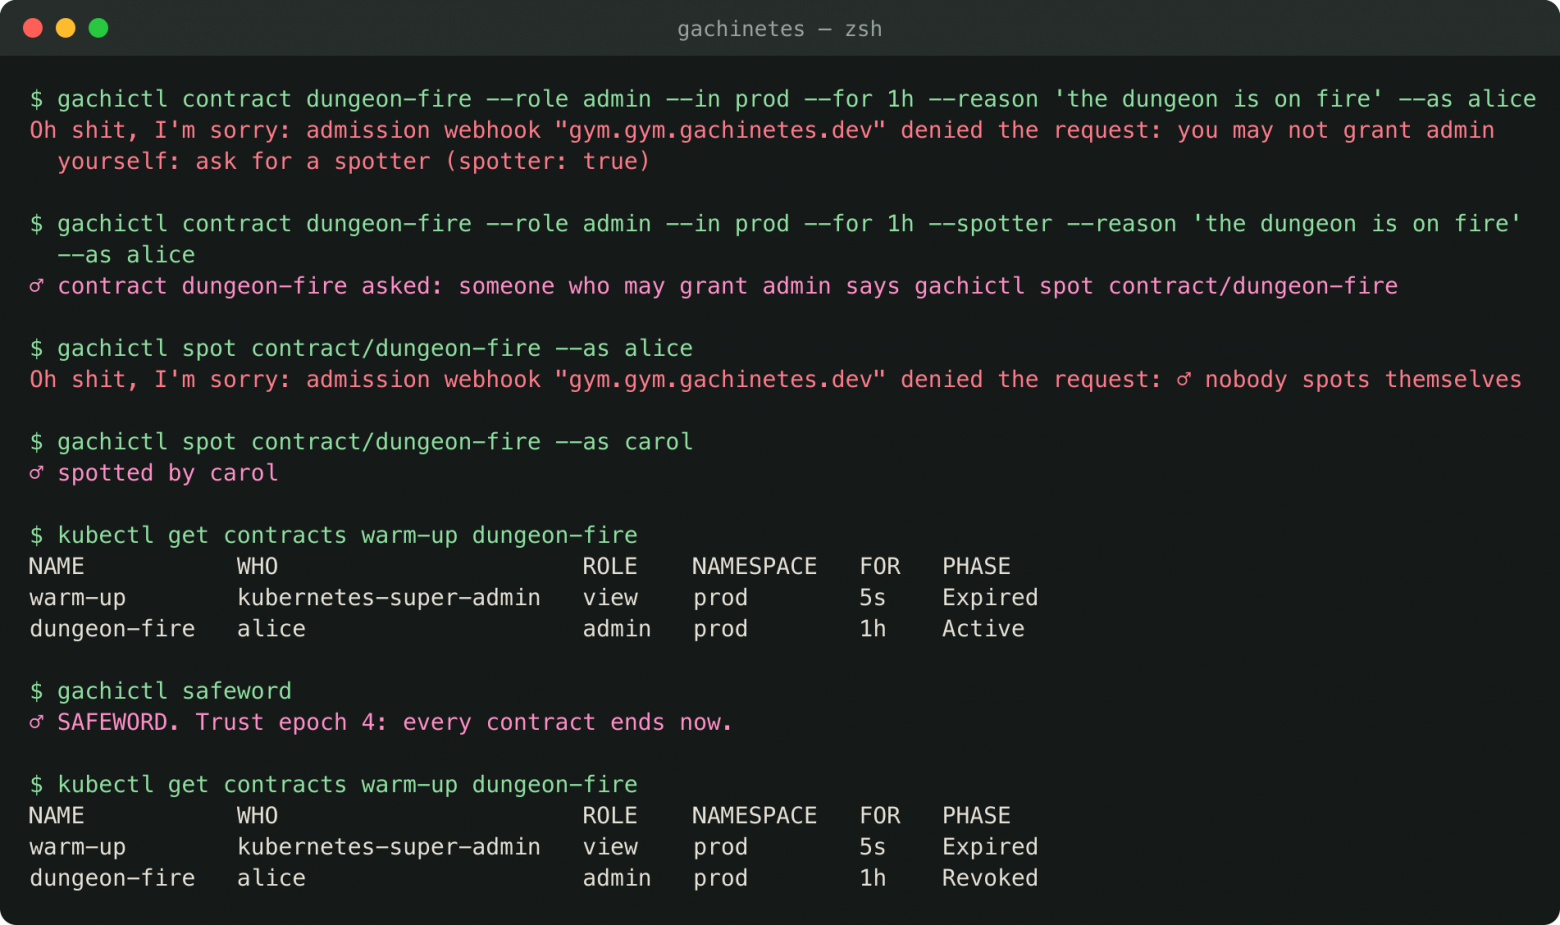
Страхующий работает и для удалений. Неймспейс, CRD или том можно пометить, и тогда удалить их получится только с одобрением второго человека, данным недавно.
Dungeon — карантин вместо убийства. Подозрительный под не удаляется, а выводится из‑под своего контроллера и из своих сервисов. Трафик на него больше не идёт, контроллер поднимает замену, а сам под остаётся целым для разбора. Leather — жёсткие умолчания: в неймспейсе с меткой нельзя запускать привилегированные поды, лезть в пространства имён хоста и монтировать его пути. Метку надо ставить, а не снимать: сетевым и системным пакетам хост нужен. Раздевалка выдаёт каждой нагрузке свой шкафчик: Secret доступен только сервис‑аккаунтам, которым он положен.
Здесь же меня подловила командная строка. Короткий флаг -s у одной команды совпал с флагом -s, который означает адрес сервера у всех команд kubectl. В итоге падала с паникой не одна команда, а все сразу. С тех пор в тестах есть проверка, что --help проходит у каждой команды.
Тренер, спарринги, Аники и выездные матчи
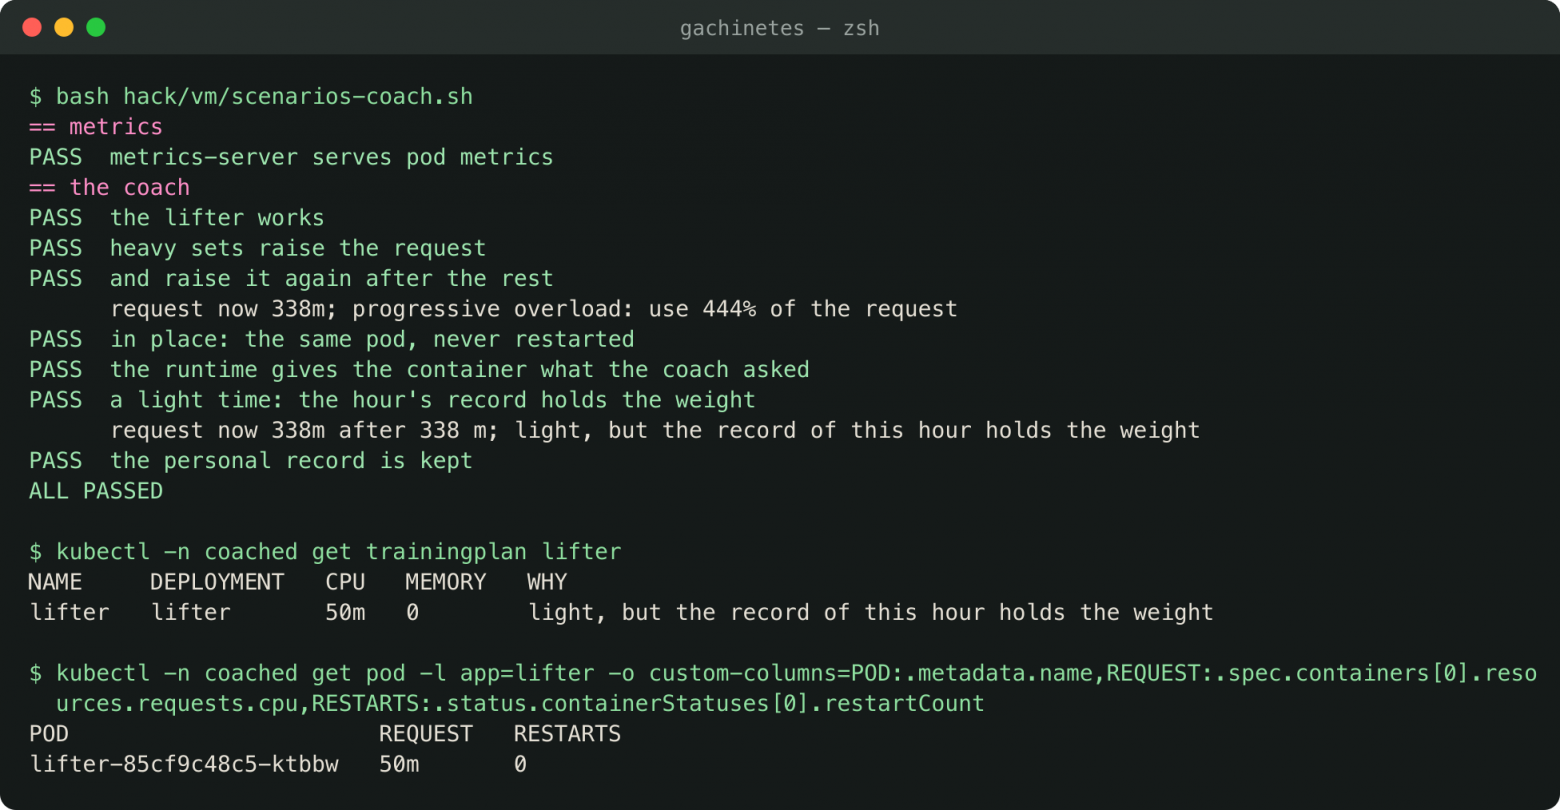
GymAutoscaler — это вертикальный автоскейлер, устроенный как программа тренировок. Если под стабильно работает выше 80% своего запроса, тренер поднимает запрос небольшим шагом, а потом даёт отдых, прежде чем поднимать снова. Это прогрессивная нагрузка. Тренер помнит личные рекорды и пики каждого часа недели: если по понедельникам в десять приходит нагрузка, он поднимает запрос заранее. Это мышечная память. А когда под долго работает легко, тренер снижает запрос, но не ниже рекорда текущего часа. Это разгрузка. Запрос меняется на работающем поде, без перезапуска: в Kubernetes это наконец стало штатной возможностью.
На живом кластере тренер выглядит так. Под с запросом 100 m крутит пустой цикл на целом ядре. Тренер поднимает ему запрос до 150 m, потом до 225 m, 338 m и 507 m, а под всё это время тот же самый и ни разу не перезапускался.
$ kubectl -n coached get trainingplan
NAME     DEPLOYMENT   CPU    WHY
lifter   lifter       507m   light, but the record of this hour holds the weight
Спарринги — хаос по расписанию. Партнёр по спаррингу убивает под сервиса и засекает, за сколько сервис снова полностью готов. Из этого складывается рейтинг: кто держит удар, а кто поднимается по пять минут.
Аники — наставник зала. Он смотрит на нагрузку при создании и один раз, по‑доброму, говорит, что ей навредит: одна реплика («a one‑man gym»), все реплики на одной ноде, образ без тега, нет запросов ресурсов, нет проверки готовности, привилегированный режим. Серьёзные вещи приходят предупреждением прямо в kubectl apply, а включается Аники меткой на неймспейсе.
Выездной матч выносит команду в другой кластер. Если подам Deployment долго не находится места дома, те, кому места не хватило, играют в другом кластере, а когда дома освобождается место, возвращаются.
Get your ass back here: живая миграция
Это самая длинная история в проекте, и ради неё стоило всё затевать.
В Kubernetes нет переноса пода. Есть удаление и создание нового. Если на ноде нужно обновить ядро, все поды с неё убиваются и стартуют где‑то ещё с нуля. Для веб‑сервиса это неприятно, для многочасового обучения модели — катастрофа: всё, что посчитано в памяти, пропадает. Технология, которая умеет сохранить процесс вместе с памятью и поднять его в другом месте, существует давно, это CRIU. В Kubernetes даже есть API, через который kubelet снимает чекпойнт контейнера. Я рассчитывал, что достаточно соединить эти куски.
Схема получилась такая. Пользователь создаёт объект Migration. Контроллер gachi-mover через apiserver просит kubelet исходной ноды снять чекпойнт каждого контейнера. Агент на этой ноде отдаёт архив чекпойнта агенту целевой ноды, тот упаковывает его в образ контейнера с пометкой «это чекпойнт» и кладёт в маленький реестр, доступный только самой ноде. Затем контроллер удаляет старый под и создаёт такой же на новой ноде, только вместо образа приложения указывает образ чекпойнта. Агенты пускают к себе только тех, у кого по мнению apiserver есть право снимать чекпойнты на этой ноде.
Ломалось всё по очереди, каждый слой отдельно. В ядре kuberoot не было нужных CRIU опций, и у дистрибутива появился свой фрагмент конфигурации ядра. CRIU нет в Alpine, а версия из Debian не понимала устройство памяти современного ядра, поэтому CRIU 4.3 пришлось собирать из исходников. По умолчанию CRIU блокирует сеть через iptables, а на нодах kuberoot только nftables. Чтобы упаковать содержимое временных файловых систем, CRIU нужен tar, а tar нужен gzip. Всё это пришлось отлаживать на нодах, где нет shell, через привилегированный под в отдельном неймспейсе.
Когда снятие чекпойнта и перенос заработали, выяснилось главное. Почти все дистрибутивы Kubernetes, и kuberoot в том числе, запускают контейнеры через containerd, а containerd умеет снимать чекпойнт через свой API, но не умеет из него восстанавливать. Ни в последнем релизе, ни в основной ветке. Восстановление из чекпойнта есть только в CRI‑O. Значит, живая миграция в Kubernetes упирается не в Kubernetes и не в CRIU, а в выбор среды запуска контейнеров. Поэтому Gachinetes перешёл на CRI‑O, а kuberoot научился работать с ним как со второй средой запуска.
На CRI‑O миграция сразу отчиталась об успехе, а под на новой ноде упал с ошибкой «нет такого файла sh». CRI‑O скачал образ чекпойнта и попытался запустить его как обычный образ, а внутри него только дамп процесса, никакого shell. Оказалось, что в CRI‑O 1.37 появилась отдельная настройка уровня поддержки чекпойнтов, и по умолчанию она разрешает их снимать, но не восстанавливать. Старый флаг, который все включают по документации, ставит тот же уровень.
Следующая ошибка звучала как «образ не найден». Чекпойнт хранит процесс и то, что он изменил на диске, но не файловую систему, с которой процесс стартовал. CRI‑O накладывает дамп поверх исходного образа контейнера и ищет этот образ на ноде, а нода, где под никогда не работал, его никогда и не скачивала. Решение получилось аккуратным: восстановленный под несёт исходный образ как том, который никуда не смонтирован. Kubelet скачивает такие тома до создания контейнеров, с секретами доступа самого пода и по тому же digest, который работал на старой ноде. При этом образ не запускается.
После этого всё заработало, а тест сообщил о провале. Счётчик в контейнере сказал 22 на старой ноде в 18:48:29 и 23 на новой в 18:48:32. Три с половиной секунды тишины, после чего тот же процесс считал дальше, ни одно число не повторилось. Тест же прочитал первую строку лога пода и нашёл там единицу. CRI‑O переносит вместе с чекпойнтом и лог контейнера, поэтому лог переехавшего пода начинается ещё на старой ноде. Тест теперь смотрит на первое число, написанное после последнего запуска контейнера.
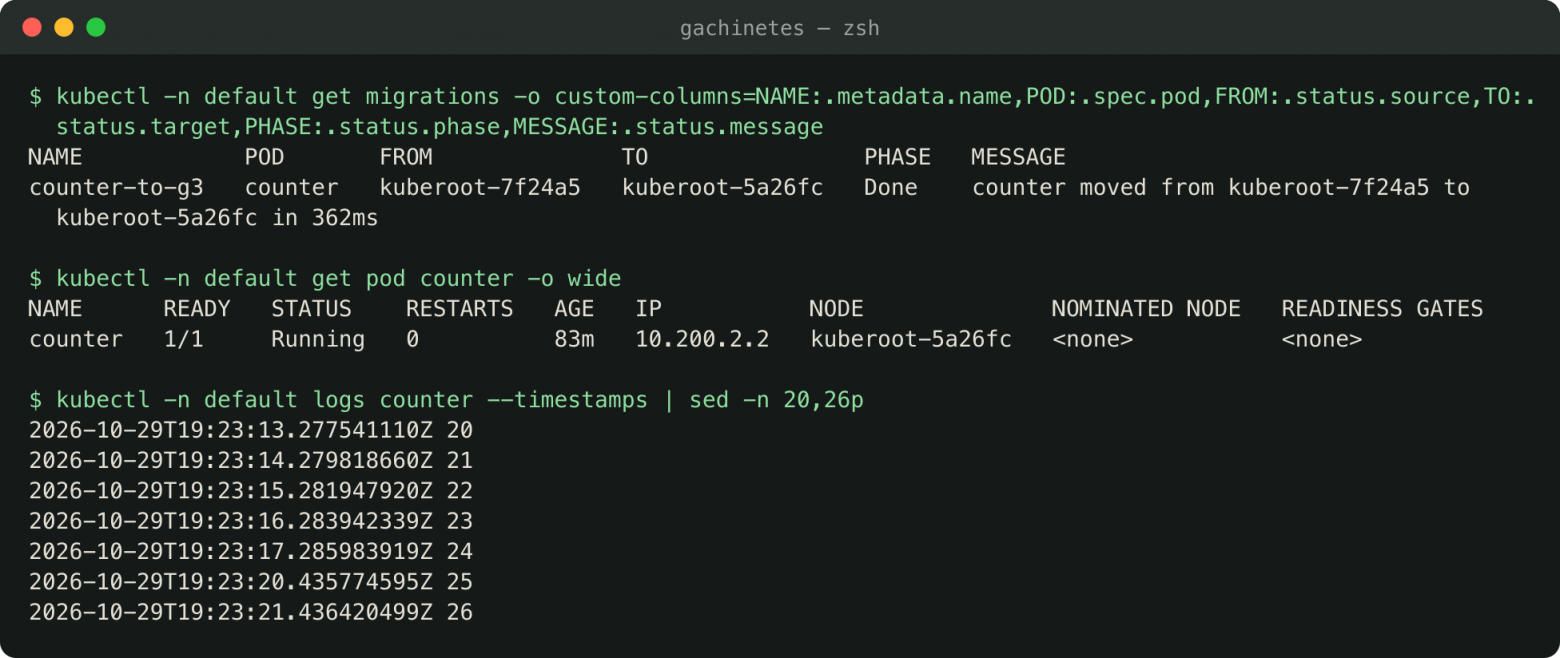
== live migration
PASS  the counter runs on kuberoot-7f24a5
      counted 21 on kuberoot-7f24a5
PASS  the migration is done
PASS  the counter runs on kuberoot-5a26fc
PASS  it counts on from where it was, not from 1
      first count after the move: 25, now 30
== rounds
PASS  the long job runs
PASS  a round is taken
PASS  it comes back
PASS  on the node that held its round
PASS  from its last round, not from 1
      reached 29 before it went; came back at 25
ALL PASSED
На этой же механике работают раунды. Под с аннотацией раунда раз в заданный интервал получает чекпойнт, который хранится на запасной ноде. Если под падает или его нода пропадает, он возвращается с последнего раунда, а не с начала. Для долгой задачи это разница между потерянными минутами и потерянными сутками.
Что тренер нашёл в полу
Последняя находка случилась, когда я проверял тренера на виртуальных машинах. Ему не на что было опираться: metrics‑server отдавал метрики нод и ни одного пода. Причина оказалась в основании. Встроенный в kubelet сборщик метрик ищет CRI‑O по жёстко зашитому пути /var/run/crio/crio.sock, а в kuberoot каталога /var/run не было вообще. Та же ошибка тихо выключала менеджер вытеснения, который освобождает ноду при нехватке памяти или диска, и сборку мусора образов. Кластер в таком состоянии может работать часами и выглядеть здоровым.
Исправление — символическая ссылка /var/run на /run, которую стандарт файловой иерархии описывает с девяностых. Шуточный автоскейлер нашёл ошибку, которую серьёзный кластер скрывал бы до первого переполненного диска.
Как это проверялось
Каждая возможность закрыта сценарием, который выполняется на живом кластере, а не в моках. Для быстрых сценариев управляющий слой целиком поднимается в одном поде: хранилище с кассетой, apiserver, контроллеры, сервис кассеты как расширение API и имитатор нод для планировщика. Такой стенд поднимается за минуты, и все шесть наборов сценариев проходят на нём подряд.
Последний чистый прогон — 131 проверка из 131: кассета и восстановление — 38, борьба, пояса и why — 17, фантазии — 13, контракты, страхующий, подземелье, Leather и раздевалка — 32, спарринги, Аники и выездные матчи — 13, планировщик, деньги и протеин — 18.
То, что требует настоящих нод, проверяется на трёх виртуальных машинах с собранным Gachinetes: живая миграция, раунды и тренер с настоящим metrics‑server. После каждой правки дистрибутив пересобирается, машины пересоздаются с нуля, и сценарии идут заново.
Последней проверкой был официальный набор тестов совместимости Kubernetes, тот самый, по которому дистрибутивы получают сертификат CNCF. Для Gachinetes он важнее, чем для обычного дистрибутива. Здесь своё хранилище с кассетой вместо etcd, свой планировщик вместо kube‑scheduler, рефери с вебхуками на каждой записи и CRI‑O вместо containerd, и всё это легко могло незаметно сломать какое‑нибудь обещание Kubernetes. На трёх виртуальных машинах с Kubernetes v1.37.1 прошли все 462 теста из 462. Так что при всех поясах, кассетах и подземельях Gachinetes остаётся настоящим, совместимым Kubernetes.
Что из этого следует
Мем оказался хорошим инструментом поиска. Каждое его слово указывало на место, где у Kubernetes нет ответа, и почти каждый ответ удалось построить из того, что в Kubernetes уже есть. Войны контроллеров видны из managedFields любого кластера. Отменяемое удаление и перемотка получаются из хранилища, которое просто не выбрасывает старое. Протеин стоит на штатном вытеснении. Контракты держатся на обычной проверке прав. Детектор боёв, пояса, фантазии, деньги, контракты, тренер и Аники ставятся на любой кластер.
Самое неожиданное — где на самом деле живут ограничения. Живая миграция не упирается в Kubernetes: API для чекпойнтов в нём есть. Она упирается в то, какую среду запуска контейнеров вы выбрали, в одну строчку конфигурации CRI‑O и в то, что чекпойнт — это разница с образом, а не самостоятельный контейнер. А самая опасная ошибка нашлась не в сложном коде, а в отсутствующей символической ссылке, и нашёл её компонент, который писался как шутка про качалку.
Исправления, которые понадобились по дороге, ушли в kuberoot: история хранилища, снимок для etcdctl, CRI‑O как вторая среда запуска и /var/run.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.