Appleが使われていないMacを集めて仮想GPUクラウドを構築する「Minions」を開発、AI処理の待ち時間を10時間以上から数分に短縮
そこでAppleの研究チームが開発したのが「Minions」です。Minionsは社内にある複数のMacの空きGPUリソースを集め、仮想的なGPUクラウドとして利用する仕組みです。新たなGPUサーバーを購入することなく、既存のMacを使ってAIの処理能力を確保できます。
Minionsは大きな処理を複数の小さなタスクに分割し、ネットワークに接続されたMacにそれぞれを割り当てます。各Macでは「Minion Executor」と呼ばれるプログラムが動作し、処理可能なタスクを取得してApple SiliconのGPUで実行します。処理が完了するとその結果はAmazon S3に保存されます。
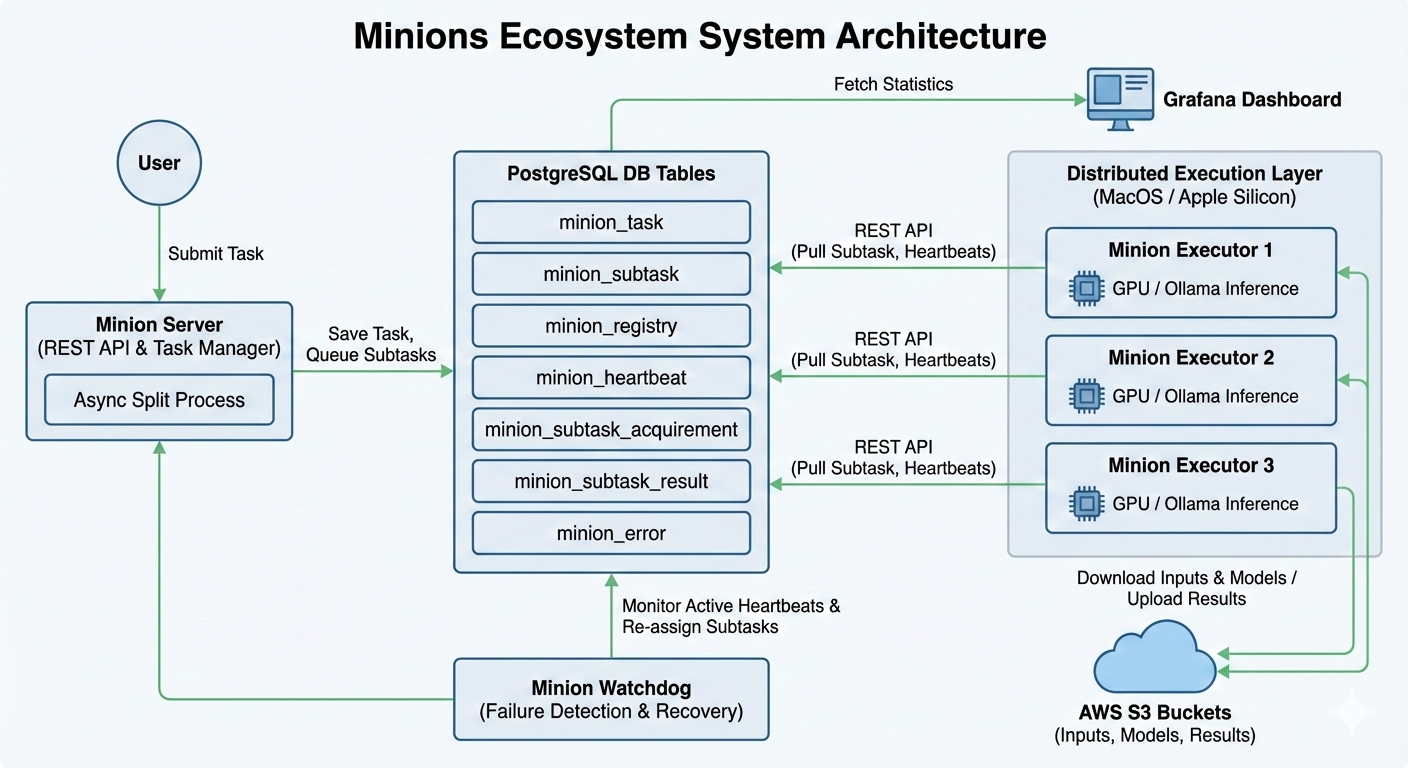
Minionsが対応しているのは、文章などのデータをAIが扱いやすい数値の形式に変換する「埋め込み生成」と、大規模言語モデル(LLM)による文章生成の2種類です。埋め込み生成にはHugging Faceのオープンソースモデルを使用し、文章生成にはMac上でLLMをローカル実行できる「Ollama」を利用しています。なお、1つのAIモデルを複数のMacに分割して動かす仕組みではなく、それぞれのMacが独立して処理を実行します。
また、処理中のMacがスリープしたり、ネットワークから切断されたり、ユーザーによって処理を停止されたりする可能性があります。そこで、各Macは5分間隔で「ハートビート」と呼ばれる稼働状況の信号をサーバーに送信します。そして、信号を監視する「Minion Watchdog」と呼ばれるシステムが応答がなくなったMacを検出すると、そのMacが担当していた未完了のタスクを待機キューに戻します。これによりMinionsでは、別のMacがタスクを取得して処理をやり直せます。
さらに、Macの所有者は自分のGPUをどのチームやプロジェクトの処理に優先的に利用するかを設定できます。Appleによると、社内ではSlackを通じてチームメンバーにMinion Executorの起動を依頼し、特定のプロジェクトに計算能力を集めることもあるそうです。
実際の運用では、従来のGPU環境で10時間以上の待ち時間が発生していた処理を、Minionsでは数分以内に開始できるケースが確認されました。研究チームは、「追加のGPU調達が不要になり、既存のハードウェアを利用することでインフラの追加コストをゼロに抑えられた」と報告しています。ただし、このコスト評価に電気代やハードウェアの消耗は含まれていません。
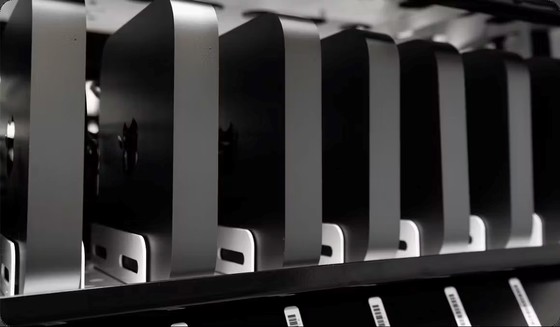
一方、課題として挙げられているのがデータの機密性です。ほかのチームや組織が管理するMacでAIの処理を実行することには、社内のデータであっても情報漏えいなどの懸念があります。この問題に対処するため、Minionsではチームや組織ごとにデータベースと処理を担当するMacのグループを分離する仕組みが用意されているとのこと。
記事作成時点でMinionsが対応しているのはAIモデルを使って結果を生成する「推論処理」だけですが、研究チームは今後、AIモデルの学習にも対応させる計画を示しています。さらに、異なる組織や世界中のMacを安全に連携させることができれば、膨大なGPUリソースを共有する大規模な分散コンピューティング基盤を構築できる可能性があると論じました。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.