Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов
Alibaba пополнила арсенал моделей искусственного интеллекта мультимодальной системой Qwen3.8-Omni-Flash. В рамках единой архитектуры она обрабатывает текст, изображения, аудио и видео, а также поддерживает контекстное окно размером 1 млн токенов. Новинка, отмечает разработчик, показывает высокие результаты в различных сценариях, включая редактирование видео, подготовку музыкальных клипов, кинопроизводство, обобщение аудиовизуальной информации и ведение диалогов в реальном времени.
Источник изображений: qwen.ai
Одним из главных достижений стало снижение стоимости сервиса. По сравнению с предыдущей версией Qwen3.5-Omni-Plus при доступе по API цена за час обработки аудиоданных снизилась более чем на 98 %, аудио и видео — более чем на 93 %. Средний результат в 29 бенчмарках вырос более чем на 25 % по сравнению с предыдущим поколением. В тестах, охватывающих работу аудио- и видеоагентов, написание кода и выполнение задач с долгосрочным планированием, модель набрала 71,0 балла в WildClawBench-MM — на 36,5 балла больше предшественницы. В UniClawBench результат составил 69,6 балла. В тесте LongAudioSpan на понимание длинных аудиозаписей модель получила 82,7 балла, в OmniVideoBench на анализ аудио и видео — 63,4 балла, в OmniCap-IF на следование инструкциям при описании видео — 28,2 балла, а в AliMeeting на расшифровку совещаний на китайском языке с участием нескольких человек — 89,7 балла.
По качеству совместной обработки звука и видео Qwen3.8-Omni-Flash приблизилась к Google Gemini 3.8 Flash, а при работе только со звуком даже превзошла американского конкурента. Система распознавания речи поддерживает 74 языка и диалекта, включая кантонский, уйгурский и маори, а система генерации — 29 языков. Обе системы поддерживают китайский, английский, корейский, французский, немецкий, испанский и японский языки.
Одной из основных особенностей модели стал механизм «агентного понимания» аудио и видео. Модель не анализирует многочасовую запись последовательно от начала до конца, а, исходя из сути запроса, сама решает, «куда смотреть и что слушать», постепенно сужая область поиска в несколько этапов. В OmniVideoBench этот механизм помог повысить результат с 63,4 до 67,8 балла, а число расходуемых на один запрос токенов сократилось со 145 736 до 79 117, или на 45,7 %. Современные решения, подчеркнули в Alibaba, плохо справляются с продолжительными аудио- и видеозаписями: программные средства для ИИ-агентов пока не имеют полноценной встроенной поддержки этих форматов, а соответствующие механизмы находятся лишь на начальном этапе развития.
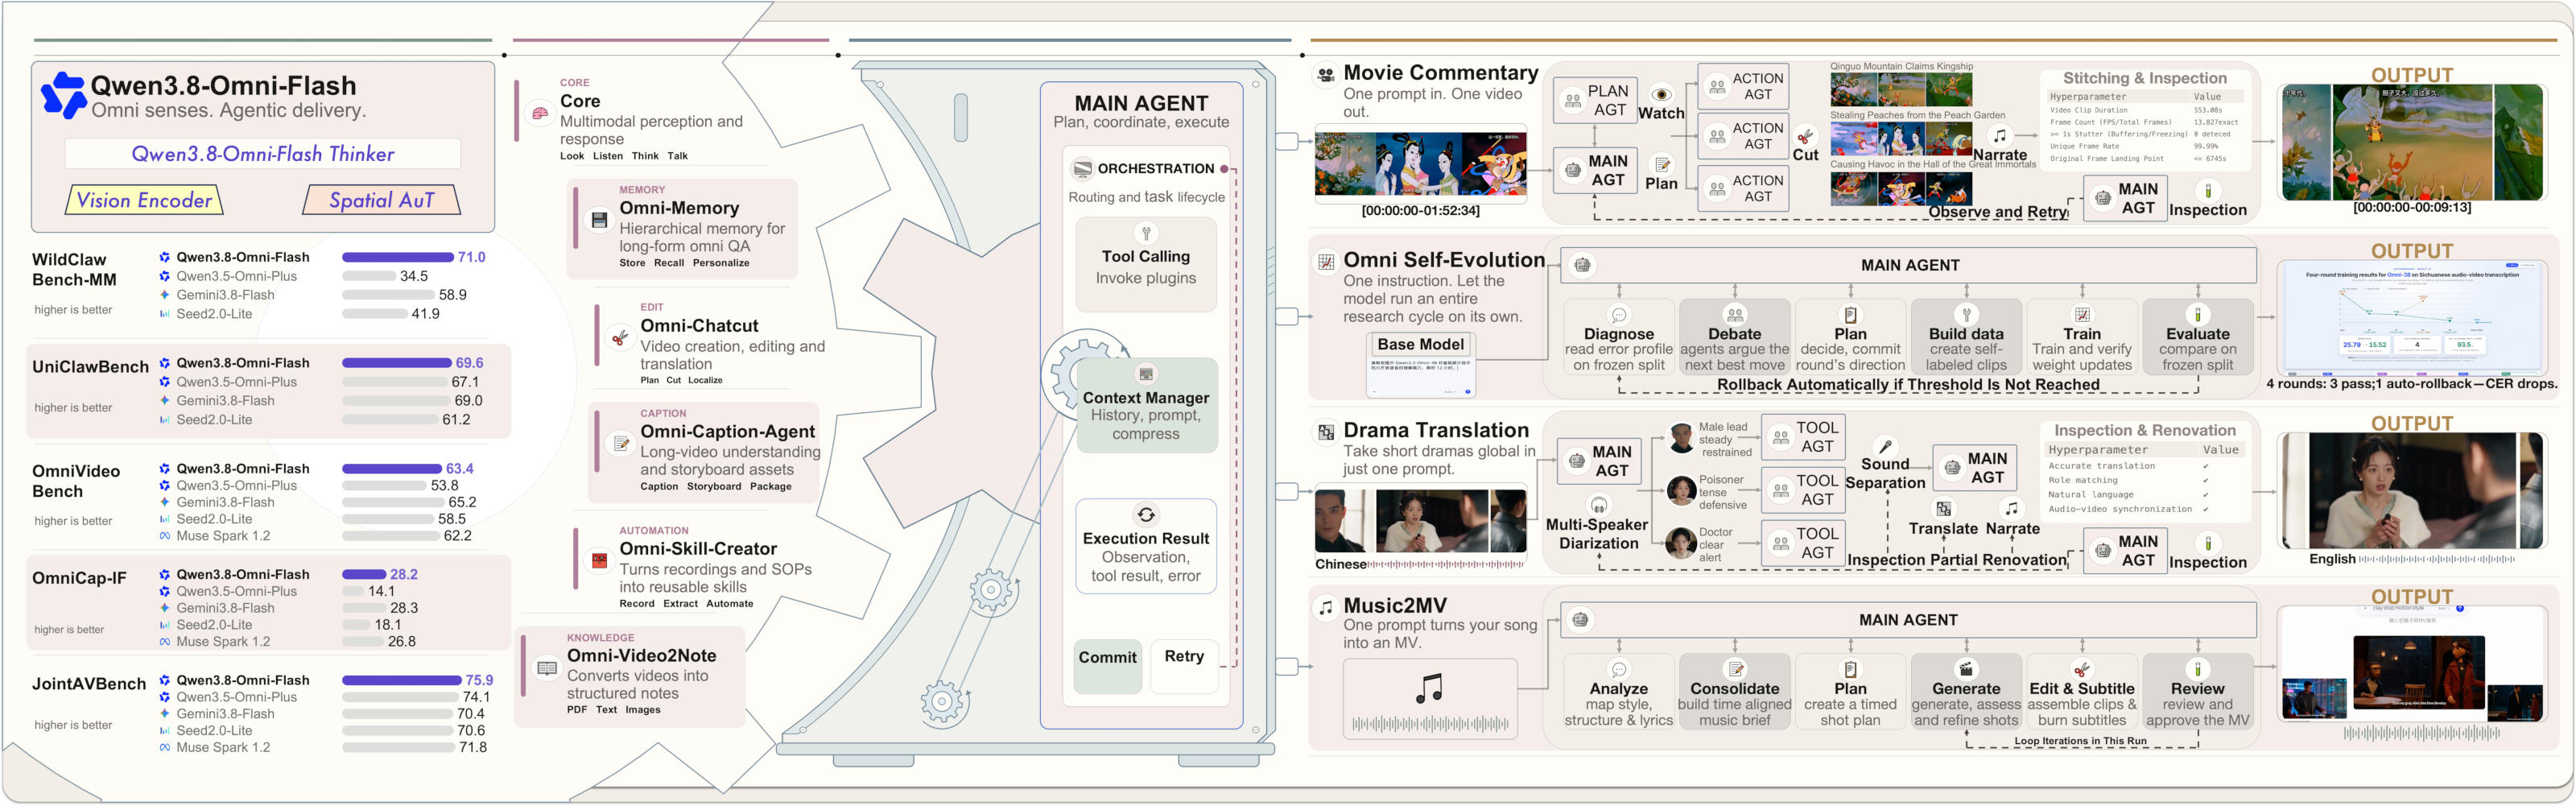
Alibaba также провела эксперимент, в ходе которого Qwen3.8-Omni-Flash использовалась для разработки другой модели ИИ. Ей поставили задачу за 12 часов улучшить распознавание сычуаньского диалекта китайского языка более компактной моделью Qwen2.5-Omni-3B. «Старшая» модель самостоятельно отобрала тестовую выборку, замерила исходные показатели и сформировала набор обучающих данных. За четыре серии экспериментов она создала 3413 обучающих примеров, благодаря которым доля ошибок при распознавании отдельных символов снизилась с 25,79 до 15,30 %, то есть на 40,7 %. Таким образом, ИИ-агенты могут не только пользоваться другими моделями, но и самостоятельно улучшать их.
Помимо самой модели, разработчик обновил сопутствующие программные средства. Набор плагинов Qwen-MM-Plugins для работы со звуком и видео получил средства контекстного поиска по медиаданным, подключения внешних инструментов и последовательной обработки продолжительных аудио- и видеофайлов. Поддерживаются различные среды для работы ИИ-агентов, включая OpenAI Codex, Anthropic Claude Code, Alibaba Qwen Code и Google Gemini CLI.
Компания также выпустила Qwen-Live Harness с открытым исходным кодом — среду для создания интерактивных приложений на базе API Qwen3.8-Omni-Flash-Realtime. Она поддерживает протоколы WebSocket и WebRTC и обеспечивает низкую задержку. По утверждению Alibaba, это первая мультимодальная модель с функцией «звуковой локализации»: объединяя данные пространственного аудио с визуальной информацией, она умеет определять направление и расстояние до источников звука.
Qwen3.8-Omni-Flash создаёт клипы на основе музыкальных композиций, готовит переводы коротких сериалов и комментарии к полнометражным фильмам, составляет PDF-конспекты обучающих видео и осваивает новые навыки по видеодемонстрациям. При переводе модель может сохранять индивидуальные особенности оригинального голоса. Доступ к Qwen3.8-Omni-Flash открыт через корпоративную ИИ-платформу Alibaba Qianwen AI.
Если вы заметили ошибку — выделите ее мышью и нажмите CTRL+ENTER.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.