ИИ-агентура и Harness: современные системы ИИ-агентов
Мир ИИ-агентов стремительно развивается. Совсем недавно ИИ-агент был обычным чатом с LLM, где он творил что хотел. Но в последнее время вы могли даже сами слышать такие вещи как скиллы, MCP, оркестрационный цикл, инструменты, управление контекстом — все это составляющие части агентской системы. И такая обвязка носит имя Harness. Этот термин родом из среды тестировщиков — Test harness — это обвязка, которая позволяет прогонять код в контролируемых условиях. А Agent Harness — уже слой инфраструктуры, который позволяет автоматизировать и оперировать рабочим окружением. Проще говоря, приближает агента к агентности, если каламбурить.
Сам агент — это LLM + Harness. При умелом использовании даже не самая лучшая модель, но с качественным Harness-окружением может обогнать использование топовой LLM, но без обвязки.
В этой статье я и расскажу, что такое Agent Harness и из каких составляющих частей на момент 2026 года он состоит.
Само слово Harness, как я уже говорил, пришло из сферы тестирования, и обозначает инфраструктуру и условия для прогона кода. В нашем случае это эволюционировало в действия, которые нужно сделать после LLM, чтобы та решала задачи качественно, и меньше слопила. На данный момент сюда входит управление контекстом, инструменты, память, скиллы, MCP, инструменты и мультиагентная логика.
В эталонном восприятии ИИ-агента LLM это всего лишь эндпоинт, который принимает JSON (или другой формат) и отдает JSON.
Без качественного harness даже топ-модель остаётся чат-ботом; с хорошим harness средняя модель решает задачи иногда даже надёжнее. Собственно, именно поэтому есть такие вещи как оркестрация и мультиагентность — дорогая модель для верификации и сложного проектирования и раздумывания, средняя для генерации и оркестрации, быстрая и дешёвая для массовых субагентских вызовов.
Такое распределение требует единого слоя доступа к разным моделям, и здесь практическим решением становится OpenAI-совместимый шлюз BotHub (https://openai.bothub.chat/v1). Официальные SDK работают без изменений, а при регистрации по реферальной ссылке начисляется 300 000 CAPS.
Дальше разберём, из чего состоит harness, как устроены MCP и skills, зачем нужны субагенты и как выбрать модели под конкретные роли — чтобы агент перестал быть демонстрацией возможностей и стал рабочим инструментом.
Что есмь упряжка?
Слово harness в прямом переводе — упряжка, а в контексте агентских систем это runtime scaffolding («строительные леса в рантайме», если переводить буквально).
Способность агента решать задачи — это не свойство модели, а эмерджентное свойство системы «модель — харнесс — среда», где харнесс опосредует, как агент видит проект, действует в нём, получает обратную связь и убеждается, что изменение завершено. Иными словами, спор «какая модель лучше» часто упирается в то, какой харнесс её окружает. Об этом же говорит и практика, один и тот же ReAct-цикл может быть реализован в десяти строках, но 95% работы агентной системы — это контекст, инструменты, песочницы и обработка ошибок вокруг этих строк.
Давайте попробуем разобраться в слоях.
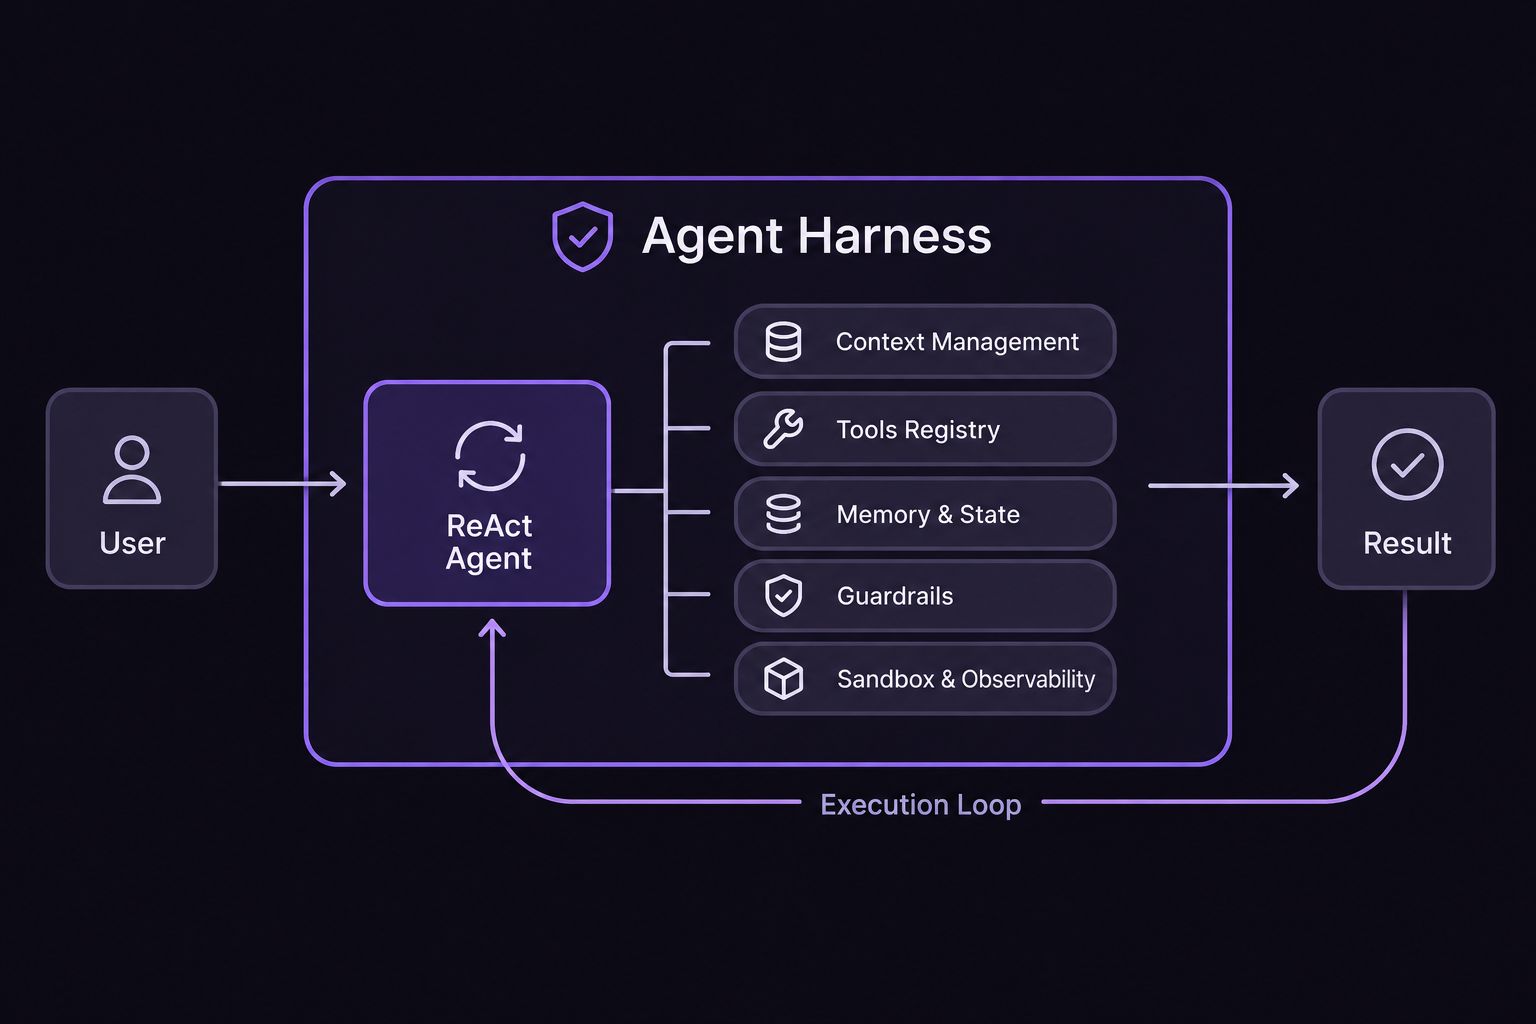
Execution loop
Цикл ReAct — это последовательность операций, выглядящая так: промпт -> модель -> парсинг -> выполнение инструментов -> возвращение результата в контексте, повторяемая до завершения задачи.
В AgentScope Java есть даже явное разделение на ReActAgent, который реализует сам reasoning-acting loop, и HarnessAgent, оборачивающий его, не меняя цикл, но добавляя workspace, долговременную память, компакцию контекста, скиллы, субагентов, песочницы и журналирование сессий.
Почему это важно? Потому что сам цикл — самая дешёвая часть харнесса. Сложность состоит в том, что непонятно когда останавливаться. Модель сгенерировала ответ без вызова инструментов — это финал или она просто, не знаю, устала? Достигнут лимит итераций — это ошибка или нормальное завершение? Здесь начинается инженерия termination conditions, который заключается в том, что появляется отдельный выход по финальному ответу, по превышению бюджета токенов, по срабатыванию guardrail, по пользовательскому прерыванию.
Context management
Контекстное окно — весьма популярная метрика ИИ. Но это не бесконечный склад, каждый вызов инструмента добавляет новые условия и новые сообщения. API LLM — stateless-сервис, поэтому вам нужно передавать весь контекст на каждый запрос.
И если этим не управлять, модель начинает тонуть в собственных логах, а ваш кошелек может значительно исхудать — контекст растет нелинейно. Поэтому сжатие контекста и кэширование контекста — важная фича. Кэширование есть кэширование, а сжатие контекста либо отрубает старые сообщения, либо фильтрует сообщения, либо модель генерирует саммари.
Кстати, здесь же живёт и выбор, что вообще попадает в промпт. Anthropic в своём харнессе для длинных задач использует context resets — полную очистку контекста с передачей структурированного handoff.
Кэшированные токены в контексте могут быть уже бесплатными или дешевыми, но все равно, лучше не эксплуатировать один чат, и создавать под каждую независимую задачу отдельный чат.
Инструменты
Инструменты попадают в модель как схемы с метаданными и параметрами. Харнесс занимается грязной работой, в виде валидации, проверки, запуске в песочницы, результатов. Эта весьма важная часть, так как дает модели руки. Да, и опять же, чаще всего инструмент это JSON/MD спецификация. Модель сама во время работы решает когда ей использовать инструмент.
Но есть небольшой нюанс — чем больше инструментов, тем хуже модель выбирает. Контекст не резиновый, не стоит забивать его описаниями инструментов. Пользовательский запрос может теряться, и модель начнет фокусироваться на баловстве с инструментами.
Memory and state
Память в агенте делится на короткую (в пределах сессии) и длинную (между сессиями).
Anthropic в Managed Agents явно разделяет сессию (append-only лог всего, что произошло), harness (цикл вызовов) и песочницу (среда исполнения), чтобы имплементацию каждого можно было заменить, не ломая остальные. Состояние не должно быть прибито к контейнеру, падение контейнера не означает потерю сессии. В общем, угадывается system design — не делай единую точку отказа.
Guardrails and permissions
А теперь насчет ответственности, защиты и разрешений. Модель может хоть что сгенерировать и хоть что использовать, но одобрение лучше оставить себе. Большинство харнесс-систем могут проверять политику, список разрешенных или запрещенных инструментов, при необходимости спрашивать разраба, и только потом продолжать действовать.
Да и если у вас не один агент, лучше распределять права на запись, исполнение, чтение и так далее, дабы не было такого, что создавался бы race cognition среди агентов.
Sandbox and observability
Ну и конечно важны две вещи — песочница и наблюдаемость. Песочница это вам не docker-контейнер, а именно изоляция от системы. Даже инфраструктура растет, появляются Cloudflare Sandboxes, Google Managed agents. А параллельно этому наблюдаемость важна не только как логи, но и как условие допуска агента. Если харнесс не может показать что агент натворил и в каком контексте — не стоит этот харнесс и одной плашки оперативной памяти для Сэма Альтмана.
В некоторых академических работах предлагают “trace-based evaluation protocol”, превращающий каждый запуск агента в аудируемый episode package — с воспроизведением, атрибуцией ошибок и детерминированными проверками.
Все 6 слоев не обязательно одинаково сильно могут быть развиты. Ведь харнесс — это набор компромиссов (можно сказать что агентные системы это поджанр system design). Где-то вы жертвуете глубиной памяти ради скорости, где-то — строгостью и защитой ради пропускной способности, где-то — централизованным оркестратором ради простоты отладки.
Харнесс кодирует предположения о том, чего модель не может сама. Когда модель меняется, эти предположения устаревают — и компонент, который вчера был несущей стеной, сегодня становится тормозом. Anthropic прямо пишут, что харнессы должны эволюционировать, и поэтому мы увидим еще много нереально “инновационных фич” в виде очередного md-файла, описывающий что-то.
А теперь перейдем к конкретным компонентам!
Skills
Скиллы — технология, построенная поверх настройки модели, промптинга и файлов. По факту это композиционный пакет процедурных знаний, который учит агента как решать задачу.
Чтобы понять суть, важно отличать скилл от инструмента (tool), который был основным строительным блоком агентов ранее. Инструмент (Tool) — это одна детерминированная функция с четким входом и выходом, описанная схемой (например, get_weather(city)). Агент просто решает, когда ее вызвать, просто исполняет. А вот скилл (Skill) — это слой суждения и оркестрации. Он представляет собой «рецепт» или свод процедурных знаний, который определяет, какие инструменты, в каком порядке и почему нужно использовать для достижения цели. Если инструмент — это молоток, то скилл — это инструкция по сборке шкафа, которая говорит, когда и как этим молотком бить.
Типичный скилл — это по факту директория с документами. Метаданные и основные инструкции в виде SKILL.md, и ресурсы в виде субдиректорий scripts, ref, assets и прочих.
Скиллы вышли на первый план не случайно. К 2026 году наметился «паритет моделей»: ведущие LLM (GPT-6.x, Claude 5.x) достигли схожего уровня в бенчмарках, и разница между ними на практике стала минимальной. Конкурентное преимущество сместилось с «сырого» интеллекта модели на инженерию — способность строить вокруг нее надежную, расширяемую систему навыков.
Но также скиллы несут уязвимости, и множество скиллов может только запутать и переусложнить все. Всё есть яд, и ничто не лишено ядовитости; одна лишь доза делает яд незаметным. А еще не стоит ставить ноунейм скиллы, да и даже известные стоит проверять на всякий случай, ибо уже были случая эксплуатации уязвимостей
Дальше начинается самое интересное — механика загрузки. Агент сначала видит только имя и описание, и лишь когда задача совпадает, открывает полные инструкции, а потом подтягивает дополнительные файлы по мере необходимости.
AGENTS.md и llms.txt
Немного поговорим о подкомпонентах харнесса, которые хоть и не входят в основной цикл, но очень важны.
AGENTS.md — открытый формат, предложенный OpenAI в августе 2025, по сути README для AI-агентов, который поддерживают не только Claude Code, но и Cursor, и другие инструменты. Он лежит в корне репозитория и содержит команды для сборки, стиль кода, разрешённые и запрещённые паттерны.
Ну вот пример AGENTS.md
# AGENTS.md

## Setup commands
- Install deps: `pnpm install`
- Start dev server: `pnpm dev`
- Run tests: `pnpm test`

## Code style
- TypeScript strict mode
- Single quotes, no semicolons
- Use functional patterns where possible
Можете посмотреть и другие примеры, например AGENTS.md из AIR — веб-фреймворка на Python, который заявляется как «designed for AI». Внутри инструкции по работе с HTML-макетами, код минимального приложения, правила маршрутизации, шаблонизация, формы, SSE, БД, общие паттерны и зависимости. По факту это выжимка из документации для разработчика с заметками и стилем кода — что-то среднее между CONTRIBUTING.md, README.md и самими доками.
llms.txt и llms-full.txt — стандарт от Answer.AI, предложенный в сентябре 2024 года и с тех пор заметно распространившийся. llms.txt — индекс, то есть обычный файл со списком ссылок на документацию, который агент сканирует и решает, что читать дальше. llms-full.txt — полный текст документации в одном файле, который скачивается один раз и держится в контексте. Логика простая и связана с токен-экономикой — агенты ограничены по токенам, и им выгоднее прочитать один файл, чем ходить по двадцати ссылкам и парсить HTML.
Как собрать llms-full.txt? Склейте все страницы документации в один файл — markdown, rST или любой похожий формат.
Эти файлы лучше класть на сайт документации — как сделано в проекте django-modern-rest: https://django-modern-rest.readthedocs.io/llms.txt и https://django-modern-rest.readthedocs.io/llms-full.txt.
MCP vs A2A: инструменты и координация — разные слои
MCP и A2A — это два открытых протокола, которые решают разные, но взаимодополняющие задачи в экосистеме ИИ-агентов. MCP дает агенту “нервы” для доступа к инструментам (если уж инструменты у нас руки модели, то MCP — нерв), а A2A — «коллег» для совместной работы.
MCP — это открытый протокол (изначально созданный Anthropic), который стандартизирует способ подключения LLM-приложений к внешним источникам данных и инструментам. Строится по модели «клиент-сервер». Хост-приложение (например, IDE или чат-интерфейс) через клиента подключается к MCP-серверам, которые предоставляют контекст и возможности. Это вертикальная интеграция — агент «смотрит вниз» на инструменты. MCP оптимизирован для быстрых, структурированных запросов и ответов (request-response).
A2A — это горизонталь, открытый протокол (представленный Google), который позволяет автономным ИИ-агентам общаться друг с другом, обмениваться информацией и координировать действия, даже если они построены на разных фреймворках или у разных поставщиков. Обеспечивает взаимодействие между равноправными (peer-to-peer) агентами. В отличие от инструмента в MCP, удаленный агент в A2A — это полноценная автономная система со своей моделью, инструментами и суждениями. Он может принять задачу, задать уточняющий вопрос, работать в течение длительного времени или отказаться от выполнения.
Кстати, забавно как ИИ-агенты дали новое дыхание классическим UNIX утилитам — grep, find, cat, sed и так далее.
Оркестрация и субагенты
А вот тут самое интересное. Мультиагентность делится на централизованную модель оркестратор-агенты и децентрализованную модель роя агентов.
Централизованная модель стала мейнстримом благодаря Anthropic. В их харнессе для длинных автономных задач финальная архитектура оказалась трёхзвенной: planner, generator, evaluator. Идея подсмотрена у GAN-ов: генератор создаёт, эвалуатор оценивает по заранее выбранным критериям, планировщик декомпозирует работу на куски, которые можно проглотить.
Но такая архитектура стоит дорого. Трехзвенный централизованный харнесс может довести задачу до полного приложения за часы, но счет вырастает в разы, по сравнению с одиночным агентом.
И вот здесь хочется сделать небольшое отступление про выбор моделей под роли. Если у вас есть условный planner, generator и evaluator, логично, что это не обязательно одна и та же модель. Дорогая — на верификацию и сложное проектирование, средняя — на генерацию, быстрая и дешёвая — на массовые вызовы субагентов. Такое распределение требует единого слоя доступа к разным моделям, и здесь практическим решением становится OpenAI-совместимый шлюз BotHub.
Децентрализованная модель выглядит иначе. Microsoft Research выпустила Agensh — харнесс без ведущего агента и без центрального оркестратора. Каждый воркер сам забирает подзадачу, делится находками и мержит код в общий Git-репозиторий. Масштабируется с одного агента до 1024 на ProgramBench, 16 узлов по 64 агента. На некоторых задачах рост с 1 до 1024 агентов поднял итоговый test-pass rate с 33,89% до 55,06%. Но масштабирование постепенно перестает окупаться.
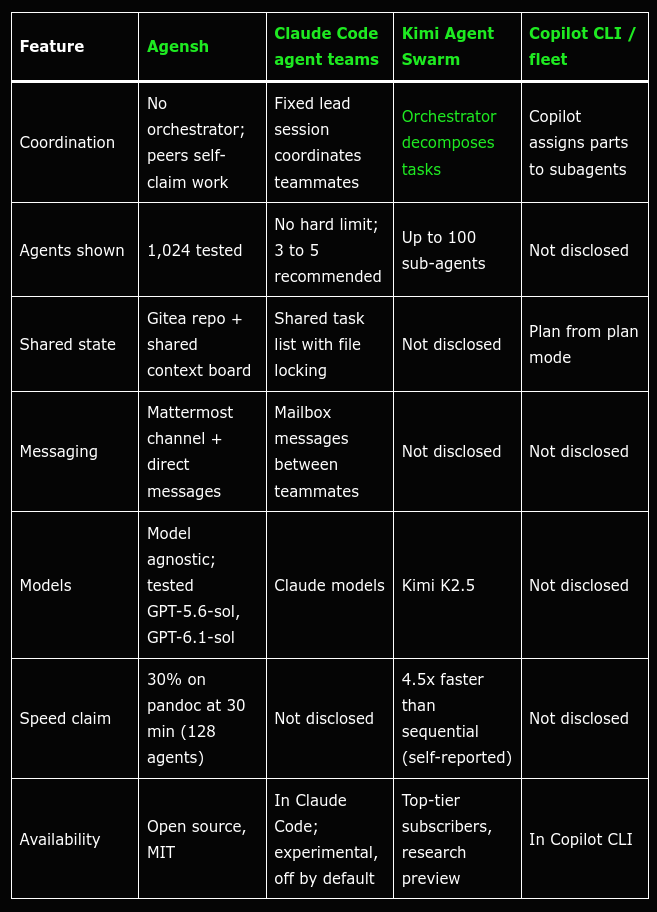
Agensh не заменяет работу через одного агента, а надстраивается над ним. В экспериментах использовался GitHub Copilot CLI, и через тонкий адаптер подключаются Claude Code и другие харнессы. То есть децентрализация — это попытка убрать одну точку принятия решений и создать рой.
Заключение
Начнем с банального, харнесс все таки это поджанр system design, можно даже сказать программный продукт. У него есть версии, зависимости, регрессии, жизненный цикл. Каждый харнесс эволюционирует и обретает новые фичи, используя современные стандарты, форматы, и пытается переосмыслить классические инструменты.
Кроме того, нужно понимать, что харнесс тоже может деградировать, поэтому тестировать систему тоже нужно. И саму систему, и выхлоп ее ИИ-агентов. Google в блоге для разработчиков идёт ещё дальше и предлагает behavioural evals — проверять отдельные наблюдаемые действия, то есть задал ли уточняющий вопрос на неполном промпте, запустил ли валидатор перед тем, как объявить работу завершённой, дал ли канонические ссылки в документации.
Теперь про безопасность. Skills и MCP снижают vendor lock-in, но одновременно расширяют поверхность атаки, и это не абстрактное предупреждение. В 2025–2026 годах зафиксированы целые классы атак именно на уровне харнесса, по типу вредоносных инструкций, спрятанных в SKILL.md или в reference-файлах, инъекции через описания инструментов MCP, включая невидимые Unicode-символы и ANSI-последовательности, «rug pull», когда сервер после авторизации подменяет описание инструмента, и атаки на выбор инструмента, при которых точность выбора падает ниже 20%. И это не считая классического перегруза фичами.
Еще стоит понимать, что не нужно строить себе второй OpenClaw (эх, так взорвал интернет, но в итоге сейчас ни слуха…), ибо агенты должны выполнять одну задачу, это настоящая система, цепочка, имеющая свои издержки.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.