[Перевод] Ловушка декогеренции
Прим. пер.: слово «когеренция» условно означает «согласованность», а «декогеренция» — «несогласованность».
В этом эссе рассматривается понятие декогеренции (decoherence): накопление локально допустимых, но взаимонесовместимых или избыточных моделей в рамках системы, при котором стоимость изменений в основном определяется переводом между этими моделями и предотвращением непредвиденных побочных эффектов.
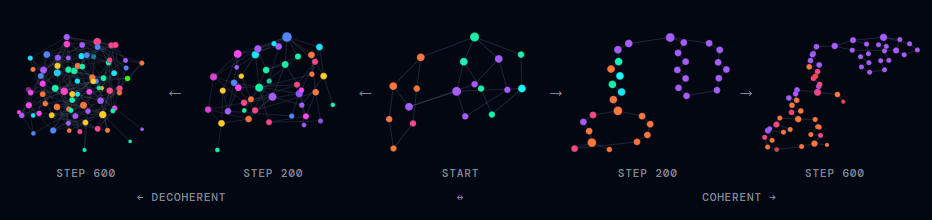
Другими словами, это то, что происходит, когда «слоп» (slop — мусор) заглушает сигнал в бесконечном море шума.
Декогерентность возрастает пропорционально скорости изменения системы, и чем более декогерентной является система, тем быстрее она увеличивается, что приводит к неуправляемому экспоненциальному росту. Это не новое явление, и люди всегда противодействовали ему, тщательно изыскивая способы делать больше с меньшими затратами, объединяя разрозненные модели и паттерны в единое целое. Однако широкое использование ИИ в настоящее время приводит к его возникновению с неустойчивой скоростью.
Хорошая новость в том, что это исключает призрак безудержного рекурсивного самосовершенствования (recursive self-improvement), взрывного роста интеллекта, который достигает параболической траектории прежде, чем кто-либо успеет отреагировать, поскольку декогеренция препятствует улучшению ИИ в замкнутом пространстве (bubble — пузырь) и ограничивает скорость его развития за пределами этого пространства. Плохая новость в том, что мы стремительно движемся к другому типу катастрофы: коллапсу декогеренции (Decoherence Collapse).
Представьте себе здание, скажем, небольшую офисную высотку. При строительстве этого здания использовали трубы такого типа, которые со временем изнашиваются и в конечном итоге требуют замены. Это стандартный инфраструктурный долг (infrastructural debt); обычный износ, как говорится.
Допустим, пришло время заменить трубы, и нам нужно перейти на новый стандарт. Это может быть связано с новыми требованиями строительных норм, с тем, что старые трубы больше не производятся, или с тем, что новые трубы намного лучше и проще в обслуживании. Это стандартный пример долга технического прогресса (technical advancement debt) — необходимость модернизации и перехода в связи с прогрессом технологий с течением времени.
Существует третий вид задолженности, который может возникнуть в зависимости от способа замены старых труб на новые. Рассмотрим следующие варианты:
Останавливаем работу всего здания и заменяем все трубы одновременно. Это очень трудоемкий и дорогостоящий вариант, поскольку здание нельзя использовать во время проведения работ, и за замену необходимо заплатить авансом. Но к концу процесса все будет завершено.
Отключаем каждый этаж по очереди и заменяем трубы поэтажно. В целом это менее трудоемкий вариант, но несколько дороже, поскольку нам все равно придется платить авансом, а также дополнительно оплачивать работу, необходимую для поддержания бесперебойной работы остальной части здания по мере выполнения работ.
Заменяем трубы по мере необходимости, когда они начинают выходить из строя. Это наименее затратная стратегия, позволяющая амортизировать стоимость замены всех труб с течением времени, выполняя один мелкий ремонт за другим.
Для большинства людей вариант 3 очень привлекателен. Он позволяет поддерживать бесперебойную работу и распределять затраты на техническое обслуживание. И если мы можем просто обновить корабль Тесея и заменить трубы по одной, почему бы нам этого не сделать?
Во-первых, это создает декогерентность.
А декогерентность — это, безусловно, наихудшая форма технологического долга.
> Эволюция
Корабль Тесея на самом деле дает нам хорошее представление о подлинном масштабе декогеренции. Мы знаем, как строить корабли из дерева, и мы знаем, как строить корабли из стали. Можно ремонтировать корабль по частям, используя один и тот же материал, как предполагал первоначальный мысленный эксперимент, и корабль останется функциональным, сохранив все первоначальные конструкции и элементы дизайна.
Но знаем ли мы, как построить каждую модификацию корабля, используя дерево и сталь? Можно ли, скажем, постепенно заменить каждую деталь старого военного корабля и превратить его в современный эсминец? И чтобы он был функциональным (в каком-либо понимании функциональности) на каждом этапе этого процесса?
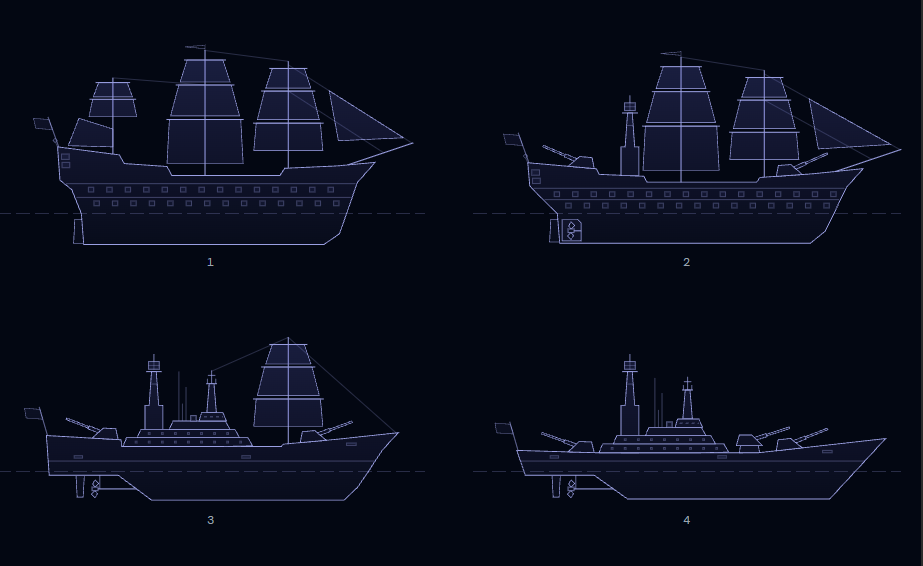
Это не значит, что ответ однозначно «нет». Если мы проявим достаточно креативности, если над этим будут работать лучшие умы, то, я уверен, найдется какой-то способ это осуществить. Но для этого потребуются изобретательность, мастерство и профессионализм. Потребуется внимание к деталям. И, что крайне важно, нужно будет довести процесс до конца, потому что корабль, наполовину фрегат, наполовину эсминец, вряд ли будет очень эффективен в современных боевых действиях.
Возвращаясь к нашему примеру с сантехникой, мы видим, как та же стратегия регулярно применяется в строительстве. Каждый раз, когда лопается труба, вызывают сантехника, вскрывают стены, ремонт выполняется вручную для конкретного участка, а затем все снова заделывают. Если повезет, сантехник оставит подробные записи, а если нет, то спустя годы какой-нибудь бедолага снова вскроет эту стену и спросит себя: «Что, черт возьми, здесь происходит?».
Теперь умножьте этот процесс на время, по мере того как мы постепенно заменяем трубы в нашем здании, и в результате вы получите лоскутное одеяло из старых и новых труб, которое гораздо сложнее, чем любая из этих систем по отдельности. Каждое соединение, каждая изготовленная вручную заплатка — это свой собственный маленький набор уникальных сил и свойств, которые недостаточно изучены, и поэтому для полного понимания и работы с ними требуется эксперт по обеим системам.
На первый взгляд, все в порядке. Трубы работают, неважно, как именно? Главное, чтобы заплатка была качественной, какая разница?
А что, если мы, скажем, захотим добавить пристройку?
Для целей нашего мысленного эксперимента предположим, что воду для пристройки необходимо проложить как минимум через часть существующего здания, используя имеющиеся трубы. И, что крайне важно, нам необходимо увеличить общее давление воды в системе.
Теперь вопрос: безопасно ли повышать давление?
Если бы у нас были трубы только типа А или только типа Б, даже те, которые со временем были отремонтированы и залатаны, то это был бы простой вопрос. Обе системы хорошо изучены, в обеих есть инструменты и процессы для расчета их пропускной способности, и люди постоянно проводят эти расчеты.
Но если у нас есть неизвестная смесь обеих систем, то внезапно нам приходится проводить гораздо больше анализа, чтобы ответить на этот вопрос. Каждый фрагмент может изменить ответ, даже те, что находятся на другом конце системы, потому что все они взаимосвязаны.
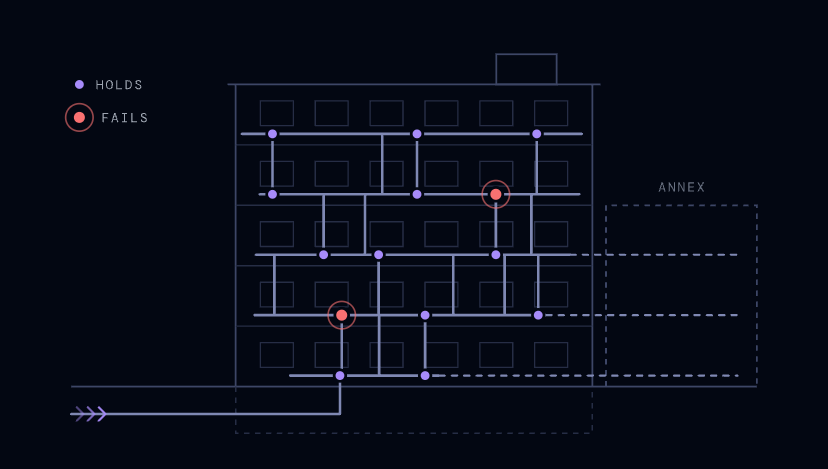
Именно здесь становится очевидной истинная сложность декогеренции. Когда мы пытаемся внести изменения в декогерентные системы, это требует гораздо больше знаний и навыков, чем работа с каждой системой по отдельности. Инженер, работающий над системой, должен отслеживать и понимать ее гораздо тщательнее и внимательнее, потому что его изменения могут иметь непредвиденные последствия.
Это непростая задача, и лучше не торопиться. Но для стороннего наблюдателя, не понимающего всей глубины проблемы, это может быть неприятно. Обычно эта часть выполняется легко. Почему же на этот раз это занимает так много времени?
В подобных ситуациях руководство часто оказывает давление, чтобы ускорить процесс. Под давлением эксперт не проводит полный анализ быстрее; он просто останавливается раньше и делает то, в чем он уверен в достаточной степени. Некачественное соединение, необычная деталь, возможно, дополнительные меры предосторожности на всякий случай.
Однако некачественное выполнение задачи приводит к цепной реакции: это конкретное изменение имеет более низкое качество и делает систему более хрупкой и сложной. Это означает, что следующее изменение потребует еще больше внимания и тщательности, и если давление на инженера останется прежним, то он выполнит работу еще хуже.
В нынешнем виде ситуация довольно запутанная, и уже сейчас можно наблюдать экспоненциальный рост сложности. Но подождите, дальше будет еще хуже! Давайте рассмотрим следующий уровень декогеренции: начало второго перехода до завершения первого.
> Лабиринт
Сложность программного обеспечения, в отличие от физического здания или других типов реальных систем, заключается в том, что оно в некотором смысле невидимо.
Программисты каждый день проходят по коридорам кодовых баз. Мы так часто успешно преодолеваем этот лабиринт, что знакомимся с каждым углом и каждым поворотом, и когда наши прогулки становятся длиннее, с большим количеством коридоров, тупиков и ловушек, мы ощущаем это гораздо быстрее и интуитивнее.
Но это сложно объяснить людям, которые даже не видят лабиринт, которые не ходят по нему с вами каждый день. А когда дело доходит до погашения долгов, упрощения и уменьшения извилистости лабиринта, ваши предложения трудно продать даже тем, кто когда-то давно ходил по лабиринтам. В конце концов, никто из них не знает ваш лабиринт. Они не знают, с какими трудностями вы сталкиваетесь каждый раз, когда входите в него.
В отличие от них, наш друг-сантехник в реальной жизни может гораздо нагляднее показать владельцу здания абсурдность его труб.
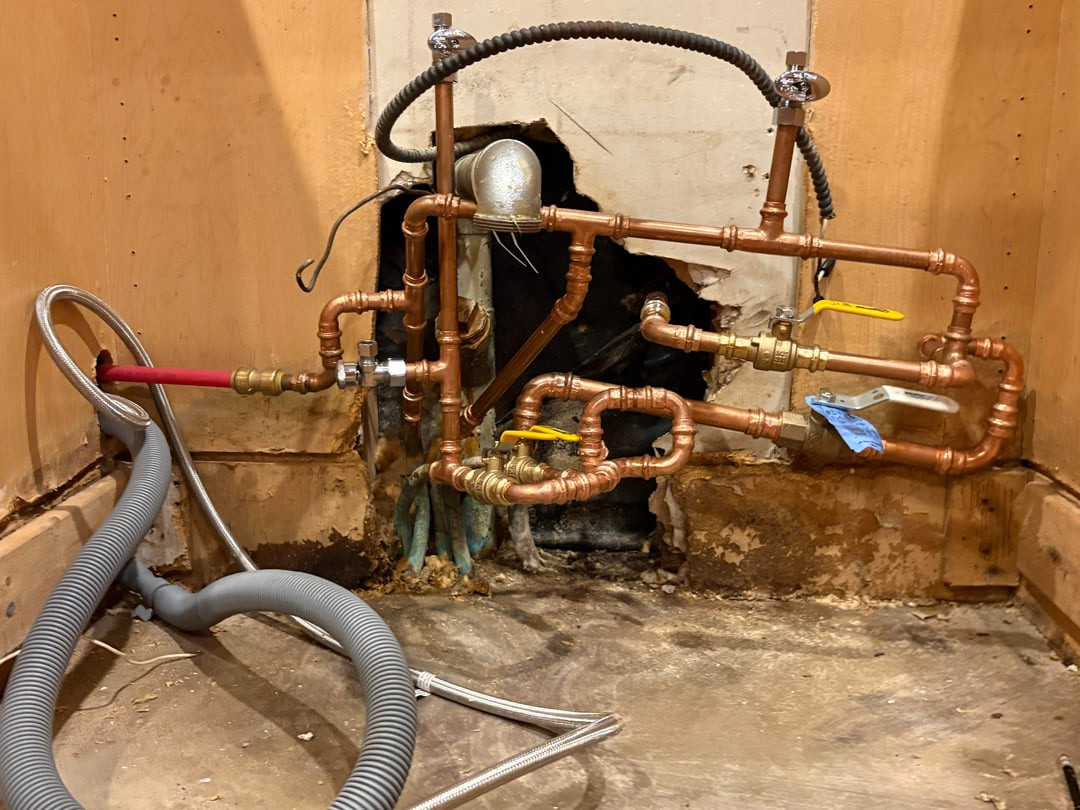
Когда мы начинаем смешивать более двух систем, добавляя множество фрагментов с течением времени в произвольном порядке, сложность лабиринта резко возрастает. Теперь он становится комбинаторным: нужно продумать последовательность A -> B, A -> C, B -> C, A -> B -> C, C -> B -> A и т.д.
Конечно, мы можем в некоторой степени оградить инженеров от этого. Мы можем разработать лучшие практики, использовать инструменты и структуры для изоляции одной части системы от другой (например, с помощью клапана ограничения давления в наших трубах). Однако неизбежно наступает момент, когда даже лучшие инженеры, самые умные люди, уже не могут безопасно ориентироваться в этом лабиринте.
Возможно, им это удастся в 80 или 90% случаев, но в конечном итоге они все равно свернут не туда.
Это ловушка декогеренции (decoherence trap). Лабиринт разрастается все дальше и дальше, пока не поглотит нас целиком, оставив блуждать в темноте. Пока не станет настолько огромным, что на его прохождение будет уходить целая жизнь.
Ну, по крайней мере, для людей это продолжительность жизни. А что насчет ИИ?
> Симуляция
Люди устают и достигают физических пределов, но рои автономных агентов могут работать круглосуточно, коллективно и неустанно исследуя лабиринт, как и подобает хорошим маленьким роботам. Если проблема в масштабе, разве мы не можем просто увеличить вычислительные мощности и на этом остановиться?
Ну, это зависит от характера сложности, с которой мы сталкиваемся. Это:
Линейный рост с увеличением размера всей кодовой базы, ИЛИ
Экспоненциальный рост, при этом каждое изменение увеличивает вероятность того, что следующее изменение добавит еще больше сложности.
Если речь идет о первом варианте, то да, по мере роста масштаба проблемы мы можем просто добавлять все больше агентов и центров обработки данных, решая задачу примерно с той же скоростью. Но если речь идет о втором варианте, то увеличение мощности позволит нам продвинуться лишь немного дальше, прежде чем размер лабиринта будет угрожать исчерпанием всех вычислительных ресурсов на Земле (и в космосе, если планы SpaceX реализуются).
По моему опыту, чаще всего происходит второе. Когда сантехник вскрывает стену и видит беспорядок, ему непонятно, что происходит. Он может выбрать трубу А, трубу Б или, в своей растерянности, установить совершенно новый тип трубы. То же самое в еще большей степени относится и к строительным нормам.
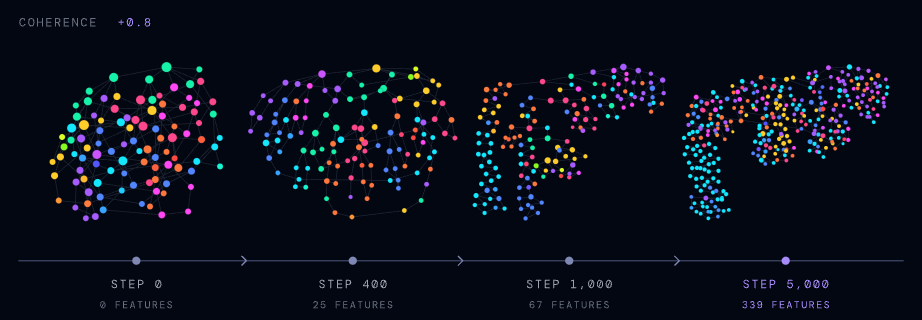
Мы можем увидеть это на примере простой симуляции ниже. Здесь представлен граф, иллюстрирующий кодовую базу (или другую сложную систему), где:
узлы представляют различные компоненты внутри системы;
размер узла представляет собой размер компонента;
цвет узла отражает доминирующую парадигму, к которой принадлежит компонент. Можно рассматривать это как «тип» компонента — различные материалы труб, различные конструкции в коде, различные типы систем и т.д.;
ребра представляют собой связи между этими компонентами.
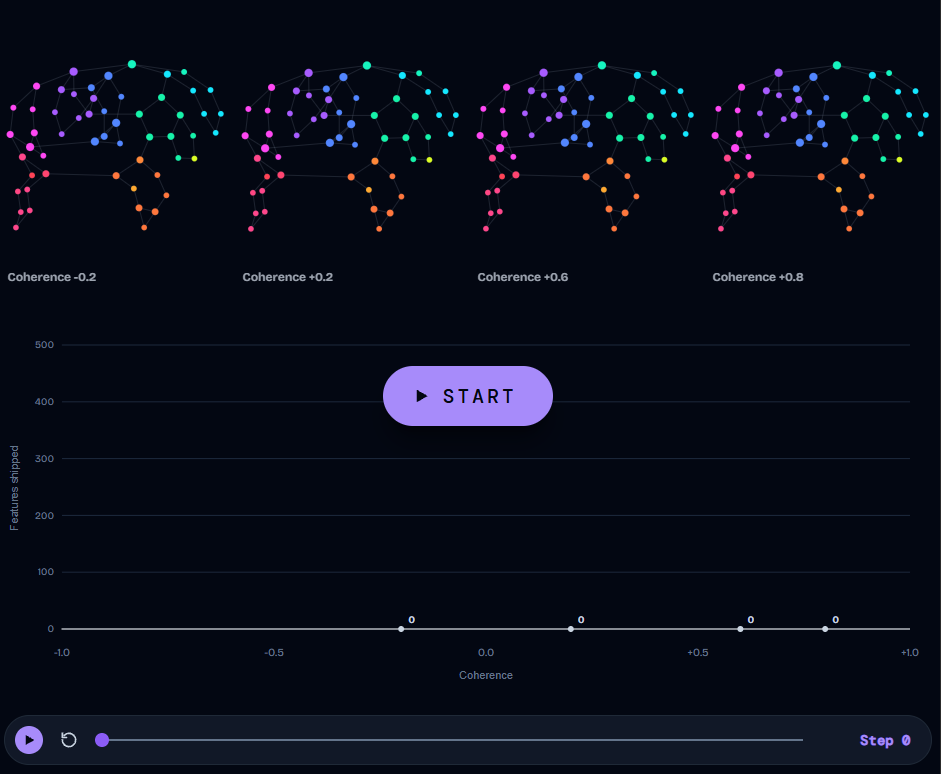
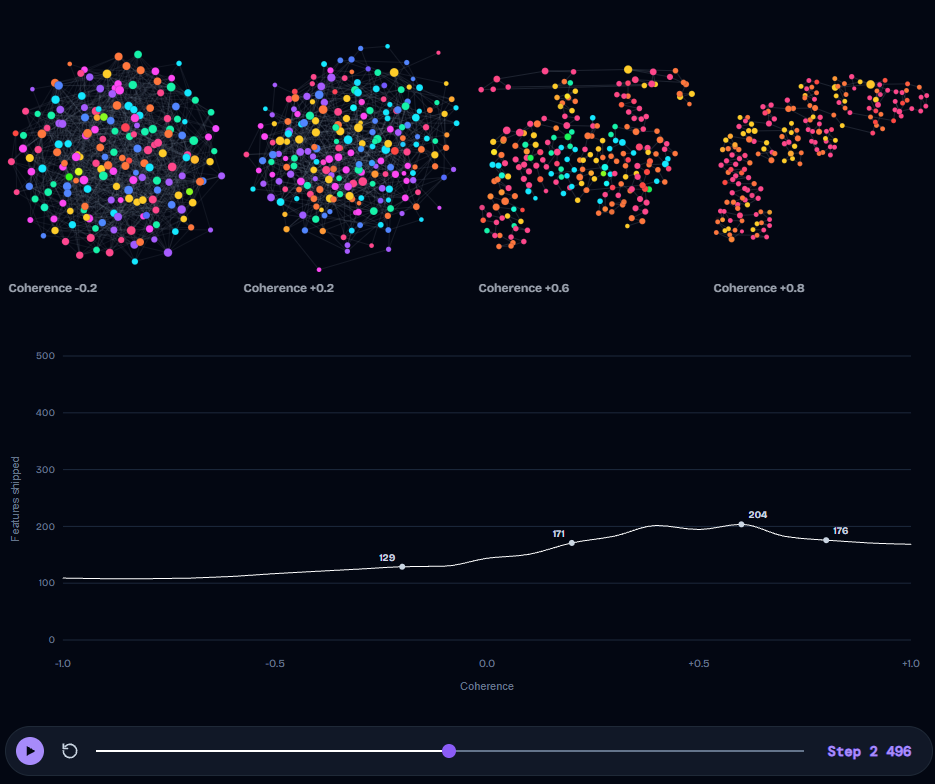
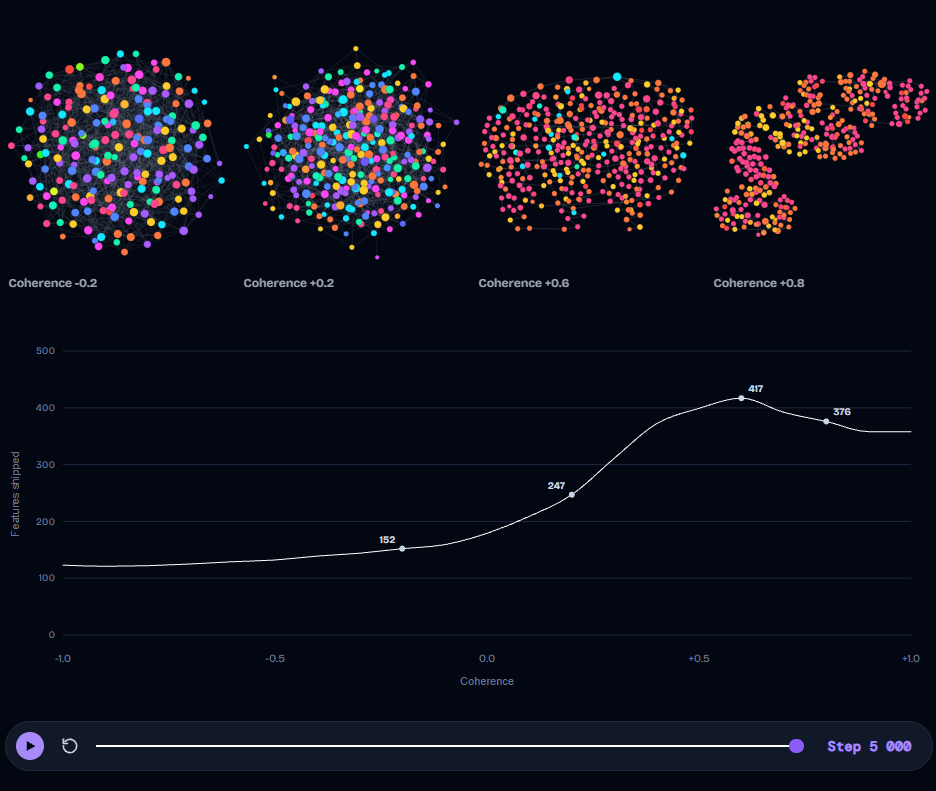
Это запись нескольких запусков. Если вы хотите поиграть с полной симуляцией, изменить настройки и посмотреть, что получится, вы можете найти ее здесь.
Актор, представляющий разработчика, реализует «функцию», проходя по случайному участку графа и затем изменяя его. Базовое поведение актора определяется его коэффициентом когерентности (coherence factor).
Низкая когерентность означает, что актор быстрее решает проблему, но принимает поспешные решения, предпочитая простые решения, не учитывая контекст, и в целом усложняет граф.
Более высокая когерентность означает, что актор тратит больше времени и подходит к каждой проблеме более обдуманно, и, следовательно, имеет больше шансов внести менее сложные изменения или даже устранить сложность.
Поначалу актор с меньшей когерентностью движется очень быстро по сравнению с актором с большей когерентностью. Однако, по мере изменения графа, это также влияет на перемещения. Каждый из следующих факторов замедляет продвижение актора:
Более высокая степень связности (количество ребер). Это отражает дополнительную нагрузку, связанную с необходимостью, по крайней мере частично, извлекать контекст каждого смежного узла, чтобы понять его влияние на текущий узел.
Переходы между цветами. При переключении парадигм в процессе реализации функции возникают дополнительные затраты, и от пользователя требуется заново осваивать контекст и понимание каждой парадигмы, а также того, как они связаны между собой.
Длина пути. Сам путь может значительно увеличиться, поскольку требуется больше связей и переходов. Это означает, что актору необходимо больше читать и возвращаться к информации, чтобы получить весь необходимый контекст для реализации функции, и этот показатель может бесконечно расти, пока не будет достигнут размер всей системы (то есть, чтобы внести изменения в любом месте, нужно понимать все).
Если мы возьмем распределение характеристик, сформированных с течением времени и обладающих согласованностью, мы можем построить график результата и увидеть форму, которая должна быть знакома любому инженеру: оптимальная точка (sweet spot).
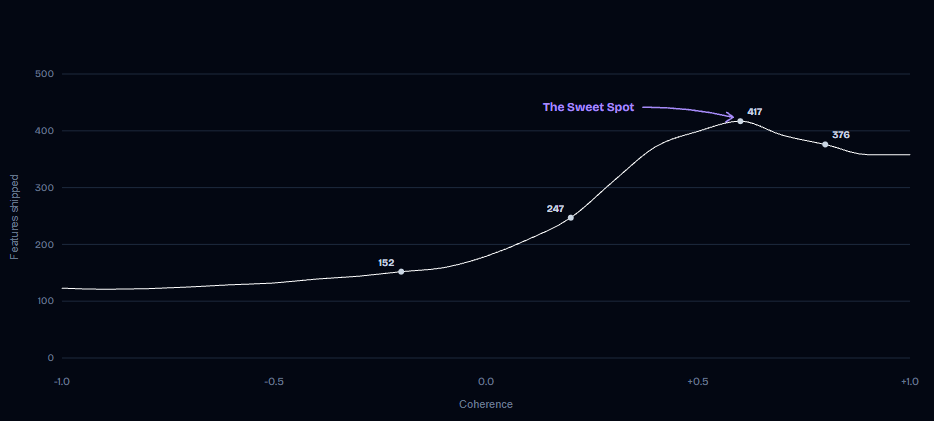
В оптимальной точке система относительно стабильна, и мы активно инвестируем в нее, чтобы она оставалась такой. Существует несколько доминирующих парадигм, но есть достаточная нестабильность, чтобы со временем все могло меняться и адаптироваться, и мы не слишком перфекционисты во всем.
Выше оптимальной точки мы прилагаем огромные усилия, чтобы каждый новый узел вписывался в существующие парадигмы, и устраняем сложность на каждом этапе. Это занимает гораздо больше времени и замедляет разработку новых функций, но в худшем случае все равно позволяет создать высокосогласованную систему, которую можно относительно быстро дорабатывать.
Ниже оптимальной точки происходит резкое падение производительности. Мы очень быстро теряем скорость по мере экспоненциального усложнения кодовой базы. Если коэффициент согласованности отрицательный, и не уделяется должного внимания поддержанию согласованности, то время на внедрение новой функции увеличивается без видимых ограничений.
Мы также можем увидеть, как различные стратегии влияют на систему с течением времени, исходя из разных начальных точек. Если мы начнем с высококогерентной системы и будем использовать преимущественно декогерентную стратегию (когерентность +0,2, при которой сохраняется некоторая когерентность, но все же используются упрощенные подходы), то график сначала будет медленно деградировать, прежде чем достигнет нескольких точек перегиба и попадет в ловушку.
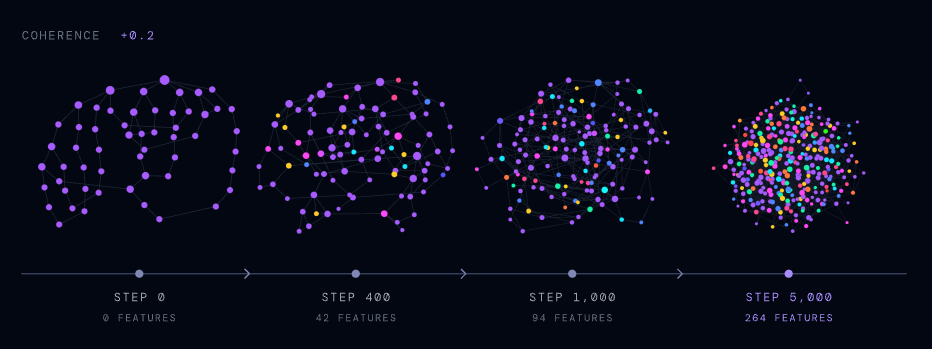
Напротив, если мы возьмем систему, которая изначально является декогерентной, и приложим усилия для ее восстановления с течением времени, то мы сможем приблизить ее к когерентности и ускорить процесс.
Критики могут возразить, что в этой симуляции используются произвольные веса, и она не доказывает однозначно, что именно так будут развиваться сложные системы. Я этого не утверждаю.
Моделирование показывает, что эта кривая может существовать как результат простых правил и локальных решений. Действия участников, изменяющих систему сегодня, могут улучшить или ухудшить возможность будущих участников изменять систему завтра. Это очевидная истина, но я думаю, что ее значение легко упустить из виду, если мы не можем увидеть сложность системы так же, как в реальном мире, с трубами, проводами и физическим оборудованием.
Итак, мы возвращаемся к вопросу об агентах: могут ли агенты работать в этих системах и поддерживать согласованность? Или же со временем они вносят даже незначительную декогеренцию? Потому что здесь есть еще один важный риск, который следует учитывать: декоренция не нарастает со временем, а возникает при изменении.
Если сегодня построить декогерентную систему, а затем прекратить ее изменения на 10 лет и вернуться к ней, она останется точно такой же декогерентной, какой вы ее оставили. В ней могут быть и другие виды технического долга, но они не связаны с декогеренцией. Декогеренция возрастает или уменьшается только при внесении изменений в систему.
А если вы вносите много изменений очень быстро, то декогеренция может развиваться столь же быстро. Даже очень незначительное увеличение декогеренции может выйти из-под контроля, прежде чем мы это осознаем.
Дело в том, что мы сталкиваемся с этим явлением гораздо, гораздо дольше, чем существует разработка агентных систем. В каждой компании, где я когда-либо работал, наблюдалось огромное количество декогеренции, и менее опытные инженеры, а также инженеры, работающие под давлением, также склонны к увеличению декогеренции с течением времени, так что нельзя сказать, что люди в этом отношении идеальны.
На самом деле, я бы осмелился сказать, что большинство компаний работают где-то значительно ниже оптимального уровня, и, по сути, функционируют в непрерывном цикле, где:
Декогеренция нарастает до такой степени, что ни одну из функций нельзя завершить в разумные сроки.
Прилагаются значительные усилия для уменьшения декогеренции.
Эти усилия приносят результаты, и новые функции снова начинают выпускаться, хотя и медленно, но приемлемо.
Усилия не завершены, или, если и завершены, то все еще не доводят нас до оптимального результата. Ресурсы и приоритеты перераспределяются, и система снова начинает распадаться.
Помыть, почистить, повторить. Некоторые компании восстанавливаются быстрее и дольше, чем другие, и лишь очень небольшой процент из них умудряется оставаться в оптимальном положении с течением времени, но для этого необходима целенаправленная культура инженерного совершенства.
Вопрос в том, действительно ли агенты на данном этапе превосходят среднестатистическую инженерную культуру? И притом значительно превосходят?
Пока мы не обнаружили этому никаких доказательств. Более того, предварительные исследования указывают на обратное.
Исследование Гарвардского университета, охватившее 718 компаний, показало, что внедрение агентов-программистов увеличило объем написанного кода на 30%, но не привело к измеримому увеличению количества завершенной работы. Дополнительный код вместо этого накапливался на этапе проверки: запросы на слияние (pull requests) стали проверяться на 49% дольше, и почти вдвое больше запросов на внесение изменений были возвращены. Исследование Университета Карнеги-Меллона, посвященное проектам с открытым исходным кодом, которые внедрили Cursor, выявило значительный скачок скорости разработки, который, однако, не был устойчивым, наряду с увеличением сложности кода, которое сохранилось, и что добавленная сложность сама по себе стала основной причиной последующего замедления. А анализ более 300 000 коммитов, созданных ИИ в более чем 6000 репозиториях, показал, что примерно каждый одиннадцатый из них, и до одного из семи в зависимости от помощника, содержал как минимум одну проблему качества, и что почти четверть этих проблем до сих пор остаются в коде.
Больше кода, тот же объем выполненной работы, но с каждым изменением растет сложность.
> Прогрессия
Теперь давайте рассмотрим главный контраргумент, а именно аргумент о технологическом прогрессе. Он звучит примерно так:
Первое поколение агентов будет создавать код не очень высокого качества, но пока он “достаточно хорош”, они все еще могут заменить людей в большинстве задач программирования, и мы можем строить наши процессы вокруг них, ожидая появления более совершенных агентов в будущем.
По сути, это история автоматизации во времена промышленной революции, где первое поколение текстильных машин действительно было намного хуже людей, но в конце концов они их догнали и перегнали. Как отметил Кори Доктороу, промышленники стремились внедрить автоматизацию, потому что она позволяла им дисциплинировать труд и укреплять власть за счет рабочих и населения, которым приходилось терпеть гораздо худшие условия труда и товары худшего качества на протяжении поколений.
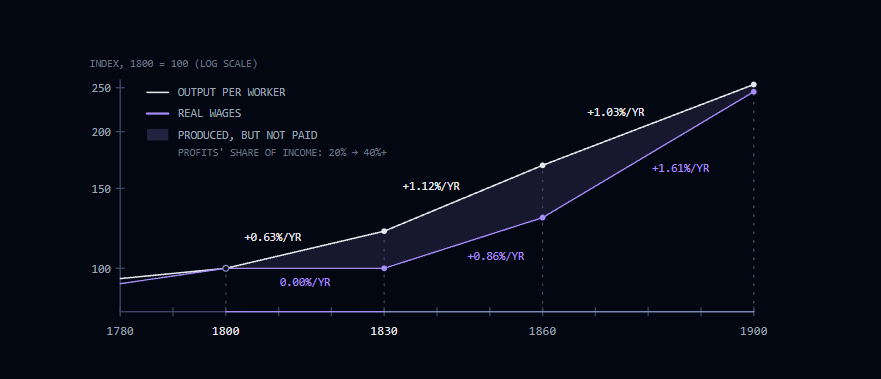
Но я хочу развить эту мысль дальше, потому что в текстильной промышленности это работало по одной ключевой причине: машины производили продукцию низкого качества, но она соответствовала минимальным требованиям.
Сами машины тоже были очень хорошо спроектированы, учитывая их назначение. Недавно я разговаривал с инженером-механиком, который расхваливал качество этих поколений машин, то, как хорошо они работали, как долго служили. Да, они могли производить низкокачественный продукт, но делали это быстро, неустанно и на протяжении многих лет, пока не появилось следующее поколение, заменившее их постепенными улучшениями. И что особенно важно, во время работы машины не наблюдалось увеличения декогеренции. Износ — да. Улучшения поколений — да. Но не декогеренция.
Вот в чем загвоздка: логика этого аргумента основана на предположении, что код аналогичен текстилю. То есть, код — это конечный продукт, за который пользователи будут платить. Но никто не хочет покупать код. Все хотят покупать приложения.
Другими словами, код — это не текстиль, а текстильная машина. Каждый раз, когда отображается экран, отправляется форма, обновляется запись, — это и есть «продукт», который производит код. Именно поэтому код приносит такую огромную прибыль, ведь каждый дополнительный клиент не требует дополнительных накладных расходов. Сырье — это биты и байты электричества на микросхемах, а продукт — это информация и процессы, закодированные в этих битах.
Более точная аналогия — это если бы мы каким-то образом вернулись в прошлое и создали не просто текстильную машину, а машину, которая проектирует текстильные машины. Машину, которая самостоятельно, полуавтономно или, возможно, полностью автономно, совершенствовала бы следующее поколение текстильного производства. Такого никогда раньше не существовало, и это беспрецедентно в истории автоматизации.
Это мечта о рекурсивном самосовершенствовании . О взрыве интеллекта, технологической сингулярности. Это, прежде всего, мечта об ИИ.
> Сингулярность
Правила игры постепенно меняются. В мае этого года Том Рид, скептик теории взрыва интеллекта, ввел термин «сингулярность Гудхарта» для описания ограничений ИИ, развивающегося в замкнутом пространстве без новых данных о реальном мире. Это основано на законе Гудхарта:
Когда показатель становится целью, он перестает быть хорошим показателем. Мэрилин Стратерн, перефразируя Чарльза Гудхарта.
В посте, опубликованном в прошлом месяце, Том Дэвидсон, старший научный сотрудник Forethought, признал, что узкие места в данных замедлят прогресс, как только ИИ достигнет того, что он называет «потолком человеческого качества» (human-quality ceiling): точки, где не осталось лучшего примера человеческого опыта, на котором можно учиться, и ИИ должен производить данные более высокого качества, чем все, что существует. Дэвидсон много писал о моделях скорости развития ИИ, а позже и о прогнозах, основанных на его работе, наиболее известным из которых является сценарий ИИ 2027.
Поэтому тот факт, что Дэвидсон, пусть даже незначительно, поколебался, заслуживает внимания. Но он утверждает, что это разовое замедление, а не непреодолимая преграда, и в целом те, кто ожидает быстрого взлета, по-прежнему считают, что система сможет рекурсивно самосовершенствоваться самостоятельно, используя относительно небольшое количество данных, и что этот процесс может выйти из-под контроля в изоляции в центре обработки данных и привести к рождению сверхинтеллекта.
Они рассчитывают сделать это с помощью того, что они называют взрывом программного интеллекта (Software Intelligence Explosion - SIE). В частности, тонкий, но важный момент в аргументации связан с постом Дэвидсона об узких местах в данных:
Вместо того чтобы создавать среды обучения с подкреплением, которые учат создавать реальные программные артефакты, ИИ должен создавать среды обучения с подкреплением, которые учат ИИ создавать ПО лучше, чем все, что существует в реальном мире.
Я думаю, это возможно! Проще сформулировать сложные задачи и проверить ответы на них, чем решить их. Уже сегодня эксперты создают среды обучения с подкреплением, которые генерируют данные, качество которых превышает человеческий уровень. Качество данных не достигнет предела, установленного человеческим уровнем.
Давайте разберем это по пунктам.
Здесь Дэвидсон утверждает, что ИИ должен уметь создавать ПО лучше, чем все, что существует в реальном мире, в значительной степени изолированно. Для этого ему потребуется создать среду обучения с подкреплением, которая сможет производить это ПО. Принцип работы этого процесса примерно таков:
Определить цель.
Определить набор действий, которые можно выполнить.
Использовать алгоритм, чтобы опробовать множество различных методов для достижения цели.
Оценить, насколько близко мы подошли к достижению цели и насколько хорош наш метод.
Найти лучший метод.
Для того чтобы произошел SIE, ИИ должен уметь самостоятельно выполнять весь этот процесс, чтобы открывать все более совершенные алгоритмы обучения, и это самое важное. Речь идет не о создании лучшего ПО как такового, а о создании лучших алгоритмов обучения и совершенствования.
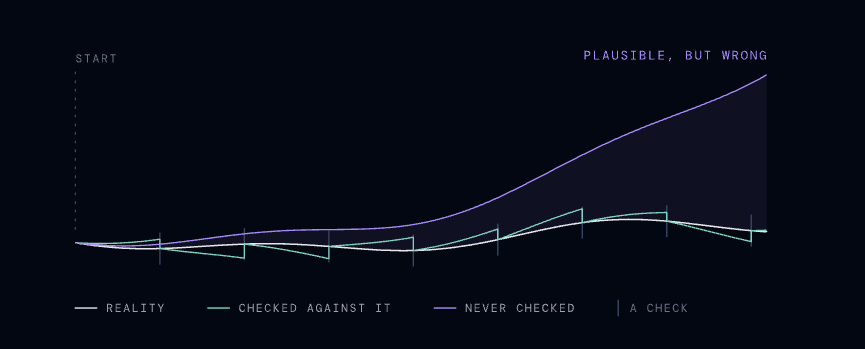
Теория сингулярности Гудхарта фактически утверждает, что ИИ, находящийся в изоляции в центре обработки данных, не сможет справиться с большинством важных задач реального мира из-за этапа измерения. Если вы хотите понять, как создать лучший автомобиль, ракету или компьютерный чип, вы, возможно, сможете создать симуляцию и поэкспериментировать, но вам все равно потребуется проверить результаты в реальном мире, иначе вы будете все дальше и дальше отходить от реальности, доводя свои разработки до все более экстремальных пределов. Это вводит ограничение скорости, которое значительно замедлит процесс.
Но это не относится к некоторым областям, о чем и говорит Дэвидсон во второй части. Для таких игр, как Го или шахматы, правила игры охватывают весь мир, и существуют четкие условия победы, поэтому можно играть изолированно и находить все лучшие стратегии, а также находить лучшие алгоритмы для поиска лучших стратегий. То же самое верно и для более сложных игр, таких как StarCraft или Dota.
Но это всего лишь игры, и мы можем это делать, потому что условия победы ясны и просты, а правила или условия очень ограничены. Чтобы добиться взрыва, нам нужно уметь применять эти методы к чему-то действительно важному, и нам нужно иметь возможность проверить это в замкнутом пространстве центра обработки данных, не сверяясь с внешним миром.
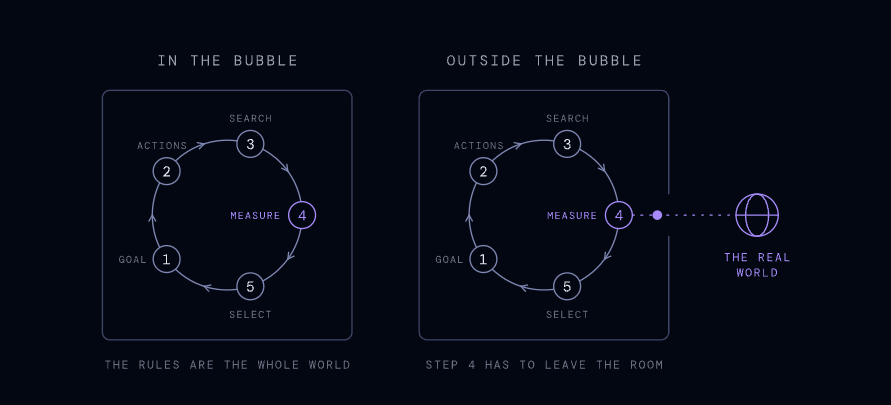
Это подводит нас к ПО. Я думаю, что сторонники SIE действительно увлеклись ПО, потому что видят в нем способ преодолеть этот разрыв. ПО может работать изолированно, и его можно очень легко и быстро тестировать в изоляции. Это идеально подходит для создания среды обучения с подкреплением, и они считают, что в конечном итоге мы сможем создать такую среду, которая не потребует синхронизации с реальным миром.
Ведь это же программное обеспечение. Оно может делать практически все, верно?
Можно понять, почему это кажется таким естественным для жителей Силиконовой долины. Мы гордимся своим высоким интеллектом и способностью решать сложные задачи. Значительная часть образования в области информатики посвящена логическому доказательству свойств ПО, алгоритмов и т.п. Завершится ли эта программа? Будет ли этот алгоритм сортировки быстрым? Насколько быстрым? Будет ли эта система безопасной и не даст сбоев во всех возможных случаях?
Мы привыкли думать о проблемах именно так и привыкли к мысли, что у ПО нет границ. Технологии захватили мир, поэтому вполне естественно предположить, что если вы можете научить машину писать код, то со временем она сможет сама научиться писать код лучше.
А потом, в конце концов, машина захватит мир.
> Лучшее программное обеспечение
Проблема такой точки зрения заключается в том, что она полностью упускает из виду то, что на самом деле делает ПО хорошим, а именно — когерентность.
Позвольте мне пояснить. ПО — это инструмент для достижения цели в реальном мире. Достижение цели может состоять из нескольких шагов, требовать множества абстракций, но успех или неудача в конечном итоге определяются тем, насколько хорошо ПО решает эту задачу.
Вы можете подумать: «Хорошо, но раз у нас есть ПО, и оно решает поставленную задачу, разве нельзя использовать это в качестве целевого результата? А затем ИИ мог бы просто итеративно искать лучшие способы достижения этой задачи?»
Если мы определим «лучшее» как нечто простое и легко измеримое, например, количество строк кода, скорость, объем памяти или эффективность, то да. Все это важно, но если мы будем рассматривать это как цель, то в итоге получим ПО, которое будет небольшим, быстрым и совершенно некогерентным.
Код становится быстрым за счет пропуска работы, а пропустить работу можно только при условии, что остальная часть системы предполагает определенные вещи: этот список уже отсортирован, это значение никогда не равно нулю. Каждое из этих предположений — это скрытая связь, которую никто не записал. Оптимизированный нативный код находится под абстракциями не просто так: он нужен нам для повышения производительности, поэтому мы запираем его в ящик, где его предположения не могут просочиться. Если бы мы писали весь код таким образом, это был бы запутанный беспорядок (практический пример на JavaScript — объединение нескольких логических классов в один для обеспечения мономорфности «горячих путей». Это всегда большая головная боль, но она окупается, когда нам больше не приходится с этим возиться).
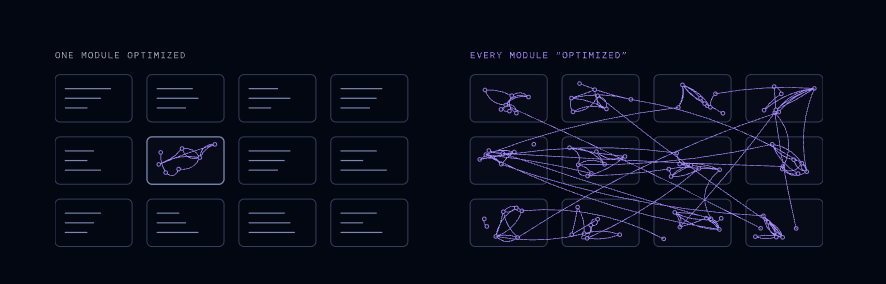
Было бы хорошо, если бы нам нужно было написать программу всего один раз и больше к ней не прикасаться. Но на практике так не бывает. Потому что ПО — это бесконечный корабль Тесея. Приложения, библиотеки и фреймворки должны развиваться со временем, чтобы соответствовать меняющимся условиям: реальным ограничениям, которые меняются и эволюционируют по мере того, как мы меняем то, как функционирует общество, по мере того, как мы узнаем больше о мире и по мере того, как мы расширяем границы того, чего можем достичь.
Таким образом, хорошее ПО способно адаптироваться со временем. Вы можете взять существующий технологический капитал (все ранее написанное нами ПО) и быстро перекомбинировать его для решения новых задач на ходу.
А адаптивность обеспечивается именно когерентностью. Большинство крупных достижений в области программирования и качества ПО были связаны с повышением когерентности ПО, и единственный способ проверить, действительно ли оно стало более когерентным, — это получить обратную связь из реального мира.
Давайте разберем это на конкретном примере: фьючерсы (futures).
Фьючерсы упрощают асинхронное программирование по ряду действительно фундаментальных аспектов. До появления фьючерсов существовало множество способов обработки асинхронных операций, и это было предсказуемо хаотично. В частности, дезорганизованно: множество локально логичных способов сделать одно и то же, ни один из которых не сочетался друг с другом.
Разработчикам пришлось бы жить в этом хаосе и тщательно, вдумчиво ориентироваться во всех различных типах асинхронности, которые могут быть в конкретном приложении. Если бы мы пропустили какой-то шаг или что-то забыли, у нас бы возникли труднообнаружимые ошибки и проблемы. А сам код был бы практически нечитаем, поскольку количество коллбэков увеличивалось бы, а приложения становились бы все сложнее и требовали обработки все большего количества асинхронных операций.
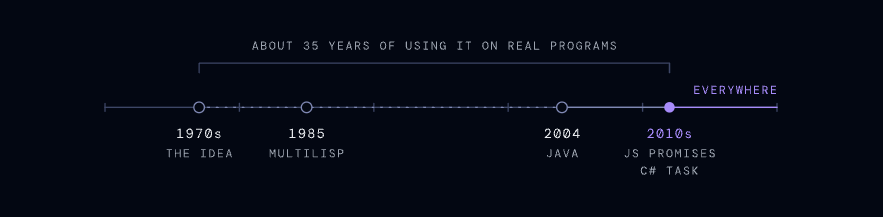
Концепция фьючерсов впервые появилась в 1970-х годах, и их основная идея заключалась в том, что они представляли собой заполнитель для будущего значения. Первая конкретная реализация появилась в MultiLisp в 1985 году. Но они не получили широкого распространения до 2000-х годов, когда Java добавила их в 2004 году, и не стали популярными до 2010-х годов, когда в JavaScript впервые были введены цепочки промисов (chainable promises), а в C# появилась функция Task.
Этому было две основные причины:
Первые API для работы с фьючерсами работали, но были неуклюжими. Можно было передавать фьючерс, но при попытке чтения значения возникала блокировка, а это означало, что нужно было тщательно выбирать момент для чтения. Кроме того, они не были независимыми цепочками, поэтому создать форк фьючерса было непросто.
Фьючерсы требуют дополнительной работы. Например, приходится каждый раз создавать объект-обертку для отслеживания состояния, вместо того чтобы просто хранить указатель на функцию.
Однако со временем мы нашли API, которые хорошо работали, устранили неполадки и поняли, что накладные расходы того стоят, поскольку это упростило понимание и объединение более крупных систем (снижение стоимости вычислительных ресурсов и памяти тоже сыграло свою роль).
Вернемся к ИИ.
Для создания более совершенного ПО на основе ИИ необходимо иметь возможность проверить, действительно ли оно стало лучше. И, что немаловажно, как мы уже упоминали, мы должны иметь возможность измерить его эффективность в изолированном пространстве. Мы не можем проверить это за его пределами, потому что это снова приведет к ограничению скорости обработки данных окружающим миром.
Итак, что же мы можем проверить внутри этого пузыря?
Мы сузили круг до следующих вариантов:
Игры.
Программное обеспечение.
Математика.
Игры на самом деле не приносят нам большой пользы, потому что они не связаны с реальными задачами, которые нас волнуют. Поэтому давайте перейдем к ПО.
Как мы уже выяснили, хорошая программа должна быть когерентной. Итак, как измерить когерентность?
Итак, вы берете абстракцию и смотрите, насколько хорошо она работает в разных контекстах и насколько код должен адаптироваться к каждому из них. Поскольку нам не разрешено покидать центр обработки данных, есть ровно два варианта, как мы можем это сделать:
Применить это ко всему существующему ПО. Этого будет недостаточно, потому что даже если это хорошо работает для всех программ, невозможно узнать, будет ли это хорошо работать для всего будущего ПО. Обратные вызовы и циклы событий не были распространены до тех пор, пока не стали стандартом графические интерфейсы пользователей, а ранние веб-серверы все еще использовали потоки и традиционный параллелизм, поэтому не было ясно, насколько ценными будут фьючерсы, пока не был открыт и исследован весь набор программ, составляющих веб. Мы переобучались на уже известных нам программах. Результат может выглядеть совершенно логичным сегодня, а затем первую новую проблему, которая не соответствует требованиям, придется решать с помощью патчей.
Создание нового ПО. Теоретически это можно попытаться сделать, но на практике мы не можем просто генерировать правдоподобно полезные программы для расширения обучающего набора данных. Еще раз подчеркнем, что ПО — это инструмент для достижения цели в реальном мире, и если мы время от времени не будем проверять его полезность, мы можем существенно отклониться от реальности.
Помимо этого ключевого вопроса, еще одним важным критерием когерентности является то, насколько хорошо абстракция или концепция адаптируются со временем, в различных контекстах и при меняющихся требованиях. Стандарт может хорошо выглядеть на бумаге и даже хорошо работать в одной среде, например, на настольных компьютерах, но затем оказаться совершенно непригодным для мобильных устройств или облачных систем в масштабе предприятия.
Вам потребуется не только создавать правдоподобно полезное ПО, но и разрабатывать правдоподобные сценарии его эволюции, чтобы увидеть, как оно адаптируется, что происходит, когда не все обновляются, когда люди (или агенты) отстают или решают двигаться в другом направлении, когда у вас есть экосистема систем, которые постоянно меняются.
Можно достичь сколь угодно высокого уровня мастерства в повышении когерентности уже существующего ПО. Для улучшения качества еще не имеющегося ПО требуется либо (а) ждать, пока реальный мир создаст новое ПО, либо (б) создавать новое ПО, тестировать его в реальных условиях и ждать, пока оно будет развиваться со временем. Оба варианта требуют выхода за пределы пузыря.
Теперь давайте соберем все воедино:
Мы можем создать ИИ, который будет разрабатывать более быстрое, компактное и эффективное ПО, превосходящее человеческие возможности, оставаясь при этом внутри пузыря.
Как отмечалось выше, мы не можем создать ИИ, который улучшит когерентность ПО за пределами возможностей человека, не выходя из пузыря.
Поскольку ИИ не может проверить, является ли ПО в целом лучше, не выходя из пузыря, он не может определить, действительно ли он улучшает свои алгоритмы обучения или же происходит дрейф.
Мы снова оказались в сингулярности Гудхарта.
Это сразу же ставит крест на возможности быстрого и изолированного SIE. Но мы можем подойти к этому и с другой стороны, и этот подход применим и к другим формам взрывов интеллекта.
Любая форма интеллектуального взрыва зависит от того, насколько ИИ исследует и совершенствует собственное программное или аппаратное обеспечение, при этом каждое последующее поколение основывается на улучшениях предыдущего.
Каждое поколение будет иметь определенную вероятность внесения декогеренции в свои системы, поскольку ИИ будет создавать или расширять системы за пределы своих нынешних возможностей понимания.
Если ИИ будет действовать слишком быстро, он будет накапливать декогеренцию быстрее, чем сможет ее исправить, что приведет к застою или регрессу в его общих возможностях.
Если ИИ подтвердит и проверит все свои выводы, его скорость будет ограничена способностью собирать данные из окружающего мира.
Эту проблему нельзя решить с помощью более совершенных алгоритмов обучения, разработанных изолированно, поскольку ИИ не с чем их сравнивать (см. первый пункт).
На следующем графике, адаптированном из модели Эта и Дэвидсона в их статье о SIE, мы можем увидеть, как выглядит режим отказа (failure mode), указанный в пункте 3. Их прогноз предполагает параболическую форму кривой роста до пятого месяца. На графике ниже сохранена их модель, но добавлено одно предположение: что стоимость каждого изменения удваивается по мере роста накопленной работы, что и представляет собой декогеренция в кодовых базах, созданных людьми.
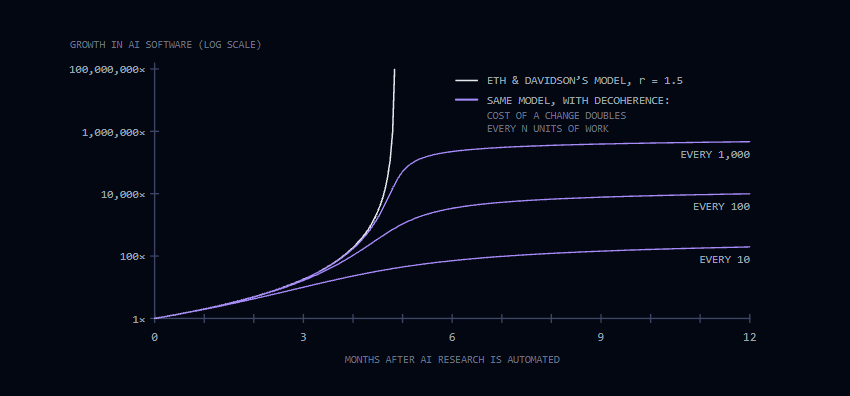
Если это правда, и ИИ не может обойти декогеренцию, то в конечном итоге скорость развития ИИ будет ограничена реальностью. Дело не в том, что он никогда нас не превзойдет, а в том, что до этого еще очень далеко в каком-либо значимом смысле, и даже когда это произойдет, ему все равно придется выполнять всю работу, которую требует реальность, ограниченную теми же физическими и информационными рамками, которые управляют нами.
Дэвидсон утверждает, что мы могли бы легко собрать достаточно данных, просто записывая реальные задачи:
Если бы весь мир объединил усилия, это не заняло бы много времени. Для каждой задачи 1000 человек могли бы записывать изображение со своих экранов и носить видеокамеры на головах, и в течение 4 месяцев ИИ накопил бы опыт, эквивалентный 300 годам.
Это, по сути, недооценивает сложность окружающего мира. Если мы ожидаем, что машина сможет бесконечно совершенствоваться, она не может просто хорошо управлять курсором на экране или распознавать объекты на видео. Ей необходимо развить глубокое понимание самого мира. Ей не нужно воспринимать его так же, как человек, но она должна уметь улавливать ту же информацию, ту же перспективу, измерять неосязаемые и тонкие нюансы, которые невозможно зафиксировать только с помощью записи экрана и видеопотока.
ИИ должен уметь устанавливать связи между вещами, которые на первый взгляд кажутся совершенно не связанными друг с другом. Что подводит нас к последней теме.
> Математика
Математика — еще одна область, которую теоретически можно проверить в условиях изоляции с помощью верифицированных доказательств. Если ИИ сможет лучше разбираться в математике в условиях изоляции, то он сможет разработать более совершенный алгоритм обучения в целом, и тогда, возможно, аргумент о самоэффективности останется в силе.
Дело в том, что математика в некотором смысле произвольна. Мы принимаем множество решений о том, как она работает и что полезно. Например, число ноль не всегда принималось как допустимое число. Мнимым числам потребовались столетия, чтобы быть принятыми, а их четырехмерные аналоги, кватернионы, показались Льюису Кэрроллу настолько абсурдными, что, как считается, он высмеял их в чаепитии у Безумного Шляпника.
Это примеры вещей, которые мы принимаем как должное, но которые на самом деле не так очевидны или естественны, как нам кажется. Они получили широкое признание только тогда, когда были применены в реальной жизни, и когда результаты соответствовали реальности осмысленным образом.
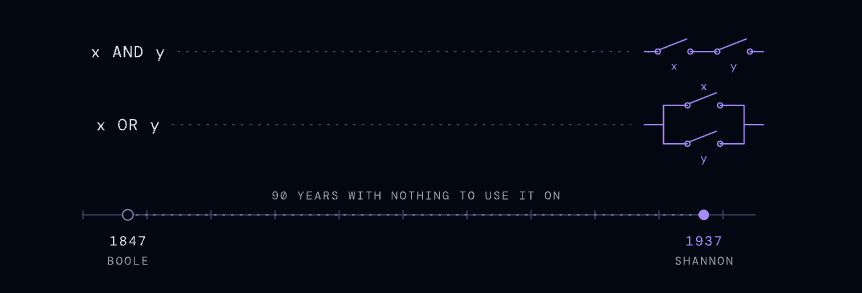
Аналогичным образом, булева алгебра, фундаментальная математика, лежащая в основе вычислений, также считалась эзотерической отраслью математики почти столетие. Она была впервые опубликована Джорджем Булем в 1847 году, но не имела практического применения и изучалась как курьез формальной логики, а не как инструмент для серьезной инженерии.
Важность этой математики была обнаружена только в 1930-х годах, когда Клод Шеннон работал в Массачусетском технологическом институте над управлением реле для дифференциального анализатора Ванневара Буша. Ранее он познакомился с булевой алгеброй на курсе философии, который он посещал во время обучения в университете, и, работая над схемами, понял, что они идеально совпадают. Его магистерская диссертация «Символический анализ релейных и коммутационных цепей» установила эту связь в 1937 году, а остальное уже история.
Буль не просто изобретал математику ради самой математики. У него было интуитивное предчувствие, что открытые им свойства, созданная им система, когда-нибудь станут важными. Он считал, что открывает законы человеческого мышления, и хотя это могло быть несколько ошибочным предположением, оно оказалось достаточно интересным, чтобы логики и философы изучали его и передавали из поколения в поколение, пока Шеннон не обнаружил его и не развил.
Смог бы Шеннон найти эту связь в эпоху ИИ? Если бы он не стоял в комнате, полной реле, перед которым стояла реальная проблема, указывающая, куда смотреть, а вместо этого разбирался бы в бесконечных кучах доказательств, которые были локально действительны и глобально бессмысленны?
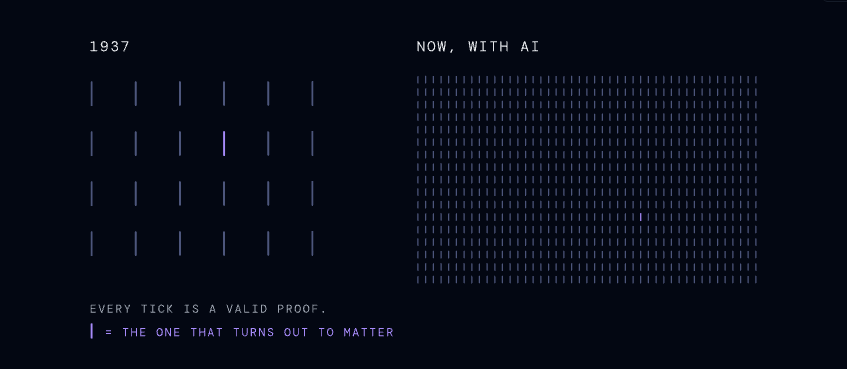
В отрыве от реальности можно определить бесконечное количество логических и математических систем, и можно очень хорошо научиться строить и исследовать эти гипотетические сценарии. А вот понять, имеют ли они значение для реального мира, — это уже совсем другой навык, и его невозможно улучшить в отрыве от реальности.
Математики уже обеспокоены этой дихотомией. В сентябре двадцать пять лауреатов Филдсовской премии, в том числе Теренс Тао, подписали декларацию, в которой утверждалось, что решение проблем является лишь заменой истинной цели математики, которой является понимание, и что массовое производство истинных утверждений может подорвать почву, на которой растут новые идеи.
Что произойдет, когда вся эта почва будет размыта?
> Коллапс
Работа по построению когерентности — это долгий и неустанный процесс. Это работа по исследованию каждой трещинки и заглядыванию под каждый камень. Это работа по погружению в грязь реальности, позволяющая ей проникать в ваши ботинки, пока вы вслепую шарите вокруг, ища всевозможные способы, которыми мир может бесконечно меняться и перестраиваться вокруг вас, не позволяя ему поглотить вас целиком.
Речь идет не просто о решении проблем. Речь идет о том, чтобы понять, какие именно проблемы мы пытаемся решить.
Речь идет о том, чтобы разобраться во всех проблемах, которые мы пытаемся решить, и найти единое решение, которое устранит каждую из них, не превратившись в лабиринт сложностей.
Что подводит меня к последнему пункту.
В последнее время было много разговоров об Omarchy. Многие его любят, а многие, скажем так, скептически относятся к дистрибутиву Linux, ориентированному на агентов ИИ. Они довольно быстро продвинулись в этом направлении и, похоже, трансформируются от первоначальной цели — чистого набора настроек по умолчанию — к полноценному дистрибутиву с пользовательским ядром.
Хочу подчеркнуть, что экспериментирование на периферии экосистемы очень важно. Создание форков, изучение идей, поиск работающих решений без ограничений и донесение результатов до сообщества — все это составляет огромную часть того, что делает ПО с открытым исходным кодом таким успешным.
Но меня это беспокоит.
Меня беспокоит, что где-то по пути мы, возможно, забыли, что все мы вместе поднимаемся на гору. Что то, что сделало нас такими успешными и такими устойчивыми как сообщество, что так быстро продвинуло вычислительную технику вперед, — это процесс построения когерентности.
В 80-х, 90-х и на протяжении всех 2000-х годов каждая компания управляла собственным стеком. Каждый сервер представлял собой отдельный набор зависимостей, скриптов, версий ОС и т.д. В обычной компании для бесперебойной работы всего этого требовалась целая команда.
Во время войн ОС эта фрагментация была еще хуже. У Unix не было явного преемника, а Windows набирала обороты, используя совершенно другую парадигму. Если бы Linux не был создан в то время и не занял место стареющей экосистемы *nix, где бы мы были сегодня? Да, я знаю, что FreeBSD существовала и могла бы занять ее место. На самом деле я имею в виду следующее: что если бы вообще не было движения за свободное программное обеспечение?
Придется ли нам платить лицензионные сборы каждый раз при запуске контейнера в облаке?
Сколько стартапов не смогли бы начать работу только из-за высоких затрат на поддержание своей технологической инфраструктуры?
Эта фрагментация также стала причиной того, что со временем каждая система начала казаться устаревшей и неуклюжей. Вся экосистема была декогерентной, и большая часть работы за последние два десятилетия была направлена на добавление когерентности (и на извлечение части этой ценности из SaaS-продуктов, но я забегаю вперед).
Боюсь, мы здесь практикуем своего рода подсечно-огневое земледелие, когда мы отбрасываем достигнутую когерентность в пользу перестройки каждой зависимости, индивидуальной настройки каждого ПО, расширения во всех направлениях для решения краткосрочных проблем.
И, сами того не осознавая, мы все это время катимся в глубокую яму.
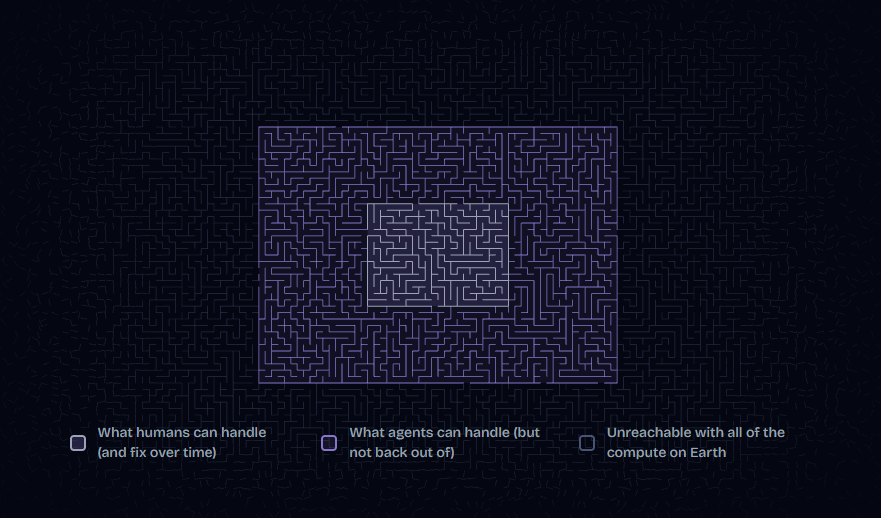
Если мы будем слишком долго и слишком далеко заходить, не поддерживая и не восстанавливая когерентность, то, следуя нынешним тенденциям, мы окажемся в ситуации, когда нам придется использовать агентов для поддержания наших систем, потому что системы станут настолько большими и сложными, что мы не сможем делать это сами. Но если мы попадем в такую ситуацию, и окажется, что агенты не могут нам помочь, выполнив необходимые ремонтные работы, мы можем оказаться в очень неудобном положении:
Мы застряли в модели разработки, которая постепенно ухудшает состояние наших систем, независимо от того, сколько усилий мы прилагаем для их исправления.
Дело не в том, что мы не сможем в конечном итоге исправить системы. Но на это могут уйти годы или даже десятилетия, и тем временем мы не сможем внедрять новые функции или продвигаться в решении многих других насущных проблем нашего общества.
Это я называю коллапсом декогеренции (Decoherence Collapse). И я боюсь его гораздо больше, чем вышедшего из-под контроля сверхразума, потому что это происходит прямо сейчас, у нас на глазах.
Я хочу подчеркнуть, что в ИИ есть определенная польза, просто я считаю, что она скорее на периферии, чем в замене основных рабочих процессов или в полной автономности. Я полностью разделяю анализ Кори Доктороу с обратным кентавром — мы не хотим, чтобы машина управляла нами, мы хотим управлять машиной. В связи с этим вы можете ознакомиться с моей Политикой и Руководством по использованию ИИ для более подробного ознакомления с тем, как я подхожу к этому в своей работе и жизни.
Как я уже неоднократно говорил в этой статье, декогеренция — это не новая проблема. Наоборот, она существовала с самого начала человеческой цивилизации, а может быть, даже еще раньше. Это естественный вид распада или деградации, своего рода энтропия, с которой мы всегда имели дело и всегда будем иметь дело. С учетом этого, я хотел бы оставить вам две последние мысли.
Декогерентность меняется только тогда, когда меняются сами системы. Это значит, что как бы плохо ни было, мы всегда можем остановиться и начать отступать. Если ИИ загнал нас глубоко в ловушку, на полное восстановление могут уйти годы или даже десятилетия, но самое сложное — это начало. Все последующие этапы будут развиваться по принципу снежного кома, пока мы будем продолжать фокусироваться на улучшении когерентности и доводить дело до конца. Если мы улучшим ее лишь настолько, чтобы вернуться к старым моделям поведения, мы просто перезапустим цикл.
У нас уже есть процессы, которые, как известно, улучшают когерентность со временем. Человечество нашло способы создания более согласованных систем, и именно эти системы во многом обеспечили масштаб и размах технологического прогресса за последние несколько столетий.
В частности, процесс разработки ПО с открытым исходным кодом, обеспечивающий значительную часть когерентности в процессе разработки ПО, настолько успешно создает эту когерентность, что превзошел корпоративную разработку ПО по нескольким поистине впечатляющим показателям. Но об этом мы поговорим подробнее в следующем эссе: «Открытый капитал».
Новости, обзоры продуктов и конкурсы от команды Timeweb.Cloud — в нашем Telegram-канале ↩
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.