Техническая документация как артефакт коммуникации
Ещё недавно техническую документацию в командах часто приходилось буквально проталкивать через строгие требования, так как разработчикам не хватало времени или желания писать и поддерживать её.
С появлением AI-агентов ситуация изменилась: им нужен контекст о проекте, и сами они охотно бесконечно собирают документы и обновляют после каждого изменения. Создавать документацию стало проще. И её стало больше. Но пользы это не прибавило.
Полностью сгенерированные документы имеют множество проблем. А сами документы зачастую генерируют для галочки или только ради контекста AI, забывая о людях.
Документация — прежде всего инструмент коммуникации. Она передаёт знания и договорённости между людьми, командами, отделами и помогает проектировать систему, проверять реализацию и сопровождать её. Причём AI-агент стал ещё одним новым звеном в цепочке коммуникации. И ему тоже нужны свои рабочие материалы.
Т.к. мы вели документацию в проектах ещё до широкого распространения AI-инструментов, у нас не было проблем с адаптацией — мы просто добавили новый слой документов для работы с новым AI-отделом. И в этой статье я расскажу и покажу, что у нас по итогу получилось и как устроена работа с документацией.
1. Назначение документации
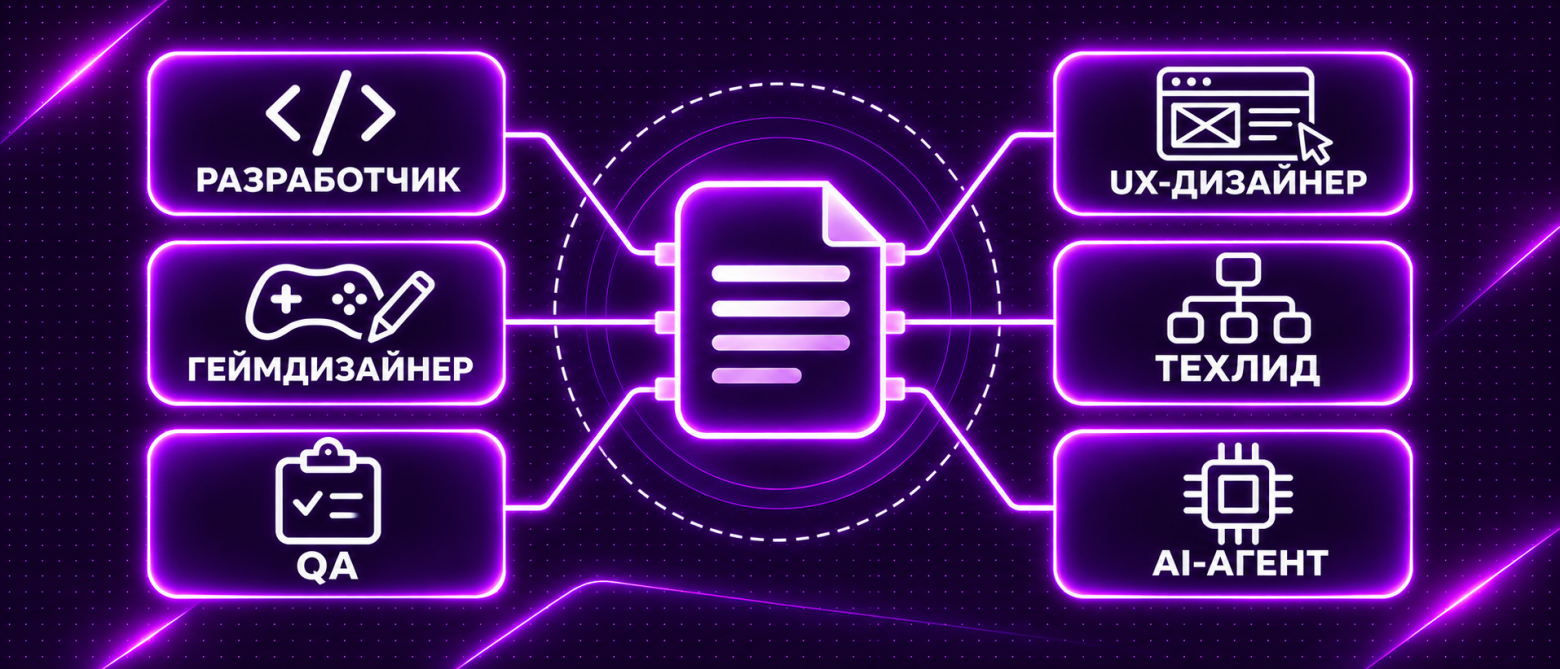
Разным участникам команды техническая документация помогает решать разные задачи.
Разработчикам она помогает снизить когнитивную нагрузку при работе с незнакомой или забытой механикой. Самостоятельная попытка изложить решение помогает структурировать мысли, найти противоречия и обнаружить пробелы реализации. А на ревью документ позволяет сначала понять замысел перед оценкой кода, если это вообще после документации понадобится.
Геймдизайнерам документация помогает сопоставить требования с особенностями реализации, QA — уточнить ожидаемое поведение, UX-дизайнерам — понять технические ограничения. Но на практике специалисты нетехнических отделов редко читают технические документы напрямую — для этого они используют агентов, искусственных и естественных.
AI-агентам документ служит структурированным контекстом: помогает быстрее найти нужную систему и понять её устройство, прежде чем обращаться к исходному коду. Это уменьшает риск неверной интерпретации, сокращает время исследования, потребление контекста и токенов.
В нашей команде одним из основных читателей технической документации является технический руководитель (то есть я). Чтобы оценить новые требования или развитие существующей механики, мне часто достаточно восстановить общую картину: из каких компонентов состоит система, как они взаимодействуют, где находятся ограничения и точки расширения. Для этого не нужно читать весь код или отвлекать разработчиков. Восстановить контекст можно и с помощью AI-агента, но часто ответы нужны быстрее, чем он успеет исследовать код.
На определённых этапах технические документы помогают обнаруживать несогласованные расхождения между отделами: например, ГДД обновили, но разработчики не в курсе новых требований. Или, наоборот, логика изменилась, но до геймдизайнеров это не дошло. Зафиксированные исходные требования и описания итоговой реализации дают возможность сопоставить ожидания между отделами и своевременно устранить расхождения.
Звучит как переусложнённая бюрократия. Но чем больше в команде людей и передач работы между отделами, тем важнее явно фиксировать переходящий контекст и критерии готовности. Это помогает согласовывать ожидания, препятствовать постоянному перекладыванию ответственности и контролировать результат.
В небольшой вовлечённой многофункциональной команде схема коммуникации компактнее. Многое закрывается общим контекстом и прямым общением, поэтому потребность в документах ниже, а сами документы — проще. Основным читателем тогда вполне может стать AI-агент. Отчасти поэтому концепция Tiny Teams сейчас становится более актуальной.
2. Виды документации
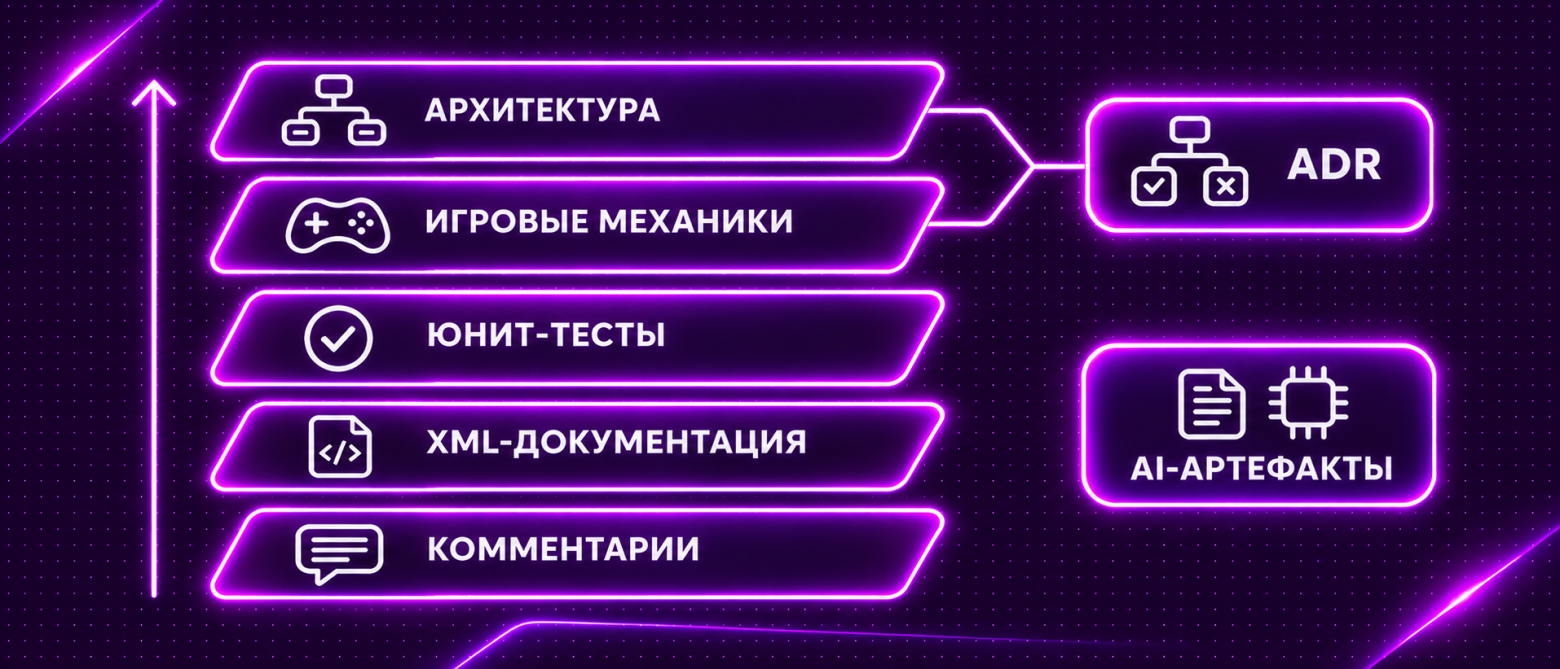
У документации разные читатели, и им нужна разная информация: одним достаточно понять общую картину, другим — разобраться в конкретном контракте или алгоритме. Поэтому информацию полезно разделять на слои с разной глубиной погружения. Чем шире круг читателей, тем доступнее должна быть документация — и в плане содержания, и в плане местонахождения.
У информации также разный срок жизни и частота изменений. Одни знания сохраняются надолго, другие — меняются вместе с реализацией, какие-то вовсе нужны только на время работы над конкретной задачей. Это тоже влияет на то, где и как информация хранится.
Чтобы учитывать эти особенности, мы используем несколько видов документов. Каждый из них отвечает на свои вопросы и содержит информацию подходящего уровня детализации.
Технический документ игровой механики описывает её функциональные требования, компоненты, связи между ними, потоки данных внутри и технические ограничения.
Архитектурный документ охватывает общую структуру проекта: инфраструктуру, общие компоненты, разделение на слои и контракты между системами.
Оба вида этих документов отвечают на вопросы "как устроена система сейчас" и "как её можно расширять". Они создаются и обновляются по мере изменения соответствующих механик и систем.
Чтобы не плодить бесполезную информацию и не делать лишнюю работу, отдельные технические документы мы создаём только для крупных, значимых единиц: например, механики боя, магазина или системы синхронизации прогресса.
Также у нас ведутся ADR (Architecture Decision Record). Такой документ появляется, когда команда сталкивается с проблемой, для решения которой нужно провести ресёрч и сделать определённый архитектурный выбор. В нём фиксируем саму проблему, рассмотренные варианты, причины выбора, принятые компромиссы и осознанные последствия.
ADR мы оформляем тоже только для действительно значимых решений с долгосрочными последствиями — например, выбора подхода к сериализации данных. Иначе место хранения всех ADR превратится в источник шума, а не ценной информации.
Но, в отличие от других технических документов, ADR не меняется после создания. Если решение пересмотрено, его отмена или замена фиксируется в новом ADR, а прежнее обоснование сохраняется как часть истории.
Информацию о чём-то менее значимом или более глубокие подробности реализации мы оставляем ближе к коду: чем информация конкретнее, тем чаще она обновляется вместе с ним. Контракты типов и методов описываем в XML-документации, неочевидные детали логики — в комментариях, ожидаемое поведение и граничные сценарии — в юнит-тестах.
На примере системы статусов:
Технический документ механики описывает её общие правила и взаимодействие её компонентов.
ADR хранит решение об использовании ECS и выборе фреймворка.
Архитектурный документ описывает взаимодействие ECS с объектно-ориентированной частью приложения.
XML-документация описывает контракты методов.
Комментарии поясняют сложный алгоритм отбрасывания статусов при коллизиях.
Тесты проверяют повторное применение статуса, завершение его действия и сочетание эффектов.
Кроме знаний об устройстве некой системы, команде нужны знания о том, как с ней работать. Для повторяемых действий мы используем гайды: например, как подключить новую способность или настроить окружение.
Чтобы команда придерживалась единых правил, мы отдельно фиксируем документы-соглашения: например, как именовать сущности, организовывать проект и разделять контент.
Для AI-агентов это всё становится кормом для соответствующих скиллов и инструкций.
3. Жизненный цикл документации
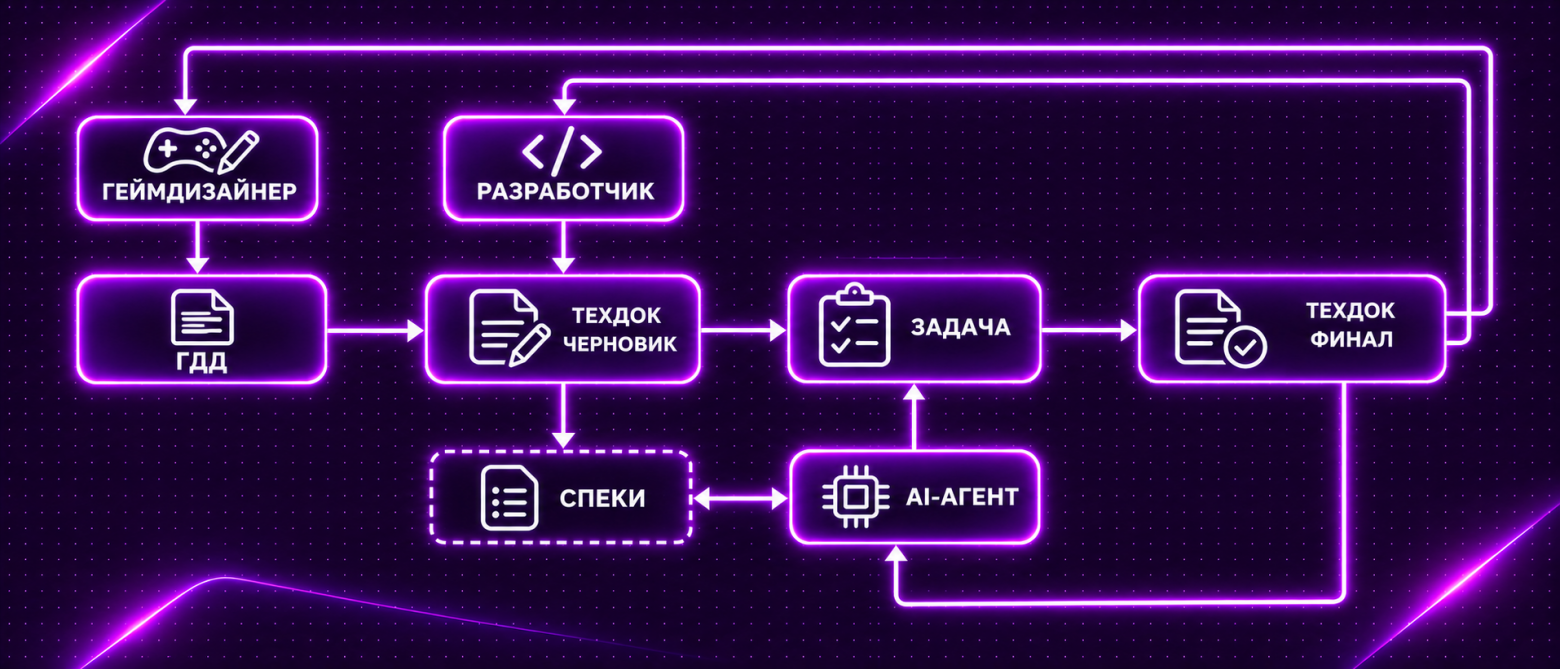
Сначала геймдизайнеры формулируют и согласуют требования в ГДД. ГДД у нас хранятся в Confluence. Если нужны интерфейс и визуальные образы, их дополняют UX-описания, макеты и требования для художников. Эти материалы задают ожидаемое поведение, но не описывают технического устройства.
Разработчик изучает требования, существующую документацию и код: выясняет ограничения, точки интеграции и возможные подходы. На основе исследования появляется черновик-зарисовка технического документа, который позволяет обсудить решение с коллегами или AI-агентом до написания кода.
При работе с AI-агентом дополнительно прорабатывается спецификация задачи — расширенный документ с более детальным описанием необходимых изменений. На её основе составляется план с границами и зависимостями отдельных этапов работы, чтобы потом их распределить по субагентам и построить адекватную историю изменений.
Перед отправкой Merge Request (далее — просто MR) технический документ приводится в соответствие с фактической реализацией. Если мы работаем с уже существующей механикой, то обновляем существующую документацию, но тоже в том же MR. За актуальность отвечает тот, кто выполняет задачу.
Эта ответственность не закрепляется навсегда за первым автором: если магазин реализовал один разработчик, а дорабатывает другой, документацию обновляет второй. Если в ходе работы обнаруживается расхождение, его может исправить тот, кто расхождение нашёл. Когда уверенности не хватает, можно обратиться к автору, если он ещё доступен.
Технический документ после работы над задачей остаётся частью репозитория. Нагенерированные спецификации, планы, исследования и отчёты не добавляются в репозиторий, но могут сохраняться локально у автора — дальше он отвечает за их хранение и сам решает, когда контекст ещё нужен, а когда документы можно удалить.
Так как ведение документации — часть работы над задачей, её, как и код, полезно рефакторить: большой документ можно декомпозировать на несколько и связать ссылками. Устаревшие описания нужно исправлять или удалять.
4. Организация документации
Техническая документация хранится в Markdown и отдельно от исходного кода, в директории Docs/ в рамках того же Git-репозитория. Это даёт команде и агентам единое известное место для документов и позволяет поддерживать общую структуру.
Шаблон такой структуры с примерами документов можно найти в git-репозитории. Все документы намеренно переведены полностью на русский и существенно переработаны со значительным упрощением, чтобы отдалить их от реального проекта.
Docs/
├── README.md
├── tech-passport.md
├── Architecture/
│   ├── Backend/
│   ├── Shared/
│   └── Unity/
├── GameFeatures/
│   ├── CoreGame/
│   └── MetaGame/
├── ADR/
├── Conventions/
└── Guides/
Индекс документации
В корне Docs/ находится README.md — индекс с деревом документов, ссылками и поисковыми тегами. Например:
GameFeatures/
└── CoreGame/
    ├── [attack-system.md](GameFeatures/CoreGame/attack-system.md):
    │   attack, атака, урон
    ├── [status-system.md](GameFeatures/CoreGame/status-system.md):
    │   status, статус, эффект, дебафф, бафф
    └── [ability-system.md](GameFeatures/CoreGame/ability-system.md):
        ability, способность, умение
Теги включают ключевые термины, синонимы и переводы. Поэтому документ можно найти обычным поиском по тексту, даже если читатель не знает его точного имени. При этом индекс помогает не только найти отдельный файл, но и сразу увидеть соседние по теме документы.
Теоретически теги можно хранить и внутри самих документов, во frontmatter. Но тогда потребуется выполнить лишнее действие, чтобы добраться до общего дерева. И не то чтобы есть какая-то существенная разница — тут больше дело вкуса.
Директория Docs/ обособлена от исходного кода, поэтому документацию легко индексировать для векторного поиска и RAG. Но обычно это избыточно: это усложнение, дополнительная поддержка и дисциплина при актуализации индекса. Для одного проекта выигрыша от этого усложнения никакого.
Связь документации с кодом
В XML-документации классов мы используем <seealso>, чтобы указать соответствующий технический документ:
/// <summary>Управляет жизненным циклом игровых статусов.</summary>
/// <seealso href="status-system.md"/>
public class StatusService
{
}
В href указываем только имя файла, без пути, так как структура Docs/ со временем меняется: документы перемещаются и перегруппировываются. Имя файла — достаточный инвариант, чтобы успешно найти документ. При этом агент знает, что если он натыкается на такой тег, то ему стоит прочитать сначала соответствующую документацию.
Документация для AI-агентов
Помимо технической документации, агенту нужен контекст о том, как работать с проектом: где искать информацию, какие правила соблюдать и как выполнять типовые задачи. Для этого рядом с Docs/ мы храним общие инструкции, скиллы и рабочие материалы агентов.
./
├── AGENTS.md
├── Docs/
│   └── AGENTS.md
├── .opencode/
├─х .codex
├─х .claude
└── .agents/
    ├── skills/
    ├─х plans/
    │   └── status-system/
    │       ├── spec.md
    │       ├── plan.md
    │       ├── explore.md
    │       ├── research.md
    │       └── probe-01.md
    └─х tmp/
Инструкции для агентов у нас написаны на английском. Были времена, когда русский заметно влиял на качество ответов (и на кол-во токенов, но кто бы их считал с подписками). Сейчас, по нашим наблюдениям, уже не так важно, на каком языке написаны документы. Но мы продолжаем использовать английский по инерции и для лаконичности.
При этом сама техническая документация написана на русском: с ней работают прежде всего люди, которым удобнее читать и писать на родном языке.
Корневой AGENTS.md служит точкой входа в проект для агента: указывает важные каталоги, источники знаний и основные общие правила.
Вложенные в другие директории AGENTS.md дополняют общие инструкции правилами для отдельных частей проекта. Так, в Docs/ тоже есть свой AGENTS.md с требованиями к структуре и оформлению технических документов. Более конкретные детали описаны уже в соответствующих скиллах.
.agents/ — универсальная директория, которая позволяет хранить контент для агентов независимо от используемого харнесса, как и AGENTS.md. Для специфических харнессов у нас есть инструмент, создающий симлинки, раннюю версию которого я успел показать в своём докладе по AI-Driven Development.
В каталоге skills/ находятся скиллы для агента. tmp/ служит общим местом для скриптов и прочих временных вспомогательных файлов агента. В plans/ хранятся временные материалы, которые нужны агенту для работы над задачами. Задачи группируются по каталогам с уникальными именами. Содержимое tmp/ и plans/ полностью исключается из git-репозитория и существует только локально.
Внутри plans/ у каждой задачи могут быть следующие файлы:
explore.md— карта текущей области задачи, собранная по документации и коду: компоненты, связи, контракты и другие факты со ссылками на источники. Она помогает понять, как система устроена сейчас.research.md— исследование вариантов решения конкретной проблемы: возможные подходы, их плюсы, минусы и ограничения. На его основе агент выбирает направление работы.probe-*.md— результаты проверок гипотез, которые нельзя подтвердить или опровергнуть только чтением кода и документации. В каждом файле фиксируются рассматриваемая гипотеза, способ проверки, отчёт и влияние результата на решение.spec.md— полное описание задачи: цель, контекст, границы, гипотезы, выбранное решение, необходимые изменения и сценарии. В нём также фиксируются всякие допущения и ссылки на другие документы.plan.md— разбиение спеки на задачи для субагентов. Для каждой задачи задаются описание, ожидаемый результат, зависимости, порядок выполнения и условия завершения.
Эти файлы — артефакты коммуникации с агентом: через них мы передаём ему задачу и контекст, обсуждаем решения и получаем результаты исследований. Они также помогают субагентам обмениваться контекстом при распределении работы.
Помимо общего .agents/ рядом могут лежать директории с дополнительными настройками для конкретных харнессов. И они исключены из репозитория, чтобы каждый мог себе заколхозить всё, что захочет.
Но есть референсный .opencode/ с подключенными MCP, плагинами, субагентами и прочими настройками, которые можно при желании мигрировать в форматы иных харнессов.
Автоматизация проверок
Каждый MR проходит отдельное AI-ревью в CI как этап Quality Gate. Это не единственная точка, где агенты проверяют работу. Это происходит ещё и до публикации MR, но здесь — это финальный страховочный пункт.
Помимо кода и других изменений, агент здесь перепроверяет, нужно ли было создать или обновить документацию, соответствует ли она реализации, нет ли дублирования и противоречий. При обнаружении проблемы он оставляет комментарий в MR.
При перемещении и добавлении документов могут ломаться ссылки, устаревать индекс или нарушаться принятая структура. Агент на CI тоже за этим следит. Если такие ошибки становятся регулярными, их можно отслеживать более быстрыми и дешёвыми детерминированными проверками через скрипты. Но нам пока хватает простых инструкций.
Помимо ревью изменений, мы периодически запускаем агента, который сверяет документацию с кодом и самостоятельно исправляет расхождения. Так как технический документ описывает именно текущую реализацию, то у агента весь контекст для этого доступен.
Ещё сейчас тестируем дополнительного агента, который сверяет изменённые технические документы с ГДД и подсвечивает расхождения на этом уровне. Потому что такое, увы, случается, и за этим сложно уследить.
┌────┐     ┌───────────────┐                 ┌──────────────────┐
│ MR │ ──> │ AI-ревью в CI │ ── проблема ──> │ Комментарий в MR │
└────┘     └───────────────┘                 └──────────────────┘

┌───────────────┐     ┌────────────────────┐     ┌─────────────┐
│ По расписанию │ ──> │ Документация ↔ код │ ──> │ Исправление │
└───────────────┘     └────────────────────┘     └─────────────┘

┌──────────────┐     ┌────────┐                    ┌────────────┐
│ ГДД ↔ техдок │ ──> │ Сверка │ ── расхождение ──> │ Оповещение │
└──────────────┘     └────────┘                    └────────────┘
5. Качество документации
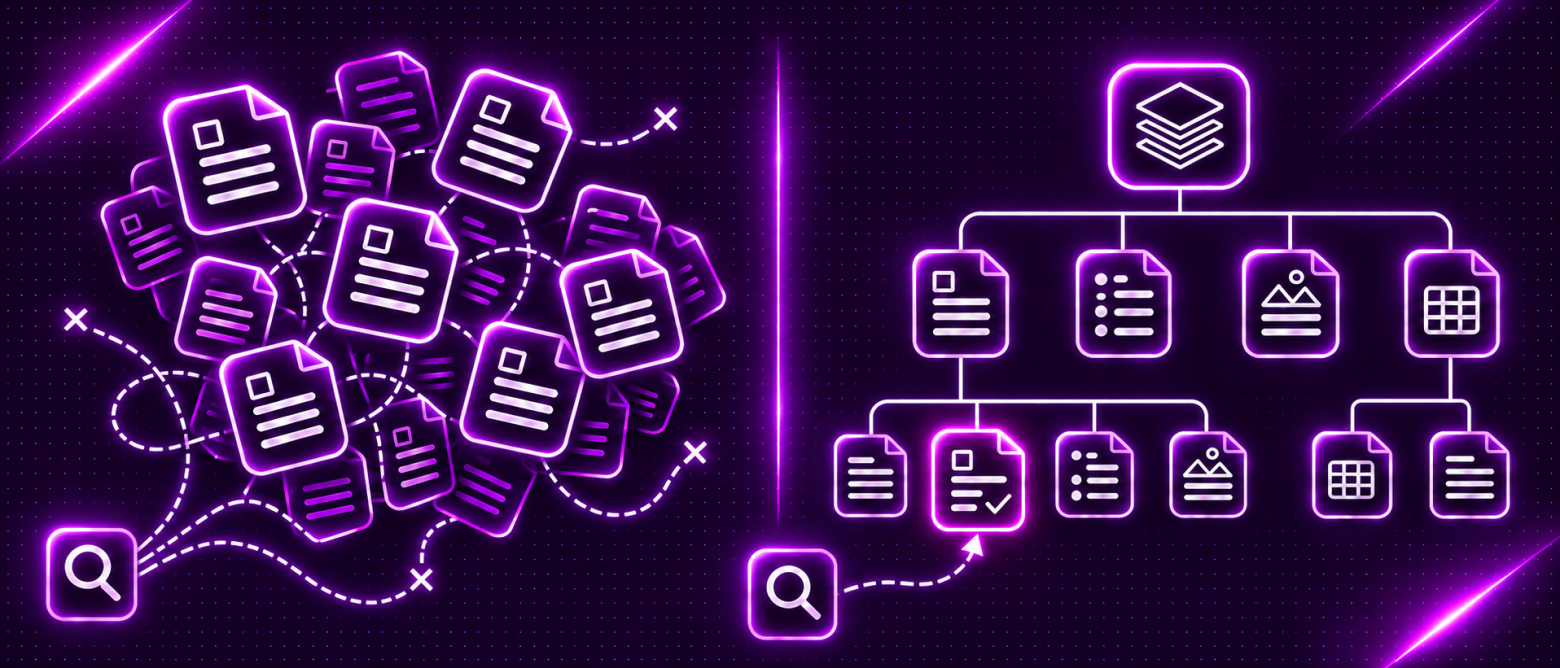
Хороший документ помогает быстро найти ответ без дополнительных объяснений автора. Умение писать такой текст — отдельный нарабатываемый навык. Нужно уметь выделять главное, структурировать информацию и смотреть на решение глазами будущего читателя.
К сожалению, этот навык редкий. И агент пока не способен его качественно заменить. Хотя и с каждым новым поколением моделей становится лучше. Зато он отлично масштабирует все накопленные в документах проблемы. Что сильно усложняет дальнейшую работу. Поэтому навык работы с текстом сейчас имеет большую ценность.
Документ читают многократно, поэтому минуты, сэкономленные автором на проработке, могут обернуться потерями времени или менталки каждого читателя. Краткость и удобная навигация важны даже тогда, когда сгенерировать ещё букв почти ничего не стоит.
Агент может помогать создавать и поддерживать документацию, но его тексты и выводы по-прежнему нужно проверять. AI также не всегда правильно понимает, сколько подробностей в документе уместно. Агент может создать документ для тривиальной локальной логики или многословно и витиевато пересказать очевидное.
Работу с документацией стоит начинать с вопросов: кому она нужна, на какой вопрос должна ответить и нельзя ли получить этот ответ из уже существующих источников? Может оказаться, что отдельный документ и вовсе не нужен. Избыток информации — это такая же проблема, как и её недостаток. За этим нужно следить.
Хорошие документы в проекте становятся примерами для следующих, и с каждым новым документом растёт качество покрытия и уровень автономности агентов. Порядок в документации — это залог здорового масштабирования.
Помните, что ценность документации определяется не количеством написанных строк и документов, а количеством вопросов, на которые она помогает ответить, и количеством сэкономленного времени на получение этих ответов.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.