MicrosoftがOutlookの大規模障害の原因を公表、2026年7月のバグ修正が引き金となりサーバーの80%以上が応答不能に
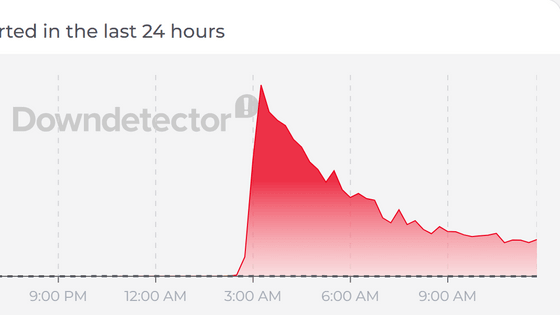
Microsoftの幹部であるチャールズ・ラマナ氏は11月16日、障害が発生した経緯をXで説明しました。
— Charles Lamanna (@clamanna) 2026年11月16日More details on the root cause can be found in the Microsoft 365 Admin center, and an abridged version can be found below.
We are deeply sorry for the impact to all our customers and recognize the impact that this has on their normal business & operations.
The incident on… https://t.co/p8mUHxDe67
ラマナ氏によると、障害の根本的な原因は2026年7月にMicrosoft 365のネットワークゲートウェイに適用されたソフトウェアの修正にあったとのこと。修正によって、複数の処理が同じリソースを取り合って処理が滞る「ロック競合」が発生し、特定の負荷条件下でサーバーが応答しなくなるバグが混入していました。
問題のソフトウェアはMicrosoftの通常のテストを通過し、数週間かけて世界中のサーバーに展開されていました。Microsoftのテスト環境では主にCPUのコア数が少ない旧型のサーバーが使用されていましたが、バグはCPUのコア数が多い新型のサーバーで発生しやすかったため、事前に検出できなかったそうです。
大規模障害が発生するおよそ15時間前、MicrosoftはTeamsの通信を代替のネットワークゲートウェイからExchange Onlineと共用するメインのネットワークゲートウェイに切り替えていました。さらに、前日に発生した別の問題によってネットワークゲートウェイの処理能力の約14%が失われていました。残りの86%でも通常の通信量を処理するには十分でしたが、Teamsの通信が加わったことで負荷や通信パターンが変化し、7月から潜伏していたバグが表面化しました。
Microsoftのインフラには、サーバーが応答しなくなった際に通信を正常なサーバーへ自動的に振り分ける仕組みが備わっています。しかし、今回は通信の振り分け先でも負荷が増加して同じバグが発生し、障害が次々と別のサーバーに波及しました。結果として、わずか2時間足らずでネットワークゲートウェイを構成するサーバーの80%以上が応答不能に陥りました。
通常はサーバー群を分割したり地域ごとにインフラを分離したりすることで障害の拡大を防げるはずでしたが、別の問題によってこうした安全策も機能しませんでした。TeamsやOneDrive、SharePointなどは障害の影響を受けたゲートウェイから通信を迂回させることができた一方で、Exchange Onlineでは同様の対応ができなかったとのこと。
Microsoftによると、従来の復旧の仕組みはこれほど大規模な障害を想定しておらず、サーバーを復旧させても滞留していた通信が殺到し、再び応答不能になるという問題が発生していました。また、バグが混入してから約4カ月が経過していたため、ソフトウェアを単純に以前のバージョンに戻すことも困難でした。
そこでMicrosoftは問題のある処理を正常に動作していた状態に戻す修正プログラムを開発。サーバーをまとまった単位で停止させて修正プログラムを適用し、再起動したサーバーを段階的に稼働させることでサービスを復旧させました。Microsoftは週内に最終的な調査報告書を公開し、より詳細な技術情報や再発防止策を明らかにする予定です。
しかし、障害の原因が公表された11月16日には、再びMicrosoft 365で問題が発生していることがユーザーやシステム管理者から報告されています。新たな問題と11月12日の大規模障害との関連性は明らかになっていません。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.