Миграция 4 миллионов игроков на новую версию: три подхода к подготовке и авария за сутки до старта
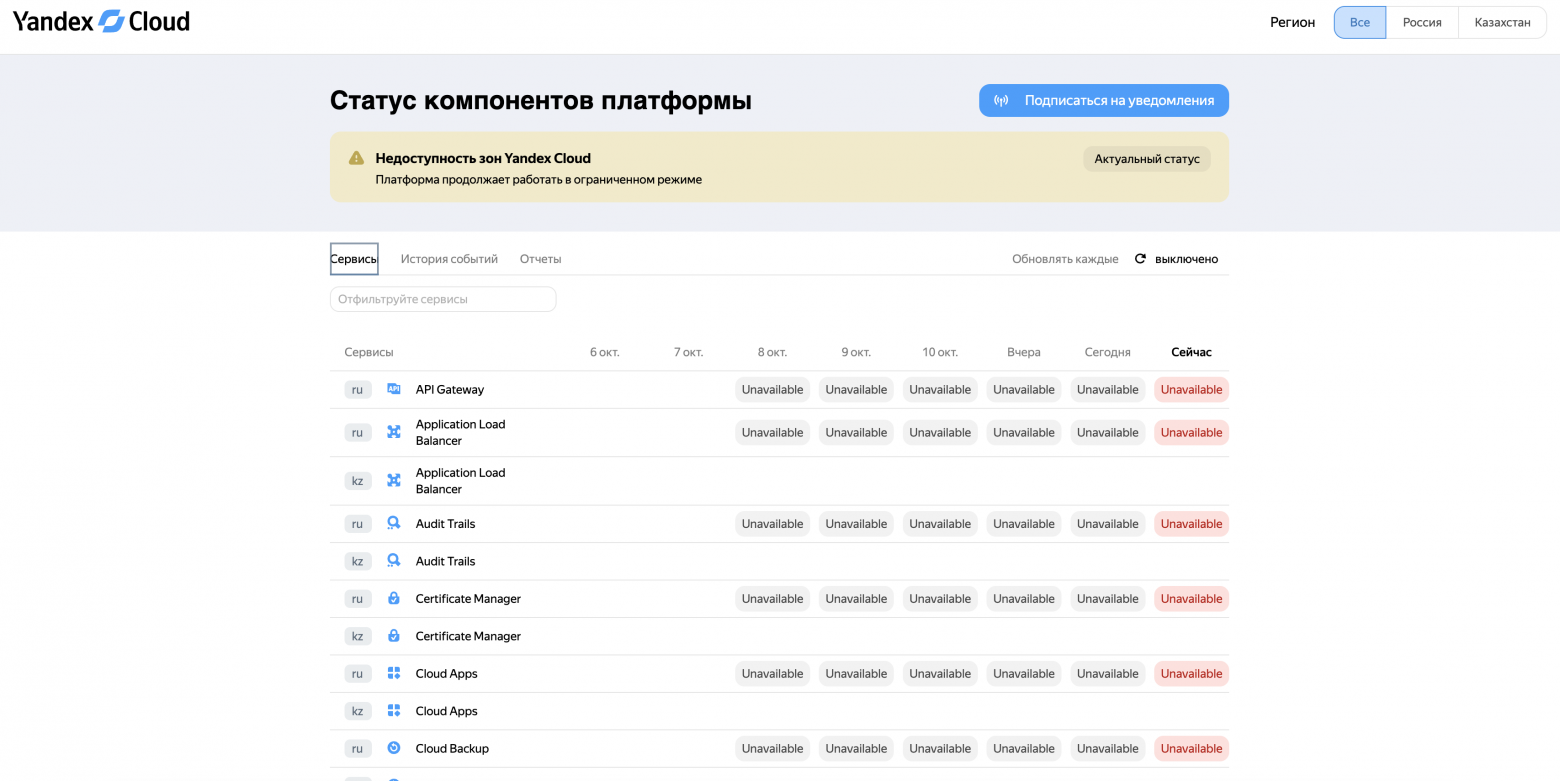
Вечером, за сутки до переноса четырёх миллионов игроков на новую версию игры, вся российская часть нашей инфраструктуры стала недоступна: после атаки на Yandex Cloud легла зона, в которой она жила. Расскажу, как мы год готовились к этой миграции, какие предположения подтвердились, а какие нет, где нам помог Claude Code и где мы ошиблись, несмотря на его помощь. В конце покажу, что стало с аудиторией и выручкой.
Всем привет! Я тимлид инфраструктуры в игровой студии, и это история о переезде с позиции человека, который отвечал за то, чтобы в день миграции всё работало. К аварии в Yandex мы ещё вернёмся, а начать стоит с того, что у нас было и к чему хотелось прийти.
Что переезжало и зачем
Наш продукт — мобильная игра с примерно 4,2 млн аккаунтов и средним DAU около 80 тысяч. Старая версия представляла собой монолит на PHP и много, очень много cron job, а сверху — тяжёлый мобильный фронтенд на Unity. Данные хранились в MySQL, Redis и object storage, в качестве балансировщиков работал старый добрый nginx. Всё это крутилось на bare metal в Hetzner — дёшево, но иногда слишком сердито.
Уже из этого описания можно угадать предпосылки миграции. Перечислю основные продуктовые:
Unity собиралась брать деньги за каждую установку игры, без оглядки на выручку. Позже они переобулись, но процесс перехода на другую технологию было уже не остановить.
Скорость работы, архитектура и дизайн игры перестали отвечать современным требованиям. Для людей, любящих вспоминать свои 2010-е, в самый раз, но в 2020-х уже не то.
Очень хотелось освежить стек.
Были и инфраструктурные:
Нам не хватало облака с управлением ресурсами через API. На bare metal новый сервер заказывается заявкой, и ждать его можно часами, а то и днями.
Новая версия игры проектировалась как набор микросервисов, так что Kubernetes напрашивался сам собой.
Хотелось выстроить CI/CD правильно и наконец уйти от Jenkins. Я безмерно люблю и уважаю Jenkins, но для современных проектов это перебор.
Новый стек получился таким:
фронтенд — Flutter: одна кодовая база для мобильных версий и веба;
бэкенд — Go, несколько десятков микросервисов;
данные — целый набор: Postgres, Valkey, Redpanda, Cassandra, OpenSearch и, конечно, object storage.
Всё это заезжало в DigitalOcean: stateless-сервисы в managed Kubernetes, stateful-компоненты на виртуальные машины. Отдельный кусок инфраструктуры для игроков из России жил в Yandex Cloud.
Почему Valkey, а не Redis или KeyDB, Redpanda, а не Kafka, и Cassandra, а не ScyllaDB, — тема для отдельной статьи. Если интересно, напишите в комментариях, и я её подготовлю.
Над новой версией работали около 20 человек. Саму миграцию поддерживали шестеро: CTO, пара бэкенд-разработчиков, один DevOps-инженер, тестировщик. К переезду мы подходили трижды, и каждый подход учил чему-то своему.
Подход первый: нагрузочные тесты, которые ничего не доказали
Первые попытки оценить, сколько выдержит строящаяся новая версия, начались примерно за год до миграции. Главный вопрос звучал так: как соотнести её возможности с нагрузкой, которую держит старая?
Повторить стенд из Hetzner в DigitalOcean один в один мы не могли. Это было слишком дорого, да и некоторых конфигураций железа в DO просто нет. Поэтому пошли через пропускную способность и latency на единицу ресурсов. Написали несколько сценариев для Grafana k6 — регистрация, получение профилей пользователей, получение личных сообщений — и гоняли их против бэкендов, запущенных в одной реплике, чтобы было проще считать:
при 10 rps ответы в среднем укладывались в 250 мс;
при 50 rps кое-где доходили до 600–800 мс;
более серьёзная нагрузка исчерпывала выделенные ресурсы и приводила к отказам.
Параллельно мы пытались экстраполировать. Новая версия уже была доступна для новых игроков, их было немного, но мы сравнивали онлайн и создаваемую нагрузку на обеих версиях. Ясности это не внесло. Архитектура отличалась слишком сильно: логика нового фронтенда порождала больше запросов к бэкенду, а каждый такой запрос — ещё и пачку внутренних запросов между микросервисами. Железо, базы данных и типы хранимой информации тоже были разными. Сравнивать «запрос старой версии» с «запросом новой» оказалось всё равно что сравнивать километры с литрами.
Зато первый подход дал нам первый урок: лимиты по CPU на бэкендах — зло. В Kubernetes requests уже определяют, какую долю процессорного времени получит контейнер, когда за CPU на ноде идёт конкуренция. limits же жёстко режут контейнер даже тогда, когда процессор на ноде простаивает. В итоге бэкенду внезапно нужно больше CPU, свободное CPU на ноде есть, а забрать его не даёт лимит, и latency растёт на ровном месте. Лимиты по CPU мы убрали.
Подход второй: меняем фундамент на ходу
За три месяца до миграции на нас посыпались крупные изменения, и почти ни одно из них мы не планировали.
ScyllaDB закрыла opensource-версию. Бесплатно остались только небольшие кластеры, а за всё, что больше, цену обсуждают индивидуально: приходите, расскажите, какой кластер собираетесь развернуть, и мы скажем, сколько заплатить. Выход — миграция в Cassandra, пока пользователей в новой версии мало.
Старый добрый ingress-nginx объявили завершённым проектом. Выход — миграция на Gateway API с реализацией на Envoy.
Redis 7 исполняет команды в одном потоке, и в это мы легко могли упереться. Выход — Valkey, который заметно лучше параллелит ввод-вывод.
Ресурсы для десятков бэкендов. Отдельной задачей стояло подобрать requests и настройки HPA (Horizontal Pod Autoscaler — автоматического масштабирования подов) так, чтобы сервисы эффективно утилизировали воркер-ноды.
Связь с Yandex Cloud. Российская часть инфраструктуры общалась с основной в обе стороны, и периодически мы наблюдали замедления и потери пакетов. Когда игроков станет в десятки раз больше, в игре, рассчитанной на реалтайм, это могло обернуться серьёзными задержками. Тяжело играть, когда оппонент сделал ход, а ты видишь его только через пару-тройку секунд: это ломает механики.
В это же время мы провели первый боевой перенос: около 10 тысяч игроков из одной страны. Всё прошло хорошо, и мы были уверены, что дальше будет так же.
Решение по ресурсам на этом этапе было простым: наращиваем инфраструктуру с запасом. Лучше переплатить за неделю утилизации дополнительных ресурсов, чем выделить впритык и сломаться на самом ответственном этапе. Позже за этот запас пришлось платить и деньгами, и временем на ужимание, но об этом в конце.
Подход третий: агент с доступом ко всему
Всё это время прогресс не стоял на месте, и AI-агенты плотно вошли и в разработку, и в инфраструктурные задачи. Примерно за месяц до переезда мы посадили Claude Code составлять план: чего нам не хватает и что может пойти не так.
К тому моменту агент был подключён через MCP ко всем нашим системам. У него был доступ к коду во всех репозиториях, к метрикам, логам и трейсам, к Kubernetes-кластерам. Он знал главную вводную: следующая волна — 200 тысяч игроков. На выходе получился документ с приоритизированным списком рисков (P0 — чинить до волны, P1 — до основной миграции), и дальше мы работали по нему.
Волна на 200 тысяч
Примерно за неделю до основной миграции мы перенесли первые 200 тысяч «счастливчиков» из нескольких стран. Задача волны была отточить процедуру переноса и, главное, увидеть, как растёт нагрузка на каждом компоненте: балансировщиках, бэкендах, базах.
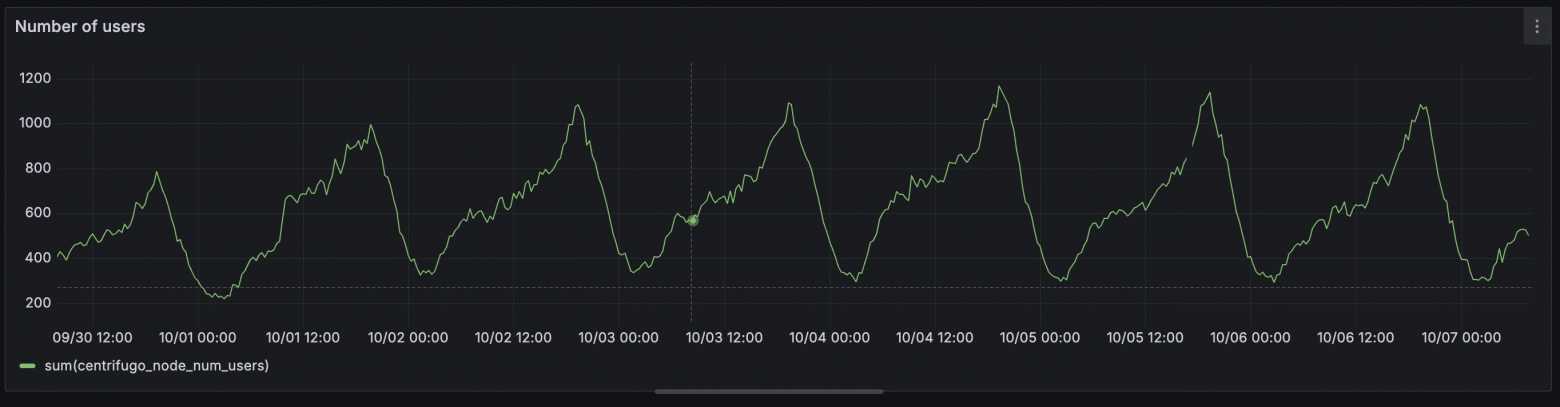
Хорошо видно это по Centrifugo — нашему realtime-серверу. Каждый открытый клиент держит к нему WebSocket, поэтому число подключённых пользователей и есть онлайн в моменте (CCU, concurrent users). В неделю до волны суточные пики онлайна держались на уровне 650–830 человек, в день волны дошли примерно до 1010, а в следующие дни — до 1110–1180.
После волны мы снова отдали агенту метрики «до» и «после» и попросили найти, что будет узким местом при 4 миллионах. Вот что он нашёл.
Таблица на 599 строк, которую прочитали 310 миллионов раз
Postgres, обслуживающий комнаты, заметно нагружал CPU. Claude нашёл причину: кривой запрос, который при каждом вызове целиком сканировал таблицу (seq scan), причём дёргался он неоправданно часто. Сама таблица была крошечной, 599 строк, но суммарно её прочитали 310 миллионов раз. Агент сам поправил и запрос, и частоту его вызова.
Гистограммы, которые съедали Prometheus
HTTP-метрики сервисов отдавались гистограммами с большим числом бакетов. Каждый бакет — это отдельный временной ряд, умноженный на число эндпоинтов, методов и статусов. При кратном росте трафика такая кардинальность убила бы Prometheus, и в самый ответственный момент мы остались бы без мониторинга. Prometheus и так уже подбирался к своему лимиту памяти в 8 ГБ.
Библиотеку метрик мы с Claude поправили сами. Но выкатывать новую версию во все сервисы долго, поэтому для скорости добавили relabeling, отбрасывающий лишние ряды прямо при сборе. Данных всё равно оставалось так много, что дашборды тормозили, и пришлось завести recording rules — заранее посчитанные агрегаты, которые Grafana читает вместо сырых рядов.
Перекосы в хранилищах
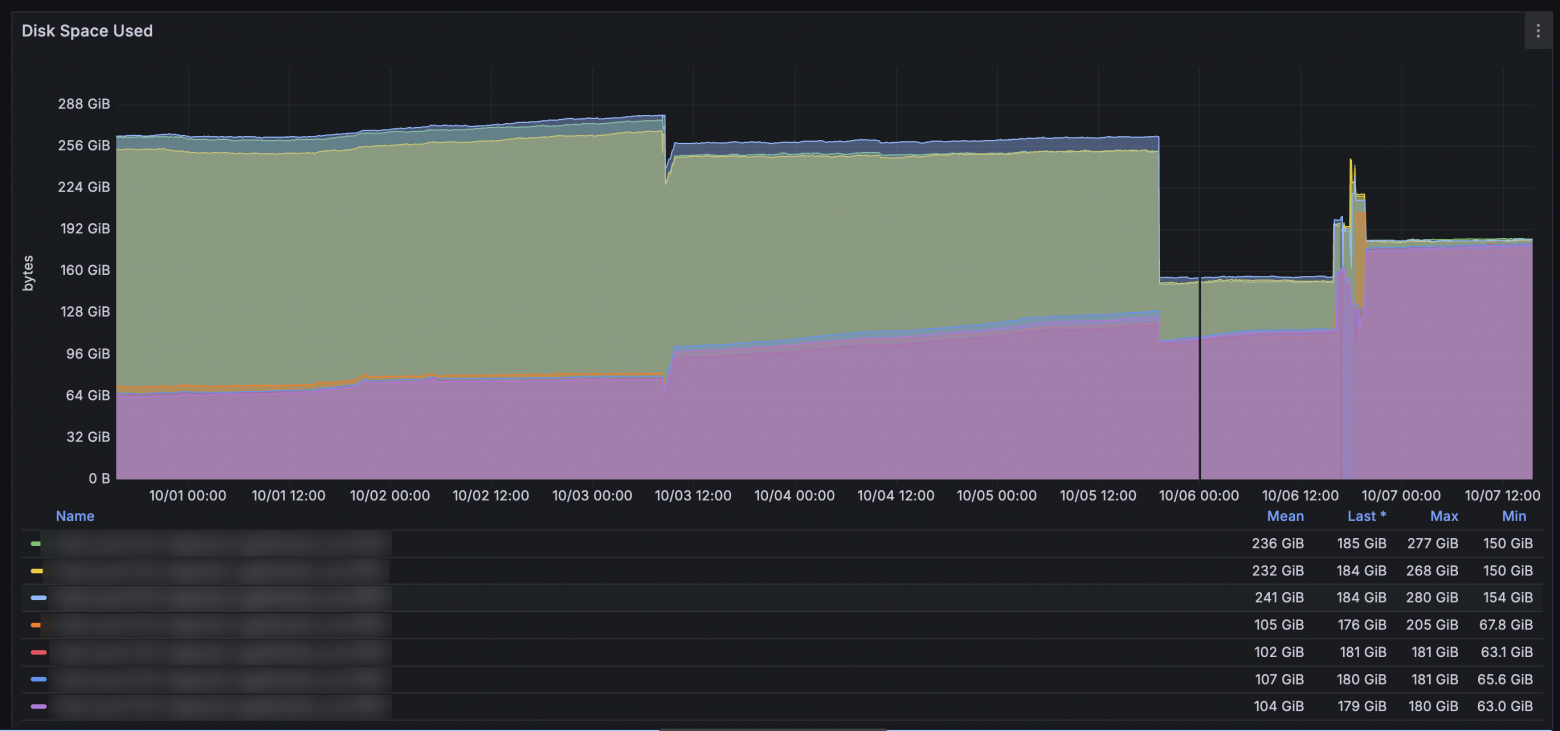
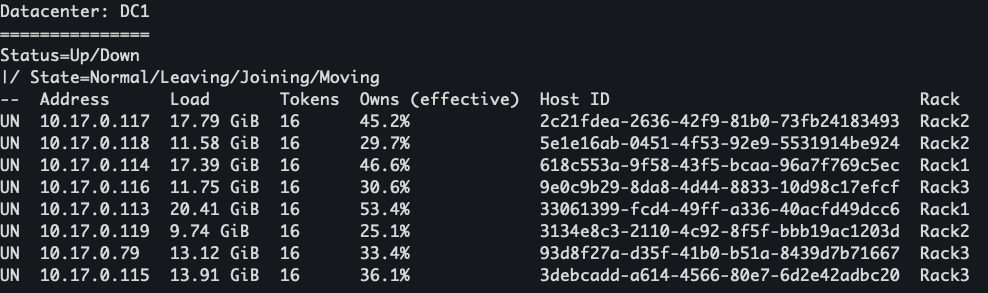
В Redpanda брокеры 0–2 были заняты на 60–65%, а брокеры 3–6 — на 25–28%: данные распределились неравномерно, и при росте нагрузки первыми закончились бы диски у «старших» брокеров. В Cassandra похожая история: доля данных, которой владел каждый узел, отличалась в два раза. Обе ребалансировки мы провели до основной миграции.
Потолок масштабирования
Эту находку до агента не видел никто из нас. У части бэкендов стояло жёсткое правило anti-affinity: не больше одного пода сервиса на ноде. Задумывалось оно ради отказоустойчивости, но некоторым сервисам под нагрузкой нужно 20–30 реплик. HPA честно поднимал бы maxReplicas, а новые поды висели бы в Pending, потому что столько нод в пуле просто нет. Мы разрешили планировщику ставить несколько подов одного сервиса на одну ноду.
Гипотезы против данных
Отдельно полезным оказалось то, что агент проверял наши гипотезы цифрами. «8 тысяч ошибок», которые выглядели как системная проблема, оказались двумя id, застрявшими в бесконечном ретрае. Ошибки 3012 в Centrifugo, которые мы списывали на инфраструктуру, вызывал сам клиент. Это уберегло нас от раскопок не в том месте.
Не всё в выводах агента было точным. Его заключения по балансировщикам и сертификатам мы перепроверяли руками, и это правильная привычка: агент уверенно формулирует и верные, и неверные выводы.
Казалось, что мы готовы.
Облако, которого больше нет
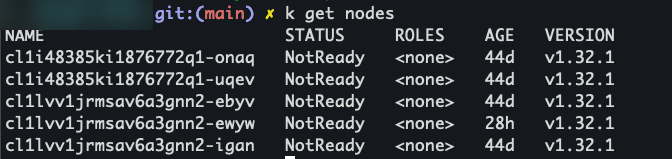
За неделю до миграции мы как раз обсуждали один из старых долгов: вся российская инфраструктура находилась в одной зоне доступности Yandex Cloud. Идея раскидать всё по нескольким зонам и заранее подготовить код для развёртывания необходимого в альтернативном облаке выглядела вполне рабочей — на потом, после миграции.
За день до миграции дата-центр Yandex подвергся атаке, и все compute-ресурсы в нашей зоне стали недоступны. Создать ресурсы в других зонах было невозможно, так что идея про «на потом» отпала сама собой. Мы начали экстренный переезд в другое, менее популярное облако.
В РУ-части у нас жили Kubernetes-кластер, бакеты и CDN. Кластер переносили в первую очередь, и здесь Claude Code отлично помог с кодом: инфраструктуру под новое облако нужно было описать за считанные часы, без права на долгие эксперименты. Кластер подняли за 14 часов до старта миграции. Бакеты и CDN продолжили работать в Yandex и переехали через два дня.
Нам очень повезло в одном: для старой версии игры ресурсы были подняты в двух дата-центрах, поэтому основная часть игроков аварии не заметила.
Последний поворот: старые клиенты
Перед самой миграцией выяснилось, что запросы от определённых User-Agent нужно отправлять по старому адресу. У части игроков стояли старые версии клиентов, и они ходили на главный домен. Этот домен для новых пользователей открывал веб-приложение, а для этой небольшой части должен был вести на старое приложение.
Изначально домен должен был работать через CDN, а там такие правила маршрутизации не настроишь. Решение пришлось быстро менять. Claude помог собрать маршрутизацию на Envoy, и тут, в спешке, я понял, что больше не держу схему распределения трафика в голове: такой сложной она стала и так часто менялась.
День миграции
Структуры данных в старой и новой версиях сильно отличались, поэтому переносили их логически, через API, а не копированием баз. Процесс подразумевал недоступность игры около двух часов и состоял из таких этапов:
Загрузка мобильных версий в сторы.
Блокировка изменений некоторых сущностей в игре.
Перенос этих сущностей.
Включение заглушки о технических работах.
Миграция основных данных.
Распространение обновления мобильных клиентов.
Снятие блокировок с перенесённых сущностей.
Переключение DNS-записей на новую версию.
Дальше, когда игрок заходил в приложение, выполнялась быстрая синхронизация последних данных, и он мог продолжать игру в новой версии, сохранив весь свой инвентарь, сообщения и так далее. Простой уложился примерно в запланированные два часа.
Сколько запросов на самом деле делает новый клиент
Около 10:00 UTC трафик на Envoy подскочил с 600–700 до 3,5 тысяч запросов в секунду и к вечеру дошёл до 5,1 тысячи.
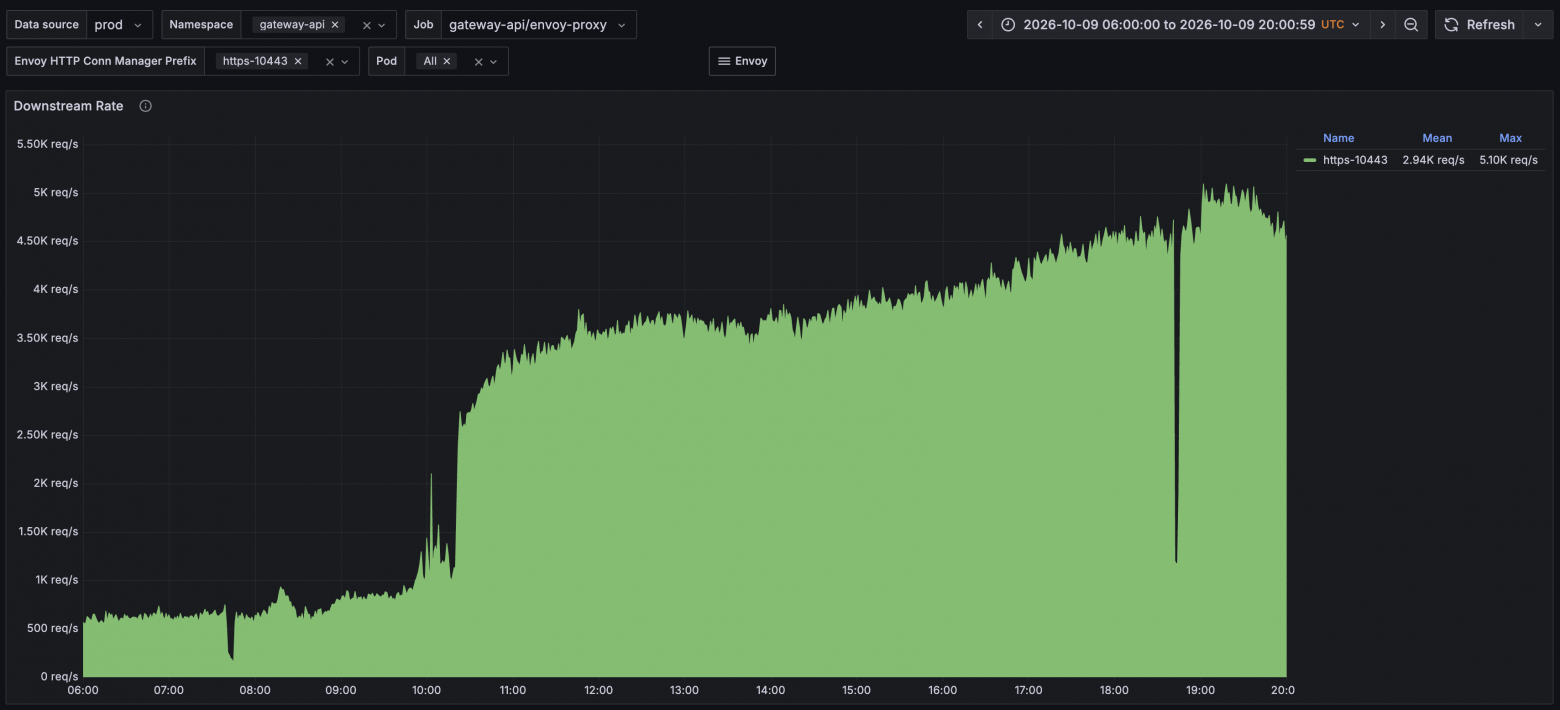
Для сравнения: nginx старой версии при сопоставимом DAU держал 300–900 rps.
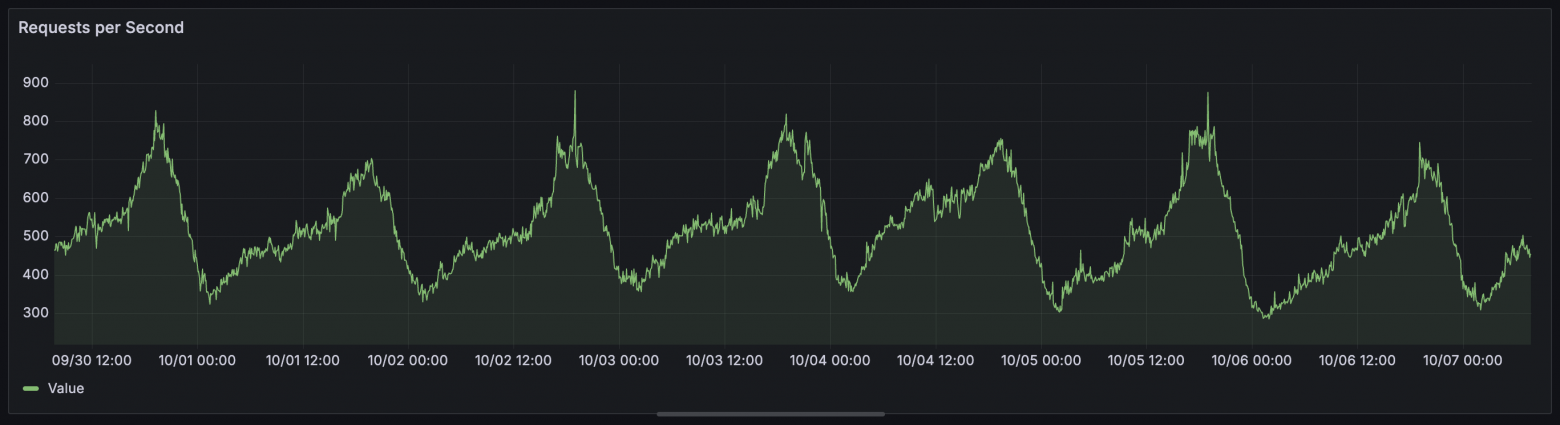
В пересчёте на игрока новый клиент обращается к API примерно в 6–7 раз чаще старого. Ровно это мы подозревали ещё в первом подходе, когда экстраполяция не сходилась, но масштаб увидели только в бою. Хорошо, что инфраструктуру закладывали с запасом.
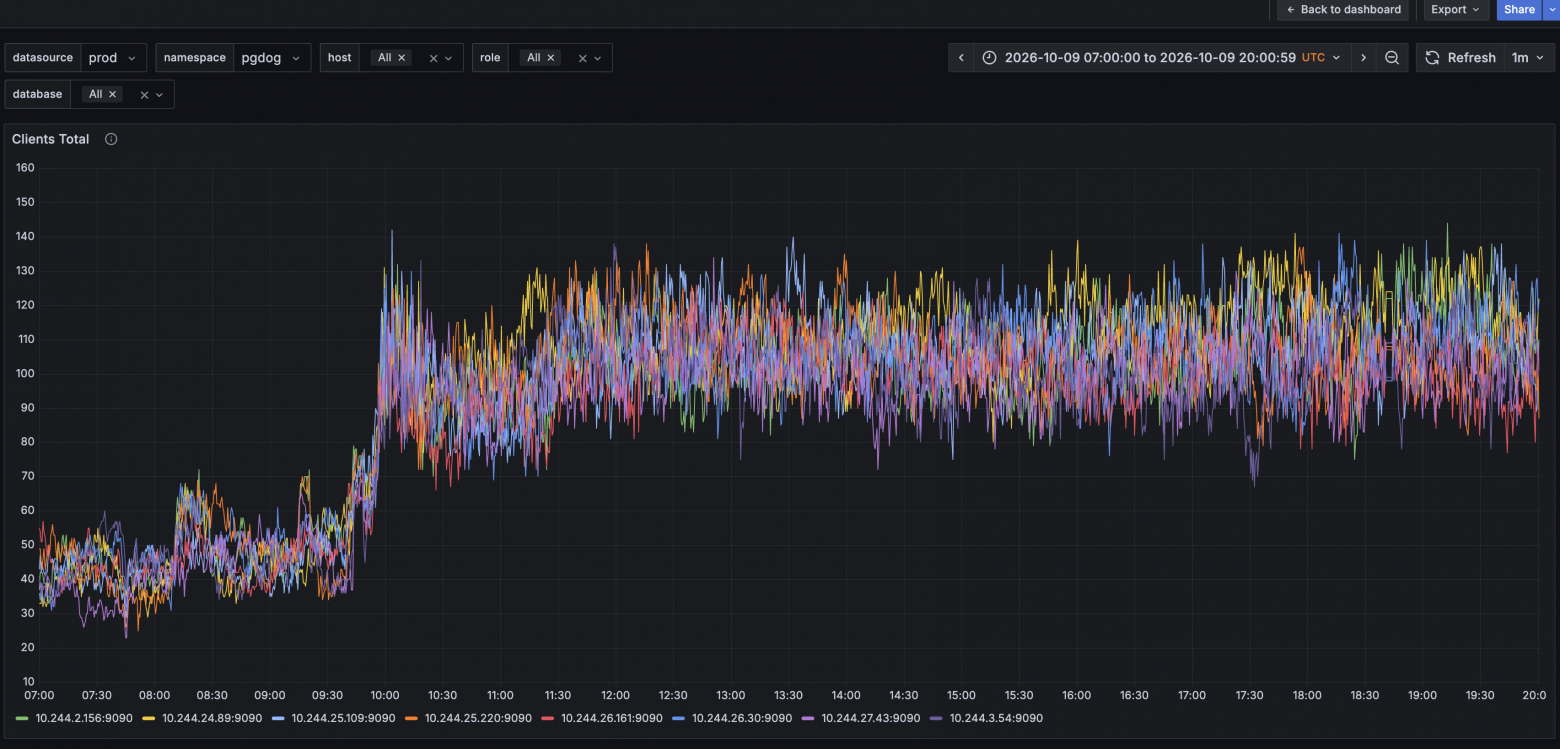
Вслед за трафиком выросла нагрузка на базы. Число клиентов на каждом инстансе PgDog, нашего пулера соединений к Postgres, выросло с 40–50 до 110–130.
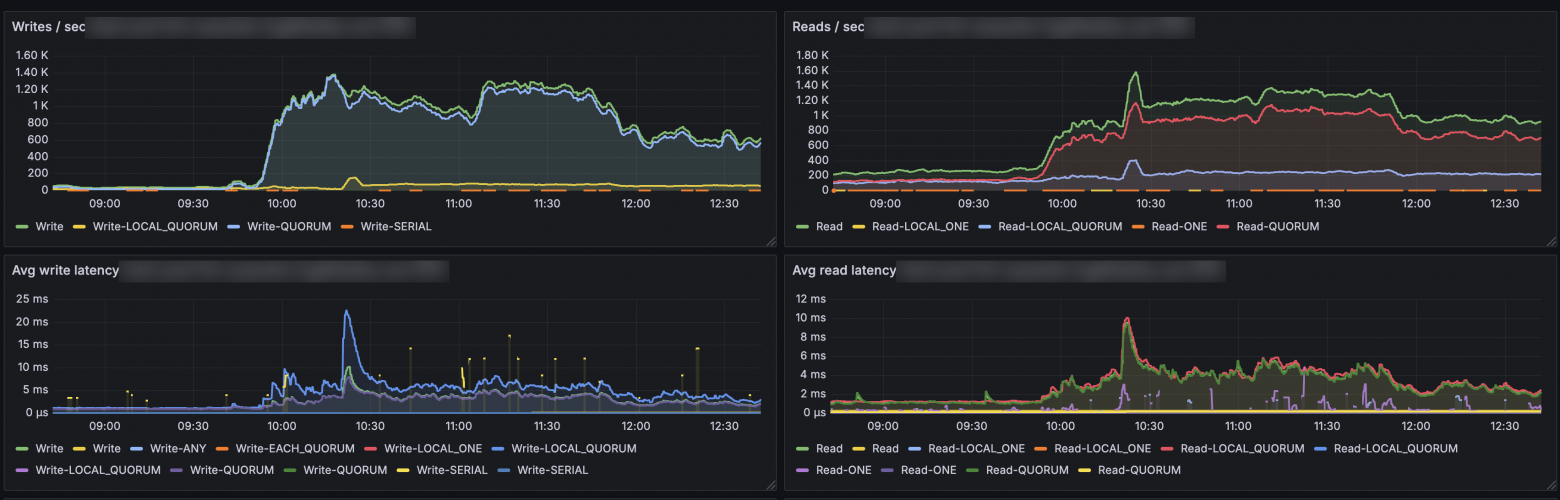
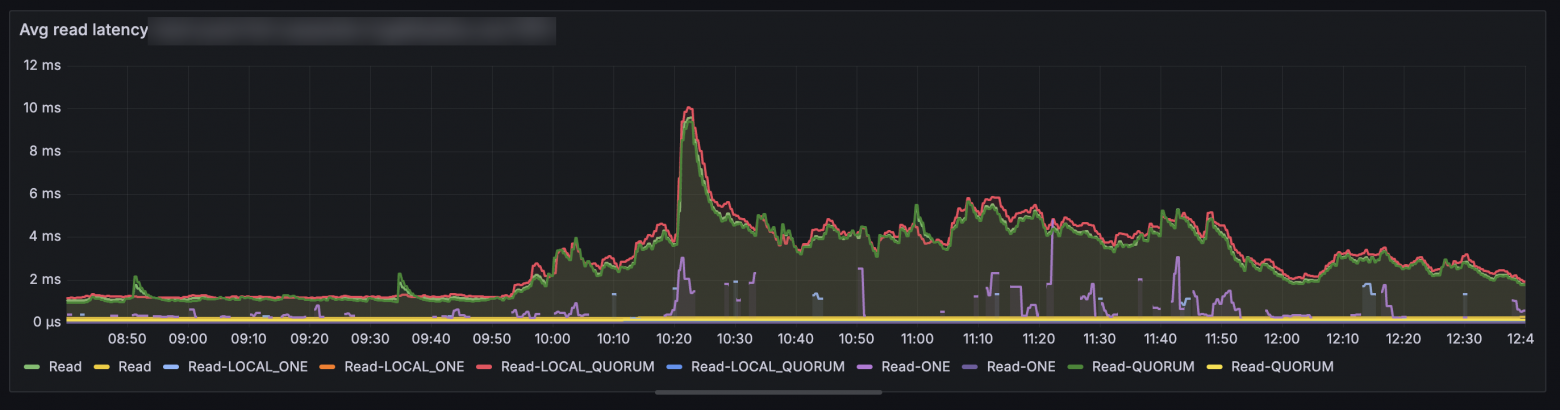
В процессе миграции стало ясно, что Cassandra справляется хуже, чем мы ожидали. Средняя задержка чтения выросла примерно в 4 раза: с 1 мс до 4–5 мс, с пиком в 10 мс в 10:20. Мы добавили узлы, расширив кластер с 9 до 12, и задержка вернулась на место.
Пропавшие переписки
Аналитика показала странное: люди стали резко меньше общаться в личных чатах. Оказалось, чаты переносились в порядке создания, и самые свежие диалоги оказались в самом низу списка. Игроки не могли найти последние переписки и грустили. Сделали быстрый фикс.
Бакеты в очереди
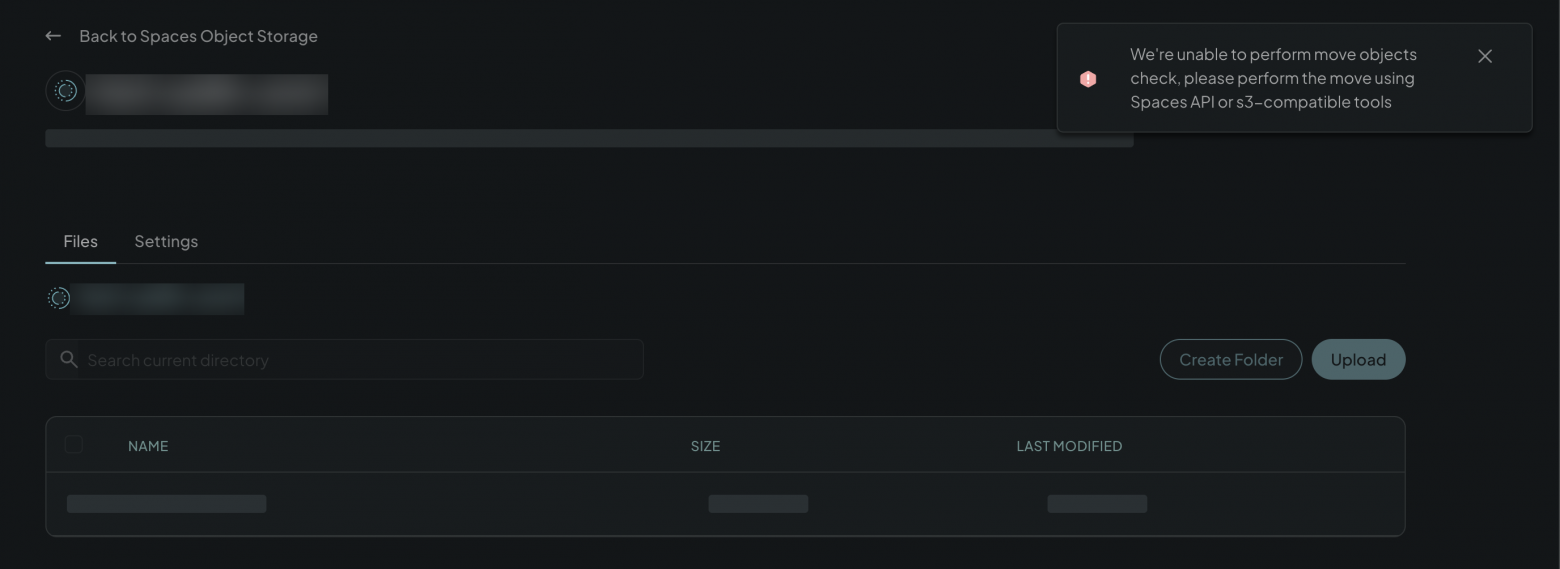
Параллельно мы запустили копирование бакетов из DigitalOcean Spaces в новое РУ-облако. Скрипт выбирал лимиты запросов к бакету, и Spaces начал отвечать с задержками; панель управления и вовсе отказывалась работать с бакетом. Заметили это сразу после миграции и поправили скрипт.
Что вылезло после
CoreDNS и ndots
Через несколько дней мы заметили, что внутренний CoreDNS периодически медленно отвечает. Причина — настройка ndots в resolv.conf подов. По умолчанию в Kubernetes ndots: 5: если в имени меньше пяти точек, резолвер сначала пробует подставить к нему все search-домены кластера. Запрос к api.example.com превращается в несколько заведомо неудачных запросов вида api.example.com.namespace.svc.cluster.local и только потом доходит до настоящего имени. Каждый неудачный запрос — это ответ NXDOMAIN и лишняя нагрузка на CoreDNS.
Мы выставили ndots: 2 в dnsConfig подов. Результат за сутки:
До | После | |
Всего DNS-запросов | 114 млн | 51 млн |
Из них NXDOMAIN | 80.4 млн | 27.5 млн |
Ошибок на бэкендах | ~200 | 16 |
Около 70% всех DNS-запросов в кластере были мусором.
Масштабирование, которое опаздывает
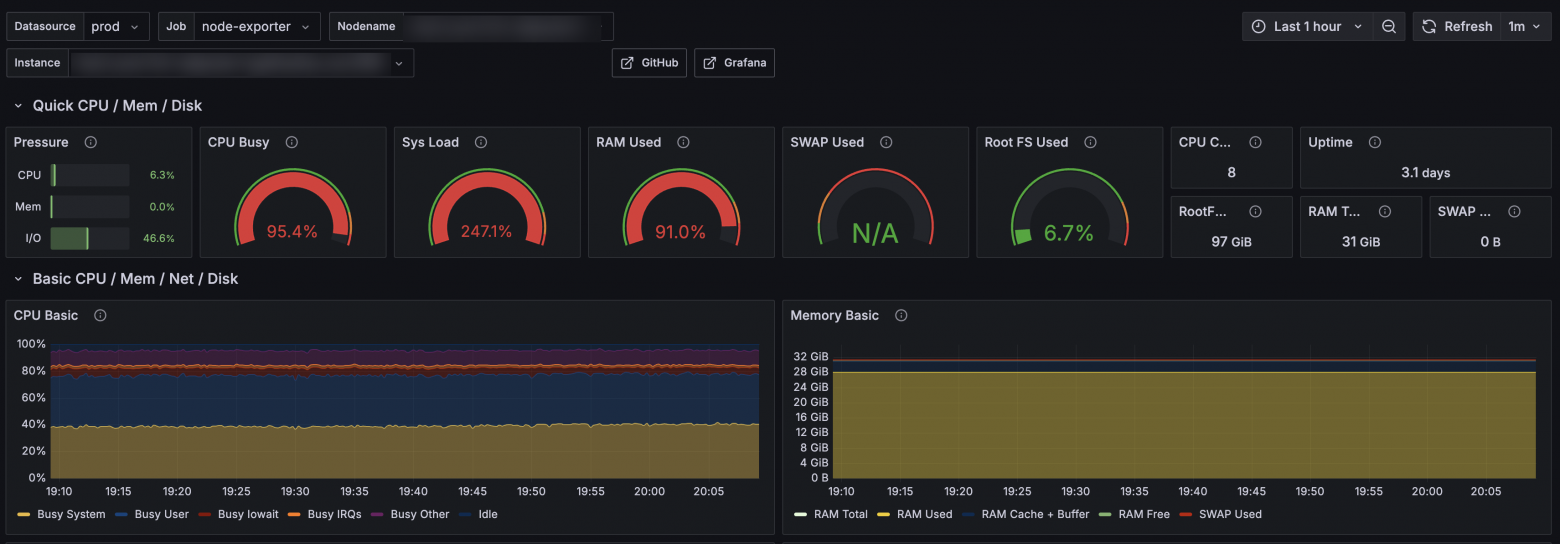
HPA работал, но поды скедулились слишком поздно. Цепочка «метрика дошла до порога → HPA добавил реплики → для них нашлась или поднялась нода → под прошёл проверки готовности» занимает минуты, и к её концу пик уже был в разгаре. Для резкого роста, как в день миграции, реактивное масштабирование слишком медленное: реплики нужно поднимать заранее.
Запас, который стал лишним
Обратная сторона «лучше переплатить» — после миграции стоимость надо было ужимать. Вот что мы сделали:
перевели диски Redpanda на XFS: потребление CPU снизилось, и число брокеров удалось сократить;
срезали реплики Envoy;
уменьшили инстансы Postgres;
отказались от слишком больших дисков, которые заложили «на всякий случай».
Где мы просчитались, даже с агентом
Заголовок обещает, что мы где-то облажались, и это правда. Облажался не Claude, а мы — даже с его помощью. Вот список:
DNS. Намёки на проблему с CoreDNS были в метриках и до миграции. Ни мы, ни агент их не связали в одну картину.
Масштабирование. Мы не угадали с тем, как быстро должны подниматься реплики бэкендов. Агент нашёл потолок anti-affinity, но не то, что HPA просто не успеет.
Prometheus. Мы знали, что он на грани, поправили гистограммы — и всё равно в день миграции у него кончилась память.
Yandex. Риск единственной зоны доступности мы обсуждали за неделю до аварии и сознательно отложили.
Старые клиенты. Требование маршрутизировать по User-Agent всплыло за считанные дни, и решение собиралось в спешке.
Запас ресурсов. Где-то мы заложились слишком сильно, и потом это пришлось ужимать.
Общий вывод такой: агент отвечает на вопросы, которые ему задали, и хорошо ищет в тех данных, к которым у него есть доступ. Он существенно сокращает число неприятных находок, но не позволяет найти или предсказать всё, что пойдёт не так. Особенно то, что лежит на стыке продукта и инфраструктуры, или риски, которые команда сама решила отложить.
Итоги: стоило ли оно того
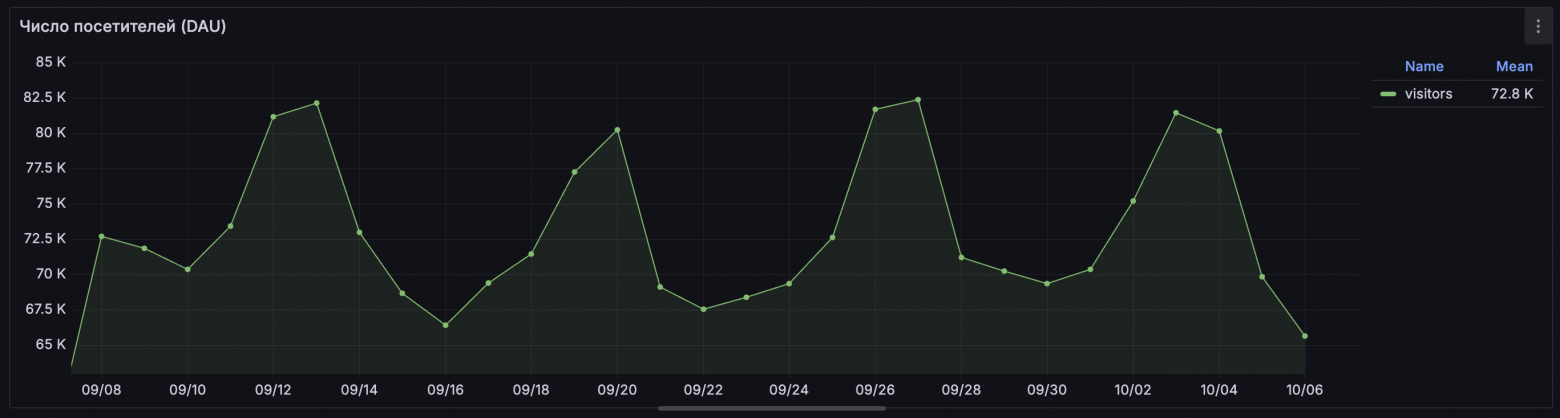
Аудитория. Первые дни было много сообщений о том, что интерфейс изменился, теперь непонятно, где какие кнопки, и вообще всё стало слишком мультяшным. Через неделю от таких заявлений не осталось и следа. DAU не просело: на следующий день после миграции было 86 тысяч против 73 тысяч в среднем на старой версии, а к 25 октября — уже 102 тысячи. Регистрации выросли с 30 тысяч в сутки до 50 тысяч. Здесь, конечно, сработала не только миграция: мы запустили маркетинг и новые фичи.
Было
Стало
Выручка. Прошло только три недели, делать окончательные выводы рано. Пока выручка сопоставима с прежней, а некоторые категории показывают динамику лучше, чем раньше.
Стоимость. Инфраструктура подорожала на 20%. Но сравнивать в лоб нечестно: в новой версии появился функционал, которого не было в старой, например встроенные мини-игры со своими бэкендами и базами.
Что я вынес из этой миграции:
Нагрузочное тестирование при смене архитектуры почти бесполезно для прогноза. Гораздо больше даёт перенос реальной части игроков волнами: 10 тысяч, 200 тысяч, все.
Не ставьте CPU-лимиты на бэкенды. Requests достаточно.
Проверьте
ndots. Возможно, большая часть вашего DNS-трафика — мусор.Закладывайте запас ресурсов на время миграции, но заранее планируйте, как будете его ужимать.
Отложенные риски срабатывают в самый неподходящий момент. Если риск обсуждается за неделю до важного события, его стоит закрыть до события.
AI-агент с доступом к метрикам, логам и коду — сильный аудитор. Но его выводы нужно перепроверять, а вопросы на стыке продукта и инфраструктуры задавать самим.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.