PayPhone 2077: как я превратил скучный PDF в карту таксофонов России
Недавно я с удивлением обнаружил, что таксофоны до сих пор существуют и используются по назначению. Казалось бы, эпоха этих аппаратов давно закончилась: последние карточные таксофоны демонтировали, отключили от сети или оставили ржаветь где-нибудь на улице в качестве арт-объектов. Теперь они разве что пугают зумеров и вызывают приступы ностальгии у бумеров, которым достаточно увидеть телефонную будку, чтобы вспомнить «Плачет девушка в автомате».
Кстати, о старых фильмах, раз мы вспомнили песню из клипа Осина. Иногда смотришь кино, снятое всего несколько десятилетий назад, и думаешь: сколько же сюжетов развалилось бы, если бы у героев под рукой был обычный мобильник! Потерялся человек — позвони ему. Не можешь дозвониться домой — попробуй ещё раз. И вся драматургия насмарку.
Вообще, я думал, что мой интерес ограничится самим фактом, что таксофоны до сих пор существуют и работают. Но потом я нашёл на сайте Ростелекома PDF со списком адресов и номеров от Карелии до Кореи - нет, конечно, но для такой архаичной технологии как оказалось карта РФ покрыта достаточно плотно.
Так же обнаружил несколько статей на Хабре по интересующей меня теме:
Окраины городов и полукабины-призраки. Ищем последние рабочие таксофоны
Последний выход из «Матрицы». Где сейчас остались таксофоны?
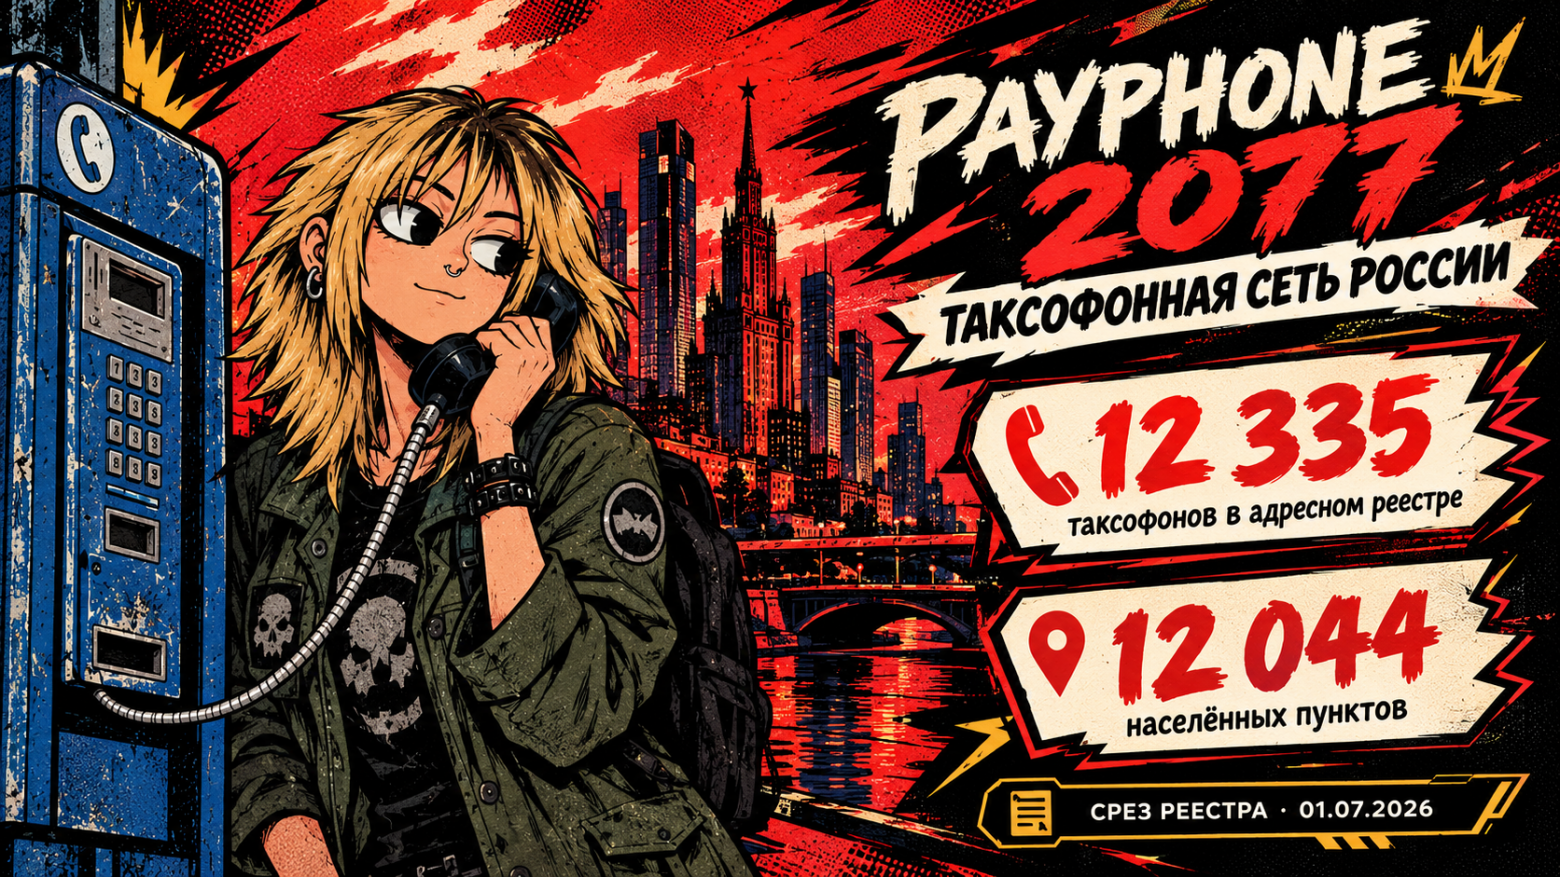
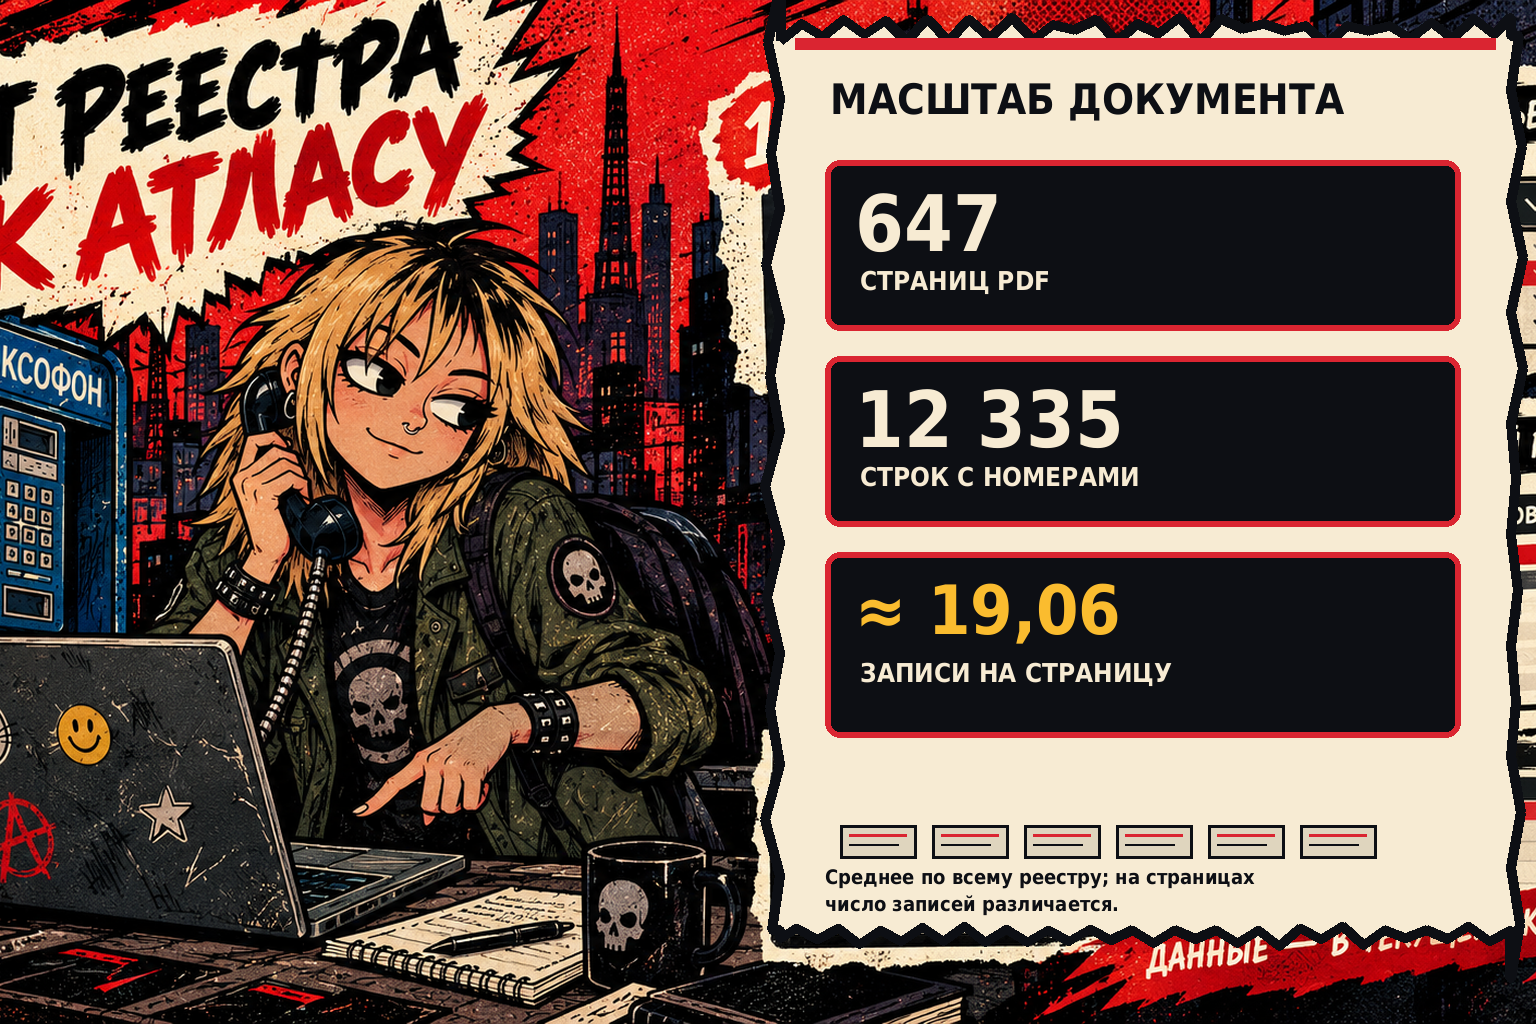
На странице Ростелекома, посвящённой универсальным услугам связи, цифра такая: 12 335 универсальных таксофонов в 12 044 населённых пунктах. Я перечитал её дважды. Двенадцать тысяч — это не «пара уцелевших экземпляров на вокзалах и в музеях». Это сеть.
Звонить с них можно бесплатно: на стационарные и мобильные номера по России, а также в экстренные службы. То есть это не аттракцион и не памятник, а работающая штука с вполне конкретным назначением. Просто мы её перестали замечать.
Зацепила меня, если честно, не столько сама цифра, сколько её форма. Двенадцать тысяч адресов — это уже не список, который можно прочитать глазами. Это данные. А у данных есть неприятное свойство: пока они лежат в PDF, они как бы существуют, но пользоваться ими неудобно.
Почему PayPhone 2077 и что дальше?
Название с иронией. Смотрим в киберпанковское будущее через легаси-инфраструктуру. Мне вообще кайфово копаться в старых технических решениях и смотреть, какой след они оставляют в открытых данных. Да, я тот самый человек, который принцип KISS понял слишком уж буквально и теперь с подозрением смотрит на уровень абстракции в современной разработке.
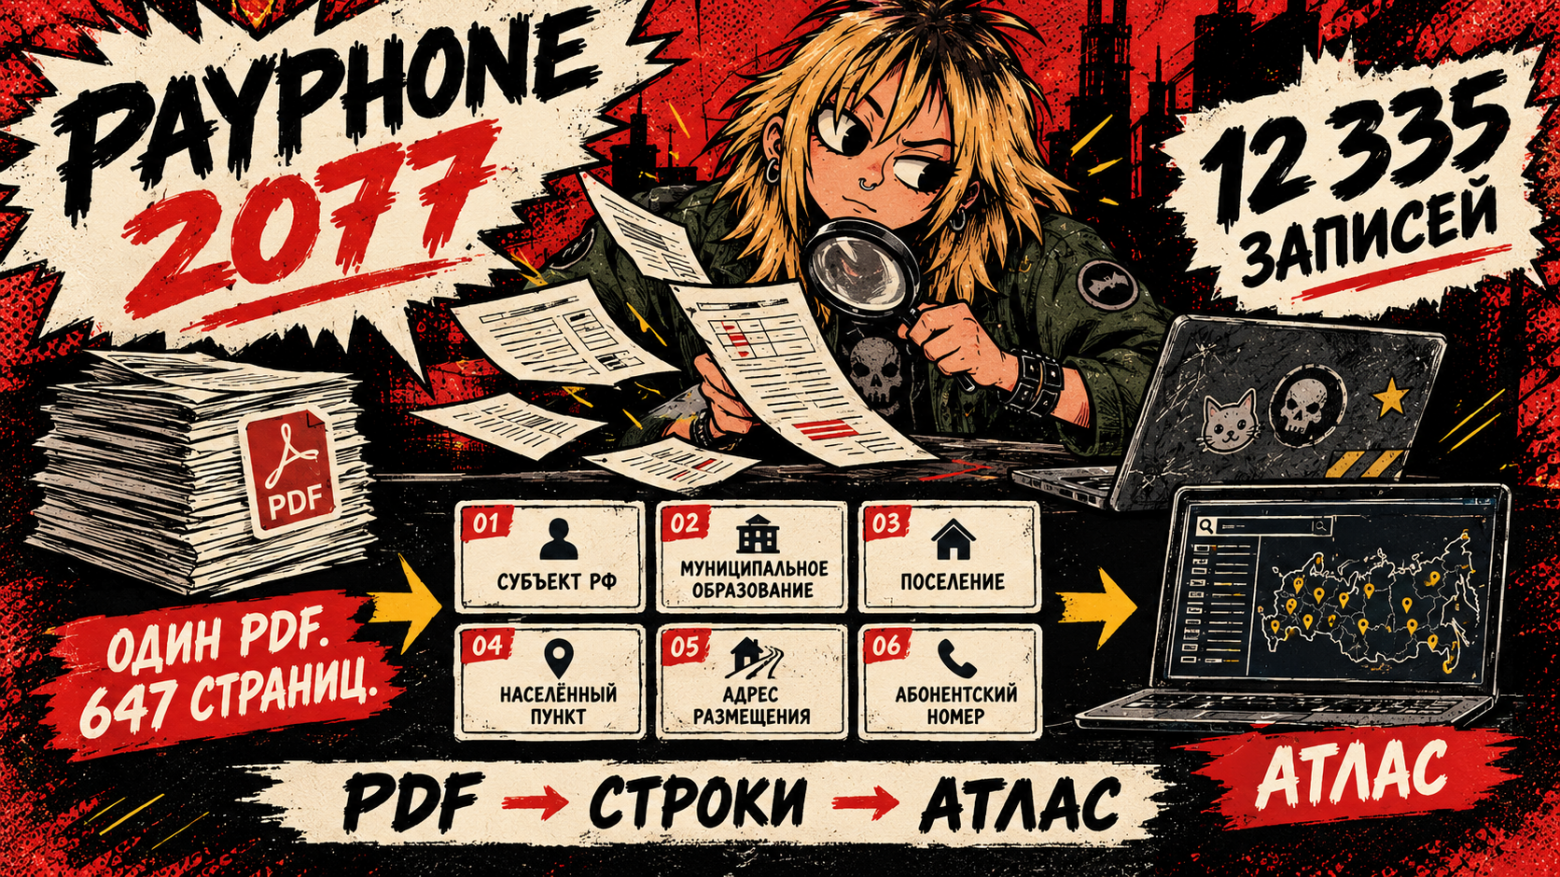
Как из PDF сделать карту (и не сойти с ума)
Я же говорил, что люблю KISS? Так вот, PDF — это не KISS. PDF — это когда кто-то когда-то решил, что документ — это не текст, а набор глифов с координатами на холсте. У PDF-файла нет понятия «строка», «колонка» или «таблица».
Для извлечения текста я использовал pdf.js (стандарт де-факто). И да, вся эта мясорубка крутится прямо в браузере. Тащить ради этого Node.js на сервер — это как стрелять из пушки по воробьям - cовременный фронтенд и так сильно перегружен на мой взгляд.
- это шутка, конечно, но меня несколько напрягает тот факт, что большинство современных сайтов превращаются в неюзабельный компост при отключении javascript.
PDF — это не таблица, это хаос
Первая задача — понять, где вообще таблица. Код сканирует верхнюю половину страницы, ищет ключевые слова (субъект рф, муниципальное образование, адрес, номер телефона) и кластеризует их по Y-координате. Зная, где начинаются заголовки, мы вычисляем середины между ними — это и есть невидимые границы колонок.
Чтобы выжить в этом хаосе, мне пришлось ввести несколько магических констант, которые подбирались эмпирическим путем:
const MAX_ROWS = 10;
const Y_TOLERANCE = 3.5;
const HEADER_CLUSTER_TOLERANCE = 30;
const WRAPPED_LINE_MAX_DISTANCE = 16;
const TABLE_FIELDS = ['region', 'municipality', 'settlement', 'locality', 'address', 'phone'];
Иллюзия таблиц и невидимые колонки
Первое, с чем сталкиваешься: там нет сетки. Как понять, что текст относится к колонке «Адрес», а не к «Муниципалитет»? Код сканирует верхнюю часть страницы, ищет ключевые слова и кластеризует их по Y-координате. Зная, где начинаются заголовки, мы вычисляем середины между ними. Это и есть наши невидимые границы колонок.
function detectColumnLayout(rows) {
    const allItems = rows.flatMap((row, rowIndex) => row.items.map(item => ({ item, rowIndex, x: Number(item.transform[4]) || 0, y: Number(item.transform[5]) || 0, field: getHeaderField(item.str) })));
    if (!allItems.length) return null;
    const ys = allItems.map(item => item.y);
    const minY = Math.min(...ys), maxY = Math.max(...ys);
    const topCutoff = minY + (maxY - minY) * 0.52;
    const candidates = allItems.filter(item => item.field && item.y >= topCutoff);
    if (candidates.length < 6) return null;
    let best = null;
    for (const seed of candidates) {
        const nearby = candidates.filter(candidate => Math.abs(candidate.y - seed.y) <= HEADER_CLUSTER_TOLERANCE);
        const byField = new Map();
        for (const candidate of nearby) {
            const current = byField.get(candidate.field);
            if (!current || Math.abs(candidate.y - seed.y) < Math.abs(current.y - seed.y)) byField.set(candidate.field, candidate);
        }
        const score = byField.size;
        const meanY = [...byField.values()].reduce((sum, item) => sum + item.y, 0) / Math.max(score, 1);
        if (!best || score > best.score || (score === best.score && meanY > best.meanY)) best = { score, meanY, byField };
    }
    if (!best || TABLE_FIELDS.some(field => !best.byField.has(field))) return null;
    const headerItems = TABLE_FIELDS.map(field => best.byField.get(field));
    const starts = headerItems.map(item => item.x);
    if (starts.some((value, index) => index > 0 && value <= starts[index - 1] + 10)) return null;
    return { starts, headerMinY: Math.min(...headerItems.map(item => item.y)), headerMaxY: Math.max(...headerItems.map(item => item.y)), headerRowIndexes: new Set(headerItems.map(item => item.rowIndex)) };
}
А дальше каждый текстовый блок просто падает в нужное «ведро» по своей X-координате. Но тут вступает в игру его величество перенос строк.
Если адрес не влезает в ширину ячейки, PDF его переносит на следующую строку. Для pdf.js это уже не один адрес, а две независимые строки с разными Y-координатами (transform[5]). А если еще учесть, что шрифты в PDF рендерятся с микроскопическими сдвигами, то стандартный trim() и группировка по координатам начинают превращать адреса в кашу. Дом №5 может внезапно стать домом №58.
Как я с этим боролся? Пришлось писать геометрию. Сначала группируем все текстовые элементы в строки по Y-координате с допуском:
function groupItemsIntoRows(items) {
    const valid = (items || []).filter(item =>
        item && typeof item.str === 'string' &&
        item.transform && item.transform.length >= 6
    );

    // Сортируем сверху вниз, затем слева направо
    valid.sort((a, b) =>
        Number(b.transform[5]) - Number(a.transform[5]) ||
        Number(a.transform[4]) - Number(b.transform[4])
    );

    const rows = [];
    for (const item of valid) {
        const y = Number(item.transform[5]);
        let row = rows[rows.length - 1];

        // МАГИЯ Y_TOLERANCE: если Y отличается меньше чем на 3.5px,
        // считаем это той же строкой, а не переносом
        if (!row || Math.abs(y - row.y) > Y_TOLERANCE) {
            row = { y, items: [] };
            rows.push(row);
        }
        row.items.push(item);
        row.y = row.items.reduce((sum, part) => sum + Number(part.transform[5]), 0) / row.items.length;
    }

    rows.forEach(row =>
        row.items.sort((a, b) => Number(a.transform[4]) - Number(b.transform[4]))
    );
    return rows;
}
Магия в константе Y_TOLERANCE = 3.5. Все текстовые блоки, чья Y-координата отличается меньше чем на 3.5 пикселя, считаются одной строкой. Это эмпирически подобранное значение, которое работает для большинства случаев.
PDF из источника использует объединенные ячейки. Регион или муниципалитет могут быть написаны один раз на 50 строк, а в остальных 49 строках эти ячейки просто пустые.
Чтобы не оставлять карту пустой, пришлось сделать мини-стейт-машину. Парсер запоминает контекст: «Ага, мы в Карелии, в Сортавальском районе». И пока в ячейках не появится новый текст, он молча подставляет запомненные значения во все нижележащие строки.
function updateHierarchyContext(cells, context) {
    // Пытаемся распознать регион. Если он сменился — обновляем контекст
    const candidateRegion = recognizedRegion(cells[0]);
    if (candidateRegion && normalizeText(candidateRegion) !== normalizeText(context.region)) {
        context.region = candidateRegion;
        // Сбрасываем вложенные уровни, чтобы не приписать чужой муниципалитет
        context.municipality = '';
        context.settlement = '';
        context.locality = '';
    }

    // Аналогичная логика для муниципалитета, поселения и населенного пункта:
    // если значение сменилось, сбрасываем только вложенные уровни
    const values = ['municipality', 'settlement', 'locality'];
    const indexes = [1, 2, 3];

    for (let i = 0; i < indexes.length; i++) {
        const field = values[i];
        const value = cleanCellText(cells[indexes[i]]);
        if (!value) continue;

        if (context[field] && normalizeText(context[field]) !== normalizeText(value)) {
            if (field === 'municipality') {
                context.settlement = '';
                context.locality = '';
            } else if (field === 'settlement') {
                context.locality = '';
            }
        }
        context[field] = value;
    }
}
Это работает как стек: если сменился регион, сбрасываются все вложенные уровни. Если сменился муниципалитет — сбрасываются только поселение и населенный пункт.
Хирургия переносов (спасаем «оторванные хвосты»)
Группировка по Y — это полдела. Если адрес перенесся на следующую строку, у него нет номера телефона (телефон всегда в последней колонке). Поэтому код ищет строки без телефонов и проверяет: если такая строка находится в пределах 16 пикселей (WRAPPED_LINE_MAX_DISTANCE) от строки, где телефон есть — поздравляю, это перенесенный кусок адреса.
    const phoneRows = mappedRows.filter(row => row.phoneInfo);
    const supplementalFor = new Map(phoneRows.map(row => [row, []]));
    for (const row of mappedRows) {
        if (row.phoneInfo || !phoneRows.length) continue;
        let nearest = null, nearestDistance = Infinity, secondDistance = Infinity;
        for (const phoneRow of phoneRows) {
            const distance = Math.abs(phoneRow.y - row.y);
            if (distance < nearestDistance) { secondDistance = nearestDistance; nearestDistance = distance; nearest = phoneRow; }
            else if (distance < secondDistance) { secondDistance = distance; }
        }
        const clearlyNearest = secondDistance === Infinity || nearestDistance + 2 < secondDistance * 0.8;
        if (nearest && nearestDistance <= WRAPPED_LINE_MAX_DISTANCE && clearlyNearest) {
            supplementalFor.get(nearest).push(row);
            row.supplemental = true;
        }
    }
Код аккуратно подхватывает этот «хвост», помечает его как supplemental = true и позже подклеивает обратно к основной записи, соблюдая все правила пунктуации.
Регулярная артиллерия для телефонов
Последний штрих. Иногда pdf.js в порыве старания склеивает номер телефона с последними цифрами адреса, или телефон «уезжает» не в ту колонку.
function findPhoneInText(text, allowLocalTenDigits = false) {
    const source = String(text ?? '');
    const nationalRegex = /(^|[^\d])((?:\+7|8)(?:[\s().-]*\d){10})(?!\d)/g;
    let match;
    while ((match = nationalRegex.exec(source)) !== null) {
        const phoneText = match[2].trim();
        const digits = phoneText.replace(/\D/g, '');
        if (digits.length !== 11 || !/^[78]/.test(digits)) continue;
        const start = match.index + match[1].length;
        return { phone: phoneText.replace(/\s+/g, ' '), start, end: start + phoneText.length, before: source.slice(0, start).replace(/[\s,;|]+$/g, '').trim() };
    }
    if (allowLocalTenDigits) {
        const localRegex = /(^|[^\d])((?:\d[\s().-]*){9}\d)(?!\d)/g;
        while ((match = localRegex.exec(source)) !== null) {
            const phoneText = match[2].trim();
            if (phoneText.replace(/\D/g, '').length !== 10) continue;
            const start = match.index + match[1].length;
            return { phone: phoneText.replace(/\s+/g, ' '), start, end: start + phoneText.length, before: source.slice(0, start).replace(/[\s,;|]+$/g, '').trim() };
        }
    }
    return null;
}
«Весёлые картинки»: спецвыпуск про таксофоны
А теперь то, ради чего все затевалось - ради весёлых и даже познавательных (удивительно даже) картинок.
Я вообще считаю, что инфографика — это почти чит-код для работы с данными. Можно сколько угодно рассказывать про 12 тысяч записей, шесть колонок и сотни населённых пунктов, но пока всё это лежит в таблице, мозг воспринимает информацию примерно как очередной лог-файл: ну да, много строк, и что?
А потом берёшь те же данные, рисуешь карту, добавляешь пару графиков — и внезапно появляется масштаб. Становится проще сравнить регионы, увидеть структуру реестра и понять, как вообще устроена сеть. Причём не нужно читать весь PDF от корки до корки или разбираться в коде парсера. Можно сразу перейти к вопросам, ради которых всё и затевалось.
Например, инфографика помогает быстро разобраться в нескольких вещах:
Какого масштаба сеть? Не пара забытых аппаратов у вокзалов, а тысячи записей в официальном адресном перечне. Это уже повод посмотреть на таксофоны не как на городской артефакт, а как на инфраструктуру.
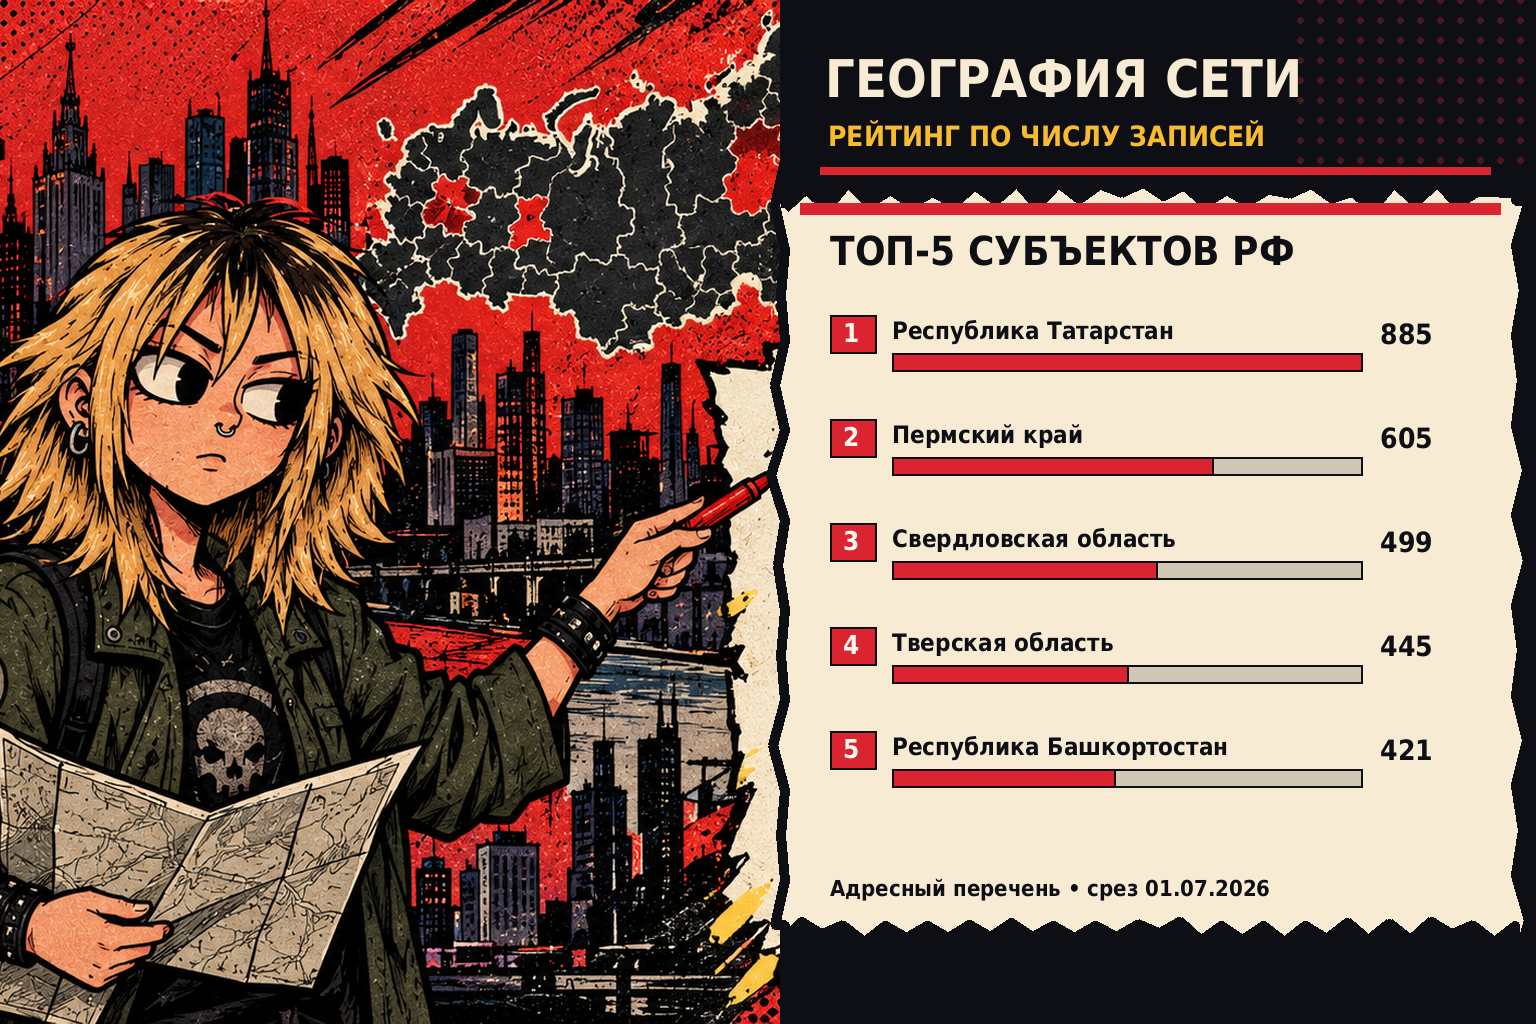
Как сравниваются регионы? Рейтинг позволяет быстро найти территории с большим количеством записей. Например, в нашем подсчёте лидируют Татарстан — 885 записей, Пермский край — 605, Свердловская область — 499 и Тверская область — 445. Важно: это именно количество строк в реестре, а не число жителей, плотность сети или гарантия, что каждый аппарат работает.
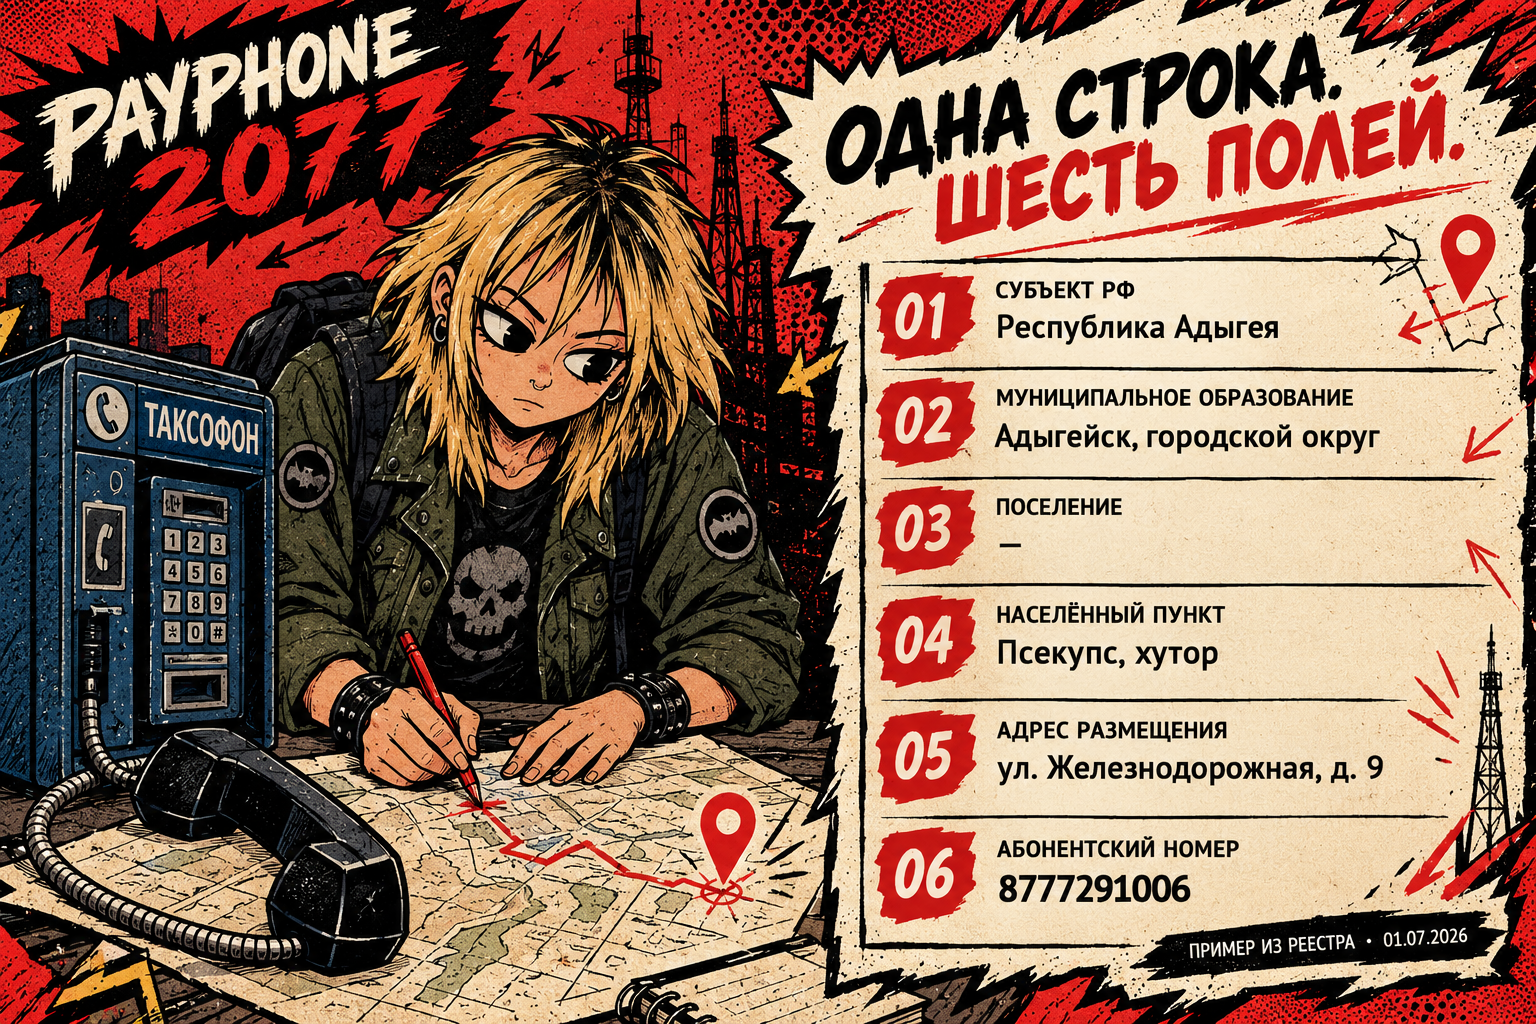
Что вообще хранится в одной записи? Шесть полей связывают субъект РФ, муниципалитет, поселение, населённый пункт, адрес и абонентский номер. Благодаря этому запись можно не просто прочитать, но и использовать для фильтрации, поиска и привязки к месту.
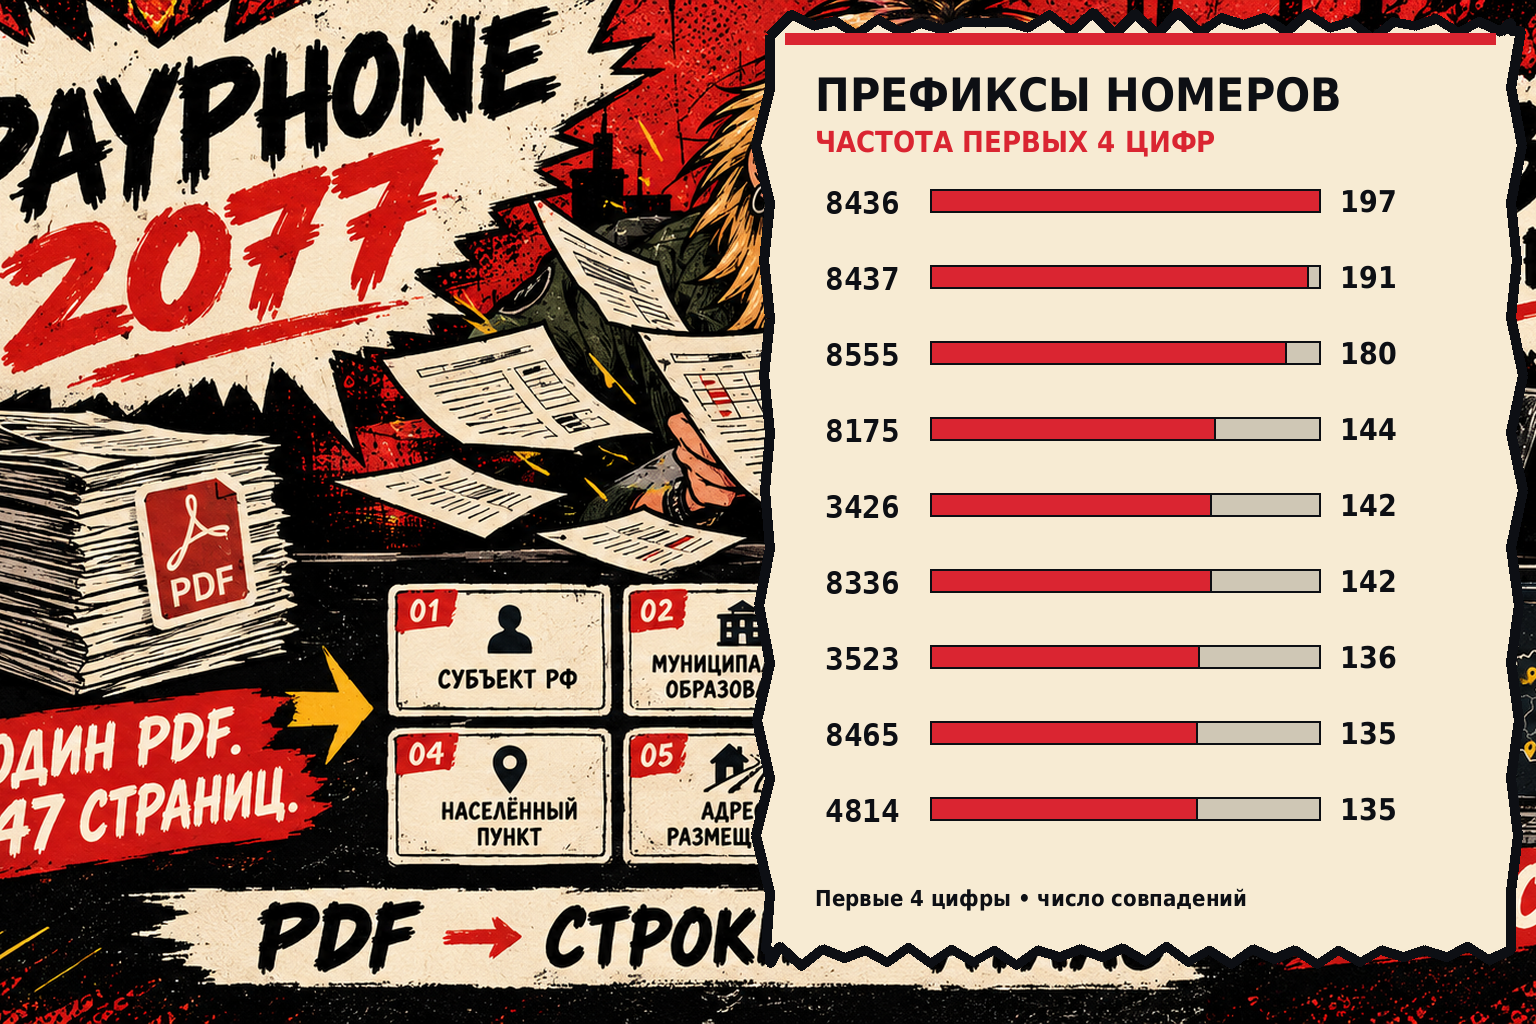
Как из документа получилась карта? На схеме обработки видно весь путь: PDF → извлечение текста → восстановление строк и колонок → структурированные записи → визуализация. Это помогает понять, откуда взялись данные, и где именно могут возникнуть ошибки.
Что можно исследовать дальше? Искать конкретные адреса, фильтровать записи по регионам, сравнивать их между собой и проверять, как распределены таксофоны в разных частях страны. То есть инфографика не только пересказывает результат, но и подсказывает новые вопросы.
Есть и ещё один полезный момент: визуализация помогает не перепутать то, что данные действительно показывают, с тем, что нам хотелось бы из них узнать. Количество записей в регионе не говорит напрямую о доступности связи, а адресный перечень сам по себе не подтверждает, что все аппараты исправны. Для этого нужны другие данные и отдельная проверка. Зато реестр уже позволяет исследовать заявленное размещение сети и находить точки, с которых можно начать проверку.
Для меня здесь самое интересное — не просто сделать красиво. Инфографика позволяет буквально увидеть результат всей этой технической возни: координаты текста превратились в строки, строки — в структуру, структура — в данные, а данные — в историю, которую можно понять без чтения исходного кода.
И это полезно не только читателю. Когда данные показаны на карте или в рейтинге, ошибки тоже легче заметить. Если один регион внезапно оказывается на первом месте из-за неверно перенесённого контекста, это уже не абстрактная проблема парсера — это странность, которую можно поймать глазами и перепроверить по исходному PDF.
Короче, инфографика — это не украшение поверх данных. Это способ быстрее понять масштаб, увидеть закономерности, заметить подозрительные места и решить, что исследовать дальше. А если для этого нужно нарисовать несколько картинок, добавить красного, чёрного и немного комиксного безумия — почему бы и нет?
Что в итоге и куда двигаться дальше?
Если посмотреть на PayPhone 2077 целиком, то начиналось всё довольно прозаично: нашёл PDF с адресами таксофонов, стало интересно, сколько их вообще осталось, а дальше понеслось. Оказалось, что между документом на сотни страниц и нормальной картой лежит небольшая, но весёлая инженерная пропасть.
И вот что мне нравится в этом проекте: он не пытается решить проблему, которой не существует, с помощью очередного фреймворка на триста зависимостей. Есть конкретный источник данных, конкретная задача и понятный результат. Берём документ, извлекаем записи, проверяем их, визуализируем — и вместо нечитаемого PDF получаем инструмент, которым действительно можно пользоваться.
При этом карта — только первый слой. Сейчас интересно не только посмотреть, где находятся таксофоны, но и научиться нормально проверять данные, выгружать их для дальнейшей работы и задавать вопросы к самому документу. Поэтому я вижу три направления развития.
1. Выгрузка проверенных данных: чтобы можно было забрать всё с собой
Карта — это здорово, но рано или поздно хочется получить данные в виде файла и утащить их в свой Python-скрипт, QGIS, табличку или вообще другой проект. И вот здесь кнопки «Скачать CSV» недостаточно. Она должна гарантировать хотя бы то, что скачанный файл действительно содержит то, что мы собирались выгрузить.
Поэтому следующий шаг — сделать полноценный экспорт с понятной структурой и проверкой результата.
В CSV будет 14 колонок в фиксированном порядке: страница источника, ID, регион, район, населённый пункт, адрес, широта, долгота, надёжность координат, качество, дубль, примечание, исходный регион и строка.
Ключевой момент здесь — не уничтожать исходные данные ради удобства интерфейса. Например, для карты мы можем нормализовать название региона, убрать лишние пробелы и привести варианты написания к единому значению. Но при экспорте исходное название должно остаться таким, каким оно было в документе. То же касается исходной строки. Нормализация нужна для поиска и фильтров, но она не должна незаметно переписывать источник.
Дубли тоже не будем просто выбрасывать. Если две записи похожи или даже имеют одинаковый номер, их нужно сохранить, пометив соответствующим флагом. Иначе можно случайно потерять информацию о качестве исходного документа, а потом ещё долго удивляться, почему собственные данные не сходятся с первоисточником.
Для CSV планирую использовать UTF-8 с BOM, экранирование по RFC 4180 и сохранение переводов строк внутри ячеек. Координаты и ID будут обрабатываться как строки, чтобы не терять ведущие нули и точность. Для XLSX отдельно нужно предусмотреть длинные значения, ограничения длины ячеек и защиту от случайного исполнения содержимого как формул.
Но самое важное — проверка перед скачиванием.
Я бы формировал файл в памяти, затем читал его обратно тем же парсером, которым будет пользоваться потребитель, и сверял количество записей, набор колонок и заголовки. Дополнительно можно сравнивать контрольную сумму или ключевые поля. Если что-то не совпало, файл не скачивается, а пользователь получает понятное сообщение об ошибке.
Здесь есть принципиальная оговорка: успешная проверка экспорта доказывает, что файл сформирован корректно, но не доказывает, что исходный PDF был распознан без ошибок. Если парсер перепутал регион ещё до экспорта, идеально собранный CSV лишь аккуратно сохранит эту ошибку. Поэтому проверка сериализации и проверка качества исходных данных должны оставаться разными этапами.
Для этого же пригодится отдельный отчёт о качестве: по каждой странице — количество строк и символов, распознанные колонки, найденные ошибки и полный извлечённый текст. Если на какой-то странице таблица развалилась, лучше прямо сказать об этом и предложить отчёт, чем радостно скачать пустой CSV с одной шапкой.
В результате проект станет полезен не только тем, кто хочет посмотреть на карту, но и тем, кто собирается исследовать сами данные, строить собственные визуализации или использовать реестр как часть другого исследования.
2. Навигация по разделам: меньше скролла, больше дела
Второе улучшение небольшое, зато вполне практичное: боковое меню с якорями на основные разделы — загрузка, валидация, карта, аналитика и экспорт.
Сейчас по мере развития проекта страница постепенно превращается в настоящий исследовательский инструмент. Чем больше на ней возможностей, тем меньше хочется прокручивать всё вверх-вниз в поисках нужной кнопки.
Ссылка ведёт к реальной секции страницы, активный пункт меняется при прокрутке, а на узких экранах меню сворачивается, чтобы не отъедать половину карты.
Технически это не выглядит чем-то особенно страшным: обычные HTML-якоря, корректные id, scroll-margin-top и IntersectionObserver для определения активного раздела. Плавную прокрутку стоит включать с учётом prefers-reduced-motion, а прямые ссылки на секции должны работать и после первоначальной отрисовки контента.
Зачем вообще тратить на это время, если можно просто оставить длинную страницу?
Потому что хороший интерфейс должен сокращать путь от намерения до действия. Если пользователь хочет проверить качество распознавания, он должен попасть к валидации. Если собирается скачать данные — к экспорту. Если хочет исследовать географию — сразу к карте.
Это не самая эффектная часть проекта, зато именно такие мелочи постепенно превращают демонстрацию возможностей в удобный инструмент.
3. Маленький RAG по одному PDF: а что, если с документом можно будет разговаривать?
Вот это направление мне кажется особенно интересным.
Представим следующий сценарий: я загружаю PDF, а система строит по его содержимому интерактивный граф. На нём видны регионы, районы, населённые пункты, отдельные записи и страницы исходного документа. Можно нажать на узел, ограничить им область поиска, а затем задать вопрос модели: «Покажи записи для этого района», «Откуда взялся этот адрес?» или «Найди на исходных страницах строки, которые относятся к выбранному населённому пункту».
По сути, это маленький RAG — Retrieval-Augmented Generation, то есть генерация ответа с предварительным поиском по источнику.
Идея не в том, чтобы скормить модели все 647 страниц и надеяться, что она всё запомнит. У языковых моделей есть ограничения по объёму контекста, а ещё они умеют уверенно ошибаться. Нам нужен механизм, который сначала найдёт релевантные фрагменты документа, а уже потом передаст их модели для ответа.
Я бы реализовывал это следующим образом.
Первый этап — подготовка источника. Используем уже существующий механизм извлечения текста из PDF. Каждому фрагменту сохраняем номер страницы и доступные структурные поля. Для адресного перечня особенно важно не потерять связь между строкой, регионом, населённым пунктом и абонентским номером. Если парсер не смог надёжно восстановить какую-то запись, её нужно помечать как сомнительную, а не выдавать за проверенный факт.
Второй этап — индекс. Разбиваем текст на небольшие фрагменты с сохранением метаданных и строим поисковый индекс. Для такого документа необязательно сразу поднимать отдельную векторную базу и устраивать небольшую корпорацию из микросервисов. Сначала можно проверить, насколько хорошо работает обычный полнотекстовый поиск. Если его окажется недостаточно для запросов в естественной речи, добавить векторный поиск и объединить результаты.
Третий этап — граф. Здесь я бы не поручал модели самостоятельно придумывать всю структуру документа. Надёжнее построить граф программно из уже распознанных записей: регион связан с районом, район — с населённым пунктом, населённый пункт — с адресной записью, а запись — со страницей источника. Граф становится не декоративной картинкой, а способом навигации и ограничения поиска.
Четвёртый этап — вопрос и ответ. Пользователь выбирает узел или вводит запрос. Система ищет подходящие фрагменты, при необходимости учитывает выбранную область графа, а затем передаёт найденный текст модели. Ответ должен содержать ссылки на страницы PDF, откуда взяты сведения. Если подтверждающего фрагмента нет, система должна честно сказать, что не нашла ответ, а не достраивать его из воздуха.
И вот здесь появляется приятная вещь: граф и RAG решают разные задачи, но хорошо дополняют друг друга. Граф помогает ориентироваться в структуре и выбирать, где искать. RAG помогает находить нужные фрагменты даже тогда, когда пользователь не знает точного названия поля или формулировки из документа.
Например, можно будет начать с региона, нажать на конкретный район, затем перейти к населённому пункту и попросить систему показать связанные записи с указанием исходных страниц. Или задать вопрос без предварительного выбора узла и дать поиску самому найти подходящие места в документе.
Но есть важная граница: считать статистику должна программа, а не языковая модель. Если спросить, сколько записей приходится на Татарстан, система должна вычислить число по структурированным данным. RAG может найти соответствующие строки, объяснить, откуда они взялись, и показать подтверждения. А вот поручать модели самостоятельно пересчитывать сотни страниц — особенно после моих приключений с региональным рейтингом — идея сомнительная.
Для точных запросов будем использовать данные реестра и обычные программные расчёты. Для вопросов по содержанию PDF — поиск по источнику с последующим ответом модели. А когда вопрос затрагивает неоднозначную или плохо распознанную запись, система должна показывать исходный фрагмент, чтобы пользователь мог проверить его самостоятельно.
Есть ли в этом смысл для одного документа? На мой взгляд, да, если не пытаться превратить RAG в обязательный слой для любой операции. Для фильтрации регионов, подсчёта записей и построения графиков он вообще не нужен. Но если хочется исследовать сотни страниц, находить отдельные упоминания, задавать вопросы разными формулировками и возвращаться к первоисточнику по одному клику, такой механизм может оказаться очень удобным.
Я бы начал с простого прототипа: поиск по распознанному тексту, номера страниц, переход к исходным фрагментам и возможность ограничить поиск выбранным регионом или населённым пунктом. Затем проверил бы его на реальных вопросах и только после этого добавлял векторный индекс и генерацию ответов. Если простой поиск уже решает задачу, усложнять архитектуру ради модного слова RAG незачем.
В идеале получится не чат-бот, который делает вид, что прочитал PDF, а небольшой исследовательский интерфейс, в котором можно проследить путь от вопроса до конкретной строки документа.
И что в итоге?
Все три направления дополняют друг друга.
Выгрузка делает данные переносимыми и пригодными для дальнейшего анализа. Навигация помогает быстрее находить нужные инструменты. А граф с поиском и RAG открывает возможность исследовать сам источник, а не только заранее подготовленные представления данных.
И что особенно приятно, для этого не нужно выбрасывать уже написанный код и начинать всё с нуля. У нас есть извлечение текста, таблица, карта и аналитика. Следующий шаг — аккуратно связать их между собой, добавить проверяемый экспорт и только потом экспериментировать с более умным поиском.
В конечном счёте мне хочется, чтобы PayPhone 2077 был не просто ещё одной красивой картой и не очередной демонстрацией того, что можно сделать с помощью JavaScript. Хочется получить инструмент, который позволяет исследовать забываемую инфраструктуру, проверять источники, замечать ошибки и самостоятельно задавать вопросы данным.
А если по пути получится ещё и сделать PDF чуть менее страшным для человечества — значит, всё это было не зря.
Эпилог. Абонент всё ещё существует
Таксофоны — это инфраструктура, которую мы, кажется, успели мысленно похоронить раньше, чем она исчезла на самом деле. Где-то в начале 2010-х они будто выпали из реальности: остались в текстах песен, старых фильмах и воспоминаниях о мире, в котором, чтобы позвонить человеку, иногда приходилось искать телефонную будку. Казалось бы, зачем они вообще нужны, если мобильник теперь есть у каждого первоклассника?
Но таксофоны никуда окончательно не делись. Какие-то работают, какие-то давно превратились в декорации постапокалипсиса, но вот что интересно: пока существует реестр с их адресами, мы можем хотя бы попытаться разобраться, где эта инфраструктура находится и как она вообще выглядит сегодня.
Конечно, наличие записи в реестре ещё не означает, что конкретный аппарат стоит на месте и работает - как в известном анекдоте, есть нюанс: 12 335 записей — это не результат независимой проверки 12 335 физических аппаратов.
Реестр содержит адреса и абонентские номера, но сама запись ещё не доказывает, что аппарат действительно стоит на месте и работает. Поэтому дальше я буду говорить именно о записях реестра, когда речь идёт о подсчётах, а не выдавать их за проверенное количество действующих таксофонов.
Вот тут мне и стало интересно: а насколько сложно превратить этот список в интерактивный атлас? Можно ли увидеть, где в реестре больше записей, как они распределены по регионам и где искать конкретный адрес? И что вообще получится, если перестать воспринимать PDF как документ для чтения и начать относиться к нему как к источнику данных?
Но мне кажется, самое интересное здесь даже не сами таксофоны. А то, что где-то рядом с нами существует огромное количество данных, на которые обычно никто не обращает внимания. Они лежат в PDF, таблицах, старых базах и документах, которые открывают разве что по необходимости. Стоит немного покопаться — и из них внезапно получается что-то, чем можно пользоваться, что-то изучать и о чём задавать новые вопросы.
Сколько ещё таких незаметных историй спрятано в документах, которые мы привыкли считать скучными?
В конце концов, данные — это не просто цифры и строки. Это способ заметить то, что мы перестали видеть. А иногда, чтобы обнаружить целую сеть, достаточно перестать листать PDF и наконец-то нанести его содержимое на карту.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.