ИИ против традиционных приложений в ЦОД
Меня зовут Андрей Бирюков. Я — независимый эксперт в области ИТ и ИБ, преподаю в учебных центрах и пишу статьи и книги.
Что из себя представляет современный центр обработки данных? Огромный зал со стройными рядами работающих серверов, СХД, коммутаторов и другого оборудования… Вроде бы всё так, но если заглянуть под капот, то выяснится, что нынешние ЦОДы перестали быть однородной средой.
А ведь ещё лет десять назад проектировщик сети мог позволить себе выбрать одну архитектуру и один транспорт, отталкиваясь от доминирующего профиля трафика. Сегодня под одной крышей сосуществуют два принципиально разных мира.
С одной стороны, это кластеры графических ускорителей, которые синхронизируют градиенты для обучения моделей с триллионами параметров, а с другой — классические веб‑сервисы, базы данных и микросервисные платформы, десятилетиями работающие поверх TCP/IP.
Причём зачастую эти два мира могут взаимодействовать в рамках одной системы, которая, будучи по сути классическим веб‑ресурсом, при этом активно использует искусственный интеллект.
Но их требования к сети не просто различаются — по сути, они противоположны по ключевым параметрам. Так, ИИ‑обучение требует неблокирующей фабрики с детерминированной задержкой и минимальными потерями, в то время как традиционные приложения предпочитают масштабируемость и гибкость изоляции, а возможные потери пакетов компенсируются механизмами TCP.
Попытка построить сеть, одинаково хорошо подходящую для обоих сценариев, ведёт либо к неоправданному удорожанию инфраструктуры, либо к деградации ИИ‑нагрузок, которая проявляется не в среднем времени отклика, а в неделях простоя дорогостоящих ускорителей.
В этой статье мы разберём профили трафика, точки конфликта, архитектурные стратегии и практические критерии выбора.
Профили нагрузок для каждого мира
Обучение больших языковых моделей представляет собой последовательность вычислительных фаз и фаз коллективной коммуникации, при этом каждая должна полностью завершиться прежде, чем начнётся следующая.
Коллективные операции (AllReduce, AllGather, ReduceScatter) между тысячами GPU порождают трафик, который не имеет аналогов в традиционных ЦОД.
Так, каждый шаг обучения требует обмена градиентами между всеми узлами. И здесь паттерн трафика — это уже не случайный набор независимых потоков, а жёстко синхронизированная волна, где задержка доставки последнего сообщения определяет время выполнения всего шага.
Одновременная отправка данных от множества источников к одному приёмнику создаёт перегрузку буферов на коммутаторах, которая не успевает рассасываться между шагами.
При этом средняя задержка не имеет большого значения. Здесь гораздо критичнее задержка последнего, самого медленного сообщения в коллективе источников.
Также большое значение имеют коэффициенты переподписки, то есть соотношение между суммарной пропускной способностью нисходящих каналов (от коммутатора к серверам или хранилищам) и пропускной способностью восходящих каналов (от коммутатора к магистральным узлам).
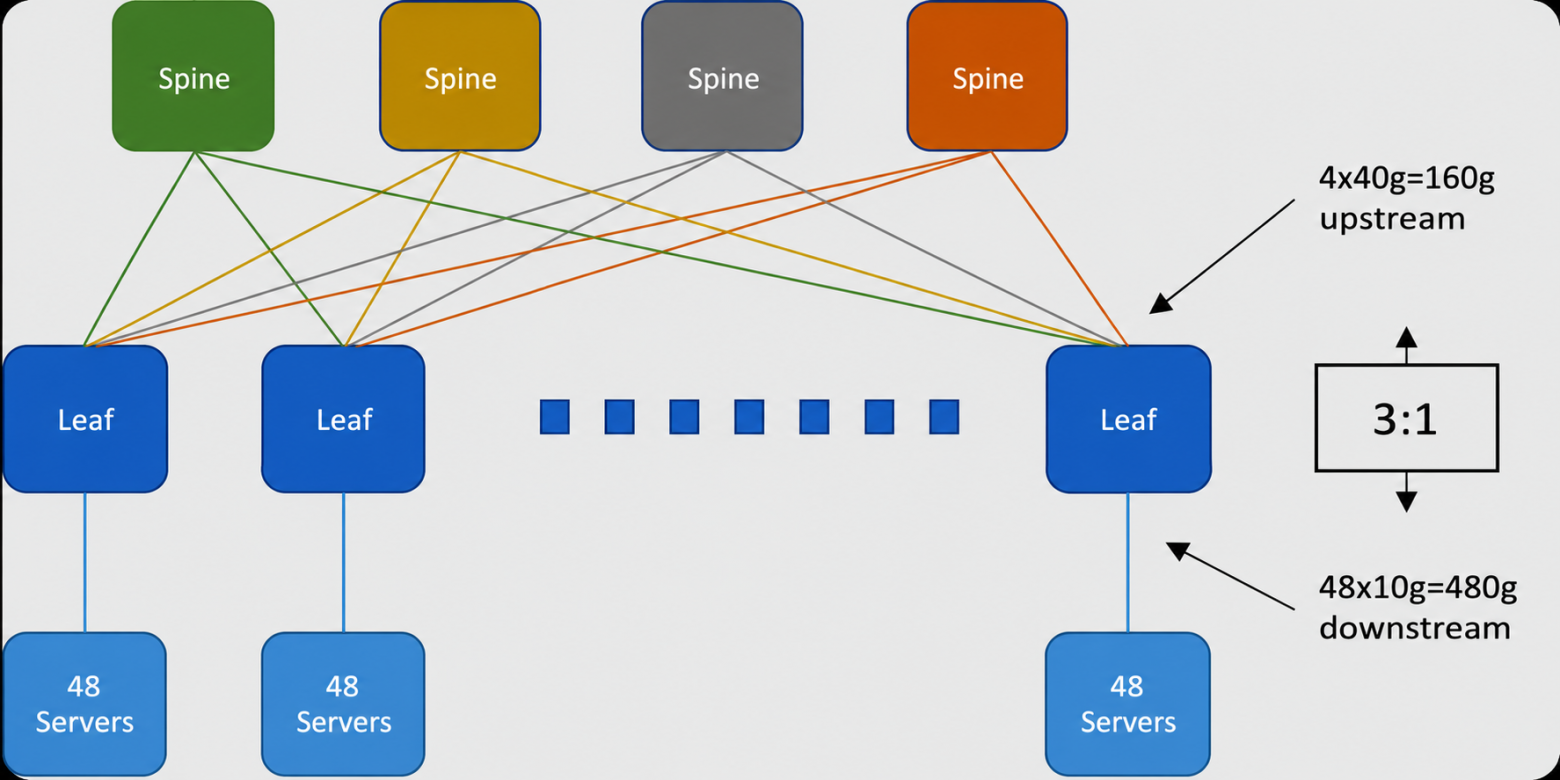
Дело в том, что реальные тренировочные кластеры проектируются с коэффициентом переподписки 1:1, при котором 50% портов коммутатора зарезервированы под аплинки к ядру, и любая переподписка на пути коллективного обмена напрямую конвертируется в простой GPU.
Ну а второй мир — это как раз традиционные приложения, то есть всеми любимые веб‑сервисы, API, базы данных, микросервисы и прочие системы, чей трафик десятилетиями оптимизировался под иную парадигму.
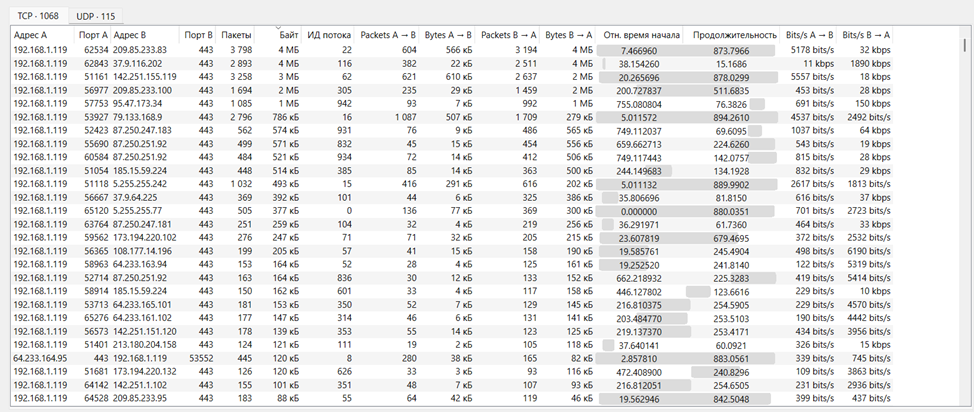
Здесь в трафике присутствует смесь размеров потоков, когда до 40 процентов потоков имеют размер менее 1 КБ, 80 — менее 10 КБ, и лишь незначительная доля превышает 100 МБ.
Это означает, что сеть должна одинаково хорошо обрабатывать как короткие всплески запросов, так и редкие длинные передачи.
Традиционные приложения проектировались с расчётом на то, что сеть может быть перегружена, а TCP скорректирует скорость с помощью Sliding Window. Соответственно, потери пакетов воспринимаются как сигнал перегрузки, а не как катастрофа.
Также в этом мире доминирует передача трафика по направлению North‑South. И хотя современные микросервисы увеличили долю East‑West‑трафика, паттерн остаётся стохастическим, а не синхронизированным.
Наконец, для интерактивных запросов важна задержка (Google сообщал о падении числа поисков на 0,6% при росте задержки на 400 мс), но недетерминированность в микросекундном диапазоне не критична.
Пять точек напряжения
Как мы уже упоминали выше, коэффициент переподписки — это отношение доступной полосы аплинков к полосе, которую могут запросить подключённые устройства.
Для традиционного ЦОД переподписка 3:1 или даже 5:1 была нормой. При этом статистическое мультиплексирование работало, потому что потоки не синхронизированы.
Для ИИ‑обучения переподписка на пути коллективного обмена означает, что в момент синхронизации градиентов аплинки становятся узким местом.
Кластер, спроектированный с переподпиской, будет простаивать в ожидании сети на каждом шаге. Именно поэтому кластеры в продуктиве переходят на 1:1, резервируя половину портов коммутатора под аплинки.
Это удваивает количество необходимых коммутаторов и оптики по сравнению с традиционной экономикой.
Буферизация и управление перегрузкой: PFC против TCP
RoCEv2 (RDMA over Converged Ethernet, version 2) — это сетевой протокол, который обеспечивает удалённый прямой доступ к памяти (RDMA) через сети Ethernet.
Его ключевая задача — минимизация задержки и снижение нагрузки на центральный процессор при передаче данных между серверами.
RoCEv2 полагается на Priority Flow Control (PFC) для создания иллюзии lossless‑среды поверх Ethernet. По факту этот механизм работает на уровне приоритетной очереди порта: когда буфер заполняется выше порога, коммутатор отправляет pause‑кадр upstream, останавливая передачу.
Но здесь проблема заключается в том, что PFC страдает от head‑of‑line blocking. Если одна очередь заблокирована, она останавливает весь трафик данного приоритета на порту, даже если пункт назначения других потоков не перегружен.
Более того, каскадное распространение pause‑кадров может привести к PFC‑штормам и даже взаимной блокировке (deadlock), когда несколько коммутаторов одновременно ждут освобождения буферов друг друга.
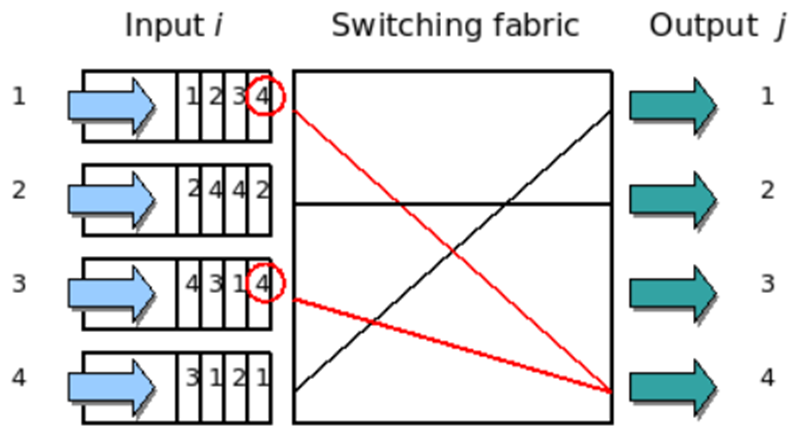
А вот для традиционного трафика PFC не нужен, так как TCP с его окном перегрузки и ECN (Explicit Congestion Notification) справляется с подобными проблемами мягче. Например, коммутатор маркирует пакеты, а отправитель снижает скорость, не останавливая очередь целиком.
Плоская фабрика против иерархии
Классическая трёхуровневая архитектура (core — aggregation — access) проектировалась для North‑South‑трафика и обеспечивала избыточность через протоколы связующего дерева (STP).
Правда, судя по отзывам к одной из моих предыдущих статей, сетевики серьёзно разочаровались в Spanning Tree как протоколе обеспечения отказоустойчивости.
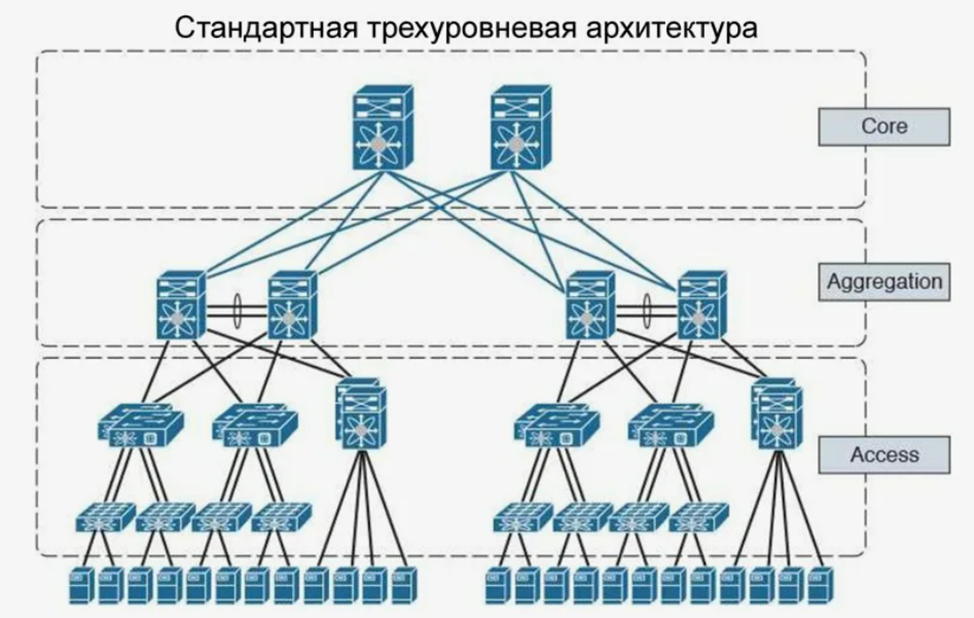
Для современного East‑West‑трафика она создаёт избыточные хопы: пакет от сервера к серверу в той же стойке может пройти через aggregation и core, добавив задержку и создав потенциальные точки перегрузки.
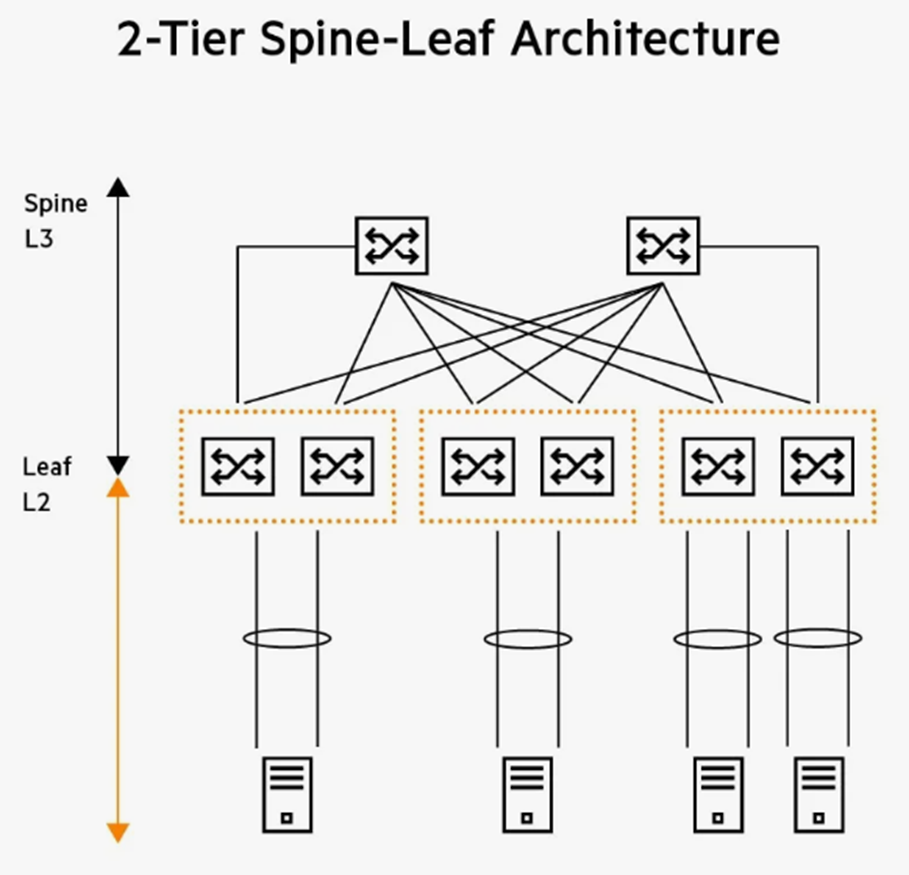
Spine‑leaf (двухуровневая фабрика) решает эту проблему, позволяя подключить любой leaf к каждому spine, и путь между любыми двумя leaf‑коммутаторами составляет ровно два хопа.
Каждый аплинк активен, ECMP распределяет трафик по всем доступным путям, а топология масштабируется добавлением leaf или spine.
Мониторинг и метрики
Ни один хоть сколько‑нибудь приличный ЦОД не может функционировать без мониторинга. Мы должны знать уровень загрузки каналов, доступность узлов и многое другое.
Традиционная сеть мониторится по утилизации портов, количеству ошибок и средним задержкам, но для ИИ эти метрики практически бесполезны.
Например, сеть может показывать 50% утилизации, но training job будет стоять из‑за задержки на одном из путей.
Для ИИ нам нужно мониторить совсем другие метрики:
Per‑packet latency;
Queue occupancy;
Congestion events;
Время завершения коллективных операций.
Для получения этих метрик In‑band Network Telemetry (INT) и программируемые NIC становятся необходимостью, без которых мы не сможем получить полную картину.
В то время как для традиционного трафика достаточно стандартных SNMP‑счётчиков и NetFlow.
Архитектурные стратегии разрешения конфликта
Наиболее чистое решение для мирного сосуществования обеих сетей — построение двух независимых физических сетей.
Одна сеть будет использоваться для ИИ‑обучения, а другая — для традиционных приложений.
Очевидным плюсом такого подхода является то, что каждая фабрика оптимизирована под свой профиль и отказ одной не влияет на другую.
Ну а не менее очевидным минусом является дублирование инфраструктуры, удвоение энергопотребления, охлаждения и эксплуатационных затрат. Для малых и средних ЦОД это часто неприемлемо.
Разобравшись с физикой, давайте перейдём на уровень логики.
Логическая сегментация позволяет нам ограничиться одной фабрикой и использованием изолированных доменов. Здесь будет одна физическая инфраструктура Ethernet с выделенными VRF, QoS‑политиками и, возможно, выделенными парами spine для ИИ‑трафика.
PFC включается только на портах, обслуживающих RoCEv2, ECN настраивается для традиционного трафика.
В результате мы экономим на оборудовании и оптике, а также у нас есть единая точка управления.
А вот минусов здесь будет гораздо больше.
Прежде всего, при логической сегментации у нас появляется риск распространения PFC‑штормa за пределы выделенного домена. Помимо этого, нам сложно гарантировать изоляцию на уровне буферов сетевого оборудования.
Также диагностика проблем становится сложнее, потому что отказ ИИ‑нагрузки может быть вызван поведением традиционного трафика на общем коммутаторе.
В большинстве случаев оптимальным будет гибридный подход, при котором мы выделяем неблокирующую фабрику для обучения (например, RoCEv2 с rail‑optimized топологией) плюс общую Ethernet‑сеть для inference, веб‑сервисов и управления.
Inference‑нагрузки, которые не требуют синхронизированных коллективов, могут размещаться на общей Ethernet‑фабрике с переподпиской.
Этот подход по сути признаёт, что не весь ИИ‑трафик одинаков. Обучение больших моделей остаётся специализированным сценарием, требующим выделенной инфраструктуры.
Но inference, fine‑tuning малых моделей и preprocessing могут использовать общую сеть.
Как выбрать топологию
В завершение мы предлагаем набор основных действий для определения того, какая топология лучше подойдёт для вашего ЦОД.
Определите долю ИИ‑трафика и его профиль (обучение vs. inference). Обучение требует неблокирующей фабрики; inference — нет.
Проверьте физическую инфраструктуру: существующая кабельная система, энергетические вводы, охлаждение.
Для обучения закладывайте переподписку 1:1. Для inference и традиционного трафика — 3:1 и выше.
Если выбираете RoCEv2, настройте PFC и ECN до продакшена и протестируйте на микробёрстах. Не запускайте RoCE без lossless‑конфигурации.
Настройте мониторинг tail latency и времени завершения коллективных операций, а не только утилизации портов.
Оцените операционную модель: одна команда с двумя компетенциями или две специализированные группы. Гибридная среда требует обоих наборов навыков.
Запросите у вендоров reference designs для вашего масштаба и профиля нагрузки. Не полагайтесь на общие рекомендации.
Хотите проверить, насколько хорошо вы ориентируетесь в проектировании сетей ЦОД? Пройдите вступительный тест: он поможет оценить текущий уровень знаний и определить темы, которые стоит подтянуть.
Делаем выводы
Итак, в этой статье мы поговорили о том, как и когда нужно строить сеть для работы систем ИИ‑обучения, какие сложности могут возникнуть и как легче всего их преодолеть.
Здесь важно понимать, что конфликт традиционных приложений и мира ИИ‑систем нельзя просто устранить с помощью изменения физической топологии. Одна и та же сеть не может одинаково эффективно обрабатывать синхронизированный коллектив с тысячами участников и асинхронный веб‑запрос.
Прежде чем начинать проектирование нового ЦОД, вам нужно сначала понять, какой объём ИИ‑трафика у вас будет присутствовать в сети, и исходя из этого уже закладывать топологию, планировать переподписку.
Не забывайте о необходимости стендирования выбранных решений до запуска в продуктиве.
И главное, проектируйте сеть от рабочих нагрузок, а не от моделей коммутаторов и другого сетевого оборудования, так как в противном случае она вряд ли будет работать эффективно.
Проектирование сети ЦОД начинается с понимания особенностей нагрузок и требований к инфраструктуре. Если хотите глубже разобраться в сетевых архитектурах и развить практические навыки, обратите внимание на курс «Дизайн сетей ЦОД».
Дополнить знания и разобрать отдельные практические задачи можно на открытых уроках:
2 ноября в 20:15. «Как пройти собеседование на Network Engineer ЦОД: что реально спрашивают на VXLAN EVPN и почему на этом режут». Записаться
19 ноября в 20:00. «OSPF Deep Dive: Практикум по построению карты сети из базы данных маршрутизаторов». Записаться
Другие технические темы и практические занятия ищите в дайджесте открытых уроков OTUS.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.