Ищем нейросети в 37 тысячах вакансий hh: «ии» в слове «компании», дубли и ручная проверка
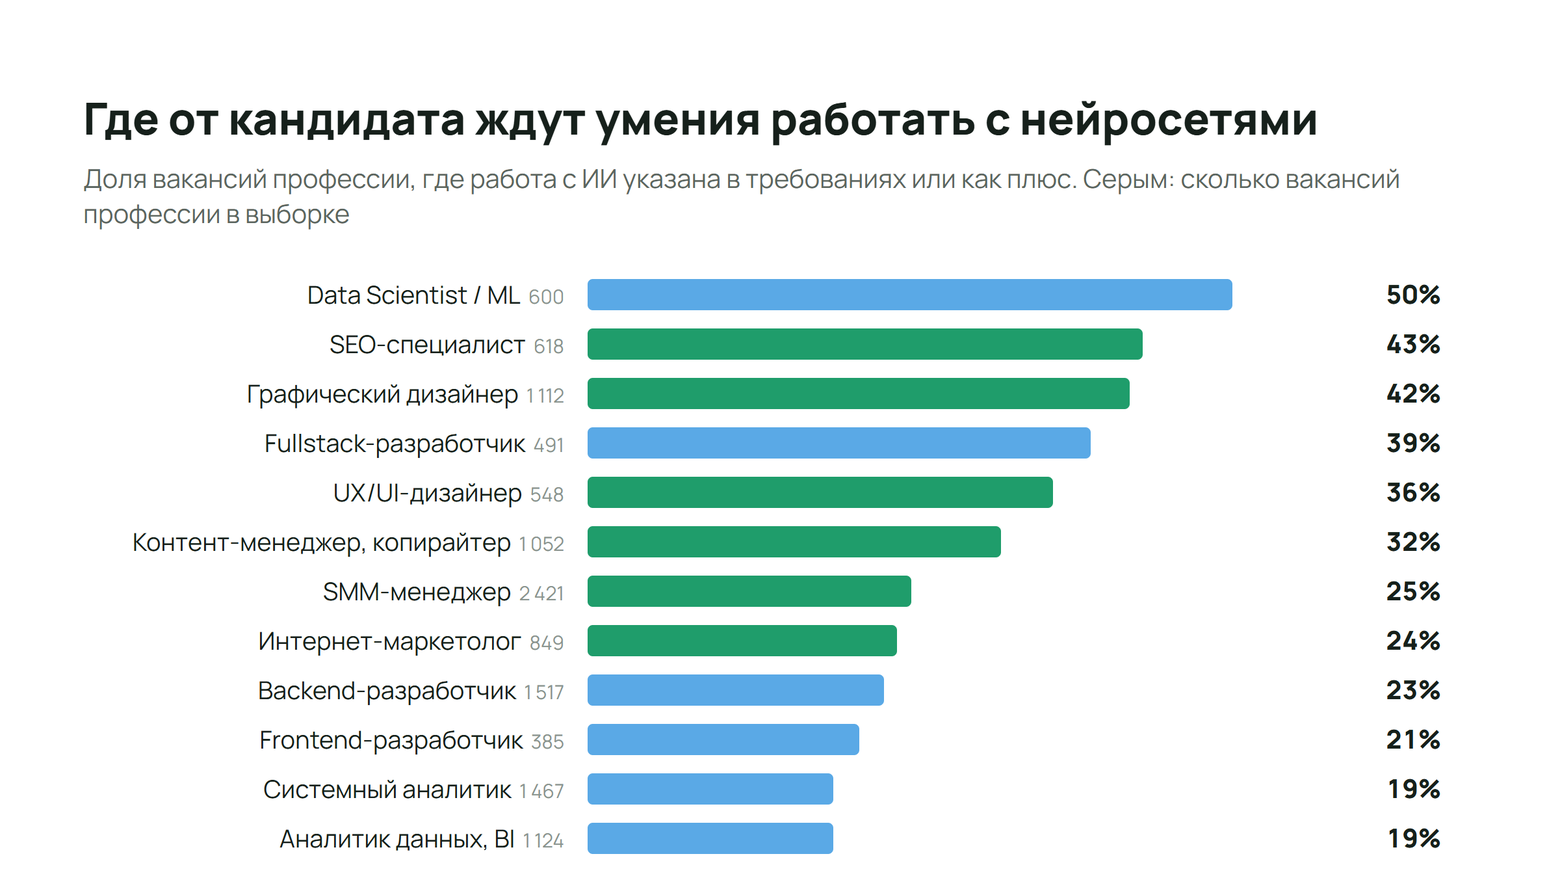
Я разобрал около 43 тысяч вакансий hh.ru за октябрь и начало ноября 2026 года, у каждой полный текст описания. Захотелось ответить на простой вопрос: в каких профессиях работодатель уже прямо пишет, что ждёт от кандидата работы с нейросетями. Ответ получился такой: больше всего в Data Science (50% вакансий), SEO (43%) и графическом дизайне (42%), меньше всего у сетевых инженеров, безопасников и сисадминов (2–3%).
Интереснее оказалось, сколько раз я ошибся по дороге. Почти каждый наивный шаг давал заметную ошибку, и ниже я разберу их по порядку: дубли, определение профессии по названию, поиск «ИИ» регулярками и попытку отличить требование к кандидату от рассказа компании о себе. В конце покажу ручную проверку на случайной выборке и то, что она сказала о точности метода.
Данные
Вакансии у меня в CSV: id, название, город, требуемый опыт, ключевые навыки и текст описания длиннее 300 знаков. Дальше я работал на чистом Python без pandas, потому что задача сводится к одному проходу по строкам с регулярками.
Описания бывают длинными, поэтому стандартный лимит поля в модуле csv пришлось поднять. Текст я сразу привожу к нижнему регистру и заменяю «ё» на «е», иначе «ещё» и «еще» становятся разными словами:
import csv
csv.field_size_limit(10**9)

def rows(path="v.csv"):
    with open(path, encoding="utf-8") as f:
        for r in csv.DictReader(f):
            r["t"] = r["title"].lower().replace("ё", "е")
            r["d"] = r["description_raw"].lower().replace("ё", "е")
            yield r
Получилось 42 969 вакансий. Около трети из Москвы, примерно десятая часть из Минска, Алматы, Ташкента и Астаны, остальное из других городов. У 13% город не указан.
Ловушка 1. Одна вакансия, много копий
Когда я начал читать вакансии глазами, стали попадаться одинаковые тексты. Без чистки такая вакансия считается несколько раз, и доли смещаются в сторону компаний, которые публикуются широко.
Убрал повторы по хешу описания (после того самого нижнего регистра и замены «ё»):
import hashlib

seen = set()
for r in rows():
    h = hashlib.md5(r["d"].encode()).hexdigest()
    if h in seen:
        continue
    seen.add(h)
    ...
Лишних копий набралось 5 506, это 13% выборки, и они собраны в 3 400 групп. Примерно половина копий (2 789) это одна вакансия в разных городах, остальное повторные публикации в том же городе. Рекорд у одного текста: 88 копий. Осталось 37 463 вакансии.
Дедупликация по точному совпадению текста грубая: две версии вакансии с разницей в одну строку она не склеит. Здесь этого хватило, но если делать аккуратнее, я бы сравнивал пару «работодатель и название» или считал похожесть текстов.
Ловушка 2. Профессия по названию вакансии
Профессию я определял регулярками по названию. Для каждой роли есть шаблон и список исключений. Ниже фрагмент, в рабочем списке 26 ролей и другой порядок:
import re

ROLES = [
    ("Backend-разработчик",
     r"backend|бэкенд|бекенд|python-разраб|java-разраб|golang|php|node\.?js|c#|\.net",
     r"frontend|fullstack|1с|аналитик|qa|тестиров|devops"),
    ("Frontend-разработчик", r"frontend|фронтенд|react|vue|angular", r"fullstack|backend"),
    ("UX/UI / продуктовый дизайнер",
     r"\bux\b|\bui\b|ux/ui|ui/ux|продуктов\w* дизайнер|веб-дизайнер", r""),
    ("Специалист по ИБ",
     r"информационной безопасност|кибербезопас|security|пентест|\bиб\b|\bsoc\b", r""),
]

# пустое исключение компилировать нельзя: re.compile("") совпадает с чем угодно
COMPILED = [(n, re.compile(p), re.compile(e) if e else None) for n, p, e in ROLES]

def role(title):
    for name, pat, excl in COMPILED:
        if pat.search(title) and not (excl and excl.search(title)):
            return name
    return None
Без границ слова шаблон ui ловит всё подряд. Слово с «ui» внутри нашлось в 63 названиях, чаще всего recruiter (23) и acquisition (10), дальше builder и equipment. С безопасниками то же самое: soc без границ находит social и associate, таких названий 15. С \b с обеих сторон таких ошибок не осталось.
Вторая тонкость в порядке ролей. 1 548 названий подходят сразу под две роли и больше, например «SMM-менеджер / таргетолог». Функция возвращает первое совпадение, поэтому порядок в списке я подбирал сам, от него зависит результат. Исключения нужны как раз для таких пересечений.
Роль нашлась у 27 893 вакансий из 37 463, это 74%. Остальные в таблицы я не выносил.
Ловушка 3. «ИИ» есть почти в каждой вакансии
Очевидный шаблон для поиска нейросетей содержит «ии» и «ai». Если искать их подстрокой, «ии» находится в 35 726 описаниях из 37 463, то есть в 95%. Причина в падежах: «компании», «документации», «автоматизации», «информации», «интеграции». С границами слова \bии\b остаётся 2 923 описания.
В Python 3 для строковых шаблонов флаг re.UNICODE включён по умолчанию, поэтому \w и \b учитывают буквы любого алфавита, и граница слова в кириллице работает из коробки. В JavaScript \b знает только латиницу, в PCRE для этого нужен (*UCP).
С английским «ai» похожая история, только мягче: подстрока встречается в 7 789 описаниях, а отдельное слово в 4 250. Остальное приходится на email, retail, airflow, domain, training и другие слова.
Итоговый шаблон собран из отдельных слов и названий инструментов:
AI = re.compile(
    r"нейросет|chatgpt|\bgpt|\bllm|\bai\b|\bии\b|искусственн\w* интеллект"
    r"|midjourney|stable diffusion|copilot|cursor|claude|yandexgpt|gigachat"
    r"|генеративн\w* (ии|модел|сет)|deepseek"
)
\bgpt не находит yandexgpt и chatgpt, поэтому они перечислены отдельно. Слитное genai шаблон пропускает. Ложные срабатывания тоже остались: у дизайнеров «ai» иногда означает формат Adobe Illustrator, но это меньше 1% их вакансий.
Ловушки с подстроками нашлись одним приёмом: я выводил самые частые слова, внутри которых сработал шаблон, и читал этот список глазами.
Ловушка 4. Упоминание не значит требование
После правок выше нейросети упоминаются в 20% вакансий. Но в вакансиях аналитиков и дата-сайентистов часто пишут о компании, например «создаем доступные решения на основе ai». Это не требование к кандидату.
Отличать одно от другого я стал по словам перед совпадением. Если не дальше 70 символов перед упоминанием нейросети стоит «опыт», «умение», «навык», «владение», «используете», «будет плюсом» или «преимущество», вакансия засчитывается. Для более общих слов вроде «работа с» и «знание» допуск короче, 20 символов. Между словом и совпадением не должно быть точки, точки с запятой и HTML-тега, чтобы не цеплять слово из соседнего пункта списка:
strong = re.compile(
    r"(опыт|умени|умеет|умеешь|навык|владе|использ|применя|приветству"
    r"|плюсом|преимуществ|готовност|пользуешься|освоени)[^.;<]{0,70}$"
)
weak = re.compile(r"(работ\w* с|знани|знаешь)[^.;<]{0,20}$")

def is_requirement(d):
    for m in AI.finditer(d):
        if strong.search(d[max(0, m.start() - 90):m.start()]):
            return True
        if weak.search(d[max(0, m.start() - 30):m.start()]):
            return True
    return False
Доля упала с 20% до 15%. В процентных пунктах сильнее всего упали Data Science (с 70% упоминаний до 50% требований), SEO (с 57% до 43%) и DevOps (с 27% до 15%). В относительном выражении больше всех потеряли безопасники: из 7% осталось 3%.
Ручная проверка
Регулярки я подбирал на глаз, поэтому проверил их руками: взял две случайные выборки по 30 вакансий и прочитал контекст совпадений.
Первая выборка состояла из вакансий, которые метод засчитал как требование. Все 30 оказались требованием, обязанностью или «будет плюсом». Правда, в четырёх речь шла не об использовании нейросетей в работе, а о разработке на их основе: «опыт тестирования llm с подходом llm-as-a-judge», «знание ai/ml-решений». Ещё один случай засчитан по слову из рассказа компании: «мы активно используем claude code». Основа «использ» ловит и «мы используем». Здесь повезло, дальше в тексте шло «нужен человек, который умеет».
Вторая выборка состояла из вакансий, где нейросети упомянуты, но метод требования не нашёл. Здесь 13 из 30 действительно оказались рассказом о компании, продукте или бонусах: «доступ к современным ai-инструментам» в разделе «мы предлагаем», «нейросетями пользоваться можно» в описании тестового задания. Ещё три спорные. А 14 из 30 всё-таки были про работу кандидата, просто сформулированы иначе. Чаще всего это обязанности: «генерация изображений с помощью нейросетей», «написание и редактирование текстов (в том числе с ии)». Есть и настоящая дыра в списке: «навыки оптимизации рутинных процессов, в том числе с применением современных ии-инструментов». Слово «навык» стоит в 72 символах от совпадения при допуске 70, а основа «применя» не ловит «применением».
Итог такой: ложных срабатываний в первой выборке нет, а во второй требований почти половина. Для 30 из 30 нижняя граница точности по Уилсону около 89%. Для 14 из 30 интервал Уилсона примерно от 30 до 64%. Среди вакансий с определённой профессией 4 838 засчитаны и 1 652 отброшены. Если засчитанные все верны, то вместе по этим вакансиям настоящая доля выше полученной на 10–22% от её величины.
По отдельным профессиям поправка может быть разной, а выборка у меня общая. Верх и низ таблицы от неё не меняются, а в середине строки могут сдвинуться на несколько пунктов. Поэтому проценты ниже лучше читать как нижнюю границу.
Дальше хочу отдавать короткое окно вокруг совпадения модели и сверять её с этой же ручной разметкой.
Что получилось
Ниже доли по 25 профессиям. Менеджеров маркетплейсов я убрал, их всего 33 вакансии. «Упоминают» означает, что нейросети есть где-то в тексте вакансии, «ждут от кандидата» означает, что метод нашёл рядом слова про опыт, умение или плюс.
Профессия | Вакансий | Упоминают | Ждут от кандидата |
|---|---|---|---|
Data Scientist / ML | 600 | 70% | 50% |
SEO-специалист | 618 | 57% | 43% |
Графический дизайнер | 1 112 | 49% | 42% |
Fullstack-разработчик | 491 | 49% | 39% |
UX/UI-дизайнер | 548 | 45% | 36% |
Контент-менеджер, копирайтер | 1 052 | 40% | 32% |
SMM-менеджер | 2 421 | 29% | 25% |
Интернет-маркетолог | 849 | 32% | 24% |
Backend-разработчик | 1 517 | 31% | 23% |
Frontend-разработчик | 385 | 30% | 21% |
Системный аналитик | 1 467 | 25% | 19% |
Аналитик данных, BI | 1 124 | 26% | 19% |
Маркетолог | 291 | 22% | 19% |
Мобильный разработчик | 282 | 23% | 17% |
QA, тестировщик | 1 326 | 23% | 15% |
DevOps, SRE | 949 | 27% | 15% |
Product manager | 1 500 | 20% | 14% |
Бизнес-аналитик | 1 360 | 20% | 14% |
Таргетолог | 262 | 19% | 12% |
Руководитель проектов | 2 637 | 13% | 8% |
Программист 1С | 1 859 | 7% | 5% |
Техподдержка | 1 646 | 5% | 4% |
Системный администратор | 1 885 | 5% | 3% |
Специалист по ИБ | 1 148 | 7% | 3% |
Сетевой инженер | 531 | 5% | 2% |
Отдельно я посчитал, какие инструменты называют в вакансиях разработчиков (бэкенд, фронтенд, fullstack и мобильные, всего 2 675). Здесь учитывалось любое упоминание, а не только требование. Claude встречается в 8% вакансий, Cursor в 5%, ChatGPT и Copilot примерно в 3–4%. Слова про ИИ-агентов и MCP есть в 12% вакансий, но чаще всего речь о том, что агентов нужно разрабатывать, а не просто ими пользоваться. У SEO-специалистов на первом месте ChatGPT (14%), у дизайнеров Midjourney (6%).
Если хотите проверить какую-то гипотезу на этой выборке, например по другой профессии или по другому требованию, напишите в комментариях. Посчитаю тем же способом и отвечу цифрами.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.