Копируем содержимое Яндекс.Диск к себе
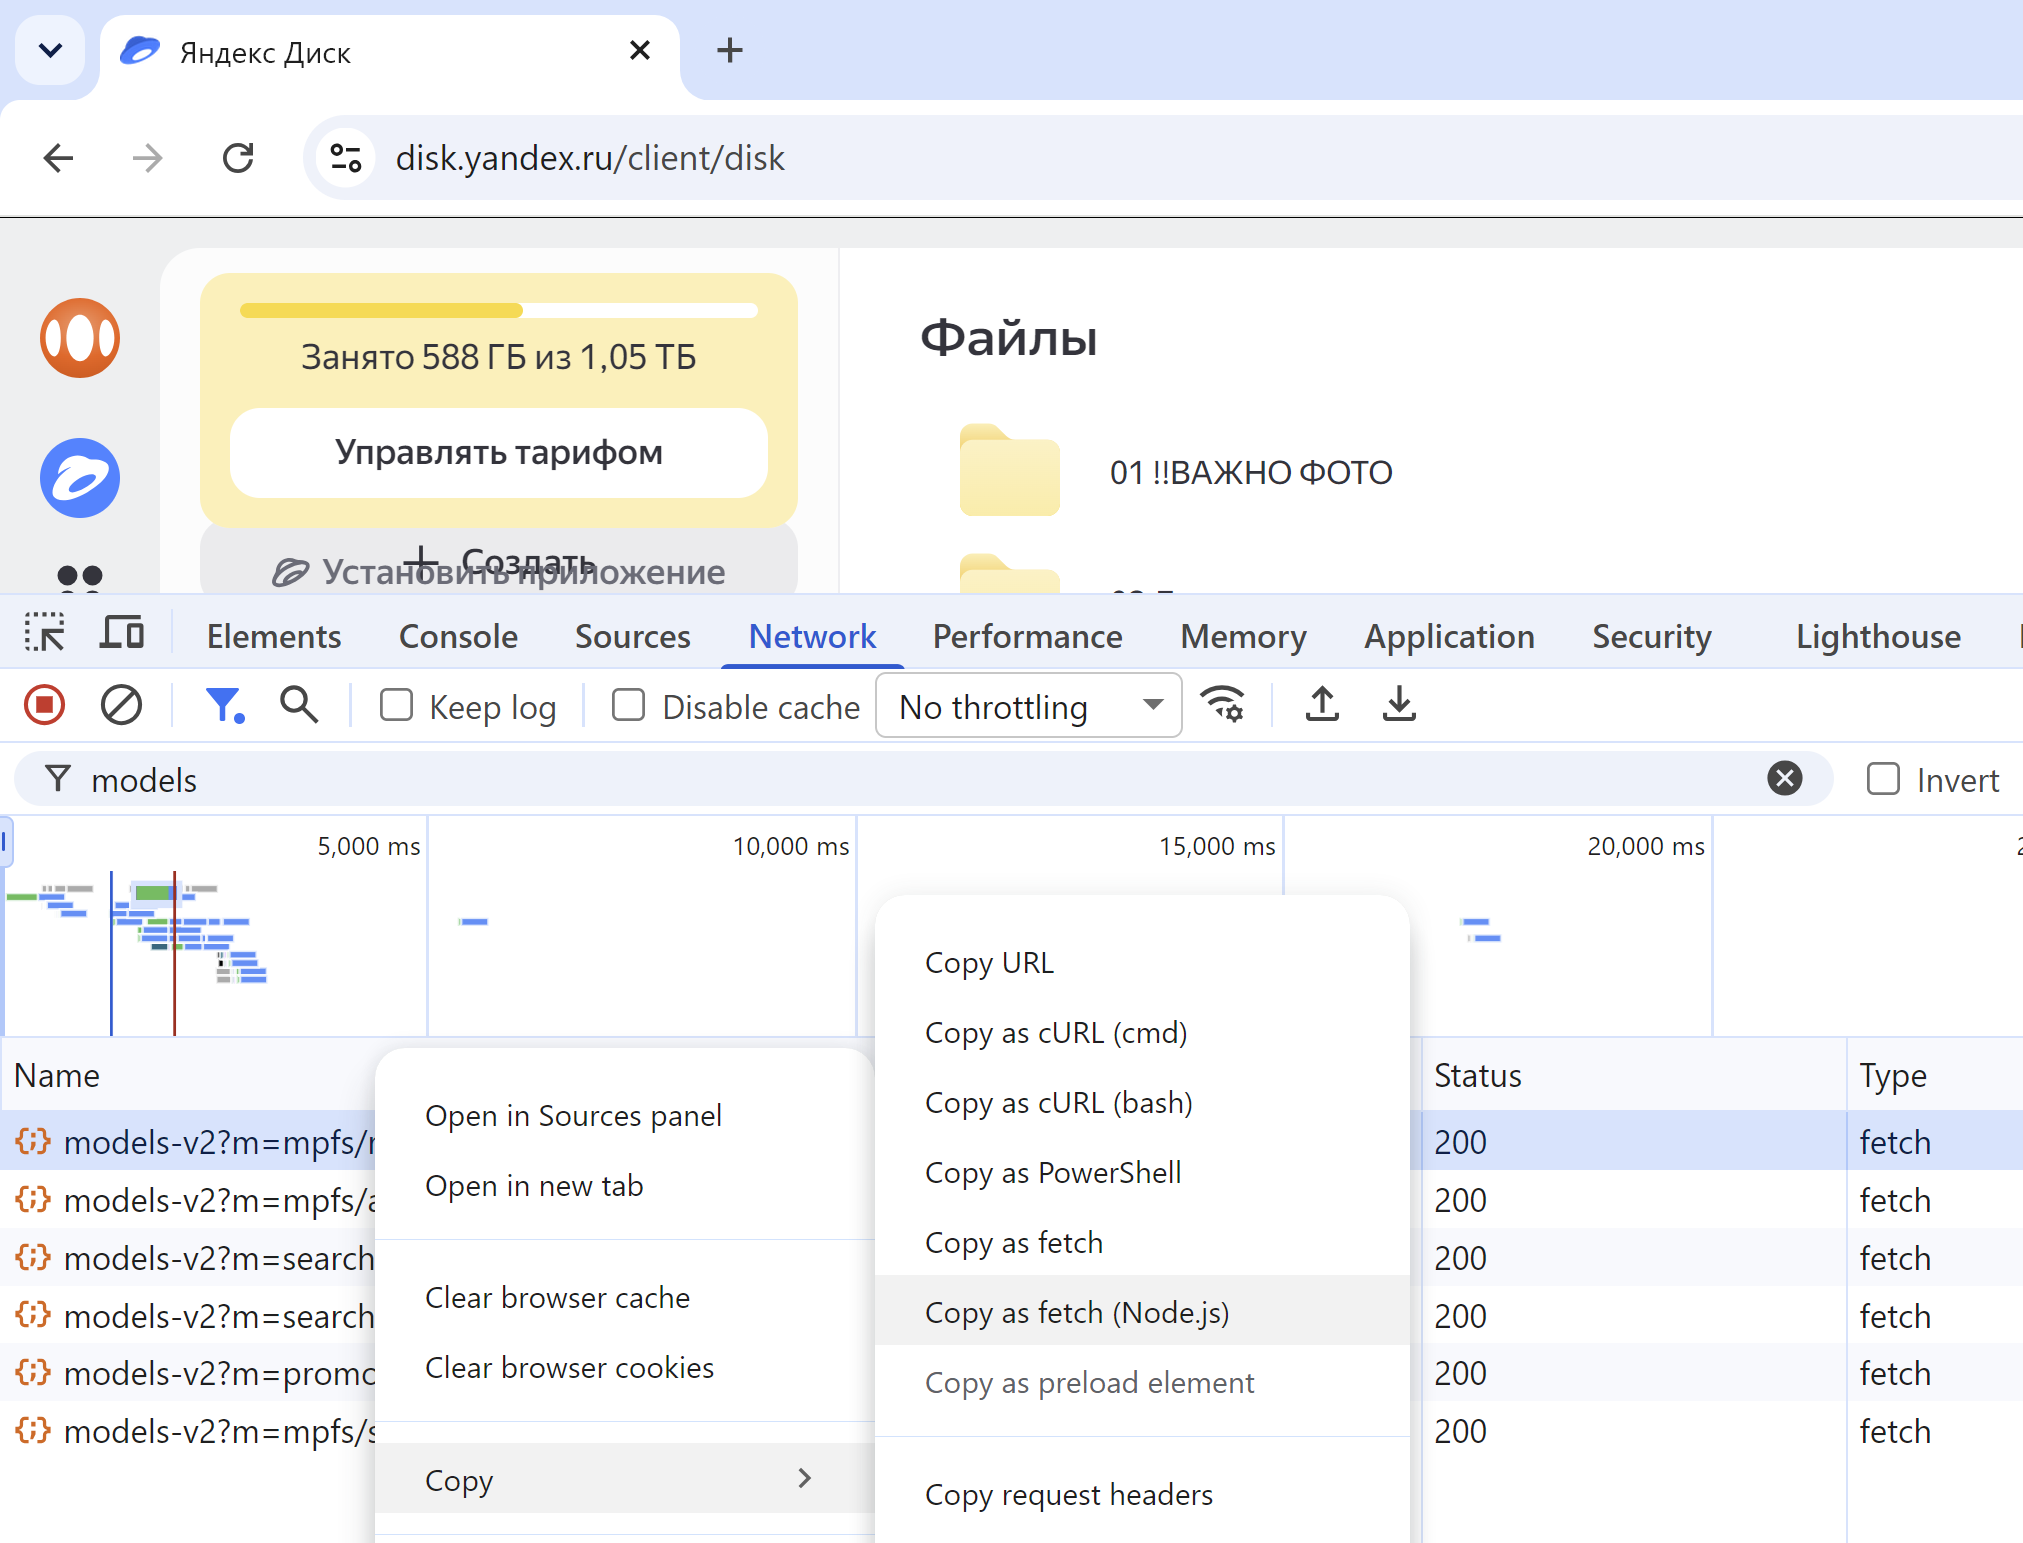
есть Яндекс.Диск объемом ~500GB, заполненный в основном фото (RAW и JPEG) и видео
большинство файлов успешно скачивается через web-интерфейс на полной скорости
есть задача сохранить все его содержимое на локальный диск, насколько это возможно, учитывая последние события
Вроде бы ровно для этого и нужен официальный клиент - но в реальных условиях он повел себя крайне странно:
не позволил выбрать целевую папку ни на каком локальном диске, кроме C:
несмотря на позитивные новости, регулярно натыкался на какой-то недоступный файл и впадал в ступор
скорость загрузки оставляла желать лучшего
Пришлось брать дело в свои руки, а заодно плотнее познакомиться с node:streams...
Как все устроено "для браузера"
Пробовать API Диска после попыток использовать "родной" клиент не хотелось совсем - лучше посмотрим, как работает web-клиент в браузере, и постараемся прикинуться им.
В общем-то от нас никто ничего не скрывает, и нам потребуется реализовать всего несколько типов операций.
Листинг раздела
Чтобы получить список объектов любого раздела, включая корневой, используется POST-запрос по адресу https://disk.yandex.ru/models-v2?m=mpfs/resources.
Аргументы:
{
  sort       : 'name'  // сортировка по имени
, order      : '1'
, idContext  : '/disk' // path до объекта
, amount     : 40      // количество элементов на странице
, offset     : 0       // стартовый по порядку элемент
}
Web-клиент запрашивает списки файлов страницами по 40 штук, и мы не будем нарушать эту традицию.
В ответ получаем JSON-массив примерно таких объектов с вполне прозрачной структурой:
{
  type  : "dir"              // тип объекта: 'dir' или 'file'
, id    : "/disk/My Folder/" // полный путь к объекту на Диске
, name  : "My Folder"        // имя объекта
, path  : "/disk/My Folder"  // полный путь к объекту на Диске, еще раз
, meta  : {
    size : 123456            // размер - для файла
  }
  // время создания, изменения, ... в Unix Timestamp
, ctime : ...
, mtime : ...
, utime : ...
}
Путь к файлу
Еще один POST-запрос, теперь по адресу https://disk.yandex.ru/models-v2?m=mpfs/url с единственным аргументом path помогает нам получить URL для загрузки файла:
{
  file : "//downloader.disk.yandex.ru/disk/..."
}
Тело файла
Обратившись к полученному URL, теперь уже GET-запросом, мы получим HTTP 302-редирект с адресом конкретного хранилища в заголовке:
location : https://mds.storage.yandex.net/rdisk/...
Собственно, там и находится искомый контент.
Загрузчик
Для того, чтобы "притворяться браузером" условно-корректно, нам потребуются заголовки любого из упомянутых выше POST-запроса - их легко скопировать прямо из браузера:
Нам потребуются сами заголовки (headers) и два параметра, передаваемых в body: sk и connection_id.
Данные сессии (
sk / connection_id) "протухают" примерно через сутки после получения. Поэтому если контента у вас много - загрузка отвалится, и необходимо будет взять из браузера актуальные реквизиты.
Я постарался обойтись минимумом внешних библиотек. Понадобилась всего одна - utimes для удобной простановки атрибутов времени на файлах и каталогах под Windows.
Основной алгоритм весьма прост:
обрабатываем очередь задач
tasks, пока она не опустеет, начиная с "корня"/disk(если вам более приоритетна конкретная папка - подставьте ее)для задачи-каталога (
type == 'dir') страницами по 40 получаем все лежащие внутри элементы и добавляем в начало очереди задачдля задачи-файла (
type == 'file') пытаемся несколько раз получить его контент, и если загруженный размер совпадает с ожидаемым - выкладываем в целевое хранилищев некоторых случаях при доступе к файлу случаются таймауты, HTTP 500 или просто обрыв в ходе загрузки - поэтому делаем пару попыток, пока не удалось загрузить весь ожидаемый объем файла
В моем случае целевой диск находится на медленном сетевом хранилище, поэтому тело файла сначала потоково "чанками" пишется во временный файл на локальном диске, а потом целиком копируется куда надо.
// yad-dl.js

// очередь задач
const tasks = [
  {
    id     : '/disk/'
  , type   : 'dir'
  , path   : '/disk' // откуда начинаем сканирование
  , name   : 'disk'
  , depth  : 0
  , target : 'Z:\\#ya.dsk.dump' // целевая папка на локальном диске
  }
];

// реквизиты сессии
const headers = {
  ...,
  "Referer": "https://disk.yandex.ru/client/disk"
};
const reqJSON = {
  sk            : '...:...'
, connection_id : '...'
};

const path = require('node:path');
const fs = require('node:fs');
const {Readable, Transform} = require('node:stream');
const {pipeline} = require('node:stream/promises');

const {utimes} = require('utimes');

// форматируем таймстамп в убодное представление
Date.prototype.toTimeStringEx = function() {
  return `${this.getFullYear()}-${(this.getMonth() + 1).toString().padStart(2, '0')}-${this.getDate().toString().padStart(2, '0')} ${this.getHours().toString().padStart(2, '0')}:${this.getMinutes().toString().padStart(2, '0')}:${this.getSeconds().toString().padStart(2, '0')}.${this.getMilliseconds().toString().padStart(3, '0')}`;
};

// статистика обработки
const filestat = {
  skip  : 0
, dump  : 0
, error : 0
};

// создаем временную папку
const temp = fs.mkdtempSync('yad-dl');

(async () => {
  // обрабатываем задачи из очереди по обной
  do {
    const task = tasks.shift();
    if (!task) {
      break;
    }
    task.name = task.name.replaceAll(/[\:\?\"]/g, '+'); // убираем недопустимые символы из имени
    task.target = path.join(task.target, task.name);
    console.log(`${new Date().toTimeStringEx()} | -- ${task.type == 'file' ? 'f' : 'd'} : ${JSON.stringify(task.path)}`);
    console.log(`${new Date().toTimeStringEx()} | -- --- ${JSON.stringify(task.target)}`);

    // обработка папки
    if (task.type == 'dir') {
      // если целевой папки еще нет - создаем ее и проставляем ей атрибуты времени
      if (!fs.existsSync(task.target)) {
        try {
          fs.mkdirSync(task.target);
        }
        catch (e) {
          console.log(`${new Date().toTimeStringEx()} | mkdir`, e);
        }
        await utimes(task.target, {
          btime : (task.ctime ?? 0) * 1000
        , mtime : (task.mtime ?? 0) * 1000
        , atime : (task.utime ?? 0) * 1000
        });
      }
      else {
        console.log(`${new Date().toTimeStringEx()} | -- -- : skip mkdir`);
      }

      // загружаем вложенные элементы "страницами" по 40 штук
      const nested = [];
      const amount = 40;
      do {
        console.log(`${new Date().toTimeStringEx()} | -- -- : get offset : ${nested.length.toString().padStart(9)}`);
        const res = await fetch(
          'https://disk.yandex.ru/models-v2?m=mpfs/resources'
        , {
            headers
          , method : 'POST'
          , body   : JSON.stringify({
              ...reqJSON
              , apiMethod     : 'mpfs/resources'
              , requestParams : {
                  sort       : 'name'
                , order      : '1'
                , idContext  : task.path
                , amount
                , offset     : nested.length
                , with_share : '1'
                }
            })
          }
        );
        const {resources} = await res.json();
        console.log(`${new Date().toTimeStringEx()} | -- -- : segment-sz : ${resources.length.toString().padStart(9)}`);
        nested.push(...resources);
        if (resources.length < amount) {
          break;
        }
      }
      while (true);
      // прописываем всем "дочерним" задачам целевой каталог и добавляем в начало очереди
      nested.forEach(item => item.target = task.target);
      tasks.unshift(...nested);
    }
    // обработка файла
    if (task.type == 'file') {
      console.log(`${new Date().toTimeStringEx()} | -- -- : vol = ${task.meta.size.toString().padStart(10)}`);
      // пропускаем, если целевой файл уже есть, и нужного размера
      let need = !fs.existsSync(task.target);
      if (!need) {
        const {size} = fs.statSync(task.target);
        need ||= size != task.meta.size;
        if (need) {
          fs.rmSync(task.target); // если размер не совпал - зачищаем
        }
        else {
          console.log(`${new Date().toTimeStringEx()} | -- -- : skip file`);
          filestat.skip++;
        }
      }
      if (need) {
        console.log(`${new Date().toTimeStringEx()} | -- -- : get storage : ${JSON.stringify(task.path)}`);
        // получаем URL для доступа к файлу
        const res = await fetch(
          'https://disk.yandex.ru/models-v2?m=mpfs/url'
        , {
            headers
          , method : 'POST'
          , body   : JSON.stringify({
              ...reqJSON
            , apiMethod     : 'mpfs/url'
            , requestParams : {
                path : task.path
              }
            })
          }
        );
        const data = await res.json();
        if (data.file) {
          let retry = 2; // до 2 попыток загрузки
          let success;
          do {
            console.log(`${new Date().toTimeStringEx()} | -- -- : rcv storage : ${data.file}`);
            const res = await fetch('https:' + data.file, {
              headers
            , method : 'GET'
            })
              .catch(e => {
                console.log(`${new Date().toTimeStringEx()} | GET`, e);
              });
            if (res?.status == 200) {
              const tempfile = path.join(temp, task.name);
              console.log(`${new Date().toTimeStringEx()} | -- -- : rcv data | ${tempfile}`);
              // считаем полученный объем файла и выводим в лог раз в секунду
              const tsb = Date.now();
              let size = 0;
              let tsl = tsb;
              const monitor = new Transform({
                transform(chunk, encoding, callback) {
                  size += chunk.length;
                  const tse = Date.now();
                  if (tse >= tsl + 1000 || size == task.meta.size) {
                    console.log(`${new Date().toTimeStringEx()} | -- -- : rcv = ${size.toString().padStart(10)} (${(size/task.meta.size * 100).toFixed(2).padStart(6)}%) | ${(size/((tse - tsb)/1000)/1024/1024).toFixed(2).padStart(6)} MB/s | ETA = ${new Date(tse + (tse - tsb)/size * (task.meta.size - size)).toTimeStringEx()}`);
                    tsl = tse;
                  }
                  this.push(chunk);
                  callback();
                }
              });

              try {
                // перенаправляем поток загружаемого файла через наш монитор во временный файл
                await pipeline(
                  Readable.fromWeb(res.body)
                   .on('error', e => {
                     console.log(`${new Date().toTimeStringEx()} | bodyStream`, e);
                   })
                , monitor
                , fs.createWriteStream(tempfile, {flags : 'wx'})
                )
                  .catch(e => {
                    console.log(`${new Date().toTimeStringEx()} | finished`, e);
                  });
                // если загруженный размер совпадает с ожидаемым - перекопируем в целевое хранилище
                if (size == task.meta.size) {
                  console.log(`${new Date().toTimeStringEx()} | -- -- : cpy = ${task.target}`);
                  fs.copyFileSync(tempfile, task.target);
                  await utimes(task.target, {
                    btime : task.ctime * 1000
                  , mtime : task.mtime * 1000
                  , atime : task.utime * 1000
                  });
                  const tse = Date.now();
                  console.log(`${new Date().toTimeStringEx()} | -- -- : mov = ${size.toString().padStart(10)} (${(size/task.meta.size * 100).toFixed(2).padStart(6)}%) | ${(size/((tse - tsl)/1000)/1024/1024).toFixed(2).padStart(6)} MB/s |`);
                  success = true;
                  filestat.dump++;
                }
                else {
                  console.log(`${new Date().toTimeStringEx()} | -- -- : neq sizes : ${size} != ${task.meta.size}`);
                }
              }
              catch (e) {
                console.log(`${new Date().toTimeStringEx()} | catch`, e);
              }
              fs.rmSync(tempfile);
            }
            else {
              console.log(`${new Date().toTimeStringEx()} | -- -- : ${res?.status} - ${res?.statusText}`);
            }
          }
          while (!success && --retry);
          if (!success) {
            // файл, который не удалось получить, выводится в STDERR
            console.error(`${new Date().toTimeStringEx()} | ${task.path}`);
            filestat.error++;
          }
        }
        else {
          console.log(data);
        }
      }
    }
  } while (true);
  console.log(`${new Date().toTimeStringEx()} | finish | skip : ${filestat.skip}, dump : ${filestat.dump}, error : ${filestat.error}`);
})();
Поскольку часть файлов все еще недоступна, но постепенно "открывается", рекомендуется периодически перезапускать скрипт. Я для себя сделал следующий bat-файл, который формирует новую пару log/err-файлов при каждом запуске, чтобы можно было сразу увидеть, что еще не загрузилось в этот раз:
@echo off
for /f "tokens=2 delims==" %%i in ('wmic OS Get localdatetime /value') do set "dt=%%i"
set "timestamp=%dt:~0,14%"
node yad-dl.js >_log-%timestamp% 2>_err-%timestamp%
Вместо заключения
Практически каждый новый запуск скрипт приносит сейчас новые, недоступные на предыдущих итерациях, файлы - так что, благодаря коллегам из Яндекса, ситуация постепенно улучшается.
Возможно, вам будет достаточно и официального клиента, но у меня он так и не смог показать утилизацию канала выше 1Mbps. Эксперименты же со скриптом показали, что сейчас файлы отдаются хоть и на разных уровнях скорости, зато от 1.5Mbps до 50Mbps (видимо, в зависимости от конкретного ЦОД).
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.