Как перестать проверять одно и то же руками? Testence и ИИ-агент в работе тестировщика
Перед релизом нужно снова убедиться, что всё ещё работает: вход, создание записи, редактирование, сохранение, удаление. Ты уже проверял это десятки раз и знаешь каждый шаг наизусть. Но пройти сценарии заново нужно внимательно: знакомый интерфейс после пачки изменений может скрывать неожиданную ошибку.
Именно поэтому рутинные проверки обязательны и требуют внимания. Но так хочется потратить время на новые сценарии и хитрые дефекты. Но, увы, нужно прокликать еще тридцать три почти одинаковых формы под разными пользователями.
Кажется, самое время автоматизировать эти проверки. Но между «хочу перестать проверять это руками» и полезными, надежными и быстрыми автотестами — пару десятков разнородных задач. Инструменты есть, а собрать из них рабочий процесс приходится самому тестировщику. Ну и ошибаться, конечно, тоже. На текущий момент ИИ-агенты помогают с отдельными задачами, но связать всё воедино всё ещё непросто.
Мне захотелось объединить эти блоки в единый процесс и решить основные проблемы, которые съедают время и силы при написании автотестов. В идеале это должно работать так:
Тестировщик передаёт агенту всё, что знает о фиче: ожидаемое поведение, ограничения, нюансы и известные риски.
Агент проводит тест-дизайн, исследует интерфейс, пишет и отлаживает тесты.
Готовые тесты запускаются по команде или в CI/CD — обычным кодом, без участия агента.
Когда фича меняется, агент помогает актуализировать сценарии и тесты, а тестировщик проверяет изменения.
Для этого я разрабатываю Testence — открытый Python-фреймворк для автоматизации веб-тестирования с ИИ-агентом. Он связывает весь цикл: от описания фичи и тест-дизайна до готовых pytest-тестов и отчёта с доказательствами результата. Агент исследует, пишет и разбирается в проблемах. Готовые тесты дальше работают без него.
Почему UI-тест зелёный, хотя данные не сохранились
Допустим, агент написал первый тест: создать карточку в приложении. Тест вводит название, нажимает «Сохранить», проверяет уведомление об успехе и новую карточку в списке. Всё проходит. Кажется, один пункт ручного чек-листа можно больше не трогать.
Только карточка на сервере не сохранилась.
Интерфейс показал её сразу, не дожидаясь сохранения, — так работает оптимистичное обновление. В нашем синтетическом стенде сервер намеренно подтверждает запрос, но не сохраняет данные. Уведомление есть, карточка в списке есть. Обновляем страницу — карточка исчезает.
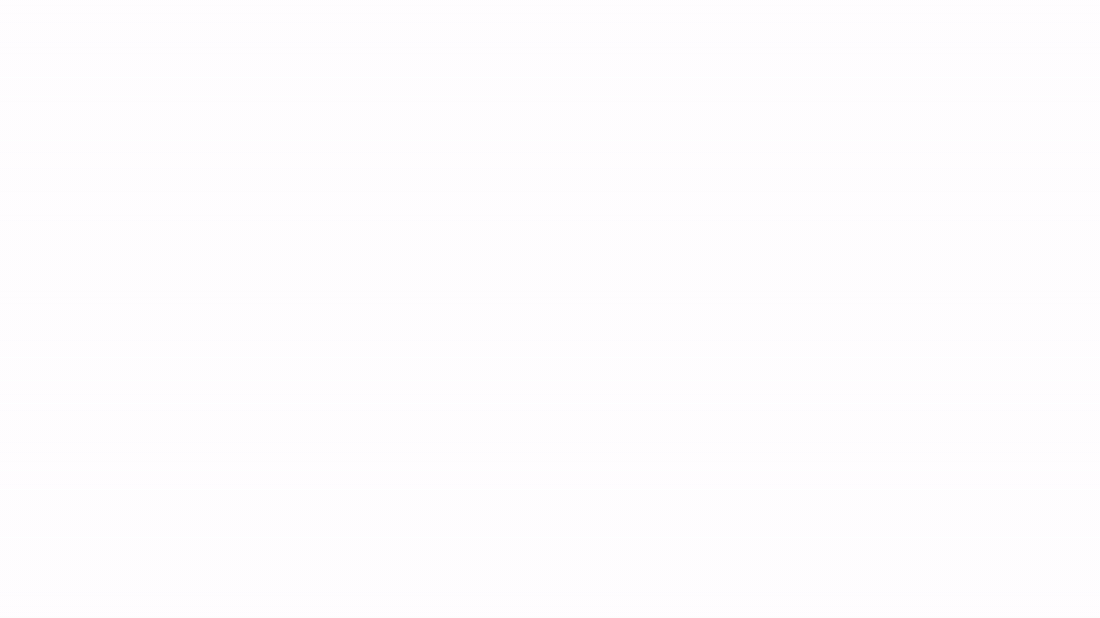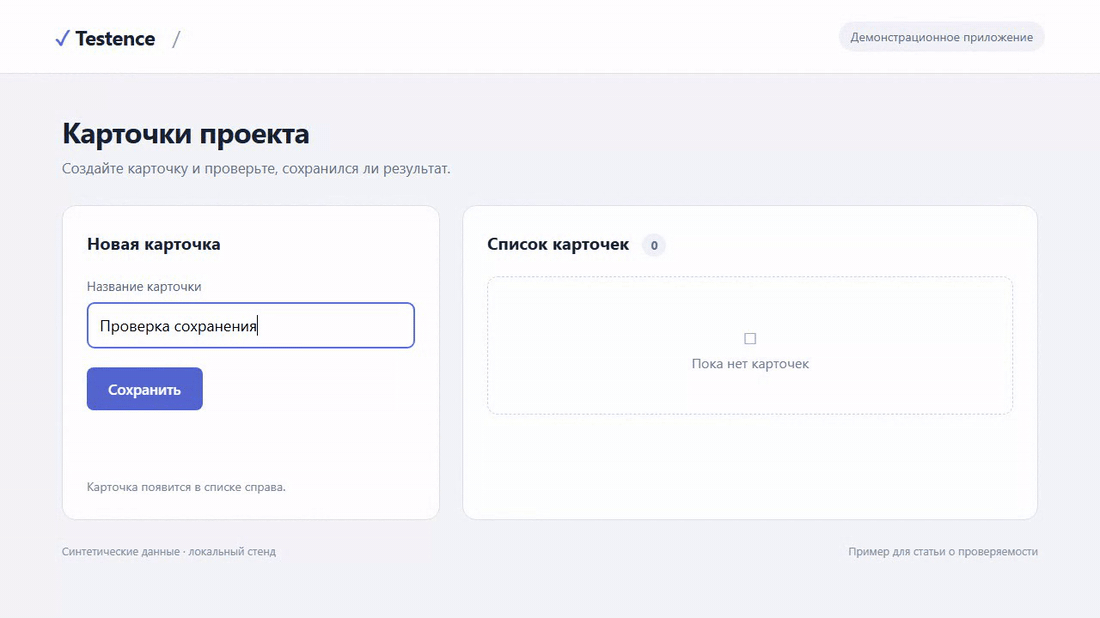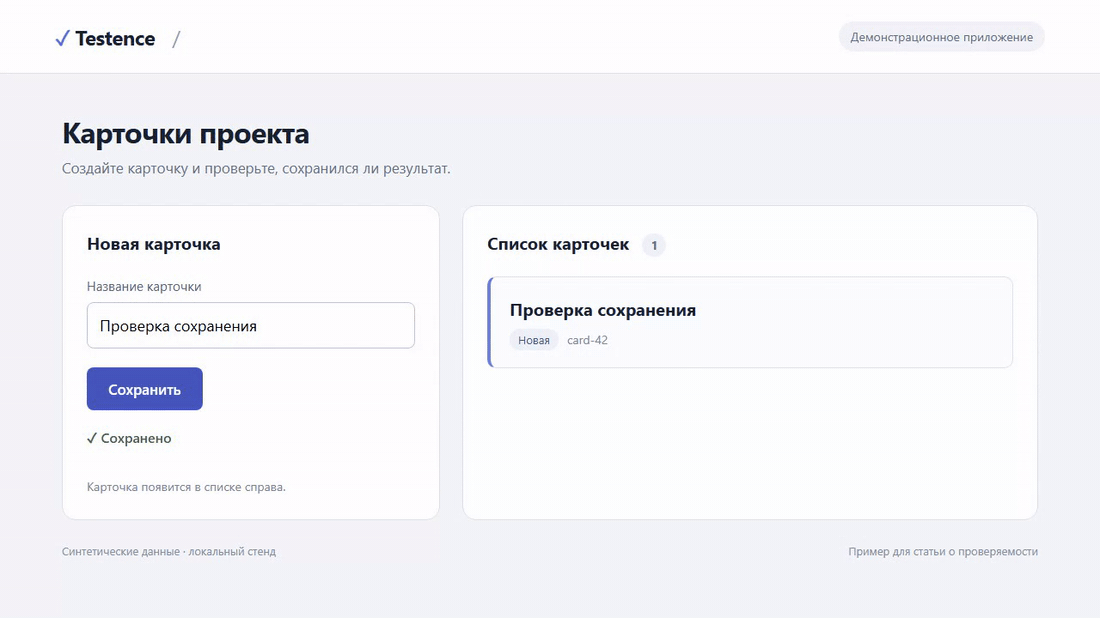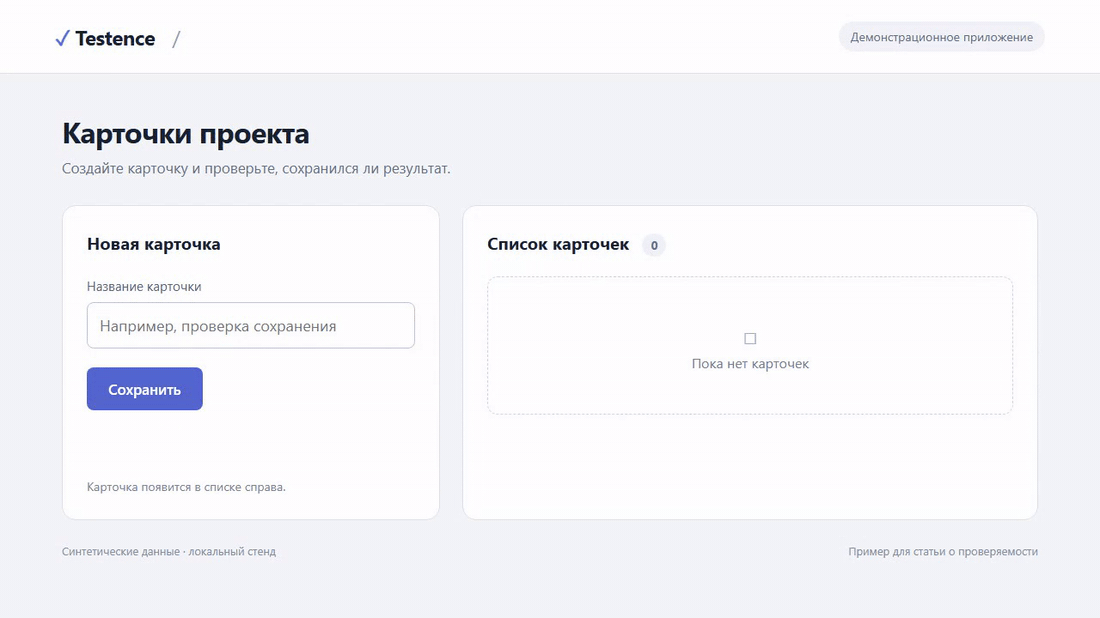
Получается, мы автоматизировали действия из чек-листа, но саму проверку потеряли. Тест исправно подтверждает, что интерфейс показал успех. А нас интересовало, сможет ли пользователь потом вернуться к созданной карточке.
Поэтому при тест-дизайне нужно решить не только что сделать, но и чем подтвердить результат. В этом примере — после сохранения независимо прочитать карточку через API от имени того же пользователя и проверить, что она действительно существует с нужным названием.
В Testence такая проверка называется oracle. Сам по себе запрос к API ещё ничего не гарантирует: можно прочитать кэш, другую карточку или данные другого пользователя. Проверка должна быть связана с конкретным действием и читать именно то состояние, которое мы хотим подтвердить.
В прогоне r-habr-card-defect разница получилась наглядной: UI-проверки прошли, а независимое чтение вместо ожидаемого названия и состояния saved вернуло name: null и state: missing.
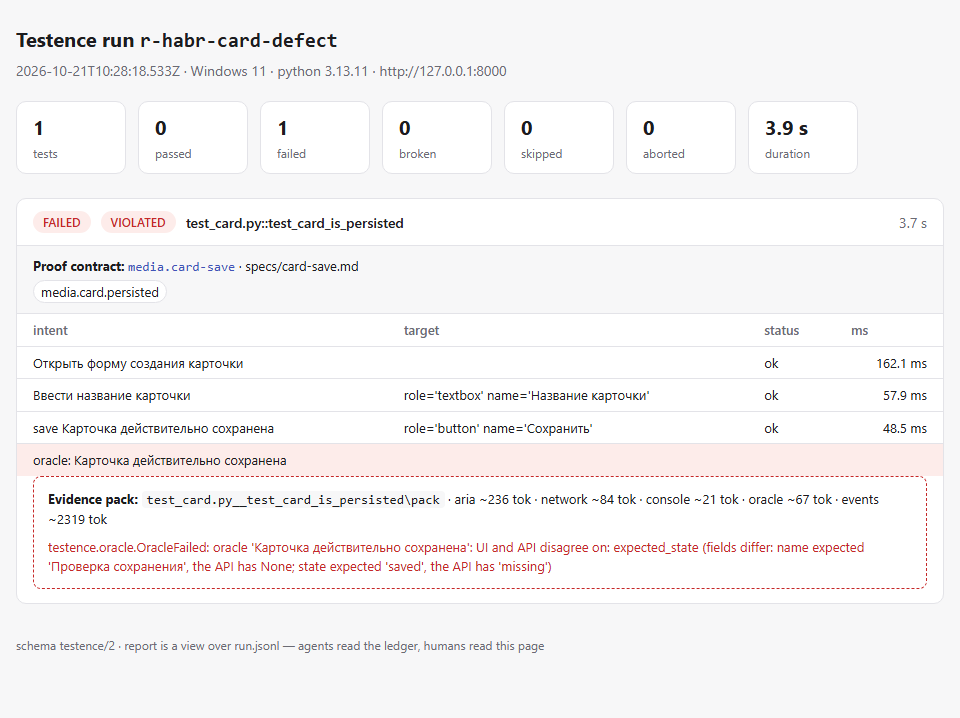
Вот почему мне понадобился единый процесс от тест-дизайна до проверки результата. Если агент просто переведёт ручные шаги в код, можно получить быстрый, стабильный и совершенно бесполезный зелёный тест. Нужно ещё на этапе проектирования определить, что будет доказательством успеха, и сохранить эту проверку в готовом тесте.
И это один из самых наглядных случаев. Есть ещё сотня нюансов: реактивные обновления, повторный рендер компонентов, отложенные запросы, виртуальные списки. Элемент уже появился, но ещё не готов к взаимодействию. Или его перекрыла модалка. Запрос завершился, но новые данные так и не отобразились.
Агенту нужно понимать, как устроен интерфейс, чего дожидаться и как достоверно проверять результат. Допустим, кнопка стала доступна на одну миллисекунду, и автоматизация успела её нажать. Тест зелёный. Но сможет ли пользователь повторить этот сценарий? Успешное выполнение команды ещё не доказывает, что интерфейсом можно нормально пользоваться.
Зачем нужен Testence, если есть Playwright?
Между «нажать кнопку» и «проверить сценарий» довольно много работы.
Playwright умеет находить элементы, ждать их доступности и взаимодействовать с браузером. Но его встроенные ожидания не всегда совпадают с тем, что происходит внутри приложения. Например, при гидратации кнопка уже может быть видна и доступна, а обработчик нажатия ещё не подключён. Playwright нажмёт её, но ничего не произойдёт. Этот случай описан прямо в документации.
В итоге ты садишься автоматизировать проверку, а сначала воюешь с самой автоматизацией: почему клик прошёл, но ничего не случилось? Чего опять не дождались? Откуда взялся таймаут? А сверху наваливается специфика приложения: виртуальные списки, роли, тестовые данные, хитрые компоненты. И вот вместо поиска дефектов ты отлаживаешь тест, который должен был освободить тебе время.
Вот эту работу я и хочу поручить агенту в Testence: исследовать приложение, учесть ограничения инструментов, провести тест-дизайн и превратить всё это в надёжный, поддерживаемый код. А готовые тесты запускать без агента — по команде или в CI/CD.
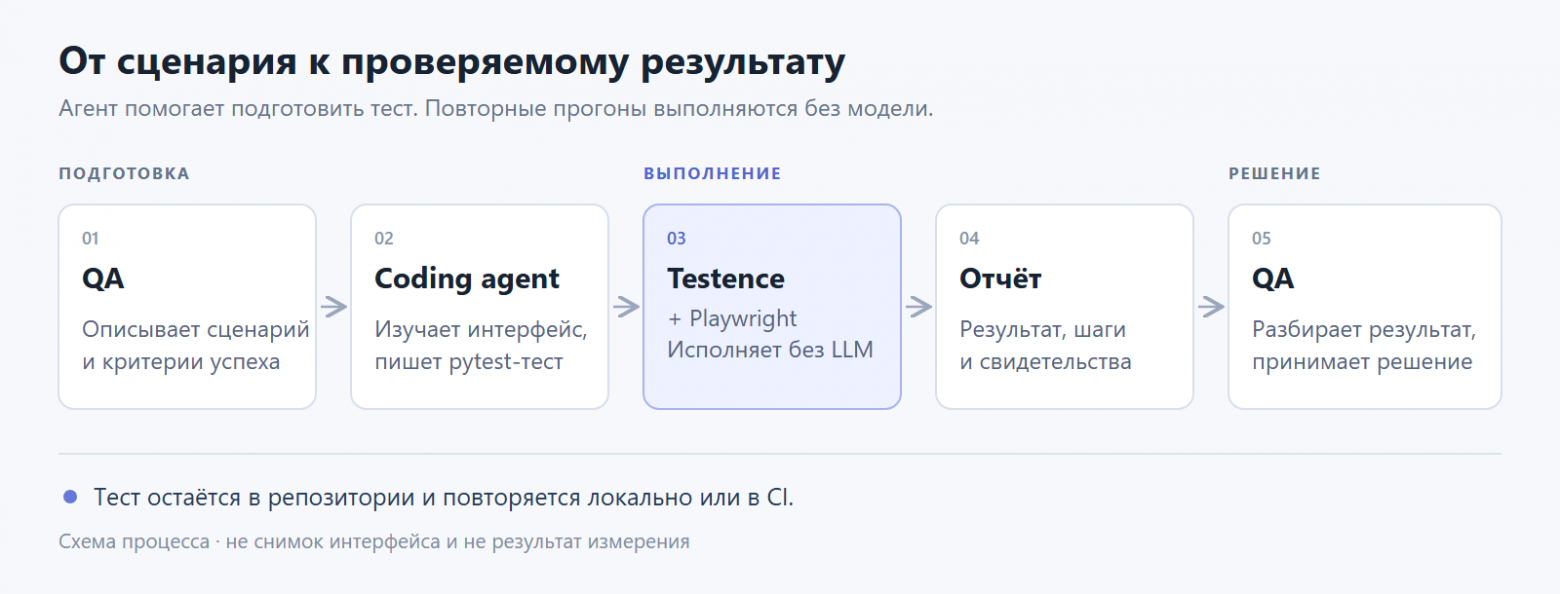
Поэтому агент нужен на этапах, где приходится исследовать, выбирать и разбираться. При каждом запуске заново решать, куда нажать и чего дождаться, уже незачем: эти решения должны остаться в коде теста.
В Testence это разделено на две роли:
Агент исследует приложение, проводит тест-дизайн, пишет и отлаживает тесты. При падении помогает разобраться в причинах и предложить исправление.
Детерминированный runner выполняет готовые Python/pytest/Playwright-тесты и сохраняет результаты — локально или в CI, без вызовов LLM.
Агент проделал сложную работу один раз — дальше её результат можно воспроизводить обычным кодом. Когда приложение меняется или тест падает, агент снова подключается к исследованию. Но каждый штатный прогон не требует заново тратить время и токены на уже разобранный сценарий.
После работы агента в проекте должны остаться согласованный план проверок и готовые тесты: с локаторами, условиями ожидания и проверками результата. Следующий прогон запускает этот код — без нового объяснения задачи, исследования интерфейса и обращений к модели.
А после прогона нужен отчёт, который объясняет результат. Какие ожидания подтвердились? Где получили расхождение и чем оно подтверждается: данными, скриншотами, независимым чтением через API? Тестировщик должен видеть, что произошло, без необходимости заново проходить весь сценарий руками.
Как установить Testence и запустить первый тест
Для первого знакомства не нужен рабочий проект вашей компании. У Testence есть стартовые примеры, в том числе специально сломанный сценарий сохранения.
Понадобятся Python 3.10+ и Chromium. В отдельной пустой директории выполните:
python -m pip install testence
python -m playwright install chromium
testence doctor
testence init .
init создаёт конфигурацию и изолированные демонстрационные файлы. Затем запускаем тот самый сценарий с ложным успешным сохранением:
testence run --project . --run-id r-demo-failure -- .testence/examples/test_demo_failure.py -q
testence report runs/r-demo-failure
Первый запуск здесь намеренно завершается ошибкой. Это не ошибка установки: пример специально показывает, как интерфейсная проверка может пропустить дефект сохранения. Вторая команда создаст отдельный HTML-отчёт; откройте файл отчёта, путь к которому напечатает команда.
Если хочется сначала увидеть полностью успешный пример, после init можно выполнить:
testence plan prepare .testence/specs/onboarding.md --project .
testence run --project . --run-id r-onboarding
testence inspect runs/r-onboarding
Здесь не требуется ни ключ к LLM, ни подписка на облачный сервис. Это обычный запуск тестов.
Как написать UI-автотест с ИИ-агентом в Testence
Для собственного приложения создайте в проекте конфигурацию testence.json. Для локального веб-приложения без авторизации минимальный пример такой:
{  "base_url": "http://localhost:3000",  "auth": "none"
}
Для приложений с логином потребуется настроить подходящий способ авторизации. Секреты лучше хранить в переменных окружения, а не прямо в тестах или промпте. Подробности есть в документации по авторизации.
Для знакомства с реальной страницей можно выполнить:
testence doctor --target
testence explore / --project . --json
explore помогает увидеть доступные элементы интерфейса и варианты обращения к ним из теста. Эти данные полезны и человеку, и агенту.
А чтобы не объяснять агенту устройство Testence с нуля, можно установить готовые Agent Skills. Например, для Codex:
testence agent install --project . --client codexДля Claude Code используется --client claude, для OpenCode — --client opencode. Skills описывают четыре задачи: планирование проверок, написание тестов, разбор ошибок и предложение исправлений.
Теперь можно дать агенту примерно такое задание:
Используй Testence, чтобы проверить создание записи в моём приложении. Вот что я знаю о фиче: […]
Исследуй интерфейс, предложи сценарии и объясни, чем будем подтверждать результат. После согласования плана напиши и отладь pytest-тесты: учти авторизацию, тестовые данные и динамику интерфейса. Если доступен независимый API — проверь, что запись действительно сохранилась.
При падениях разбирайся в причинах: не меняй приложение, не ослабляй проверки и не прячь нестабильность за перезапусками.
В конце покажи отчёт: что проверено, что прошло, где обнаружены проблемы и какие доказательства есть. Явно отметь, что подтвердить не удалось. Приложи тесты, артефакты и команду запуска без агента — локально и в CI.
Авторизация, нестандартные компоненты, подготовка данных и особенности самого приложения могут потребовать донастройки. Но любой агент поможет пройти этот путь безболезненно.
Как проверить, что автотест действительно ловит баги
Я бы проверял результат по четырём вопросам.
1. Тест действительно проверяет требование? Если мы хотим убедиться, что запись сохранилась, одного текста «Готово» недостаточно.
2. Он падает на настоящей поломке? Самый полезный эксперимент — проверить тест на исправном приложении, а затем на контролируемом дефекте. Зелёный результат без этой второй половины мало о чём говорит.
3. Его можно повторить? Тест не должен зависеть от вчерашнего чата с моделью, случайного состояния браузера или записи, которую уже удалил другой тест.
4. Понятно, почему он упал? Если падение заставляет каждый раз вручную восстанавливать весь путь пользователя, автоматизация быстро перестаёт экономить время.
Для последнего пункта Testence собирает структурированные свидетельства: действия, состояние доступных элементов страницы, сетевые и консольные сигналы, результаты проверок. Их можно изучить через testence inspect и HTML-отчёт. Скриншоты включаются политикой захвата; чувствительные данные требуют отдельного внимания перед передачей отчётов за пределы команды.
Отдельно мне не нравится идея, когда агент молча чинит тест до зелёного состояния. Если селектор устарел, исправление может быть полезным. Если перестало работать что-то еще, такое «лечение» легко скроет баг. Поэтому Testence формирует предложение изменения, которое можно проверить, а не незаметно подменяет проверку во время запуска.
А как это впишется в текущую работу QA?
Переезжать на отдельную платформу и выбрасывать привычный стек не нужно. В основе остаются pytest и Playwright. Тесты живут в своем автотест-репозитории, запускаются в CI и могут использовать привычные инструменты отчётности.
У Testence уже есть экспорт в Allure, JUnit XML и CTRF, а для Allure TestOps предусмотрены способы передачи результатов как после прогона, так и по мере завершения тестов. Например:
testence export runs/r-demo-failure --to allureС чего начать автоматизацию тестирования с Testence
Не пытайтесь автоматизировать весь чек-лист в первый же день. Возьмите одну повторяющуюся и дорогую ошибкой проверку: создание заказа, сохранение настроек, изменение прав или другой сценарий, который каждый релиз приходится проходить руками.
Сначала сформулируйте, что должно быть правдой после действия. Затем попробуйте получить тест с помощью агента. Посмотрите, проходит ли он на исправной версии и замечает ли намеренно внесённый дефект. И только после этого считайте задачу автоматизированной.
Сейчас Testence — публичная alpha, поэтому мне особенно полезна обратная связь: где агент справился сам, где запутался, что оказалось неудобно, каких свидетельств не хватило, чего хотелось бы сразу "из коробки".
Testence на GitHub — исходники, установка и демо-сценарий.
Если решите попробовать, расскажите о своём первом сценарии в GitHub Issues. Даже неудачный опыт полезен: именно по реальным случаям лучше всего видно, какую рутину стоит автоматизировать следующей.
Мне хочется, чтобы после очередного ручного регресса у тестировщика оставалась не только галочка в чек-листе, но и готовая проверка, которую больше не нужно повторять руками.
Вопросы о Testence: запуск без LLM, API и исправление тестов
Это замена Playwright и pytest?
Готовые тесты по-прежнему используют Python, pytest и Playwright. Testence связывает работу вокруг них: что проверяем, как агент пишет тест, чем подтверждаем результат и что сохраняем после прогона.
За каждый запуск придётся платить модели?
Готовые тесты запускаются без обращений к LLM. Модель нужна, когда агент исследует приложение, пишет тесты или помогает разобраться в падении.
А если у приложения нет доступного API?
Проверяем то, что можем подтвердить через интерфейс: например, сохранилась ли запись после обновления страницы. Но честно отмечаем границы такой проверки. Уведомление «Сохранено» само по себе ещё не доказывает, что данные действительно сохранились.
Агент сам починит упавший тест?
Он может исследовать падение и предложить исправление. Но сначала нужно понять, что сломалось: тест, приложение или окружение. Переписать ожидание под текущий результат — простой способ получить зелёный тест и потерять полезную проверку.
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.