Нейросеть пишет спецификацию интеграции и молча решает за аналитика
Всем привет, меня зовут Сергей Прощаев, я Tech Lead и руководитель направления Java | Kotlin разработки в FinTech & E‑commerce и преподаю на курсах разработки и архитектуры в ОТУС.
В этой статье расскажу про эксперимент, который я провёл с двумя нейросетями: дал им расплывчатое ТЗ на интеграцию интернет‑магазина со складом и оценивал не столько качество текста, сколько решения, которые модели приняли за аналитика.
Знакомая картина: аналитик получает от бизнеса два абзаца, вставляет их в чат и через пару минут получает документ на сорок килобайт.
Там цели, границы, модель статусов, JSON‑примеры, коды ошибок и приёмочные тесты.
Документ выглядит лучше многих спецификаций из реальных проектов. Поэтому его и отдают разработчикам почти без правок.
Спойлер: обе модели задают вопросы. Но самые дорогие решения в спецификации они принимают молча, и эти решения выглядят как готовые требования.
Почему этот вопрос сейчас у всех на столе
Проблема в том, что расплывчатое ТЗ не становится точным от того, что его переписали аккуратно. Неизвестное никуда не делось, его просто заполнили правдоподобными значениями.
Исследователи это уже измеряют. В майской работе «Ask Early, Ask Late, Ask Right» агентам давали намеренно неполные задачи и инструмент, чтобы переспросить пользователя. На 300 сессиях GPT-5.2 переспрашивал в 52% сессий, Claude Sonnet 4.5 в 23%, а Gemini 3 Flash не спросил ни разу из 100.
В бенчмарке ClarifyCodeBench (июль 2026) авторы пишут, что почти все модели задают меньше уточняющих вопросов, чем требует задача, и что режим рассуждений их к вопросам не подталкивает.
Мне стало интересно, как это выглядит не на коде, а на классической задаче системного аналитика: спецификации интеграции.
Эксперимент
Задача взята типовая, из тех, что разбирают на курсах по интеграциям:
магазин на своей платформе;
товары на складе логистического партнёра;
у партнёра своя WMS.
Заказы должны уходить на склад, статусы отгрузки и остатки возвращаться в магазин. Больше в условии нет ничего, и это намеренно.
Промптов два. Они отличаются только последним абзацем:
(text, промпт A)
Ты опытный системный аналитик.

Наш интернет-магазин работает на собственной платформе. Товары хранятся на складе
логистического партнёра, у него своя WMS. Нужно настроить интеграцию: заказы из
магазина должны уходить на склад, а статусы отгрузки и остатки возвращаться в магазин.

Подготовь спецификацию интеграции для разработчиков.
В промпте B последняя строка другая:
«Прежде чем писать спецификацию, перечисли вопросы, которые нужно прояснить с заказчиком и с партнёром. Затем подготовь спецификацию интеграции для разработчиков».
Модели: ChatGPT на бесплатном тарифе (модель по умолчанию, интерфейс не показывает её название) и Claude Opus 5.5 в claude.ai с уровнем усилий High.
Каждый промпт по три раза, каждый раз в новом чате без памяти аккаунта: у ChatGPT временный чат, у Claude режим инкогнито.
Всего 12 прогонов, 18 октября 2 026 года. ChatGPT отвечал за полторы‑две минуты, Claude за шесть‑семь.
До первого прогона я зафиксировал 14 вопросов, которые опытный аналитик задаст по такой интеграции.
Вот они:
что уже умеет WMS партнёра;
кто источник истины по остатку и резерву;
когда заказ уходит на склад;
объёмы и пики;
допустимая задержка;
что делать, если WMS недоступна;
дубли и идемпотентность;
порядок событий;
изменение и отмена после передачи;
нехватка и частичная сборка;
сверка;
изменение контракта;
безопасность и персональные данные;
мониторинг и владелец ошибок.
По каждому из 14 пунктов в каждом прогоне ставилась одна из трёх оценок:
«спросила» (вопрос или явная пометка «согласовать»),
«решила молча» (решение без пометки),
«пропустила».
У каждой оценки есть дословная цитата из ответа, и скрипт проверяет, что цитата действительно есть в файле.
Как устроен эксперимент, показано на схеме:
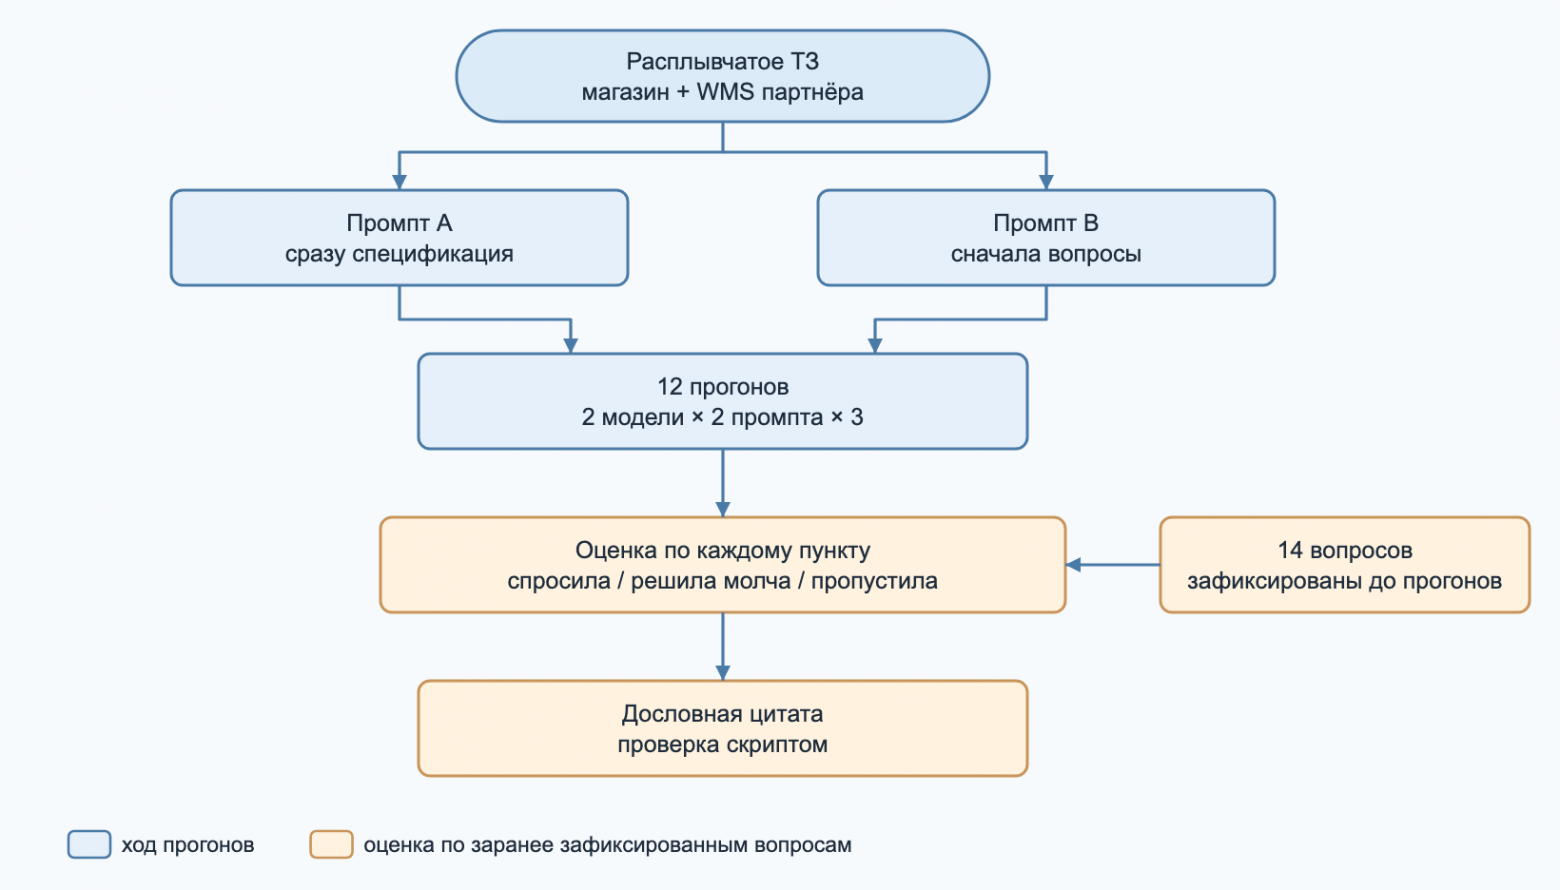
Главное на этой схеме: список вопросов появился раньше ответов. Иначе легко подогнать критерии под то, что модель случайно написала.
Что получилось
Сводка по 14 пунктам, в каждой клетке три прогона. Формат: спросила / решила молча / пропустила.
Пункт | ChatGPT A | ChatGPT B | Claude A | Claude B |
|---|---|---|---|---|
Когда заказ уходит на склад | 1 / 2 / 0 | 3 / 0 / 0 | 3 / 0 / 0 | 3 / 0 / 0 |
WMS недоступна | 1 / 2 / 0 | 3 / 0 / 0 | 0 / 3 / 0 | 2 / 1 / 0 |
Дубли, идемпотентность | 0 / 3 / 0 | 3 / 0 / 0 | 3 / 0 / 0 | 3 / 0 / 0 |
Порядок событий | 0 / 3 / 0 | 3 / 0 / 0 | 1 / 2 / 0 | 2 / 1 / 0 |
Изменение контракта | 1 / 1 / 1 | 3 / 0 / 0 | 0 / 1 / 2 | 1 / 0 / 2 |
Владелец ошибок | 0 / 3 / 0 | 3 / 0 / 0 | 3 / 0 / 0 | 3 / 0 / 0 |
Итого из 42 | 24 / 17 / 1 | 42 / 0 / 0 | 32 / 8 / 2 | 38 / 2 / 2 |
Вопросов в среднем на прогон | 8 | 66 | 17 | 37 |
В таблице только пункты, где модели разошлись.
Пять пунктов спросили все 12 прогонов:
интерфейс партнёра;
источник остатка;
объёмы;
задержку;
отмену заказа.
Полная таблица и все цитаты лежат в репозитории.
Вопросы считались по‑разному: у ChatGPT по строкам со знаком вопроса, у Claude по пунктам разделов вопросов. Поэтому последнюю строку стоит сравнивать внутри модели, между промптами A и B, а не между моделями.
И ещё одна оговорка. Таблица показывает одну, основную оценку по каждому пункту. Случай, когда модель спросила и тут же записала решение в тело документа, в ней считается как «спросила». Такие случаи я разбираю отдельно, на цитатах в наблюдениях 1 и 2.
Худшего не случилось. Логично было ждать, что модель на промпте A не спросит про интерфейс партнёра и сразу нарисует ему REST API. Ничего подобного: «что умеет WMS» спросили все двенадцать прогонов.
Зато расхождения собрались в узкой полосе из шести пунктов, и почти все они про надёжность обмена. Дальше разберу, что за этим стоит.
Наблюдение 1. Модель не молчит, она отвечает за вас
Заголовок этой статьи немного лукавит. Ни один прогон не обошёлся без вопросов. Даже на промпте A у ChatGPT в конце каждой спецификации был раздел «вопросы, требующие согласования» на 6–12 пунктов, у Claude на 15–19.
Подвох в другом.
Вопросы стоят в хвосте документа, а в теле те же темы уже закрыты решениями. ChatGPT в одном из прогонов пишет: «Предлагаемый график повторов: 5 секунд, 30 секунд, 2 минуты, 10 минут, 30 минут».
В другом: «Статус нельзя понижать из‑за поздно пришедшего события». Это разумные правила. Но разработчик читает раздел 9, а не раздел 15, и реализует ровно их.
Я бы сформулировал так: модель не скрывает неопределённость, она её переупаковывает. Вопрос превращается в значение по умолчанию, и значение выглядит как требование.
Наблюдение 2. Молча решается то, что зависит от партнёра
Интересно, какие именно пункты модели закрывают сами. Это не бизнес‑вопросы: про объёмы, задержку и отмену заказа спрашивали все.
Молча решаются инженерные: повторы при недоступности WMS, ключ дедупликации, порядок событий, кто разбирает сбой.
ChatGPT на промпте A ни разу из трёх не спросил про идемпотентность, порядок событий и владельца ошибок.
Claude на том же промпте по идемпотентности спросил во всех трёх прогонах, зато поведение при недоступности WMS решил сам все три раза: «1 мин → 5 мин → 15 мин → 1 ч → далее каждый час до 24 часов с момента первой попытки».
Модель считает это своей зоной: это же «надёжность», там есть best practice. Но ключа дедупликации на стороне магазина мало, если запрос к WMS оборвался и непонятно, создан ли заказ: нужна идемпотентность у партнёра или способ проверить результат.
Без версии состояния или другого согласованного механизма порядок событий по времени получения надёжно не восстановить. А «до 24 часов» не только инженерное решение: сколько заказ может пролежать неотправленным, прежде чем звонить клиенту, задают SLA бизнеса и порядок эскалации.
Наблюдение 3. Изменение контракта не видит никто
Самый слабый пункт у обеих моделей: что будет, когда партнёр поменяет API. В девяти прогонах трёх групп (ChatGPT A, Claude A и Claude B) вопрос об изменении контракта появился только в двух, в пяти тема пропущена совсем.
Claude здесь отвечает архитектурно: «Смена WMS или изменение её API затрагивает только адаптер». Это хороший принцип, но он не отвечает, кто предупредит об изменениях, за сколько дней и как долго живёт старая версия. Могу себе представить, как такая интеграция полгода работает без единого сбоя, а потом партнёр в пятницу вечером переименовывает поле статуса.
Наблюдение 4. Эндпоинты партнёра придуманы, но аккуратно
В 7 прогонах из 12 модели написали конкретные пути к API партнёра, например POST /integration/v1/orders. Каждый раз с оговоркой: «условный», «окончательный URL определяется согласованным интерфейсом WMS». Здесь к моделям претензий нет.
Претензия к процессу вокруг. Оговорка живёт в одном предложении, а JSON‑пример на полстраницы. Через месяц в задаче на разработку остаётся пример, оговорку никто не помнит.
Наблюдение 5. Просьба «сначала вопросы» работает, но рождает шум
Промпт B поднял долю «спросила» у ChatGPT с 24 до 42 из 42, у Claude с 32 до 38. Но вопросов на прогон у ChatGPT стало 66 вместо 8. Это уже не уточнения, а опросник, который партнёр не заполнит.
Похожее видно в исследовании, опубликованном на ESEM 2026. Авторы сравнивали пользовательские истории аналитиков и Claude Sonnet 4.6 с требованиями, восстановленными по артефактам трёх работающих промышленных систем.
Полнота у модели выше: recall 79,5–98,4% против 37,7–72,7%. Точность ниже: 46,4–78,8% против 93,6–100%, потому что модель добавляла правдоподобные требования, которых в системах нет. Это довод за связку аналитика и модели, а не за замену одного другим.
Мой вывод: просить вопросы нужно, но выбирать из них должен аналитик.
История из практики: модель, которая сама перечислила допущения
Фабрицио Ладзаретти в апреле 2 026 года описал, как генерировал спецификацию AsyncAPI по артефактам DDD‑воркшопа с помощью Claude Opus 4.7. Вместе со спецификацией модель перечислила решения, которые приняла в условиях неопределённости, и попросила подтвердить или переопределить каждое. Автор пишет, что именно на этот список разработчику и стоит смотреть.
Важная деталь: в системном промпте прямо стояло «делай разумные допущения там, где входные данные неясны, и объясняй ход рассуждений». То есть поведение не появилось само, его попросили.
Это ровно то, чего не хватало в моих прогонах на промпте A: допущения были, но рассыпаны по тексту, а не собраны в один список. И на вход модель получала уже структурированные артефакты воркшопа, а не два абзаца ТЗ.
Как я бы встроил модель в работу аналитика
Порядок, который я бы предложил после этого эксперимента, показан на схеме:
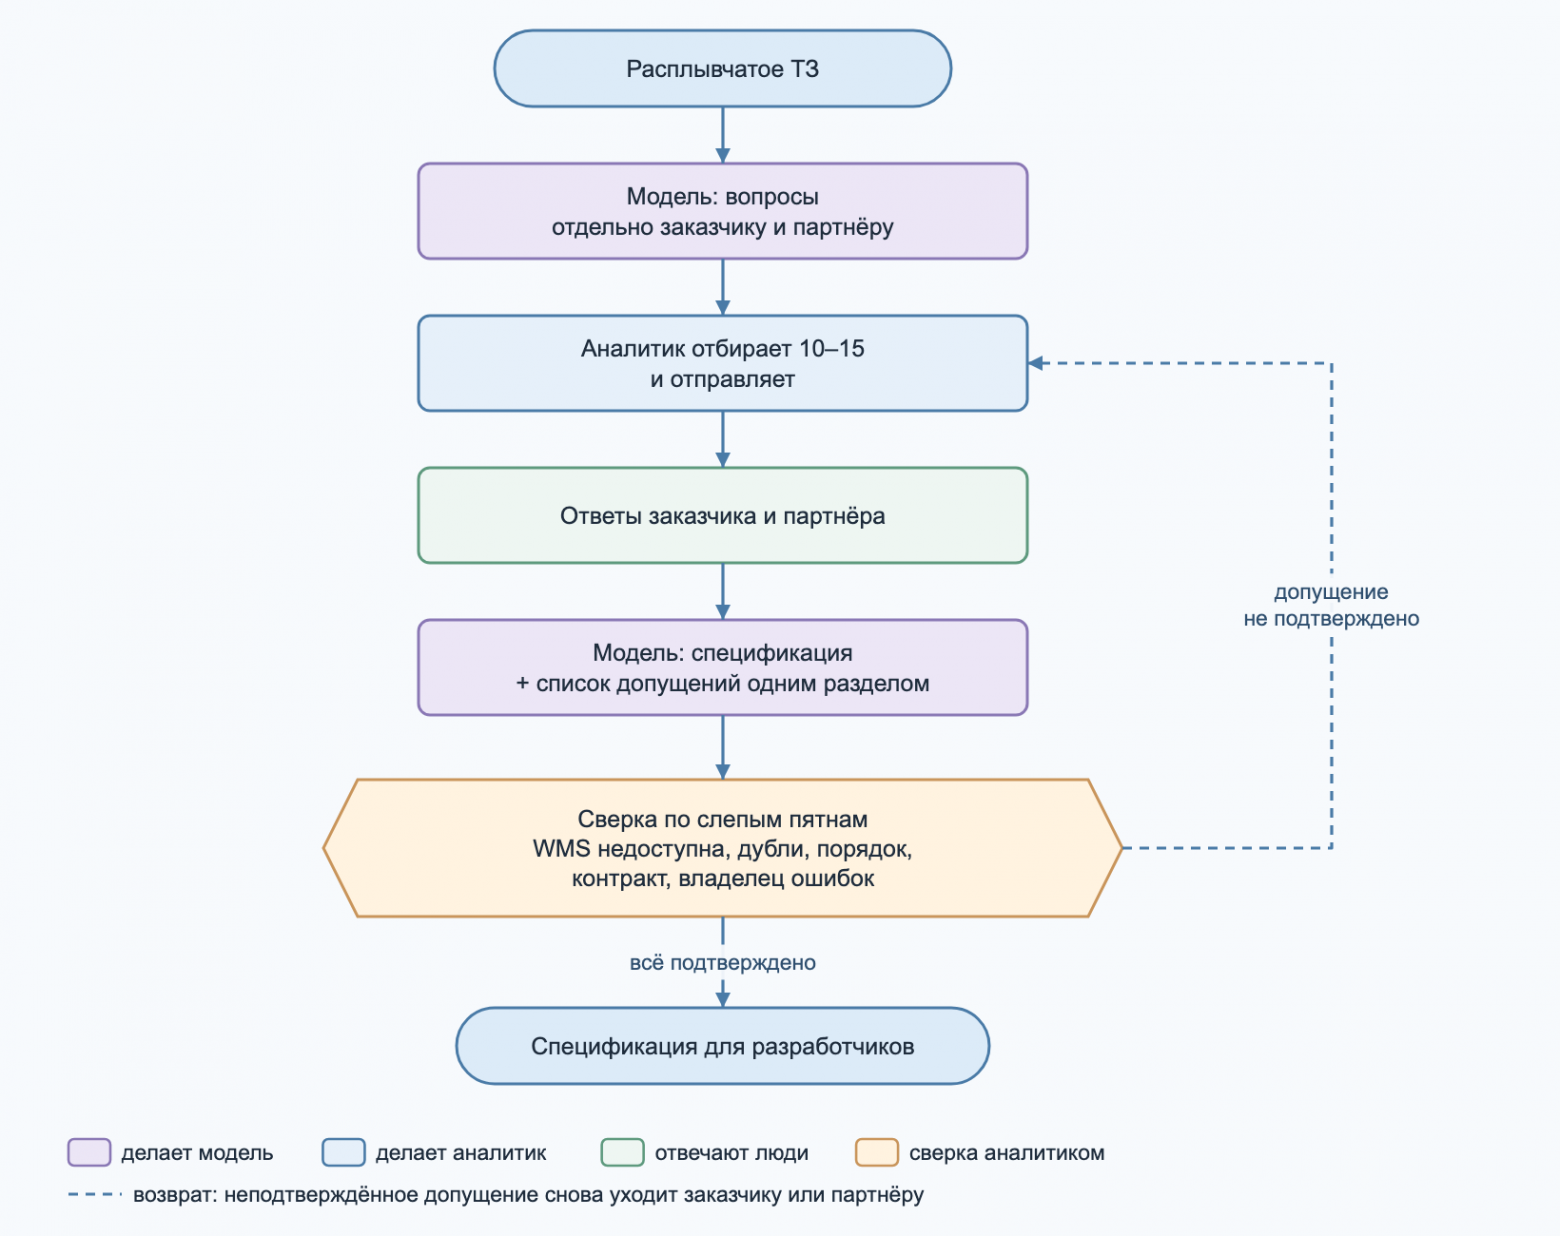
Главная мысль схемы: модель стоит на двух шагах из пяти, и ни один из них не последний.
На практике я бы держал пять правил:
просить вопросы до спецификации и сразу разделять их по адресату, заказчику и партнёру;
требовать в конце один раздел «Допущения», где каждое решение без источника помечено и имеет владельца;
отдельно проверять пять слепых пятен из таблицы выше: недоступность WMS, дубли, порядок событий, изменение контракта, владелец ошибок;
вычищать из спецификации придуманные пути API, пока не пришла документация партнёра;
отдельно проверять требования к передаче персональных данных и применимые нормы: в шести прогонах ChatGPT ни разу явно не назвал 152-ФЗ, хотя в заказе уходят адрес и телефон покупателя.
Ограничения
Выборка маленькая: одна задача, две модели, по три прогона. Оценки ставились по одной шкале без второго независимого оценщика, зато каждую можно перепроверить по цитате.
Часть «спросила» засчитана по косвенным формулировкам; при строгом подсчёте пунктов в категории «спросила» меньше: 22, 41, 28 и 34 вместо 24, 42, 32 и 38.
Модель бесплатного ChatGPT может смениться в любой день. Это не бенчмарк моделей, а проверка одного рабочего приёма.
Итог
Нейросеть пишет спецификацию интеграции за минуты, и пишет хорошо. Она даже задаёт вопросы.
Но самые дорогие решения (сколько ждать недоступный склад, как отличать дубль, что делать с перепутанными событиями, кто узнаёт о сбое, что будет при смене API) в моём эксперименте чаще всего оказывались не в разделе вопросов, а в теле документа, уже принятыми.
Работа аналитика от этого не исчезает, она смещается: от написания текста к поиску того, что в тексте решено без него.
Проверить это у себя можно за полчаса. Возьмите последнюю спецификацию, которую помогала писать модель, и пройдите по 14 вопросам из эксперимента. Где ответ в теле документа есть, а вопроса к заказчику или партнёру не было, там решение уже принято без вас.
Начать стоит с summary.md: там сводная таблица по всем 14 пунктам. Оценки каждого прогона с цитатами лежат в scores/, сырые ответы моделей в runs/, а ./run.sh одной командой проверяет, что каждая цитата есть в ответе дословно и что сводная таблица пересчитывается из оценок.
ИСТОЧНИКИ
Когда нейросеть за несколько минут превращает неполное ТЗ в подробную спецификацию, важно уметь отличать согласованные требования от её собственных допущений.
Разобраться в проектировании интеграций, научиться точнее формулировать требования и использовать ИИ без потери контроля над решениями помогут бесплатные открытые уроки:
26 октября в 20:00. «Интеграция приложений: пошаговая инструкция для системного аналитика». Записаться
17 ноября в 20:00. «User Story vs Use Case: что выбрать для описания требований». Записаться
23 ноября в 20:00. «Какие навыки системного аналитика не заменит нейросеть». Записаться
Больше вебинаров по системному анализу и другим ИТ‑направлениям — в дайджесте.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.