Токеномика для самых маленьких
Кажется, мы довольно быстро привыкли к тому, что с нейросетью можно разговаривать почти как с человеком. Попросить написать код, пересказать статью, разобраться в документах. Потом уточнить. Потом ещё раз уточнить, потому что она опять сделала что-то не то.
А где-то между «почти готово» и «ты зачем вообще это переписал?» заканчивается лимит. А иногда - ещё до первого ответа. Отправляешь запрос в Claude, он долго думает. Потом ещё думает. Ты уже начинаешь подозревать, что там решают что-то на уровне устройства Вселенной, и наконец получаешь уведомление: лимит закончился. Ответа пока нет. Зато размышление получилось основательное.
Особенно интересно это выглядит с ИИ-агентами: отправил короткую задачу, отвлёкся, вернулся - агент прочитал половину проекта, запустил тесты, починил что-то по соседству и написал подробный отчёт о своих приключениях. Всё это, конечно, за ваши токены - этот господин уплатит за всё.
Немного похвалюсь: у меня самого с лимитами достаточно неплохо - не жалуюсь. При том что регулярно и очень активно пользуюсь ИИ для работы, и личных задач, и просто поржать. На нынешней подписке в $100 ещё ни разу не упирался в лимит, и кнопка сброса лимитов мне ни разу не понадобилась: просто не успевал их потратить. А некоторые друзья жалуются, что им не хватает даже подписки за $200.
Конечно, и $100 за подписку кажется многовато. Но тарифа за $20 для моего режима уже не всегда достаточно: кроме обычных диалогов есть фоновые процессы, периодические задачи и прочая работа, которая выполняется без моего постоянного участия. Разбаловал меня ИИ. Поэтому приходится раскошеливаться.
Конечно, задачи и объём работы у всех разные. Но мне стало интересно разобраться, сколько ресурсов уходит на полезный результат, а сколько - на то, как мы вообще организовали общение с моделью.
Поэтому сегодня немного токеномики (не про NFT щиткоины, извините за байт в заголовке). Разберёмся, что такое токены, почему короткое сообщение иногда обходится неожиданно дорого и на чём действительно имеет смысл экономить.
Что вообще такое токен?
Да вы и так уже хорошо представляете, но хочется проговорить основные понятия, чтобы не было недопониманий в дальнейшем.
Для нас сообщение - это текст. Для языковой модели его сначала превращают в последовательность числовых идентификаторов. Каждый такой идентификатор соответствует токену: это может быть слово, часть слова, пробел вместе со словом, знак препинания или фрагмент байтов.
Этим занимается отдельный компонент - токенизатор. На выходе модели происходит обратное преобразование: последовательность токенов снова становится понятным нам текстом. Это и есть входные (input) и выходные (output) токены соответственно.
Почему нельзя просто читать по буквам? Можно строить и такие системы. Но последовательности получаются длинными. Если же завести отдельный токен для каждого возможного слова, довольно быстро начнутся вопросы к размеру словаря, новым словам, опечаткам и всем языкам мира. Разбиение на части - компромисс между длинными последовательностями и огромным словарём.
При этом токенизатор не обязан соблюдать школьную морфологию. Он не обещал делить слова на корни и суффиксы. У него свои представления о прекрасном, основанные на алгоритме и данных, на которых строился словарь.
Например, в кодировках cl100k_base и o200k_base из библиотеки tiktoken получается так:
Текст | Разбиение | Токенов |
|---|---|---|
|
| 1 |
|
| 1 |
|
| 2 |
|
| 1 |
Одно и то же слово, но заглавные буквы поменяли количество токенов. А пробел вообще уехал внутрь токена.
Поэтому правила вроде «один токен - это четыре символа» можно использовать только для грубой прикидки на подходящих текстах. Посчитать точно помогает токенизатор конкретной модели.
А русский правда дороже
Разные языки действительно могут занимать разное количество токенов при передаче одного смысла. Это исследовали, например, авторы работы Language Model Tokenizers Introduce Unfairness Between Languages.
Помимо того, что русский язык великий и могучий, за что тоже приходится платить токенами, есть и более техническая причина.
При обучении токенизатора на основе BPE часто встречающиеся фрагменты текста объединяются в токены. Если английского в обучающих текстах заметно больше, его слова и части слов получают больше готовых «кирпичиков» в словаре. Русские слова при этом могут разбиваться на более мелкие кусочки. А разнообразие окончаний и словоформ добавляет вариантов, которые тоже нужно уместить в словарь. Поэтому один и тот же смысл на русском нередко занимает больше токенов.
Но универсальный курс «одно русское слово равно трём токенам» устанавливать рано. Вот две фразы:
Write a Python function that returns the sum of two numbers.
Напиши функцию на Python, которая возвращает сумму двух чисел.
И результат подсчёта через tiktoken 0.14.0:
Кодировка | Английский | Русский | Отношение RU / EN |
|---|---|---|---|
| 12 | 23 | 1,92 |
| 12 | 14 | 1,17 |
Текст не изменился, поменялся токенизатор - и разница сократилась с почти двукратной до примерно 17%. Это подсчёт двух конкретных строк, без служебных сообщений приложения. Если вы свободно формулируете задачу на английском, можно проверить такой вариант. Но если ради экономии вам приходится дольше переводить запрос и вы теряете важные оттенки смысла, стоит посчитать ещё и стоимость собственного времени. Я, кстати, часто общаюсь с LLM через переводчик, если собственного английского не хватает. И токены пытаюсь сэкономить, и язык подтягиваю.
Куда уходят токены между сообщением и ответом
Когда вы пишете «а теперь добавь тесты», модель обычно получает гораздо больше этих четырёх слов. Во входе могут оказаться системные инструкции, правила проекта, предыдущие сообщения и ответы, содержимое файлов, результаты поиска, описания инструментов. Приложение собирает из этого контекст, с которым модель будет работать на очередном шаге.
Контекстное окно - это ограничение на объём информации, доступной модели в одном вызове. А расход за всю задачу складывается из множества вызовов. Поэтому агент вполне может потратить миллион токенов, ни разу не имея миллион токенов в контексте одновременно.
Модель также может расходовать токены на внутреннее рассуждение, которое не целиком показывается пользователю. Например, у Claude thinking-токены учитываются как выходные - это описано в документации контекстного окна. Короткий видимый ответ ещё не означает, что вся работа была короткой.
При оплате через API у входных, выходных и кэшированных токенов могут быть разные ставки. Выход у многих моделей дороже обычного входа. Поэтому убрать тысячу токенов из промпта и сократить ответ на тысячу токенов - не обязательно одинаковая экономия в деньгах.
С агентами добавляется ещё один слой. Попросить прочитать файл - один шаг. Получить его содержимое и решить, что делать дальше, - следующий. Потом поискать соседний файл, посмотреть документацию, запустить команду, изучить ошибку. Между этими действиями модель вызывается снова и снова. И вот уже задача «исправь пару строк» превращается в маленькую экспедицию.
Почему длинные диалоги обходятся дорого
В обычной схеме работы с LLM следующий вызов получает предыдущую переписку, чтобы модель понимала, что происходило раньше. Приложение может обрезать историю, делать выжимки или выбирать только её часть, но сама история от этого бесплатной памятью не становится.
Давайте посчитаем на условном примере. Каждый ваш запрос занимает 1000 токенов, каждый ответ - ещё 1000. Вся переписка сохраняется, служебные инструкции и инструменты пока уберём из расчёта.
Номер обращения | Вход в этом вызове | Всего токенов за все обращения |
|---|---|---|
1 | 1 000 | 2 000 |
5 | 9 000 | 30 000 |
10 | 19 000 | 110 000 |
20 | 39 000 | 420 000 |
На двадцатом обращении вы добавляете очередную тысячу токенов, а во входе уже 39 тысяч. При наших условиях суммарный расход за n обращений составляет 1000 × n × (n + 1). Это арифметика повторной передачи истории, без учёта кэширования и её сокращения. Переводить эту таблицу в деньги напрямую нельзя.
Тут приходит кэш
У провайдеров есть prompt caching: повторяющийся начальный фрагмент запроса может использовать уже подготовленное внутреннее состояние модели. В подходящем случае это уменьшает вычисления и стоимость обработки входа. Например, Anthropic отдельно тарифицирует создание кэша и его чтение. Ставки, срок хранения и условия попадания зависят от модели и настройки. Главное здесь - повторяющаяся часть контекста может стоить дешевле обычного входа.
Поэтому большой контекст не обязательно целиком пересчитывается по полной цене на каждом шаге. Но кэш не делает его полезнее и не увеличивает контекстное окно. Он также не гарантирует, что конкретное приложение удачно им пользуется.
Для разработчика API-приложения отсюда следует практический вывод: стабильные инструкции и общие материалы удобно держать в начале, меняющуюся часть - после них. Кэширование префикса требует совпадения предшествующего содержимого.
Подписка и API: сравнение цен
А для пользователя чата полезно просто помнить, что счётчик токенов, денежная стоимость и лимиты подписки - три разных показателя. Правила конкретной подписки нужно смотреть отдельно.
Несколько месяцев назад я увидел такую таблицу со сравнением цены подписки и стоимости сопоставимого объёма работы через API. Цифры внушительные: тысячи долларов токенами за пару сотен.
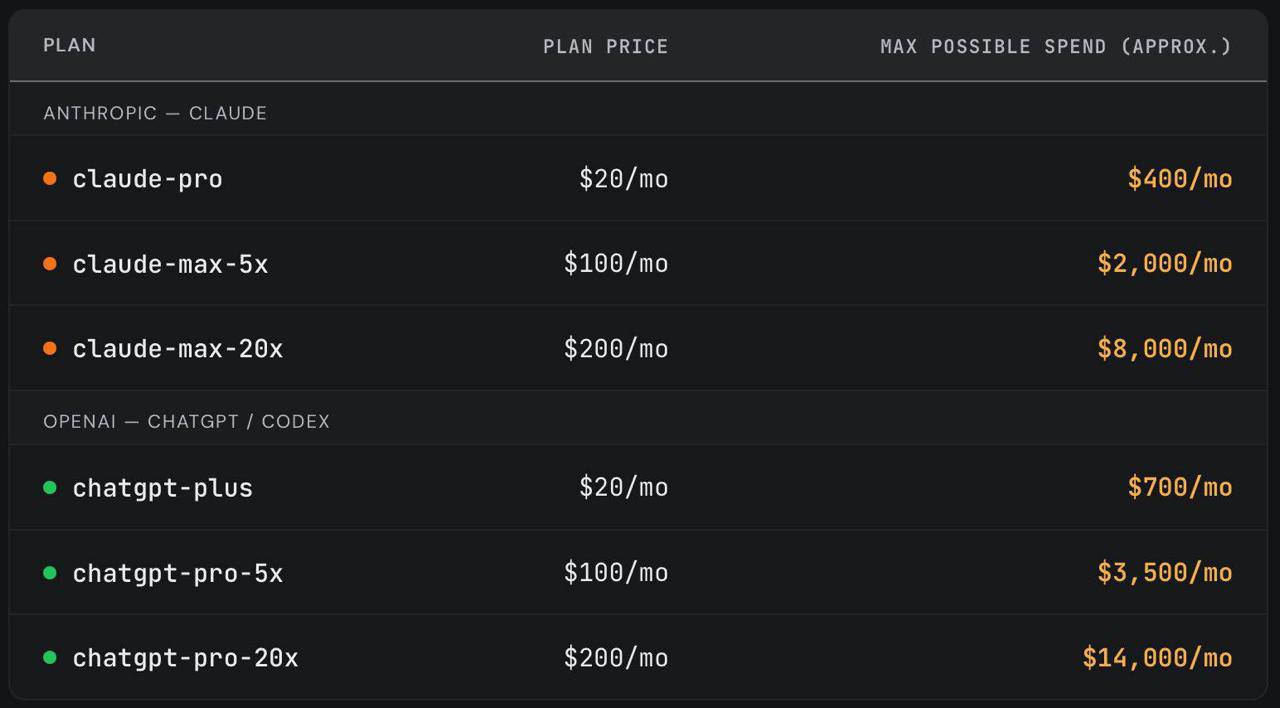
Как именно они тогда замеряли расход, я, честно, не знаю. Зато в более свежем исследовании SemiAnalysis от 5 октября 2026 года методика уже описана: авторы измеряли, как разные типы токенов расходуют лимит подписки, а затем пересчитывали доступный объём в API-цены для выбранной модели и нагрузки. Получилось примерно так:
Подписка | Модель в расчёте | Цена в месяц | Оценка объёма за месяц в API-ценах | Отношение к цене подписки |
|---|---|---|---|---|
Claude Pro | Opus 5.5 | $20 | ≈ $1 178 | ≈ 59 раз |
Claude Max 5x | Opus 5.5 | $100 | ≈ $5 725 | ≈ 57 раз |
Claude Max 20x | Opus 5.5 | $200 | ≈ $11 726 | ≈ 59 раз |
ChatGPT Plus | GPT-6.1 Sol | $20 | ≈ $211 | ≈ 11 раз |
ChatGPT Pro | GPT-6.1 Sol | $100 | ≈ $1 055 | ≈ 11 раз |
ChatGPT Pro | GPT-6.1 Sol | $200 | ≈ $2 084 | ≈ 10 раз |
Оценки SemiAnalysis на 5 октября 2026 года при полном использовании лимитов и заданном составе агентной нагрузки. Это не гарантированный баланс подписки. Отношения округлены.
Здесь есть существенная деталь: около 96,6% токенов в расчёте приходится на чтение кэша. Если у вас другое соотношение входа, выхода и кэширования, получится другая сумма. Да и модели в двух половинах таблицы разные: качество результата и количество попыток она не сравнивает. Поэтому выбирать победителя только по последней колонке я бы не стал.
Сами цены тоже проверил 25 октября 2026 года. У Claude при помесячной оплате это по-прежнему $20 за Pro, $100 за Max 5x и $200 за Max 20x. У ChatGPT - $20 за Plus и варианты Pro за $100, $200 и $500. Последнего в сравнении выше нет. Итоговая цена покупки может зависеть от региона, налогов и способа оформления.
Ещё одна отдельная история: в Claude Max теперь входят ежемесячные API-кредиты на $100 или $200 соответственно. Их нужно активировать, связав подписку с организацией в Console; новым подписчикам это доступно через семь дней. Эти кредиты не увеличивают лимиты чата и не оплачивают дополнительное использование Claude Code, а остаток не переносится на следующий расчётный период. С тысячами долларов из таблицы их смешивать не нужно.
Подписка действительно может оказаться выгодной при активном использовании. Но если за месяц вам понадобилась пара коротких запросов, потенциальные тысячи долларов так и останутся потенциальными. Для своих задач сравнивать варианты лучше по фактическому расходу и полученному результату.
Большое контекстное окно ещё не решает всё
Кажется, решение очевидное: давайте дадим модели огромное окно и загрузим туда вообще всё. Переписку за год, кодовую базу, документацию, инструкцию к аэрогрилю. Но техническая возможность поместить информацию в контекст не означает, что модель одинаково хорошо воспользуется каждой его частью.
В исследовании Context Rot команда Chroma проверила 18 моделей и обнаружила, что с ростом входного контекста надёжность выполнения задач может ухудшаться. Причём результат зависит от модели, задачи и устройства самого текста. Размер окна из рекламной таблицы этого не показывает.
Поэтому я бы не ориентировался на магическую границу вроде «до 100 тысяч токенов всё хорошо, потом всё плохо». Иногда полезен большой объём исходных данных. Иногда десять страниц посторонних инструкций только мешают найти нужное. Хороший вопрос перед добавлением очередного файла: какая информация из него нужна для текущего решения?
На чём я бы экономил в первую очередь
Можно начать с удаления каждого «пожалуйста». Но если рядом лежит лог на двадцать тысяч строк, экономия получится довольно своеобразная. Мне кажется разумным сначала посмотреть на крупные источники расхода: ненужные документы, накопленную историю, повторные исследования и исправления неудачных ответов. Уже потом заниматься отдельными словами.
Как сформулировать понятную задачу
Здесь хочу сослаться на работу моего коллеги из Яндекса - Юрия Зеленкова, доктора технических наук и компьютерного лингвиста. На основе его исследования я составил публичную версию руководства «Две грамматики за один вечер» о промптах и скиллах. Одна из полезных идей оттуда: запросу нужен минимально достаточный контракт. Что должно получиться, какие условия действительно важны и как проверить результат. Например:
Сделай сервис для заказов.
Что именно? Класс в существующем приложении? Отдельный микросервис? HTTP API? Мы с вами можем представлять разные вещи. Модель тоже что-нибудь представит и начнёт делать. А можно так:
В существующем Django-приложении добавь метод
OrderService.cancel_order(order_id). Отменять можно только заказы в статусе NEW. Для остальных верни существующую доменную ошибку. Ориентируйся на соседние методы и добавь тесты для обоих случаев.
Запрос стал длиннее. Зато из него исчезло несколько развилок, по которым агент мог уйти совсем в другую сторону.
В Grammar.md разбираются ещё две похожие ловушки. Первая - скрытое допущение: вопрос «почему мой код медленный?» уже предполагает, что он действительно медленный. Сначала полезно попросить проверить саму проблему. Вторая - подразумеваемые требования: под «production-ready» каждый понимает свой набор тестов, логирования, метрик и ещё десятка прекрасных вещей. Чем раньше существенные условия становятся явными, тем меньше поводов возвращаться с сообщением «я вообще-то имел в виду другое». При этом не нужно превращать любой вопрос в должностную инструкцию на три страницы. Для перевода одной фразы достаточно попросить перевести одну фразу.
Когда ничего не работает
Отдельный жанр общения с нейросетями начинается после нескольких неудачных попыток:
Ты дебил? Ничего не работает, всё переделывай, идиот.
Или знаменитое:
Make no mistakes.
Раздражение вполне понятно. Особенно если до этого модель уже трижды сообщила, что всё исправлено. Но что из нового сообщения она узнает о самой проблеме? Оскорбления сообщают, что пользователь зол. Они занимают токены и остаются в истории, но не объясняют, какой тест упал, где ошибка и что должно было произойти. Если эта ветка диалога продолжится, эмоциональную часть можно будет передавать модели ещё не раз.
И тут, помимо того, что вы повышаете свои шансы быть съеденным первым при восстании машин, вы ещё и не объясняете агенту, что именно нужно исправить.
«Ничего не работает» тоже довольно трудно превратить в конкретное действие. Не запускается приложение? Падает один запрос? Кнопка не того цвета? А «всё переделывай» вдобавок расширяет область задачи. Вместо проверки одного проблемного места агент может начать заново исследовать проект, менять соседние модули и, не дай бог, переписывать всё с нуля на Rust.
С пресловутым «make no mistakes» похожая история. Корректный результат и так входит в задачу. Но фраза не объясняет, что именно считать ошибкой и как её обнаружить. В зависимости от модели и окружения она может вылиться в дополнительные проверки, а насколько они окажутся полезны - отдельный вопрос.
Гораздо больше информации содержит такое сообщение:
При отмене заказа в статусе PAID метод cancel_order возвращает успех, хотя должен выбрасывать существующую доменную ошибку. Проверь условие отмены и добавь тест на этот случай.
Теперь есть конкретное место, наблюдаемое поведение, ожидаемый результат и способ проверки. Агенту проще понять, откуда начинать и когда можно остановиться. Нам важно передать суть, а не обмениваться состояниями, как говорил... неважно кто.
Как выбрать формат ответа
Если вам нужна команда для терминала, можно попросить команду. Если список трёх проблем - три проблемы с объяснениями. Если разбор устройства event loop - объяснение, примеры и подробности будут вполне уместны. Модель может написать длинное вступление, предложить пять альтернатив и закончить приглашением продолжить. Иногда это полезно. Иногда вам нужен был только SQL-запрос.
Формат стоит задавать под следующего потребителя. Для программы удобна схема. Для человека - короткий список или связный текст. И JSON не становится короче просто потому, что выглядит технически серьёзнее. Вот ещё один подсчёт тех же кодировок:
Представление |
|
|
|---|---|---|
| 14 | 9 |
| 19 | 15 |
В JSON появились имена полей и синтаксис. Для машинной обработки это может быть отличным обменом. Для ответа человеку схема здесь просто добавляет токены.
И ещё: требование «отвечай кратко» лучше понимать как просьбу убрать лишнее. Если вместе со вступлением исчезли условия применимости ответа, мы сэкономили на довольно важном месте.
Тут очень хочется ещё рассказать про новые модели System One для быстрых решений и извлечения данных в заданном формате, но, кажется, мы и так уже сильно выходим за пределы заявленной темы. Да и я писал о них в своём канале здесь. Там же и ссылки на хорошие статьи и видео на эту тему.
Не смешивать всё в одном чате
Диалог, в котором сначала выбирали аэрогриль, потом обсуждали переезд, а потом начали писать Python-сервис, постепенно превращается в содержимое ящика с проводами. Всё вроде когда-то было нужно, но попробуй теперь найти подходящее.
Для самостоятельной новой задачи обычно удобнее отдельный чат. А если продолжается большая работа, стоит передать её состояние: цель, уже принятые решения, важные ограничения, нужные файлы и то, что осталось сделать. «Продолжи» без этой информации заставит модель восстанавливать картину. Хорошая выжимка помогает начать с нужного места. Но и она может потерять деталь, поэтому исходники и существенные решения лучше сохранять в доступном виде.
Не нужно при этом открывать новый чат после каждой реплики. Если вы всё ещё разбираете одну проблему и предыдущий результат нужен для следующего шага, этот контекст выполняет полезную работу.
Как вовремя исправить направление
Если модель неверно поняла исходное сообщение, а интерфейс позволяет его отредактировать или вернуться к предыдущему состоянию, этим стоит пользоваться. Так ошибочная ветка не будет участвовать в дальнейшей работе. При работе с кодом важно различать историю разговора и состояние файлов. Удалённый из чата ответ не обязательно отменяет изменения на диске. Нужно понимать, что именно откатывает ваш инструмент. Уже потраченные токены никто не вернёт. Польза отката - в следующих шагах: агент продолжит от подходящего состояния и не будет опираться на отброшенное решение.
В Claude Code есть и отдельная команда /btw для побочных вопросов. Она использует текущий контекст, но не добавляет вопрос и ответ в основную историю. Запрос всё равно требует работы модели; полезно здесь именно то, что побочная тема не разрастается в основном диалоге.
Отправлять нужную информацию
Если ошибка находится в нескольких строках лога, полезно начать с них и достаточного окружения. Если нужна проверка одного пункта договора - найти этот пункт и связанные условия. Если задача зависит от всего документа, придётся дать весь документ или организовать поиск по нему. Иначе легко получить другую крайность: удалить столько контекста, что модель начнёт запрашивать его по кусочкам или просто додумает отсутствующее.
С файлами имеет значение и способ чтения. Например, при штатной обработке PDF Claude получает текст и изображения страниц. Если нужны только текстовые положения, извлечение текста может убрать ненужную визуальную часть. Но если задача про графики, расположение блоков или содержимое схем, она как раз нужна. Поэтому «переведи всё в Markdown и сэкономишь половину» - слишком смелый рецепт. Нужно понимать, что приложение извлекает из файла и какая часть этого нужна вам.
Особенности работы с агентами
С обычным чатом мы в основном управляем тем, что отправляем сами. Агент ещё и самостоятельно добывает информацию. Причём иногда с таким энтузиазмом, что невольно хочется спросить: а мы точно всё это заказывали? И многое здесь зависит от того, что мы ему подключили и какие правила написали.
Постоянные инструкции и подробности по необходимости
В CLAUDE.md, AGENTS.md и похожие файлы удобно складывать правила проекта. Но если туда постепенно переехала вся внутренняя Википедия, агент будет получать её даже для небольшой задачи. Хорошая постоянная инструкция помогает найти нужное: команды проверки, важные особенности проекта, ссылки на локальные правила. Подробности миграций базы не обязательно нужны при изменении текста кнопки.
Для повторяемых процедур подходят скиллы. Например, в Claude Code заранее доступны их названия и описания, а основной текст загружается при использовании. Так большую инструкцию можно доставать по необходимости. Но один перенос текста в соседний файл ничего не гарантирует. Если основной файл автоматически импортирует его целиком, контекст останется большим. Важен момент фактической загрузки.
Сначала найти нужное
Для изменения одного метода обычно не требуется читать каждый файл репозитория. Карта проекта, поиск по символам, эталонная реализация и точный путь помогают быстрее сузить область работы.
То же относится к результатам инструментов. Для проверки количества ошибок иногда достаточно агрегата. Для расчёта суммы по таблице - вычисления в коде. Нет большой необходимости отправлять языковой модели десять тысяч строк, чтобы она сама их складывала. В статье Code execution with MCP Anthropic показывает похожую организацию работы: агент загружает нужные инструменты и обрабатывает данные кодом, прежде чем возвращать результат в свой контекст.
Отдельный источник расхода - описания самих инструментов. В некоторых реализациях они загружаются сразу, в других находятся по необходимости. Поэтому стоит проверять, что реально попало в контекст, а не считать любой подключённый MCP-сервер одинаково дорогим.
Субагенту тоже нужно платить
Субагент может прочитать длинную документацию, выполнить исследование и вернуть основной модели короткий результат. Это полезно: подробности остаются в отдельном контексте, а основной агент продолжает работу с выжимкой. Но из этого не следует, что суммарных токенов стало меньше. У субагента были собственные инструкции, чтения, вызовы и ответы. Всё это тоже нужно учитывать.
Anthropic в описании своей многоагентной исследовательской системы прямо пишет о повышенном расходе таких архитектур. За дополнительные возможности приходится платить. Для большой самостоятельной подзадачи это может быть оправдано. Создавать целый отдел агентов ради переименования переменной, пожалуй, всё-таки избыточно. Хотя организационная структура получится солидная.
План и проверки должны помогать задаче
Если изменение затрагивает несколько сервисов, предварительный план позволяет обнаружить неверное направление до реализации. А понятные критерии проверки помогают агенту заметить проблему до того, как вы начнёте разбираться с результатом.
Но для очевидной локальной правки отдельная архитектурная сессия может оказаться лишней. План тоже занимает время и токены. Я бы перед этим спросил себя: этот шаг поможет избежать существенной переделки или я добавил его просто потому, что так принято работать с агентами?
Немного измерений вместо обещаний
Давайте вернёмся к обычному промпту. Вот два варианта простой задачи. Первый:
Привет! Помоги мне, пожалуйста, написать функцию на Python, которая принимает два числа и возвращает их сумму. Нужен только код функции без пояснений. Заранее спасибо!
Второй:
Python: функция add(a, b) возвращает сумму двух чисел. Только код, без пояснений.
Вариант |
|
|
|---|---|---|
Первый запрос | 70 | 39 |
Второй запрос | 32 | 22 |
Входной текст сократился примерно на 54% и 44% соответственно. Это результат подсчёта этих строк. Чтобы посчитать стоимость всей задачи, нужно учесть ещё и ответ, служебные инструкции и другие данные, которые добавит приложение. В длинной агентной сессии разница в несколько десятков токенов может быть незаметна на фоне документов и результатов инструментов. А в приложении с большим количеством коротких обращений такие сокращения уже стоит измерить на реальной нагрузке.
Для воспроизведения достаточно установить tiktoken==0.14.0 и выполнить:
import tiktoken

texts = [
    "Привет! Помоги мне, пожалуйста, написать функцию на Python, "
    "которая принимает два числа и возвращает их сумму. "
    "Нужен только код функции без пояснений. Заранее спасибо!",
    "Python: функция add(a, b) возвращает сумму двух чисел. "
    "Только код, без пояснений.",
]

for name in ("cl100k_base", "o200k_base"):
    enc = tiktoken.get_encoding(name)
    print(name, [len(enc.encode(text)) for text in texts])
А чтобы проверить сохранение качества на содержательной задаче, одного токенизатора мало. Нужны одинаковые исходные данные, одна модель с одинаковыми настройками, заранее определённый критерий результата и несколько повторов. Тогда можно сравнить полный цикл: вход, выход, кэш, дополнительные вызовы, время и исправления человеком. Если в одном варианте мы попросили полный разбор, а в другом «только пять пунктов», более короткий ответ ожидаем. Но полноту работы ещё нужно сравнить.
Это же относится к красивым процентам из чужих рекомендаций. В приложении к Grammar.md есть исходные количественные оценки, однако публичная версия прямо обозначает их как авторские иллюстративные ориентиры без доступной методики и сырых данных. Я бы использовал их как идеи для проверки на своих задачах. И если несколько приёмов дали экономию по отдельности, складывать проценты тоже не стоит. Они могут сокращать одни и те же части работы.
Когда выгоднее потратить больше
Мы пока говорили в основном о сокращении расхода. Но иногда стоит сделать обратное. Дать дополнительный пример, если без него непонятна граница. Приложить связанный участок кода. Попросить объяснение, если результат нужно проверить. Выбрать более сильную модель для сложного решения.
У более дешёвой модели может быть ниже цена за токен, но больше неудачных попыток. А слишком короткий ответ может сэкономить генерацию и оставить вам час самостоятельного расследования. Поэтому я бы смотрел на стоимость выполненной задачи с учётом времени человека. Для себя - хотя бы приблизительно. Для рабочего инструмента - по возможности на наборе реальных примеров.
Самая дорогая часть процесса иногда находится по эту сторону экрана.
С чего начать
Для начала достаточно посмотреть, куда уходит основной объём. Если инструмент показывает вход, выход и кэширование - хорошо. Если нет, можно хотя бы оценить размер постоянных инструкций, загружаемых файлов и длину истории. Затем выбрать один крупный источник лишней работы. Убрать ненужный документ. Уточнить повторяющуюся неоднозначность. Перестать перечитывать весь проект. Настроить нужный формат ответа. И сравнить результат.
Если без длинного объяснения вы получаете правильный ответ, его можно убрать. Если без контекста начинаются ошибки, контекст нужен. Если план предотвращает несколько переделок, он себя оправдывает.
Мне кажется, это хорошо укладывается в то, о чём я обычно пишу в Econet. Цифровые ресурсы стали доступнее, но привычка добавлять всё «на всякий случай» никуда не делась. Теперь она добралась и до наших разговоров с нейросетями. За подписку всё-таки хочется получать полезный результат. А если часть оплаченной работы можно было вообще не делать, почему бы с этого и не начать?
Если вы уже измеряли расход токенов на своих задачах, буду рад примерам в комментариях. Особенно интересно, какие способы экономии у вас не сработали и почему. А больше обсуждений про ИИ, данные и цифровую экологию - в моём канале Econet.
Материалы по теме
Юрий Зеленков. «Две грамматики за один вечер». Автор исходной концепции и исследования - Юрий Зеленков; составление и редакция публичной версии - Нарек Меликсетян. Публичная версия опубликована с разрешения автора исследования.
Матвей Шульга. Видео о расходе токенов и лимитах Claude и Codex. Один из поводов подробнее разобраться с практическими приёмами работы с контекстом.
Simon Willison. Understanding GPT tokenizers. Наглядное введение в токенизацию; примеры относятся к указанному в статье токенизатору.
Anthropic. Effective context engineering for AI agents. Отбор контекста и организация длительной работы агентов.
Microsoft Research. LLMLingua. Исследование автоматического сжатия промптов и качества на выбранных задачах.
Спасибо, что дочитали статью. Для меня самого это в первую очередь попытка разобраться с происходящим и поделиться мыслями, чтобы в дискуссии найти новый взгляд, отточить собственные мысли и проверить их на прочность. Поэтому буду очень рад обратной связи в виде ваших комментариев и реакций.
А если хотите больше обсуждений, мемов и просто всякого разного интересного, что происходит в мире IT (и AI, конечно), добро пожаловать в мой скромный канал Econet.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.