Дедупликация фото без нейросетей. Часть 2: предобработка и поиск в PostgreSQL
Верлинский Максим
Бэкенд-разработчик в Домклик
В первой части я взял 20 фотографий, изменил каждую 26 способами и проверил, как на это реагирует перцептивный хеш. Пересказывать всё не буду, но пара выводов из той статьи пригодятся нам дальше. Во-первых, лучше всего использовать pHash на 64 бита. Версия на 16 бит даёт коллизии, а 256 бит не дают заметного преимущества по сравнению с 64. aHash же слишком часто выдаёт ложные срабатывания. Во-вторых, водяные знаки хешу безразличны: будь то логотип в углу или плитка из надписей по всему кадру — это всего 0—6 бит из 64. Зато любые правки геометрии сильно портят результат: если обрезать изображение на 20%, хеш не найдёт ничего, если добавить белую рамку — найдёт половину, а если отзеркалить — снова ничего. При пороге 12 это даёт recall 86% при precision 100%.
Далее я расскажу, как повысить recall с 86 до 95% и при этом уместить поиск в один SQL-запрос.
Срезаем однотонные поля перед хешированием
Белая рамка, добивка до квадрата, чёрные полосы по краям — всё это добавленные поля, которые хеш воспринимает как часть композиции и из-за этого ломается. Если убрать эти поля, кадр возвращается к исходной геометрии.
import numpy as np

def autocrop(im, tol=14, max_strip=0.35):
    """Срезаем однотонные поля по краям. Возвращает кадр без рамки."""

    g = np.asarray(im.convert("L"), dtype=np.int16)
    h, w = g.shape
    flat = lambda line: int(line.max()) - int(line.min()) <= tol

    top = 0
    while top < int(h * max_strip) and flat(g[top]):
        top += 1
    bottom = h
    while bottom > h - int(h * max_strip) and flat(g[bottom - 1]):
        bottom -= 1
    left = 0
    while left < int(w * max_strip) and flat(g[:, left]):
        left += 1
    right = w
    while right > w - int(w * max_strip) and flat(g[:, right - 1]):
        right -= 1

    if right - left < w * 0.3 or bottom - top < h * 0.3:
        return im          # это уже не поля, а половина фото
    return im.crop((left, top, right, bottom))
Про max_strip: не срезаем больше трети стороны. Без этого функция может «съесть» половину фотографии (реальный случай будет ниже, в разделе «Подводные камни»). Важно применять эту функцию к обеим сторонам сравнения: к тому, что кладём в базу, и к входящему изображению — иначе получится, что вы сравниваете обрезанный кадр с необрезанным, и станет только хуже.
Одна только эта функция повышает recall с 86 до 91%: «белая рамка» и «поля до квадрата» из 50 и 15% превращаются в 100%.
Кладём в базу два хеша: кадр и его зеркало
Зеркало хешем не лечится: отражённый кадр — это другая композиция, 32 бита из 64. Зато можно не лечить, а хранить оба варианта.
import imagehash
from PIL import ImageOps

def to_bigint(h):
    v = int(str(h), 16)                              # imagehash отдаёт hex
    return v - (1 << 64) if v >= (1 << 63) else v    # bigint знаковый, см. ниже

def hashes_for_storage(im):
    im = autocrop(im)
    return [to_bigint(imagehash.phash(im)),
            to_bigint(imagehash.phash(ImageOps.mirror(im)))]
Входящее фото прогоняем через autocrop и считаем один хеш. Если он совпадёт с любой из двух строк в базе — значит, это дубликат. Зеркалить пробу не нужно: если пришло отражённое фото, оно совпадёт с «зеркальной» записью оригинала.
Цена — вдвое больше строк в таблице. Что это значит для скорости — посчитаем ниже, когда дойдём до бенчмарка.
Что получилось
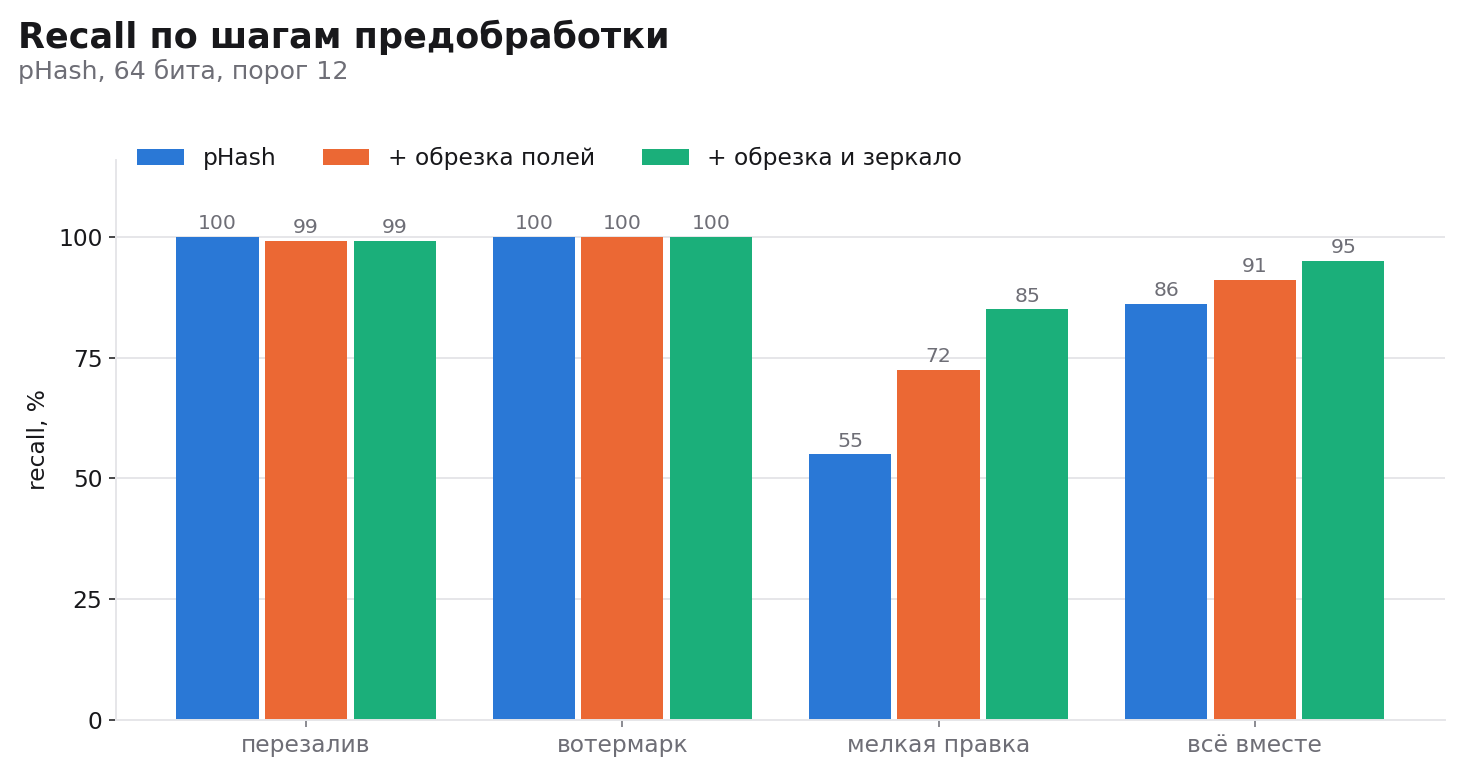
Шаг | Хешей на фото | Перезалив | Водяной знак | Мелкая правка | Всего |
|---|---|---|---|---|---|
pHash как есть | 1 | 100% | 100% | 55% | 86% |
+ обрезка полей | 1 | 99% | 100% | 72% | 91% |
+ зеркало в базе | 2 | 99% | 100% | 85% | 95% |
В итоге recall вырос с 86 до 95%, а precision остался на уровне 1,000. И этот прирост дали всего две небольшие функции.
Я попытался пойти дальше и хранить по четыре хеша: исходный кадр и обрезанный, каждый с зеркалом. Recall вырос всего на 0,4 процентного пункта — это статистический шум. Лишние строки в базе и дополнительный хеш на каждый запрос того не стоят, поэтому от этой идеи я отказался.
Что не чинится: настоящее кадрирование
Остаётся одна уязвимость.
Найдено | |
|---|---|
Обрезали 5% | 100% |
Обрезали 10% | 80% |
Обрезали 20% | 5% |
Ни порогом, ни предобработкой это не исправить. Если срезать пятую часть кадра, меняется композиция, а перцептивный хеш — это именно слепок композиции. Информации о срезанном участке в 64 битах просто нет, и извлечь её оттуда нечем.
Если в потоке много агрессивно обрезанных копий, то здесь заканчивается зона хешей и начинается зона локальных признаков. На Хабре есть два отличных разбора, посвящённых этой границе:
Поиск кропнутых дубликатов изображений с помощью перцептуальных хешей: SURF-точки, k-means по ним и хеш от каждого устойчивого фрагмента; в итоге получается около 200 хешей на изображение вместо одного, зато обрезка перестаёт быть проблемой
Найти за полсекунды: сравниваем похожие фотографии: та же идея, масштабированная на 150 млн снимков (ключевые точки AKAZE, бинарные дескрипторы и префиксное дерево вместо B-дерева)
Цена решения описана в тех же статьях: вместо одного числа на фото — сотни точек, вместо одной колонки — отдельная поисковая подсистема. Поэтому выбирать нужно не «что технически круче», а исходя из того, сколько в вашем потоке реально обрезанных копий. В нашем случае их было мало, поэтому мы остались на хешах.
Ищем похожие хеши в PostgreSQL
Хеши посчитаны, теперь нужно по ним искать, когда фотографий миллионы.
Хранение
BIGINT — компактный формат с поддержкой побитовых операций через # (XOR), поэтому мы выбрали именно его. BIT(64) даёт нативные побитовые операции, но значительно шире в хранении. VARCHAR из нулей и единиц использовать не стоит — сравнивать такие строки долго и неудобно.
CREATE TABLE image_hashes (
    image_id bigint NOT NULL,
    hash     bigint NOT NULL,     -- две строки на фото: кадр и его зеркало
    PRIMARY KEY (image_id, hash)
);
Запрос
Расстояние Хэмминга — это количество единиц в XOR. В PostgreSQL 14+ для подсчёта единиц существует bit_count(). Однако есть нюанс: она работает для bit и bytea, но не для bigint. Поэтому требуется явный каст:
-- PostgreSQL 14+
-- найти всё, что отличается от пробы не более чем на 12 бит
SELECT DISTINCT image_id FROM image_hashes
WHERE bit_count((hash # $1)::bit(64)) <= 12;
Небольшое историческое отступление. В статье 2013 г. автор пытался вычислять расстояние Хэмминга средствами SQL, но посчитал это слишком медленным и переписал на C++ с битовой магией. Для того времени и конкретной нагрузки (около 200 хешей на картинку) вывод был правильный: в PostgreSQL тогда не было функции bit_count — она появилась только в 14-й версии, выпущенной в 2021 г. Сейчас ситуация изменилась, что подтверждают приведённые ниже замеры.
Что сравнивали
A — «выгребание» в Python: серверным курсором читаем все хеши, сравниваем в numpy. Выгрузку и сравнение замеряем отдельно.
B — полное сканирование в PG, тот же запрос. Однопоточный и параллельный.
C — GIN-индекс по блокам хэша с постфильтром. Режем хеш на N блоков, кладём их в
integer[]с GIN-индексом. ЕслиN > DIST, то по принципу Дирихле любой похожий хеш обязан совпасть хотя бы одним блоком, и индекс не потеряет ни строки.
Блоки нарезаются следующим образом (номер блока добавляем в старшие биты, чтобы одинаковые куски в разных позициях не считались совпадением):
def chunks(h: int, n: int = 4) -> list[int]:
    size = 64 // n
    mask = (1 << size) - 1
    return [(i << size) | ((h >> (size * i)) & mask) for i in range(n)]
ALTER TABLE image_hashes ADD COLUMN chunks integer[];
CREATE INDEX ON image_hashes USING gin (chunks);

SELECT DISTINCT image_id FROM image_hashes
WHERE chunks && $1                              -- блоки пробы, сужаем кандидатов
  AND bit_count((hash # $2)::bit(64)) <= 3;     -- и точный фильтр поверх
Стенд: PostgreSQL 15 в Docker, таблица image_hashes(image_id, hash bigint, chunks integer[]), 20 случайных проб, медиана, кэш прогрет через pg_prewarm.
Результаты
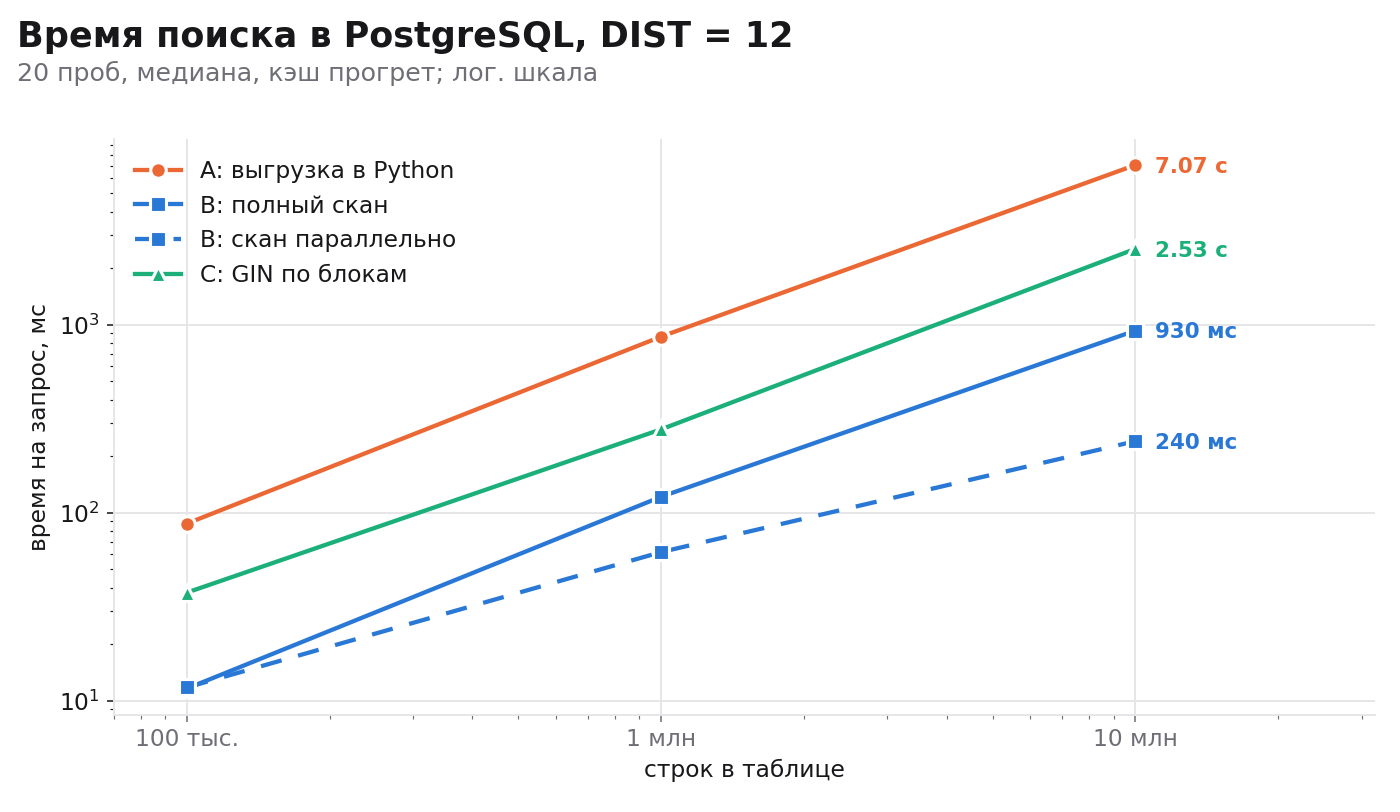
DIST = 12, «похожи на ≥80%»:
Количество строк | A: выгрузка | A: сравнение | B: скан | B: параллельный | C: GIN (16×4) |
|---|---|---|---|---|---|
100 000 | 80 мс | 7,2 мс | 11,6 мс | 11,8 мс | 37,6 мс |
1 000 000 | 790 мс | 74 мс | 122 мс | 62 мс | 278 мс |
10 000 000 | 6,5 с | 0,55 с | 0,93 с | 0,24 с | 2,5 с |
DIST = 3, «почти идентичные»:
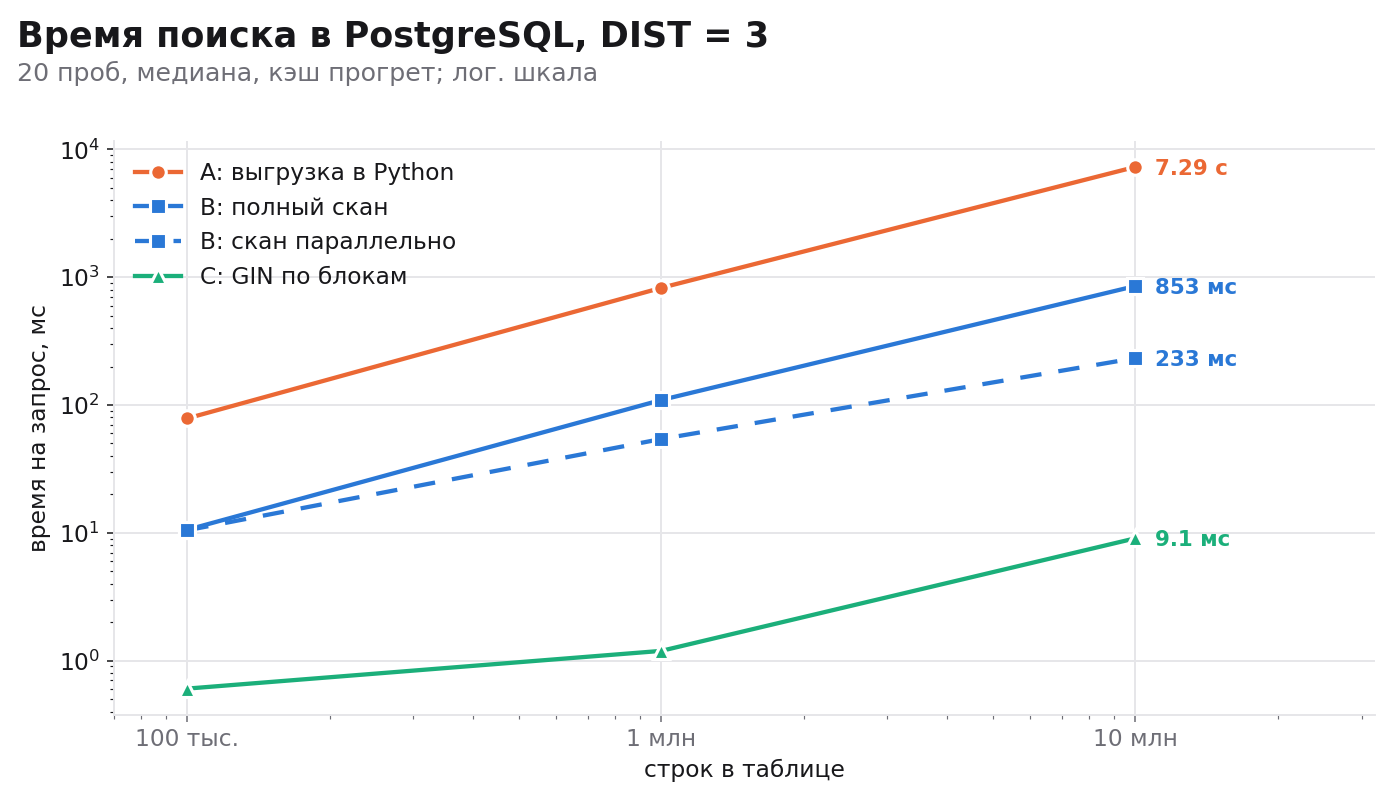
Количество строк | A: выгрузка | A: сравнение | B: скан | B: параллельный | C: GIN (4×16) |
|---|---|---|---|---|---|
100 000 | 72 мс | 6,8 мс | 10,6 мс | 10,5 мс | 0,6 мс |
1 000 000 | 750 мс | 75 мс | 110 мс | 54 мс | 1,2 мс |
10 000 000 | 6,7 с | 0,61 с | 0,85 с | 0,23 с | 9,1 мс |
При узком пороге блочный GIN полностью решает задачу: 9 мс против 850 мс полного сканирования на 10 млн — почти в 100 раз быстрее. Четыре блока по 16 бит дают достаточную селективность, чтобы индекс реально сужал выборку.
При широком пороге индекса нет, и с этим ничего не поделать. Гарантия полноты требует 16 блоков по 4 бита, а 4-битный блок совпадает почти с любой строкой. GIN на 10 млн работает медленнее полного сканирования — 2,5 с против 0,93 c. Он сначала раздувает список кандидатов, а затем фильтрует их. Поэтому остаётся только полный скан с bit_count, который, впрочем, и так неплох.
Также видно, что выгружать данные в приложение не стоит ни при каком пороге. Выгрузка 10 млн хешей в Python занимает 6,5 с и обходится более чем в 10 раз дороже самого сравнения (0,55 с). Запрос в базе данных выполняется одним проходом и не платит за сетевой транспорт.
Ещё про SP-GiST: для поиска по расстоянию Хэмминга он напрямую не подходит, так как отсутствует оператор расстояния. Рабочие варианты — полный скан с bit_count при широком пороге и GIN по блокам при узком.
Теперь вернёмся к изначальной задаче — максимально быстро (быстрее двух минут) сравнить новое фото со всеми (сотни тысяч). При 100 тыс. строк полный скан занимает 12 мс. Даже если у наc два хеша на фото и база на 1 млн фотографий, это будет 2 млн строк, то есть примерно четверть секунды (интерполируя между замерами на 1 млн и 10 млн). Плюс 15 мс на вычисление хеша самой фотографии. Двухминутный лимит перекрывается в тысячи раз, поэтому удвоение таблицы ради зеркала — приемлемое решение.
Если же такой запас не нужен, а важна экономия, то посмотрите статью автора AntiDupl: там аналогичная задача решена вообще без хешей и базы, с помощью многомерной индексации по средней яркости и половинкам кадра. 100 тыс. изображений обрабатываются за 30 с на одном ядре.
Подводные камни
Автообрезка полей может «съесть» часть фотографии. Самый неприятный сюрприз за всё время: на двух снимках из 20 пересвеченное небо оказалось залито чистым 255, то есть неотличимо от белого поля. autocrop добросовестно срезал верхние 18% кадра, и расстояние выросло с 2 до 30 бит. Ради таких случаев в функции предусмотрен max_strip. Полностью проблему это не решает: отличить белое поле от выбитого в ноль неба по пикселям невозможно, они выглядят одинаково.
64-битный хеш не помещается в bigint как есть. imagehash отдаёт беззнаковое число вплоть до 2⁶⁴, а bigint — знаковый. Из-за этого половина хешей при вставке уедет в переполнение — для этого в коде выше и появился to_bigint. На поиск это никак не влияет: PostgreSQL кастует bigint в bit(64) без изменений, в дополнительном коде, поэтому XOR и bit_count работают с теми же битами.
Прозрачность в PNG. Перед хешированием альфу надо заливать белым или чёрным цветом, иначе под прозрачностью окажется мусор, и хеш будет зависеть от используемой библиотеки для открытия файла.
EXIF не считаем, но ориентацию применяем. Хеш берётся только по пикселям. Если в EXIF содержится ориентация, её нужно применить до хеширования, иначе одно и то же фото даст разные хеши в зависимости от того, повернул его просмотрщик или нет.
Приводите к одному формату. Сравнивать нужно после унификации (grayscale, один размер), иначе артефакты сжатия «съедят» полезные биты.
Измеряйте аккуратно. Прогревайте кеш PG через pg_prewarm, повторяйте запросы, отбрасывайте первый прогон и берите медиану. При 10 млн строк одиночные прогоны у нас расходились на 20—30%, и по одному измерению можно было сделать любой вывод.
SHA-256 всё-таки посчитайте. Точные дубли — заметная доля потока, и их можно отсеять бесплатно, ещё до перцептивного хеша.
Что делать
Итоговая схема выглядит так:
SHA-256 файла первой ступенью — ловит точные дубли бесплатно
pHash на 64 битах: не aHash (ложные срабатывания), не 256 бит (не даёт улучшения, зато порог придётся подбирать заново), не wHash (медленнее и не лучше)
Перед хешированием применяем EXIF-ориентацию, заливаем альфу и обрезаем однотонные поля с ограничением на ширину полосы
В базу сохраняем два
bigint— хеш кадра и хеш зеркалаПоиск выполняем запросом
bit_count((hash # $1)::bit(64)) <= threshold, без выгрузки в приложениеПорог подбираем на своих данных: вычисляем precision и recall, находим минимальное расстояние между явно разными фотографиями
Для узкого порога добавляем GIN по блокам — это даёт миллисекунды при 10 млн записей
Если в потоке много обрезанных копий, стоит рассмотреть подход с ключевыми точками — хеши в таких случаях заканчиваются
На моем наборе данных это дало recall 95% при precision 100% и запас по времени в тысячи раз больше требуемого.
А вам приходилось решать задачу поиска похожих фотографий? Как вы её решали: через хеши, готовые библиотеки или сразу использовали нейросетевые эмбеддинги?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.