Цена за 50 штук записалась в колонку «200 штук»: разбираю 42 PDF с коммерческими предложениями
У нас в мастерской за год накопилась папка коммерческих предложений: 42 PDF, 532 страницы, 650 мегабайт. Прайсы, презентации, предложения под конкретных заказчиков. Мне понадобилась из неё одна таблица: позиция, тираж, цена за штуку. Вопрос простой: насколько дешевеет изделие, когда тираж растёт с 10 до 200 штук, и одинаково ли это работает для футболки и для стикеров.
Казалось, что это вечер работы: снять текст, найти числа рядом со словом «шт», сложить. Вышло иначе, и почти все ошибки по дороге были тихими. Скрипт отрабатывал без исключений и выдавал правдоподобные числа, которые не совпадали с тем, что напечатано на странице.
Сначала посчитать, где в папке вообще есть текст
Первый проход ничего не парсит, он только считает, где в файлах вообще есть текст. Страница, с которой pypdf снимает меньше 30 символов, считается пустой.
GLYPH = re.compile(r"/uni([0-9A-Fa-f]{4})")

def triage(pdf_path, min_chars=30):
    reader = PdfReader(pdf_path)
    empty, glyphs = 0, 0
    for page in reader.pages:
        text = page.extract_text() or ""
        empty += len(text.strip()) < min_chars
        glyphs += len(GLYPH.findall(text))
    return len(reader.pages), empty, glyphs
Итог по папке:
Файлов | 42 |
Страниц | 532 |
Страниц без текста | 166, это 31 % |
Файлов целиком из картинок | 7 |
Файлов хотя бы с одной пустой страницей | 21 |
Семь файлов сделаны так, что каждая страница представляет собой одну картинку. Скорее всего, их экспортировали из графического редактора «в PDF» без текстового слоя. Ещё в четырнадцати файлах картинками стали отдельные страницы, обычно самые нужные, с ценой. Со всеми этими страницами я ничего не делал, о них ниже. Вторая колонка, glyphs, понадобилась из-за следующей находки.
Буквы, которые пришли именами
Поиск по слову «футболка» в одном из предложений ничего не нашёл, хотя футболка там на каждой странице. Вот что pypdf отдал с первой страницы:
КОММЕРЧЕСКОЕ
ПРЕДЛОЖЕНИЕ
/uni041F/uni043E/uni0434/uni0430/uni0440/uni043E/uni0447/uni043D/uni044B/uni0435 /uni0438 ...
Заголовок читается, а дальше идут имена глифов. В спецификации PDF (ISO 32000-1, раздел 9.10 про извлечение текста) описано, откуда это берётся. Внутри PDF текст хранится кодами глифов шрифта, а не символами Юникода. Чтобы программа могла вернуть из кода букву, у шрифта должна быть таблица соответствия ToUnicode. Если её нет, остаётся запасной путь через имена глифов. У кириллицы в таких шрифтах имена часто вида uni041F, где после uni записан номер символа в Юникоде. pypdf таблицы не нашёл и отдал имена как есть.
Заголовок, судя по всему, набран другим шрифтом, у которого таблица была, поэтому одна страница вышла наполовину нормальной. Это хуже, чем если бы она была сломана целиком: при беглом просмотре файл выглядит прочитанным.
Лечится одной заменой, раз номер символа уже лежит в имени:
def fix_glyphs(text):
    return GLYPH.sub(lambda m: chr(int(m.group(1), 16)), text)
Таких файлов в папке шесть, «битых» символов в них 1 850. В одном из файлов вся первая страница целиком состоит из имён. Если не считать их отдельно, эти шесть файлов выпадают из выборки молча: в них просто ничего не находится.
Цена за 50 штук записалась в колонку «200 штук»
Дальше основная часть: найти на странице метки тиража («10 шт», «50 шт», «200 шт») и цены, а потом связать их. Первая версия делала это в лоб, по порядку следования в тексте:
def naive_pairs(text):
    tiers = re.findall(r"(?:от\s+)?\d+\s*шт", text)
    prices = [int(p) for p in re.findall(r"(\d+)\s*(?:р\b|РУБ)", text)]
    return list(zip(tiers, prices))
На оптовом прайсе это сработало. На втором прайсе, где те же позиции свёрстаны по-другому, футболка вышла такой:
[('10 шт', 680), ('200 шт', 610), ('от 201 шт', 550)]
На странице всё иначе: 680 рублей за 10 штук, 610 за 50, 550 за 200, а в колонке «от 201 шт» стоит не число, а «цена согласовывается». Вот как эту строку отдаёт pypdf:
10 шт 200 шт от 201 шт50 шт
pypdf выдаёт текст в том порядке, в каком операторы вывода стоят в потоке страницы. Порядок, в котором дизайнер расставлял надписи, с порядком на листе никак не связан: колонку «50 шт» в макете, видимо, двигали последней, и в потоке она оказалась в конце. Хуже всего, что результат выглядит правильно: три цены, три тиража, цены убывают.
У термокружки из того же файла поток такой: 885р 792р978р. Самая высокая цена стоит последней и приклеилась к самому большому тиражу.
Я попробовал вместо pypdf взять текст из pdfplumber, он собирает строки по координатам. Второй прайс стал читаться правильно, зато сломалась одна страница первого. Там число 680 стоит на несколько пунктов выше своего «РУБ», pdfplumber разнёс их по разным строкам, и между ними оказалась метка «10 шт.»:
680
10 шт. РУБ
Регулярка цену без «РУБ» не узнала, и футболка за 10 штук стала стоить 610. Счёт по всем страницам, где есть шкала тиража:
Способ связать цену с тиражом | Страниц с ценами | Ошибок |
|---|---|---|
По порядку в тексте pypdf | 38 | 17 |
По порядку в тексте pdfplumber | 38 | 1 |
По координатам слов | 38 | 0 |
Все 17 ошибок pypdf пришлись на один файл: из 19 страниц с ценами в нём ошиблись 17. Ни одна не уронила скрипт.
Рабочий вариант не доверяет никакому порядку текста. pdfplumber отдаёт каждое слово с рамкой на странице, и цена привязывается к ближайшей метке. Нужно только понять, как идёт шкала: если метки стоят в одну строку, сравнивать надо по горизонтали, если в столбик, то по вертикали. В двух прайсах встретились оба случая, одна и та же футболка свёрстана то так, то эдак.
def match(labels, found):
    # labels и found: (значение, x центра, y центра)
    if len(labels) < 2 or not found:
        return []
    ys = [l[2] for l in labels]
    axis = 1 if max(ys) - min(ys) < 5 else 2  # в одну строку сравниваем x, в столбик y
    return sorted(
        (min(labels, key=lambda l: abs(l[axis] - p[axis]))[0], p[0])
        for p in found
    )
Метка тиража ищется как число, за которым в той же строке идёт «шт», а цена как число, после которого стоит «р» или отдельное слово «РУБ» на расстоянии до 40 пунктов. Отдельное слово понадобилось для февральского прайса, где цена и «РУБ» набраны разными словами. Там же pypdf в одном месте склеил подпись со следующей строкой в 550 РУБСОСТАВ, так что искать «РУБ» внутри одного слова было бы ещё и ненадёжно.
Один прайс, две вёрстки, разные тиражи
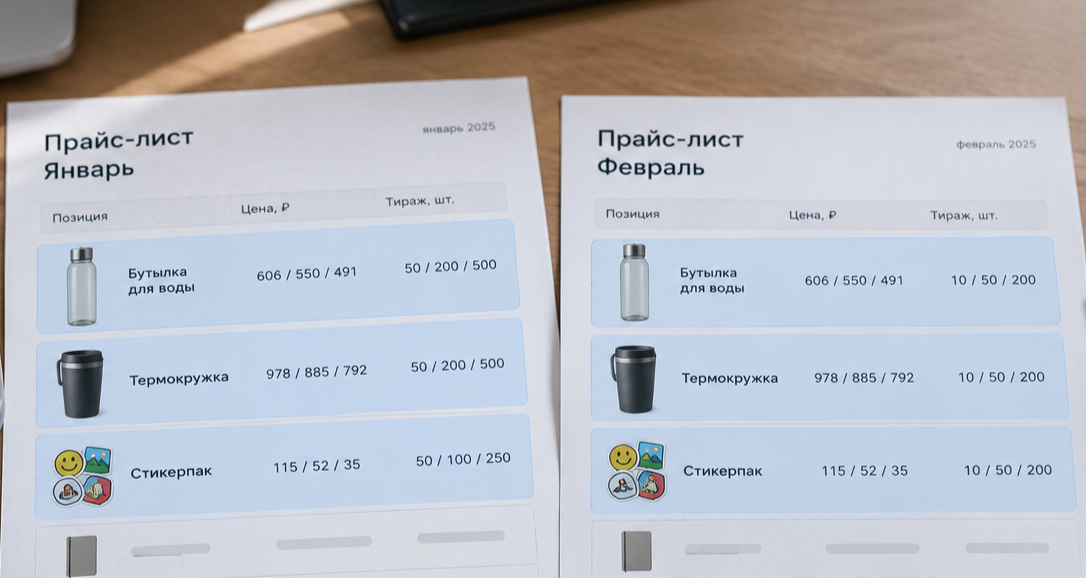
Когда оба прайса прочитались, я сверил их между собой. Позиции я сопоставлял по тройке цен: если три числа совпадают, это одна и та же вещь. Общих позиций нашлось 13, у десяти совпали и цены, и тиражи. У трёх цены совпали, а тиражи нет:
Позиция | Цены, ₽ | Файл от января | Файл от февраля |
|---|---|---|---|
Бутылка для воды | 606 / 550 / 491 | 50 / 200 / 500 шт | 10 / 50 / 200 шт |
Термокружка | 978 / 885 / 792 | 50 / 200 / 500 шт | 10 / 50 / 200 шт |
Стикерпак | 115 / 52 / 35 | 50 / 100 / 250 шт | 10 / 50 / 200 шт |
Это уже не ошибка парсера, я проверил по картинкам страниц: в двух файлах действительно напечатаны разные тиражи. Для бутылки разница существенная. По январскому файлу 491 рубль стоит штука в партии из 500, по февральскому в партии из 200. Какой из файлов верен, по самим файлам не понять. Скрипт здесь сделал своё дело: показал расхождение, которое при чтении глазами одного документа заметить невозможно.
Отсюда же нашлась ошибка у нас самих. В рабочих заметках по этому архиву позиция за 606 / 550 / 491 была записана термокружкой. На странице это бутылка для воды, а термокружка стоит 978 рублей. Заметки составлялись чтением текстового слоя, а название позиции на этой странице набрано отдельным блоком далеко от цены.
Пакетик соли за 9.750 рублей
В предложении для сети кофеен цена на брендированные пакетики соли выглядит так:
/ / от 9.750 ₽ минимальная ппартия 25.000 шт
float("9.750") даёт 9,75, и так цена уменьшается в тысячу раз. Точка здесь отделяет тысячи, как часто бывает в презентационной вёрстке. Отличить это от копеек можно по форме: ровно три цифры после точки и ни одной после запятой.
def parse_money(s):
    s = s.replace(" ", " ").replace(" ", "")
    if re.fullmatch(r"\d{1,3}(\.\d{3})+", s):
        s = s.replace(".", "")
    return int(s)
Вторая ловушка в той же строке: это цена партии, а не штуки. 9 750 рублей за 25 000 пакетиков означает 0,39 рубля за штуку. Салфетки на соседней странице стоят 29 500 рублей за 540 упаковок по 100 штук, это 0,55 рубля за салфетку. Название позиции («Упаковка соли») при этом в текстовом слое отсутствует, оно нарисовано картинкой. Без чтения глазами из этой страницы получается только «какая-то вещь за 9,75 рубля».
Что получилось: шкала тиража считается коэффициентом
В февральском прайсе 19 позиций со шкалой 10 / 50 / 200 штук. Я поделил цену за 50 и за 200 штук на цену за 10:
Позиция | 10 шт, ₽ | 50 шт, ₽ | 200 шт, ₽ | 50 / 10 | 200 / 10 |
|---|---|---|---|---|---|
Футболка классическая | 680 | 610 | 550 | 0,897 | 0,809 |
Футболка оверсайз | 1 470 | 1 330 | 1 190 | 0,905 | 0,810 |
Поло | 910 | 820 | 730 | 0,901 | 0,802 |
Свитшот | 1 940 | 1 750 | 1 570 | 0,902 | 0,809 |
Худи | 2 430 | 2 210 | 1 980 | 0,909 | 0,815 |
Кепка | 630 | 570 | 510 | 0,905 | 0,810 |
Шоппер | 360 | 330 | 290 | 0,917 | 0,806 |
Рюкзак | 840 | 760 | 680 | 0,905 | 0,810 |
Кружка | 210 | 190 | 170 | 0,905 | 0,810 |
Бутылка для воды | 606 | 550 | 491 | 0,908 | 0,810 |
Термокружка | 978 | 885 | 792 | 0,905 | 0,810 |
Повербанк | 1 360 | 1 240 | 1 110 | 0,912 | 0,816 |
Двенадцать позиций из девятнадцати укладываются в 0,905 и 0,810 с отклонением не больше 0,012. Разница в последней цифре объясняется округлением до десяти рублей. Получается, что шкала у этих позиций не выведена из себестоимости каждой вещи, а получена одним правилом: минус 9,5 % за 50 штук и минус 19 % за 200. Для худи с DTF-печатью и для керамической кружки скидка одна, хотя изделия и способ нанесения у них совсем разные.
Остальные семь позиций в правило не попадают, и по ним видно, где правило перестаёт работать:
Позиция | 50 / 10 | 200 / 10 |
|---|---|---|
Стикерпак | 0,452 | 0,304 |
Ручка | 0,846 | 0,731 |
Подарочный набор | 0,948 | 0,777 |
Ремувка | 0,879 | 0,803 |
Рюкзак из переработанного полиэстера | 0,893 | 0,852 |
Блокнот | 0,928 | 0,855 |
Картхолдер | 0,944 | 0,888 |
Стикерпак при росте тиража в двадцать раз дешевеет втрое. Для печатной продукции так и должно быть: подготовка и запуск стоят столько же, сколько печать небольшой партии, и на 200 штук они размазываются тоньше. В январском прайсе так же ведут себя бумажные пакеты и коробки с цифровой печатью: от 50 к 500 штукам цена падает до 0,28 и 0,31 от начальной. Шкала там другая, поэтому в общую таблицу я их не ставил.
Почему я не стал распознавать картинки
166 страниц без текста я не распознавал. OCR на сервере не установлен, а качество распознавания цифр на стилизованных шрифтах (у пакетиков соли цена набрана узким плакатным) пришлось бы проверять глазами по каждой странице. На этом объёме проще и надёжнее прочитать сами страницы. Цены есть далеко не на всех этих страницах: среди семи полностью картиночных файлов, например, брендбук, где цен нет вовсе.
Чего я не нашёл
Я не выяснил, почему pypdf в режиме visitor_text отдал для части слов на страницах второго прайса нулевые координаты. Сначала я пытался связывать цены с метками через него и получил нули там, где на странице явно другое место. Проверка Form XObject ничего не дала, текст лежит прямо в потоке страницы. Разбираться дальше я не стал и перешёл на pdfplumber.
Я не знаю, какой из двух прайсов верен для бутылки, термокружки и стикерпака. Февральский файл на месяц новее, но это не доказывает, что тиражи в нём изменили намеренно, а не ошиблись при вёрстке.
В расчёт не вошли тридцать предложений под конкретных заказчиков. В них у позиции чаще одна цена под один тираж, шкалы нет, и коэффициент по ним не посчитать.
Что я из этого вынес
Первое: из PDF приходит не тот порядок, который видит человек. Для таблиц полагаться можно только на координаты.
Второе: «скрипт отработал» и «скрипт прочитал правильно» нужно проверять отдельно. Все ошибки выше прошли без исключений, и найти их помогло только сравнение с картинкой страницы и с другим источником.
Третье: перед тем как парсить, стоит посчитать, что именно вы парсите. Треть страниц без текста и шесть файлов с именами глифов вместо букв за первые пять минут сказали больше, чем первая версия парсера за вечер.
Данные разбора: 42 PDF из архива коммерческих предложений мастерской, загружены в архив с сентября 2025 по сентябрь 2026 года; скрипт прогнан 14 октября 2026 года, pypdf 6.16.0, pdfplumber 0.11.10.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.