Движки таблиц ClickHouse
Система баз данных ClickHouse предоставляет изобилие разнообразных движков таблиц, из которых зачастую на практике разработчиками используется только ограниченный набор. Многие редко используемые движки, однако, предоставляют очень полезные и даже уникальные функциональные возможности, оптимизированы под использование в специфических ситуациях, и при правильном использовании способны существенно ускорить не только выполнение некоторых конкретных запросов, но и работу всей базы данных.
Привет! Я Дмитрий, Data Engineer в ИТ-компании SimbirSoft. В этой статье я постараюсь кратко описать основные категории существующих движков системы ClickHouse, особенности использования движков, а в конце дам несколько рекомендаций для их практического использования. Думаю, материал будет полезен больше джунам, однако и опытным специалистам, работающим с другими базами данных, будет интересно узнать про движки, которыми они еще не пользовались. Поэтому перед рассмотрением самих движков начну с небольшой вводной части.
Что такое ClickHouse?
ClickHouse – это колоночная СУБД, предназначенная для аналитической обработки больших объемов данных. Для обеспечения возможности эффективной обработки существуют различные движки таблиц. Любая таблица в ClickHouse строится на основании какого-либо движка.
Движок (в оригинале engine) определяет:
способ хранения данных таблицы (место физического размещения данных, особенности хранения и др),
виды доступа (запросы),
совместный доступ к данным,
использование индексов (если они есть),
многопоточное выполнение запросов,
параметры репликации данных.
Давайте посмотрим на сравнительную таблицу движков (приведены наиболее распространенные).
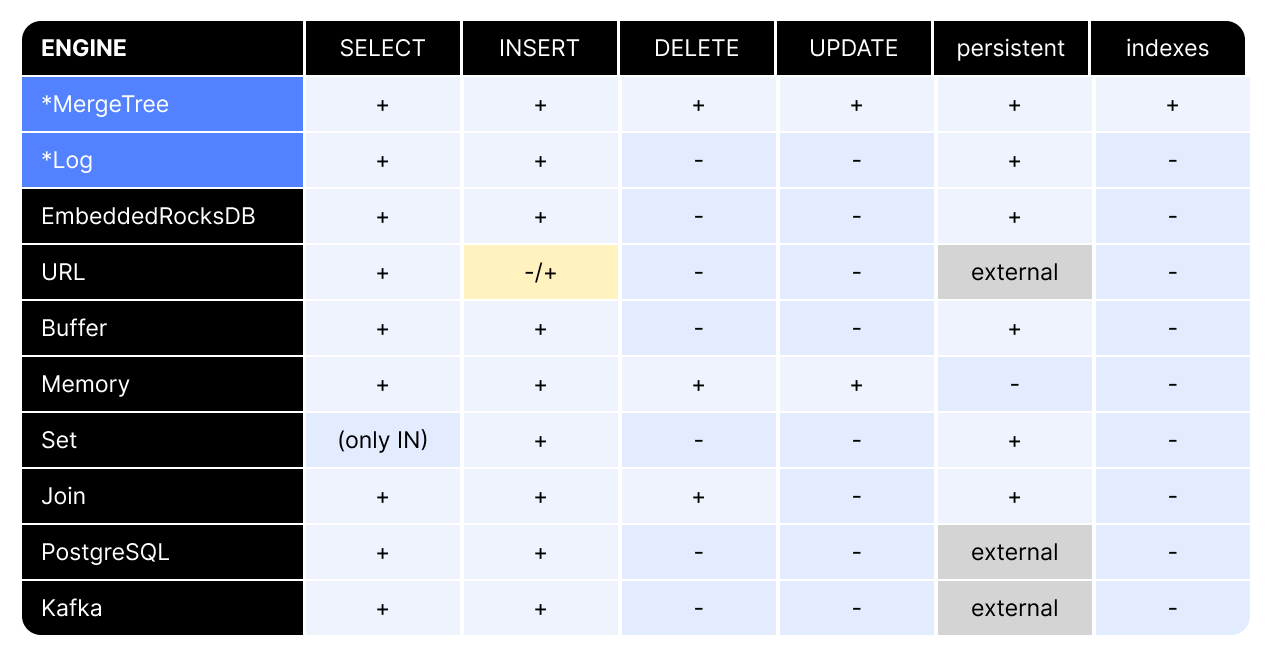
Даже для небольшого числа движков таблица достаточно объемная. Понимание различий движков в поддержке команд select, insert, delete, update, а также наличии возможности сохранять данные между перезагрузками БД (персистентность) и поддержке индексов придет естественно после того, как мы все их изучим по очереди. Однако уже сейчас мы можем заметить, что delete, update и индексы поддерживают отнюдь не все движки.
Семейство *MergeTree
Семейство *MergeTree является основой для хранения данных в ClickHouse и предоставляет большинство функций для обеспечения отказоустойчивости и высокопроизводительного извлечения данных: колоночное хранение, настраиваемое партиционирование, разреженный первичный индекс, вторичные индексы с пропуском данных и т. д.
Основным недостатком движков MergeTree является то, что они довольно ресурсоемкие. Поэтому таблицы на основе движков этой категории следует использовать для хранения содержательной части данных хранилища, а для информации другого вида использовать другие, более специализированные и оптимизированные под такие задачи движки. Для небольших таблиц с временными данными, например, подойдут движки из семейства Log, про которое я расскажу позже.
Движок MergeTree
Движок MergeTree – базовый, все остальные движки этого семейства являются его расширением и используются аналогичным образом.
Рассмотрим общие для всего семейства особенности:
Первичный ключ таблицы определяет порядок сортировки внутри каждой части таблицы, то есть является кластеризованным индексом. При этом первичный ключ указывает не на отдельные строки, а на блоки по 8192 строки, которые называются гранулами. Размер гранул можно поменять, хотя в общем случае это не рекомендуется. Благодаря этому индекс получается достаточно компактным, чтобы помещаться в оперативную память даже для очень больших объемов данных.
Таблицы можно разбивать на разделы (партиции), чтобы при чтении пропускать ненужные партиции (partition pruning).
С помощью Replicated*-движков данные могут реплицироваться между узлами кластера.
Поддерживаются различные виды статистики и методы выборочного чтения (sampling), помогающие оптимизировать запросы.
Используется механизм слияния данных.
Механизм слияния данных очень важен для всех движков семейства, потому что на его основе реализован их дополнительный функционал. Слияние частей данных (data parts) – это фоновый процесс объединения мелких частей в более крупные (до 150 ГБ), необходимый для оптимизации хранения и производительности, уменьшения небольших файлов на диске.
Хотя процесс слияния фоновый, выполняемый системой, но его можно явно запустить с помощью команды OPTIMIZE TABLE. Зачем его запускать вручную, мы увидим на примере следующих движков.
SummingMergeTree
Представим, что мы хотим хранить суммы полей по какому-то ключу. Тогда нам поможет SummingMergeTree – таблица с группировкой одинаковых записей по ключу сортировки и применением суммы к числовым полям, перечисленным в параметрах движка при определении таблицы.
В процессе слияния все строки с одинаковым первичным ключом (ключом сортировки) будут заменяться на одну строку. В ней столбцы из ключа сортировки остаются теми же, а числовые суммируются. Иными словами, происходит группировка по ключу сортировки и агрегация (SUM) по числовым столбцам. Для столбцов, не входящих в ключ сортировки и параметры движка, значения не суммируются, – из них выбирается одно случайное значение из записей группы.
Рассмотрим таблицу с тремя полями: id, val, по которому будет считаться сумма, и example, которого нет в ключе сортировки и параметрах движка, то есть он будет браться случайным.
CREATE OR REPLACE TABLE summing_mt
(
    id UInt32,
    val UInt32,
    example UInt32,  -- столбец, не входящий в ключ сортировки и параметры движка
)
-- сумма будет считаться по полю val, т.к. оно указано в качестве параметра движка
ENGINE = SummingMergeTree(val)
ORDER BY (id); -- записи по этому ключу будут группироваться
Сделаем две вставки с одинаковым id. В первой будут три строки со значениями val 10, 20, 30, а во второй – одна строка с val 10. Выполним select и увидим 2 строки.
INSERT INTO summing_mt SELECT 1, (number + 1) * 10, (number + 2) * 100 FROM numbers(3);
INSERT INTO summing_mt SELECT 1, 10, 100;

SELECT * FROM summing_mt;
+------+-----+---------+
| id   | val | example |
+------+-----+---------+
| 1    | 10  | 100     |
| 1    | 60  | 200     |
+------+-----+---------+
Первые три строки слились в одну, где val равен 60, то есть 10+20+30. Но строка из второй вставки еще не успела просуммироваться. Это значит, что механизм группировки работает только в пределах одной части данных, созданной при вставке.
Добавим в SELECT ключевое слово FINAL и увидим корректный результат, будто слияние уже произошло.
SELECT * FROM summing_mt FINAL
+------+-----+---------+
| id   | val | example |
+------+-----+---------+
| 1    | 70  | 200     |
+------+-----+---------+
Того же результата можно добиться при помощи запуска OPTIMIZE TABLE:
OPTIMIZE TABLE summing_mt;
SELECT * FROM summing_mt;
+------+-----+---------+
| id   | val | example |
+------+-----+---------+
| 1    | 70  | 200     |
+------+-----+---------+
Кстати, SummingMergeTree можно использовать для предварительной подготовки данных, по которым будут строиться отчеты, вместе с обычной MergeTree-таблицы.
AggregatingMergeTree
Для остальных видов агрегации можно использовать AggregatingMergeTree – таблицу, которая группирует одинаковые записи по ключу сортировки и применяет агрегатные функции к полям, например, подсчет уникальных значений, среднее, перцентиль и другие.
AggregatingMergeTree назначает агрегатные функции при описании полей. Рассмотрим таблицу с ключом сортировки id и полем val с типом SimpleAggregateFunction с параметром max.
CREATE OR REPLACE TABLE agg_mt
(
    id UInt32,
    val SimpleAggregateFunction(max, UInt32) -- агрегатная функция max
)
ENGINE = AggregatingMergeTree
ORDER BY (id);
Вставим в таблицу 10, 20 и 30 с id, равным 1, и посмотрим результат.
INSERT INTO agg_mt SELECT 1, (number + 1) * 10 FROM numbers(3); -- 10, 20, 30
SELECT * FROM agg_mt;
+----+-----+
| id | val |
+----+-----+
|  1 |  30 |
+----+-----+
Получается только значение 30, агрегатная функция отработала на одном data part. Создадим похожую ситуацию, как с SummingMergeTree.
INSERT INTO agg_mt SELECT 1, 50; -- вставка данных в новый кусок
SELECT * FROM agg_mt;
+----+-----+
| id | val |
+----+-----+
|  1 |  30 |
|  1 |  50 |
+----+-----+
Последний SELECT нам выдал 2 строки, потому что данные вставились в разные data parts, а агрегация автоматически срабатывает для данных только в одной части. Нужно, чтобы прошло слияние и данные оказались в одном data part. Применим инструкцию FINAL и увидим корректный результат.
SELECT * FROM agg_mt FINAL;
+----+-----+
| id | val |
+----+-----+
|  1 |  50 |
+----+-----+
Но FINAL работает примерно в 1,5-2 раза медленнее, чем указание группировки, поэтому лучше использовать такой запрос:
SELECT id, MAX(val) as val
FROM agg_mt
GROUP BY id;
+----+-----+
| id | val |
+----+-----+
|  1 |  50 |
+----+-----+
В данном примере мы использовали SimpleAggregateFunction, который хранит только текущее значение агрегатной функции и не сохраняет ее полное состояние. SimpleAggregateFunction предназначен для простых агрегатов типа min, max, sum.
В отличие от него, AggregateFunction хранит не готовое значение, а состояние функции. Это позволяет объединять состояния так, как будто функция выполнилась над объединенным массивом входных данных один раз.
Однако теперь нам приходится вставлять в таблицу не сами значения, а состояния агрегатных функций – промежуточные данные в двоичном формате. Например, для такой таблицы с двумя AggregateFunction с параметрами uniq и any:
CREATE OR REPLACE TABLE aggr_func_tbl
(
    id UInt64,
    val_uniq AggregateFunction(uniq, UInt64),
    val_any AggregateFunction(any, String)
) ENGINE = AggregatingMergeTree ORDER BY id;
Для вставки следует использовать функции uniqState и anyState:
INSERT INTO aggr_func_tbl
SELECT
    1,
    uniqState(toUInt64(rnd)),
    anyState(toString(rnd))
    -- 10 строк со случайными числами
FROM
    (SELECT arrayJoin(arrayMap(i -> rand(i), range(10))) as rnd);
Для чтения – uniqMerge и anyMerge:
SELECT
    uniqMerge(val_uniq),
    anyMerge(val_any)
FROM aggr_func_tbl
+----------------------+--------------------+
| uniqMerge(val_uniq)  | anyMerge(val_any)  |
+----------------------+--------------------+
|                   10 | 2686059166         |
+----------------------+--------------------+
Кстати, если повторять этот запрос, то anyMerge всегда возвращает одно и то же значение.
ReplacingMergeTree
Механизм слияния можно использовать не только для предагрегации, но и для удаления дубликатов, которые часто являются неприятной проблемой. Появиться они могут по многим причинам, например: неидемпотентный ETL-процесс, повторные сообщения из Kafka в режиме at-least-once и даже человеческий фактор.
ReplacingMergeTree удаляет дублирующиеся записи с одинаковым значением ключа сортировки. После дедупликации для каждого значения ключа сортировки останется последняя строка из последней вставки.
Важно помнить, что удаление дублей происходит во время слияния, которое происходит в фоновом режиме, и какая-то часть записей все еще может быть необработанной. Для гарантии следует использовать либо модификатор FINAL, либо явно применять OPTIMIZE TABLE.
Рассмотрим таблицу с двумя полями, где id – ключ сортировки:
CREATE OR REPLACE TABLE replacing_mt
(
    id UInt32,
    val UInt32
)
ENGINE = ReplacingMergeTree
ORDER BY (id); -- записи по этому ключу будут заменяться
Вставим числа 10, 20 и 30 с одинаковым id и посмотрим результат:
INSERT INTO replacing_mt SELECT 1, (number + 1) * 10 FROM numbers(3);
SELECT * FROM replacing_mt;
+----+-----+
| id | val |
+----+-----+
|  1 |  30 |
+----+-----+
Вставилась только последняя запись. При вставке записей с одинаковым ключом сортировки в разных INSERT снова придется использовать FINAL.
CollapsingMergeTree
Иногда нужно быстро удалять и обновлять имеющиеся записи, тогда может помочь CollapsingMergeTree(Sign), который асинхронно удаляет (сворачивает) пары строк, если все поля в этой паре в ключе сортировки ORDER BY эквивалентны и значение поля Sign у одной строки равно 1 (активное состояние строки), а у другой – -1 (отмененное состояние строки, можно расценить как команду на удаление). Название поля может быть любым, главное – указать его параметром движка.
Рассмотрим такую таблицу, где хранятся события по действиям пользователей, то есть clickstream. Мы хотим быстро обновлять количество просмотренных страниц и длительность.
CREATE OR REPLACE TABLE UAct
(
    UserID UInt64,
    PageViews UInt8,
    Duration UInt8,
    Sign Int8
)
ENGINE = CollapsingMergeTree(Sign)
ORDER BY UserID;
Добавим указанные строки и посмотрим, что находится в таблице.
INSERT INTO UAct VALUES (123456789, 2, 35, 1);
INSERT INTO UAct
VALUES (123456789, 2, 35, -1),(123456789, 3, 48, 1);
SELECT * FROM UAct;
+-----------+-----------+----------+------+
| UserID    | PageViews | Duration | Sign |
+-----------+-----------+----------+------+
| 123456789 |         2 |       35 |   -1 |
| 123456789 |         3 |       48 |    1 |
| 123456789 |         2 |       35 |    1 |
+-----------+-----------+----------+------+
Дубликаты остались, применим FINAL:
SELECT * FROM UAct FINAL;
+-------------+-----------+----------+------+
| UserID      | PageViews | Duration | Sign |
+-------------+-----------+----------+------+
| 123456789   |         3 |       48 |    1 |
+-------------+-----------+----------+------+
Осталась только одна строка с новыми значениями полей.
Важно следить со стороны приложений, которое взаимодействует с ClickHouse, за логикой состояния Sign. Когда приоритетна скорость получения актуальных данных, то FINAL слишком медленный, поэтому можно использовать такой запрос, в котором противоположные значения обнулятся:
SELECT sum(PageViews*Sign) FROM UAct;VersionedCollapsingMergeTree
Часто при реальной работе вставка идет параллельно и не по порядку. В таком случае следует использовать VersionedCollapsingMergeTree. Это реализация CollapsingMergeTree, но с иным алгоритмом удаления строк, который адаптирован для многопоточной вставки. Это достигается при помощи дополнительного поля version.
VersionedCollapsingMergeTree удаляет дублирующиеся записи с одинаковым значением ключа сортировки, за исключением поля Sign с учетом версии строки. Этот процесс имеет альтернативное название – «сворачивание записей». То есть в процессе слияния ClickHouse удаляет каждую пару строк, которые имеют один и тот же первичный ключ и версию, но разный Sign.
Может появиться вопрос: «А зачем эти движки нужны, если можно просто сделать UPDATE?» Однако эта операция в ClickHouse дорогая и медленная, и ее использование не рекомендуется.
Рассмотрим таблицу, где будем обновлять поле val:
CREATE OR REPLACE TABLE vcollapsing_mt
(
    id UInt32,
    val String,
    sign Int8,
    version UInt8
)
ENGINE = VersionedCollapsingMergeTree(sign, version)
ORDER BY (id);
Вставим указанные строки и посмотрим на результат:
INSERT INTO vcollapsing_mt SELECT 1, 'state', 1, 1;
INSERT INTO vcollapsing_mt SELECT 1, 'cancel state', -1, 1;
SELECT * FROM vcollapsing_mt;
+----+--------------+------+---------+
| id | val          | sign | version |
+----+--------------+------+---------+
|  1 | state1       |    1 |       1 |
|  1 | cancel state |   -1 |       1 |
+----+--------------+------+---------+
Сворачивания не произошло, используем FINAL.
SELECT * FROM vcollapsing_mt FINAL;
+----+--------+------+---------+
| id | val    | sign | version |
+----+--------+------+---------+
|    |        |      |         |
+----+--------+------+---------+
Теперь обе строки «свернулись», и не осталось ни одной.
Добавим еще 3 строки, где первые две свернутся, а вторая будет иметь отличную от них версию.
INSERT INTO vcollapsing_mt SELECT 1, 'state', 1, 1;
INSERT INTO vcollapsing_mt SELECT 1, 'cancel state', -1, 1;
INSERT INTO vcollapsing_mt SELECT 1, 'state2', 1, 2;
SELECT * FROM vcollapsing_mt FINAL;
+----+--------------+------+---------+
| id | val          | sign | version |
+----+--------------+------+---------+
|  1 | state2       |    1 |       2 |
+----+--------------+------+---------+
В выборке осталась только последняя строка.
ReplicatedMergeTree
Завершая обзор MergeTree, кратко рассмотрим движки для репликации. В ClickHouse она реализуется через движки с префиксом Replicated, например, ReplicatedMergeTree.
ReplicatedMergeTree – это обычная MergeTree, которая реплицируется на все узлы кластера.
CREATE TABLE repl_example ON CLUSTER test_cluster
-- таблица появится на всех узлах, входящих в состав указанной группы шардов
(
    EventDate DateTime,
    CounterID UInt32,
    UserID UInt32
)
ENGINE = ReplicatedMergeTree('/clickhouse/tables/{shard}/repl_example', '{replica}')
PARTITION BY toYYYYMM(EventDate)
ORDER BY (CounterID, EventDate, intHash32(UserID));
Здесь первый параметр – это путь к таблице в ZooKeeper, а второй – имя реплики с макросом, который подставляет имя реплики, которое нужно для каждого хоста кластера.
Интеграционные движки
Интеграционные движки предназначены для доступа к данным, физически расположенным за пределами ClickHouse в других системах. Внешние источники оформляются как таблицы, которые создаются при помощи CREATE TABLE и которыми можно работать при помощи SELECT, как с обычными таблицами.
Движок S3
Движок таблиц S3 обеспечивает интеграцию с веб-службой Simple Storage Service (AWS S3, minIO). Свойства S3-движка:
чтение и запись могут быть параллельными,
не поддерживаются ALTER и мутации,
не поддерживается семплирование,
не поддерживаются индексы и репликация.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    fld [type1] [DEFAULT|ALIAS expr1],
) ENGINE = S3(path,
              [aws_access_key_id, aws_secret_access_key,]
              format,
              [compression]);
Обязательные параметры:
path – URL-адрес бакета с указанием пути к файлу. Для обращения к нескольким файлам предусмотрены подстановочные знаки: *, ?, {abc,def}.
format – формат файла, например CSV, JSON, TSV.
Необязательные параметры:
aws_access_key_id, aws_secret_access_key – данные пользователя учетной записи AWS могут быть заданы в файле конфигурации.
compression – тип сжатия.
Движок PostgreSQL
Движок PostgreSQL позволяет выполнять запросы SELECT и INSERT к данным, хранящимся на удаленном сервере PostgreSQL. В настоящее время для движка таблиц поддерживаются только версии PostgreSQL 12 и выше.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    name1 type1 [DEFAULT|MATERIALIZED|ALIAS expr1] [TTL expr1],
    name2 type2 [DEFAULT|MATERIALIZED|ALIAS expr2] [TTL expr2],
) ENGINE = PostgreSQL({host:port, database, table, user,
password[, schema, [, on_conflict]] | named_collection[, option=value [,...]]})
Движок Kafka
Движок Kafka предназначен для доступа и считывания данных из топиков брокера сообщений Kafka. Он не хранит данные самостоятельно и предназначен для подписки на потоки данных и публикации данных.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    name1 [type1] [ALIAS expr1],
    name2 [type2] [ALIAS expr2],
) ENGINE = Kafka()
SETTINGS
    kafka_broker_list = 'host:port',
    kafka_topic_list = 'topic1,topic2,...',
    kafka_group_name = 'group_name',
    kafka_format = 'data_format';
Обязательные параметры:
kafka_broker_list – список брокеров, разделенных запятыми (например, localhost:9092),
kafka_topic_list – список топиков Kafka,
kafka_group_name – группа потребителей Kafka,
kafka_format – формат сообщений. Использует ту же нотацию, что и SQL-функция FORMAT, например, JSONEachRow.
Семейство *Log
Как я упоминал выше, движки семейства MergeTree достаточно ресурсоемкие, и для быстрой записи временных данных рекомендуются *Log-движки.
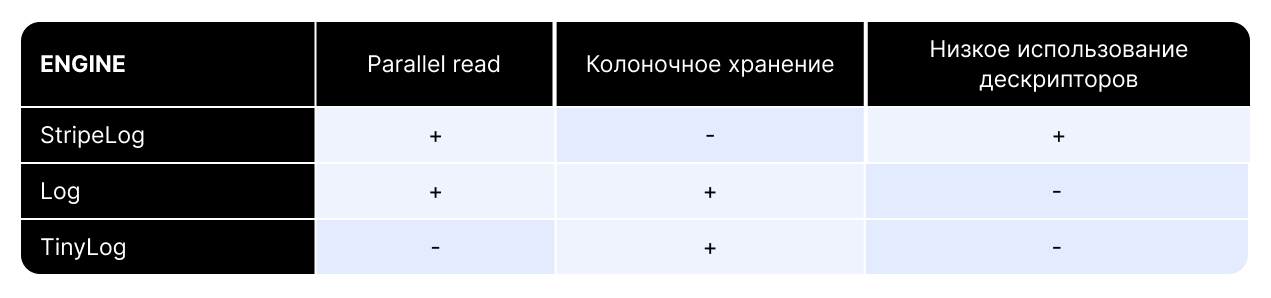
Таблицы на основе этих движков предназначены для сценариев, когда нужно быстро записывать много таблиц с небольшим объемом данных – менее одного миллиона строк, а затем читать их целиком.
Рассмотрим их основные свойства:
При записи данные добавляются в конец файла.
Каждый столбец хранится в отдельном файле.
Поддерживаются блокировки для конкурентного доступа к данным.
Во время запросов INSERT таблица блокируется, а другие запросы на чтение и запись ожидают разблокировки таблицы. Если запросов на запись данных нет, можно выполнять любое количество конкурентных запросов на чтение.
Однако некоторые возможности этим движками этого семейства не поддерживаются:
Индексы. Запросы SELECT неэффективны для выборки диапазонов данных. Движки подходят для выборки всех записей сразу.
Модификация записанных данных через UPDATE и DELETE.
Атомарность записи. Вы можете получить таблицу с поврежденными данными, если что-то прервет операцию записи, например аварийное завершение работы сервера.
Синтаксис создания *Log-таблиц предельно простой и состоит из перечисления полей и указания типа движка StripeLog, Log или TinyLog:
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    column1_name [type1] [DEFAULT|MATERIALIZED|ALIAS expr1],
    ...
) ENGINE = [ StripeLog | Log | TinyLog ];
Рассмотрим их подробнее.
Движок TinyLog
Самый простой в семействе и является менее функциональным и эффективным по сравнению с остальными движками.
Не использует файлы засечек (mark-файлы), из-за чего не поддерживает параллельное чтение данных в несколько потоков, поэтому читает данные медленнее, чем другие движки семейства.
Хранит каждый столбец в отдельном файле.
Подходит для простых сценариев «записал-прочел-удалил» или с низкой нагрузкой.
Движок Log
В отличие от TinyLog, вместе с файлами столбцов хранит небольшой файл засечек, это обеспечивает многопоточное чтение.
Поддерживает параллельное чтение – при считывании данных ClickHouse использует множество потоков, и каждый поток обрабатывает отдельный блок данных.
Сохраняет каждый столбец таблицы в отдельном файле.
Движок Log подходит для временных данных, таблиц write-once и тестовых и демонстрационных целей.
Движок StripeLog
Хранит все данные в одном файле и использует меньше дескрипторов в операционной системе.
Поддерживает параллельное чтение.
StripeLog используется в сценариях, когда нужно создавать большое количество таблиц с небольшим объемом данных. Если нужно хранить логи объемом более миллиона, то использовать *Log неэффективно. Для такой задачи лучше подойдет MergeTree.
Специализированные движки
Движок EmbeddedRocksDB
Для хранения и обработки key-value-данных ClickHouse имеет встроенный движок EmbeddedRocksDB. С ним таблица хранит данные не по столбцам, а в собственном формате RocksDB. Указание первичного ключа является обязательным, причем максимально в него входит только 1 столбец.
Также запросы с фильтрацией на равенство по ключу или вхождение в множество (оператор IN) оптимизируются для поиска по нескольким ключам в RocksDB.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    pk_name [type0],
    column1_name [type1] [DEFAULT|MATERIALIZED|ALIAS expr1],
    column2_name [type2] [DEFAULT|MATERIALIZED|ALIAS expr2],
    ...
)
ENGINE = EmbeddedRocksDB([ttl, rocksdb_dir, read_only])
PRIMARY KEY(pk_name); -- только одно поле в первичном ключе
Параметры движка:
ttl – время жизни значений в секундах,
rocksdb_dir – путь к директории существующего RocksDB или целевой путь созданного RocksDB,
read_only – режим «только для чтения».
Движок File
File позволяет работать с данными файлов из файловой системы. При объявлении таблицы на основе этого движка создается одноименный каталог на диске в каталоге с названием базы данных.
File бывает полезен в следующих сценариях:
экспорт данных из ClickHouse в файл,
преобразование данных из одного формата в другой,
обновление данных в ClickHouse путем редактирования файла на диске.
Свойства File:
Многопоточная запись и чтение выполняются по очереди.
При первой вставке в таблицу создается файл, если он не существовал ранее.
Не поддерживаются изменения данных с помощью ALTER.
Не поддерживается семплирование.
Не поддерживаются индексы и репликация.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    column1_name [type1] [DEFAULT|ALIAS expr1],
    ...
) ENGINE = File([CSV | TabSeparated | JSON | ... ]);
По умолчанию ClickHouse создаст папку /var/lib/clickhouse/data/default/table_name.
Движок URL
URL похож на File с тем различием, что чтение и запись данных происходят с удаленного HTTP/HTTPS сервере, где и лежит файл. Соответственно, запросы INSERT и SELECT транслируются в POST- и GET-запросы.
Свойства движка URL:
Поддерживаются многопоточные запись и чтение.
Не хранит данные локально, а обращается за данными, хранящимися на удаленном сервере.
Не поддерживается изменение данных с помощью ALTER.
Не поддерживается семплирование.
Не поддерживаются индексы и репликация.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    column1_name [type1] [DEFAULT|ALIAS expr1],
    ...
) ENGINE = URL('http://127.0.0.1:12345/', [CSV | TabSeparated | JSON | ... ]);
Движок Buffer
Buffer буферизует записываемые данные в оперативной памяти, периодически сбрасывая их в другую таблицу. Причем данные читаются одновременно и из буфера, и из другой таблицы.
Зачем он нужен? Для MergeTree оптимальна вставка записей большими частями, поэтому с помощью Buffer можно собрать одиночные INSERT в одну большую часть, которая сама вставится при достижении одного из указанных порогов.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster] (
    column1_name [type1] [DEFAULT|ALIAS expr1],    ...
) ENGINE = Buffer(database, target_table,
                  num_layers, min_time, max_time, min_rows,
                  max_rows, min_bytes, max_bytes
);
Параметры движка:
database – имя базы данных. Вместо имени базы данных может использоваться константное выражение, возвращающее строку;
target_table – таблица, в которую сбрасываются данные;
num_layers – уровень параллелизма. Физически таблица будет представлена в виде num_layers независимых буферов. Рекомендуемое значение – 16;
min_time, max_time – условие времени в секундах от момента первой записи в буфер;
min_rows, max_rows – условие на количество строк в буфере;
min_bytes, max_bytes – условие на количество байт в буфере.
Движок Memory
Memory предусмотрен для хранения данных только в оперативной памяти. В частности, он подходит для данных, которые не нужно хранить постоянно и потеря которых не критична, но важно при необходимости быстро считывать. Memory позволяет записывать и модифицировать данные. При перезапуске инстанса БД данные очищаются.
Его можно использовать как кеш. Например, считать из большой таблицы небольшую часть для дальнейшей работы. А если заданы нижняя и верхняя границы размера таблицы, то такая таблица может работать как кольцевой буфер. При вставке данных, объем которых выше заданной границы, старые данные будут удаляться.
Свойства Memory-движка:
Используется на датасетах до 100 млн строк.
Чтение распараллеливается.
Чтение и запись не блокируют друг друга.
Данные по умолчанию хранятся в несжатом виде.
Индексы не поддерживаются.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    column1_name [type1] [DEFAULT|ALIAS expr1],
    ...
) ENGINE = Memory [SETTINGS ...];
Раздел SETTINGS может содержать следующие необязательные параметры:
min_bytes_to_keep – минимальный размер в байтах,
max_bytes_to_keep – максимальный размер в байтах,
min_rows_to_keep – минимальный размер в строках,
max_rows_to_keep – максимальный размер в строках,
compress – нужно ли сжимать данные в памяти.
По умолчанию везде – 0, а для сжатия – false. Параметры можно менять через ALTER.
Движок Set
Set – это множество, всегда находящееся в оперативной памяти. Предназначен для использования в правой части оператора IN. Этот движок подходит для работы с набором неменяющихся данных, которые требуются в постоянном доступе.
Стоит отметить, что обычный SELECT из такой таблицы недоступен. В Set при вставке дубликаты игнорируются, а данные хоть и хранятся в оперативной памяти, но с опцией persistent, которая по умолчанию 1, будут храниться и на диске.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    column1_name [type1] [DEFAULT|ALIAS expr1],
    ...
) ENGINE = Set
SETTINGS persistent = [1 | 0];
Движок Join
Предназначен для предварительной подготовки данных для использования в операциях JOIN. Иногда встречаются задачи, где для отчетных данных нужно выполнять соединение с данными из небольших справочников. В таких случаях и пригодится этот движок.
Свойства Join-движка:
Таблица используется в правой части секции JOIN или в функции joinGet.
Данные всегда в ОЗУ.
Данные сохраняются на диск для восстановления после перезапуска сервера (опция persistent).
Поддерживаются DELETE-мутации.
Не поддерживается семплирование.
Не поддерживаются индексы и репликация.
Можно выполнять операцию OPTIMIZE для уменьшения объема занятой памяти.
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    fld [type1] [DEFAULT|MATERIALIZED|ALIAS expr1] [TTL expr1],
    ...
) ENGINE = Join(
    [ANY | ALL],          -- строгость соединения
    [INNER | LEFT | ...], -- тип соединения
    fld[, fld2, ...]      -- ключевые столбцы
);
Движок имеет три параметра:
Строгость соединения: ANY, ALL. Если таблица создана со строгостью ANY, при вставке данные с повторяющимися ключами игнорируются. Если таблица создана со строгостью ALL, при вставке добавляются все строки.
Тип соединения: INNER, LEFT и т. д.
Ключевые столбцы. По ним будет производиться соединение.
Эти параметры будут определять применимость таблицы этого движка в соединениях. То есть, если присоединить таблицу оператором LEFT, а в движке был указан INNER, то произойдет исключение.
Движок Merge
Merge (не путать с MergeTree) не хранит данные сам по себе, но позволяет одновременно читать из любого числа других таблиц.
Свойства Merge-движка:
чтение автоматически параллелизуется;
запись в таблицу не поддерживается;
при чтении используются индексы таблиц, которые фактически читаются, если они существуют.
CREATE TABLE ... Engine = Merge(db_name, tables_regexp);Параметры движка:
db_name – имя базы данных, или константное выражение, которое возвращает строку с именем базы данных, или регулярное выражение для соответствия именам баз данных.
tables_regexp – регулярное выражение для соответствия именам таблиц в указанной БД.
Чтобы убрать зацикленность, при выборе таблиц для чтения сама таблица Merge не выбирается, даже если она соответствует регулярному выражению. Но возможно создать две Merge таблицы, которые будут бесконечно пытаться прочесть данные друг друга – так делать не стоит.
Подведем итоги
На этом мы завершаем обзор движков. Конечно, это не все из существующих, в официальной документации можно найти и более специфичные. Те, про которые мы узнали, используются в подавляющем большинстве случаев. По этой ссылке собрал основные тезисы по движкам.
В этой статье я рассказал о движках таблиц в ClickHouse и для чего они нужны, описал три семейства движков и группу специализированных, разобрал сценарии их использования, какую задачу они решают.
И в завершении напомню важное правило: некоторые механизмы работают асинхронно, поэтому для гарантированного результата нужно прописать FINAL или OPTIMIZE TABLE.
Спасибо за внимание!
Больше авторских материалов для backend-разработчиков от моих коллег читайте в соцсетях SimbirSoft – ВКонтакте и Telegram.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.