Как IaC, документация и бэкапы помогли восстановить сервисы, когда пострадали дата-центры Яндекса
Привет, я Сергей, DevOps-инженер в KTS. Перейду сразу к делу.
К отказу отдельной виртуалки вы наверняка готовы. Но не все готовы к другому классу аварии: к потере площадки, на которой находятся почти все ВМ проекта.
Именно с такой ситуацией столкнулся один из наших заказчиков после серии атак на дата-центры Яндекса в октябре 2026 года. Компания сообщила, что дата-центр в Сасово был серьезно поврежден и полностью остановлен, часть инфраструктуры площадки в Калуге вышла из строя, а позднее остановилась работа дата-центра во Владимире.
Авария затронула инфраструктуру Yandex Cloud, где работали сервисы нашего заказчика. Восстановить работу системы на прежней площадке в тот момент было невозможно, а очередь за новыми ресурсами обрабатывалась несколько дней.
Заказчика и его внутренние системы я называть не буду, статья не о нем. На его примере я хочу поговорить о механике восстановления: что происходит после потери основного дата-центра и какие инженерные практики помогают вернуть бизнес в рабочее состояние.
Сразу оговорюсь: не существует архитектуры, которую невозможно сломать, так что в статье не будет волшебной пилюли от всех бед. Я расскажу о мерах, которые помогли нам сократить простой и исключить полную потерю рабочего контура. К моменту аварии у нас за плечами уже был проведенный аудит, мы описали риски и зависимости, подготовили документацию и инфраструктурный код, проверили резервные копии и исключили бас-фактор. Во время аварии оставалось применить эти наработки на практике.
Оглавление
До аварии
Когда наша команда подключилась к проекту, инфраструктура заказчика уже существовала и много лет развивалась вместе с бизнесом. Основные виртуальные машины находились в одном дата-центре. Схема работоспособная, но неустойчивая.
Если внутри площадки выходил из строя отдельный узел, проблему можно было компенсировать средствами виртуализации или перезапуском сервиса. Но при недоступности всей площадки терялись бы вычислительные ресурсы, сеть и доступ к зависимостям, на которых держался прикладной контур.
Мы зафиксировали этот риск во время полноценного инфраструктурного аудита и предложили план повышения надежности. В него входили распределение сервисов, развитие оркестрации, перенос отдельных компонентов, перевод конфигураций в код и постепенное устранение единой точки отказа, и работа была расписана на год вперед. Мы согласовали план преобразований с заказчиком и поэтапно выполняли его. К моменту аварии часть работы уже была сделана, а оставшиеся унаследованные компоненты и ручные настройки были известны и учтены.
Это важный контекст. Надежность нельзя «взять и включить», приходится искать баланс между допустимым временем простоя, возможной потерей данных, сложностью системы и стоимостью ее содержания. Мы помогли заказчику нащупать этот баланс, но риск реализовался до того, как все работы были завершены.
В момент аварии
После повреждения дата-центров Яндекса облачная инфраструктура заказчика, размещенная в одном отказном домене Yandex Cloud, стала недоступна. Соответственно, вместе с виртуалками остановились работавшие на них приложения. Чинить было нечего, нужно было восстановить контур в другом месте.
Задача осложнялась следующими факторами:
новая площадка должна была предоставить достаточные вычислительные ресурсы;
на ней требовалось заново подготовить сеть, доступы и базовые платформенные компоненты;
нужно было перенести или восстановить данные;
приложения следовало запускать с учетом зависимостей;
после запуска требовалось проверить не только техническую доступность, но и ключевые бизнес-сценарии.
Время поджимало, поэтому мы применили заранее определенную приоритизацию и начали с минимального набора сервисов, без которого бизнес заказчика не мог выполнять основные операции.
Первые дни
С проблемой столкнулись не мы одни. Множество компаний одновременно искали новые мощности, создавали ВМ и переносили большие объемы данных. Ожидаемо, на альтернативных площадках ресурсы выдавались не мгновенно. Создание виртуальных машин, подготовка облачных сервисов и согласование сетевых настроек занимали время. Скорость переноса данных зависела от каналов связи и объектных хранилищ.
Часть восстановления зависела от взаимодействия с Яндексом: через поддержку мы получали снапшоты и организовывали выгрузку данных из S3. Команда провайдера оставалась на связи и передавала данные по мере готовности. Хотя доступность инфраструктуры была нарушена, сами данные сохранились, так что в этой части SLA был соблюден. Ограничивала нас только скорость их получения и переноса на новую площадку.
Пока переносились данные, наша команда параллельно готовила конфигурации, проверяла зависимости, создавала базовую инфраструктуру, уточняла порядок запуска и составляла проверки для приложений. В каждый момент мы старались выполнять всю работу, которая не была заблокирована внешней зависимостью.
В подобных инцидентах полезно разделять два времени:
инженерное время, т.е. сколько занимает развертывание, настройка и проверка со стороны команды;
календарное время, т.е. сколько проходит с начала аварии до восстановления с учетом ожидания ресурсов и передачи данных.
Эти два счетчика помогают разобраться, где узкое место: в рабочем процессе или в устройстве инфраструктуры.
Что было на руках
Как я отмечал во введении, к моменту аварии у нас уже было несколько слоев подготовки: результаты аудита, карта сервисов, инфраструктурный код, документация, проверенные резервные копии и несколько погруженных в проект инженеров. В свете инцидента они очень пригодились. Расскажу, почему и как именно.
Устройство контура и зависимости
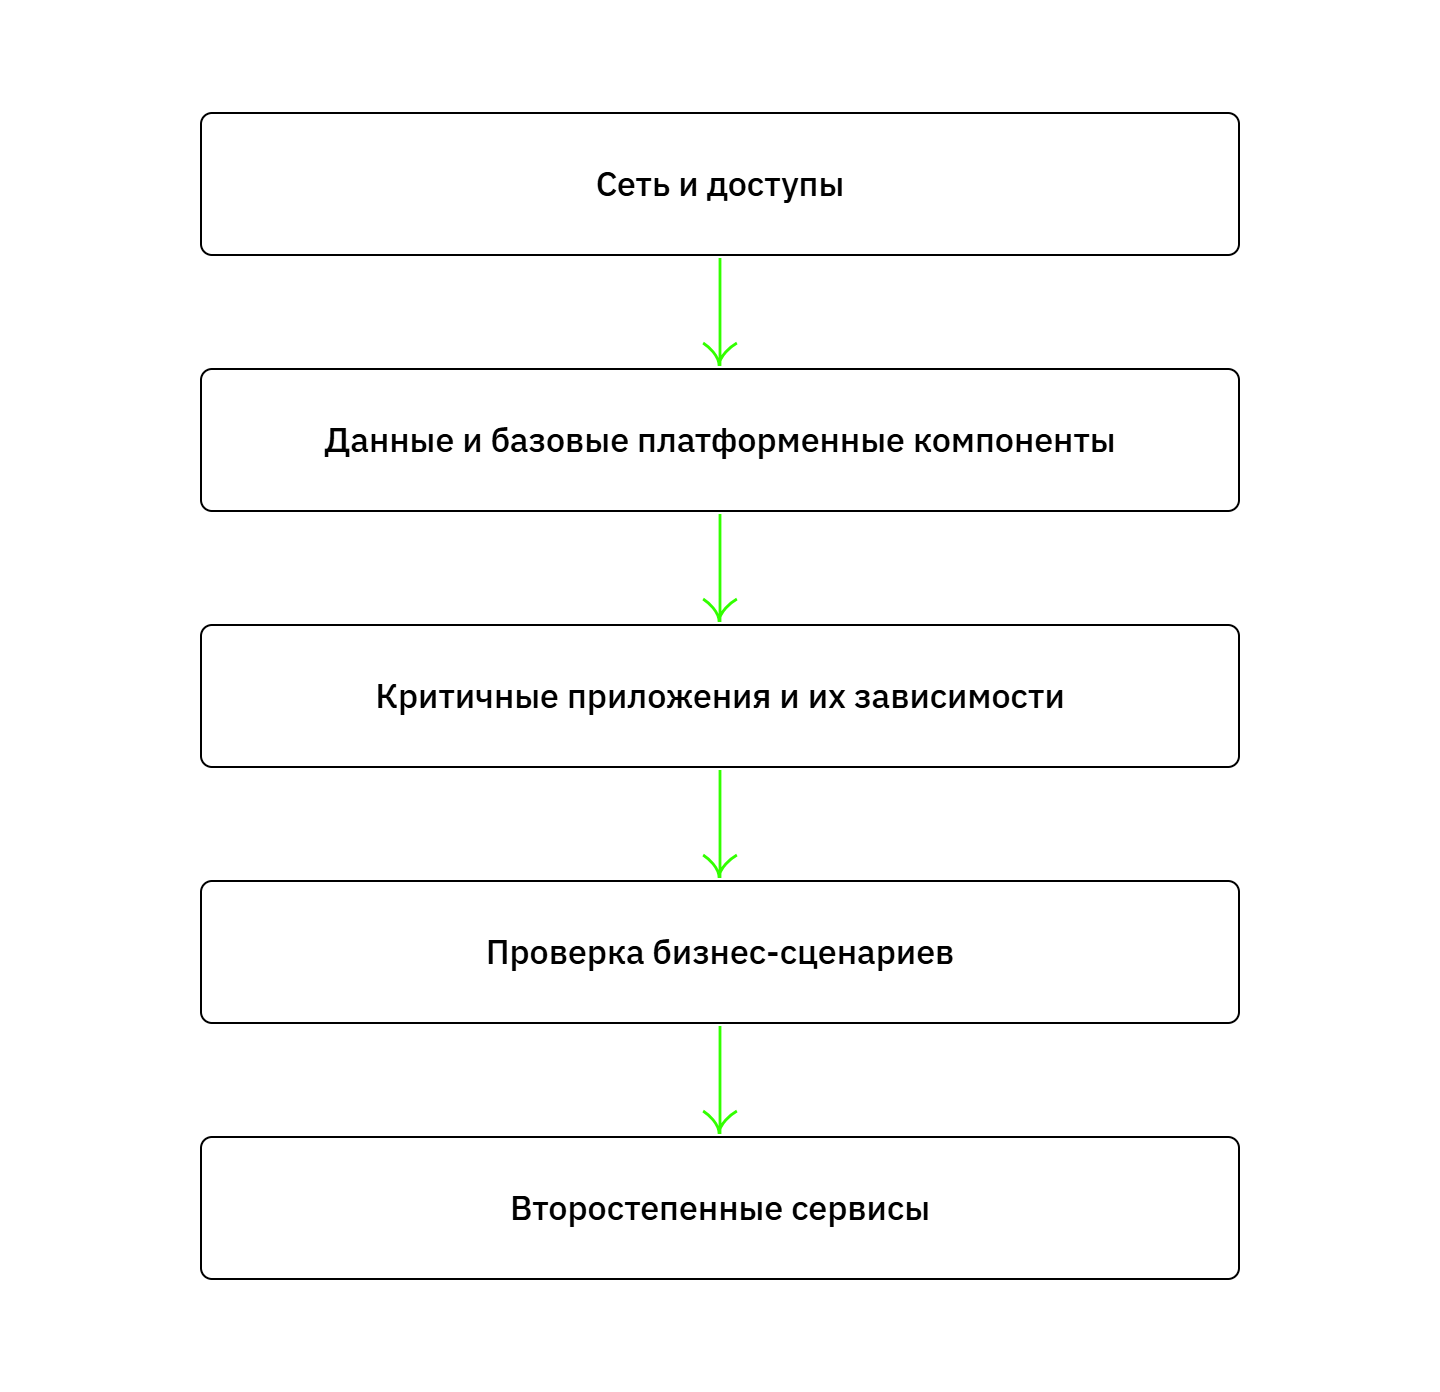
Благодаря проведенному аудиту и последующей работе на проекте мы знали состав критичного контура, основные зависимости и объемы данных. Нам не пришлось проводить инвентаризацию во время аварии: необходимая информация уже была собрана и зафиксирована. Мы знали:
какие сервисы непосредственно влияют на основные операции бизнеса;
какие базы и хранилища им необходимы;
какие платформенные компоненты должны быть развернуты раньше приложений;
какие системы можно временно не восстанавливать;
в каком порядке проверять работоспособность.
В упрощенном виде последовательность выглядела так:
IaC
На проекте применялись Terraform, Ansible и GitOps-подход. Это позволяло воспроизводить инфраструктурные компоненты и конфигурации по содержимому репозиториев, а не восстанавливать настройки по памяти или скриншотам из интерфейса облака.
Инфраструктура как код дала сразу несколько преимуществ:
стало видно, какие ресурсы нужны для запуска контура;
одни и те же конфигурации можно было последовательно применять на новой площадке;
изменения оставались проверяемыми и воспроизводимыми;
несколько инженеров могли работать параллельно без конфликтов в согласованности;
после первой попытки развертывания исправления сохранялись в коде и не терялись.
Деплой не всех сервисов был описан в IaC, поскольку не весь наш годовой план был реализован к моменту аварии. Авариям в целом не свойственно ждать, пока к ним подготовятся. Но мы знали обо всех компонентах и ручных настройках, поэтому заранее понимали их назначение, зависимости и порядок восстановления.
Одной кнопкой IaC систему не восстановил, зато превратил восстановление из археологии в последовательность понятных шагов.
Бас-фактор
Параллельно с переводом инфраструктуры в код мы устраняли бас-фактор, то есть риск, что критичные знания о проекте есть только у одного специалиста. В проект погрузились сразу несколько инженеров: они работали с одними и теми же контурами, участвовали в изменениях и имели доступ к документации и коду. Поэтому во время аварии к восстановлению подключились сразу несколько инженеров. Мы не зависели от единственного человека, который знал бы, как тут все устроено.
Документация
Много где принято вести документацию по остаточному принципу. Сервис и так работает, зачем тратить время? Может, и действительно незачем, пока работает. А если перестанет работать, чем будете заниматься?
Мы документацию вели, и нам очень пригодились описания сервисов, их зависимости, сведения о конфигурации и инструкции по эксплуатации. По ним команда сверяла порядок запуска и заранее знала, в каких местах потребуется ручное вмешательство. Несколько инженеров одновременно восстанавливали разные части системы и ориентировались по одному и тому же описанию.
Качество документации мы оцениваем контрольным вопросом: может ли инженер, который не строил конкретную систему, понять по описанию ее место в общей схеме и сделать следующий шаг для восстановления? Если нет, то это пока справочник, а ранбук еще предстоит написать.
Резервные данные
Инфраструктурный код без данных дает только пустые сервисы, так что еще одной опорой стали резервные копии критичных систем. Мы знали, какие данные нужны приложениям, где лежат их копии и в каком порядке их восстанавливать. После переноса проверяли не только наличие файлов и дампов, но и целостность данных, запуск зависимых систем и пользовательские операции.
Сам по себе факт, что бэкапы существуют, еще ничего не гарантирует. До аварии команда проводила тестовые восстановления и заранее знала:
переживет ли копия тот же отказ, что и основная система;
сколько времени займет ее получение;
какова фактическая точка восстановления, то есть RPO;
сколько занимает развертывание из этой копии;
кто и как проверяет результат.
Поэтому во время аварии мы не гадали, «взлетят» ли бэкапы. Процедура была проверена на практике, оставалось повторить ее в новой среде.
Как мы поднимали критичный контур
Условно работу можно разбить на восемь шагов.
Определили минимальную цель
Возвращать всю инфраструктуру в доаварийное состояние сразу мы не пытались. Первой целью стал контур, без которого заказчик не мог вести основные операции. Все остальное отложили.
Сопоставили знания, код и данные
Мы сверили карту сервисов, репозитории конфигураций и доступные бэкапы, чтобы увидеть цепочку восстановления целиком и не обнаружить посреди процесса, что какой-то критичной зависимости не хватает.
Выбрали доступную площадку
В момент массового спроса идеальная площадка и доступная площадка не всегда совпадают. Мы выбирали ту, где быстрее давали нужные мощности.
Подготовили базовую инфраструктуру
На новой площадке мы подняли сеть, доступы, вычислительные ресурсы и платформенные компоненты. Где было возможно, использовали существующие описания в Terraform, Ansible и GitOps-конфигурации.
Восстановили данные
Данные переносили с той скоростью, которую позволяли внешние системы. Зависимые сервисы не запускали, пока не прошли проверки целостности.
Запустили приложения в порядке зависимостей
Сначала подняли базовые компоненты, затем критичные приложения и только после них менее важные сервисы. Так работающая бизнес-цепочка появилась раньше, чем если бы мы поднимали все подряд.
Проверили пользовательские сценарии
Зеленый статус процесса и ответ на healthcheck еще не значат, что бизнес восстановлен. Поэтому мы прогоняли сквозные операции и смотрели, может ли пользователь выполнить нужное действие, проходит ли оно через все зависимости и сохраняются ли данные.
Вернули критичные сервисы в эксплуатацию
После технических и функциональных проверок основные операции заказчика снова заработали. Дальше мы продолжили восстанавливать оставшиеся компоненты и разбирать накопившиеся отклонения.
Что получилось в итоге
Ключевые сервисы, без которых заказчик не мог работать, мы восстановили на новой площадке менее чем за сутки. Это время ушло и на ожидание решения заказчика (пока он определялся, стоит ли мигрировать, или лучше дождаться восстановления исходного ЦОДа), и на сами технические работы, и на ожидание ресурсов и перенос данных. Но мы не потеряли дни на выяснение состава системы и ручное воссоздание каждой настройки.
После инцидента мы вместе с заказчиком разделили три вопроса:
Первопричина аварии: атаки на дата-центры Яндекса и временная недоступность части инфраструктуры Yandex Cloud.
Масштаб воздействия: концентрация критичного контура в одном отказном домене.
Качество восстановления: действия, данные и инструменты, которые позволили вернуть ключевые сервисы.
Такое разделение нужно для нормального постмортема. Конечно, можно просто обвинить во всем провайдера, но архитектура и риски останутся прежними. Еще можно обвинить команду сопровождения, но тогда ей придется строить отказоустойчиво-георезервированно-бронированный космолет вместо оптимальной инфраструктуры, чтобы не оставаться крайней (то есть получится дорогая система, оторванная от реальных требований и возможностей бизнеса). Система становится жизнеспособной, когда стороны договариваются, какой риск нужно закрыть, какое время восстановления требуется и сколько они готовы за это платить.
Ограничения исходной схемы мы обсуждали с заказчиком еще до аварии, поэтому во время разбора мы не спорили о том, кто должен был ее предвидеть и предотвратить. Так что мы не искали виноватых, а сразу перешли к следующему этапу повышения надежности.
Что показала авария
Ничего из перечисленного ниже мы не открыли во время восстановления. На этих тезисах строились аудит и план работ, авария просто подтвердила их состоятельность. И они применимы в работе с любым облачным провайдером.
Облако не избавляет от точек отказа
Виртуалка в облаке все равно привязана к физической инфраструктуре, сети и системам хранения. Если все экземпляры живут в одном дата-центре, система наследует его доступность, сколько бы автоматизации вокруг ни было.
Список серверов не равен плану восстановления
Полный перечень ВМ полезен, но его мало. Нужно понимать зависимости и приоритеты, то есть какие данные, платформы и приложения вместе обеспечивают критичную операцию.
IaC, документация и бэкапы работают только вместе
Код без данных дает пустую инфраструктуру, а данные без кода приходится долго оборачивать новой средой. Если же нет документации и владельцев, то и код, и данные превращаются в набор артефактов, назначение которых выясняют уже во время аварии.
RTO и RPO должны быть бизнес-решением
RTO задает допустимое время восстановления, RPO ограничивает допустимую потерю данных. Чем жестче требования, тем дороже архитектура и ее эксплуатация. Поэтому эти параметры нельзя оставлять неявными или отдавать на откуп одной инфраструктурной команде.
Время восстановления ограничивает самое медленное звено
Можно автоматизировать развертывание до нескольких минут и потом сутки ждать выдачи ресурсов или копирования данных. Поэтому после каждого восстановления стоит разобрать календарное время по этапам и работать с настоящим узким местом.
Восстановление нужно проверять заранее
Репозиторий с Terraform, папка с бэкапами и документ под названием «Disaster Recovery» сами по себе еще не указывают на готовность к инцидентам. Мы проверяли восстановление на практике до аварии, поэтому процедура была отработанной.
Что дальше
Авария изменила отношение заказчика к риску. Yandex Cloud остаётся основной площадкой, но теперь у критичных сервисов есть резерв на случай её отказа. Раньше потеря основной площадки выглядела маловероятным сценарием, и стоимость постоянного резерва казалась неоправданной. Практика показала, зачем мы целый год настаивали на аудите, IaC, документации, тестировании бэкапов и распределении знаний в команде. Благодаря этим практикам критичные сервисы удалось восстановить без потери данных.
Следующим шагом стала подготовка резервного контура у другого провайдера. Звучит просто: «сделать копию в другом облаке». На деле нужно выбрать между горячим, теплым и холодным резервом, определить способ синхронизации данных, не допустить дрейфа конфигураций и регулярно проверять переключение.
У такого решения есть очевидный плюс: независимый отказный домен, а значит, и более короткий путь до восстановления. Минусы тоже понятные. Резерв стоит денег, усложняет эксплуатацию, облачные сервисы у разных провайдеров различаются, а к безопасности данных появляются новые требования.
Это уже отдельная история про поиск приемлемого баланса между надежностью, временем простоя и стоимостью. О ней я планирую рассказать в следующей статье. А пока предлагаю почитать статьи моих коллег, которые тоже пишут про инженерные практики:
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.