Как нейросети оживляют фото: большой разбор и ТОП-3 ИИ. Часть 1
Представьте фотографию, на которой человек смотрит прямо в камеру. Чтобы он повернул голову хотя бы на 30 градусов, нейросети придется дорисовать ему ухо, щеку и часть шеи, которых на снимке нет. Ни одного заготовленного пикселя этих областей у нее нет: она сама их выдумывает, опираясь на миллионы других просмотренных видео. Иногда результат не отличить от реальной съёмки, а порой лицо расплывается, как воск.
Разница между исходами почти целиком объясняется тем, как устроена модель и какое фото вы ей дали. В первой части разбора разбираемся, что происходит внутри нейросети, когда она оживляет снимок, и как этим пользоваться.
Что значит «оживить фото»
Оживление фото — это генерация последовательности кадров, в которой статичное изображение становится видеоклипом. Важное отличие от классической анимации: в After Effects или аналогичных программах аниматор двигает и деформирует то, что уже есть на картинке. Нейросеть же создает новые пиксели, которых в исходнике не было: моргающие веки, открытый в улыбке рот, ту сторону лица, которая была скрыта поворотом головы.
На словах выглядит просто, но технически это одна из сложнейших задач в компьютерном зрении. По одному плоскому снимку модель должна восстановить трехмерную структуру сцены, направление света, глубину, свойства материалов: ткань, волосы, фон. И только после этого можно правдоподобно сдвинуть хоть что-то.
500+ готовых генераций фото вы можете увидеть в наших Пресетах. Вы сразу ощутите то великое разнообразие контента, которое нам дарит ИИ. А главное, весь сложный процесс генерации идеи и промпта остаётся за кадром. Вам нужно только загрузить своё фото и нажать одну кнопку.
Что происходит внутри нейросети при оживлении фото: три шага
Если убрать формулы, работу современной модели можно описать тремя шагами.
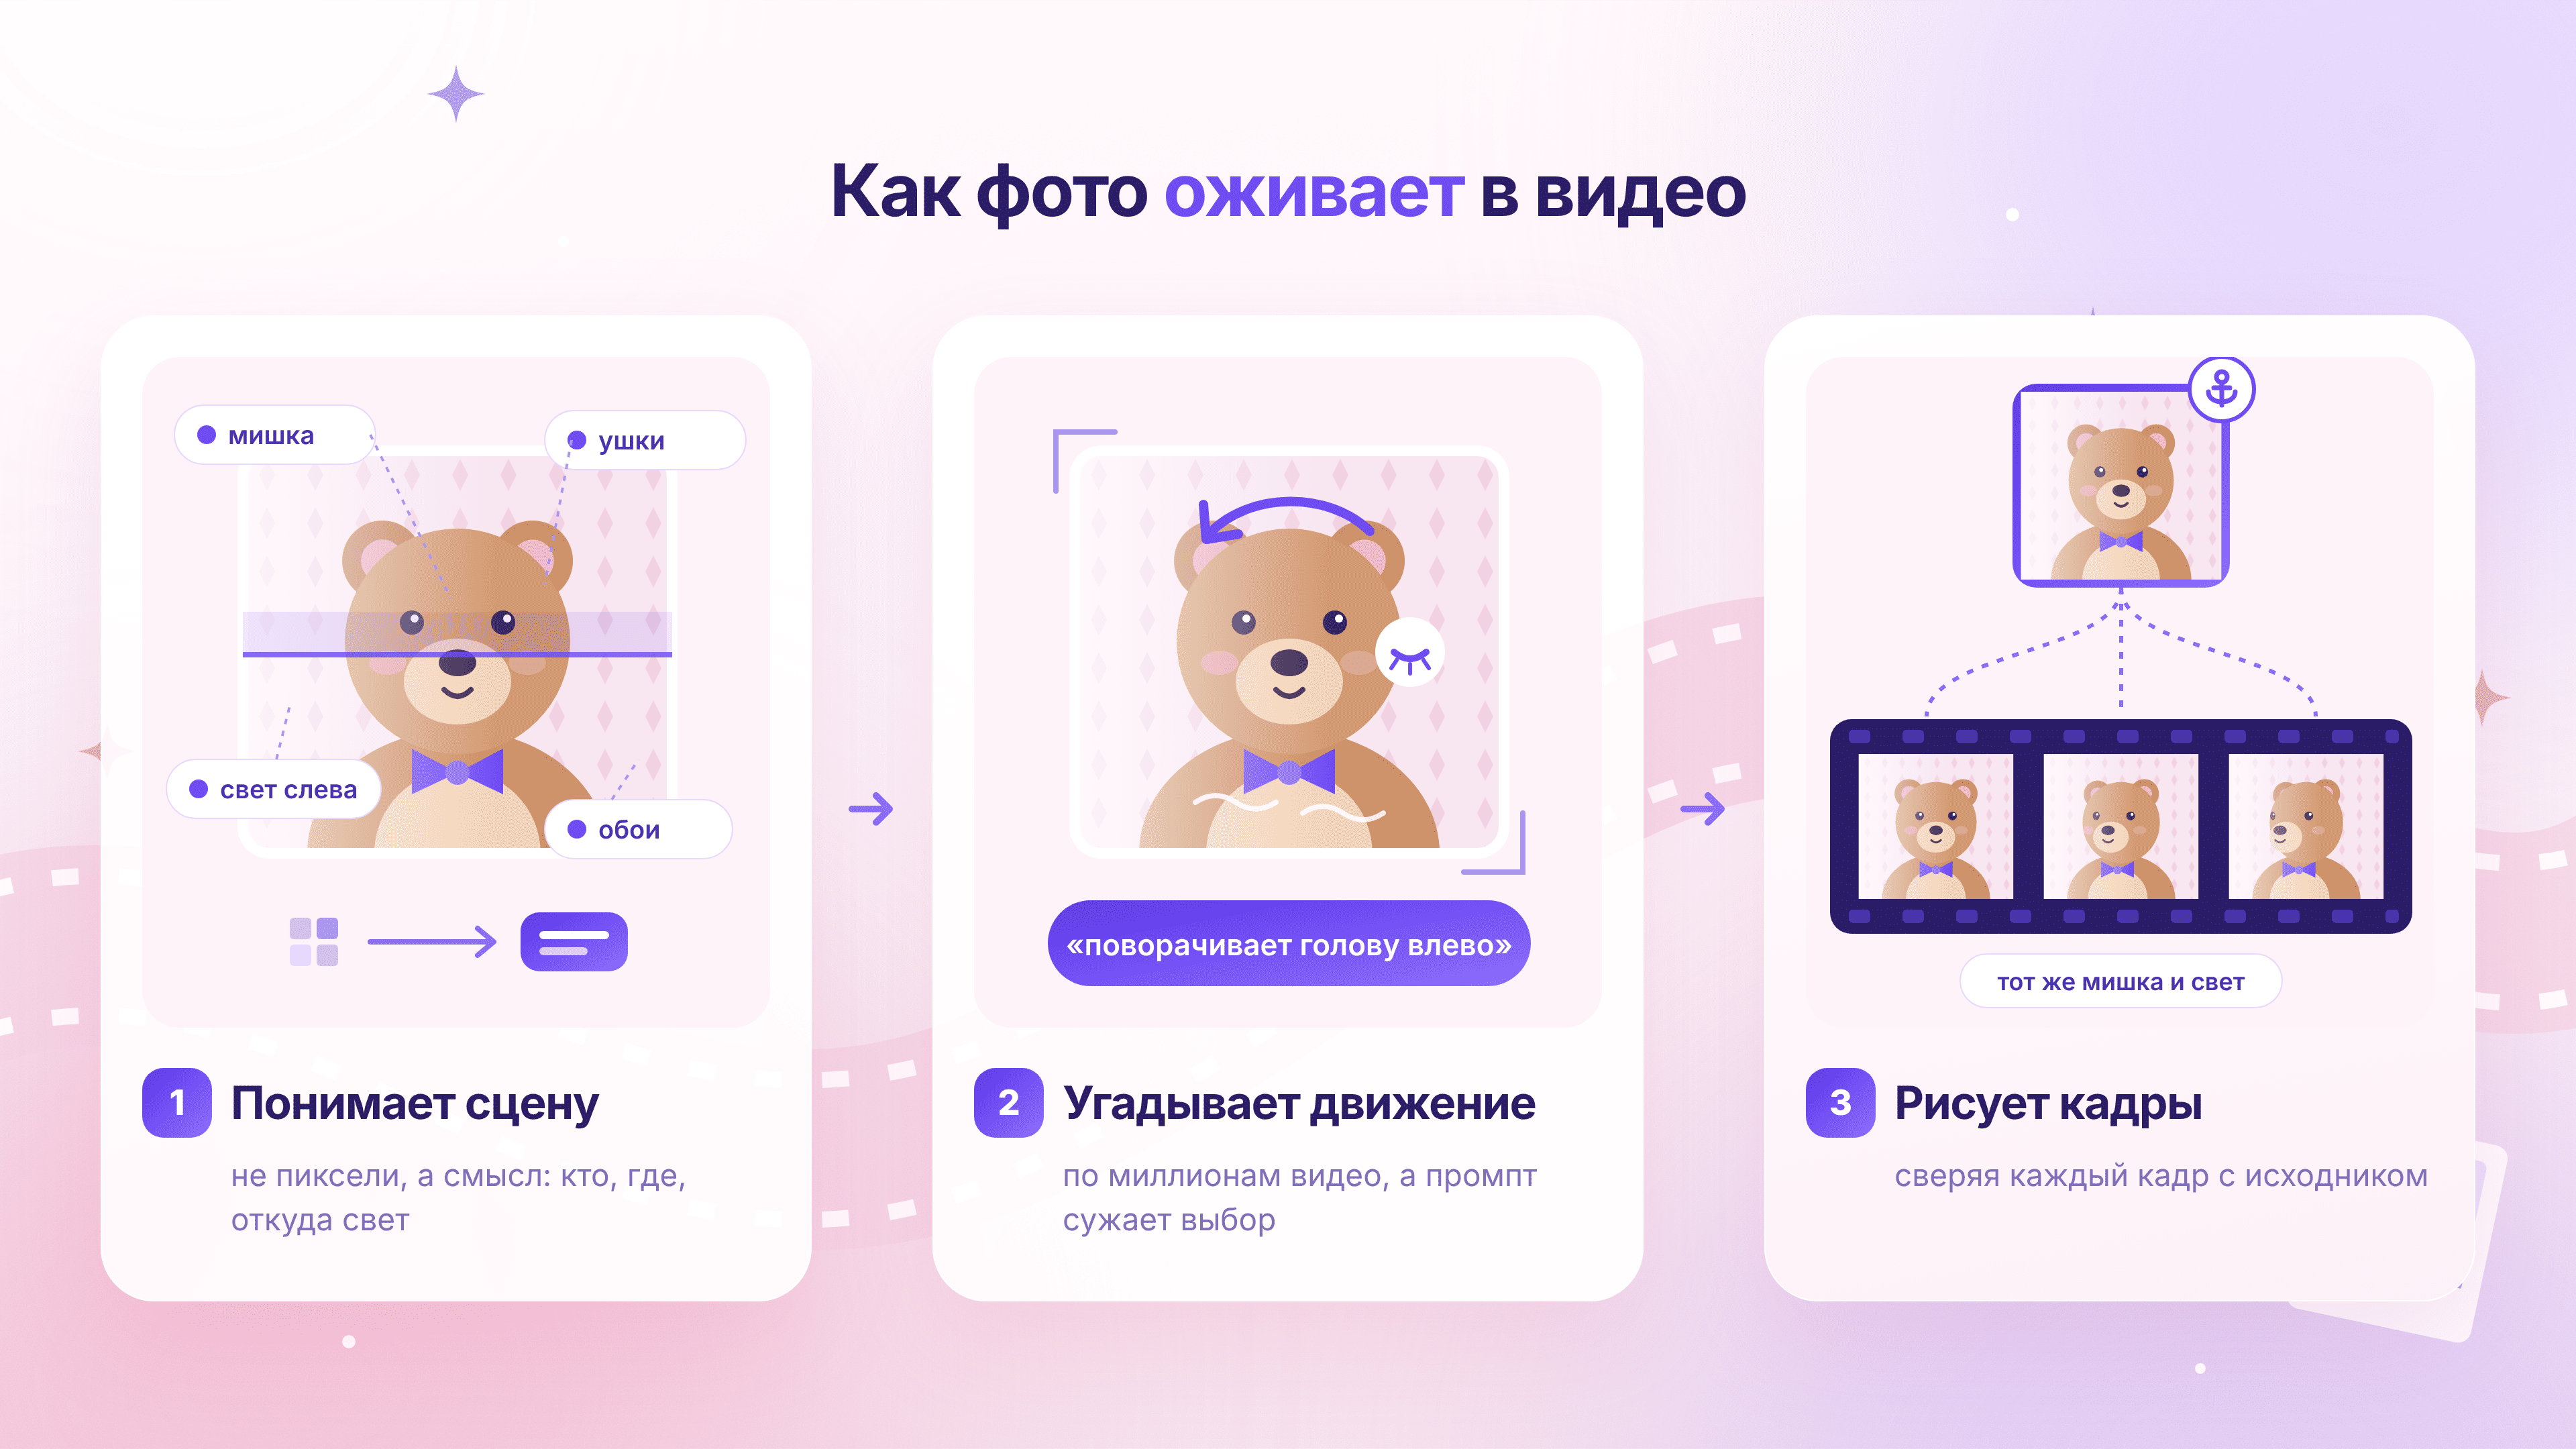
Шаг 1: модель «читает» фото. Она строит внутреннее представление сцены. Это не пиксели, а смысловое описание: пожилая женщина, волосы убраны вправо, свет падает слева, позади стена с обоями. Для этого используются энкодеры, обученные на огромных массивах изображений.
Шаг 2: предсказывает правдоподобное движение. Модель обучена на миллионах видео и «знает», как обычно двигаются похожие сцены. Лица моргают, вода рябит, ткань колышется, камера в любительском видео слегка дрейфует. Если есть текстовый промпт, он сужает выбор: «поворачивает голову влево» вместо любого другого движения.
Шаг 3: генерирует кадры, удерживая исходное фото как якорь. Каждый новый кадр сверяется с исходником, чтобы человек оставался узнаваемым, а цвета и освещение не уплывали.
Из этой схемы следует практический вывод, который сэкономит много попыток: модель гораздо надёжнее двигает камеру, чем объект. Когда камера медленно наезжает или смещается, нейросеть в основном переиспользует пиксели, которые уже есть на снимке, и лишь немного достраивает края. Когда же человек поворачивает голову, открывается область, которой на фото не было: ухо, щека, часть шеи. Её модель вынуждена придумать с нуля, и именно здесь появляется большинство артефактов. Поэтому для первых попыток лучше выбирать сценарии с движением камеры и небольшой мимикой, а не с разворотом на 90 градусов.
Два класса технологий генерации изображений
До выбора инструмента полезно понять, что под словами «оживить фото» подразумеваются разные подходы.
Анимация портрета (portrait animation)
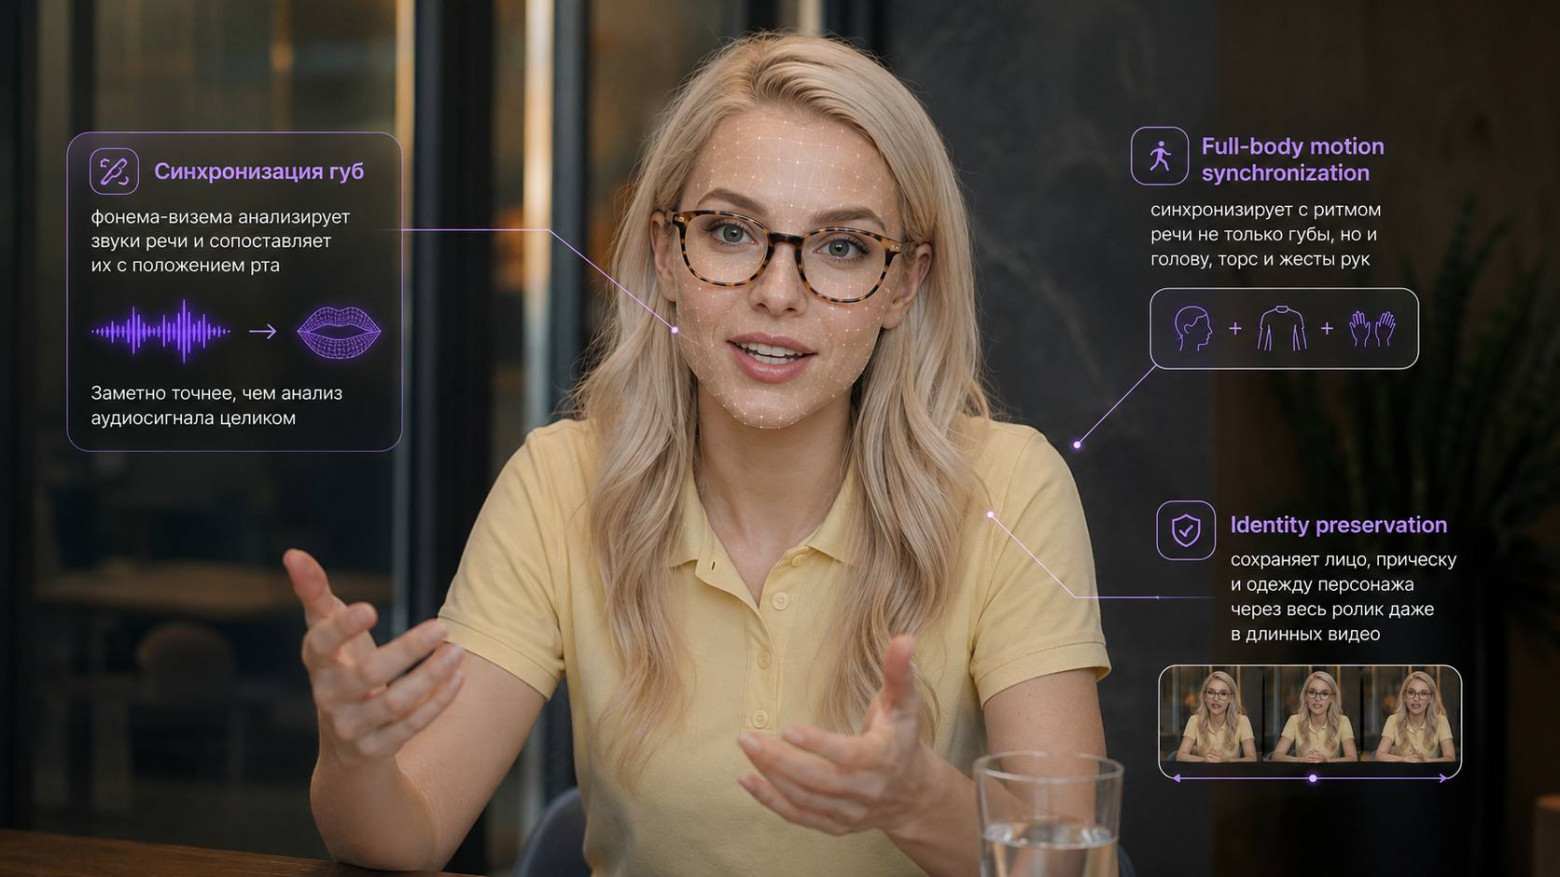
Специализированные модели для человеческого лица. Они работают с ключевыми точками лица, положением головы и мимикой, а обучены в основном на видео с говорящими людьми. Часто управляются не текстом, а «ведущим» видео (driving video): вы записываете себя на камеру, и модель переносит ваши движения на портрет. Другой вариант — аудиодорожка, под которую модель синхронизирует губы.
Что получается хорошо:
моргание, поворот головы в небольшом диапазоне, улыбка, движение бровей;
синхронизация губ с речью;
точная передача мимики с ведущего видео.
Что получается хуже:
сложный фон, который должен двигаться вместе с камерой;
несколько людей в кадре;
движение тела ниже плеч.
Характерные представители: LivePortrait от Kuaishou на генеративно-состязательной сети (GAN), а также диффузионные EMO от Alibaba, Hallo и EchoMimic. В большинстве своём это исследовательские проекты с открытым кодом, которые запускаются локально и требуют технической подготовки.
Генерация видео из изображения (image-to-video)
Универсальные видеомодели. Они не заточены под лица и работают с любой сценой: пейзажем, интерьером, товаром, животным, портретом. Двигаться может всё, что есть в кадре: волны, облака, дым, волосы на ветру, ткань. Управляются текстовым промптом.
С лицами такие модели работают чуть менее точно в микродеталях мимики, чем специализированные. Зато они не ломаются на нестандартных ракурсах, могут двигать камеру, добавлять звук и выстраивать короткий сюжет.
Сюда относятся Kling 3.0, Seedance 2.0 и Hailuo от MiniMax и др.
Что выбрать
Правило простое. Если нужно, чтобы конкретный человек на фото произнёс конкретный текст или повторил конкретную мимику, нужна анимация портрета. Если нужно, чтобы снимок «ожил» целиком (ветер, свет, движение камеры, небольшое действие), нужна генерация видео из изображения. Для большинства бытовых задач, от старых семейных фото до роликов для соцсетей, хватает второго класса.
Три поколения генерации фото: почему это стало возможно только сейчас
Поколение 1 (2019–2021): ключевые точки
First Order Motion Model (FOMM), представленная на конференции NeurIPS в 2019 году, стала одним из первых массовых методов. Она находила ключевые точки на исходном фото и на ведущем видео и переносила движение точек с одного на другое. Метод работал, но при заметных отклонениях от исходной позы появлялись разрывы, а лицо теряло сходство с оригиналом.
Поколение 2 (2022–2024): GAN и первые диффузионные модели
LivePortrait, опубликованная Kuaishou в июле 2024 года, довела подход с ключевыми точками до практического уровня. Модуль «сшивания» (stitching) аккуратно вклеивает анимированное лицо обратно в кадр, а модуль перенаправления (retargeting) позволяет отдельно управлять глазами и губами. Параллельно появились диффузионные модели: AnimateDiff в 2023 году научил генераторы изображений делать короткие анимации, а EMO от Alibaba и VASA-1 от Microsoft весной 2024 года показали говорящие портреты по одной фотографии и аудиодорожке. Качество мимики резко выросло, но ролики оставались короткими, а генерация медленной.
Поколение 3 (2025–2026): диффузионные трансформеры
В лучших видеомоделях архитектура U-Net, на которой строились ранние диффузионные генераторы, уступила место диффузионному трансформеру (Diffusion Transformer, DiT). Трансформер лучше масштабируется и держит согласованность на длинных последовательностях кадров. Модели стали мультимодальными: Kling 3.0 по описанию разработчиков построена на архитектуре Multi-modal Visual Language и обрабатывает текст, изображения, аудио и видео в одной системе. Звук теперь генерируется вместе с картинкой за один проход, а длина ролика выросла до 15 секунд.
Что изменилось в оживлении фото в 2025–2026 годах
Три вещи отличают современные ролики от того, что было ещё два года назад.
Понимание объёма. Ранние модели воспринимали снимок как плоскую картинку и двигали пиксели в двух измерениях. Современные неявно выводят из фото трёхмерную структуру сцены. Поэтому голова может повернуться без того, чтобы лицо «стекало», а тени смещаются вместе со светом.
Временная согласованность. Освещение, цвет и мелкие детали остаются стабильными от кадра к кадру. Без этого даже правильное движение выглядит как мерцающее слайд-шоу.
Звук в одном проходе. Kling 3.0 и Hailuo H3 генерируют речь, шумы и музыку вместе с видео, синхронно с тем, что происходит на экране. Раньше звук приходилось накладывать отдельно и подгонять вручную.
Три модели для генерации изображений
Kling 3.0 в России
Модель Kuaishou вышла 5 февраля 2026 года. Генерирует ролики до 15 секунд, звук создаётся вместе с видео, синхронизация губ поддерживает несколько языков, включая английский, китайский, японский, корейский и испанский. Хорошо передаёт движения тела: походку, жесты, колыхание одежды. Сохраняет читаемый текст на упаковке и вывесках, что важно для роликов с товарами. Есть Motion Brush: можно нарисовать траекторию движения прямо поверх кадра.
Слабые места: строгая модерация (в обзорах фильтровались даже безобидные запросы) и длинные очереди на бесплатном тарифе в часы пик. На официальном сайте бесплатно дают 66 кредитов в день, которые сгорают через сутки, ролики выходят в пониженном разрешении и с водяным знаком. Платные тарифы стоят от $10 до $180 в месяц.
Для чего брать: портреты с живыми деталями, динамичные сцены с движением тела, ролики с товарами.
Hailuo H3 (MiniMax) в России
Китайская MiniMax выпустила Hailuo H3 (она же Hailuo 3.0) 31 июля 2026 года. Модель генерирует видео в нативном 2K при 24 кадрах в секунду, длиной от 5 до 15 секунд за раз. Диалоги, звуковые эффекты и атмосферные шумы создаются вместе с картинкой. В качестве референсов можно передать до 9 изображений, 3 видео и 3 аудиоклипа, а готовое видео редактировать текстовыми инструкциями без полной перегенерации. Для оживления фото у MiniMax есть и предыдущая линейка 02 Image To Video в вариантах Pro и Standard.
Сильная сторона Hailuo — физика материалов: волосы, ткань и вода двигаются с правдоподобной инерцией. При оживлении фото загруженный снимок становится первым кадром, и модель старается не менять композицию и внешность.
Для чего брать: портреты и старые снимки, где важно не исказить лицо; сцены с природой, водой, тканью.
Seedance 2.0 (ByteDance) в России
Seedance 2.0 вышла в феврале 2026 года. Длительность задаётся фиксированными шагами: 4, 5, 6, 8, 10, 12 или 15 секунд. Разрешение 480p, 720p или 1080p, форматы от 21:9 до 9:16. Модель принимает на вход текст, изображения, аудио и видео, а через API можно задать первый и последний кадр. Это удобно, когда нужен переход «было → стало», например превращение старого чёрно-белого снимка в цветную сцену.
Сильная сторона — кинематографичная работа камеры: плавные облёты, наезды, отдаления. Ограничение для портретов: для синхронизации губ нужен внешний аудиофайл, а генерация звука в API по умолчанию выключена.
Для чего брать: сцены с выразительным движением камеры, переходы между двумя кадрами, ролики с несколькими референсами.
Если коротко:
лучшая передача движения тела и мимики: Kling 3.0;
максимальное разрешение и аккуратность с лицом: Hailuo H3;
работа камеры и контроль над первым и последним кадром: Seedance 2.0.
Почему результат иногда выглядит жутко
Эффект «зловещей долины» (uncanny valley) знаком всем, кто пробовал оживлять портреты: движение вроде бы правильное, но смотреть неприятно. Чаще всего причин три.
Взрывные согласные
Когда портрет говорит, сложнее всего даются звуки «п», «б», «т». Губы при них смыкаются и резко размыкаются, и даже небольшое расхождение с аудиодорожкой мозг замечает сразу. Модели лучше справляются с плавными гласными, чем с этими короткими событиями.
Скрытые области
Когда голова поворачивается, появляются части лица, ушей и шеи, которых не было на исходнике. Модель дорисовывает их по общим представлениям о человеческой анатомии, и они часто выглядят размыто или «пластилиново». Чем сильнее поворот, тем больше придуманного.
Слишком плавное движение
Живой человек двигается с микродрожанием, неравномерными паузами, лёгкой асимметрией. Идеально плавное, равномерное движение мозг считывает как механическое. Парадоксально, но немного «неряшливости» в промпте («small spontaneous movements», «natural irregular blinking») часто делает результат живее.
Требования к фото для генерации
Не все снимки одинаково хорошо поддаются оживлению. Что помогает:
фронтальный ракурс или близкий к нему;
чёткое лицо без сильного размытия;
ровное освещение без резкой тени на половину лица;
нейтральное выражение и закрытый рот: так у модели больше вариантов для анимации;
разрешение не меньше 512 пикселей по короткой стороне, а лучше от 1024.
Что мешает:
сильный профиль, больше 45 градусов от фронтального положения: при повороте почти гарантированы артефакты;
очки с бликами, которые искажают область глаз;
рука или предмет перед лицом: модель путает слои;
тёмный фон, сливающийся с волосами: теряется граница, и волосы «растекаются» по фону.
Старые фотографии с царапинами и выцветанием лучше сначала отреставрировать: убрать дефекты, поднять резкость, при желании раскрасить. Генератор изображений вроде Nano Banana справляется с этим по текстовому описанию, а оживлять потом уже чистый снимок.
Пять промптов для первого запуска
Промпты подходят для Kling, Hailuo и Seedance в режиме генерации из изображения. Видеомодели обучены в основном на англоязычных описаниях и точнее понимают операторскую терминологию, поэтому английский даёт более стабильный результат.
Мягкое оживление портрета:
The person gently turns their head slightly to the left, blinks once naturally, a subtle warm smile appears. Soft breathing is visible. The camera holds still. Cinematic portrait, warm lighting. Keep all facial features exactly as in the original photo.
Волосы и ветер:
Hair moves gently in a soft breeze, slight head movement with the wind, natural blinking. The subject looks slightly off-camera. Golden hour light, cinematic feel.
Архивное чёрно-белое фото:
The subject makes the smallest natural movements: barely perceptible breathing, one slow blink, a calm micro-expression. Preserve the vintage photographic look and film grain. Do not modernize the image.
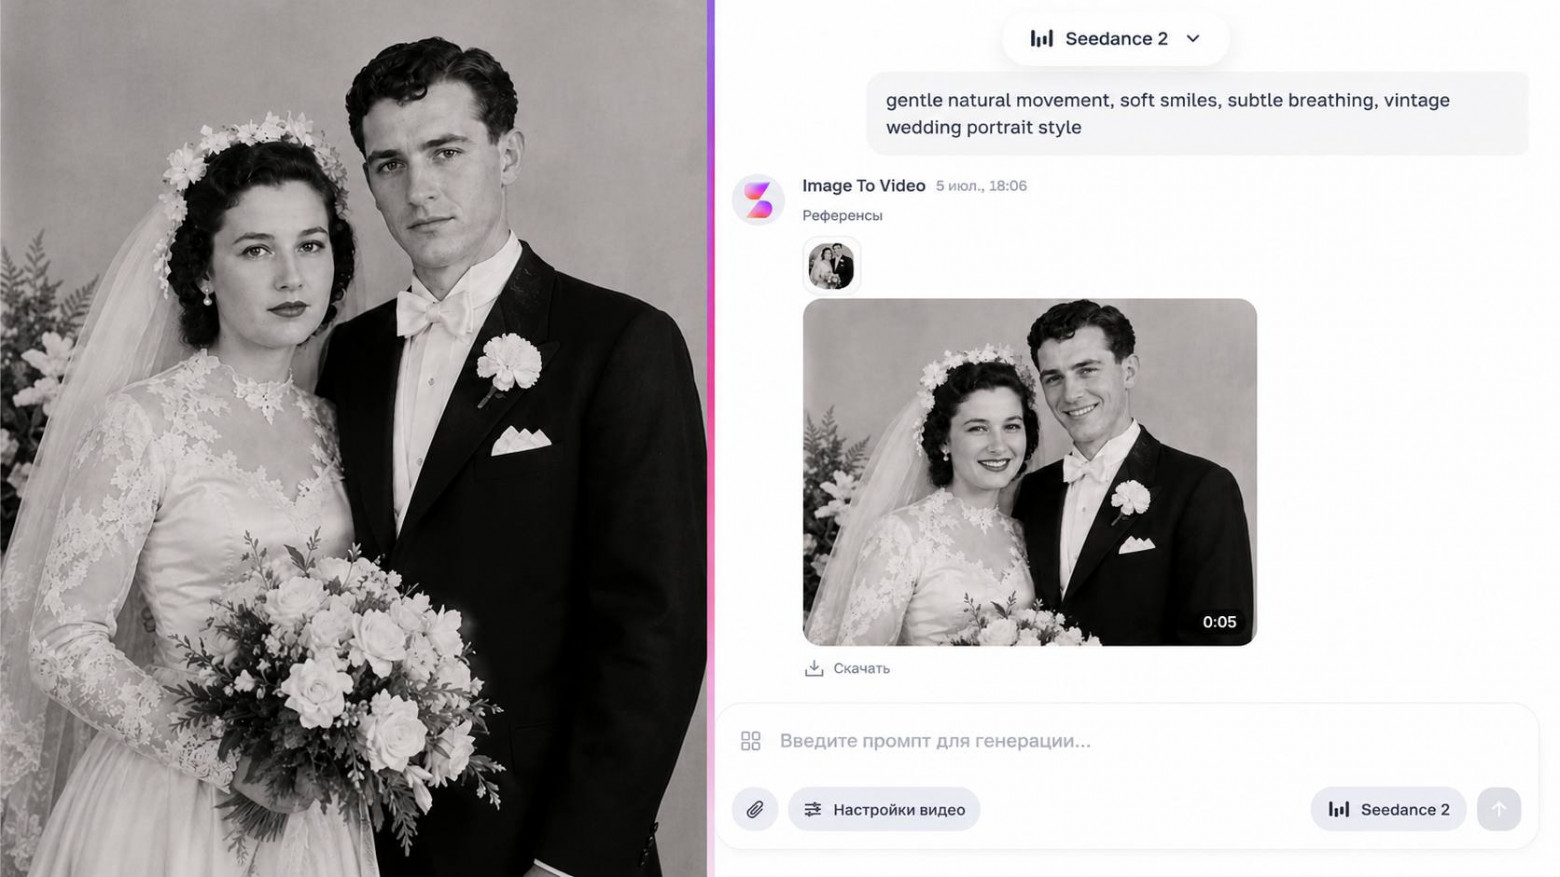
Пейзаж с человеком:
Waves roll gently onto the shore, sea foam dissolves, clouds drift slowly. The person in the foreground remains still except for natural breathing and hair movement.
Групповое фото:
People in the photo breathe naturally, with small spontaneous movements, eyes blink at different intervals. The camera holds still. Warm nostalgic atmosphere.
Обратите внимание, что во всех промптах движения минимальные. Это сознательный выбор: на первых попытках лучше получить живой, но спокойный ролик, а потом наращивать динамику.
Думаем, гайд «Джеймс Кэмерон вам позавидует: как выжать 1000% из нейросетей для видео» пригодится, если вы захотите большего: не просто оживить фото, а создать свой полноценный клип, рилс или повторить новый тренд. Структура хорошего запроса одинакова для текстовых и видеомоделей: контекст, действие, ограничения, формат результата.
Частые ошибки
Ошибка 1: просить слишком много движения. «Человек встаёт, идёт к окну, оборачивается и машет рукой» на 5 секундах почти гарантированно даст искажения. Одно-два действия на ролик.
Ошибка 2: поворачивать голову на большой угол. Чем больше поворот, тем больше модель дорисовывает с нуля. Для первых попыток ограничьтесь лёгким наклоном и движением камеры.
Ошибка 3: загружать фото в низком разрешении. Миниатюра из мессенджера или скриншот с экрана дают размытое лицо, которое модель «додумает» по-своему. Ищите оригинал или сначала увеличьте разрешение.
Ошибка 4: не указывать, что должно остаться неизменным. Без явного «keep facial features unchanged» модель может «улучшить» лицо: сделать кожу глаже, а черты правильнее, и человек перестанет быть похожим на себя.
Ошибка 5: модернизировать архивные снимки. Старое фото, превращённое в чёткое цветное видео с современной картинкой, теряет атмосферу. Если хотите сохранить эпоху, прямо попросите оставить зерно и винтажную обработку.
Ошибка 6: публиковать чужие фото без согласия. По статье 152.1 Гражданского кодекса РФ обнародование изображения человека допускается только с его согласия. Оживлённое фото друга или коллеги перед публикацией стоит показать ему самому.
Заключение
Оживление фото прошло путь от переноса ключевых точек, при котором лицо расползалось на первом же повороте, до диффузионных трансформеров, которые генерируют ролик до 15 секунд со звуком и движением камеры. Внутри всё сводится к трём шагам: понять сцену, предсказать движение и сгенерировать кадры, держась за исходник. Отсюда главные практические правила: двигайте камеру смелее, чем объект, давайте модели чёткое фронтальное фото и прямо указывайте, что должно остаться неизменным.
Во второй части перейдём к практике: разберём сложные сценарии и способы получить стабильный результат.
Попробовать Kling, Hailuo и Seedance на одном и том же фото можно в SpeShu.AI. По промокоду HABRSPESHUAI действует бонус 15% к сумме пополнения.
Частые вопросы
Какая нейросеть лучше всего оживляет фото?
Однозначного лидера нет. Kling 3.0 сильнее в движениях тела и мимике, Hailuo H3 даёт максимальное разрешение и аккуратнее обращается с лицом, Seedance 2.0 лучше работает с камерой и переходами между кадрами. Для портретов, которые должны произносить конкретный текст, существуют отдельные модели анимации портрета.
Почему при оживлении фото меняется лицо?
Модель достраивает то, чего не видно на снимке, и при повороте головы придумывает недостающие части лица. Ещё одна причина в размытом или мелком исходнике. Помогают фронтальный ракурс, хорошее разрешение, минимальный поворот и явная просьба сохранить черты лица в промпте.
Можно ли оживить старое чёрно-белое фото?
Да, это один из самых популярных сценариев. Лучше сначала отреставрировать снимок (убрать царапины, поднять резкость), а в промпте попросить сохранить винтажную эстетику и зерно, чтобы модель не превратила его в современное видео.
Чем анимация портрета отличается от генерации видео из фото?
Анимация портрета специализируется на лице и обычно управляется ведущим видео или аудиодорожкой: переносит конкретную мимику или синхронизирует губы с речью. Генерация видео из изображения работает с любой сценой и управляется текстом: двигает камеру, фон, волосы, одежду.
Сколько длится видео, сгенерированное из одного фото?
Современные модели генерируют за один раз от 3–5 до 15 секунд. Hailuo H3 позволяет продлить ролик примерно до 30 секунд инструментом продления. Более длинные сюжеты собирают из нескольких генераций.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.