Пока вы учите агентов читать чеки, ABBYY Hot Folder просто работает
Первый AI-агент появился в моей семье 21 января 2026 года. Он построен на OpenClaw с обвязкой на локальных моделях и быстро размножился до пяти помощников по решению семейных и бизнес-задач.
В мае 2026 я рассказывал о том, как устроена моя система. Все условно локально, где 20% моих запросов всё же уезжают к “большому брату”: имеющиеся мощности пока не позволяют решать некоторые задачи не выходя из дома. Например: я общаюсь с агентом и могу подождать две, три или даже пять минут. Но семь-восемь часов мне ждать сложнее. Примерно столько занимает обработка локальной моделью Bonsai-8B вопроса: какие упражнения для моего колена рекомендовали терапевты, какие дали наибольший эффект и что ещё стоит сделать с учётом их рекомендаций.
Задача: прочитать чек
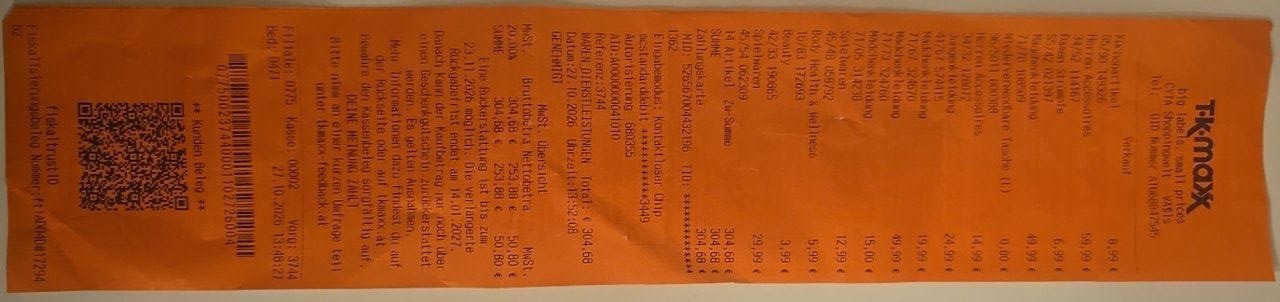
Один из агентов, Receipt Logger, был рожден c задачей обрабатывать входящие чеки и помогать следить за расходами. В феврале 2026 года процесс казался простым: получить изображение чека, распознать, записать информацию в форме, пригодной для домашней бухгалтерии.
Я думаю: если бы в феврале у меня был свободный доступ к нормальной LLM, то на этом бы все и закончилось, да и статья эта тоже бы не появилась. Но увы, доступа к нормальным LLM у меня тогда не было, зато были безумие, отвага, и несколько компьютеров уровня Lenovo Yoga 500: до 16 ГБ оперативной памяти и около 0,5 ГБ видеопамяти. И, хотя, единственным верным решением было бы покупка подписки - я вместо этого решил искать локальный способ превращения символов с картинок в обычный текст.
И, знаете, далеко ходить не пришлось. Решение для меня существовало уже очень давно. Я знаком с ним примерно с 2008 года. И это… та-да!
ABBYY Hot Folder (в составе пакета FineReader)
Сам пакет до сих пор стоит у меня на компьютере и прекрасно делает то, с чем не всегда справляются некоторые крупные мультимодальные модели: подготовить изображение к распознаванию — выровнять его, уменьшить искажения строк, подобрать контраст и цветность — и превратить фото букв на разных языках в редактируемый текст.
Внутри ABBYY FineReader есть Hot Folder — по-настоящему фантастическая штука. Он по расписанию заглядывает в папку, находит новые необработанные файлы картинок, выполняет необходимые преобразования, распознаёт их и сохраняет результат. Фактически это мини-агент по превращению картинок в текст с автоматизацией.
Недостатки: Windows, кхм платно, минимальные возможности работы через командную строку. Во время распознавания - загрузка CPU может достигать 100%.
Если ваш агент работает локально на Windows, статью, в общем-то, можно закончить читать на этом абзаце. Hot Folder решает задачу чтения чеков, в последних версиях FineReader результат невероятно качественный. В режиме ожидания программа занимает около 25 МБ памяти. Для меня FineReader много лет был и остается однозначным must-have.

Так вот. Пока Hot Folder, предлагает мне всё необходимое и даже больше, мне захотелось чего-то другого. И поскольку я у мамы инженер, я решил применить свои инженерные навыки.
docTR: две модели вместо одного Hot Folder
Так у моих агентов появился скилл ocr-reader на основе Python-скрипта. В февральской версии скилл содержал только docTR — распознавание текста с изображений. В docTR используются две модели: одна находит области с текстом, а другая распознаёт находящиеся в них символы.
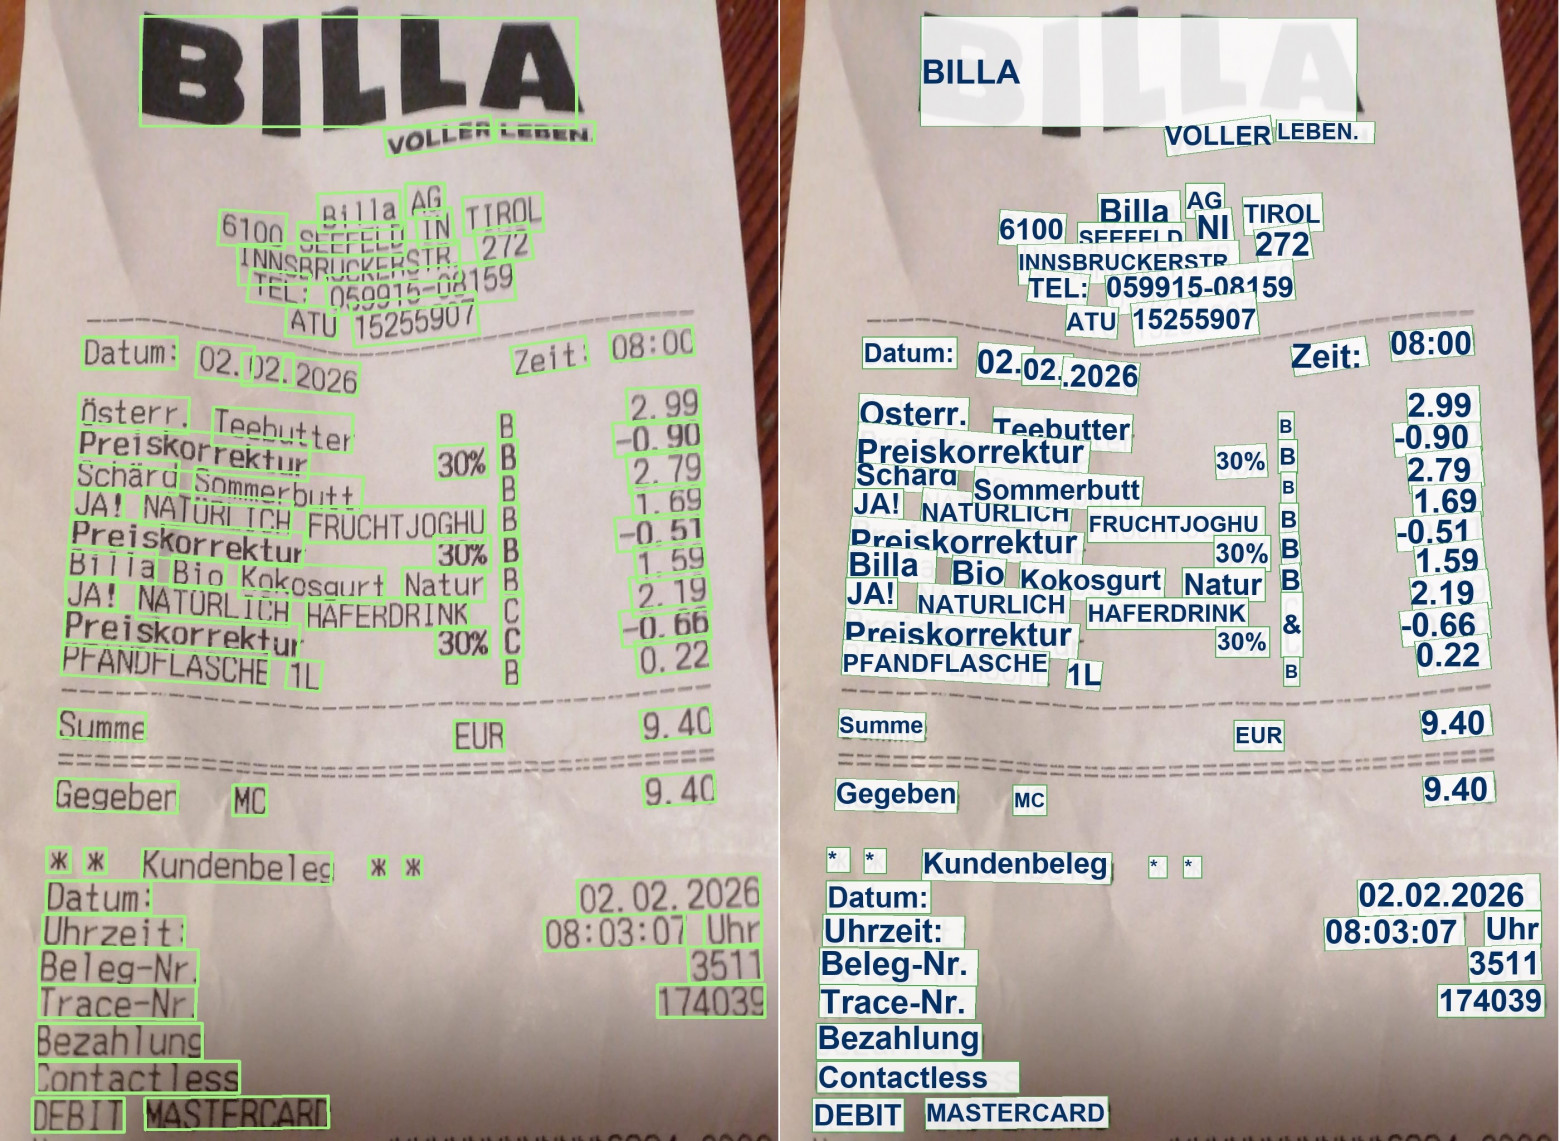
К сожалению, выбранная мной модель не поддерживает кириллицу. Но жизнь так сложилась, что последние двадцать лет все мои чеки и счета не на кириллице.
С 2025 года у меня накопилось около полутора тысяч чеков. В процессе обработки выяснилось, что не все чеки приходят в идеальной форме: одни сфотографированы криво, другие помяты, третьи деформировались или выцвели от нагрева. Поэтому появились две дополнительные задачи.
Мечта всех кудрявых: выпрямить.
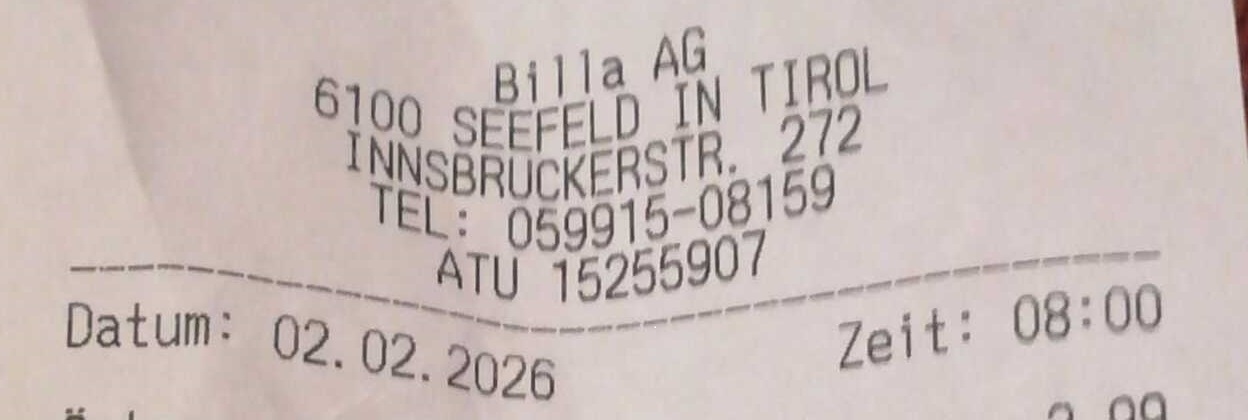
Сначала я попытался самостоятельно исправить искажение чека на фотографии: ищем на изображении большой описывающий многогранник и преобразовываем его в прямоугольник. Python, Pillow, немного инженерной мысли — всё как положено.
Но на реальных чеках стало понятно, что это решение нежизнеспособно. Позже я нашёл инструмент, он сейчас используется в skill, docuwarp, который выпрямляет искажённые области через CV.
Буквы в слова, слова в строки.
После выпрямления и распознавания выяснилось, что этого всё ещё недостаточно. Даже если привести контур документа к прямоугольнику, строки текста внутри изображения могут быть искажены.
docTR возвращает распознанные слова, но их нужно нанизать на строки. Найти эти строки оказалось не так просто, как кажется.
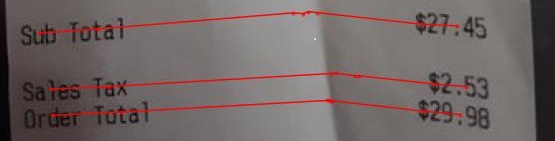
По привычке я пытался написать собственный “великий уравнитель” — ошмётки моих преобразований есть в скилле. После я обнаружил модуль bbox-align, который помогает выстраивать прямоугольники слов на строку. Работает он не всегда идеально, но мою задачу решил.
Напоминаю: Hot Folder всё это время продолжал смеяться над моими потугами, выполняя предобработку изображений и распознавание практически мгновенно.
В процессе выяснилось, что иногда координаты углов текстового прямоугольника внутри docTR приходят не так, как ожидается. Из-за этого последующее распознавание тоже работает неожиданно. Например, можно получить зеркальное распознавание слова: SOHO отображается в OHO2. Или перевернутое MIX превращается в WIX, или зеркально перевернутое: “69” становится “69”.
Происходит это не так часто, чтобы я наконец взял и исправил проблему: дальше всё равно есть еще этапы работы Агента с чеком. Хотя ничто кроме лени не мешает мне сейчас натравить Codex на эту задачу.
Кстати, описанный docTR-скилл как и эта статья написаны мясным мешком, и ни одна LLM при их создании не пострадало. Как там говорят… Ни одно животное не страдало, испытывали сразу на людях.
Конечно же, Hot Folder в это время копошился в уголочке, способный по команде беспроблемно распознать сотни чеков.
История с PyCon Italia
Интересная проверка моего подхода произошла в кулуарах после PyCon Italia 2026. Представитель израильского стартапа, занимавшегося распознаванием чеков и транзакций, показал мне платёжку, которую ни одна LLM на тот момент нормально не распознавала. Для проверки открытую на телефоне платёжку на иврите сфотографировали под углом.
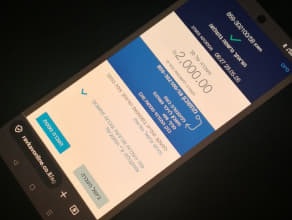
Распознавание иврита - это непростая задача, особенно если есть рукописная стилизация. Готовой модели распознавания иврита в docTR не нашлось, нужно дообучение, благо docTR это умеет. Но для нормальной работы нужно еще дополнительно изменить координаты bounding boxes: на иврите текст пишется и читается справа налево, а числа в тексте (номера, годы, цены) пишутся слева направо. Именно тогда в скрипте появилась функция align.
Платёжку удалось распознать, Фаундер удивился: он был уверен, что распознать такую платёжку быстро и локально - невозможно. Фаундеры вообще такие дети - в сказки верят! Наивнее их бывают только Startup-инвесторы.
А Hot Folder в этот момент просто работал и перемалывал входящие документы на разных языках.
Агент одного скилла
Летние эксперименты и дальнейшее совершенствование скилла привели к интересному результату. Из настроек агента, который обрабатывает чеки, постепенно исчезло всё лишнее и он превратился в агента одной задачи: распознать чек и записать информацию из него. Эта структура пережила множество итераций с разными моделями и их подключением и при этом продолжала стабильно работать.
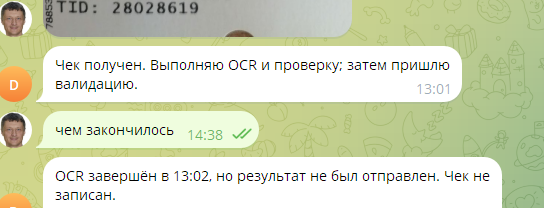
Опубликованный мной скилл на GitHub агент использует для превращения картинки в текст. Задачи записи и регистрации обработки вынесены из скилла в настройку агента.
Чуть позже на Хабре мне попалась отличная статья о том, что скиллы могут хранить данные, например в skill/data/. Сначала я не придал этому значения. Но после реорганизации скилла и переезда на другие компьютеры выяснилось, что именно это позволяет моим агентам иметь центральный архив входящих чеков и избегать повторного распознавания. При ужесточении политик и ограничении зон видимости агентов в **OpenClaw ** такой вариант продолжает работать после любых обновлений, или не работать… как и весь OpenClaw после 2026.8.xxx версий.
К сожалению, я больше не могу найти ту статью. Если вы знаете, о чем речь, напишите в комментариях.
Аналогично я поступил с кэшем моделей: обновление модели может изменить её поведение, а мне этого не хотелось. Скачанная модель внутри скилла гарантирует стабильное поведение pipeline.
А в это время Hot Folder… Ну вы поняли. Он просто работал.
На сцену выходит Xiaomi-OCR
Следующая итерация скилла случилась совсем недавно и, собственно, подтолкнула меня осилить эту статью: появилась модель Xiaomi-OCR-0. О ней также писали на Хабре. Вместе с моделью появились и skill, и MCP-сервер. Это говорит о том, что культура подготовки open-source к использованию LLM растёт. А появление небольшой модели меня обнадеживает, что рост в сторону работы с локальными LLM не отрицательный.
Ну так вот. Идея прекрасна: локальная OCR-модель с обвязкой, которая делает для меня то, что я хочу. Но реальность оказалась немного другой.
Для работы я создал скилл под мои задачи.
Сначала был вариант с постоянно запущенной моделью в llama.cpp. У меня используется форк atomic-turboquant, собранный под мой ноут HUAWEI D16: 16 ГБ RAM, 0,5 ГБ VRAM и Vulkan.

Модель используется редко, но постоянно занимает память. Скорость падает в зависимости от чека: при работе llama.cpp с Xiaomi-OCR-0-q4_k_m.gguf стартовые 120tops сползают до 7 tops. Тестовый чек обрабатывается около 30 секунд.

Команда запуска:
llama-server -m "Xiaomi-OCR-0.Q4_K_M.gguf" --mmproj "Xiaomi-OCR-0.mmproj-bf16.gguf" -c 8192 --parallel 1 --reasoning off --temp 0
Контекста 8192 хватит для чеков до 90 позиций. Категорически важно -mmproj для включения распознавания картинок и --reasoning off иначе модель не даст текст транскрипта.
промпт:
Extract all information from the document image and represent it in markdown format. Preserve every line, including headers and footers. Organize the text in reading order. Transcribe numbers and text exactly as printed. Do not summarize.
В llamacpp есть настройка, выгружающая модель после использования. Но я ж python-п_ограммист! Вот я и решил реализовать запуск через Python: скрипт запускается по запросу, сам загружает модель, а после работы выгружает модель. Так работает и мой предыдущий скилл с docTR, и другие скиллы — это позволяет балансировать между скоростью, тяжёлыми задачами и загрузкой памяти на простеньком ноутбуке.
К этому моменту оперативной памяти у моих агентов стало уже 24 ГБ; в начале истории её было меньше. С видеопамятью по-прежнему всё скромно.
Я тестирую Xiaomi-OCR уже пару недель. Когда чёткий и ровный чек, модель отлично распознаёт текст. Но на нечётких изображениях она ведёт себя странно:
Теряет куски текста.
Если что-то идёт не по плану, выдаёт иероглифы.
Не справляется со шрифтом Зюттерлина — я живу в Австрии — и вместо него тоже выдаёт иероглифы.
В комментариях к новости @Quiensabe написал, что у него всё работает с русскими буквами. Я повторить результат не смог: снова иероглифы. Очень прошу Даниила уточнить в комментариях, какая версия Xiaomi-OCR использовалась. Может, я не тот dense взял.
Короче, как я понял, у XIAOMI правило: в любой непонятной ситуации ходи с бубей и выдавай иероглифы!
Небольшо бенчмарк обоих вариантов skill.
распознаем красный чек из начала статьи
XIAOMY-OCR | docTR |
|---|---|
Tikmax big labels, small prices CYA Shop/Invert W&I Tel: 010 Number Atk0047545 14 Artikel — 304,68 € | XOWPL big labels, small prices CYTA shoppinovelt VASIS Tel: an Rumier ATU68047545 Montonartikel verkouf — 6,99 € 14 Artikel ZurSumme — 304,68 € Zahlungsdetails MwSt. Übersicht Rückerstattung bis 23.11.2026 Filiale: 775 |
Вас, конечно же, не удивит, но Hot Folder только удивлённо пожал плечами над этой выдуманной проблемой. Хотя, нет. Не все проблемы выдуманы:
Немного о чеках и боли
Распознавание чеков, казалось бы, стандартная процедура. Но разработчикам кассовых систем Европы удалось превратить её в борьбу за выживание. Если вы не в теме, просто поверьте: разнообразие чеков может привести любого филателиста в экстаз.
Названия магазина в виде текста нет, оно содержится в картинке.
При оплате наличными дата появляется один раз — в самом низу чека, после позиций, отчёта, рекламы, купонов и «спасибо за покупку».
Торговая сеть одна, но определить филиал невозможно: указан только юридический адрес. Точнее, мне не удалось. Подозреваю, что по каким-то кодам на чеке номер филиала всё же можно определить и затем вести базу.
Скидки и налоги зашифрованы буквами A, B, C, D, E…
Товары зашифрованы буквами, которых может даже не быть в собственном наименовании товара.
Товар называется «товар». Это прямо стандарт, ну почти.
В одном магазине может быть несколько разных товаров с разной ценой и с одинаковым артикулом. Я до сих пор в шоке.
На разных чеках информация представлена по-разному — даже в одном и том же магазине. Поэтому у меня не получилось использовать связку ABBYY Hot Folder + Form Editor. Раньше с этим как-то помогал жить ML, а появление LLM здорово упростило работу с чеками.
Кто сталкивался с подобными проблемами — поделитесь. А если знаете кого-то, кто дизайнит чеки, передайте ему, что я его когда-нибудь найду!
Итоги.
Задача локального распознавания чеков агентами решаема, и на 2026 год, довольно просто автоматизируется. Я создал собственное решение, хотя использовать готовое было в разы и проще и быстрее и… Да!
Качайте, пробуйте, пишите отзывы или не качайте и не пробуйте и не пишите. Решать вам.
По правилам принятым на HABR, в конце статьи должна была быть ссылка на какой нибудь телеграм канал, но у меня
нет телеграм-канала!
Что, правда нет?
ага!
Даже секретного?
и секретного тоже.
А под другим названием?
А почему ты спрашиваешь?
Ну мне ооочень интересно!
Это нездоровый интерес, между прочим.
А зачем тогда столько спойлеров?
ну, может это проверка на упрямство?
И как, я прошёл?
Нет, но ты меня пугаешь.
Я ещё даже не начинал.
У тебя последний шанс остановиться.
Поздно. Я уже эмоционально вложился.
ЛАДНО!
Ты сделал 1 байт кликов, и я сдаюсь. У меня есть канал, и он совсем не про программирование.
Если эта публикация вас вдохновила и вы хотите поддержать автора — не стесняйтесь нажать на кнопку
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.