Атаки на ЦОДы: как меняются сценарии резервирования и защиты инфраструктуры
Серия атак на цифровую инфраструктуру заставила операторов дата-центров пересмотреть привычные модели проектных угроз. Схемы компонентного резервирования N+1 и 2N надежно защищают от предусмотренных проектом отказов: выхода из строя отдельного агрегата, короткого замыкания на вводе или сбоя дизель-генератора. Однако прямое внешнее воздействие развивается иначе: ударная волна, пожар или осколочные повреждения выводят из строя инфраструктуру целыми секторами, из-за чего кабельные трассы, распределительные устройства и контуры охлаждения основной и дублирующей системы могут пострадать одновременно.
Межплощадочный Disaster Recovery существует давно, однако само наличие резервной площадки или законтрактованных мощностей автоматически не гарантирует непрерывность сервисов. Поэтому проверять нужно не только наличие резерва, но и границы сценариев, при которых он сохраняет работоспособность. Разбираемся, как на практике оценить достаточность инженерного резервирования: какие сценарии каскадных повреждений должны учитываться в проекте, на какую нагрузку рассчитаны дублирующие системы и какими испытаниями подтверждается их готовность.
Границы ответственности и метрики доступности
Надежность сценариев аварийного восстановления строится на четком разграничении зон ответственности между всеми участниками цепочки:
Оператор площадки (Colocation) отвечает за инженерную инфраструктуру и условия размещения оборудования в пределах предусмотренных проектом режимов и договорных обязательств.
Облачный провайдер отвечает за виртуализацию, вычислительные платформы и доступность сервисов в границах соглашения об уровне обслуживания (SLA).
Владелец сервиса определяет архитектуру приложения, регламенты переключения трафика, процедуры резервного копирования и непрерывность бизнес-процессов.
Устойчивость инфраструктуры ЦОД не решает задачу доступности автоматически: сервис должен быть подготовлен к процедурам аварийного восстановления на резервной площадке с учетом допустимого простоя. При этом распределенная архитектура не является обязательным условием для любой системы — выбор модели определяется балансом между бюджетом и двумя метриками:
RPO (Recovery Point Objective) — допустимый объем потерь данных, выраженный во времени (насколько актуальными должны быть восстановленные данные).
RTO (Recovery Time Objective) — допустимое время технологического простоя до возвращения сервиса в рабочий режим.
Попытка закрыть обе задачи одним инструментом не работает. Синхронная репликация минимизирует RTO и RPO, позволяя оперативно поднять сервис на резервной площадке. Однако репликация транслирует любые разрушительные изменения — от логических сбоев до действий вредоносного ПО.
Резервные копии дополняют репликацию. Их защитная роль обусловливается независимостью хранения и доступа, сохранением предыдущих версий и проверенной возможностью восстановления.
Горячий резерв всех сервисов нужен не каждому проекту: решение определяется критичностью систем, целевыми RTO/RPO и стоимостью.
Физическая защита и независимость инженерных резервов
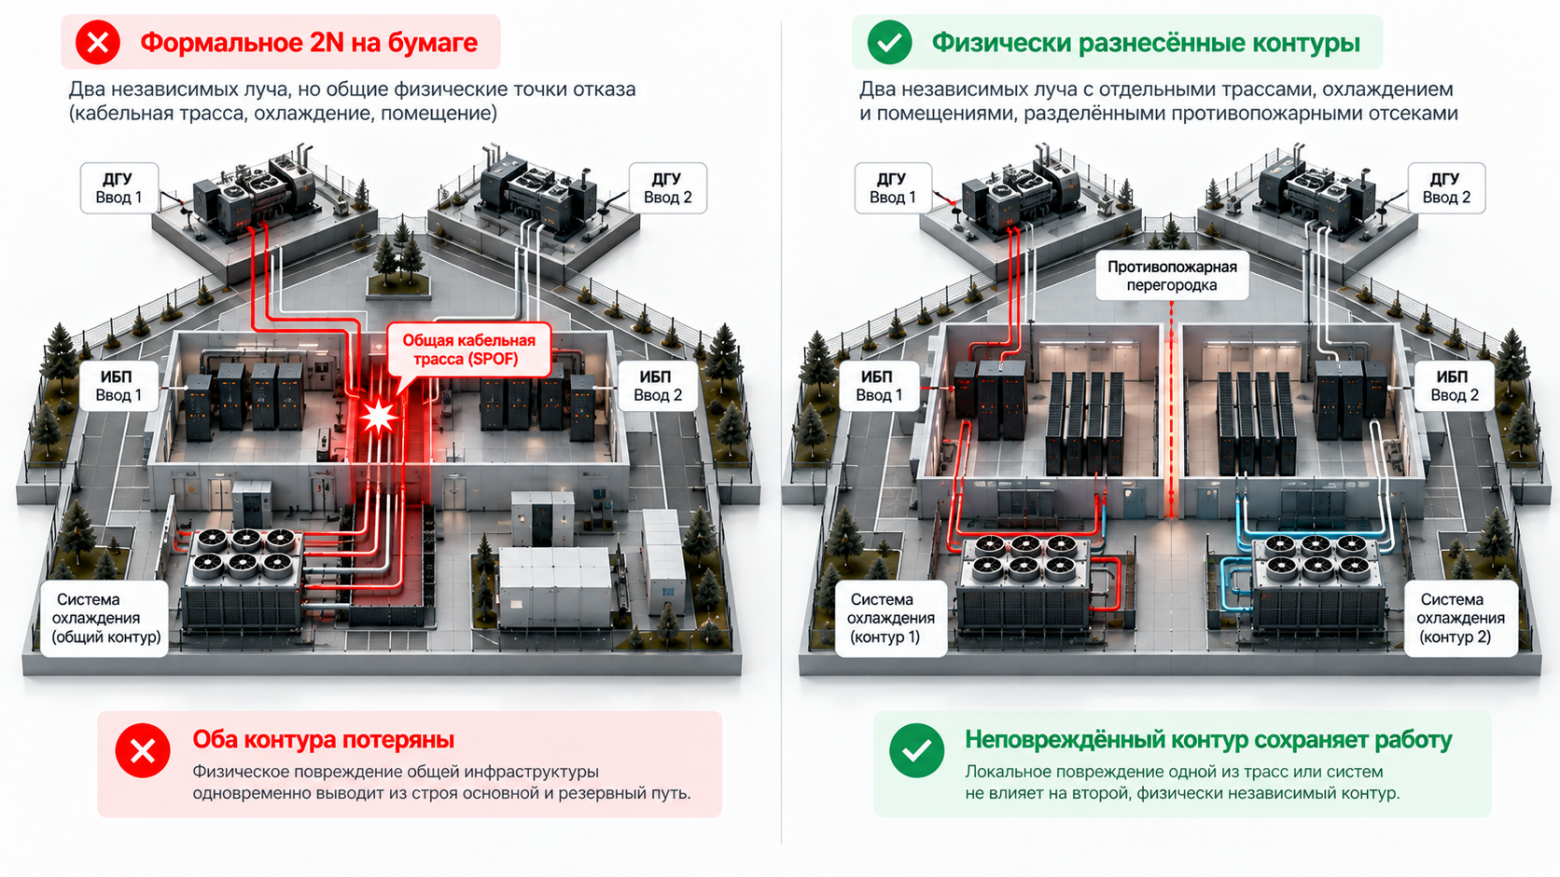
Когда угроза носит характер физического разрушения, классический расчет надежности по схемам N+1 или 2N перестает быть гарантией непрерывности. Эти резервы проектировались в расчете на отказ конкретной единицы оборудования, но они бессильны перед фактором, который одновременно выводит из строя основной и резервный контуры — например, если кабельные трассы обоих вводов уложены в одном коллекторе, а насосные группы стоят в общем незащищенном помещении.
Вопросы активной защиты находятся вне зоны контроля оператора дата-центра — это задачи государственных служб. В зоне ответственности инженеров ЦОДа остается пассивная физическая защита и живучесть обеспечивающей инфраструктуры, которая требует последовательного подхода:
Обследование и моделирование угроз: аудит уязвимости открытых площадок и несущих конструкций с выявлением скрытых общих точек отказа.
Оперативные меры без остановки объекта: установка пассивных барьеров (сетчатые конструкции, защитные экраны), зонирование открытых площадок противопожарными и противоосколочными перегородками.
Модернизация и капитальные решения: разнесение коммуникаций. Силовые кабельные трассы, контуры охлаждения, оптические вводы связи и распределительные щиты разводятся по независимым маршрутам и секторам здания, снижая риск общего отказа в пределах расчетного воздействия.
Автономность требует защиты всего комплекса обеспечивающих систем. Если на объекте уцелели серверные стойки и генераторы, но повреждена кабельная трасса управления или разрушен внешний контур теплообмена, дата-центр не сможет продолжать работу. Время до технологического останова зависит от характера повреждений, текущей нагрузки и тепловой инерции машинных залов. Независимость резерва означает способность дублирующего контура поддерживать работу инфраструктуры при локальном повреждении одной из зон площадки.
Потеря одной и нескольких площадок: сценарий каскадного отказа
Расчет отказоустойчивости на уровне одного объекта упирается в предел: если площадка обесточена полностью или разрушена, локальные резервы бессильны. Однако и распределение нагрузки между несколькими дата-центрами требует проверки на тяжелые сценарии — в частности, на последовательную потерю площадок, когда первый объект еще не успел восстановиться, а второй выходит из строя.
Готовность к каскадной аварии определяется остаточной емкостью уцелевшей инфраструктуры:
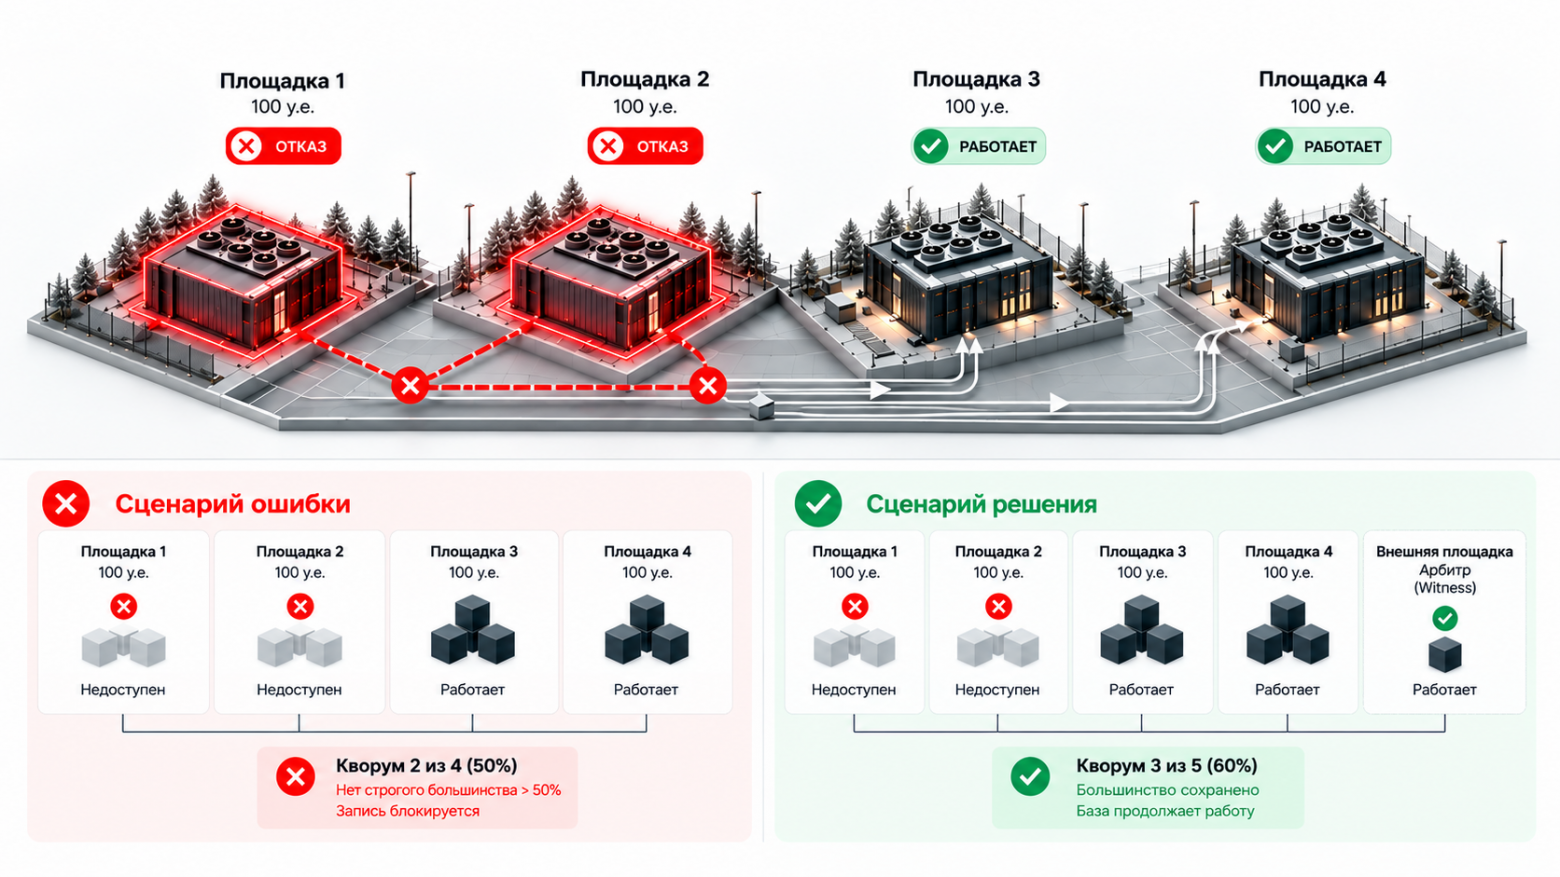
Условный расчет емкости: допустим, инфраструктура распределена по четырем независимым площадкам равной мощности (по 100 условных единиц). При выходе из строя любых двух ЦОДов суммарная остаточная емкость составит 200 единиц. Чтобы система продолжала функционировать без деградации, совокупная нагрузка, которую требуется сохранить после аварии, не должна превышать 200 условных единиц.
Инженерные допущения: такой сценарий реализуем при соблюдении базовых условий — вычислительные ресурсы на уцелевших площадках совместимы, сетевые каналы обладают достаточной пропускной способностью без критического роста задержек, а актуальные данные и журналы репликации доступны независимо от вышедших из строя площадок.
Кроме доступной емкости по питанию и стойкам, существует барьер на уровне распределенных систем. Многие распределенные базы данных и кластерные платформы требуют соблюдения правила большинства (кворума) для подтверждения транзакций и защиты от рассогласования данных при нарушении связности.
При этом сохранение кворума зависит от фактического размещения голосующих узлов, а четыре физические площадки не означают автоматически наличие четырех голосов. Если схема размещения арбитров или распределения реплик не учитывает топологию аварии, потеря двух локаций может привести к утрате кворума и блокировке операций записи — даже если уцелевшие серверы исправны и запитаны от генераторов.
Поэтому готовность к потере площадок подтверждается комплексной проверкой сетевой связности, топологии кворумов и сценариев переключения при расчетной нагрузке.
Источники резерва и критерии выбора площадок
Поиск независимых локаций для распределенной инфраструктуры породил ряд полярных гипотез — от ухода под землю до выноса серверов за рубеж. Однако инженерный анализ показывает, что универсальных убежищ не существует, а ключевым барьером масштабирования остается доступ к энергосетям.
Скальные выработки и подземные сооружения
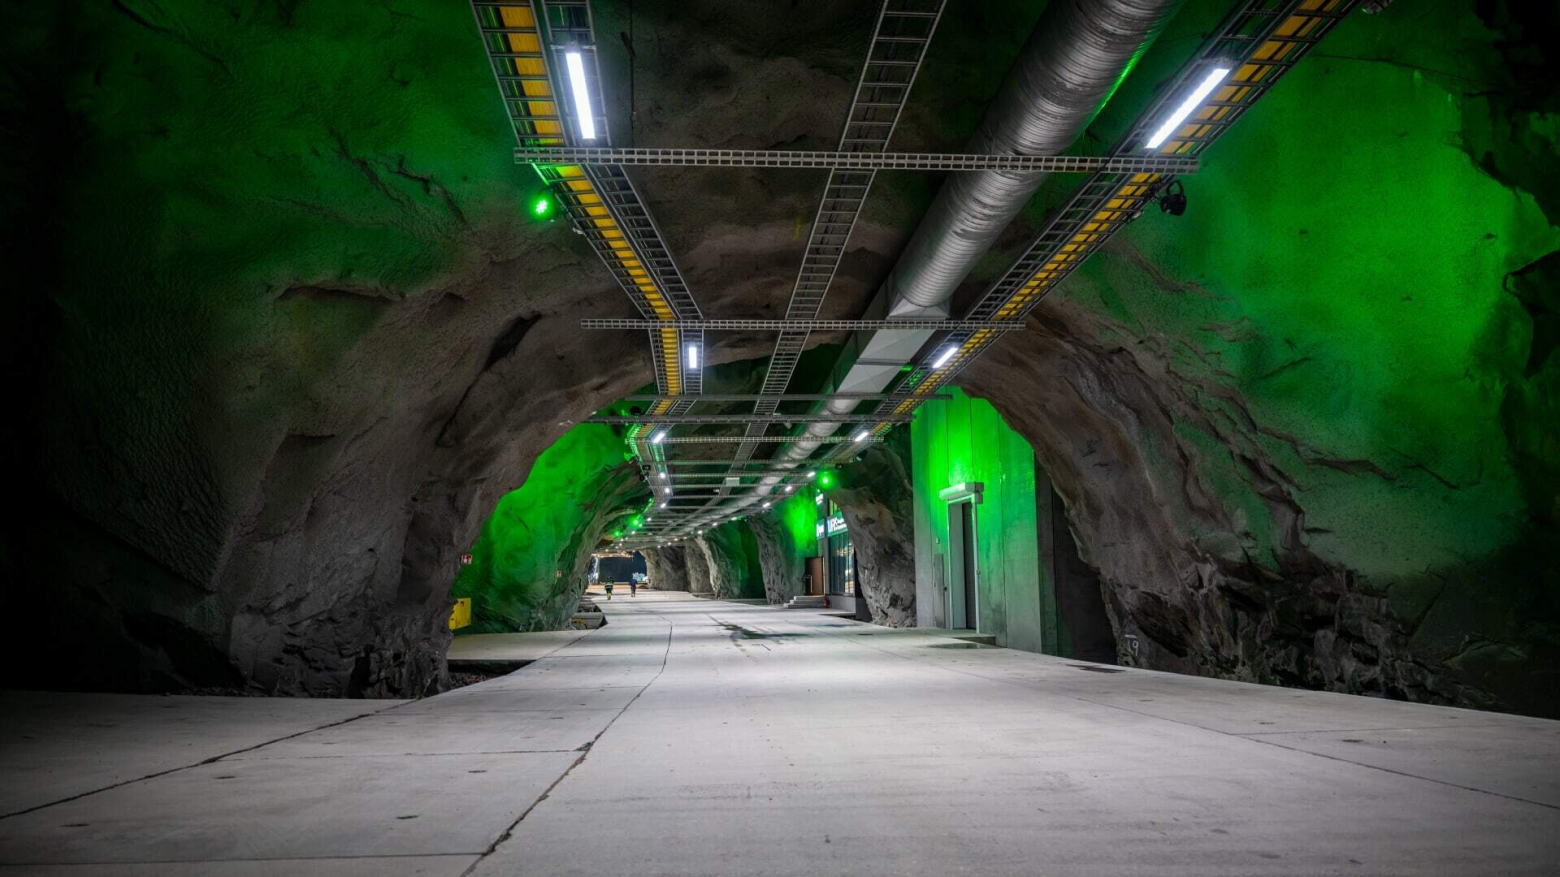
Идея размещения машзалов в горных массивах или закрытых выработках (как в норвежском Lefdal Mine Datacenter, использующем холодную воду фьорда) привлекает защитой от прямого физического попадания. К тому же подземное и бункерное базирование для критических объектов категории К1 уже фигурирует в отраслевых рекомендациях Минцифры.
Однако подземное или скальное исполнение не отменяет зависимости объекта от внешней среды и обеспечивающей инфраструктуры. Даже если серверные стойки укрыты под толщей породы, дата-центр требует постоянного притока воздуха для аварийных дизелей, контуров отвода тепла, внешних линий электропередачи и кабельных вводов связи. Сложность проектирования, логистика и капитальные затраты на таких объектах зависят от специфики проекта — в частности, от того, адаптируется ли готовое сооружение или ведется новое строительство под землей. При этом уязвимыми точками по-прежнему остаются открытые зоны ввода коммуникаций.
Вынос резервных вычислительных мощностей на удаленные площадки за пределы региона или страны ограничен сетевыми и нормативными факторами. Сетевая задержка физически привязана к длине кабельной трассы: с увеличением расстояния рост задержек может сделать синхронную репликацию неприемлемой для заданных требований приложения. Кроме того, передача и хранение данных в сторонней юрисдикции требуют детальной проверки применимых нормативных требований — в частности, законодательства о защите критической информационной инфраструктуры (КИИ) и персональных данных.
Региональная инфраструктура и энергетический фактор
Логичным сценарием распределения остается географический разнос площадок внутри страны. Однако выбор локации не сводится к поиску земельного участка с подходящей ценой и холодным климатом.
Главным ограничивающим фактором при строительстве ЦОДа выступает доступная электрическая мощность. Выбор площадки требует комплексного сравнения трех сценариев:
Технологическое присоединение к магистральным сетям: оцениваются фактические резервы мощности подстанций, сроки выдачи ТУ и тарифная сетка.
Строительство собственной постоянной генерации: оправдано при дефиците сетевой мощности или наличии доступа к дешевому природному газу, но требует капитальных вложений и развитой сервисной базы.
Комбинированные схемы: сочетание сетевого питания и собственной локальной генерации.
При этом важно разделять источник постоянного энергоснабжения и аварийный резерв. Наличие парка дизель-генераторных установок (ДГУ) в смете не гарантирует автономности объекта при длительном отключении внешней сети. Фактическая автономность складывается из запаса топлива на площадке, защищенности топливопроводов, гарантированных договоров подвоза солярки, наличия аварийного ЗИП и регулярных регламентных испытаний синхронного запуска генераторов под реальной нагрузкой.
Предложения по развитию резерва: межоператорские пулы и модульные площадки
Попытка каждого отдельного бизнеса построить персональный полноразмерный дублирующий ЦОД на случай маловероятной катастрофы упирается в экономическую нецелесообразность. Содержание незадействованных мощностей и пустующих серверных стоек может замораживать значительные бюджеты.
Межоператорский резерв инфраструктуры
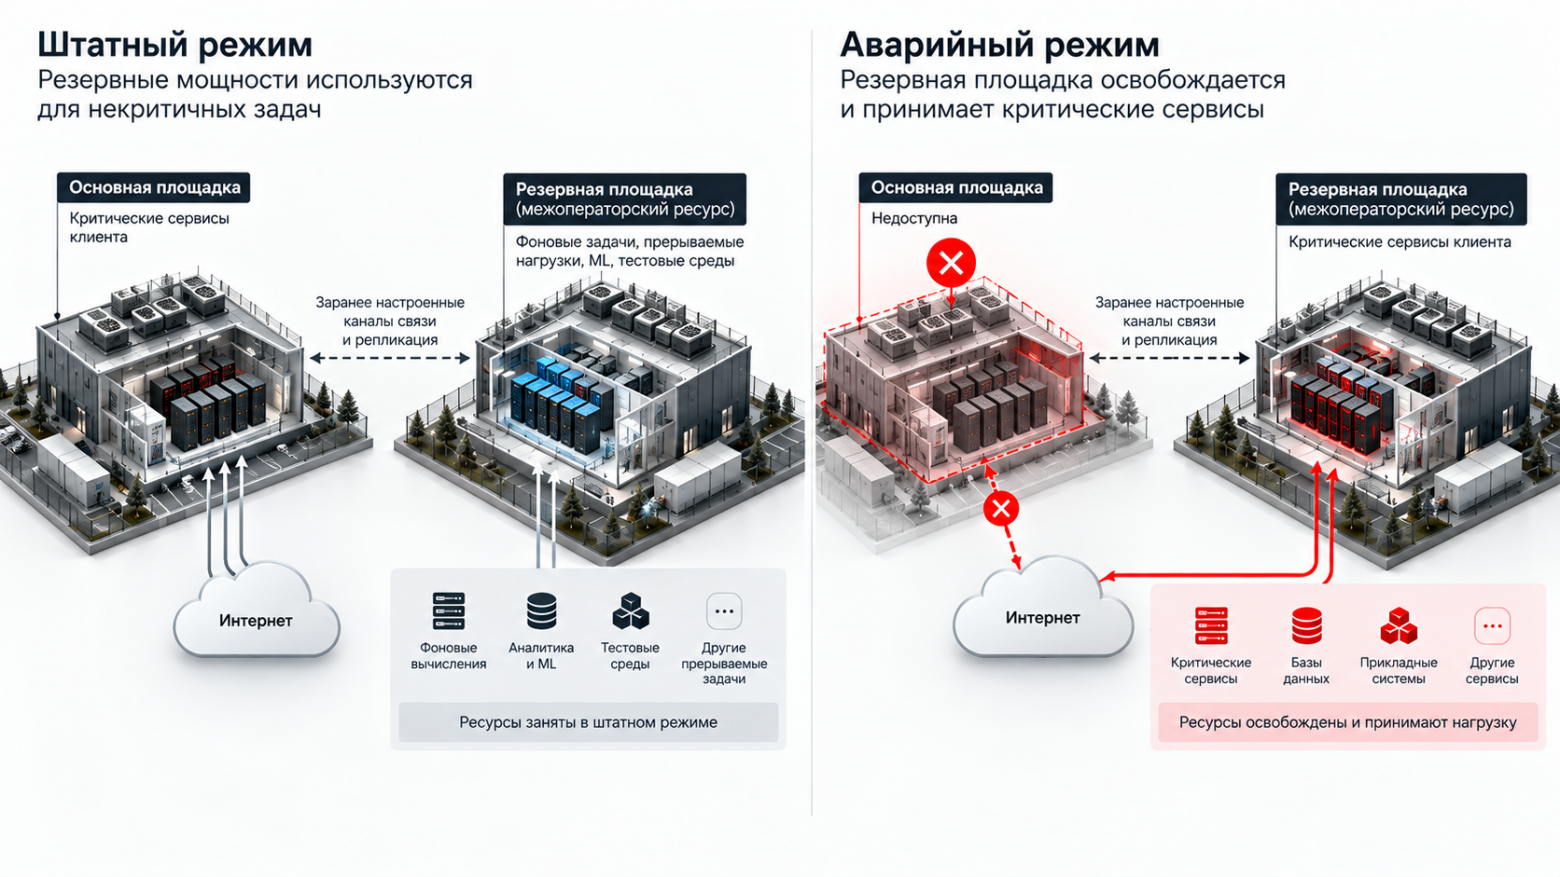
Основа этого подхода — соглашения между операторами дата-центров, в рамках которых оператор заранее закрепляет необходимые мощности на партнерской площадке под согласованный сценарий аварийного восстановления. В зависимости от архитектуры услуги предметом резервирования могут выступать подготовленные стойко-места, выделенная электрическая мощность или готовые вычислительные ресурсы. При этом запуск и восстановление прикладных систем обеспечивает владелец сервиса либо сам оператор, если услуга оказывается в формате управляемого аварийного восстановления.
Как устроена модель:
Фиксация параметров: в межоператорском соглашении заранее закрепляются сценарии активации, профили вычислительных узлов, гарантированная электрическая мощность, емкость систем хранения данных, пропускная способность резервных каналов и регламентный срок предоставления ресурсов.
Регламентная валидация: до наступления инцидента проводятся сквозные проверки совместимости платформ виртуализации, сетевой маршрутизации и изолированных каналов доступа к управлению.
Объединение ресурсов в общий пул позволяет совместно организовать и использовать резервную инфраструктуру, однако это не отменяет ее физическую стоимость. Для оговоренного сценария одновременных отказов достаточные мощности и резервы питания должны реально существовать на площадках, а не распределяться с избыточным овербукингом.
Чтобы частично компенсировать затраты, в штатном режиме резервные вычислительные мощности допустимо задействовать под прерываемые задачи (например, фоновые аналитические расчеты или обучение ML-моделей). Однако такой метод требует полной совместимости используемых платформ и подтвержденного регламента: прерываемая нагрузка должна гарантированно останавливаться, освобождая совместимые ресурсы за заранее проверенное время.
Сеть распределенных модульных площадок
Альтернативный и взаимодополняющий путь — поэтапное развертывание сети модульных дата-центров в энергетически профицитных локациях.
Модульный подход позволяет распределять капитальные затраты во времени и вводить мощности очередями под подтвержденный объем нагрузки. При этом поэтапный ввод мощностей не отменяет первоначальных затрат на базовую инфраструктуру площадки. К моменту запуска первой очереди должны быть подготовлены системы электроснабжения, охлаждения, связи, профильное оборудование и регламенты эксплуатации в соответствии с расчетной нагрузкой и сценарием резервирования. Конкретный состав инженерных систем определяется проектом.
Такие модульные объекты могут принадлежать отдельным операторам или выступать физической опорной базой для межоператорских резервных пулов.
Стоимость готовности, испытания и вопросы для аудита
Отказоустойчивость всегда упирается в стоимость владения инфраструктурой. Попытка зарезервировать 100% сервисов на случай одновременной потери любого количества площадок экономически нецелесообразна для большинства коммерческих компаний.
Практическая модель устойчивости рассчитывается от баланса рисков и бюджета:
Дифференциация сервисов: определяется ядро критических систем с околонулевыми RTO и RPO (процессинг, транзакционные базы данных, контуры оперативного мониторинга), для которых строится распределенный горячий контур.
Прерываемые нагрузки: вторичные сервисы, аналитические контуры и внутренние среды разработки в аварийной ситуации намеренно деградируют или останавливаются, освобождая вычислительные ресурсы и питание под основные задачи.
Изолированный рубеж: независимые холодные копии снижают риск необратимой потери данных при логических сбоях, сохраняя возможность восстановления даже при компрометации основного контура — при условии регулярной верификации целостности архивов и изоляции прав доступа.
Почему учения «на холостом ходу» ничего не доказывают
Вторая частая ошибка — формальное подтверждение готовности к авариям. Холостой запуск дизель-генератора или запуск тестовой виртуальной машины в изолированной среде не подтверждают устойчивость инфраструктуры при расчетном инциденте.
Комплексные испытания проводят по согласованной программе с предусмотренными мерами безопасности и процедурами восстановления:
Режимы генерации: проверяют принятие и сброс нагрузки, срабатывание автоматики (АВР) и, где предусмотрено проектом, параллельную работу и синхронизацию генераторов. Для этого используют нагрузочное оборудование либо контролируемую рабочую нагрузку, обязательно фиксируя, какие режимы проверены, а какие ограничения сохраняются.
Сетевые ограничения: проверка процедур миграции данных должна учитывать фактическую пропускную способность резервных каналов и рост задержек (RTT) при передаче массивов информации.
Независимость управления: переключения проверяются в условиях недоступности штатной корпоративной сети — у дежурной смены должен сохраняться изолированный доступ к управляющим контроллерам (ПЛК), ячейкам распределительных устройств и сервисным консолям оборудования.
Чек-лист для технического аудита инфраструктуры
Вместо абстрактных споров о надежности оператору ЦОДа и архитектору инфраструктуры достаточно ответить на шесть прямых инженерных вопросов:
Какой расчетный сценарий выдерживает система? Заложена ли в проект устойчивость к одновременному физическому разрушению сектора коммуникаций или потере двух площадок одновременно?
Какие именно услуги мы сохраняем? Согласован ли с бизнесом перечень критических систем, и разделена ли нагрузка на гарантированную и прерываемую?
Где физически находятся резервные мощности и данные? Разнесены ли кабельные трассы и трубопроводы хладоцентра по независимым маршрутам, и хранится ли неизменяемая резервная копия вне зоны риска?
Кто и как управляет восстановлением? Сохраняется ли контроль над коммутационными аппаратами и автоматикой генераторов при полной потере внешней сети и магистральной оптики?
Сколько времени занимает переключение на резерв? Подтверждены ли расчетные показатели RTO и RPO хронометражем реальных технологических операций?
Когда проводились комплексные испытания? Какие аварийные сценарии, переходные процессы и режимы нагрузки они фактически подтвердили?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.