300 тысяч job в час: как неправильный порядок Dispose в Serilog устроил утечку памяти
Периодически срабатывали алерты по памяти и CPU. Я начал расследование. Но расследование в итоге привело совсем в другое место – к Serilog.Context.
В результате удалось решить две независимые проблемы:
Длительное ожидание рабочих процессов;
Постепенный рост памяти;
Первый этап
На первом этапе я посмотрел, какие endpoint вызываются чаще всего. Стало видно, что несколько endpoint возвращают статичные данные: словари, переводы – которые редко меняются. Вместо постоянного обращения к базе данных был добавлен кэш. После оптимизации изменения были задеплоены в production. Но примерно в течение следующей недели стало видно, что проблема возвращается – ресурсы начали снова постепенно расти, а алерты снова начали срабатывать. Первоначальная оптимизация действительно помогла, но не устранила основную проблему.
Вторая проблема
Параллельно появился инцидент. В пиковый период сервис получал порядка 300к HTTP-запросов, каждый из которых приводил к постановке фонового job в Hangfire. Запросы поступают не одновременно, а распределяются в течение часа. Поэтому нагрузка имеет характерный пик.
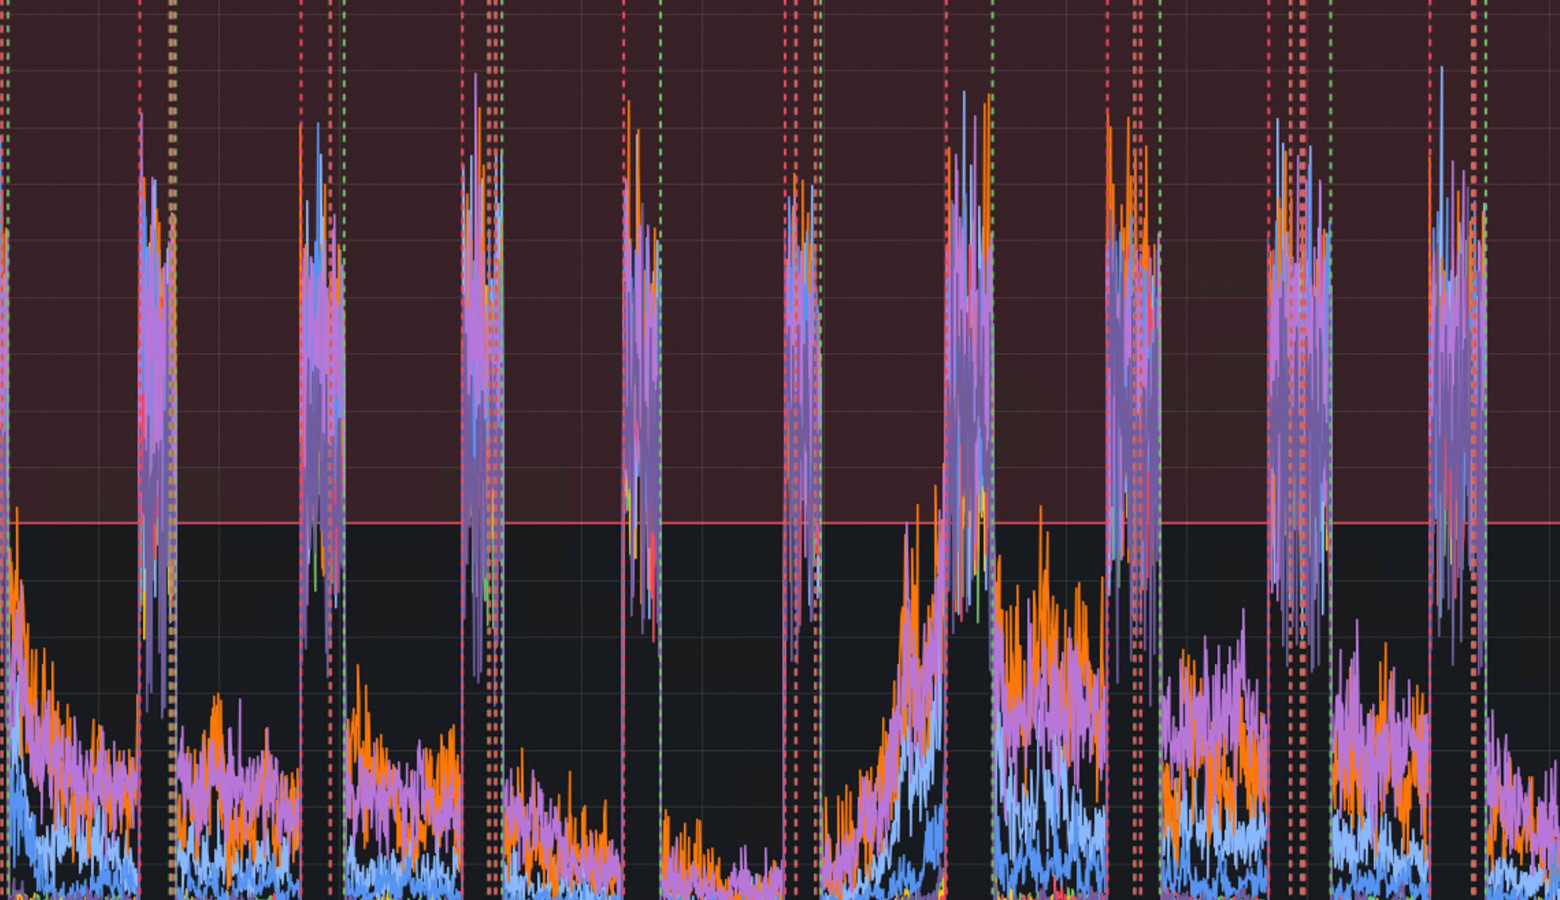
Именно в этот момент пользователь отправил запрос, у него произошел таймаут, а по логам видно, что между началом и завершением job прошло 1.5 часа.
Архитектурно:
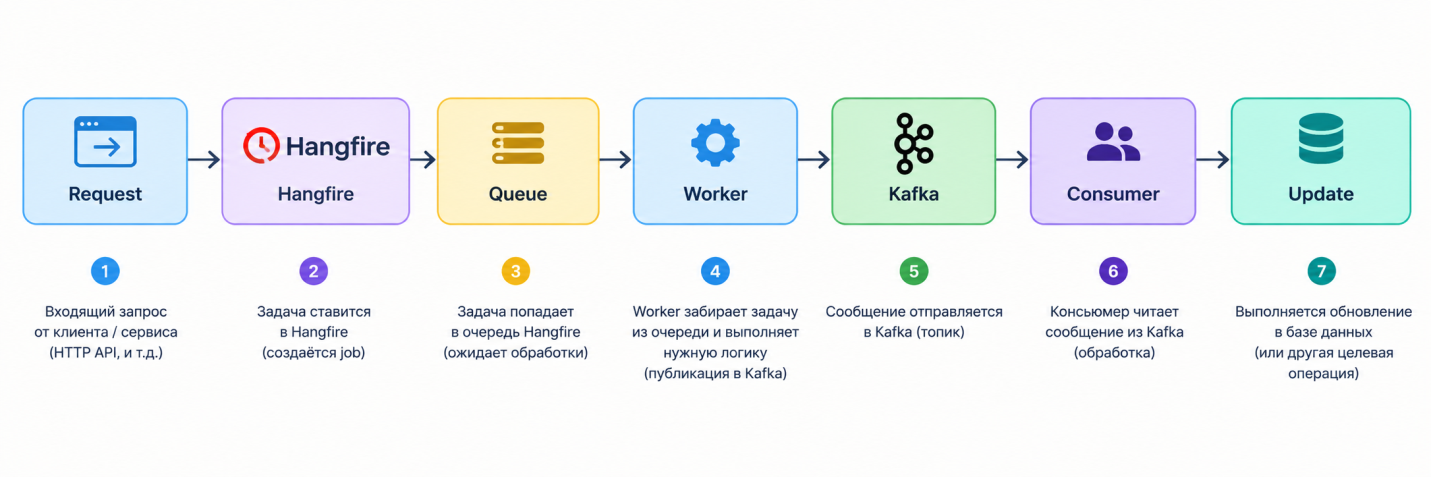
Проблема заключалась в том, что обычные рабочие задачи и массовые запросы использовали одну очередь. В момент инцидента сервис работал на 8 podах. Каждый pod запускал один worker, слушавший одну и ту же очередь Default. Два podа были добавлены autoscalingом. Таким образом, суммарная worker capacity для обеих категорий задач составляла восемь обработчиков. Когда приходила массовая нагрузка, очередь быстро увеличивалась. В какой-то момент в очереди находилось 270к необработанных job. При этом пропускная способность составляла 30–50 job/с.
И тут расчет хорошо объясняет наблюдаемую задержку:
270к / 50 ≈ 5 400 секунд ≈ 90 минут;
270к / 40 ≈ 6 750 секунд ≈ 112 минут;
Это объясняет поведение, когда пользователь ждал 1.5 часа.
Самое интересное
На этом этапе я добавил важные метрики, мониторинг двух ключевых интервалов: сколько job находилось в очереди и как быстро они выполнялись.
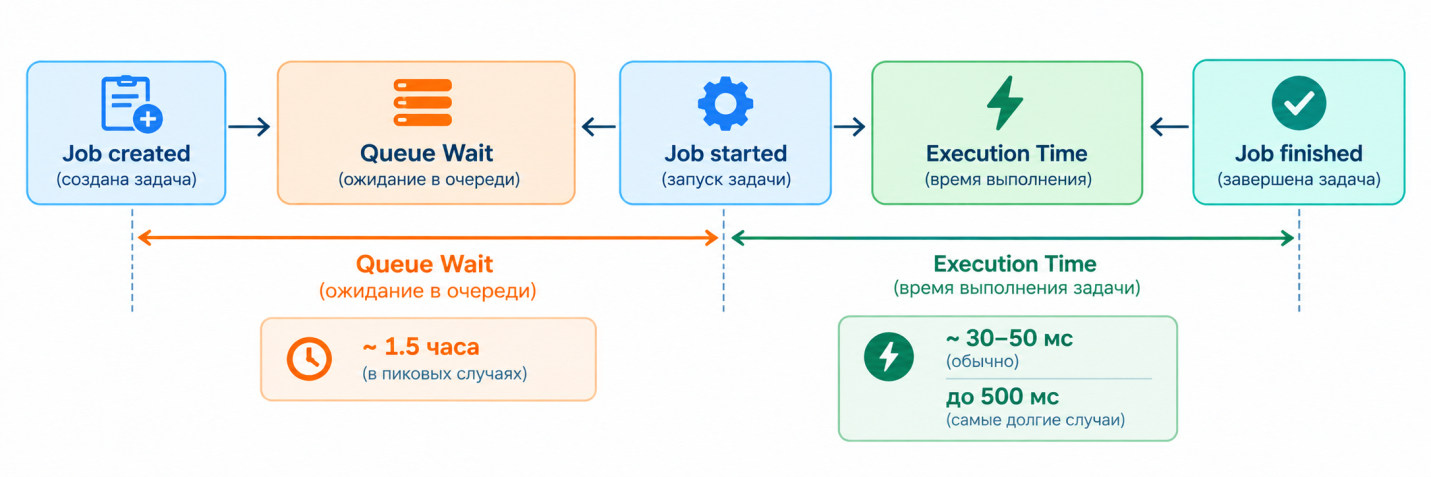
Здесь обнаружилось самое интересное
Сама job выполнялась быстро:
Обычно – 30-50 мс;
В самых долгих случаях – 500 мс;
Но перед этим job могла ожидать в очереди 1.5 часа. Проблема была не в том, что одна job выполнялась 1,5 часа, а в том, что она часами ждала свободного воркера.
Разделяем очереди
После этого стало понятно, что массовая нагрузка не должна конкурировать с обычными рабочими запросами.
Была выделена отдельная очередь:
Default – обычные задачи;
Analytics – массовые задачи 300к;
Для аналитической очереди были увеличены воркеры до двух. Также была сделана оптимизация работы в job, в результате аналитическая очередь стала разгребаться значительно быстрее. Задержка между постановкой задачи и началом выполнения снизилась до 5 минут, а количество подов сократилось до пяти: автоскейлинг больше не срабатывал. Проблема пользователя была решена. Теперь его задача не должна ждать, пока отработают job из аналитики.
Но алерты никуда не исчезли
На этом этапе расследование стало интереснее. Проблема с очередью была решена. Но спустя некоторое время снова стало видно: память растет.
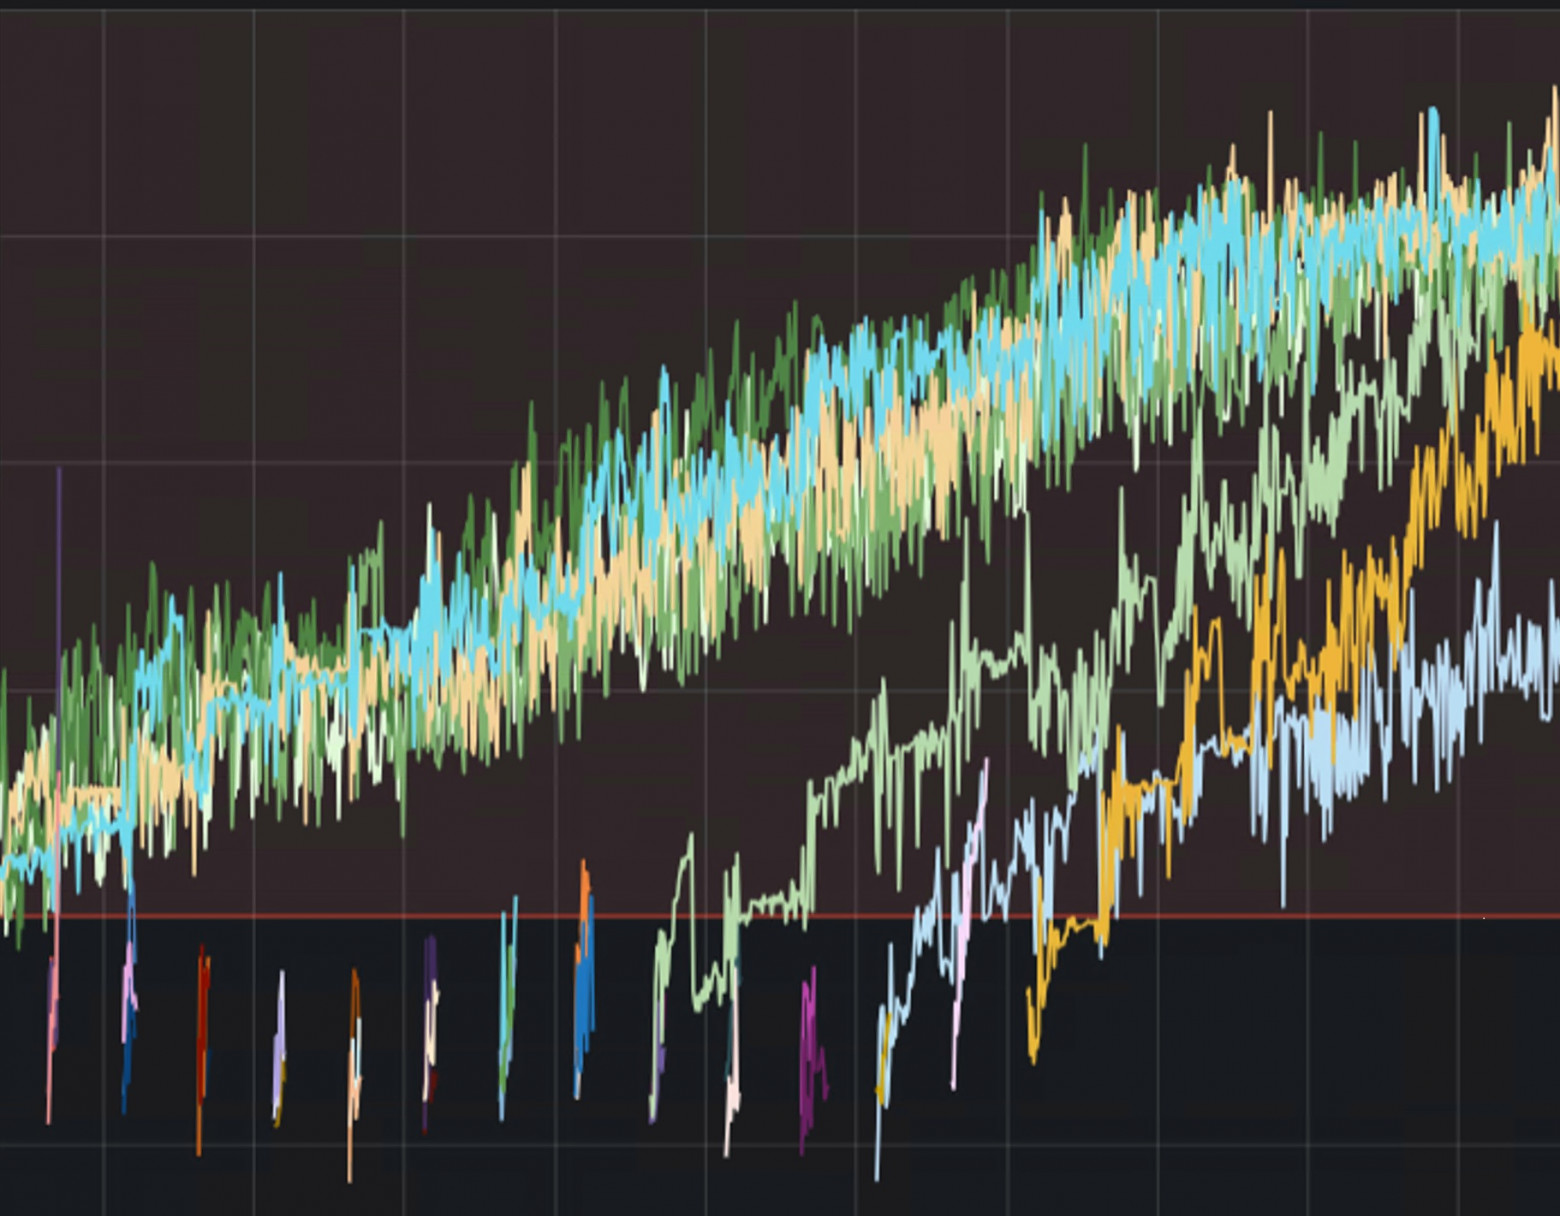
График памяти не возвращался к исходному уровню – значит, это уже другая проблема. Это был хороший момент, чтобы разделить две независимые проблемы:
Очередь – долгое ожидание job, решено разделением очередей;
Рост кучи – требовал отдельного расследования;
Сначала казалось, что всё является одной большой проблемой производительности. На практике оказалось, что один инцидент маскировал две разные проблемы.
Воспроизведение проблемы на тесте
Проблему необходимо воспроизвести в тестовой среде. В данном случае я использовал нагрузочное тестирование через NBomber. Сценарий имитировал нагрузку 10 RPS в течение 7 часов. И результат был очень показательным, на тестовой среде память начала вести себя так же, как на проде.
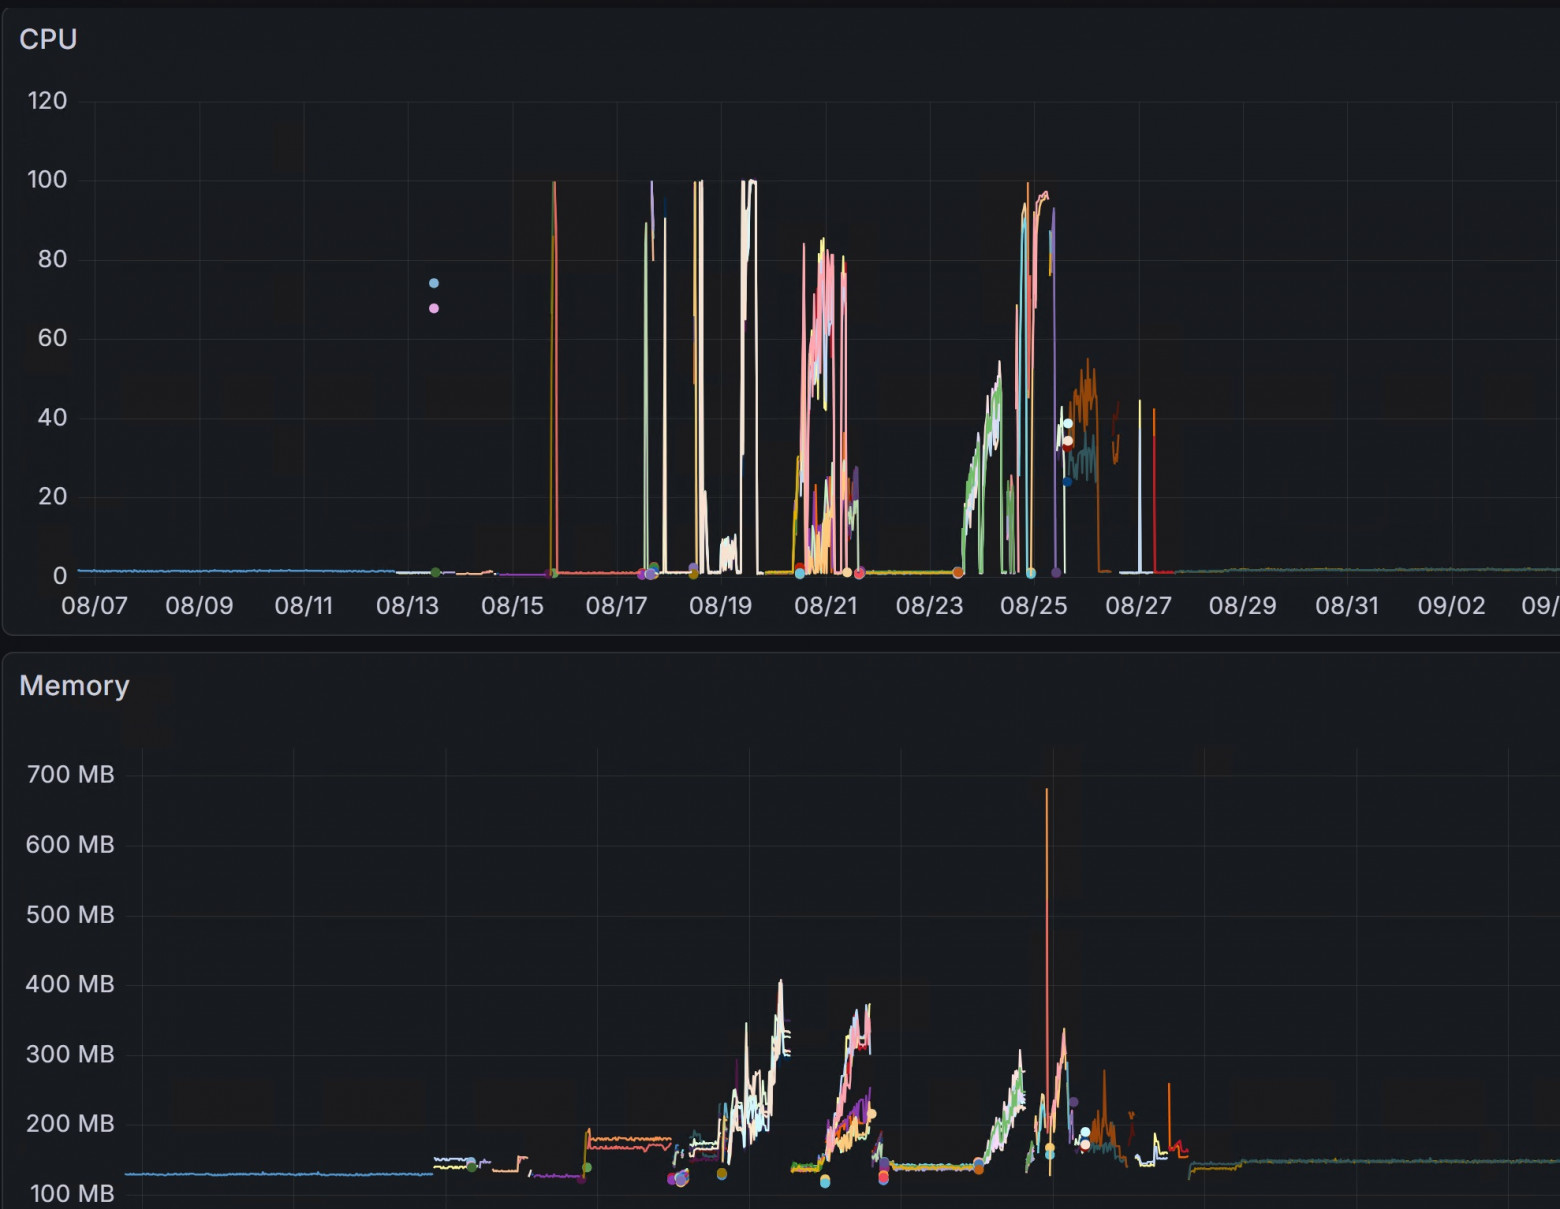
Теперь можно было снимать dump и исследовать состояние процесса в момент деградации.
Снимаем dump
Следующий этап – посмотреть, что реально находится в куче. В контейнере был собран dump.
dotnet-dump collect -p 1 -o /tmp/dump.dmpПосле этого dump можно открыть:
dotnet-dump analyze dumpЕсли память контейнера закончится, процесс может зависнуть, а контейнер – перезапуститься. Далее можно использовать команды:
dumpheap -stat;
dumpobj <address>;
Первый подозрительный кандидат
В dump среди объектов сразу бросились в глаза структуры Serilog.
7fa823644000 113,608  2,726,592 Serilog.Events.ScalarValue
7fa823643ca0 113,412  3,629,184 Serilog.Events.LogEventProperty
7fa8236449f8 229,555  9,182,200 Serilog.Core.Enrichers.PropertyEnricher
7fa823fc4bf0 229,592  9,183,680 Serilog.Context.EnricherStack
7fa89f7cdc60  28,347 18,987,024 Free
7fa8215e1650   8,061 26,506,032 System.Byte[]
7fa820e2d7c8 251,687 38,675,606 System.String
Total 1,080,957 objects, 119,064,314 bytes
Особенно интересными были:
Serilog.Core.Enrichers.PropertyEnricher;
Serilog.Context.EnricherStack;
Чтобы убедиться, что это не случайный всплеск аллокаций, я сравнил статистику кучи из двух dump, снятых на разных этапах нагрузки.
В первом dump:
Total 367,970 objects, 34,165,804 bytes

Serilog.Core.Enrichers.PropertyEnricher    6,645      265,800
Serilog.Context.EnricherStack              6,677      267,080
Во втором:
Total 1,080,957 objects, 119,064,314 bytes

Serilog.Core.Enrichers.PropertyEnricher  229,555    9,182,200
Serilog.Context.EnricherStack            229,592    9,183,680
Это уже не просто общий рост потребления памяти: одновременно увеличивалось количество объектов, связанных с контекстом логирования Serilog.
Поскольку недавно в GlobalFilter добавляли функционал, связанный с логированием, я сразу проверил его. После этого я посмотрел, где именно создаются эти объекты, метод OnPerforming создавал два скопа:
var correlationScope = LogContext.PushProperty(...);
var jobIdScope = LogContext.PushProperty(...);

if (filterContext.Items.TryGetValue(CorrelationScopeKey, out var correlationObjScope) && correlationObjScope is IDisposable correlationScope)
{
  correlationScope.Dispose();
}

if (filterContext.Items.TryGetValue(JobIdScopeKey, out var jobIdObj) && jobIdObj is IDisposable jobIdScope)
{
  jobIdScope.Dispose();
}
Основная ошибка
Контекст ведёт себя как стек. Сначала был создан scope для CorrelationId, затем scope для JobId. Поэтому освобождать их нужно в обратном порядке. LogContext.PushProperty возвращает не обычный disposable, а bookmark – Dispose не “убирает верхний элемент стека”, а восстанавливает AsyncLocal-состояние на тот момент, когда именно этот Push был сделан.
Если вызывать Dispose не в обратном порядке, первый Dispose откатывает стек к пустому состоянию, а второй – откатывает его к состоянию на момент своего push, где первый scope уже был записан. Он буквально “воскресает” после своего же Dispose.
То есть для каждой выполняемой job создавались два logging scope.
Меняем порядок
var correlationScope = LogContext.PushProperty(...);
var jobIdScope = LogContext.PushProperty(...);


if (filterContext.Items.TryGetValue(JobIdScopeKey, out var jobIdObj) && jobIdObj is IDisposable jobIdScope)
{
  jobIdScope.Dispose();
}

if (filterContext.Items.TryGetValue(CorrelationScopeKey, out var correlationObjScope) && correlationObjScope is IDisposable correlationScope)
{
  correlationScope.Dispose();
}
Проверяем гипотезу ещё раз
Финальный прогон: мы нашли подозрительный код и исправили его. Нужно было доказать, что изменение действительно устраняет проблему. Поэтому тот же нагрузочный сценарий был запущен повторно.
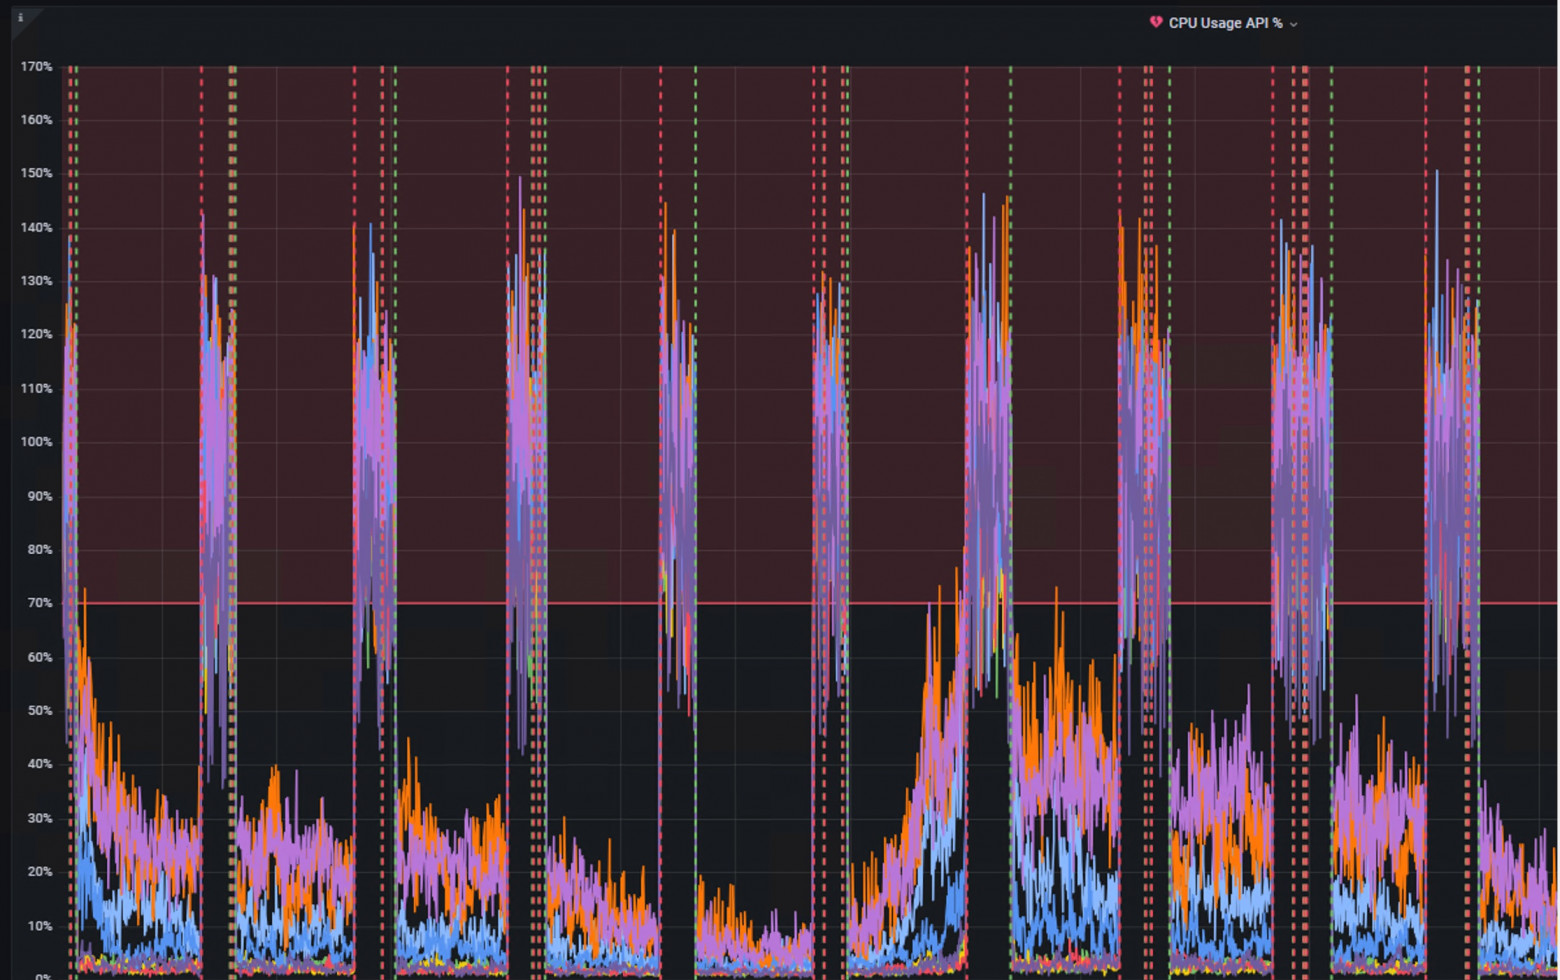
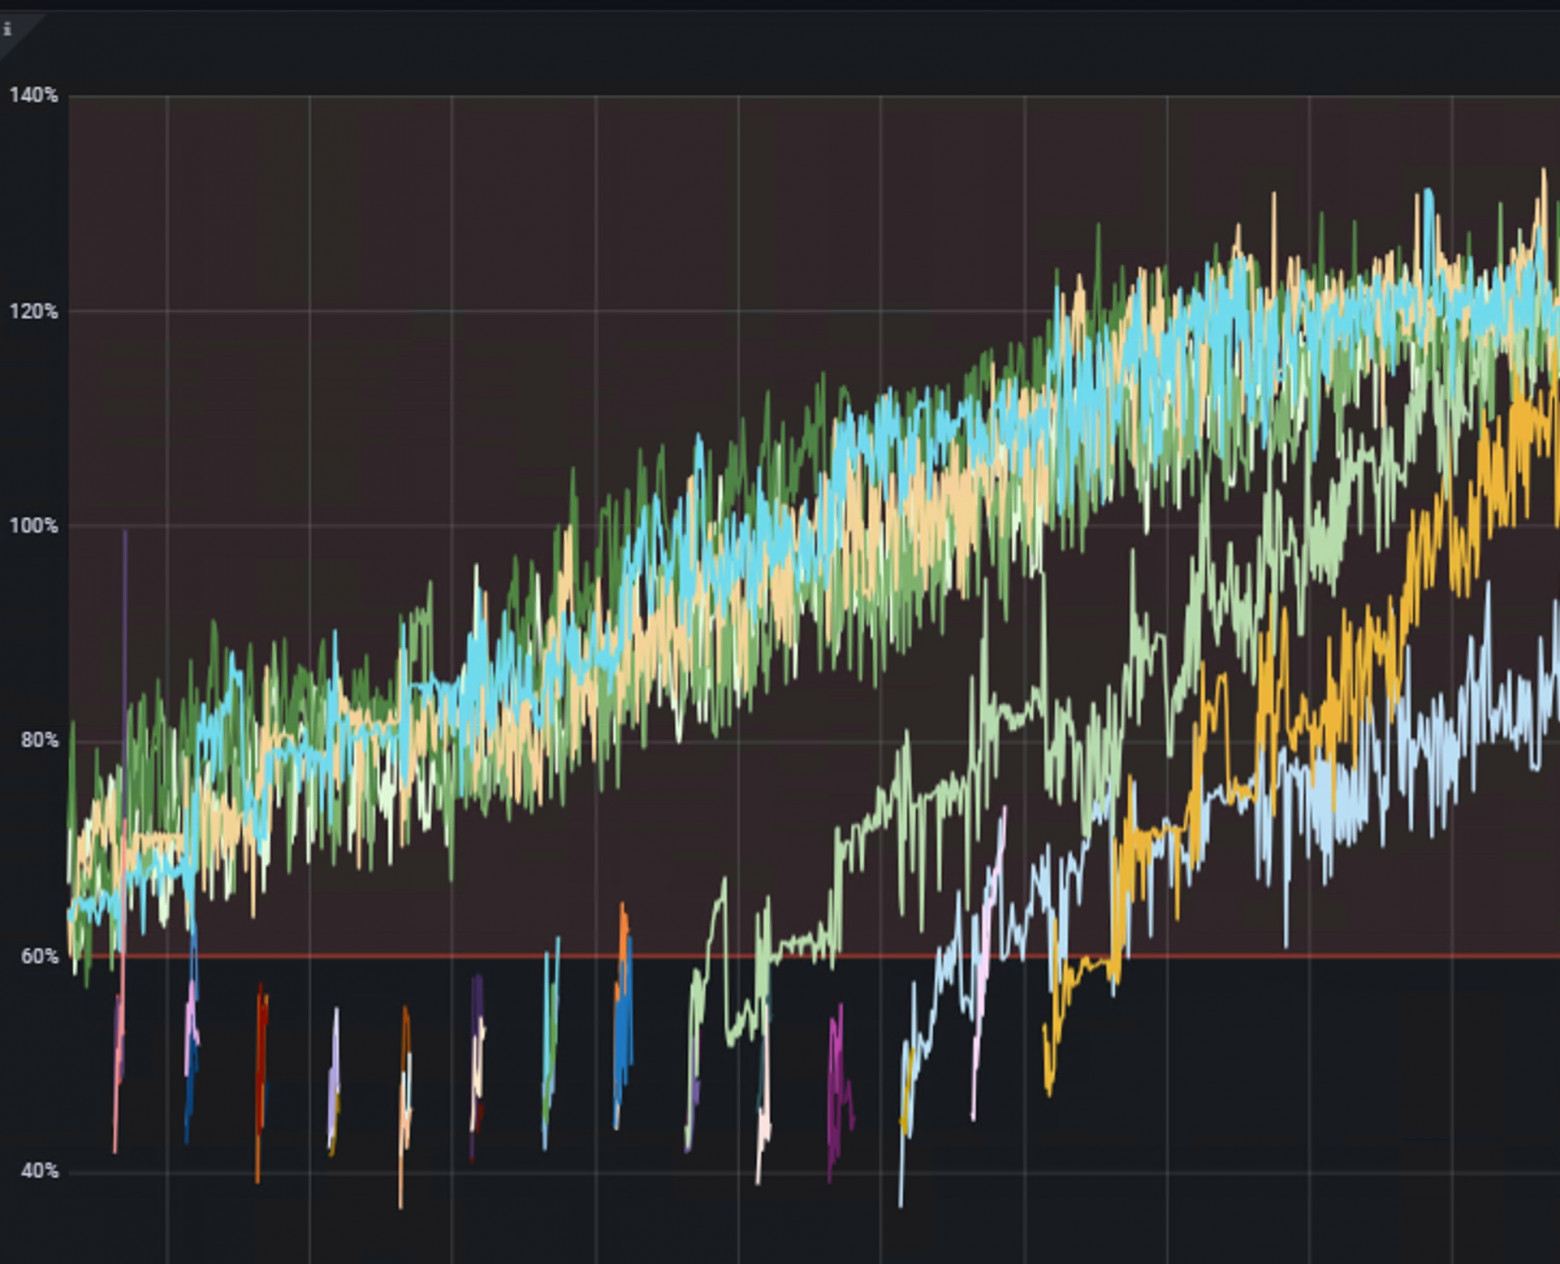
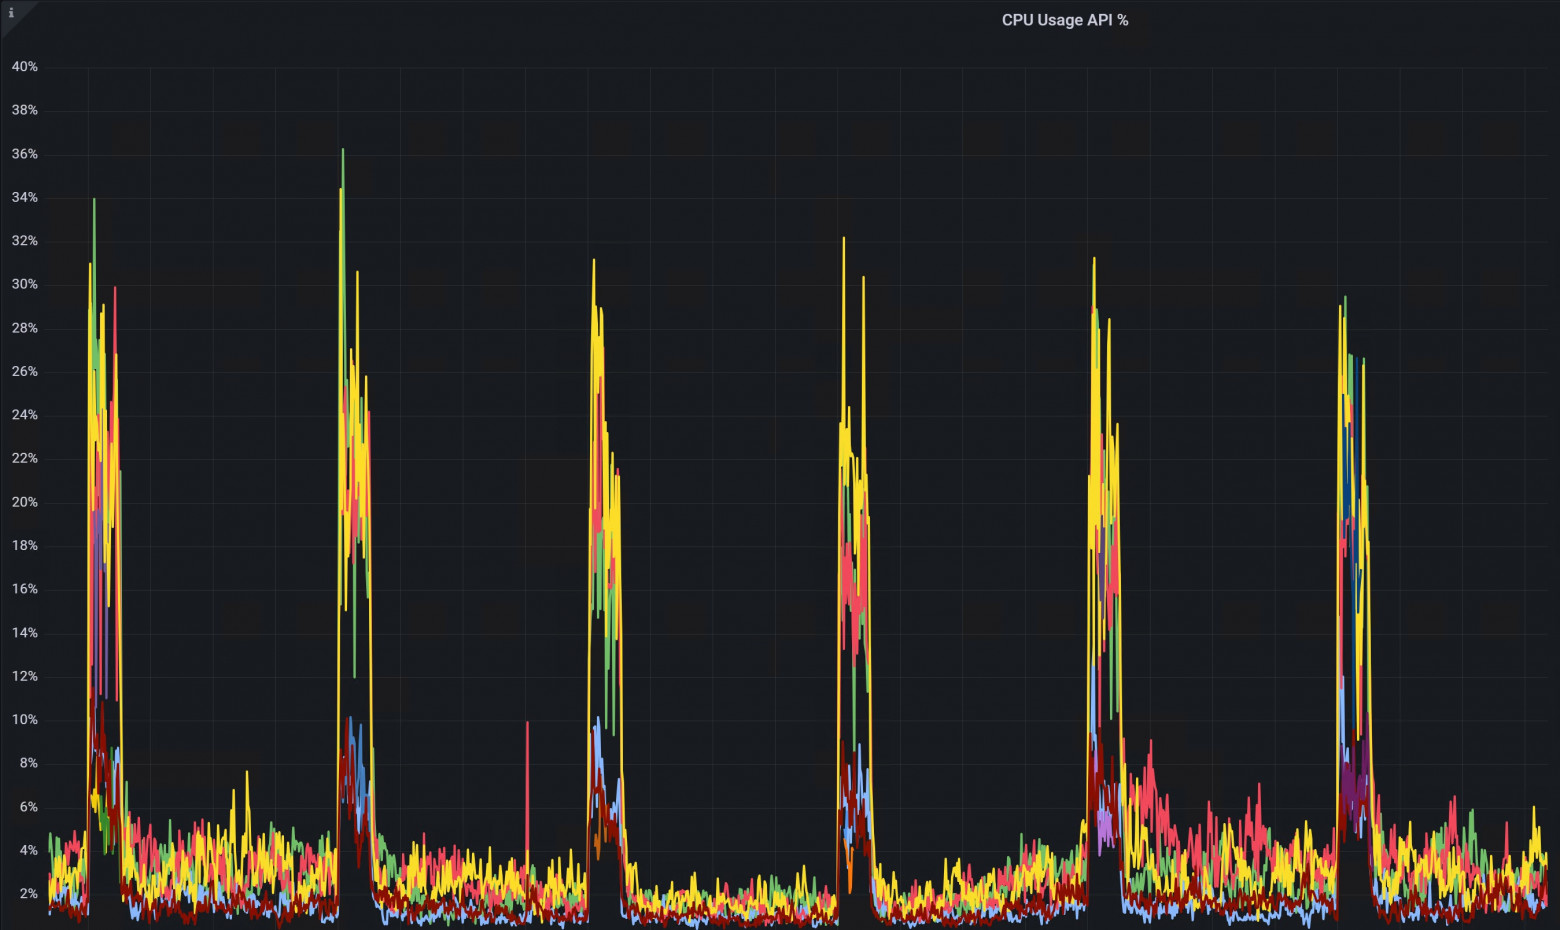
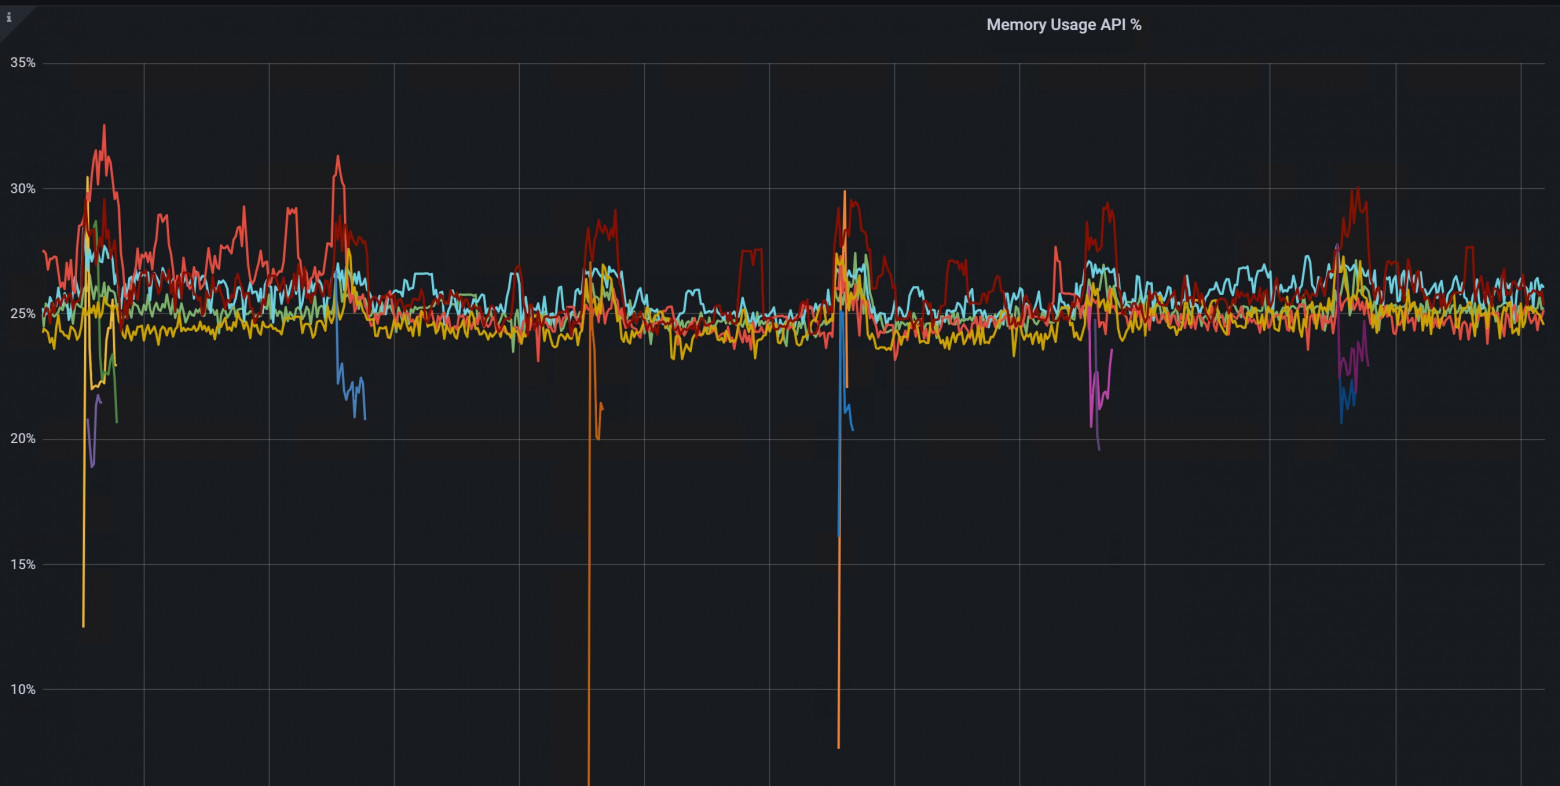
После фикса рост прекратился. Ресурсы стабилизировались примерно в районе 30–40%, без прежнего постоянного накопления.
Что в итоге оказалось причиной
Причина №1 – конкуренция очередей
Массовая нагрузка использовала ту же очередь Hangfire, что и обычные рабочие задачи. При накоплении сотен тысяч job:
Очередь росла;
Воркеры были заняты массовыми задачами;
Обычная задача могла ждать около полутора часов;
Пользователь получал timeout;
Решение: разделение очередей + увеличение количества воркеров для analytics + оптимизация запроса.
Причина №2 – накопление Serilog context
На каждую job создавались два scope через LogContext.PushProperty, но Dispose вызывался не в обратном порядке – из-за этого один из scope фактически не освобождался и оставался в активном LogContext, а связанные объекты накапливались в куче.
Выводы
Один PropertyEnricher занимал относительно немного памяти сам по себе. Но когда таких объектов становится 229к или 403к, проблема начинает проявляться. Именно поэтому она не была заметна сразу. Один PropertyEnricher сам по себе занимает немного памяти, и при коротком горизонте метрик рост легко пропустить. Нужны метрики, которые хранятся хотя бы несколько дней.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.