CPU простаивает, а Linux показывает 80% давления. Как я нашёл причину в одном контейнере
Недавно решил проверить, сколько изолированных Linux-окружений сможет одновременно обслуживать мой VPS.
Конфигурация довольно скромная: 3 vCPU, 6 ГБ RAM и Docker. На сервере работает учебный проект, который создаёт отдельные Linux-окружения с заранее подготовленными неисправностями. Изоляция реализована через gVisor.
Изначально хотел выяснить, выдержит ли сервер девять одновременно работающих стендов.
Но в процессе обнаружил кое-что интереснее.
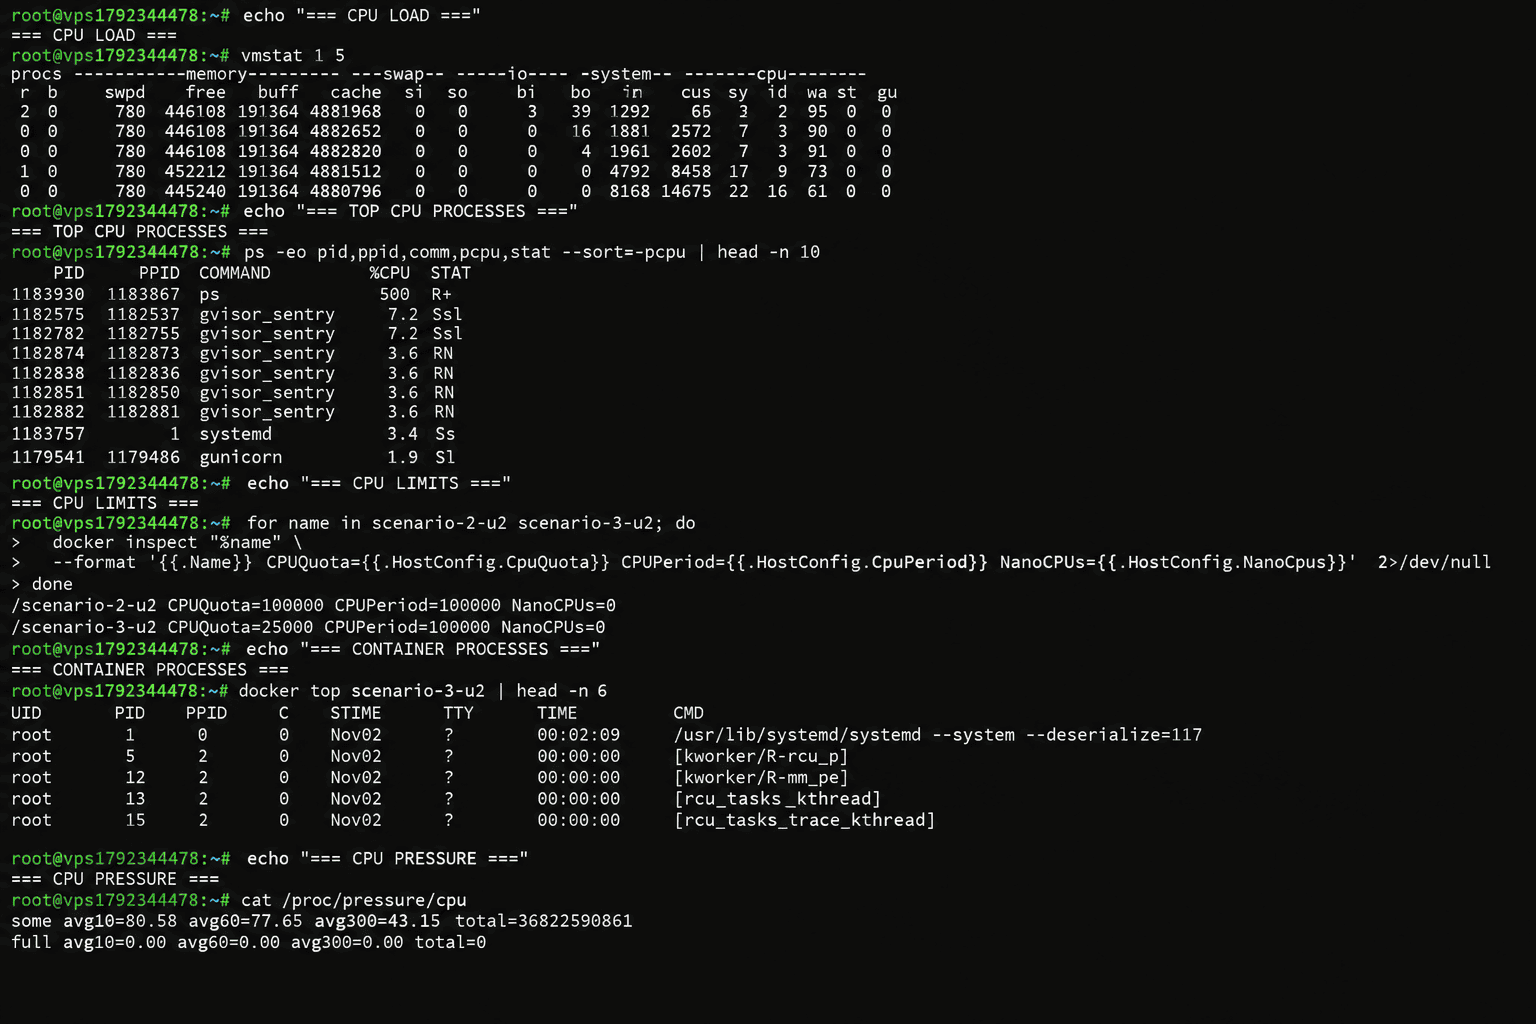
CPU на сервере большую часть времени простаивал, а Linux показывал почти 80% процессорного давления.
Пришлось разбираться, как такое вообще возможно.
Всё начиналось нормально
Сначала посмотрел на состояние VPS без игровых окружений.
free -h
vmstat 1 6
Доступно около 5 ГБ оперативной памяти. Процессор в последних секундных интервалах простаивал на 98–100%.
Затем запустил один игровой контейнер и оставил терминал бездействовать.
Через docker stats увидел, что после запуска потребление ресурсов стабилизировалось:
CPU:       0.00%
Memory:    80.19 MiB / 512 MiB
PIDs:      50
В течение нескольких измерений память практически не менялась, процессор не нагружался.
Пока всё выглядело ожидаемо.
Затем запустил ещё два сценария. Первый к этому моменту уже завершился, поэтому одновременно работали два контейнера.
Один воспроизводил проблему с запуском приложения, второй — высокую нагрузку на CPU.
И вот тут началось интересное.
Откуда взялись 80%?
Контейнер с высокой нагрузкой стабильно потреблял около 25% одного CPU.
При этом общая загрузка сервера оставалась сравнительно небольшой. vmstat показывал от 61% до 91% простоя CPU на секундных интервалах.
Но стоило открыть:
cat /proc/pressure/cpuкак я увидел:
some avg10=79.71Позже показатель доходил до 81,78%.
Для контекста: PSI (Pressure Stall Information) показывает не загрузку процессора, а время, в течение которого задачи испытывали ожидание ресурсов.
То есть 80% CPU PSI - не то же самое, что 80% загрузки CPU.
Но почему задачи так часто ждут процессор, когда сам VPS далеко не перегружен?
Первым делом я проверил ограничения контейнеров:
docker inspect scenario-3-u2 \
  --format '{{.HostConfig.CpuQuota}} {{.HostConfig.CpuPeriod}}'
Получил:
25000 100000Вот и первая зацепка.
Контейнеру разрешено использовать 25 000 микросекунд процессорного времени за период 100 000 микросекунд.
Иными словами, его лимит — 0,25 CPU.
А теперь вспомним docker stats: контейнер практически постоянно потреблял ровно четверть ядра.
Похоже, он упирался в собственное ограничение.
Проверяем CPU throttling
Чтобы подтвердить гипотезу, я посмотрел статистику cgroup v2.
Нужные данные находятся в cpu.stat и cpu.pressure соответствующей cgroup.
Сделал два замера с интервалом примерно 11 секунд.
Метрика | Первый замер | Второй замер |
|---|---|---|
| 3096 | 3199 |
| 3089 | 3192 |
| 77 805 989 | 80 369 498 |
Получилось довольно показательно.
За время наблюдения прошло 103 периода процессорной квоты, и во всех 103 периодах происходил throttling.
Контейнер использовал примерно 2,56 секунды процессорного времени за 11 секунд реального времени - около 0,23 CPU в среднем.
То есть он практически постоянно расходовал разрешённую квоту.
Внутри самой cgroup PSI показывал:
some avg10=78.89
full avg10=73.84
А на уровне всего VPS:
some avg10=79.61И вот здесь картина стала понятнее.
У сервера есть свободные вычислительные ресурсы, но конкретный контейнер не может ими воспользоваться из-за установленного ограничения.
Его задачи готовы продолжать выполнение, однако процессорная квота уже исчерпана.
Свободное CPU-время на хосте не означает, что его может получить любой контейнер.
Оставалось проверить, действительно ли именно этот сценарий создаёт основную часть наблюдаемого давления.
Останавливаем контейнер
Я завершил сценарий с высокой нагрузкой обычным способом через приложение.
Второй контейнер продолжил работать.
После остановки снова проверил PSI:
cat /proc/pressure/cpuРезультат:
Показатель | До остановки | После |
|---|---|---|
CPU PSI | 79,61% | 11,89% |
Падение на 67,72 процентного пункта.
При этом процессор VPS по-прежнему большую часть времени простаивал.
Более длительные показатели avg60 и avg300 оставались повышенными, поскольку учитывали предыдущую нагрузку.
Полученные результаты хорошо подтвердили гипотезу: основным источником высокого CPU pressure был сценарий, который практически постоянно достигал своей процессорной квоты.
Так может, нужно увеличить CPU-квоту?
В моём случае - нет.
Ограничение было установлено намеренно.
Игровой сценарий специально создаёт высокую нагрузку на процессор. Пользователь должен разобраться в причинах и исправить неисправность.
Но если разрешить такому окружению бесконтрольно использовать ресурсы VPS, оно может начать мешать другим игрокам.
Поэтому CPU throttling здесь — ожидаемое следствие защитного ограничения, а не обязательно ошибка, которую требуется устранить.
Другое дело, что подобные ограничения нужно учитывать при мониторинге. Высокий PSI сам по себе ещё не говорит, что всему серверу требуется больше процессорных ядер.
Важно выяснить, кто именно ждёт CPU и почему.
И отдельно проверять, насколько такое ожидание влияет на реальные действия пользователя — например, на отзывчивость терминала.
А сколько окружений всё-таки выдержал VPS?
Забавно, но до девяти окружений я так и не добрался.
После нескольких запусков сработала собственная защита приложения от слишком частых запросов с одного IP.
Вместо очередного терминала я получил сообщение:
«Слишком много запусков с твоего адреса. Подожди несколько минут».
Хотел проверить пределы инфраструктуры, а первым меня остановил собственный rate limiter.
Так что предел по количеству одновременно работающих окружений ещё предстоит измерить отдельно.
Зато в ходе исследования выяснилась куда более интересная вещь.
CPU utilization и CPU pressure могут рассказывать совершенно разные истории.
В моём случае:
CPU на VPS оставался преимущественно свободным.
Один контейнер был ограничен квотой 0,25 CPU.
Его задачи регулярно попадали под throttling.
CPU PSI достигал почти 80%.
После остановки контейнера показатель резко снизился.
Если бы я ориентировался только на загрузку процессора, эту особенность легко было бы пропустить.
Поэтому при диагностике контейнерных нагрузок полезно смотреть не только top и docker stats, но и cpu.max, cpu.stat и cpu.pressure.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.