Облако тоже может сломаться. Часть 2: как переехать во время аварии и не потерять
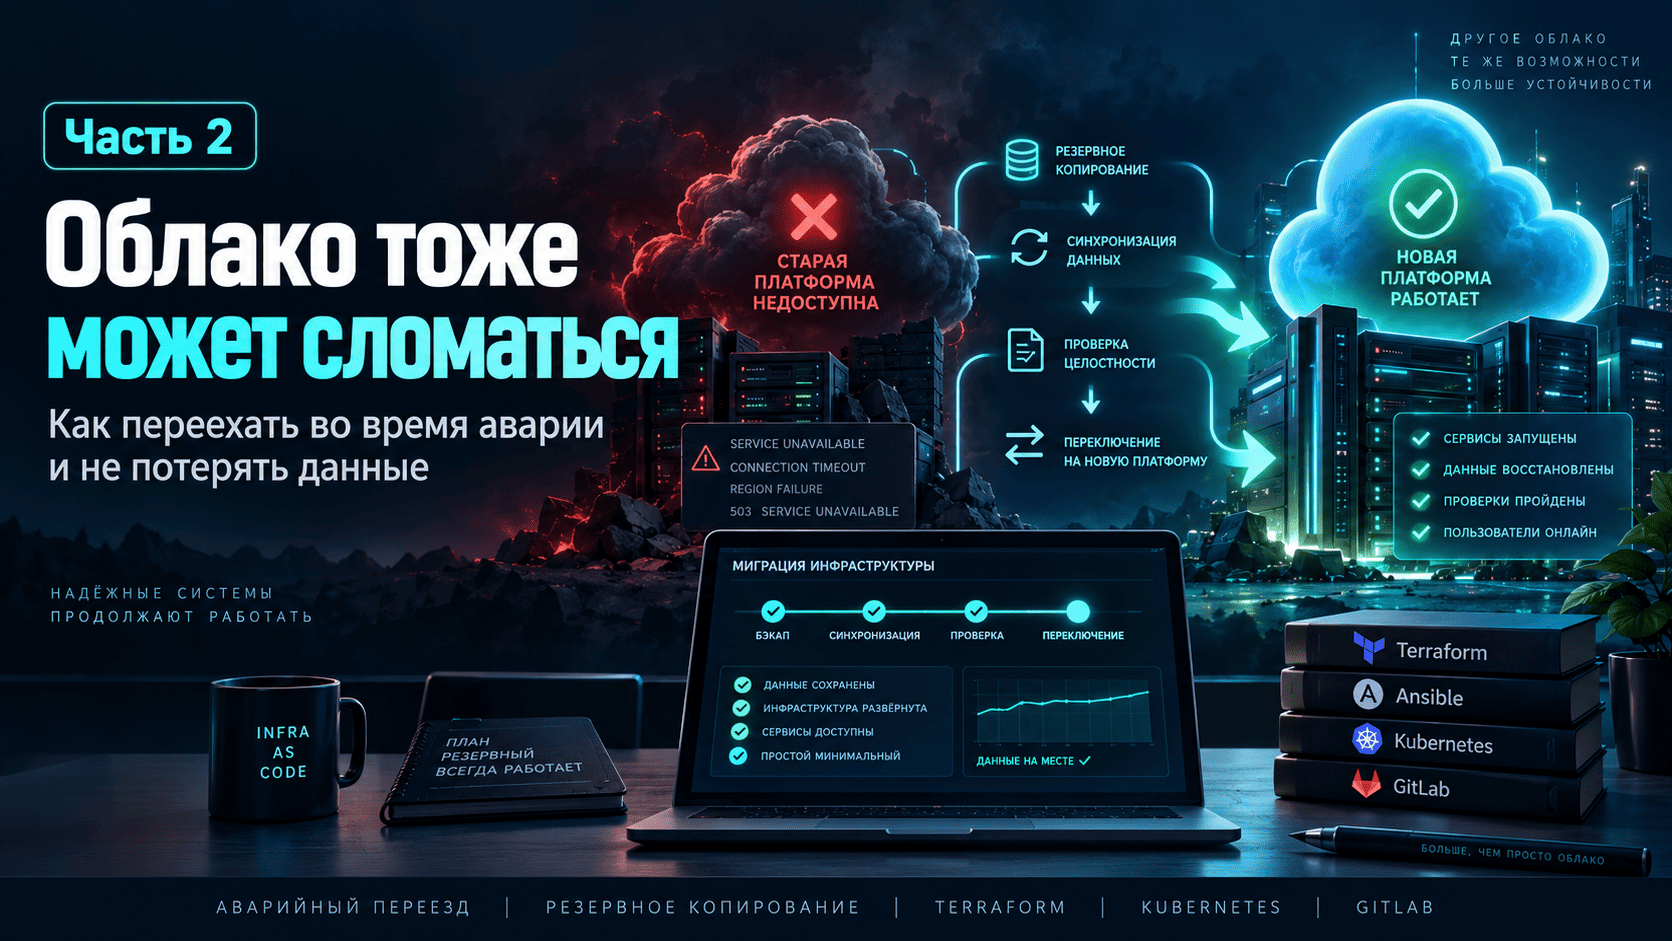
В первой части мы разделили отказы VM, зоны и всего провайдера, назначили сервисам RPO/RTO и рассмотрели два подхода: независимую резервную площадку и несколько зон внутри одного облака с внешними резервными копиями.
Теперь провайдер уже нестабилен, часть ресурсов недоступна, а бизнес спрашивает не об архитектуре будущего, а о времени возвращения GitLab, сети, документации и рабочих стендов. В этот момент скорость нужна, но хаотичные действия увеличивают риск потери последних исправных данных.
Ниже — практический порядок аварийного переезда, сформированный на опыте миграции внутренних сервисов из недоступной зоны в другое облако.
О чём эта часть
1. Создайте единый журнал инцидента
До первых изменений назначьте руководителя работ по инциденту и одно место, где фиксируются:
факты и время их проверки;
доступность API, панели, VM, дисков, снимков и объектного хранилища;
принятые решения и ответственные;
последняя успешная резервная копия каждого сервиса;
изменения DNS, межсетевого экрана и секретов;
критерии перехода к следующему этапу;
действия, которые ещё можно откатить.
Чат полезен для координации, но плохо работает как единственный журнал. Сообщения теряются, а одни и те же команды запускаются дважды.
Нужно разделять факт, гипотезу и решение. «VM не запускается» — факт. «В зоне закончились хосты» — гипотеза, пока это не подтвердил провайдер. «Восстанавливаем из резервной копии у другого провайдера» — решение.
2. Сначала остановите увеличение ущерба
Самая опасная ситуация — два независимо меняющихся экземпляра одного сервиса. Пока старая площадка иногда оживает, пользователи продолжают писать данные, а команда уже восстанавливает копию в новом облаке. После переключения эти истории невозможно просто сложить вместе.
Перед финальной копией необходимо:
Остановить запись либо включить режим обслуживания или режим только для чтения, если старый сервис доступен.
Зафиксировать время и последнюю подтверждённую позицию в журнале транзакций.
Создать свежую резервную копию средствами самого приложения.
Скопировать её за пределы зоны, затронутой аварией.
Посчитать размер и контрольную сумму.
Запретить автоматические задачи, которые могут изменить обе стороны.
Если источник недоступен, явно зафиксируйте RPO: какое время у последней пригодной копии и какие изменения придётся восстановить вручную.
3. Не удаляйте источник после первого успешного запуска
Старые VM и диски лучше остановить, но оставить до завершения проверки и оговорённого срока хранения. Они могут содержать единственную копию:
недавно загруженного файла;
конфигурации, которой нет в Git;
ключа узла SSH;
ключа шифрования;
локального слоя образа из реестра;
журнала, объясняющего расхождение данных.
Удаление освобождает деньги, но лишает последней возможности сверки. Безопасный порядок: остановить, запретить запись, пометить, сохранить снимок, ограничить доступ и удалить только после формального подтверждения успешного переноса.
4. Выберите новый провайдер по проверяемым возможностям
Во время аварии легко сравнивать только цену CPU и RAM. Это почти никогда не главный ограничитель переезда.
Terraform и API
Наличие логотипа Terraform на сайте недостаточно. Нужно проверить, какими именно ресурсами умеет управлять провайдер Terraform:
сети, маршруты и межсетевые экраны;
VM и диски;
балансировщики и публичные IP-адреса;
объектное хранилище и IAM;
DNS;
снимки, образы и импорт существующих ресурсов;
изменение ресурса без пересоздания;
документация, версия модуля провайдера и скорость исправления ошибок.
Если критичный ресурс создаётся только вручную, его всё равно следует окружить кодом: сеть, адреса, DNS, политики и зависимости остаются в Terraform, а ручной шаг документируется как явный шаг первоначальной настройки.
Квоты и фактическая ёмкость
Запросите квоты до переноса: vCPU, RAM, SSD, публичный IP-адрес, сети, число VM и пропускную способность. Затем создайте тестовую VM нужного размера. Квота разрешает операцию административно, но не гарантирует, что в выбранной локации сейчас есть физическая ёмкость.
Образы и готовые виртуальные системы
Обычную Linux-систему лучше пересоздать и настроить автоматически. Для NGFW, проприетарной виртуальной системы или специализированной ОС может понадобиться перенос готового образа OVA/OVF.
До выбора площадки проверьте:
поддерживаемые форматы;
максимальный размер файла;
UEFI или BIOS;
тип дискового контроллера, например SCSI;
максимальную поддерживаемую версию виртуального оборудования;
отсутствие примонтированных ISO;
выдаёт ли API ID импортированного образа;
может ли Terraform создать из него VM;
кто отвечает за работоспособность гостевой ОС и действует ли SLA.
Если провайдер импортирует такой образ только вручную, это не делает остальную миграцию ручной. Импорт остаётся одним контролируемым исключением, а весь окружающий контур остаётся воспроизводимым.
Объектное хранилище
Заявленная совместимость с S3 не означает, что хранилище во всём ведёт себя как Amazon S3. Проверьте:
адрес API и поддержку запросов через путь или имя виртуального хоста;
загрузку больших файлов по частям;
версионирование и запрет изменения объектов (Object Lock);
правила автоматического хранения и удаления;
шифрование на стороне хранилища;
ограничения имён объектов и метаданных;
согласованность операций и контрольные суммы;
стоимость исходящего трафика и ограничения частоты запросов API;
возможность выдать отдельные реквизиты доступа только для записи резервных копий.
Поддержка и биллинг
При миграции важны не только SLA, но и время реакции на нестандартный запрос: импорт образа, увеличение квоты, маршрутизация на втором и третьем сетевых уровнях, обратные DNS-записи. Отдельно проверьте модель оплаты. Даже технически созданные ресурсы могут не стартовать, если проект ожидает выставления счёта или ручного пополнения баланса.
Сравнительная таблица выбора провайдера
Критерий | Почему влияет на DR | Как проверить до договора | Красный флаг |
|---|---|---|---|
Покрытие ресурсов через Terraform и API | определяет объём ручной работы | создать пробный контур из всех базовых ресурсов | модуль умеет создавать только виртуальные машины |
Квоты и реальная ёмкость | влияет на достижимый RTO | запросить квоту и создать VM нужного размера | квота есть, VM создать нельзя |
Импорт OVA/OVF | нужен для готовых виртуальных систем | тестовый импорт и создание VM | только ручной импорт без срока |
Объектное хранилище | хранит резервные копии и файлы приложений | пробное копирование и восстановление, версионирование, контрольные суммы | нет защиты от изменения или возможности выгрузки |
Сеть | определяет связность и переключение трафика | схема маршрутов, VPN, публичный IP-адрес | нельзя закрепить адрес или маршрут |
Поддержка | решает нестандартные блокеры | тестовый технический запрос | нет понятного порядка эскалации |
Биллинг | может остановить ресурсы | проверить лимит, счёт и автоплатёж | запуск только после ручного платежа |
5. Выберите способ переноса для каждого сервиса
Один способ не подходит всей инфраструктуре.
Пересоздание из кода инфраструктуры и GitOps
Лучший вариант для сетей, приложений без локального состояния, нагрузок Kubernetes, узлов CI/CD и систем мониторинга. Terraform создаёт базовые ресурсы, система управления конфигурацией готовит ОС, а GitOps возвращает приложения.
Плюсы: чистая и проверяемая конфигурация без старого мусора. Минусы: схемы ресурсов у провайдеров различаются, а сценарии первоначальной настройки, балансировщики и диски требуют адаптации. Данные всё равно придётся восстанавливать отдельно.
Резервное копирование средствами приложения
Этот способ предпочтителен для PostgreSQL, GitLab, Vault, систем управления задачами, баз знаний и других приложений, которые хранят данные. Штатный механизм резервного копирования понимает внутреннюю структуру сервиса лучше обычного снимка диска.
Плюсы: переносимость между гипервизорами и типами дисков. Минусы: нужно совпадение версий, отдельно сохраняются конфигурация, секреты и объектное хранилище.
Репликация и запланированное переключение
Если обе площадки доступны одновременно, данные можно синхронизировать заранее, затем остановить запись, дождаться исчезновения отставания реплики и сделать её основной.
Это уменьшает RPO и время простоя, но требует гарантированно остановить запись в старую копию и в правильном порядке назначить новую основной.
Импорт виртуальной машины или OVA
Подходит для готовой виртуальной системы, которую невозможно нормально установить и настроить обычными средствами. Это сохраняет ОС и настройки, но переносит технический долг и зависимость от формата гипервизора.
Сравнение способов миграции
Способ | Лучше всего для | Переносимость | Скорость | Основной риск |
|---|---|---|---|---|
Код инфраструктуры + GitOps | сети, вычислительные ресурсы и приложения без локального состояния | высокая | высокая после подготовки | неполное покрытие API |
Резервная копия средствами приложения | базы данных и сервисы, хранящие состояние | высокая | зависит от объёма | забытые внешние файлы или секреты |
Репликация + переключение | критичные базы данных и сервисы | средняя | высокая | запись в две разошедшиеся копии и отставание реплики |
Снимок или образ диска | однородные платформы | низкая–средняя | высокая | несовместимость драйверов или загрузки ОС |
Импорт OVA/OVF | NGFW и готовые системы поставщиков | средняя | зависит от поддержки | ручной шаг и отсутствие SLA |
6. Восстанавливайте не по списку VM, а по цепочке зависимостей
Практичный порядок выглядит так.
Волна 0. Контур восстановления
независимая копия кода инфраструктуры, GitOps и пошаговых инструкций;
доступ к целевому облаку;
реквизиты аварийного доступа;
хранилище состояния Terraform;
целевой бакет резервных копий;
внешний DNS и канал связи команды.
Волна 1. Сеть и безопасность
VPC/VLAN, подсети и маршруты;
исходящий доступ в сеть и публичные адреса;
межсетевой экран или NGFW;
VPN или другой административный доступ;
DNS-резолвер, NTP и базовый PKI.
Если тянуть сеть до конца, каждый следующий сервис придётся временно выставлять наружу и потом переделывать.
Волна 2. Системы, в которых хранится актуальное состояние
GitLab и исходный код;
Vault или другое хранилище секретов;
IAM или midPoint, если от него зависит доступ;
реестр контейнерных образов только в объёме, необходимом для запуска.
Код и секреты разблокируют автоматизацию остальных волн. При этом восстановление GitLab не должно зависеть от конвейера CI/CD в восстанавливаемом GitLab: нужен локальный способ первоначального запуска.
Волна 3. Платформа
контур управления Kubernetes и рабочие узлы;
CNI, CSI, входящий трафик и сертификаты;
Argo CD/Flux;
базы данных и их операторы;
мониторинг, журналы и трассировка.
Волна 4. Критичные приложения
Сначала сервисы, без которых компания не может работать или разработчики не могут выпускать исправления. Затем внутренние инструменты, стенды разработки, приёмочного тестирования и кэши.
7. Что именно проверять при переносе GitLab
Открылась страница входа, совпало число пользователей и видны проекты — этого недостаточно. GitLab хранит разные классы данных в PostgreSQL, Git-репозиториях, файловой системе и объектном хранилище.
Официальная документация GitLab отдельно предупреждает, что стандартная резервная копия не включает объектное хранилище, конфигурацию /etc/gitlab, ключи TLS и SSH и некоторые системные файлы. Для восстановления нужна точно такая же версия GitLab и файл с секретами.
Проверка должна включать:
Версию и редакцию GitLab на исходной и целевой площадках.
Восстановление резервной копии базы данных.
Восстановление основных репозиториев, wiki, фрагментов кода и репозиториев дизайна.
Копирование LFS, загрузок, артефактов, пакетов, реестра образов и состояний Terraform в зависимости от конфигурации.
Восстановление
gitlab-secrets.json,gitlab.rb, ключей узла SSH и нужных настроек TLS.Сверку групп, проектов, пользователей, запросов на слияние, конвейеров и заданий CI/CD.
Сверку всех ссылок веток и тегов, а также достижимых идентификаторов коммитов.
git fsckили эквивалентную серверную проверку репозиториев.Пробное клонирование, получение и отправку изменений по SSH и HTTPS.
Запуск конвейера CI/CD и получение артефакта.
Ключевая мысль: одинаковое число проектов не доказывает наличие одинакового кода. Надёжнее построить манифест проект -> ветки и теги -> SHA коммита, сравнить источник и цель, а затем проверить достижимость объектов.
Для объектного хранилища нужно отдельно сравнить список ключей и размеры, а по возможности — контрольные суммы. Если копирование идёт с работающего источника, полезны несколько проходов: полное копирование, повторная синхронизация изменений и финальный проход после остановки записи.
8. Проверяйте каждый сервис с данными на его уровне
Универсальная проверка «контейнер имеет состояние Running» почти бесполезна.
Сервис | Недостаточная проверка | Приёмочная проверка |
|---|---|---|
PostgreSQL | порт 5432 открыт | схема и количество записей, целостность, запись и чтение, нужная позиция WAL |
GitLab | открывается интерфейс | ветки, теги и коммиты, клонирование и отправка изменений, загрузки, артефакты, конвейер CI/CD |
Docmost | пользователь входит | страницы, вложения, поиск, создание и скачивание файла |
Plane | доска открылась | проекты, задачи, комментарии, вложения, создание задачи |
Vault | хранилище распечатано | чтение и запись тестового секрета, политики, способы входа и журнал аудита |
S3 | бакет существует | полный список ключей, размеров и контрольных сумм, проверка версий |
Kubernetes | узлы имеют состояние Ready | CNI, CSI, DNS, входящий трафик, перезапуск пода, подключение тома и обновление приложения |
NGFW | виртуальная машина запущена | маршрутизация, NAT, VPN, безопасное поведение при отказе и пропускная способность |
Приёмочные тесты стоит хранить рядом с кодом сервиса и запускать одинаково на обычном учении по восстановлению и во время аварии.
9. Код инфраструктуры спасает время, если его заранее готовили к переносу
Terraform позволяет быстро получить повторяемый план изменений, увидеть зависимости и повторить создание после неудачи. Это особенно ценно, когда ресурсы приходится создавать несколько раз из-за квот или ошибок API.
Но один и тот же код Terraform не становится переносимым между облаками автоматически. У разных провайдеров отличаются:
модели сети и межсетевого экрана;
типы балансировщиков;
образы и сценарии cloud-init;
управляемые базы данных;
IAM;
диски, снимки и параметры VM.
Практичнее делать не один огромный «универсальный» модуль, а разделять слои:
общие для всех провайдеров входные параметры: имя, окружение, размер ресурсов, CIDR и описание сервиса;
отдельные модули для каждого провайдера: реализация VM, сети и балансировщика;
общие Ansible-роли и манифесты GitOps поверх созданной инфраструктуры;
средства выгрузки и загрузки данных;
проверки, подтверждающие одинаковый результат и нужные свойства инфраструктуры.
Состояние Terraform нужно хранить удалённо, с блокировкой одновременных изменений, шифрованием и независимой копией. В нём могут находиться чувствительные значения, поэтому его нельзя просто положить в публичный Git.
Таблица: что восстанавливает код инфраструктуры, а что требует отдельного плана
Объект | Код создаёт инфраструктурную оболочку | Требуется дополнительно |
|---|---|---|
Сеть, виртуальные машины, межсетевой экран | да | квоты, реальная ёмкость и доступный API |
Узлы Kubernetes | да | первоначальная настройка, CNI/CSI и данные на томах |
Сервер GitLab | да | база данных, репозитории, файлы, секреты и ключи |
Управляемая база данных | да | резервная копия, восстановление на момент времени и проверка целостности |
Бакет S3 | да | сами объекты, версии и правила хранения |
Vault | да | снимок Raft, ключи распечатывания или восстановления, политики |
Готовая виртуальная система | частично | совместимый образ и часто ручной импорт |
Запись DNS | да | решение о переключении и возврате трафика |
10. Переключайте DNS только после технической приёмки
До переключения новый сервис можно проверять через временное имя или локальное переопределение DNS. Финальное переключение выполняется после того, как:
источник переведён в режим только чтения или остановлен;
последняя дельта данных перенесена;
приёмочные проверки пройдены;
мониторинг видит новую площадку;
сертификат выпущен и полная цепочка корректна;
TTL снижен заранее;
записан точный порядок возврата трафика.
После изменения DNS проверяйте ответы нескольких публичных DNS-резолверов, HTTP/TLS, отпечатки ключей SSH и реальные пользовательские операции. Старая площадка не должна продолжать принимать запись.
Откат возможен только пока данные не начали расходиться. После первых новых записей на новой площадке «вернуть DNS назад» уже не безопасная кнопка, а новая миграция данных.
11. После переезда закройте временные решения
Аварийная миграция почти неизбежно создаёт технический долг:
открытый SSH или временный публичный IP-адрес;
секрет в файле переменных окружения, доступном только пользователю root, вместо Vault;
готовая виртуальная система, импортированная вручную;
завышенные права для копирования бакетов;
временные DNS-записи;
остановленные, но ещё оплачиваемые ресурсы;
исключения из мониторинга.
Каждое такое решение нужно записать с владельцем и сроком удаления. Через несколько дней команда уже не вспомнит, почему межсетевой экран разрешает доступ всему интернету.
Проведите отдельный тест восстановления из копии, созданной уже на новой площадке. Иначе вы доказали лишь способность переехать один раз, но не способность пережить следующий отказ.
Практическая инструкция на одну страницу
Назначить руководителя работ по инциденту, журнал и канал связи.
Зафиксировать факты, RPO и доступные источники данных.
Остановить запись или определить единственный достоверный источник данных.
Создать и вынести свежие резервные копии, списки данных и контрольные суммы.
Подтвердить квоты, биллинг, API, сеть и образы цели.
Создать базовый контур восстановления и сеть из кода инфраструктуры.
Вернуть GitLab, секреты и административный доступ.
Развернуть платформу и восстановить данные сервисов.
Выполнить приёмочные проверки каждого сервиса.
Перенести финальную дельту, переключить DNS и наблюдать.
Остановить старую площадку, но сохранить её на период сверки.
Закрыть временные доступы, проверить новую резервную копию и обновить DR-план.
Самая важная часть аварийного переезда происходит до аварии. Код инфраструктуры сокращает время создания ресурсов. Независимые резервные копии возвращают данные. Проверенные инструкции уменьшают количество решений под давлением. А регулярная репетиция превращает заявленные RPO и RTO в измеренный результат.
Как это связано с DevSecOps, безопасностью и AppSec
Аварийный переезд — момент, когда удобство особенно легко поставить выше безопасности. Команда спешит вернуть сервис и временно открывает SSH всему интернету, передаёт секреты через чат, отключает проверку сертификатов или запускает старый образ с известной уязвимостью. Если такие решения не учитывать в общем плане, «временное» быстро становится постоянным.
DevSecOps в этом сценарии означает, что восстановление проходит через те же инженерные гарантии, что и обычное изменение: код проверяется, образы имеют понятное происхождение, секреты выдаются на ограниченный срок, действия журналируются, а временные исключения получают владельца и дату удаления. Скорость достигается заранее подготовленной автоматизацией, а не отключением защитных механизмов.
Команде AppSec важно проверить не только то, что приложение открылось. Нужно убедиться, что поднята ожидаемая версия, миграции базы применены в правильном порядке, внешние интеграции не отправляют данные на старые адреса, заголовки и настройки TLS сохранились, административные методы закрыты, а секреты, которые могли оказаться в аварийных скриптах или журналах, заменены. Для публичных приложений полезен короткий набор автоматических проверок: аутентификация и авторизация, доступ к административным маршрутам, работа с файлами, защита входящих уведомлений и отсутствие отладочного режима.
ИБ-команда отвечает за сохранение цепочки доверия: кто создал резервную копию, кто имел к ней доступ, откуда получен образ, совпала ли контрольная сумма и какие ключи были восстановлены. Это особенно важно после компрометации аккаунта: нельзя автоматически считать данные из старого облака доверенными только потому, что они самые свежие.
Участник | Решение, которое нельзя принять только силами DevOps |
|---|---|
Владелец продукта | какие функции возвращать первыми и какой объём потери данных приемлем |
Разработчики | можно ли совместить версии приложения и базы, как проверить предметные данные |
AppSec | безопасна ли версия приложения и не потеряны ли защитные настройки |
Информационная безопасность | можно ли доверять копии, ключам и административным учётным данным |
Юристы и специалисты по соответствию требованиям | допустимо ли новое место хранения и требуется ли уведомление |
Руководство | какой остаточный риск принять ради сокращения простоя |
Поэтому решение «переключаем DNS» должно быть общим решением о готовности сервиса, а не только техническим фактом, что новый IP отвечает на запросы. Успешное восстановление возвращает одновременно доступность, целостность данных, конфиденциальность и управляемость системы.
Источники
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.