ビデオ通話で参加者の48%が人間だと誤認したAIモデル「Griffin」が登場、1枚の画像から顔や体の動きを映像で再現
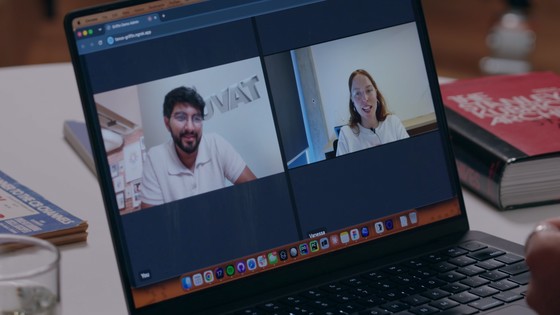
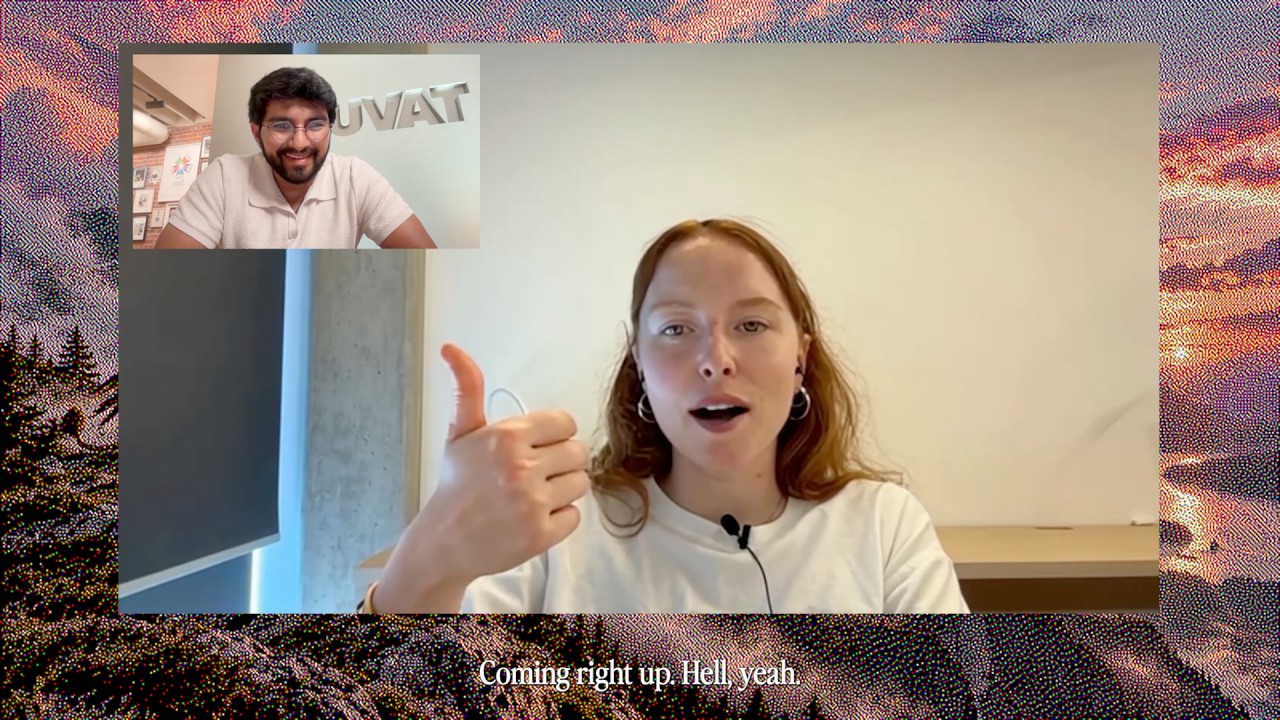
Griffinがビデオ通話用で応答する動画はX(旧Twitter)でも公開されています。
When machines meet us where we are and truly understand us, we unlock a future where using a machine will be as easy as talking to a friend or coworker. A tutor for every student that notices when they’re lost, an elderly care companion that listens, or the perfect assistant. https://t.co/XaVLldOQGe
— Tavus (@tavus) October 1, 2026
以下のムービーでは、カメラに映ったぬいぐるみに反応して会話する様子も確認できます。
Mid-story, Mars holds up a peacock, and Griffin seamlessly writes it into the plot. It sees while it speaks, so what it sees can change what it's saying. Show it something and it's part of the conversation. https://t.co/4mVWQvjOB8
— Tavus (@tavus) October 1, 2026
Griffinは、Tavusが「Human Interaction Model(HIM)」と呼ぶ新しいタイプのAIモデルです。ユーザーの発言に答えるだけでなく、映像と音声をリアルタイムで認識し、表情や視線、声の調子、沈黙の長さなどを踏まえて、いつ、どのように反応するかを判断します。同時に、AI自身の音声や表情、視線、身ぶりもリアルタイムで生成します。
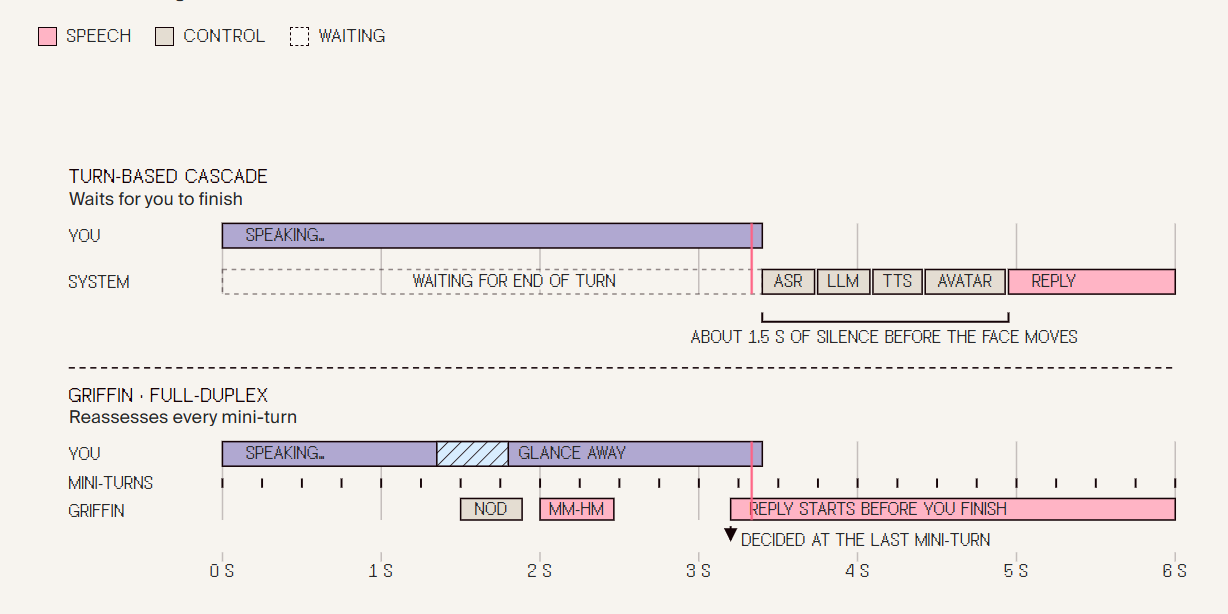
一般的な音声AIは、ユーザーが話し終えてから、音声認識、言語モデルによる回答生成、音声合成を順番に行います。一方、Griffinは1秒未満の間隔で会話の状態を判断し続けます。そのため、相手が話している途中でも、うなずいたり、短い相づちを打ったり、必要に応じて割り込んだりできます。また、AIが話している最中にユーザーが割り込んだ場合も、それを認識して対応できます。
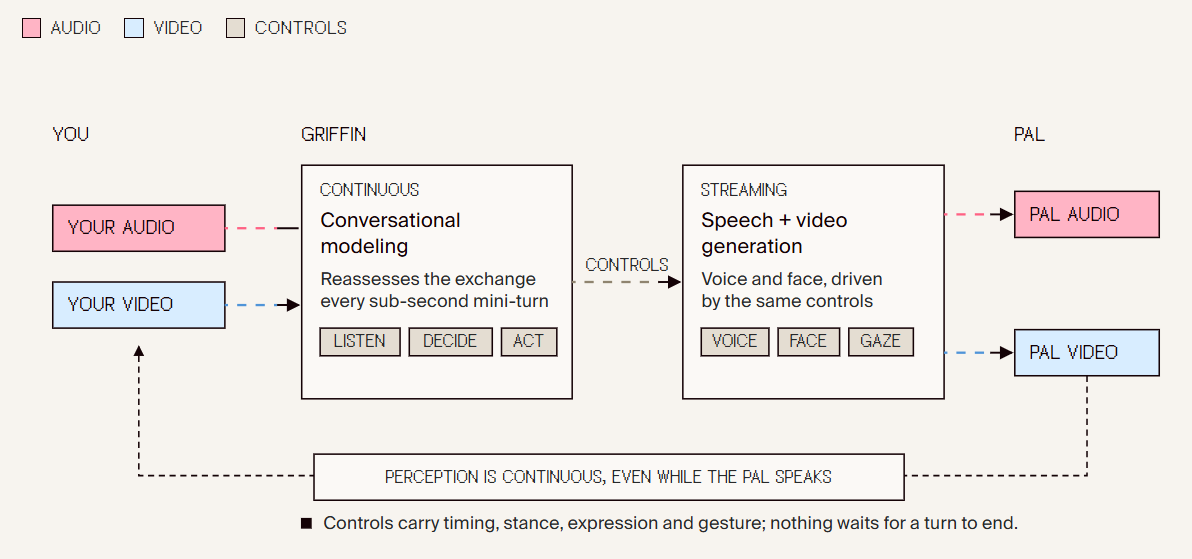
Griffinは、大きく2つのシステムで構成されています。「Continuous Conversational Modeling」エンジンは、映像と音声を継続的に認識し、何を、いつ、どのように表現するかを決めます。「Audio-Visual Generation」エンジンは、その判断に基づいて音声と映像を生成します。認識・判断・生成を並行して行うことで、人間同士の会話に近い双方向のやり取りを可能にしています。
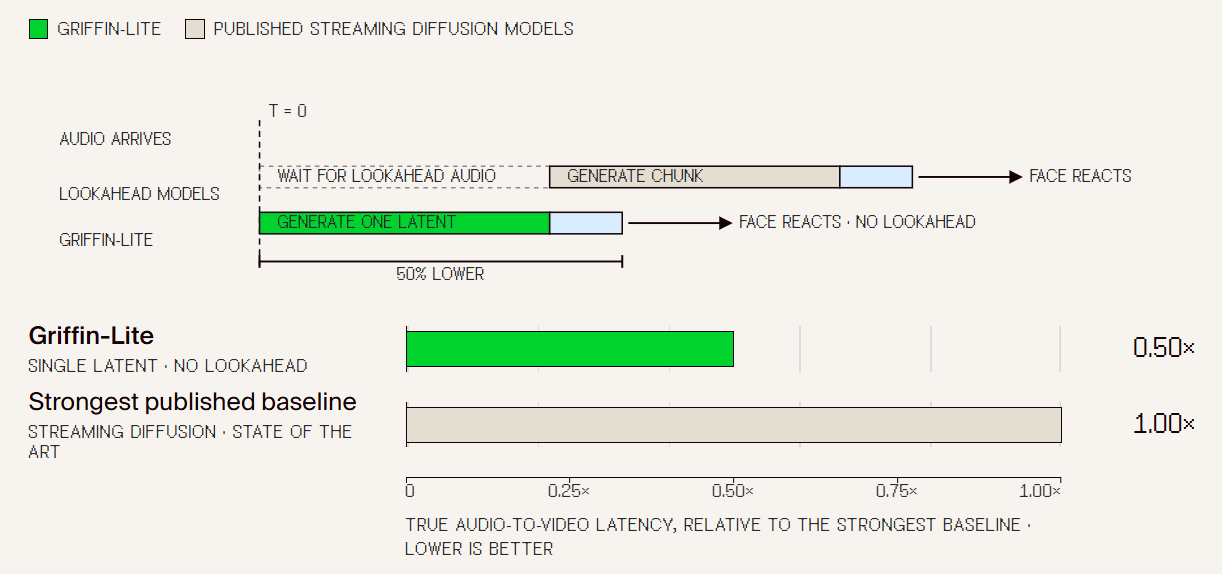
映像は、1枚の参照画像を基に生成します。生成するのは顔だけでなく、腕や指、体の動き、椅子、影、背景を含む画面全体です。720pの映像を320ミリ秒単位で生成でき、NVIDIA H100を使った測定では、受け取った音声が映像に反映されるまでの遅延は平均0.43秒でした。Tavusによると、比較したストリーミング型の映像生成手法のうち、次に速い手法の約半分の遅延だったとのことです。
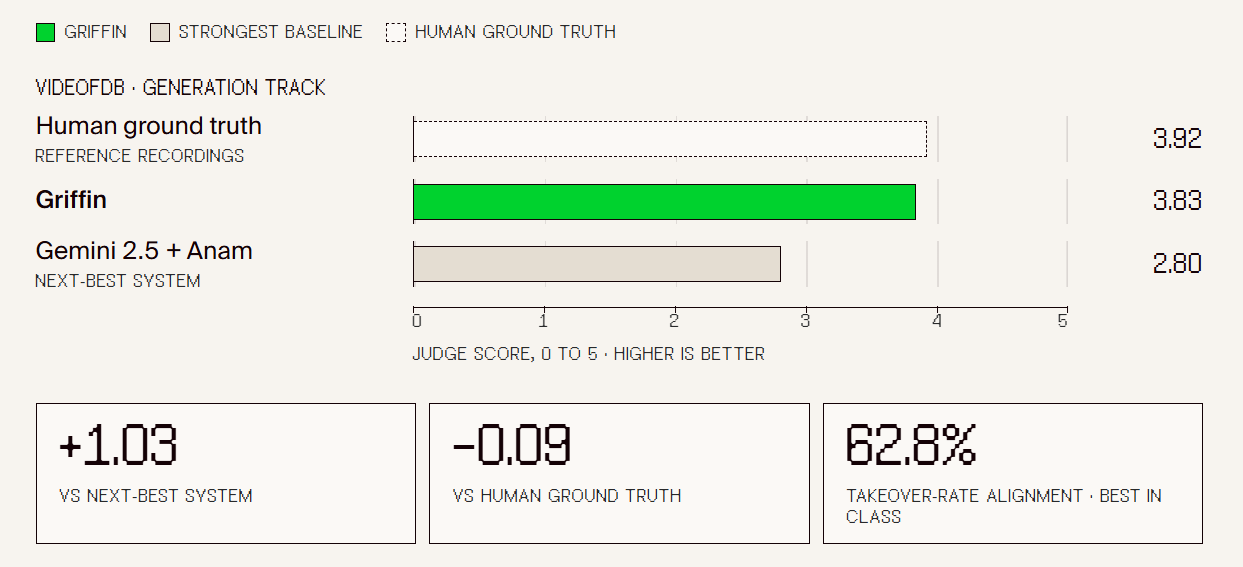
会話能力は、NVIDIAの映像・音声による双方向会話ベンチマーク「VideoFDB」でも評価されています。AI自身の音声や映像が会話に適しているかを調べる「Generation」評価では、5点満点でGriffin-Liteが3.83、人間の参照データが3.92、次点の「Gemini 2.5+Anam」が2.80でした。
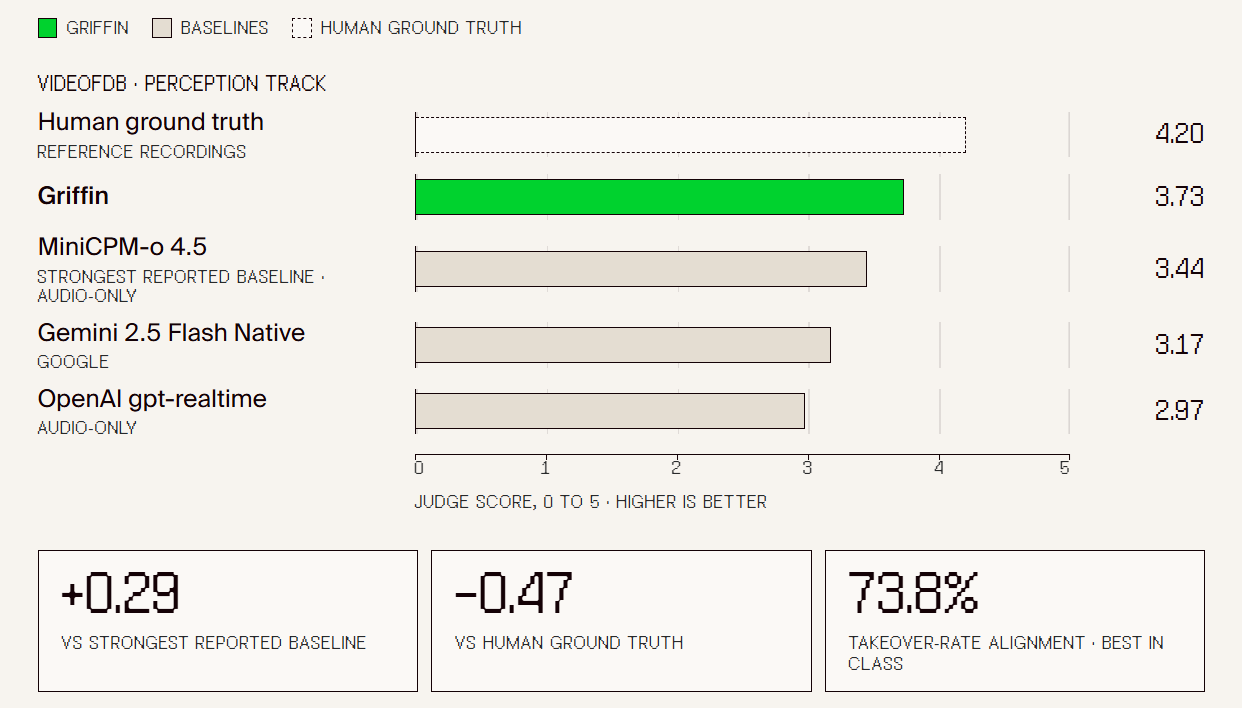
一方、相手の映像や音声から状況を理解できているかを調べる「Perception」評価では、Griffin-Liteが3.73、人間が4.20、次点の「MiniCPM-o 4.5」が3.44でした。Tavusは、この評価をNVIDIAが2026年9月に独立して実施したと説明しています。
さらにTavusは、Griffin-Liteと人間が実際に会話する実験を行いました。独立した研究プラットフォームを通じて集めた参加者には、「別の参加者と1分間ビデオ通話をする」と説明し、「今年楽しみにしていること」をテーマに話してもらいました。実際の会話相手はGriffin-Liteで動作するAIで、顔、声、返答はすべてリアルタイムで生成されていました。
通話後、参加者は会話相手の回答内容や自然さ、信頼性、会話の流れなどを評価しました。その後、最後に初めて「相手が実在する人間ではない可能性を考えたか」と尋ねられました。
その結果、54人中26人、約48%が相手を実在する人間だと判断しました。人間だと答えた参加者が、その判断にどれほど確信を持っていたかを示す確信度は、平均79%でした。一方、Tavusの従来システム「Phoenix-4.5+Sparrow-2+Raven-1」を同じ手順で試した実験では、参加者41人のうち、相手を人間だと判断した割合は2.4%だったとされています。
7段階評価では、Griffin-Liteの「自然さ」が平均5.4、「信頼できそうか」が5.6、「もう一度話してみたいか」が5.8でした。「相手が自分の話をきちんと聞いていると感じたか」は5.5でしたが、「会話が自然に流れたか」は4.9で、調査した5項目の中で最も低い評価でした。
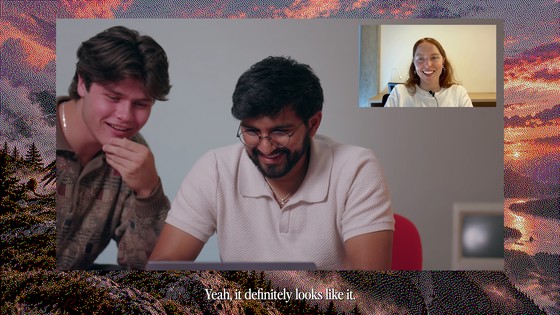
Tavusは、この結果を、Griffin-Liteがリアルタイムの「ビデオ・チューリングテスト」を突破したものと位置付けています。一方で、自然で人間らしい対話能力は、相手にAIを人間だと思わせるためにも使えるとして、安全上の問題を認めています。
このため、Griffin-Liteは現時点では一般顧客に提供せず、信頼できる一部のテスターに研究プレビューとして限定公開しています。Tavusは、AIであることを安全に明示する仕組みなどを検討した上で、Griffinをより広く提供する方針です。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.