Данные без противоречий: генерация через RegExp
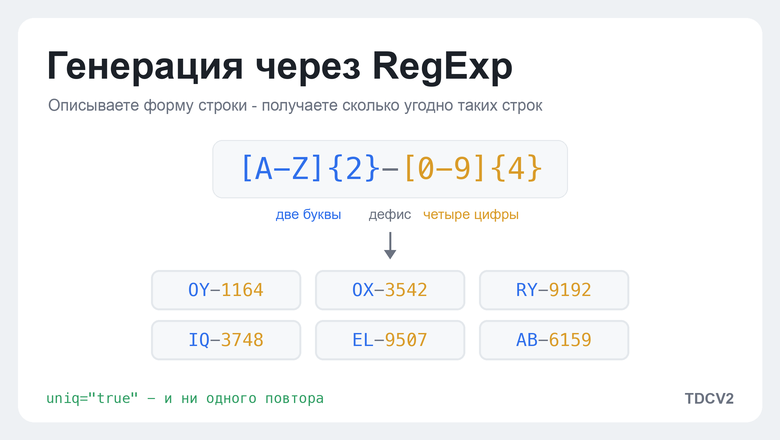
Цикл “Данные без противоречий” - про TDCV2, открытый конструктор тестовых данных, который я пишу сам. Работает он так: вы описываете конфигом, какой файл вам нужен, а конструктор порождает его целиком - от двух строк до сотен тысяч. Нужно это, когда надо наполнить базу, проверить отчёт или показать демо, а настоящие данные брать нельзя. От генераторов случайных значений он отличается одним: следит, чтобы данные не противоречили сами себе - про это весь цикл.
○ Часть 1 - Связи между полями
○ Часть 2 - Свободный формат вывода
○ Часть 3 - Справочники
○ Часть 4 - Форма данных рисунком
● Часть 5 - Генерация через RegExp
В первой части я связывал поля внутри строки, во второй собирал из значений файл любого вида, в третьей связывал уже не поля, а записи целиком, в четвёртой задавал форму данных рисунком. Сегодня про RegExp-генератор, который очень полезен: это синтаксический сахар, который позволяет генерировать значения со строгой формой.
Номер договора, госномер машины, артикул на складе, серия и номер паспорта. Форму они держат строго - две буквы, четыре цифры, косая черта, год, - и её можно проговорить словами, а значит, записать правилом. Такую колонку можно набить из списка, собрать формулой из счётчика и букв или взять генератор вроде Faker. А можно описать форму регулярным выражением и получать строки прямо по нему.
Сразу оговорюсь: идея не новая. Генерировать строки по регулярке умеют randexp в JavaScript, Xeger в Java, exrex и Hypothesis в Python. В TDCV2 я добавил это тоже, и первая половина статьи будет знакома тем, кто ими пользовался. Своё начинается дальше: уникальность, которая заранее знает, хватит ли места; точные доли прямо внутри выражения; условие, при котором одна часть строки следует из другой. Последние две вещи живут в расширенном генераторе advanced_regex, и в таком виде я их больше нигде не встречал.
И про слова. RegExp здесь - это синтаксис регулярных выражений, который TDCV2 использует как язык описания строки: конечное подмножество привычного синтаксиса плюс несколько своих конструкций. В конфиге генераторы называются regex и advanced_regex.
RegExp, вывернутый наизнанку
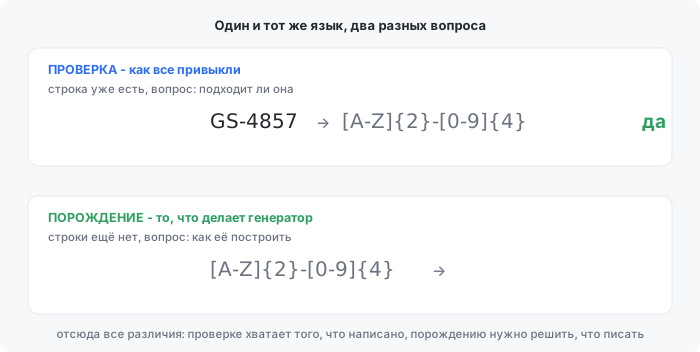
Регулярное выражение обычно проверяет, подходит ли строка. Здесь тот же синтаксис работает наоборот - порождает строку.
<sequence name="Contract">
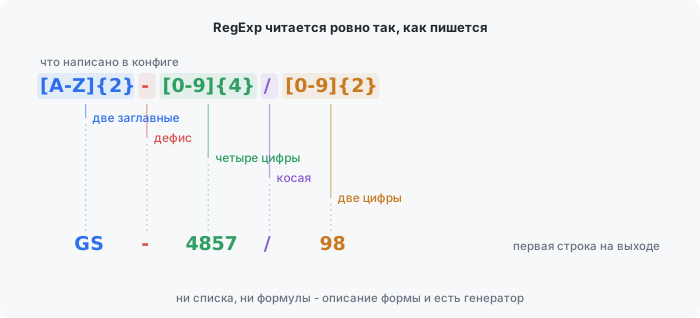
    <gen type="regex" value="[A-Z]{2}-[0-9]{4}/[0-9]{2}"/>
</sequence>
TO-0539/74
AS-8332/38
AK-9127/43
OR-8637/47
UN-2431/42
UM-8260/55Читается ровно как пишется: две заглавные буквы, дефис, четыре цифры, косая черта, две цифры. Отдельный список или формула тут не нужны - форма целиком описана выражением. На двух тысячах строк повторов не вышло, но это заслуга огромного пространства, а не гарантия - про гарантии ниже.
Кириллица работает так же - вот российский госномер:
<gen type="regex" value="[АВЕКМНОРСТУХ][0-9]{3}[АВЕКМНОРСТУХ]{2}[0-9]{2,3}"/>Т550МХ74
О738КЕ38
О389КС43
О628МТ471
В502МВ425
Р438СА556Двенадцать букв в классе - по правилам (ГОСТ Р 50577): в госномерах используют только те кириллические буквы, что похожи на латинские. Форму RegExp описывает верно, но за существование номера не отвечает: {2,3} даёт то два знака региона, то три, а регионы выходят какие попало - заодно выпадает и номер 000, которого не выдают. К этому ещё вернёмся.
Алфавиты и ловушка с отрицанием
Писать алфавит руками не обязательно: в TDCV2 есть именованные наборы, \a{...} (в обычных регулярках \a - это символ звонка, здесь он занят под алфавиты). Это удобнее диапазона и не теряет букв вроде ё, которые в [а-я] не попадают. Табельный номер для трёх офисов, каждый в своей письменности:
<gen type="regex" value="\a{cyrillic.ru.upper}{2}-[0-9]{4}"/>
<gen type="regex" value="\a{kana.katakana}{3}-[0-9]{4}"/>
<gen type="regex" value="\a{hebrew.letters}{3}-[0-9]{4}"/>
ЫХ-4053 ホョリ-1095 דהה-8329
ЖО-7087 ヒトヤ-9507 מעך-5711
ХА-3765 スヲヴ-6912 עלפ-5227Алфавиты складываются прямо в классе: [\a{arabic.letters}\a{hebrew.letters}] тянет символ из обоих.
А вот ловушка. В TDCV2 отрицание и точка считаются от печатного ASCII. [^0-9] - это не «любая буква, кроме цифр», а весь печатный ASCII без цифр, со скобками и процентами: uA?\Cg, )~IK&%. То же самое с \D, \W, \S и точкой. Для не-латиницы набор выписывают положительно - диапазоном или через \a{...}. Альтернатива, группы, обратные ссылки \1, сокращения \d и \w тоже есть - со своей, генераторной семантикой.
Ещё несколько форматов, которые я гонял на движке, - можно забирать как есть:
номер заказа    ORD-[0-9]{8}                        →  ORD-36079102
номер рейса     (SU|S7|U6|DP) [0-9]{3,4}            →  DP 607
время           ([01][0-9]|2[0-3]):[0-5][0-9]       →  21:30
цвет HEX        #[0-9A-F]{6}                        →  #5A0CF2
размер в SKU    TS-[0-9]{4}-(XS|S|M|L|XL)           →  TS-3607-XL
Вывод в статье показывает форму результата, а не эталон. Если, скопировав выражение, вы получите другие значения, - всё в порядке: розыгрыш зависит от сида и ещё от имени колонки, у каждой свой поток случайности, чтобы новая колонка не сдвигала соседние.
Имя для куска - и вопрос, выпал ли он
Группе можно дать имя - (?<p>...) - и повторить её дальше через \k<p>. Но интереснее другое: по имени можно спросить, выпала ли группа вообще. Возьмём телефон, где код то в скобках, то через дефис: (495) 123-45-67 или 495-123-45-67. Открывающая скобка необязательна, а закрывающая должна появиться ровно тогда, когда была открывающая:
<gen type="regex"
     value="(?<p>\()?[0-9]{3}(?(p)\) |-)[0-9]{3}-[0-9]{2}-[0-9]{2}"/>
331-542-63-65
(808) 463-77-50
909-237-30-53
(552) 013-20-96(?(p)\) |-) читается «если группа p что-нибудь выдала - закрой скобку, иначе поставь дефис». Обойтись без условия можно - альтернативой (\([0-9]{3}\) |[0-9]{3}-), - но тогда середину, код из трёх цифр, придётся написать дважды, а в длинном выражении - это ещё и дважды править. Условие позволяет написать её один раз. Веток у него ровно две, вторую можно опустить, а спрашивать можно только группу левее - иначе движок откажет ещё до прогона.
Красивое свойство: условие не тратит случайность. Оно ничего не разыгрывает, а читает решение, уже принятое группой. Добавьте условие в готовый RegExp - и все разыгранные куски останутся на своих местах:
(?<a>[0-9]{3})?[A-Z]{2}          (?<a>[0-9]{3})?(?(a)-)[A-Z]{2}

993ZL                            993-ZL
294EV                            294-EV
625RB                            625-RB
TR                               TR
BC                               BC
Тот же сид, те же куски, добавился ровно дефис. Правку можно внести, не переделывая эталонный файл целиком.
Почему плюс под запретом
Привычный + движок не примет:
<gen type="regex" value="[a-z]+"/>

error[TDC097]: invalid regex generator pattern: regex: unbounded "+"
               quantifier is not allowed; use "{1,n}" at offset 5
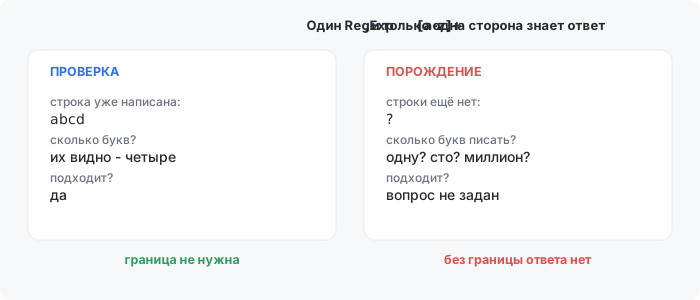
Проверяющей регулярке граница не нужна: она смотрит на готовый текст. Порождающей надо откуда-то узнать, сколько букв писать - одну, тысячу, миллион? Другие генераторы подставляют скрытый потолок по умолчанию. TDCV2 так не делает: тогда длина колонки зависела бы от невидимой настройки, и одно и то же выражение значило бы разное. Поэтому потолок пишется явно.
По той же причине запрещены *, {n,}, ленивые квантификаторы и заглядывание вперёд и назад. Лечится это вписыванием разумного потолка - {1,12} вместо +. Рядом живёт второй потолок, на длину результата: по умолчанию тридцать два знака. Для хэшей и токенов его поднимают прямо на генераторе - regex_max_length="40".
Поначалу раздражает, но из запрета растёт полезная вещь. Раз безграничных квантификаторов нет, любое выражение TDCV2 описывает конечное множество строк, и его размер можно сосчитать - а значит, попросить уникальные значения. Об этом через раздел.
Правило, список и вычисление
RegExp описывает значение правилом: какие символы, сколько и в каком порядке. Возьмите правило слишком грубое - и выйдет мусор, который только притворяется данными:
<sequence name="R"><gen type="regex" value="[А-Я][а-я]{4,7}"/></sequence>
<sequence name="P"><gen type="template" value="person.male.lastName"/></sequence>
Гжьшку | Смирнов
Ьязкая | Иванов
Цднэчъпя | Попов
Эбзфкш | Васильев
Пфбои | Кузнецов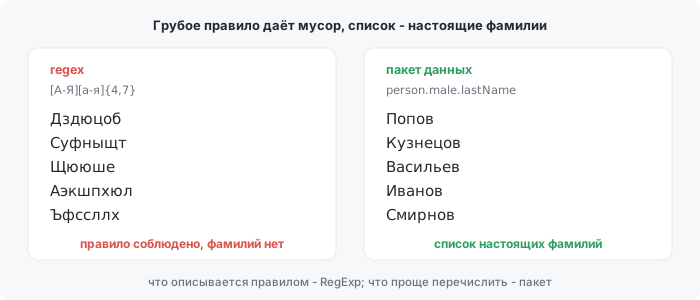
Слева формально всё верно, только это не фамилии. И дело не в том, что у фамилии есть смысл, а у номера нет. Правило «заглавная и четыре-семь строчных» просто слишком грубое и одинаково пропускает Смирнова и Гжьшку. Его можно сделать тоньше - как, показано под спойлером. Но это работа, а пакет данных даёт готовый список настоящих фамилий одной строкой.
Генератор фамилий на RegExp: слоги и окончания
Для демонстрации я упростил русскую мужскую фамилию до модели основа плюс окончание. Посмотрел на 1608 фамилий из пакета: у половины из них окончание -ов, дальше идут -ин, -ев, -ский и -кин, основа обычно в четыре-шесть букв.
Основа собирается из слогов «согласная + гласная»: буквы сами собой чередуются, и слово читается вслух. Окончание берётся вместе с последней согласной основы, потому что не всякая буква дружит с каждым окончанием. -ов хорошо встаёт после к, н, р (Раков, Панов), -ин после л, ш, д (Силин, Тишин, Дудин), -кин после ш и н (Пушкин).
<sequence name="Root">
  <gen type="regex"
    value="[БВГДЗКЛМНПРСТШ][аоуеи]([бвгдзклмнпрстш][аоуеи])?"/>
</sequence>
<sequence name="Tail">
  <gen type="regex"
    value="[кнрлтмс]ов|[црш]?ев|[лргшдтвмз]ин|[шнрт]?кин|[вн]ский"/>
</sequence>
...
<data>${{Root}}${{Tail}}</data>
Пешкин Дударев Каткин
Вуканов Шурин Мишев
Новошкин Кадоев Сушин
Номаев Бокин ГотеновБольшинство строк похожи на фамилии, хотя попадаются и неудачные - Пупосов, Роромов: модель простая. Часть совпала с настоящими - из тысячи сгенерированных семнадцать нашлись в пакете: Басов, Букин, Горев, Тишин, Шаров. А с долями, о которых ниже, окончания выходят в тех же пропорциях, что в пакете: на тысячу строк 500 -ов, 190 -ев, 160 -ин, 80 -кин и 70 -ский.
Так что правилом фамилию описать можно. Вопрос в цене: пришлось посчитать окончания по настоящим фамилиям, подобрать буквы и проверить, что на выходе нет ничего неприличного. RegExp выигрывает там, где разных фамилий нужно больше, чем есть в списке: в пакете их полторы тысячи, а RegExp на ста тысячах строк дал сорок тысяч разных. В остальных случаях пакет проще.
Граница между правилом и списком проходит и внутри одного номера. В госномере буквы и цифры - это правило, а регион - список: 74 есть, 00 нет, а трёхзначных кодов в ходу несколько десятков из девятисот возможных. В показанном прогоне на тысяче номеров [0-9]{2,3} дал трёхзначный регион 488 раз, из них 383 разных, и восемь раз регион 00. Короткий список лечится прямо в RegExp - перечислением через |:
<gen type="regex"
     value="[АВЕКМНОРСТУХ][0-9]{3}[АВЕКМНОРСТУХ]{2}(77|177|777|78|178|50|150|66|196)"/>
Х440ХН196
Х360НУ78
С816ОВ177
Т590МН150Теперь в номерах только Москва, Петербург, Подмосковье и Свердловская область, и коды у них настоящие. Длинному списку - все регионы, города, банки - место в пакете.
Отсюда правило. RegExp - для той части значения, что описывается правилом. Что проще перечислить, чем описать, - из пакета или коротким списком через |. А цифру, которую не выбирают, а вычисляют из остальных, как контрольную в ИНН или ОГРН, считают формулой - об этом раздел в конце.
Когда номер обязан быть один такой
Значения тянутся независимо друг от друга, поэтому совпадения рано или поздно пойдут. [A-Z]{2}-[0-9]{3} - это 676 тысяч строк, но на пяти тысячах ожидается около восемнадцати повторов, в показанном прогоне вышло 15. Это парадокс дней рождения: число возможных пар строк растёт как квадрат их количества. Лечится одной штукой - uniq="true":
<sequence name="V" uniq="true">
    <gen type="regex" value="[A-Z]{2}-[0-9]{3}"/>
</sequence>
Пять тысяч различных из пяти тысяч. Механика тут не та, что ожидаешь: все 676 тысяч строк никто не перечисляет - движок помнит только то, что уже выдал, а от выражения ему нужен размер. Тянем, а если значение уже было, тянем ещё раз. И здесь окупается запрет на плюс: размер считается по дереву, без единой порождённой строки. Класс даёт столько, сколько в нём символов, последовательность перемножается, | складывает. Для номеров и кодов счёт точный; там, где разные ветки могут дать одну и ту же строку, это верхняя граница, и движок вдобавок следит, чтобы не крутиться впустую.
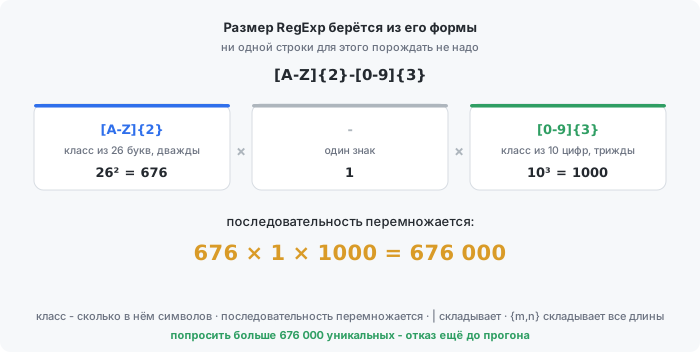
Раз размер известен до прогона, невыполнимую просьбу движок отклоняет сразу и называет оба числа:
tdcv2: uniq: sequence "V" cannot produce 700000 unique values — the pattern
"[A-Z]{2}-[0-9]{3}" makes at most 676000 different strings.
Widen the pattern, or lower the count.
Чем ближе запрос к пределу, тем больше повторных попыток, но движок доводит дело до конца: все сто тысяч значений из ста тысяч возможных для [0-9]{5} вышли меньше чем за две секунды. А если номера должны идти подряд, как выданные по порядку, - берите счётчик, и пусть RegExp рисует всё остальное.
Проценты прямо внутри RegExp
Дальше понадобится второй генератор - advanced_regex. Общего у него с обычным много, но полного вложения нет. Один RegExp, два генератора, один сид:
выражение                            regex           advanced_regex

[A-Z]{2}[0-9]{3}                     SL889 AS661     SL889 AS661
([A-Z]{3})-\1                        SLU-SLU         SLU-SLU
(?<a>[A-Z]{2})-\k<a>                 SL-SL           SL-SL
(AB|CD)-[0-9]{2}                     CD-47 CD-78     CD-47 CD-78

(?<a>[0-9]{2})?(?(a)-)X              47-X 78-X       отказ TDC130
(?%{70:RU;30:US})                    отказ TDC097    RU US
(?<a>(?%{...}))/(?if{a=A:x;*:y})     отказ TDC097    A/x B/y

[a-z]+                               отказ TDC097    отказ TDC130
Верхние строки совпали дословно. Дальше разница в обе стороны: условие (?(имя)да|нет) есть только у обычного regex, а доли (?%{...}) и условие по значению (?if{...}) - только у advanced_regex.
У номера часто есть не только форма, но и доли: семьдесят процентов договоров российские, двадцать американские, десять немецкие. Здесь они пишутся внутри самого выражения:
<gen type="advanced_regex" value="(?%{70:RU;20:US;10:DE})-[0-9]{2}"/>(?%{ открывает взвешенный выбор, дальше через точку с запятой идут пары «процент, двоеточие, ветка». Сумма должна быть ровно сто, иначе прогон не начнётся. На ста строках:
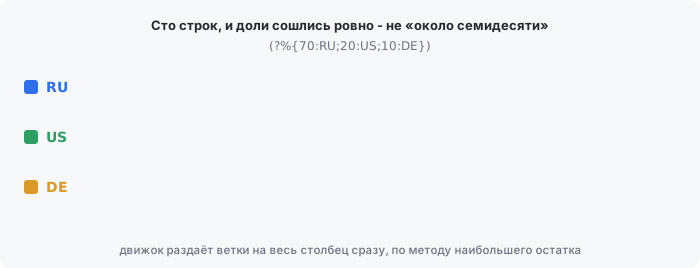
Не «примерно семьдесят», а ровно, насколько позволяет целое число строк: движок раздаёт ветки по методу наибольшего остатка - тому, которым делят мандаты между партиями. Монетка на каждую строку легко дала бы на сотне 64 или 78, и тест, сверяющий доли, падал бы через раз. Это выбор, а не единственно верный путь: если нужен разброс, как в живых данных, точные доли его уберут. Даже с uniq="true" доли не сдвигаются ни на строку - повторившееся значение тянется заново по тем же веткам, а если в ветке не хватит места на её строки, прогон откажет и назовёт долю.
Ветка - сама полноценное выражение, поэтому доли вкладываются друг в друга. Шестьдесят процентов российских, из них восемьдесят московских:
<gen type="advanced_regex"
     value="(?%{60:RU-(?%{80:MSK;20:SPB});40:US})"/>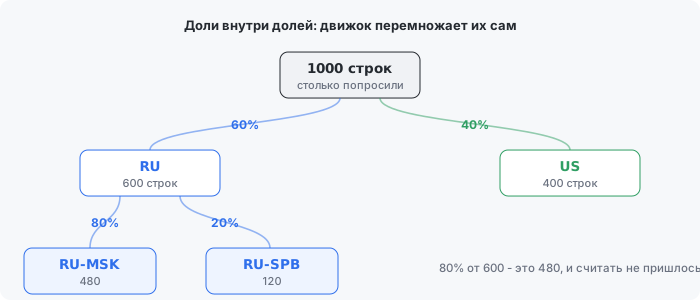
Когда одна часть строки следует из другой
Условие (?if{...}) спрашивает у группы не «выпала ли», а что именно выпало, и веток у него сколько угодно. Это частый случай в жизни: тип документа и его название, страна и формат её номера.
<gen type="advanced_regex"
     value="(?<vid>(?%{70:ДГ;30:СЧ}))-[0-9]{4}/(?if{vid=ДГ:договор;vid=СЧ:счёт})"/>
ДГ-6896/договор
ДГ-7599/договор
СЧ-6185/счёт
ДГ-3187/договор
СЧ-4244/счётГруппа с долями получает имя, а (?if{...}) читает её значение и печатает подходящую ветку. ДГ всегда получает «договор», а СЧ - «счёт»: это не совпадение долей, а свойство самой конструкции.
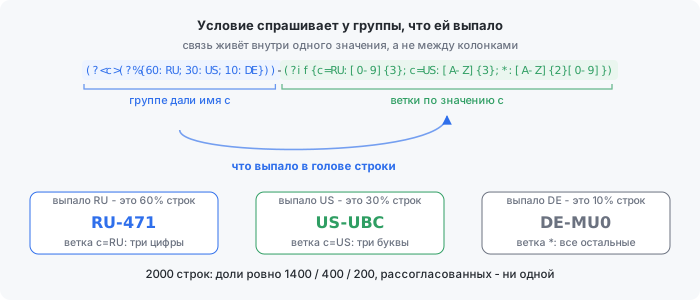
Внутрь ветки кладётся что угодно, включая ещё одно выражение. Код, у которого формат хвоста зависит от страны:
<gen type="advanced_regex"
     value="(?<c>(?%{60:RU;30:US;10:DE}))-(?if{c=RU:[0-9]{3};c=US:[A-Z]{3};*:[A-Z]{2}[0-9]})"/>
RU-185
US-UBC
RU-382
DE-MU0
US-YNQЗвёздочка - ветка «все остальные», сюда попала Германия. Без неё неподошедшая строка получит пустоту: движок не выдумывает значение за вас. Можно спорить, не лучше ли тут отказ, но пока так, поэтому ветку «иначе» стоит писать всегда. На двух тысячах строк доли остались точными, 1400, 400 и 200, а рассогласованных строк ноль. Условие читает только группу из того же выражения; связи между колонками по-прежнему делаются через parent, как в первой части.
Собираем всё вместе
Складская выгрузка. Нужен артикул, в префиксе которого зашита категория - инструмент, крепёж, электрика, - с долями 55, 30 и 15 процентов. И зона хранения, которая обязана соответствовать категории: инструмент в зоне A, крепёж в B, электрика в C.
<sequence name="Article">
    <gen type="advanced_regex" value="(?%{55:TL;30:FS;15:EL})-[0-9]{4}-[A-Z]{2}"/>
</sequence>
Можно было бы завести отдельную колонку категории и собрать из неё и артикул, и зону - так связывали поля в первой части. Здесь я нарочно беру другой случай, который встречается в чужих выгрузках: колонки нет, категория живёт только в начале артикула, и соседнее поле читает её через starts_with:
<sequence name="Zone" parent="Article">
    <gen if="starts_with(Article, 'TL')" type="regex" value="A-[0-9]{2}"/>
    <gen if="starts_with(Article, 'FS')" type="regex" value="B-[0-9]{2}"/>
    <gen if="starts_with(Article, 'EL')" type="regex" value="C-[0-9]{2}"/>
</sequence>
TL-9868-BP A-13
TL-6973-VH A-31
FS-6829-AK B-45
TL-2844-KH A-82
EL-3391-RW C-08На тысяче строк ровно 550, 300 и 150, и ни одной зоны не в свою категорию. Взвешенный выбор задал распределение, а parent и starts_with сделали из него связь. Если связанные части живут внутри одной строки, хватит (?if{...}); если это разные колонки, как здесь, - связывайте через parent.
Когда RegExp, а когда mix
Доли ведь уже были - через <mix>. Разница в том, что ветвится. Доли в RegExp ветвят кусок одной строки, а всё вокруг остаётся общим. <mix> выбирает между способами получить значение: тут из пакета, там формулой, здесь пусто.
<sequence name="Num"><gen type="increment" value="1"/></sequence>

<mix name="Otv" percent="70,20">
  <case><gen type="template" value="person.male.lastName"/></case>
  <case><gen type="formula" expr="'SRV-' + (1000 + Num)"/></case>
  <case></case>
</mix>
Алексеев
Петров
Орлов
SRV-1004
Борисов
МасловНа тысяче строк 700 фамилий, 200 служебных учёток и 100 пустых: percent="70,20" на три ветки, последняя забирает остаток. Обратите внимание на SRV-1004 в четвёртой строке: формула считается для той строки, которой досталась ветка, и читает её собственный номер. Внутри одного RegExp такое не сделать - он не умеет брать значения из пакета.
Цифра, которую не рисуют, а считают
Остался третий вид правды - вычисление. ОГРН, основной регистрационный номер организации, - это тринадцать цифр, и в нём видны все три вида сразу:
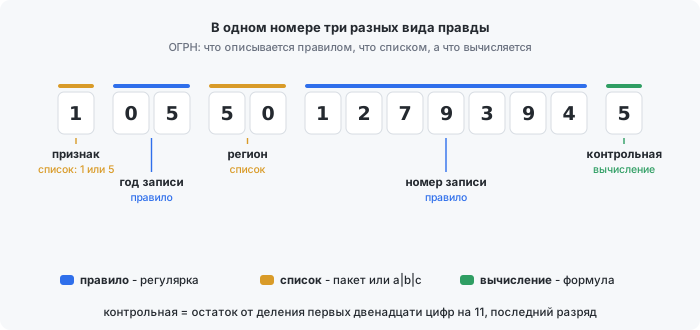
Признак (1 или 5), год записи, регион, номер записи - и тринадцатая цифра, которую считают из первых двенадцати. Если нарисовать все тринадцать одним RegExp, форму пройдёт вся тысяча строк, а контрольную - около десятой части, слепой случай: в показанном прогоне 103. Контрольная цифра - это роль, а не позиция, и операции «вычисли по предыдущим цифрам» в синтаксисе TDCV2 нет. Теоретически такой язык регулярный и выражение для него существует, но читать его было бы невозможно.
Поэтому первые двенадцать цифр рисует RegExp, а тринадцатую считает формула Base % 11 % 10: остаток от деления на 11, а если он равен 10, получается 0.
<sequence name="Base">
    <gen type="regex" value="(1|5)(0[2-9]|1[0-9]|2[0-6])(77|78|50|66|16)[0-9]{7}"/>
</sequence>
<sequence name="Check">
    <gen type="formula" expr="Base % 11 % 10"/>
</sequence>
...
<data>${{Base}}${{Check}}</data>
1055012793945
5186603287151
1267704858299
1217710063933Тысяча из тысячи. Первую строку можно проверить руками: 105501279394 делится на 11 с остатком 5. Склеивать основу и цифру надо в строке вывода, а не формулой Base + Check. Плюс в формуле складывает, если обе стороны похожи на числа, - даже '12' + 3 даст 15, - и склеивает, если хоть одна не похожа, как 'SRV-' выше. Основа из одних цифр для формулы - число.
У карты, ИНН или IBAN арифметика тяжелее, и писать её на практике не нужно: в пакетах есть готовые common.payment.card.pan, russia.tax.inn_org, common.finance.iban и тот же russia.tax.ogrn - у каждого тысяча из тысячи. RegExp с формулой нужен там, где готового нет: свой формат, свои доли, свой префикс.
Что из этого следует
RegExp в генераторе - не тот же инструмент, что в проверке, хотя язык один. Проверяющий отвечает на вопрос «подходит ли», порождающий - «как это построить». Отсюда и запрет на плюс, и доли прямо внутри выражения. И читается порождающий легче: ему не надо предусматривать всё, что может прийти на вход, - он описывает только то, что вы хотите получить.
У такого RegExp оказалось четыре слоя: форма, необязательность, доли и согласование. Четыре вопроса, на которые раньше отвечали в разных местах конфига, теперь умещаются в одно выражение.
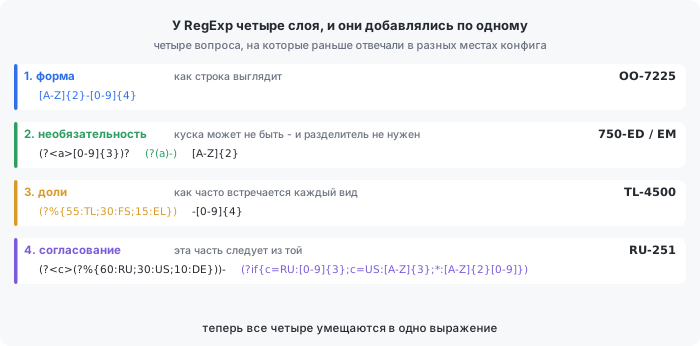
А инструмент выбирается просто. Формат можно проговорить словами - «две буквы, дефис, четыре цифры» - значит, RegExp. Значения проще перечислить, чем описать, - пакет. Цифру надо посчитать - формула. Многие настоящие идентификаторы удобно разложить на эти три части. А строка, безупречная по форме, но невозможная по существу, пройдёт проверку формы и сломается позже - на бизнес-правиле или контрольной сумме, где искать причину уже дороже.
Инструмент называется TDCV2, лежит под MIT.
○ Часть 1 - Связи между полями
○ Часть 2 - Свободный формат вывода
○ Часть 3 - Справочники
○ Часть 4 - Форма данных рисунком
● Часть 5 - Генерация через RegExp
Буду очень рад любым комментариям! Найдете ошибку, не стесняйтесь сообщить о находке и поправлять меня в комментариях. Увидимся в следующей статье. Всем добра!
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.