Три дата-центра за четыре дня: как я в одиночку увозил прод от Яндекса
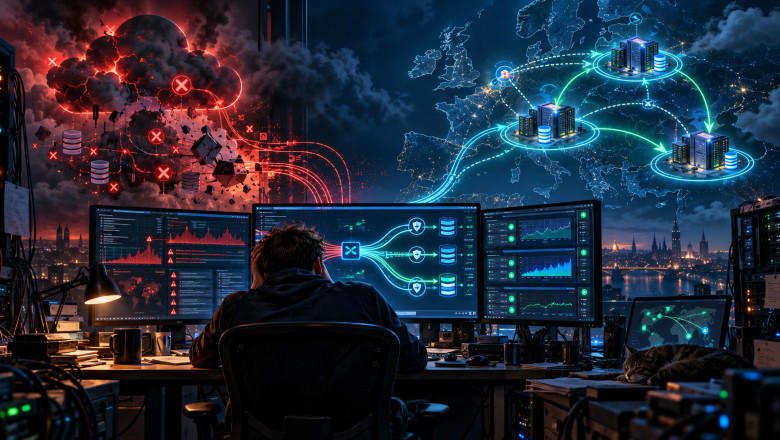
В октябре беспилотники за четыре дня выбили три дата-центра Яндекса. Через пять дней после первого удара наш прод уже жил на собственной платформе: три зоны у разных провайдеров, контрольный узел в Амстердаме (чтобы было) и ни одного managed-сервиса.
Переносил всё я один, потому что больше было некому. Это не туториал, а рассказ о том, как это было, где я споткнулся и что до сих пор не доделано.
Четверг — воскресенье: «у нас всё штатно»
8 октября прилетело в Сасово. Прод даже не моргнул: нагрузка ушла в другие зоны, клиенты ничего не заметили. Легли только тестовые контуры, но на них, честно говоря, никто и не рассчитывал. Начали делать экстра-бэкапы и поднимать резервные стенды, сдув пыль с Supermicro в офисной стойке, который подрабатывал раннером для GitLab и крутил офисный CUPS.
9-го была Калуга. Облако ушло в аварийный режим, и вокруг начало сыпаться всё подряд: банки, медиа, чужие внутренние CRM. Мы пока держались, но я уже понимал, что это скорее везение, чем архитектура.
11-го, в воскресенье, ударили по Владимиру, и везение кончилось. Встали наша CRM и клиентский ЛК. Вишенкой на торте с утра не открывался мессенджер Яндекса (год назад нам надоело крутить левые копии софта, который нельзя купить, и связанные скотчем опенсорс-проекты, и мы переехали на «надёжную общую платформу» для всего).
В тот же день я экстренно перевёз всё на тот самый офисный сервер. Один ESXi-хост, никакой нормальной репликации. Это сработало как временное решение, но жить на одной железке (которая внезапно из «хоста для всякой офисной мелочи» превратилась в прод всея Руси) — такой себе план.
Понедельник: никаких managed-сервисов
В понедельник я решил, что больше не хочу зависеть ни от одного конкретного провайдера. Облака — не зло. Просто когда за четыре дня выбивают три дата-центра одного оператора, managed-сервисы внезапно перестают быть managed. А у нас были и PostgreSQL, и ClickHouse, и Kubernetes, и Lockbox — всё managed у Яндекса, где не осталось возможности даже оживить ту самую постгрю из их же бэкапов или хотя бы выгрузить их. Благо своих дополнительных бэкапов хватало, особенно после событий прошлой недели.
Правило получилось простое и немного параноидальное: только обычные виртуалки, которые можно взять почти у кого угодно. Сеть, кластеры и failover — всё своё, поверх них. Managed Kubernetes остался в Яндексе, сервисы теперь живут в Docker Compose: поднимать собственный k8s в нескольких зонах за неделю я не рискнул.
Теперь о команде. Отдел DevOps состоял из меня, меня и меня. Благо была подмога лида одной из бэкенд-команд (меня) и надзор CTO (ну вы поняли). Проектов у нас относительно немного, в основном пока внутрянка, и на managed-сервисах у крупного облачного провайдера фултайм-DevOps был и не нужен. Так что с понедельника по пятницу я почти не спал.
Что я собирал
Единица отказа в новой платформе — зона, и каждая зона — это несколько VM в трёх ролях:
control — WireGuard-хаб зоны, Caddy на входе, etcd, Redis Sentinel;
data — PostgreSQL с Patroni, Redis, Kafka на KRaft, ClickHouse с Keeper и Garage в роли S3;
apps — сервисы в Docker Compose, edge на nginx и data-proxy на HAProxy.
VM мощные, чтобы с запасом покрывать все нужды, а перенастроить их состав позже — не проблема (об этом чуть дальше). Прод, напоминаю, в этот момент крутился на одной ESXi-тачке в офисе, которая уже хотела начать дымиться, так что было не до перфекционизма.
Все зоны обслуживают трафик одновременно, никакого деления на основную и резервную.
Сеть — WireGuard overlay. Внутри зоны узлы видят друг друга напрямую, между зонами трафик идёт через control. Базы и очереди слушают только overlay, наружу почти ничего не торчит.
Вход — DNS с проверками здоровья (StatusFox — мой личный проект, который внезапно пригодился на работе). Если зона не отвечает на /edge-health, её A-запись пропадает из выдачи. Caddy на control ведёт запросы в apps своей зоны, а если та умерла — в соседние.
Данные. Приложения ходят на pg:5432, redis:6379, kafka:9092 и так далее, а за этими именами стоит локальный data-proxy. Он сам находит лидера Patroni и master по Sentinel, поэтому переключение сервисы замечают только по разорванным соединениям. S3 — Garage в трёх зонах с тройной репликацией.
Singleton-сервисы вроде Keycloak, которые не хотят запускаться в двух копиях, держат лидерство в etcd. Пропала зона — лидерство уходит в другую, и сервис оживает там.
Прод живёт в трёх полных зонах: Москва и два Санкт-Петербурга, в разных ДЦ. Плюс один control в Нидерландах, без данных и трафика, только ради голоса в кворумах etcd и Sentinel, ну и для корпоративного КВН. Dev и staging — в двух зонах.
Главное, ради чего всё затевалось: новая зона — это несколько VM у любого провайдера и строчка в inventory. Дальше Ansible сам поднимает туннели, вводит узлы в кластеры, настраивает реплики и DNS. Удалить зону — убрать строчку и прогнать тот же pipeline: он уведёт лидера, вычистит узлы из etcd, KRaft и Keeper и обновит DNS. Захотим не три зоны, а пять — поднимем ещё VM и добавим по строчке в конфиг.
Грабли, о которых не пишут в документации
Про что-то я знал заранее, что-то выяснил по ходу, а на кое-что наступил уже после переезда.
Registry HashiCorp из России недоступен. VM описаны в OpenTofu, провайдеры ставятся из registry.opentofu.org. Мелочь, если знать заранее.
WireGuard между странами режется. Об этом (я надеюсь) давно все знают. Российские control и узел в Нидерландах напрямую друг друга не видят, поэтому межрегиональный overlay идёт через хаб в Амстердаме на другой общеизвестной родственной технологии. Через него же российские хосты ходят в зарубежный интернет: российские адреса остаются на своём канале, остальное уходит в туннель. Второй зарубежный хаб для failover исходящего трафика тоже добавляется одной строчкой — просто пока до этого не добрался.
Самая подлая — Garage. Он не закрывает простаивающие keep-alive-соединения. Когда кончаются файловые дескрипторы, S3 API умирает, а процесс жив и /health зелёный. Мониторинг доволен, сервисы — нет. Лечится поднятым лимитом, принудительным разрывом простаивающих соединений через 5 минут и алертами на закрытый порт и занятость дескрипторов.
Yandex CDN тоже надо было чем-то заменить. Оказалось, Garage умеет отдавать бакет как сайт. Так теперь работают статика и корпоративный лендинг (тот самый, о существовании которого вспоминают раз в год). Кеш только браузерный, и пока этого хватает: объёмы у нас не те.
Вторник, 19:00
Основной cutover начался во вторник в 19:00 и закончился около двух ночи. Dev, staging и prod переехали за один заход, потом было несколько дней обнаружения нюансов и мелких правок. Благо отдел QA поработал на славу и устроил полный регресс-тест всего, что только можно.
А в среду умер офисный сервер. Тот самый ESXi, который спас нас в воскресенье. У хоста поехала память: поток исправимых ECC-ошибок, а через полчаса после загрузки (если работают все VM) — PSOD. Пока не нагружаем — живёт. Отключил всё лишнее, ждёт пересадки сердца памяти, после чего опять будет служить в прежней роли на подмоге.
Переехали вовремя, в общем.
Что получилось и чего пока нет
Прод переживает потерю одной полной зоны без ручных действий. DNS уводит трафик, Patroni выбирает нового лидера, singleton-ы переезжают, деплои идут в оставшиеся зоны. Это сильно лучше, чем «надеемся, что у Яндекса (ну или VK, Сбера, <вашего_любимого_облака>) всё будет хорошо». Если «прилетит», поднимаем тот самый комплект VM (а если у провайдера есть поддержка API/Terraform, то их поднимает Ansible) и живём дальше.
Теперь честно о том, чего нет:
Потеря двух зон из трёх убивает кворум etcd, Sentinel, KRaft и Keeper. Работающие сервисы продолжат отвечать, но запись и failover остановятся. Чтобы спокойно терять две зоны, нужны пять голосующих доменов — например, две дешёвые VM-свидетели у других провайдеров. Держим это в уме: если вдруг опять «начнётся», заранее раскатаем резервные зоны.
Dev и staging живут в двух зонах. Потеря любой переводит Postgres в read-only и останавливает singleton-ы. Для них мы приняли это как ограничение — переживём.
275 таблиц сервиса каталога созданы как обычный MergeTree и лежат на одном узле. Нужна правка сервиса.
Зачем я это пишу
Если вы сидите в одном облаке и думаете «ну у нас же multi-AZ», задумайтесь: мы тоже так думали. И проверьте, есть ли у вас runbook, по которому за сутки можно переехать на чужие виртуалки, не потеряв данные. RTO, RPO, DRP, BCP — не просто красивые аббревиатуры, и в этот раз я был рад, что когда-то всё задокументировал.
Есть и менее приятный вывод: вся эта неделя держалась на одном человеке. Сработало, но bus factor, равный единице, — такая же точка отказа, как дата-центр. И её Ansible не закроет. Но это уже наша внутрянка.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.