Мелкие дефекты теряются, а метрика молчит: систематическое сравнение Mask R-CNN и YOLO на 1812 производственных снимках
Привет, Хабр! Меня зовут Максим, я студент РТУ МИРЭА, и хочу поделиться темой, которая меня давно зацепила.
Рано или поздно на это натыкается каждый, кто делает визуальный контроль на своих данных. Модель уверенно находит крупные детали, средняя метрика выглядит вполне достойно, а мелкие дефекты, ради которых всё и затевалось, она почти не видит. По общей цифре этого не понять.
Ниже инженерный разбор: что проверялось, на каком протоколе, где легко ошибиться и какие выводы из этого следуют.
Какой вопрос остаётся без ответа
Прикладные работы по сегментации дефектов обычно устроены так: берут Mask R-CNN, улучшают её под свою задачу (бетон, алюминиевые диски, дорожное покрытие) и отчитываются об одной выбранной конфигурации. Другие собирают новые датасеты и бенчмарки, синтезируют дефектные изображения, делают аугментацию по маскам или специальные few-shot сети. Третьи сравнивают YOLO и Mask R-CNN, но на садах, изоляторах или оползнях. Исследования влияния глубины дообучения и шага обучения при малых данных чаще встречаются на других задачах, например в медицинской классификации.
Среди разобранных работ мне не попалось ни одной, где на одном реальном производственном наборе с дефектами по единому протоколу проверяли бы сразу все рычаги: перенос весов, скорость обучения, объём выборки, бэкбон и функцию потерь маски, а затем сравнивали бы две архитектуры одним и тем же кодом оценки. В итоге у инженера с парой тысяч снимков нет ответа на простой вопрос: что крутить первым.
Коротко о результатах:
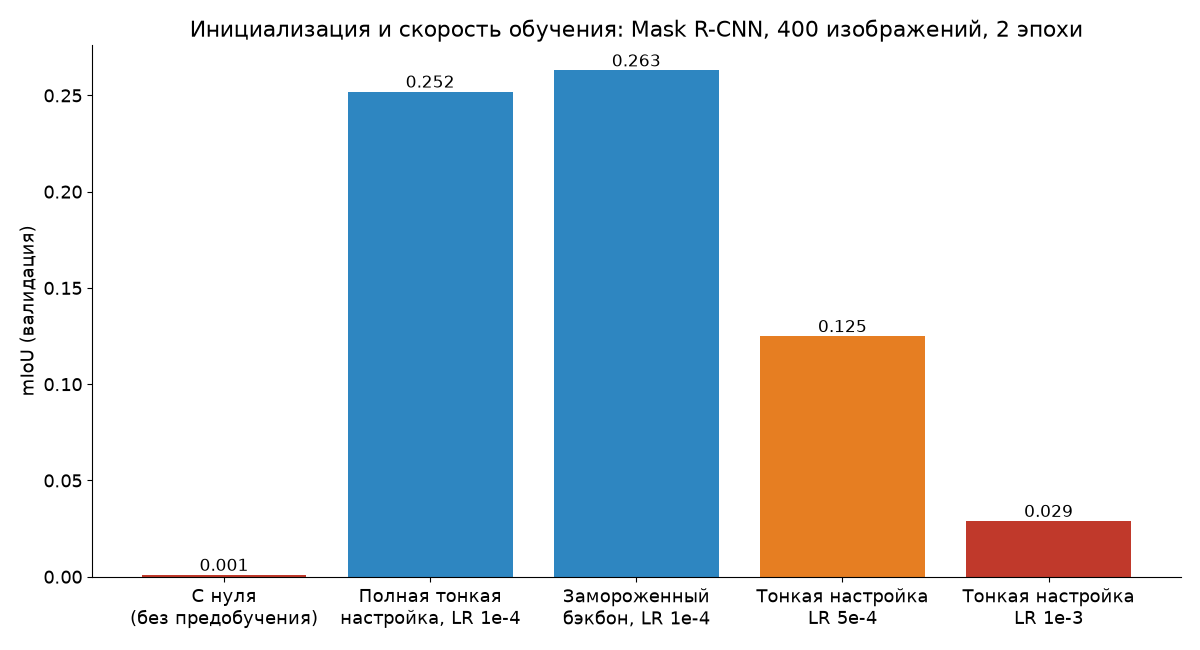
lr 1e-3 вместо 1e-4 роняет mIoU с 0,252 до 0,029, а удвоение данных с 200 до 400 снимков даёт всего +0,007;
качество класса почти не зависит от числа примеров (r около −0,23), но сильно связано с логарифмом площади маски (r = 0,68–0,74);
BCE + Dice в функции потерь маски даёт +15,8% AP на дефектах и +14,7% на мелких объектах, а на трещинах AP впервые становится стабильно ненулевым;
YOLO11s-seg и Mask R-CNN при оценке одним кодом: AP 0,193 против 0,189 при модели в 4,6 раза меньше и инференсе на порядок быстрее.
Оговорка сразу: это один основной датасет и одно семейство моделей, абсолютные цифры зависят от разрешения и бюджета обучения. Качественные выводы (нужность предобучения, вред завышенного lr, убывающая отдача от данных, разрыв между крупным и мелким) я ожидаю увидеть и в других задачах с малыми данными, а сам протокол переносится на них как есть.
Откуда взялась задача
Задача: сегментация повреждений автомобилей. На фото нужно выделить кузовные детали и дефекты на них (вмятины, царапины, сколы). Первый подход был очевидным: Mask R-CNN с весами COCO, дообучение, взгляд на общий AP. Цифра выглядела неплохо.
Картина изменилась, когда я посмотрел на предсказания глазами. Двери, бамперы, фары модель обводила аккуратно. Царапина на двери либо пропадала, либо сливалась с маской самой двери. Трещины и коррозию модель почти не замечала. Средняя цифра по всем классам этого не показывала: крупных объектов много, они хорошо сегментируются и тянут среднее вверх.
Отсюда два вопроса. Если данных мало (а на реальном производстве их всегда мало), какие настройки обучения действительно влияют на качество? И почему одни классы учатся, а другие нет?
Данные
Основной набор производственный: фотографии повреждений автомобилей, обезличенные.
1812 изображений с полигональной разметкой;
29 классов: 21 вид конструктивных элементов и 8 видов дефектов;
24 851 размеченный объект: 15 767 элементов и 9 084 дефекта.
Восемь типов дефектов: вмятина, царапина, трещина, коррозия, отслоение покрытия, скол покрытия, отсутствие элемента, разрушение элемента.
Набор неудобный ровно так, как неудобны любые реальные данные. Дисбаланс классов больше 40:1: самый частый класс встречается больше 3200 раз, самый редкий меньше 80. Сцены плотные, в медиане 15 объектов на снимок, на самом загруженном 136. Много мелочи: 11% масок меньше 100 пикселей, 34% меньше 1000. Снимки небольшие, медиана около 714×479.
Второй набор открытый, CarDD, тоже повреждения автомобилей. На нём проверялось, не особенность ли это конкретных данных.
Разбиение 70/20/10 с фиксированным seed. Тестовая часть (182 снимка) использовалась один раз, для итоговой оценки. Всё остальное, включая выбор порога, делалось на валидации. Звучит банально, но именно здесь чаще всего срезают углы.
Как устроены эксперименты
Железо обычное. Основная серия сравнений (2 эпохи, 400 снимков) шла на ноутбуке с M2 Pro через PyTorch MPS. Длинные прогоны на 15 эпох и YOLO шли на ПК с RTX 5080. Дополнительно Kaggle: 2×T4 или P100, около 30 часов в неделю. В сумме десятки прогонов и десятки GPU-часов, типичная задача занимает от 1,3 до 2,5 часа.
Чтобы этим можно было управлять, понадобилась небольшая инфраструктура. На уровне идеи:
очередь экспериментов в одном файле: у каждой задачи свой конфиг, зависимости («запускать после X»), статус и оценка времени;
раннер, который берёт следующую задачу, запускает обучение и после сбоя продолжает с последнего чекпойнта;
у каждого прогона сохраняются конфиг, окружение (версии torch, CUDA, GPU), лог, метрики по эпохам в jsonl и статус;
локальный веб-дашборд со сводкой.
Рутина отдана AI-агентам (Cursor и opencode): они готовят конфиги, ставят задачи в очередь и пишут отчёты по завершённым прогонам. Ещё один агент раз в 30 минут проверяет, не упало ли обучение и не простаивает ли GPU. Решения о том, что запускать и как трактовать результат, принимает человек.
Правила воспроизводимости: фиксированы seed, разбиения, размеры входа и пороги. В каждом сравнении меняется ровно один фактор. Каждый вывод проверяется на 2–3 seed.
Почему с нуля не работает и как легко сломать предобучение
Первый вопрос: насколько нужны веса COCO. В Mask R-CNN с ResNet-50 около 46 млн параметров. На 400 снимках за две эпохи модель с нуля дала mIoU 0,001, то есть фактически ноль. С предобученными весами получилось 0,252–0,263.
Разница между полной тонкой настройкой (0,252) и замороженным бэкбоном (0,263) в пределах шума короткого прогона, победителя тут нет. Но эпоха с замороженным бэкбоном на 21% короче (178 с против 226 с). Если GPU в дефиците, это аргумент.
Неожиданным оказался шаг обучения. AdamW очень чувствителен к нему:
1e-4: mIoU 0,252;
5e-4: 0,125;
1e-3: 0,029.
Шаг вырос в десять раз, качество упало почти в девять. Что происходит под капотом: признаки, выученные на COCO, затираются первыми же крупными обновлениями весов, и сеть фактически начинает учиться заново, но уже без данных, которых на это хватило бы. Значение lr часто берут из чужого туториала, где модель учили с нуля или на большом датасете. На малых данных с предобучением это прямой путь выбросить веса COCO и не заметить этого.
Бюджет обучения: 2 эпохи против 15
Факторы сравнивались по короткому протоколу в две эпохи: так можно быстро перебрать много конфигураций. Ловушка в том, что короткий протокол сильно занижает итоговое качество, и его цифры легко принять за потолок модели.
На тесте две эпохи дали mIoU 0,286 и AP 0,165. Та же конфигурация, дообученная до 15 эпох на всей обучающей выборке (два независимых прогона), дала тестовый mIoU 0,372–0,374 и AP 0,189–0,191. Прогоны разошлись всего на 0,0017 по mIoU и на 0,0025 по AP, результат воспроизводится.
Интереснее форма кривой. Валидационный mIoU выходит на плато 0,44–0,45 к 6–8 эпохе, максимум на восьмой. Дальше модель почти не растёт, но и не переобучается. Значит, добавлять эпохи бессмысленно: ограничение в чём-то другом.
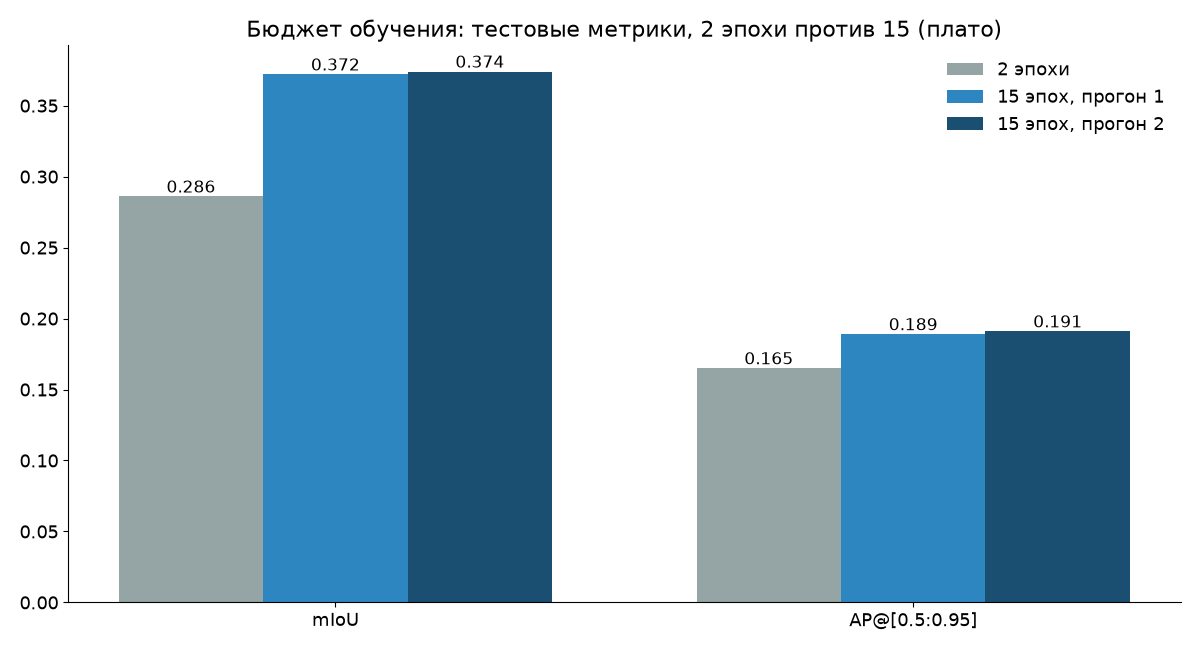
Практический вывод: короткий протокол годится, чтобы сравнивать настройки между собой, но абсолютные цифры из него показывать нельзя. Порядок факторов он сохранил, а потолок занизил.
Больше данных помогает, но всё слабее
Совет «соберите больше данных» проверялся напрямую, на подвыборках по 100, 200 и 400 изображений:
100 снимков: mIoU 0,149;
200: 0,245;
400: 0,252.
Переход со 100 до 200 дал +0,096, с 200 до 400 всего +0,007. Разметку удвоили и почти ничего не получили.
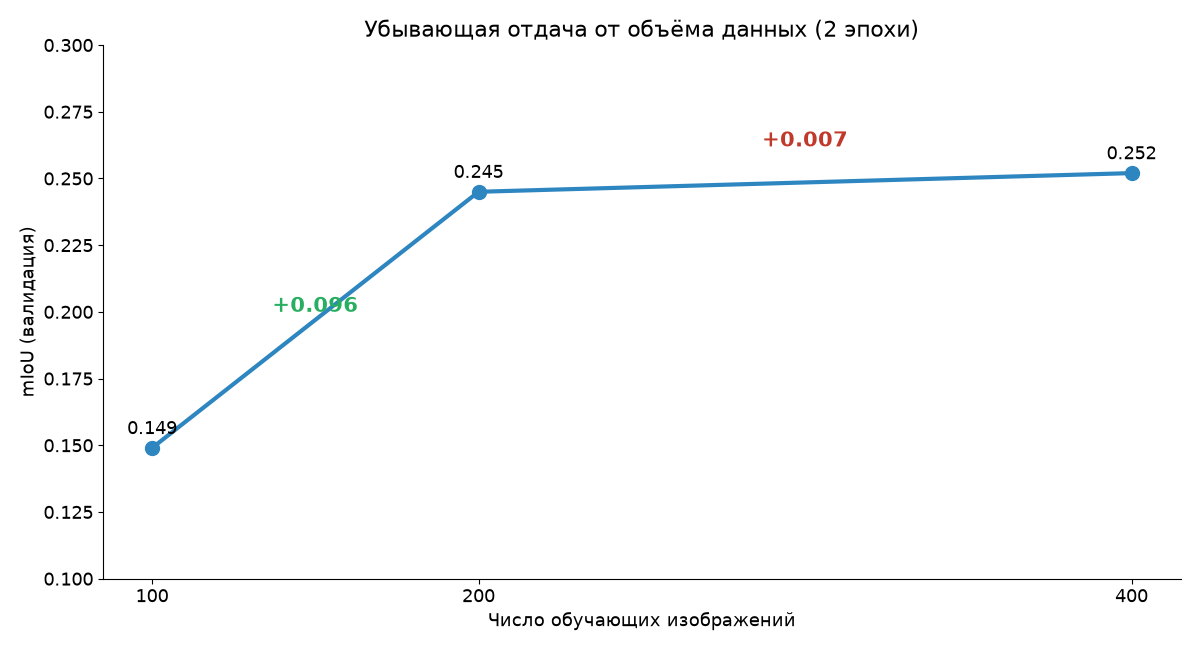
Причина в составе данных. Новые случайные снимки приносят ещё больше дверей и бамперов, которые модель и так сегментирует нормально. Редких дефектов в них по-прежнему мало. Поэтому бюджет на разметку разумнее тратить прицельно: добирать примеры редких дефектов и следить за балансом, а не размечать всё подряд.
Главное наблюдение: решает площадь маски, а не число примеров
Интуитивное объяснение звучит так: дефекты плохо учатся, потому что их мало, значит, надо ребалансировать классы. Данные с этим не согласны.
После 15 эпох средний AP конструктивных элементов 0,253, лучший класс 0,376. Средний AP дефектов 0,020, лучший 0,086. Царапины, трещины, коррозия на входе 512×384 дают AP около нуля. Разрыв больше чем в десять раз.
Корреляция по классам показывает, что связь качества с числом экземпляров почти отсутствует и даже слегка отрицательная: r около −0,23 (−0,24 при 15 эпохах). А с логарифмом медианной площади маски связь сильная: r от 0,68 до 0,74. На этом наборе модель хорошо учит крупные объекты независимо от их частоты, а тонкие и низкоконтрастные проваливаются, даже если примеров хватает.
Механика простая. Снимок ужимается до 512×384, и тонкая царапина остаётся шириной в пару пикселей. К тому же стандартная бинарная кросс-энтропия усредняется по всей области интереса, и несколько пикселей дефекта тонут в фоне. Сеть получает за них очень слабый градиент.
BCE + Dice: маленькая правка, заметный эффект
Раз вклад мелкой маски размывается, логично поменять функцию потерь маски. Сравнивались три варианта при прочих равных: обычная BCE, BCE + Dice и Focal.
Dice считает перекрытие относительно площади самой маски. Ей неважно, большая маска или маленькая: промах на маленькой стоит столько же, сколько на большой. Именно этого и не хватало.
Результат BCE + Dice (среднее двух прогонов, тест):
общий AP с 0,190 до 0,200, это +5,4%;
AP мелких объектов с 0,118 до 0,136, +14,7%;
средний AP дефектных классов с 0,0202 до 0,0234, +15,8%;
на трещинах AP впервые стал стабильно ненулевым.
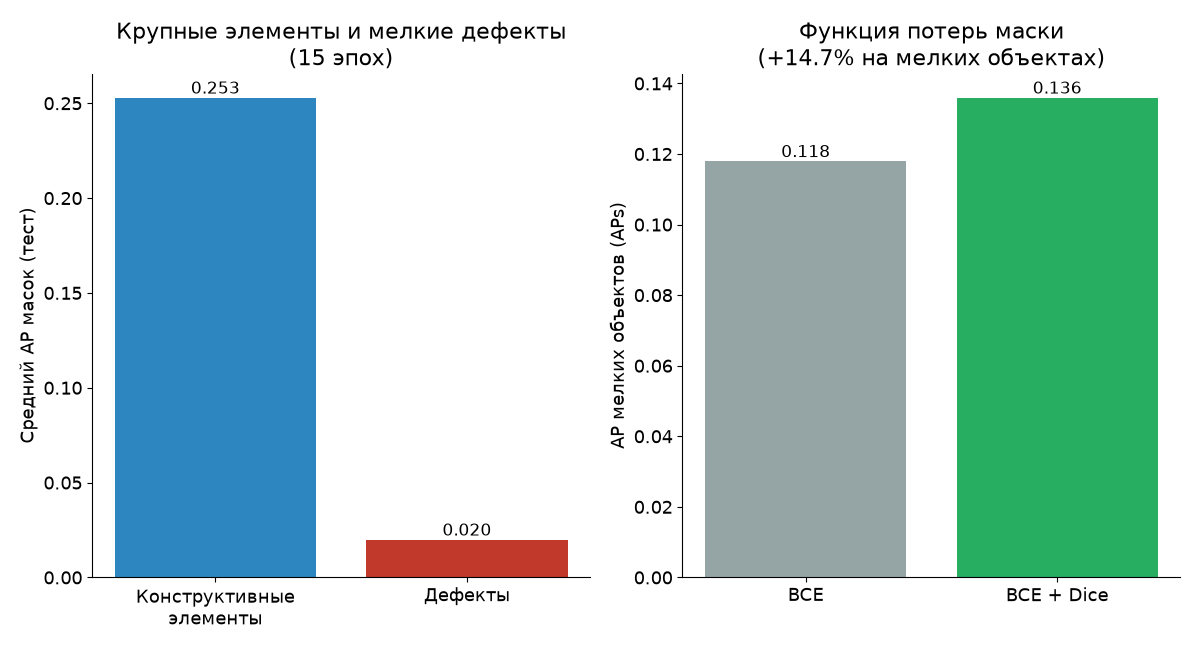
Focal без Dice оказалась хуже обычной BCE по всем метрикам, AP 0,177. Ожидалось обратное, ведь Focal придумана как раз под дисбаланс. Похоже, перевзвешивание «трудных» пикселей здесь не помогает, а помогает нормировка на площадь маски.
Абсолютные цифры для дефектов остаются низкими, иллюзий тут нет. Но правка не меняет архитектуру и скорость инференса, делается заменой одной функции и даёт прирост ровно там, где болит.
Mask R-CNN или YOLO11s-seg
Стоит ли вообще держаться за двухэтапную Mask R-CNN? Для проверки YOLO11s-seg обучалась по стандартному рецепту (30 эпох, вход 640×640), а обе модели оценивались одним и тем же кодом на одном тестовом наборе.
Итог на тесте:
AP: 0,193 у YOLO против 0,189 у Mask R-CNN;
AP50: 0,307 против 0,294;
AP мелких объектов: 0,180 против 0,127;
AR@100: 0,526 против 0,491.
Mask R-CNN выиграла только AP75 (0,204 против 0,198), и это в пределах разброса между прогонами.
Самая показательная строчка здесь AP мелких объектов: 0,180 у YOLO на входе 640 против 0,127 у Mask R-CNN на 512×384. Моя интерпретация: на мелочи количество пикселей решает больше, чем архитектура. YOLO просто видит каждый объект чуть крупнее. Асимметрия «крупное хорошо, тонкое плохо» у обеих моделей одинаковая.
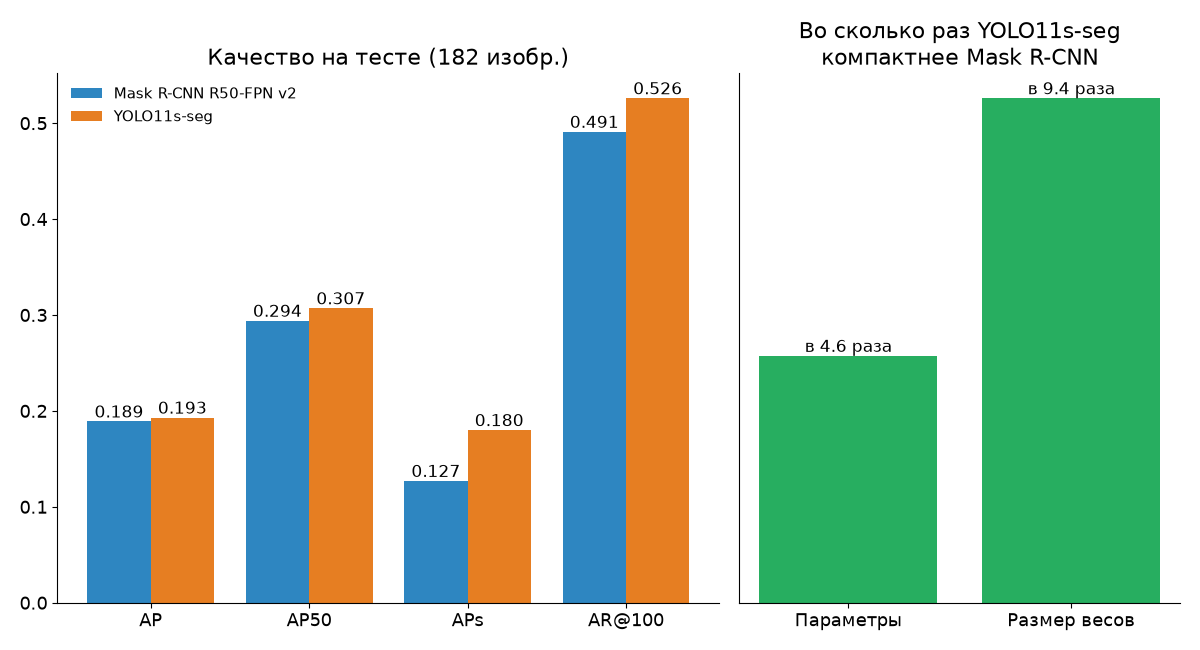
По инженерной части разница большая. У YOLO11s-seg в 4,6 раза меньше параметров (10,1 млн против 46,0 млн), веса в 9,4 раза легче (19,6 МБ против 184 МБ), инференс на порядок быстрее: 3,5–9,5 мс против 61–112 мс на снимок. Для edge-устройств выбор очевиден.
Но проблема мелких дефектов у YOLO никуда не делась: средний AP дефектов 0,023 против 0,020. Смена архитектуры сама по себе её не решает.
Ловушка с порогом уверенности
Здесь легко сделать неверный вывод при сравнении моделей. Для Mask R-CNN порог подбирался на валидации: максимум F1 на пороге 0,55 (0,4724), стандартный 0,5 дал 0,4718. Разницы практически нет, остался 0,5.
У YOLO11s-seg оптимум F1 на валидации оказался на пороге 0,2. Если сравнивать обе модели на одинаковом 0,5, YOLO выглядит хуже, чем есть. Уверенность у разных архитектур откалибрована по-разному, поэтому порог нужно подбирать для каждой отдельно.
В эксплуатации порог стоит выбирать под цену ошибки. Пропуск дефекта дорог: порог ниже, полнота выше. Ложная остановка линии дорога: порог выше.
Как увидеть проблему в цифрах
Все метрики в статье посчитаны одной библиотекой оценки, tinyeval (открытый pip-пакет, Apache-2.0, ещё в разработке). Интересна она не сама по себе, а тем, что показывает.
Стандартная разбивка COCO на три размера (small, medium, large), которой пользуются pycocotools, torchmetrics и встроенная оценка ultralytics, слишком грубая для дефектов: всё мельче 32×32 пикселей попадает в одну корзину. tinyeval режет объекты на мелкие корзины по размеру, вплоть до объектов в несколько пикселей, и для каждой метрики даёт доверительный интервал через бутстрэп. Без интервалов разница в пару сотых между моделями может оказаться обычным шумом.
Вторая полезная оценка: какая доля объектов становится крошечной после того, как снимок ужали до входа сети. Её можно получить до обучения, просто по разметке. На наборе с повреждениями автомобилей при входе 512 пикселей около 41% дефектов оказываются меньше 8 пикселей. Это хорошо объясняет, почему средний AP по дефектам упирается в потолок.
С эталонным pycocotools результаты совпадают до 1e-17, в библиотеке 32 теста и 82% покрытия кода. Все прогоны на обоих наборах посчитаны ею, так что модели, настройки и разрешения сравниваются одним кодом. В планах отдельная команда для анализа датасета до обучения: распределение размеров объектов, доля «невидимых» для сети объектов и рекомендация по разрешению.
Гипотеза: детектируемость определяется пикселями
Все наблюдения выше складываются в одну закономерность, которую я условно называю законом детектируемости. Простыми словами: точность модели на объекте зависит не столько от того, что это за дефект, сколько от того, сколько пикселей он занимает с точки зрения сети.
Что её поддерживает. На двух наборах с повреждениями автомобилей, производственном и CarDD, качество на дефекте сильно связано с его площадью и почти не связано с числом примеров (r = 0,68–0,74 против −0,23). При повышении входного разрешения точность стабильно растёт на обоих наборах, и это повторилось на нескольких seed. Сравнение YOLO и Mask R-CNN на мелких объектах ложится туда же. Последние повторы с третьим seed на CarDD на трёх разрешениях сейчас доучиваются.
Если закономерность подтвердится, практическая польза понятна:
заранее ясно, какая камера и какое разрешение съёмки нужны, чтобы находить дефекты заданного размера;
не нужно тратить недели GPU на перебор разрешений и архитектур;
можно честно увидеть, какие дефекты модель на таких снимках не найдёт в принципе.
Что ещё не проверено:
ложатся ли все результаты на одну общую кривую;
можно ли по прогонам на малых разрешениях предсказать результат на большом;
работает ли это на других типах данных, например на аэрофото.
Пока это не сделано, говорить о доказанном законе рано. Это гипотеза, подтверждённая на двух наборах одного домена.
Выводы
Главная мысль: на малых производственных данных основной враг не нехватка примеров редкого класса, а размер объекта в пикселях на входе сети. Ребалансировка классов и докупка разметки бьют мимо, если дефект после ресайза занимает два пикселя.
Чеклист для практиков:
Не учите с нуля на сотнях снимков, берите предобученные веса.
На тонкой настройке начинайте с маленького lr (здесь 1e-4 для AdamW). Шаг 1e-3 почти обнулил модель.
Если не хватает GPU, заморозьте бэкбон: качество то же, эпоха на 21% быстрее.
Сравнивайте настройки коротким протоколом, но итоговые цифры берите только с полного обучения.
Всегда отчитывайтесь по метрикам в разрезе классов и размеров объектов, а не одним средним. Именно в среднем прячутся провалы на мелочи.
До обучения посчитайте, какая доля дефектов становится крошечной при вашем входном разрешении. Если она большая, ни архитектура, ни эпохи это не исправят.
Размечайте прицельно: редкие и мелкие дефекты дают больше, чем ещё сотня случайных снимков.
Попробуйте BCE + Dice для маски. Focal без Dice здесь не помогла.
Подбирайте порог уверенности на валидации отдельно для каждой модели, иначе сравнение будет нечестным.
Согласуйте разрешение обучения и инференса.
Для edge рассмотрите YOLO11s-seg: качество на этом наборе то же, а модель в разы меньше и быстрее.
Смотрите на доверительные интервалы: разница в пару сотых AP может быть шумом.
Ограничения, о которых стоит помнить:
один основной производственный набор и один открытый, оба из одного домена (повреждения автомобилей);
исследовано одно семейство моделей Mask R-CNN и одна модель YOLO, трансформерные архитектуры не проверялись;
абсолютные цифры зависят от разрешения и бюджета обучения, переносить стоит выводы, а не значения;
абсолютное качество на тонких низкоконтрастных дефектах остаётся низким даже после всех улучшений.
Естественные следующие шаги: тайлинг (нарезка снимка на фрагменты, чтобы мелкие объекты не ужимались), локальное сверхразрешение для участков с подозрением на дефект, синтетическая балансировка редких классов и прогон трансформерных моделей сегментации на том же протоколе.
Вопрос к тем, кто решал похожую задачу в проде: что у вас реально сработало для мелких дефектов? Тайлинг, повышенное разрешение, отдельная модель на кропах или что-то ещё?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.