CactOS 2.0.0: последний релиз x86_32
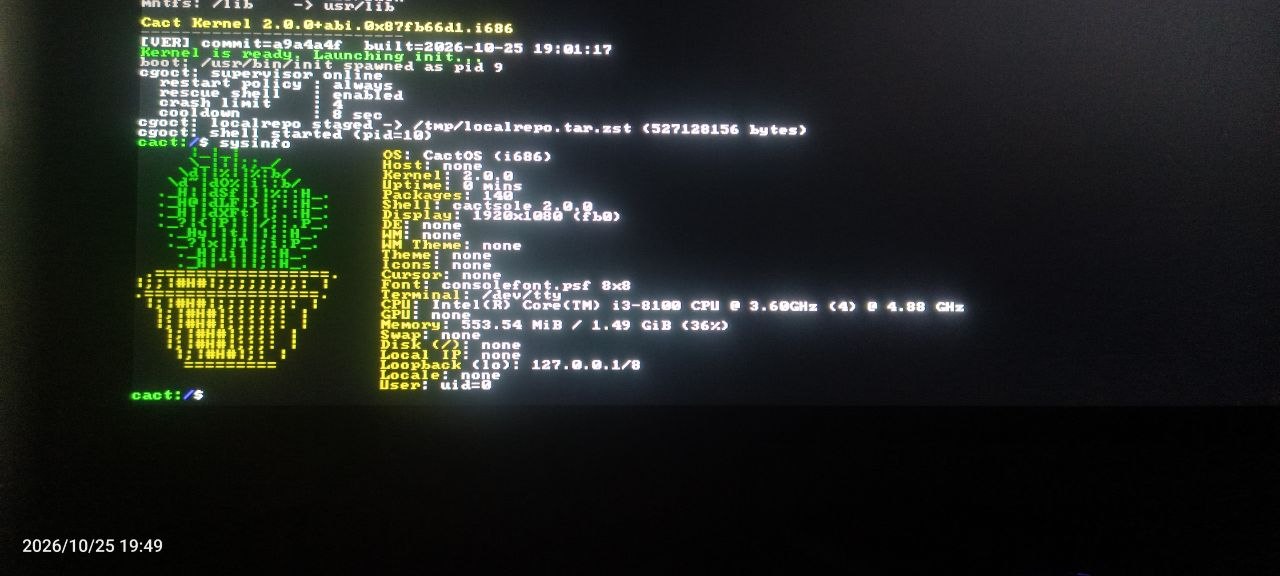
CactOS — хобби-операционная система для i686. Ядро гибридное монолитное: низкий уровень на C и NASM, критичные подсистемы переписаны на Rust — физический и виртуальный менеджер памяти (cact_mm), планировщик MLFQ (sched), примитивы синхронизации (cact_sync), сетевой стек (cact_net на smoltcp), TLS 1.3 (rustls с собственным криптопровайдером cact_crypto) и ядро VFS (cact_vfs).
Вокруг ядра — отдельный userspace: собственная libc (CactLibc), интерактивный шелл cactsole с конвейерами и job control, супервизор cgoct в роли PID 1, около 84 пользовательских утилит, пакетный менеджер cactpkg. Графическая часть в 2.0.0 ограничена modeset: рендеринг — задача 3.0.0.
Главная идея проекта — ядро намеренно минимально. Фиксированный ABI из 15 системных вызовов, всё остальное — ioctl-диапазоны в ioctl_abi.h. Драйверы вынесены из ядра в загружаемые модули .cctk, собранные как перемещаемые ELF и подгружаемые на лету. Системные сервисы — обычные userspace-демоны: logd, devd, netd, powerd, resolved, seatd, audiod. Отсюда принцип: чинить userspace, а не растить ядро.
Для тех, кто читал статью про 1.0.0: тогда было 95 системных вызовов. В 2.0.0 их 15 — не регресс, а сознательный сдвиг ABI. Всё, что раньше было отдельным сисколлом, теперь ioctl на VFS-узле: open() узла и команда из соответствующего диапазона.
Почему 2.0.0 — последний релиз x86_32
2.0.0 — не про новые возможности. Это последний 32-битный релиз, и его задача — закрыть остатки корректностных ошибок, незакрытых поверхностей и верификационного долга, чтобы 3.0.0 можно было начать с чистого листа уже на 64 битах. План был разбит на этапы, как в промышленных ОС: обязательные до тега, желательные и отложенные. Отложенные пункты я осознанно перенёс в 3.0.0. После тега v2.0.0 репозиторий x86_32 уходит в архив — дальше только 64-битная ветка.
Отдельное ограничение 32 бит — потолок адресуемой памяти. Ядро работает без PAE и может адресовать только ту физическую память, которую прошивка разместила ниже PCI-дыры. В QEMU с -M q35 при 4 ГиБ система видит около 2 ГиБ, с -M pc — около 3 ГиБ, на целевой плате — около 2,05 ГиБ. Это не ошибка ядра: PMM ставит под управление все кадры ниже дыры, а их количество определяется прошивкой, которая отображает остальное выше 4 ГиБ, куда 32-битным адресом не дотянуться.
Именно поэтому на одном из этапов граница RAM/MMIO стала вычисляемой на старте из карты Multiboot2 (pmm::ram_end()), а не константой времени компиляции, и была разведена с разделением виртуальных адресов пользователь/ядро. Раньше одна константа была одновременно потолком памяти, границей MMIO и границей VA — на плате с другой дырой это незаметно отнимало полгигабайта. Это же аргумент, почему 64 бита — не про «больше памяти», а про избавление от целого класса задач, которых в 32 битах быть не должно.
Целостность: обязательные исправления до тега
Самый серьёзный пункт обязательных исправлений — загрузчик ELF, который устанавливал пользовательские PTE в общие таблицы страниц ядра. vmm_map() трактовал любой виртуальный адрес выше PCI_HOLE_START как MMIO и писал PTE прямо в разделяемую таблицу ядра, выставляя PAGE_USER | PAGE_RW. Достаточно было ELF, у которого сегмент PT_LOAD попадает в ядровую половину адресного пространства — и writable-маппинг пользователя ложился поверх APIC, ACPI-окна и PCIe ECAM навсегда и для всех процессов.
Я исправил это в два слоя: загрузчик теперь отвергает сегменты вне [USER_SPACE_START, USER_STACK_TOP], а vmm_map() централизованно снимает PAGE_USER для kernel-half, чтобы новый загрузчик или модуль не могли это вернуть. Подобные проверки уже были в обработчиках сигналов и потоков — не хватало только в ELF-лоадере.
Там же я закрыл MAP_FIXED без нижней границы, переполнение в арифметике концов mmap-регионов, переполнение в сравнении LBA в страничном кэше и переименовал магическую константу роста brk в USER_BRK_MAX_GROWTH с объяснением, почему она маленькая: brk растёт без demand paging, и делить окно с mmap нельзя.
Подпись модулей: с HMAC на ECDSA
Раньше .cctk-модули подписывались HMAC-SHA256 ключом, зашитым в образ ядра. Это работало до момента, когда кто-то извлекает образ: извлёк — и подписывай что угодно. В 2.0.0 я перешёл на асимметричную подпись ECDSA P-256: собирающий хост подписывает приватным ключом, ядро проверяет публичным (verify-only ABI cact_sig_verify_p256_raw).
Формат трейлера: ELF, затем магия CMOD, затем 4 байта vermagic и 64-байтная подпись r||s, покрывающая ELF и метаданные. Проверка вынесена в один общий mod_tag_verify(), который используют загрузчики PCI, USB и файловых систем. Дополнительно появился ABI-отпечаток vermagic — FNV-1a по отсортированному списку экспортируемых символов ядра; модуль с чужим vermagic отвергается.
Отдельный урок: список драйверов дублировался в двух местах, и оба раза «потеряли» virtio-gpu, из-за чего в образе оставался устаревший .cctk. Теперь канонический список один — drivers.list, и интегратор, и build.py читают именно его. В образе 2.0.0 — 10 модулей .cctk.
VFS на Rust
Самая объёмная работа 2.0.0 — переписывание ядра VFS на Rust. Цель — поднять VFS до уровня Linux, не сломав UNIX-философию. Я сделал полноценную модель данных: super_block, inode, dentry с dcache, vfsmount с деревом монтирований и file. По шагам: dentry/dcache, inode/superblock, полный stat/statx/statfs с d_type, кэш страниц уровня inode (address_space), общий для read/write и mmap, жёсткие ссылки и атомарный cross-directory rename.
Пайп переехал в Rust: кольцевой буфер, блокировка через schedule(), -EAGAIN для неблокирующего режима, SIGPIPE писателю. Попутно я выловил старую ошибку учёта открытий — счётчики читателей/писателей никогда не доходили до нуля, поэтому EOF и EPIPE не срабатывали, а pipe_t и обёртки узлов текли. Теперь open/close владеют счётчиками, а refcount узла — это число открытий.
cactsole: шелл, конвейеры и job control
cactsole — интерактивный шелл в userspace. Job control работает по POSIX-модели. Лог сессии:
cact:/$ sleep 30
^Z
[1]+ Stopped  sleep 30
cact:/$ jobs
[1] stopped  sleep 30
cact:/$ bg 1
cact:/$ jobs
[1] running  sleep 30
cact:/$ fg 1
^C
cact:/$ jobs
cact:/$
Ctrl+Z останавливает задачу, jobs показывает состояние, bg 1/fg 1 меняют его, Ctrl+C завершает, повторный jobs — пуст. Конвейеры тоже работают:
cact:/$ ls /usr/lib/modules | grep -F .cctk | wc -l
      10
Три процесса в конвейере, результат — 10 модулей .cctk в образе.
Сеть и TLS
Весь L3+ — на Rust. Ethernet-демультиплексор, ARP, IPv4, ICMP, TCP/UDP-сокеты и DNS-резолвер работают на smoltcp, TLS 1.3 — на vendored rustls с криптографией из cact_crypto. DHCP-клиента в ядре нет: IPv4-адресацию решает userspace и передаёт её в ядро через /dev/net. DNS-резолвер — отдельный демон. Лог:
cact:/$ dhcpd &
[1] 34
dhcpd: link up, mac=52:54:00:12:34:56
dhcpd: discover #1 (xid=a0809ff2)
dhcpd: offer ip=10.0.2.15 server=10.0.2.2
dhcpd: request #1
dhcpd: lease ip=10.0.2.15 mask=255.255.255.0 gw=10.0.2.2 dns=10.0.2.3 server=10.0.2.2 lease=86400s t1=43200s t2=75600s
cact:/$ resolved &
[2] 35
resolved: starting
resolved: listening on /run/resolved.sock
Полный DORA-цикл, lease с T1/T2, резолвер слушает сокет в /run. ICMP на smoltcp:
cact:/$ ping -c 3 8.8.8.8
PING 8.8.8.8 (8.8.8.8): 56 data bytes
64 bytes from 8.8.8.8: icmp_seq=1 time=102.735 ms
64 bytes from 8.8.8.8: icmp_seq=2 time=181.496 ms
64 bytes from 8.8.8.8: icmp_seq=3 time=78.162 ms
--- 8.8.8.8 ping statistics ---
3 packets transmitted, 3 received, 0% packet loss
RTT в QEMU user-net (SLIRP) — десятки-сотни миллисекунд, это ожидаемо для эмуляции.
HTTPS:
cact:/$ wget https://google.com -O /tmp/x && cat /tmp/x
wget: 301 redirect -> https://www.google.com/
/tmp/x             86.8 KiB
wget: HTTP 200, 88932 bytes -> /tmp/x
<!doctype html><html itemscope="" itemtype="http://schema.org/WebPage" lang="ru">...
301-редирект обработан, TLS-сессия состоялась, сертификат проверен по системному CA-бандлу, скачано 86.8 KiB реального HTML. Адресацию и радиус действия TLS я выбрал сознательно: TLS живёт в libc, ключи — в userspace, в ядро не попадают.
SMP и энергогоvernor
Планировщик намеренно не ванильный SMP. Bring-up только поднимает ядра, дальше ими управляет energy-губернатор: мастер-ядро (cpu0) шлёт по IPI команды HALT и WAKEUP, уровень MLFQ задаёт максимальную глубину C-состояния. Все ядра исполняют один и тот же worker-код, отличаясь только политикой. cpu0 — не диспетчер, а полноценный воркер с одним ограничением: ему запрещено уходить в состояние глубже C1.
На одном из этапов я добавил CPUID-топологию (leaf 0xB/0x1F): package id, core id, siblings в /proc/cpuinfo, sibling-aware размещение и отключение ядра как единицы вместе со всеми его потоками. Убрал kill switch, который раньше выключал физический оффлайнинг ядра.
/proc/cpuinfo в QEMU:
processor       : 0
apicid          : 0
physical id     : 0
siblings        : 4
core id         : 0
cpu cores       : 4
model name      : 11th Gen Intel(R) Core(TM) i5-11400F @ 2.60GHz
role            : master
cstate          : C1
online          : yes
idle            : yes
...
processor       : 2
...
role            : worker
cstate          : C0
online          : yes
idle            : no
Видно governor в работе: ядра 0–1 простаивают в C1, ядра 2–3 заняты в C0. cpu0 — master, остальные — worker. Частота 1555 MHz — то, что отдаёт QEMU; на реальном железе она другая, а флаг hypervisor в списке CPU-флагов присутствует только в эмуляции.
S3: почему suspend вырезан в 2.0.0
Это самая ощутимая потеря релиза. Suspend не отложен — вырезан. Причина: resume на целевой машине ненадёжен.
Сначала я нашёл простую вещь: путь resume обращался к фреймбуферу до того, как ядро восстановило дисплей после платформенного сброса. pr_notice() печатал через FB-консоль, а fb_flush() делал полноэкранный memcpy (сотни строк, мегабайты) в MMIO-регион, который ещё не был декодирован — записи не доходили. Одиночная запись в тот же адрес проходила, то есть это был не #PF, а именно bulk-запись в неподнятую область. На реальном железе это выглядит как «кнопка питания мигает, экран не загорается, машина не просыпается».
Я починил это переключением консоли в serial-only на время resume. Но осталась гонка re-wake AP (smp_resume_rewake) и перемежающийся #PF в userspace уже после просыпания. Ловить это вслепую на живом железе — отдельный проект, поэтому WIP я сохранил на ветке s3-wip, а из 2.0.0 suspend убрал. poweroff, reboot и halt остались. Вернуть S3 планируется в 3.0.0 — с корректным re-modeset дисплея и без гонки на просыпании.
Как это проверяется
Основная дисциплина — verification is a QEMU boot. К этому добавились две вещи.
Первая — хостовые юнит-тесты: отдельный cargo-test-крейт, который через #[path] подключает реальные модули ядра (битовая математика PMM, политика MLFQ, энергомодель, хелперы VFS, CPUID-топология, размещение) — 58 тестов, дрейф от копии невозможен.
Вторая — единая headless-цель: ninja -C build-meson check запускает cact_check.sh, который поднимает ISO без дисплея, читает COM1, проверяет обязательные маркеры ядра (csprng, energy, timer, placement, self-test подписи sigmagic) и экспортируемое vermagic, и падает ненулевым кодом при любом несоответствии. Без интерактива — CI-совместимо.
QEMU закончился — началось железо
Всё это время основным полигоном был Q Графика и EDID. Intel i915 (UHD Graphics) поднимается как out-of-tree модуль, EDID читается через GMBUS/DDC. Была показательная история отладки: на i3-8100 разрешение отображалось как «1920x44» вместо 1920x1080. Сначала я искал ошибку в парсере EDID, но «44» оказалось значением hsync-width, прочитанным не оттуда. Корень был в другом: в образе лежал устаревший i915.cctk, потому что Intel-GPU отсутствовал в списке драйверов и сборка его не пересобирала. Ровно та проблема дублирования списка, ради которой появился drivers.list. Настоящая ошибка была не в ядре, а в инфраструктуре сборки.
На железе poweroff работает; в QEMU — нет. S3 вырезан в обоих случаях.
Что значит «архивная ветка»
После тега v2.0.0 репозиторий x86_32 замораживается. Всё, что осталось за скобками, перечислено как отложенное в 3.0.0: работающий S3, order-N/непрерывный физический аллокатор, WC-маппинги, firmware-лоадер с workqueue, workqueue/tasklet/threaded IRQ, DMA-buf и dma-fence, полноценный DRM property/blob, ACPI OpRegion и VBT, GMBUS/DDC и парсер EDID, рендер-движок i915, файлы и смещения больше 4 ГиБ, IPv6 и снятие 3-гигового потолка PMM. Часть пунктов — прямое следствие 32 бит, часть — долг, который корректнее закрыть на новом фундаменте.
3.0.0 на 64 битах — не «та же ОС, но с большей памятью». PAE и highmem для 4 ГиБ не нужны. 64 бита нужны, чтобы перестать проектировать вокруг потолка: вокруг ядра без PAE, вокруг 32-битных адресов, вокруг компромиссов, навязанных архитектурой, которой больше сорока лет. 32-битная ветка закрывается тегом; дальше — 3.0.0, 64 бита и попытка сделать suspend, который не превращает машину в кирпич.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.