Тест падает раз в 30 прогонов, и только в CI. Где искать причину?
Всем привет, меня зовут Сергей Прощаев, я Tech Lead и руководитель направления Java | Kotlin разработки в FinTech & E‑commerce и преподаю на курсах разработки и архитектуры в ОТУС.
В этой статье разберу задачу, которую я бы давал на собеседовании и автоматизатору, и бэкенд‑разработчику: интеграционный тест иногда падает в CI и ни разу не упал локально.
Все данные для расследования ниже.
Разбор начинается во второй половине статьи, так что попробуйте сначала решить сами.
Задача честная: ответ спрятан в данных, а не в знании редкого флага.
Почему эта задача сейчас у всех на столе
Флак, или нестабильный тест, по определению Google — это тест, который на одном и том же коде то проходит, то падает.
В 2016 году Джон Микко из Google написал, что по всему их корпусу около 1,5% прогонов дают нестабильный результат, почти у 16% тестов есть та или иная доля нестабильности, а 84% переходов теста из зелёного в красный связаны именно с флаками.
Цифрам десять лет, и на свою команду их напрямую не перенести, но порядок величин хорошо показывает, почему флак нельзя списывать на шум.
В августе 2026 года команда UGC из 2ГИС рассказала на Хабре, как живёт с флаками на 35 проектах и примерно 40 000 тестах.
Их наблюдение: как только тестов в проекте становится больше тысячи, частота флаков начинает расти.
Можно ожидать, что с AI‑ассистентами, которые удешевляют написание тестов, до этого порога проекты будут доходить раньше.
Самая дорогая часть флака — не перезапуск. Это привычка. Когда красные сборки привыкают списывать на флаки, настоящий баг тоже перезапускают.
Условие задачи
Сервис заказов на Spring Boot, тесты на JUnit 5, сборка Maven. Бизнес‑правило простое: новый клиент получает скидку 10% на первый заказ. Сумма в API всегда с двумя знаками после запятой.
Тест на это правило:
// (Java)
class FirstOrderDiscountIT extends AbstractIT {

    @Autowired
    TestRestTemplate rest;

    @Test
    void newCustomerGetsTenPercentOff() {
        var order = rest.postForObject("/orders",
                newOrder(TestCustomers.ALICE, "1000.00"), OrderDto.class);

        assertEquals(new BigDecimal("900.00"), order.total());
    }
}
Базовый класс интеграционных тестов поднимает приложение и чистит таблицу заказов после каждого теста:
// (Java)
@SpringBootTest(webEnvironment = WebEnvironment.RANDOM_PORT)
abstract class AbstractIT {

    @Autowired
    JdbcTemplate jdbc;

    @AfterEach
    void cleanDatabase() {
        jdbc.execute("TRUNCATE TABLE orders");
    }
}
В модуле 30 классов интеграционных тестов, база в тестах — H2 в памяти. Классы *IT подключены к Surefire через <includes>, по умолчанию он их не запускает. Настройки форков стандартные: одна JVM, классы идут по очереди.
Обычная сборка запускает классы по алфавиту, а профиль ci, с которым идёт сборка в CI, переопределяет порядок на случайный:
<!-- (XML) pom.xml: порядок по умолчанию и профиль ci -->
<properties>
  <surefire.runOrder>alphabetical</surefire.runOrder>
</properties>

<profile>
  <id>ci</id>
  <build>
    <plugins>
      <plugin>
        <artifactId>maven-surefire-plugin</artifactId>
        <configuration>
          <runOrder>random</runOrder>
        </configuration>
      </plugin>
    </plugins>
  </build>
</profile>
Локально разработчики запускают тесты из IDE, чаще всего класс или пакет. Тест и код скидки не менялись месяц. Последняя правка в модуле — новый класс LoyaltyPointsIT от соседней команды, он появился три недели назад:
// (Java)
@SpringBootTest(webEnvironment = WebEnvironment.RANDOM_PORT)
@Transactional // данные теста откатятся после каждого метода
class LoyaltyPointsIT {

    @Autowired
    TestRestTemplate rest;

    @Test
    void pointsAreCreditedAfterOrder() {
        rest.postForObject("/orders",
                newOrder(TestCustomers.ALICE, "1000.00"), OrderDto.class);
        // ... проверка начисленных баллов
    }
}
За неделю было 90 прогонов пайплайна. Тест упал три раза:
Прогон | Раннер | Время, МСК | Длительность теста | Результат |
|---|---|---|---|---|
#2117 | ci‑runner-2 | 03:10 | 1,8 с | упал |
#2140 | ci‑runner-5 | 14:42 | 1,9 с | упал |
#2163 | ci‑runner-2 | 19:05 | 1,7 с | упал |
остальные 87 | ci‑runner-1…6 | круглые сутки | 1,6–2,1 с | прошёл |
Сообщение об ошибке во всех трёх случаях одно:
org.opentest4j.AssertionFailedError: expected: <900.00> but was: <1000.00>
    at com.shop.order.FirstOrderDiscountIT.newCustomerGetsTenPercentOff(FirstOrderDiscountIT.java:14)
И фрагмент журнала сборки #2117: начало прогона и место падения:
[INFO] Tests will run in random order. To reproduce ordering use flag -Dsurefire.runOrder.random.seed=57245014
...
[INFO] Running com.shop.loyalty.LoyaltyPointsIT
[INFO] Tests run: 1, Failures: 0, Errors: 0, Skipped: 0 -- in com.shop.loyalty.LoyaltyPointsIT
[INFO] Running com.shop.order.FirstOrderDiscountIT
[ERROR] Tests run: 1, Failures: 1, Errors: 0, Skipped: 0 <<< FAILURE! -- in com.shop.order.FirstOrderDiscountIT
Попробуйте решить: что бы вы проверили первым?
Остановитесь здесь. Выберите один вариант и запишите, почему он:
1. Увеличить таймауты или добавить ожидание: в CI машины медленнее, ответ не успевает.
2. Разобраться с раннером: два падения из трёх на ci‑runner-2, может, там другой образ или часовой пояс.
3. Проверить правило «новый клиент»: вдруг оно зависит от даты регистрации, и тест ломается в определённое время суток.
4. Посмотреть, какие тесты шли перед упавшим и что они оставили после себя.
Дальше разбор.
Типовые неправильные ответы
Гипотеза про таймауты. Самая частая первая реакция, и понятно почему: CI действительно медленнее ноутбука, а асинхронные ожидания действительно частая причина флаков. Но данные её не поддерживают. Длительность упавших прогонов, 1,7–1,9 с, лежит внутри разброса зелёных, 1,6–2,1 с.
Главное, ошибка не про ожидание. Тест не упал по таймауту, он получил ответ, и в ответе другая сумма: 1000 вместо 900. Если вставить Thread.sleep(2000), падения станут реже разве что случайно, а сборка станет медленнее навсегда.
Гипотеза про раннер. Два падения на одной машине выглядят как улика. Но третье случилось на другом раннере, а на ci‑runner-2 за неделю прошли и зелёные прогоны этого теста. Три события на шесть машин — слишком маленькая выборка, чтобы что‑то утверждать. Я бы держал эту гипотезу в запасе, но первой не проверял.
Гипотеза про время. Логичная, если правило «новый клиент» завязано на дату. Падения пришлись на 03:10, 14:42 и 19:05: ночь, день и вечер. Никакой границы суток рядом нет. И снова главное: если бы проблема была в дате, тест падал бы стабильно в определённое окно, а не раз в 30 прогонов в любое время.
Общая ошибка всех трёх гипотез: они объясняют, почему CI вообще отличается от ноутбука, но не объясняют, чем три красных прогона отличаются от 87 зелёных. А вопрос именно в этом.
Правильный разбор
Я бы предложил такой порядок: сначала найти, чем падения отличаются от успехов, и только потом строить гипотезу. Пройдём его по шагам, следуя схеме:
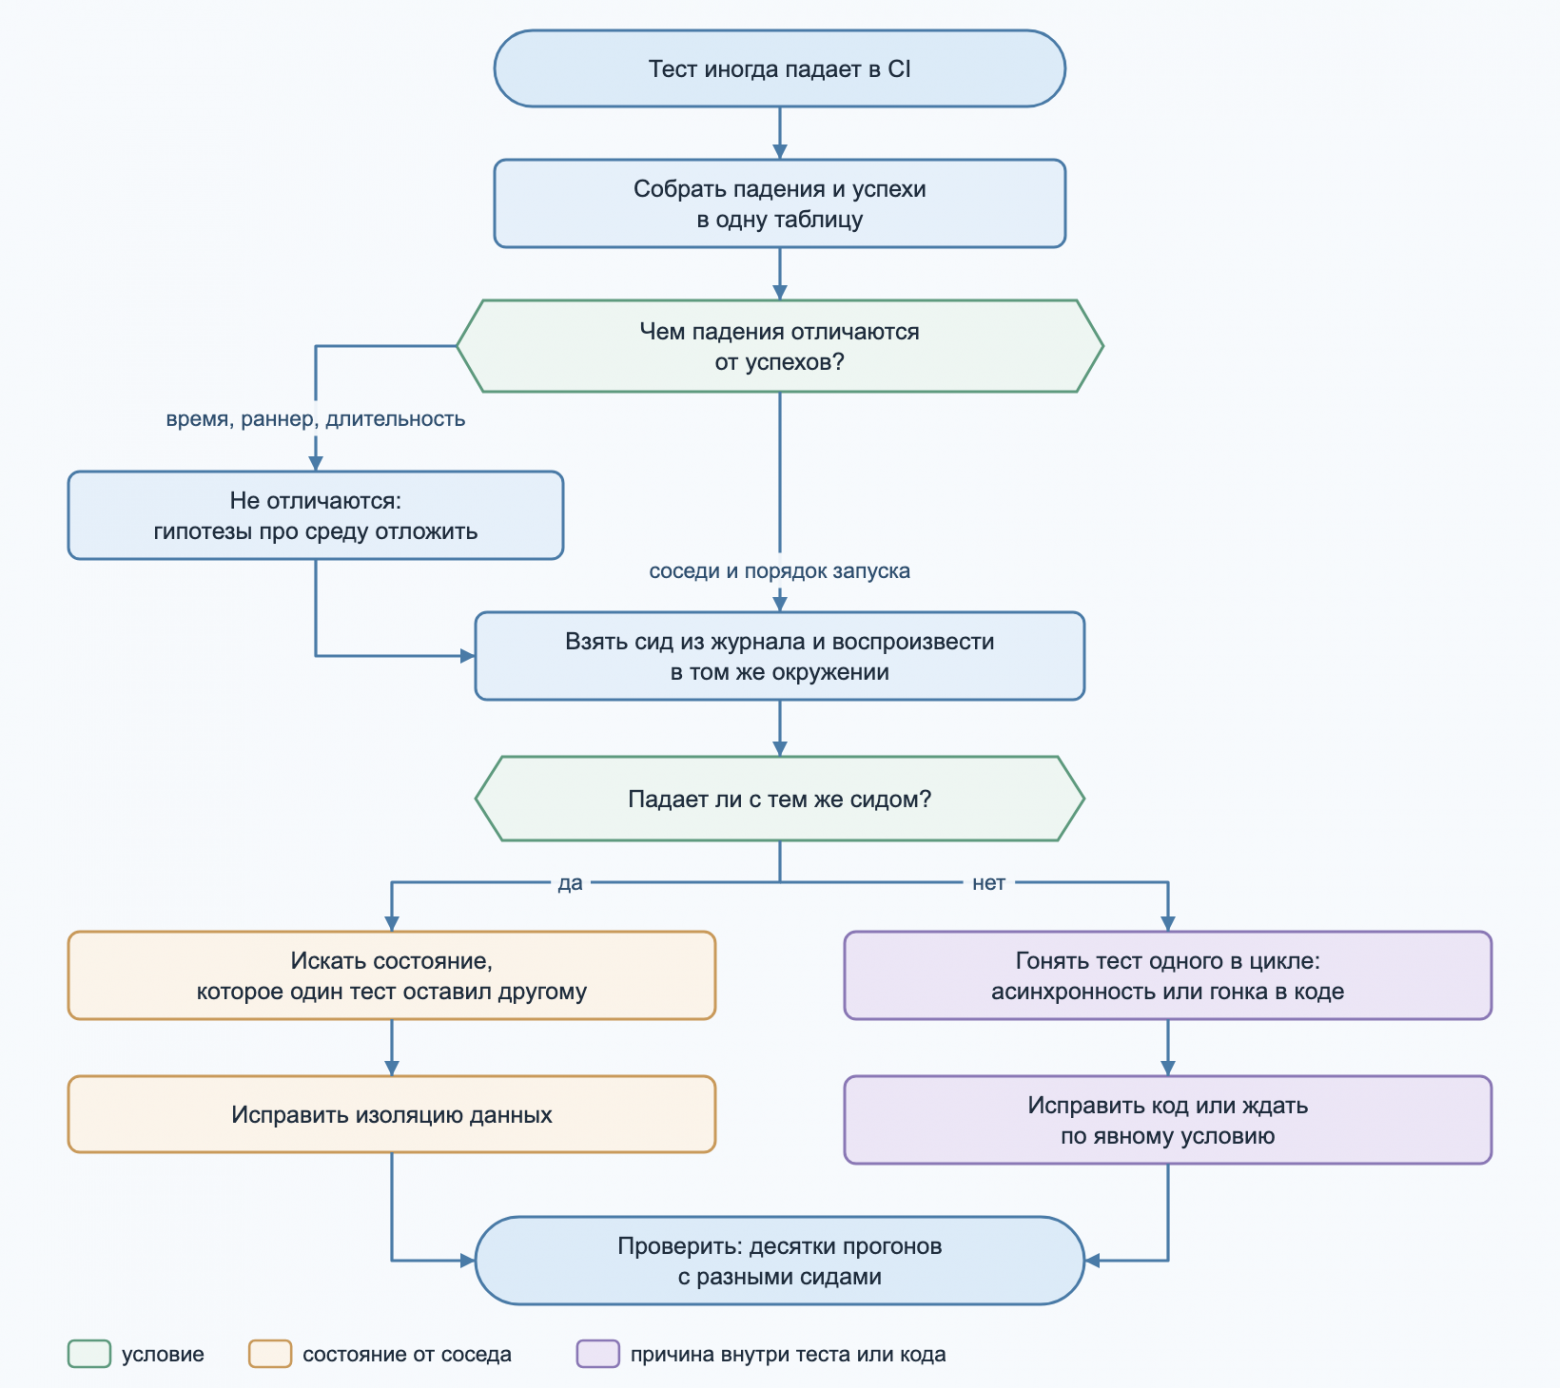
Главная мысль схемы: гипотеза появляется только после того, как найдено отличие красных прогонов от зелёных. Если по времени, раннеру и длительности отличия нет, гипотезы про среду не подтверждены, и следующий кандидат — порядок запуска и состояние, которое тесты оставляют друг другу. Не нашлось и там — расширять набор данных, а не гадать.
Шаг 1. Что общего у падений. Время разное, раннеры разные, длительность обычная. Остаётся то, что в таблице не видно: порядок классов. А в журнале он есть. Перед FirstOrderDiscountIT прямо в той же сборке шёл LoyaltyPointsIT.
В профиле ci включён runOrder=random, поэтому порядок в каждом прогоне свой. Если открыть журналы двух других падений, картина повторится: тот же сосед, прямо перед упавшим тестом. В зелёных прогонах LoyaltyPointsIT стоит где угодно, но не непосредственно перед ним.
Шаг 2. Воспроизвести. Это ключ к тому, чтобы спорить с фактом, а не с ощущением. Surefire сам пишет в журнал сид случайного порядка. По документации плагина, чтобы детерминированно повторить любой случайный порядок, достаточно передать тот же сид:
# (bash)
mvn -P ci test -Dsurefire.runOrder.random.seed=57245014
С этим сидом тест падает каждый раз. Флак перестал быть флаком, теперь это обычный падающий тест, и с ним можно работать отладчиком.
Одна оговорка, которую показал пример к этой статье. Сид повторяет порядок при той же версии Surefire (параметр появился в 3.0.0-M6), том же наборе классов и там, где его получили: в том же образе CI. Surefire перемешивает классы в том порядке, в каком нашёл их на диске, а у macOS и Linux этот порядок разный.
Поэтому на ноутбуке тот же сид может дать зелёный прогон. Сначала сверьте строки Running с журналом CI, а быстрее всего запустить подозрительную пару отдельно:
# (bash)
mvn test -Dtest='LoyaltyPointsIT,FirstOrderDiscountIT' -Dsurefire.runOrder=alphabetical
Пакет loyalty по алфавиту идёт раньше order, сосед запускается первым, и тест падает на любой машине. С reversealphabetical он зелёный.
Шаг 3. Найти, что осталось после соседа. LoyaltyPointsIT создаёт заказ для той же Алисы и рассчитывает на @Transactional: данные откатятся. Здесь и ловушка.
В документации Spring Boot прямо сказано, что при RANDOM_PORT или DEFINED_PORT HTTP-клиент и сервер работают в разных потоках, а значит, и в разных транзакциях. Если хотите проверить свои знания Spring Framework, попробуйте сначала ответить: откатится ли в таком случае транзакция, начатая на сервере?
Тест откатывает свою пустую транзакцию, а заказ, созданный контроллером, остаётся в базе.
Почему база общая для двух классов? Spring TestContext кэширует контекст приложения.
По документации, загруженный контекст переиспользуется всеми следующими тестами с той же конфигурацией в этом наборе, и хранится он буквально в статической переменной. Ключ кэша — вся конфигурация контекста: классы, профили, свойства. У двух наших классов она совпадает, поэтому контекст у них один, а с ним и одна H2 в памяти.
Почему падает только сосед, а не все следующие тесты? Потому что LoyaltyPointsIT не наследует AbstractIT и за собой не чистит. Чистит первый же следующий класс, который наследует базовый, но делает это после своего теста. Если этот класс FirstOrderDiscountIT,
Алиса для него уже не новый клиент: в базе лежит её заказ, созданный соседом. Новый заказ идёт без скидки, и API возвращает 1000 вместо 900. При 30 классах в случайном порядке шанс, что нужная пара встанет вплотную, как раз около одного к тридцати. Это совпадает с тем, что мы видим в CI.
А локально пара почти никогда не идёт подряд: из IDE запускают один класс или пакет, а при прогоне всего модуля без профиля ci порядок от запуска к запуску не меняется, и между этими классами стоят другие.
Рисунок показывает это на одном прогоне.
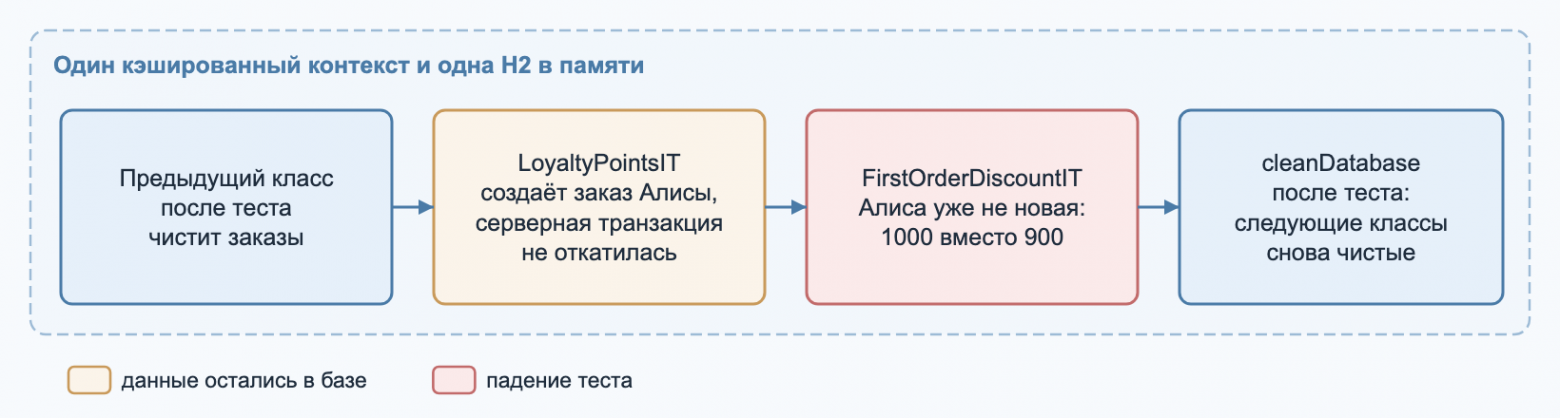
Главная мысль схемы: порядок запуска вскрыл скрытую зависимость между тестами. Сосед оставил зафиксированные данные, а упавший тест честно проверил правило на грязной базе. Поэтому чинить нужно подготовку состояния, а не место падения.
Шаг 4. Исправить. Я бы сделал три вещи.
Перенести очистку в базовом классе из
@AfterEachв@BeforeEach. Тогда тест не зависит от того, убрал ли за собой предыдущий. Это минимальный патч для последовательного прогона: при параллельном запуске общийTRUNCATEсам начнёт ломать соседей, и опорой станет следующий пункт.Не делить фикстуры между тестами: каждый тест создаёт своего клиента с уникальным email. Общая Алиса удобна, пока тестов десять.
Не рассчитывать на
@Transactionalв тестах сRANDOM_PORTкак на откат серверных изменений: он создаёт ощущение изоляции, которой нет. Если нужен откат вместе с тестовой транзакцией, подойдёт mock‑окружение без реального сервера, но только для синхронного сценария. С реальным сервером серверные данные чистят явно или берут изолированную базу.
@DirtiesContext базу не чистит: он закрывает контекст и убирает его из кэша. Помогает он, только если состояние живёт вместе с контекстом, как наша H2, и ценой повторного старта приложения: сборка заметно замедлится, а причина останется. Базу, которая живёт отдельно от контекста, придётся чистить самому.
Шаг 5. Проверить исправление. Один зелёный прогон ничего не доказывает, флак тоже зеленеет в 29 случаях из 30. Проверка — прогон с сидом из падения плюс серия прогонов с разными сидами.
В 2ГИС пошли дальше и встроили это в процесс: отдельная джоба многократно, до девяти раз подряд, гоняет новые и изменённые тесты со случайным порядком, и в мастер они попадают только если все прогоны зелёные. За июль, по их данным, так в мастер не прошло 45 флаков.
Усложнение: а если бы включили ретраи
Теперь вариант, который встречается чаще, чем хотелось бы. Представьте, что три недели назад, когда FirstOrderDiscountIT впервые покраснел, кто‑то добавил в Surefire rerunFailingTestsCount=2.
Упавший тест перезапускается и со второй попытки проходит: при перезапуске соседа уже нет, а база уже очищена. Сборка зелёная, в отчёте тест помечен как нестабильный, и на это никто не смотрит.
Вопрос: что вы потеряли?
Первое — сигнал. Через месяц соседняя команда добавит ещё один тест на Алису без очистки, и флаков станет два, потом пять.
Второе — способность отличить флак теста от бага продукта.
В той же статье Google о карантине нестабильных тестов прямо пишет, что он может легко замаскировать настоящее состояние гонки в тестируемом коде.
И вторая половина усложнения. Через две недели после исправления тест снова падает, один раз примерно на 200 прогонов, и сид из журнала падение не воспроизводит.
Что теперь? Порядок проверен и исключён, значит, идём по правой ветке рис. 2: гоняем тест в одиночку в цикле.
Если он падает и без соседей, причина внутри: скидка, например, начисляется асинхронным обработчиком события после коммита (с
@Async), и тест читает заказ раньше, чем обработчик успел.Если контракт API допускает такую задержку, ожидание с явным условием, через Awaitility, и есть правильное решение.
Если скидка обязана быть уже в ответе, ждать в тесте нельзя: это баг сервиса, и тест его честно поймал.
Та же гипотеза, что в начале статьи была ошибкой, теперь верная. Разница в одном: теперь у нас есть данные, которые её подтверждают.
Где этот порядок не сработает
Таблица «красные против зелёных» работает, когда падений хотя бы несколько. По одному падению за месяц отличие не найти, и честнее сначала набрать статистику: ночные прогоны без ретраев, как у 2ГИС.
Второе ограничение — порядок внутри одного класса. runOrder в Surefire перемешивает классы, а порядок методов внутри класса задаёт JUnit 5, и на порядок по умолчанию полагаться нельзя.
Если утечка между методами одного класса, сид Surefire её не покажет, нужен @TestMethodOrder(MethodOrderer.Random.class).
И третье: если тесты в нескольких форках ходят в одну внешнюю базу, например в общий контейнер PostgreSQL, соседом бывает не предыдущий класс, а класс, который в это же время работает в другом форке.
Какой навык проверяла задача
Не знание Surefire и не знание Spring. Флаг сида и поведение @Transactional с реальным сервером находятся за пять минут поиска, если знать, что искать.
Задача проверяла диагностическое мышление: сначала найти, чем падения отличаются от успехов, потом выдвигать гипотезу, потом воспроизвести, и только потом чинить.
Если вы выбрали вариант 4, у вас этот порядок уже есть. Если 1, 2 или 3, не расстраивайтесь, это самые частые ответы.
Они правильные для других флаков и ошибочны для этого, и как раз поэтому в каждом случае стоит начинать с данных.
Короткий чек‑лист на следующий флак:
собрать красные и зелёные прогоны в одну таблицу: время, раннер, длительность, соседи;
найти, чем красные отличаются, до любой гипотезы;
включить случайный порядок классов в CI и сохранять вместе с сидом версию Surefire и список классов в порядке запуска;
воспроизвести падение по сиду в том же окружении или парой классов, прежде чем чинить;
не включать ретраи без задачи на разбор каждого флака.
Это минимальная модель без Spring: общий контекст и H2 заменены статическим полем SharedContext, а поведение @Transactional с RANDOM_PORT описано выше по документации.
Начать стоит с expected.txt: там итог 300 прогонов со случайным порядком. Каждое падение пришлось на прогон, где LoyaltyPointsIT шёл прямо перед тестом, и ни один зелёный прогон такого соседства не имел.
Запускает всё run.sh, сами классы лежат в src/test/java/com/shop/order и src/test/java/com/shop/loyalty, а частоту один к тридцати на 100 000 перемешиваний считает tools/OrderOdds.java.
ИСТОЧНИКИ
Когда тесты периодически падают в CI, а локально всё работает, хочется просто перезапустить сборку. Но так легко пропустить настоящую ошибку. Чтобы тесты действительно помогали находить проблемы до релиза, важно уметь проверять поведение API, разбираться в работе приложения и понимать ограничения автоматических проверок.
Эти темы разберём на бесплатных открытых уроках OTUS:
26 октября, 20:00. «Тестирование FastAPI: проверяем API с помощью pytest». Записаться
16 ноября, 20:00. «Мигрировали на Java 25 и Spring Boot 4 — всё зелёное. Почему система всё равно сломана?». Записаться
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.