Kafka и ребалансинг: что можно сделать до возникновения проблемы
Почему ребалансинг — это критическая проблема в распределённых системах
При выборе Kafka Streams перед инженером встаёт множество архитектурных и технических вопросов. Ребалансинг при этом не всегда выглядит самой важной и зачастую даже не самой первой проблемой. Более того, он может никак себя не проявлять первые несколько месяцев эксплуатации системы.
Но недооценивать его не стоит. Это один из тех самых вопросов, которые относятся к категории важно, но не срочно. На этапе проектирования не всегда можно определить проблемный участок, а обнаружить уже в проде при экплуатации. В худшем случае накопленные ограничения архитектуры могут привести не только к изменению конфигурации, но и к пересмотру выбранных технологий, брокера, специалистов.
Иногда можно встретить мнение, что ребалансинг — это проблема самой Kafka. Но опыт распределенных систем показал, что отказов не следует избегать. Потенциально слабые места надо выявлять за счет повышенной observability и принимать их используя практики помогающие минимизировать отказы. Потребители могут падать, появляться новые экземпляры, изменяться нагрузка. Задача архитектора не исключить ребалансинг полностью, а сделать его предсказуемым: не провоцировать без необходимости, минимизировать время простоя обработки и быстро выявлять причины повторяющихся ребалансировок.
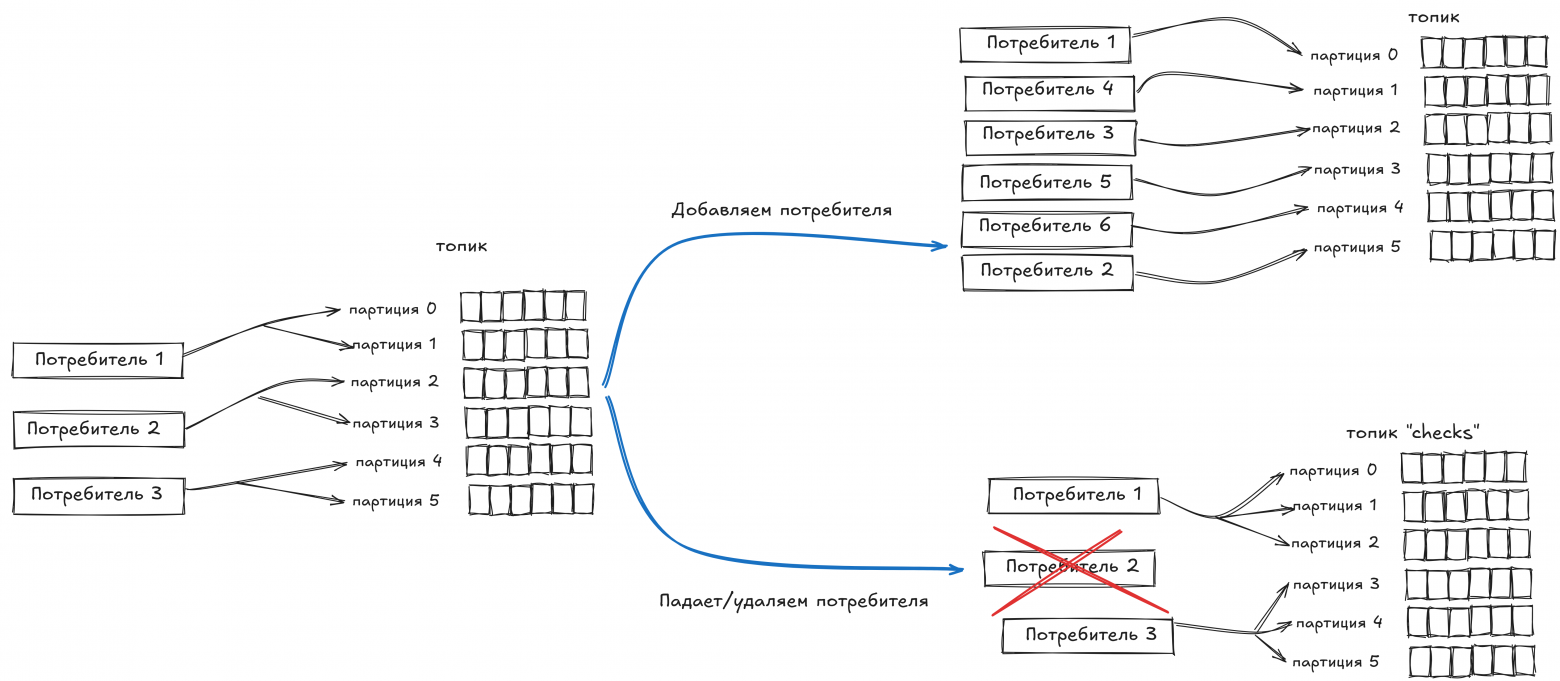
Так почему же происходит перебалансировка? В классическом случае ребалансинг consumer group происходит при изменении состава группы: например, когда добавляется новый Потребитель, один из существующих Потребителей падает или покидает группу. Добавление и удаление consumer’ов обычно относится к регламентным операциям: масштабированию, релизам, техническим работам. Их можно заранее планировать и контролировать.
Kafka использует несколько механизмов, позволяющих определить, что consumer перестал нормально работать. Первый — heartbeat и session.timeout.ms. При классическом протоколе группы consumer периодически отправляет координатору heartbeat. Если координатор не получает их в течение установленного таймаута, участник может быть исключён из группы.
Второй механизм — max.poll.interval.ms. Он ограничивает время между вызовами poll(). Если приложение слишком долго обрабатывает полученные сообщения и не вызывает poll() до истечения этого интервала, consumer может потерять членство в группе, даже если сам процесс продолжает работать и до этого исправно отправлял heartbeat.
Именно второй сценарий особенно интересен с архитектурной точки зрения: проблема может заключаться не в падении сервиса, а в том, что обработка сообщений занимает слишком много времени.
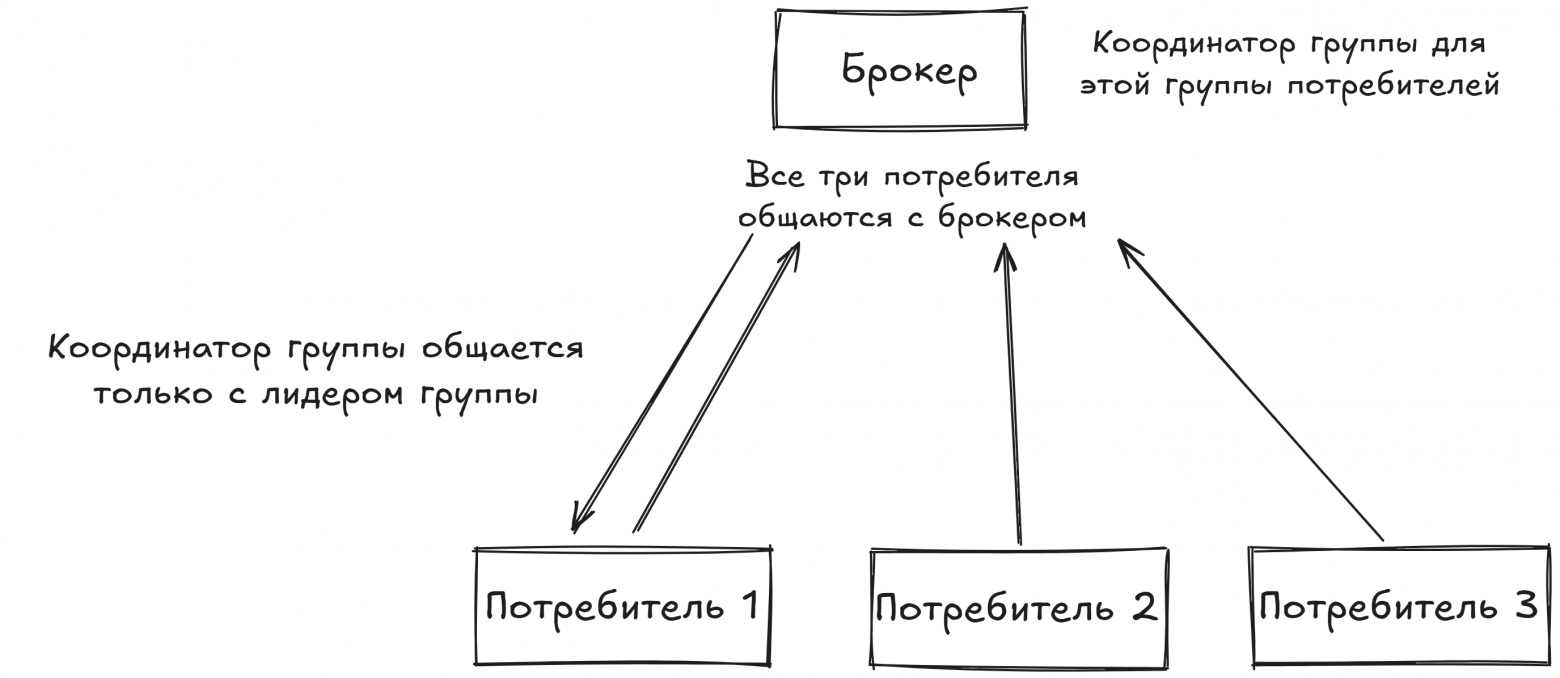
Чтобы понять этот механизм, полезно посмотреть, какую роль играет Координатор группы в consumer group, как определяется лидер группы и как происходит перераспределение партиций между участниками.
Координатор группы — это брокер, который отвечает за координацию конкретной consumer group. Хранит информацию о её участниках, обрабатывает их присоединение и выход из группы, а также отслеживает состояние участников. При этом один брокер не является координатором всех consumer groups. Каждая группа имеет своего координатора, а ответственность за координацию групп распределяется между брокерами кластера. Когда состав группы изменяется, например, присоединяется новый consumer, один из участников выходит из группы или перестаёт соответствовать требованиям, то координатор инициирует процесс ребалансировки для перераспределения партиций между новым составом.
Метрики и алерты для предупреждения перегрузок
Прежде чем перейти к решению проблемы нужно настроить механизм выявления такой проблемы. И неплохо было бы определить если не примерную причину, то хотя бы исключить факторы, которые влияют на её воспроизведение. Процесс построения новой архитектуры почти всегда связан с пробами, экспериментами и компромиссами.
После того как определена бизнес-логика системы, важно посмотреть, как она ведёт себя под реальной нагрузкой. В первую очередь я бы смотрел на три группы показателей.
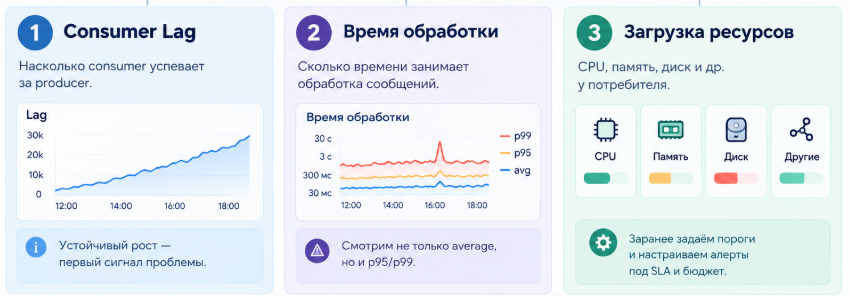
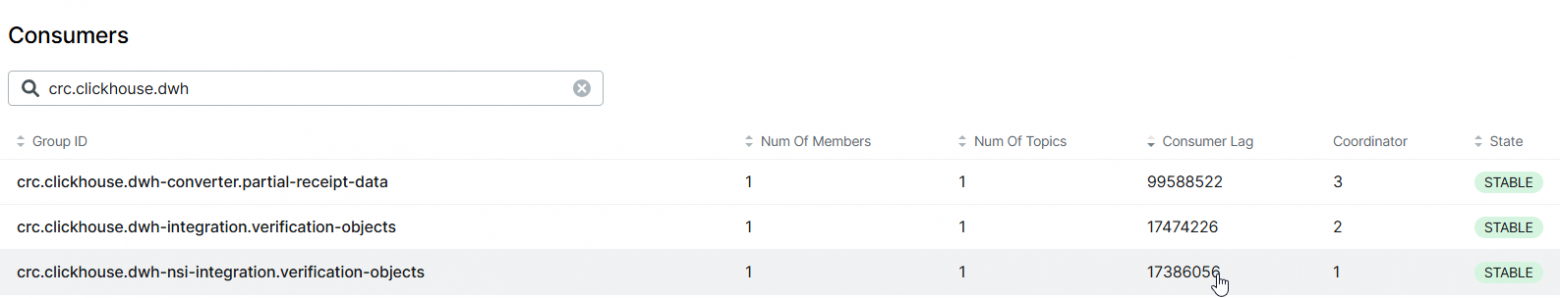
1. Consumer Lag. Первое, что стоит проверить — насколько consumer успевает за producer. На начальном этапе достаточно посмотреть показатели consumer’ов непосредственно в используемых инструментах Kafka (Kafbat UI). После стоит вынести в Grafana. Сам по себе рост lag ещё не означает, что произойдёт ребалансинг. Но устойчивый рост может быть первым сигналом того, что consumer не справляется с нагрузкой.
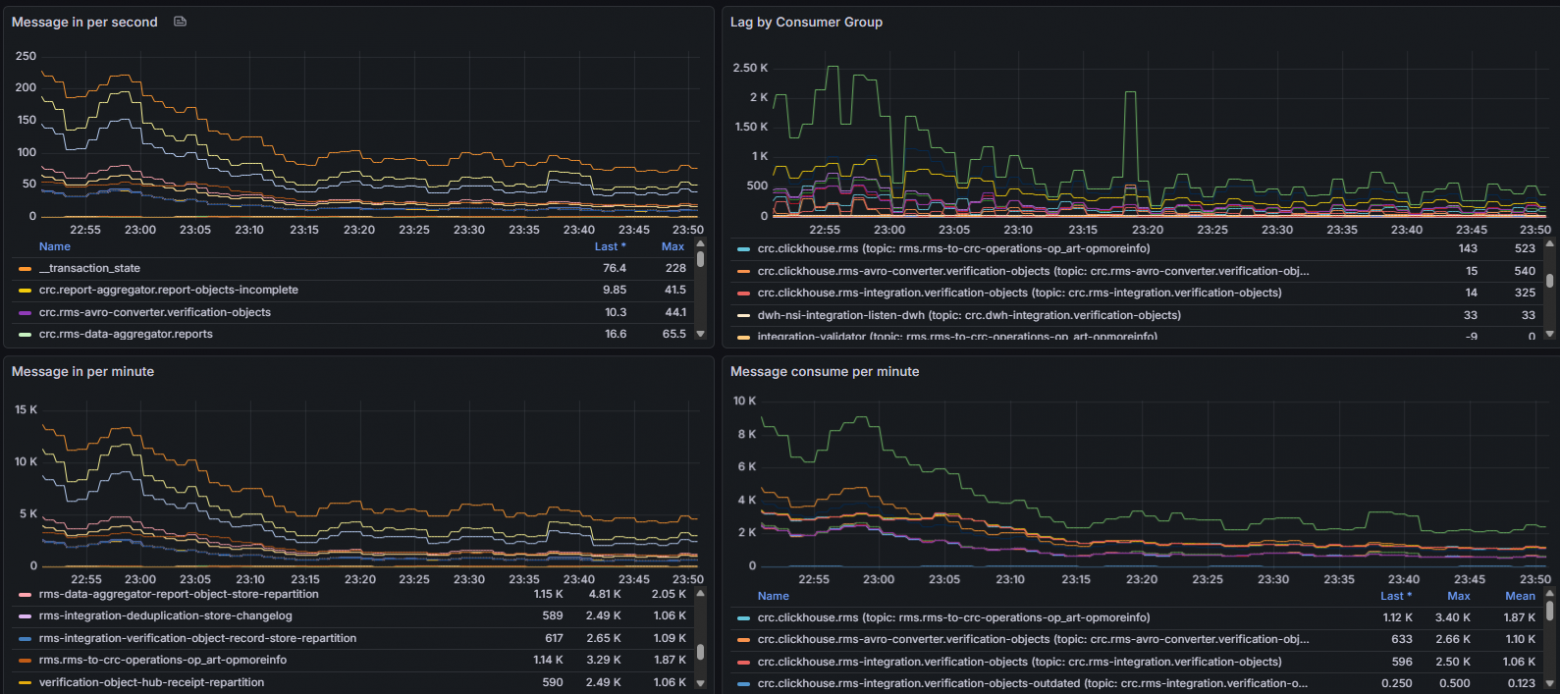
2. Время обработки. Важно измерять не только количество сообщений, но и сколько времени занимает их обработка. Среднее время здесь может быть особенно обманчивым. Например, большинство сообщений обрабатывается за Х мс, но отдельные сообщения требуют 9000Х секунд. Именно такие «тяжёлые» сообщения могут стать причиной проблем. Поэтому полезно смотреть не только average, но и p95/p99 времени обработки.
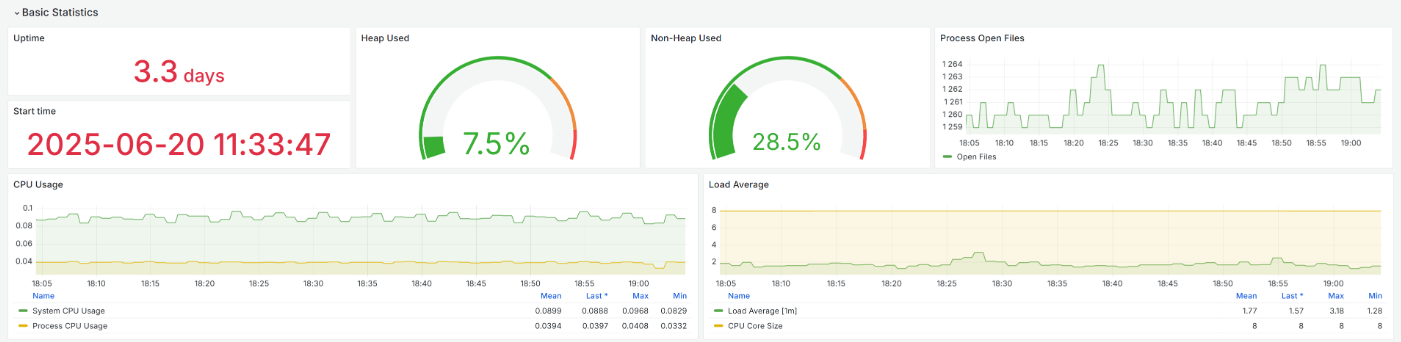
3. Загрузка ресурсов. Необходимо контролировать CPU, память, дисковое пространство и другие ресурсы, которые используются потребителем. Например, если Kafka Streams использует локальное состояние в RocksDB, рост объёма данных может привести к увеличению потребления диска и памяти. В результате это может оказаться проблемой ресурсов самого приложения. При проектировании системы стоит заранее определить пороги и настроить алерты с учётом допустимой нагрузки, SLA и стоимости инфраструктуры.
Базовые шаги для минимизации ребалансинга
Ниже в статье я сформировал практики, которые должны помочь в минимизации ребалансинга. Но надо понимать, что это не исчерпывающие решения и они не направлены магическим образом убрать ребалансинг. Их задача уменьшить вероятность ненужного ребалансинга и сделать его менее болезненным, если он всё-таки произойдёт. При этом не все рассмотренные параметры напрямую управляют механизмом ребалансинга. Некоторые из них влияют на архитектуру, распределение нагрузки или стабильность потребителей, но в итоге также помогают сделать работу consumer group более предсказуемой.
1.Правильно распределять нагрузку между партициями
Kafka распределяет сообщения между партициями в соответствии с выбранной стратегией partitioning. При использовании ключа сообщения стандартный подход это вычисление partition по хешу ключа. В большинстве случаев данное решение абсолютно рабочее и автоматически обеспечит равномерное распределение. Хеш равномерно распределяет именно ключи, а не объём работы. Например, один ключ может соответствовать смене, в которой 5 чеков, в то время как в другой смене 500 чеков. Формально сообщения распределены равномерно, но фактическая нагрузка на потребители оказывается совершенно разной.
Поэтому при проектировании нужно учитывать не только количество сообщений, но и стоимость обработки сообщения. В зависимости от особенностей процесса можно использовать несколько подходов:
Разделить разные классы нагрузки Если сообщения существенно отличаются по стоимости обработки, можно разделить их по отдельным потокам или топикам. Например, тяжёлые сообщения обрабатывать отдельной группой consumers, чтобы они не задерживали обработку лёгких.
Изменить стратегию партиционирования. Если стандартного распределения по хешу ключа недостаточно, в продюсере можно реализовать собственную логику через partitioner.class и интерфейс Partitioner. Такой подход имеет смысл, если заранее известен признак, по которому можно распределить нагрузку между партициями. Например, если бизнес-логика позволяет определить, какие сообщения требуют больше ресурсов, можно направлять тяжёлые сообщения в разные партиции. При этом важно учитывать, что собственный алгоритм не гарантирует равномерной нагрузки автоматически: неудачное распределение может привести к появлению горячих партиций.
2.Статическое членство потребителей
Если на вашем проекте состав consumer group меняется слишком часто, ребалансинг постепенно становится нормой. Для сценариев, где важна стабильность состава группы, можно рассмотреть статическое членство с помощью параметра group.instance.id. Каждому экземпляру потребителя назначается уникальный group.instance.id. При подключении к группе Kafka использует этот идентификатор, чтобы однозначно определить участника.
Если Потребитель временно становится недоступен, например из-за перезапуска пода, Kafka может не удалять его из группы немедленно. При этом партиции не приходится сразу перераспределять между оставшимися участниками. Если Потребитель возвращается до истечения соответствующего таймаута, он может продолжить работу со своим прежним членством в группе без полноценного перераспределения партиций. Это позволяет исключить два ребалансинга на исключение потребителя и на добавления потребителя.
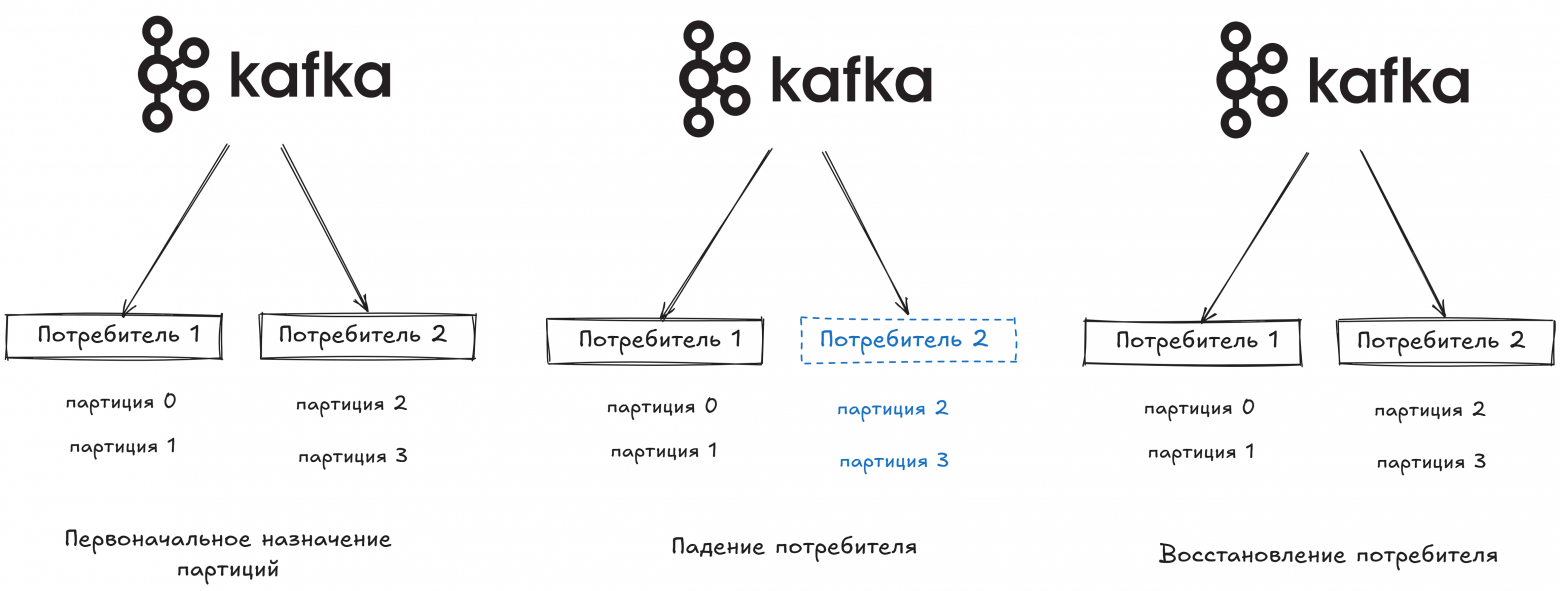
При этом group.instance.id не решает проблему длительно неработающего consumer. Если экземпляр не возвращается в течение настроенного времени, Kafka всё равно должна перераспределить его партиции между другими участниками группы.
3.Кооперативный ребалансинг Среди хороших практик стоит рассмотреть кооперативный ребалансинг, который позволяет уменьшить влияние перераспределения партиций на обработку сообщений.
Для обычных Kafka Consumer можно использовать стратегию CooperativeStickyAssignor, задаваемую через параметр partition.assignment.strategy. Она стремится сохранить существующие назначения партиций и передавать другим потребителям только те партиции, которые действительно требуется перераспределить.
В Kafka Streams кооперативный ребалансинг поддерживается собственным механизмом назначения задач StreamsPartitionAssignor и включён по умолчанию начиная с версии 2.4. Поэтому отдельно настраивать CooperativeStickyAssignor для Streams-приложения не требуется.
При кооперативном ребалансинге потребители не освобождают все партиции одновременно. Перераспределение выполняется поэтапно, а обработка партиций, назначение которых не меняется, может продолжаться. Это особенно полезно для систем с большим количеством партиций, где полное перераспределение способно заметно повлиять на обработку.
4.Правильно определить количество партиций
Количество партиций — это не только вопрос производительности. Оно определяет максимальный уровень параллелизма consumer group и, следовательно, влияет на то, насколько быстро группа сможет обрабатывать накопившуюся нагрузку. Для предварительной оценки количества партиций можно использовать расчёт, приведённый в docs confluent Kafka: partitions = max(t/p, t/c), где:
t — целевая пропускная способность;
p — измеренная пропускная способность одного участка;
c — пропускная способность одного consumer’а.
При этом количество партиций стоит рассматривать вместе с количеством потребителей и брокеров. Если потребителей больше, чем партиций, часть экземпляров не получит работы. Если партиций значительно больше, чем требуется, увеличивается операционная сложность и объём служебной работы.
5.Не допускать падения потребителя из-за локального состояния
Для Kafka Streams есть отдельная проблема, связанная с локальным state store. Переполнение RocksDB может привести к деградации или падению приложения. Поэтому управление жизненным циклом локального состояния — это тоже косвенный способ уменьшить количество ребалансировок. В этой статье не буду останавливаться на этом. В предыдущей статье я подробно раскрыл эту тему Проблема переполнения Store: настройка самоочистки RocksDB в Kafka Streams
Ключевые выводы
Ребалансинг в Kafka — это нормальный механизм работы распределённой системы, а не ошибка, которую необходимо любой ценой исключить. Проблемой он становится тогда, когда происходит слишком часто, останавливает обработку или является следствием неустойчивой архитектуры приложения. Не стоит пытаться полностью запретить ребалансинг. В распределённой системе потребители будут добавляться, удаляться, перезапускаться и выходить из строя.
Именно поэтому работа с ребалансингом начинается ещё на этапе проектирования: с понимания характера нагрузки, правильного распределения данных, определения границ производительности и настройки мониторинга. А уже затем подключаются конкретные механизмы Kafka, которые позволяют уменьшить количество ребалансировок и снизить их влияние на обработку.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.