Я дообучил маленькую нейросеть на MacBook, и она стала хуже. Честные цифры
В прошлой статье я рассказывал, как прикручивал Ollama к Lumi — это мой лаунчер в духе Spotlight, который умеет отвечать на вопросы без интернета. В конце я пообещал дообучить самую маленькую модель, lumi-mini, и показать, что получится. Добавил ещё «даже если станет хуже». Как в воду глядел.
Сразу скажу: я не ML-инженер. Код пишу вместе с Claude, многое по ходу узнаю сам. Поэтому это не туториал, а скорее дневник эксперимента. Зато все ответы модели ниже настоящие, я сохранял каждый прогон.
Зачем вообще
lumi-mini — это Gemma 4 E2B с моим системным промптом и несколькими примерами диалогов. Для своих размеров она отвечает неплохо, но у неё есть любимые слабые места. Ударения она не ставит вообще: пишет слово целиком капсом и считает, что справилась. На задачах с подвохом сыпется. А на вопрос про свежие новости иногда уверенно что-то выдумывает.
Мысль была простая: соберу несколько сотен хороших примеров, прогоню LoRA прямо на ноутбуке (MacBook с M5 Pro и 48 ГБ памяти, MLX это любит) — и модель подтянется. Спойлер в заголовке.
Взял mlx-lm 0.32 (в нём уже есть gemma4) и 4-битную mlx-community/gemma-4-e2b-it-4bit. Первая заминка случилась ещё на скачивании: 3,6 ГБ с Hugging Face качались мучительно и обрывались. Помогло отключить их новый протокол: HF_HUB_DISABLE_XET=1 и повтор при обрыве.
Экзамен, который нельзя подсмотреть
Ещё до обучения я завёл себе правило: экзаменационные вопросы в обучение не попадают. Иначе модель их просто запомнит, а я порадуюсь не тому. Назвал этот набор «сейфом». В нём 23 вопроса:
10 задач с подвохом, вроде «Батон и булка вместе стоят 110 рублей, батон на 100 дороже. Сколько стоит булка?»;
8 слов на ударения;
5 сленговых слов: скуф, краш, кринж, душнила, имба.
Каждый раз один и тот же системный промпт, те же примеры диалогов, что у lumi-mini в Ollama, и температура 0, чтобы прогоны повторялись. Проверял я руками, по заранее записанным правильным ответам.
И тут первый сюрприз, ещё до всякого обучения. За неделю до этого та же lumi-mini в Ollama (с температурой 0,4) решала мне 7 задач из 10. А в MLX с температурой 0 — всего 3. Модель та же, а результат в два раза хуже. После этого я перестал доверять цифрам, снятым в разных условиях, и прогнал «до» заново в MLX.
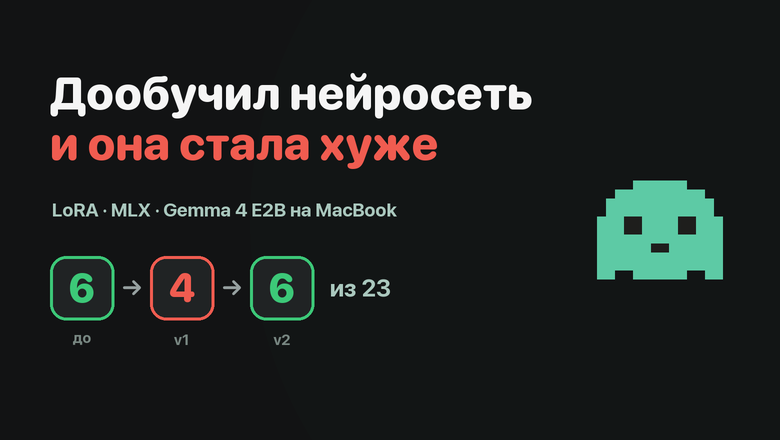
Отправная точка вышла скромная: 6 из 23. Задачи 3 из 10, ударения 0 из 8, сленг 3 из 5. «Краш», к слову, модель считала сбоем программы.
Первая попытка: модель поглупела
Датасет я собирал долго: 328 примеров для обучения и 40 для проверки, каждый перечитал. Там были вопросы про Mac («где найти Мониторинг системы»), задачи, похожие на экзаменационные, но другие (про бутылку с пробкой за 110 рублей), 24 примера на ударения, подсчёт букв по одной («с-о-с-и-с-к-а: буква „с“ — 3 раза») и 34 примера честного отказа. Например, на «кто вчера выиграл матч?» ответ был: «Не знаю: работаю без интернета, свежих данных у меня нет».
LoRA ранга 8 на 16 слоях, learning rate 5e-5, 75 шагов. Запускаю экзамен и получаю 4 из 23. Стало хуже, чем было.
До | Попытка 1 | |
|---|---|---|
Задачи | 3/10 | 1/10 |
Ударения | 0/8 | 2/8 |
Сленг | 3/5 | 1/5 |
Ошибки при этом были такие, что я какое-то время просто сидел и читал их:
«Сколько будет 2 + 2 × 2?» — «4». До обучения она отвечала 6.
Про Пушкина: «в 1841 году ему было 50».
«Как зовут пятую дочь?» (это где Чача, Чече, Чичи, Чочо) — «Не знаю: работаю без интернета». То есть мой шаблон для новостей она стала вставлять в логическую загадку.
«Скуф» — это теперь лодка.
На «кринж» она зациклилась и повторяла «от английского cringe…», пока не кончились токены.
Ударения: формат выучила (строчные буквы, ударная заглавная), но ставила их почти наугад, да ещё и коверкала слова: «зАвонИт», «вкУчИт».
Когда я разложил ошибки, картина стала понятной. Модель выучила не знания, а манеру моих ответов. Отказ «без интернета» стал универсальным ответом на всё сложное, побуквенный счёт — на всё про буквы. А часть того, что она знала раньше, вытеснилась. Это и есть катастрофическое забывание, о котором я раньше только читал. Оказалось, ему хватает 75 шагов.
Вторая попытка: осторожнее
Во второй раз я сделал всё мягче:
уменьшил learning rate в 5 раз, до 1e-5, и взял 8 слоёв вместо 16;
выкинул ударения совсем: 24 примера на такую тему, видимо, только вредят;
из 34 отказов «не знаю» оставил 10;
добавил replay. Задал исходной модели 117 обычных вопросов и её же ответы, не правя, положил в датасет: 73 в обучение, остальные в проверку. Идея в том, чтобы модель во время учёбы видела и своё «старое» поведение и не забывала его.
Всего вышло 338 примеров, 150 шагов. Итог: 6 из 23. Ровно как до обучения.
До | Попытка 1 | Попытка 2 | |
|---|---|---|---|
Задачи | 3/10 | 1/10 | 3/10 |
Ударения | 0/8 | 2/8 | 0/8 |
Сленг | 3/5 | 1/5 | 3/5 |
Всего | 6/23 | 4/23 | 6/23 |
Забывание ушло, это уже хорошо. Но и выигрыша нет. Внутри поменялось два ответа, и оба странно. Про Пушкина модель вдруг ответила правильно, 37, хотя Пушкина в обучающих данных не было вообще. А «что больше: 9,11 или 9,9?», на которое она до обучения отвечала верно, теперь проваливает. Плюс один, минус один.
Отдельно обидно за булку. Похожую задачу про бутылку с пробкой я положил в датасет с подробным решением, а на экзамене модель всё равно ответила «10 рублей».
И даже хороший результат было бы некуда деть
Пользователи Lumi получают модели через Ollama. Чтобы обученная версия до них дошла, её надо в Ollama загрузить. Тут меня ждали две ошибки подряд. Адаптер Ollama не берёт: LoRA adapters are no longer supported. Пробую слить адаптер с весами и импортировать модель целиком — получаю missing attention k projection. Насколько я понял, MLX сохраняет слитую 4-битную Gemma 4 не так, как ждёт импорт Ollama. Может, это скоро починят, но пока обученная модель живёт только внутри MLX на моём ноутбуке.
Что я для себя вынес
Несколько сотен примеров меняют то, как модель отвечает, но почти не меняют, что она знает. Формат она хватает моментально, знания — нет.
Шаблонные ответы в датасете опасны. Если в каждом десятом примере написано «не знаю, я без интернета», модель начнёт говорить это и там, где ответ знает.
Replay реально спасает от забывания. В первой попытке я потерял два балла, во второй — ноль.
Экзамен надо запечатывать и гонять в одинаковых условиях. Иначе можно «улучшить» модель, просто поменяв температуру.
Для моего приложения дообучение пока не путь. Честнее подкручивать промпт и примеры в Modelfile, а тем, у кого хватает памяти, предлагать модель побольше. Так что в Lumi остаётся обычная lumi-mini, а у меня на диске — 4 ГБ весов и три папки с адаптерами на память.
Если вы пробовали дообучать модели такого размера (2–4 миллиарда параметров), мне очень интересно: получалось ли добавить именно знаний, а не только манеры? И сколько для этого понадобилось примеров? И если кто-то переносил LoRA-обученную Gemma 4 из MLX в Ollama, расскажите, как.
Код Lumi открыт (MIT): github.com/AlbertS15/Lumi. Проект независимый и не связан с Google, Apple, Anthropic или Ollama.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.