Наконец-то я понял Андрея Карпатого с помощью Арканоида
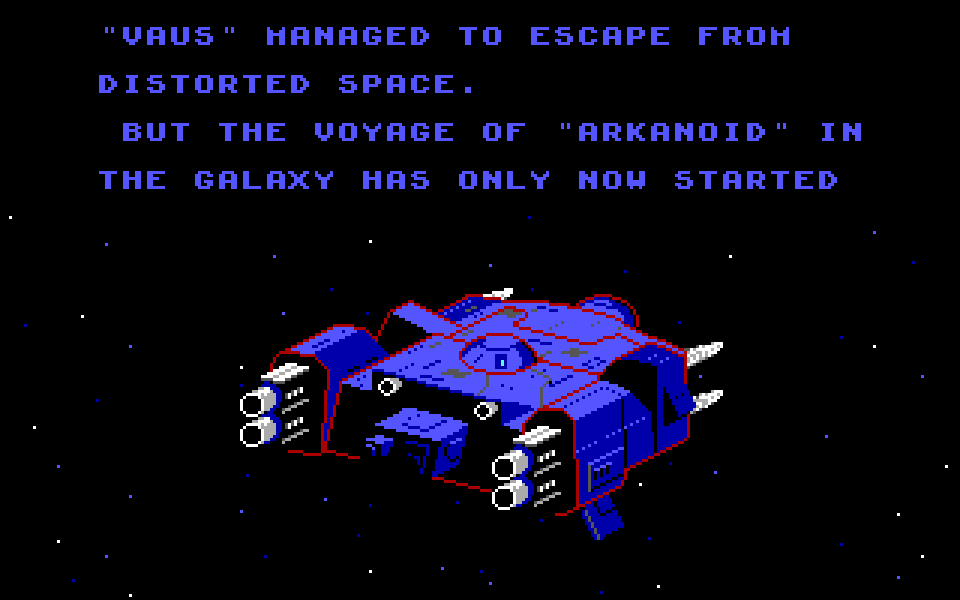
Это последний кадр DOS-Арканоида 1988 года. Корабль «VAUS» улетает, потому что в 33-м раунде разбит босс DOH. У игры нет API, то есть готового программного входа, и в её память никто не лезет. Есть только картинка 320 на 200 пикселей, клавиатура и мышь.
До этого кадра в 10 партиях из 10 дошла программа, которую написал ИИ. Сам ИИ при этом не играл. Он изучил игру, глядя на экран, и написал обычную программу-игрока, а играла уже она. Доступ к игре и отдельную программу для проверки мы подготовили вдвоём с Claude, а задачи ставил я.
Полгода назад, в апреле 2026 года, я посмотрел выступление Андрея Карпатого на конференции Sequoia AI Ascent (есть и русский дубляж). Он рассказывал о трёх поколениях программ. В Software 1.0 человек пишет код. В Software 2.0 собирает данные и обучает нейросеть. В Software 3.0 «программирование превращается в промпт», а то, что лежит в контекстном окне, становится «рычагом, которым вы управляете интерпретатором, то есть LLM». Я посмотрел, покивал и, как теперь понимаю, ничего не понял.
Я не профессиональный программист. Слова про вайб-кодинг, агентов и новую парадигму давно стали для меня абстракцией: звучат умно, но потрогать их нельзя. Недавно я пересмотрел то выступление и удивился, что теперь понимаю почти каждое слово. За эти полгода я узнал в его словах свой опыт. Сначала пытался научить ИИ играть в Арканоид через обучение нейросети, и не смог. Потом поставил задачу иначе, и получилось.
Об этом и статья: как простая игра 1988 года объяснила мне то, что не смогла объяснить лекция.
Как я делал раньше: Software 2.0
Полгода назад «сделать ИИ, который играет в игру» означало для меня одно: обучение с подкреплением (RL). Нейросеть смотрит на экран, жмёт кнопки, получает награду за набранные очки и так учится на миллионах попыток. Так когда-то учили сети играть в игры Atari. У меня тогда не вышло.
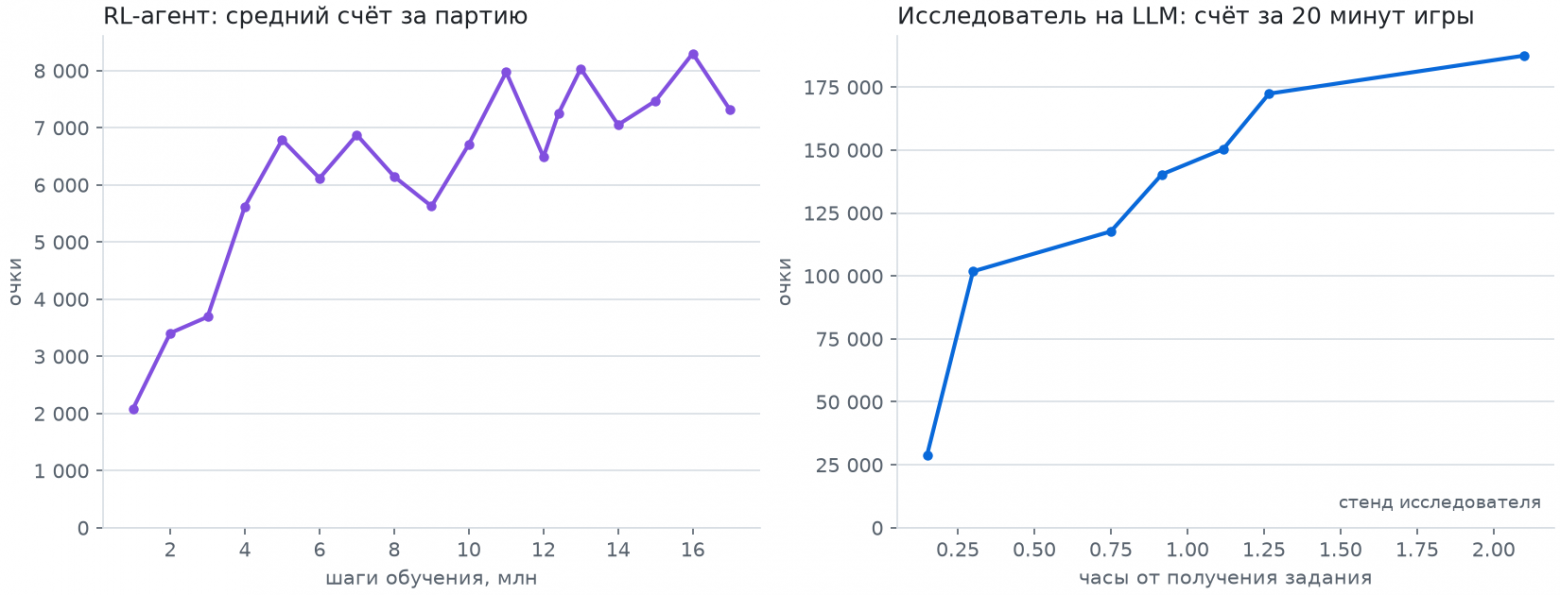
В этом проекте я прошёл тот же путь ещё раз, аккуратнее, и записывал каждый прогон. Агент видел уменьшенный экран, мог сдвигать ракетку только небольшими шагами и учился около суток на процессоре ноутбука: 17 млн шагов, примерно 17 часов чистого обучения. Средний счёт подрос и застрял на 7–8 тыс. очков. Первый раунд он ни разу не очистил от кирпичей, во второй иногда выходил через бонусную капсулу. Я менял награду, давал тренироваться с удобных позиций, увеличивал число оценочных партий. Правки немного помогали, но дальше дело не шло.
Весь код для обучения писала Claude, большая языковая модель (LLM), в роли помощника программиста. Она готовила среду, расчёт награды и проверку результатов. Она находила ошибки и предлагала правки. Но всё это внутри метода, который выбрал я. ИИ для меня был обучаемой сетью, а LLM я использовал как инструмент для её создания. Сейчас я понимаю, что это и есть Software 2.0 по Карпатому: программист «расставляет датасеты и цели обучения». Когда я подкручивал награду и стартовые позиции, я программировал именно так.
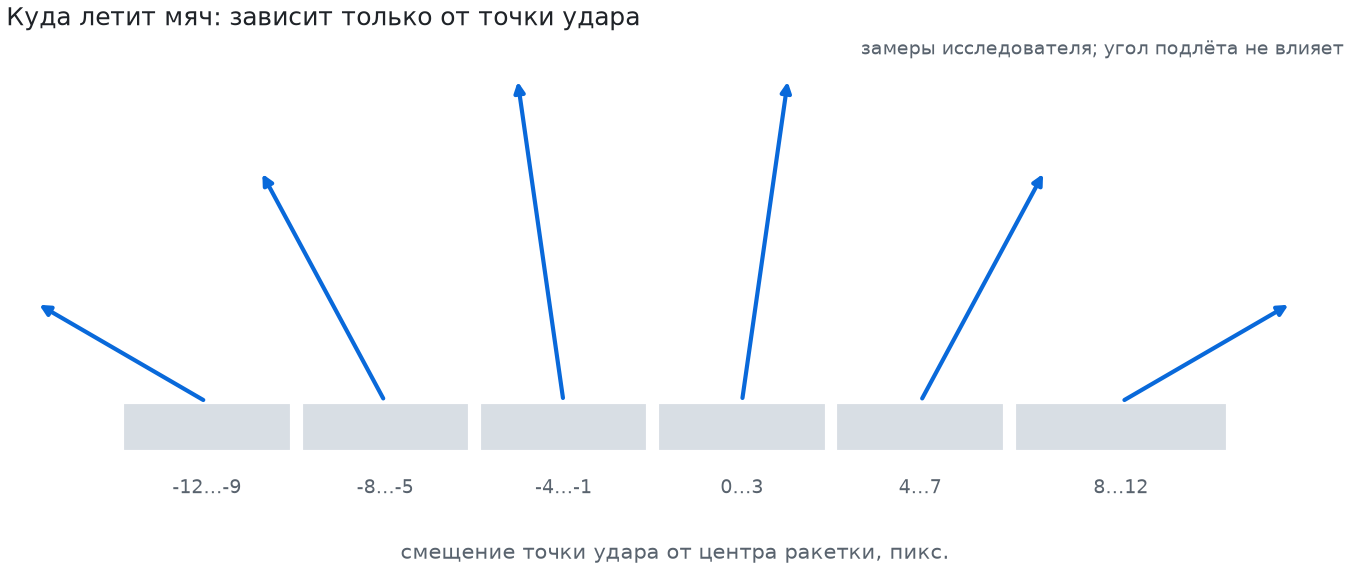
Почему агенту было так трудно, стало понятно позже. Направление отскока зависит от точки удара: если сдвигать ракетку в пределах ±12 пикселей от центра мяча, угол меняется примерно от 20° до 160°. На уменьшенной вдвое картинке мяч превращался в размытое пятно, а ракетка двигалась только маленькими шагами. Агенту было трудно и заметить этот механизм, и воспользоваться им. Сам агент этого не выяснил. Я подсказал, от чего зависит отскок, и только потом мы это измерили. Зрение и управление мы потом переделали, но новый прогон так и не доучили.
Как получилось: Software 3.0
Тогда я попробовал по-другому. Отдельная сессия той же LLM получила не задачу «напиши код для обучения», а «тело» и цель. Телом был эмулятор: в нём старая DOS-игра запускается на современном компьютере с самого начала. Исследователь мог смотреть на экран, нажимать клавиши, двигать мышь и возвращаться к сохранённым моментам игры. Цель звучала так: «разберись сам, как играть, и напиши программу-игрока». Я назвал игру и рассказал, как будет проверяться результат. Как играть, не подсказывал.
Модель была та же, Claude Opus 5.5. Поменялась её роль, а вместе с ней и условия: точное управление мышью, полный кадр вместо уменьшенного, сохранения для опытов.
И вот что я понял, когда пересмотрел выступление. Моей программой здесь был уже не код, а текст: задание на одну страницу и описание тела. Его читала LLM, тот самый интерпретатор, о котором говорил Карпатый. А она уже писала самый обычный код игрока, которому никакая LLM для игры не нужна. Software 3.0 написало Software 1.0. Я управлял её работой через задание: объяснял цель, правила и то, как будем проверять результат.
Начал исследователь так же, как начал бы человек: включил игру и стал смотреть. Нашёл меню выбора видеорежима и устройства ввода, понял, что клик мышью пропускает вступительную историю, вырезал из кадров шаблоны цифр, чтобы читать счёт с экрана. Одним из первых опытов выяснил, что мышь двигает ракетку без ограничения скорости: одним рывком её можно перебросить через всё поле за кадр, то есть за 1/70 секунды. Значит, ракетку можно поставить куда угодно. Осталось понять, куда целиться.
По истории версий видно, что меньше чем через полчаса после задания вторая версия игрока набрала 101 820 очков и дошла до раунда 9, не потеряв ни одной жизни. Это замер на собственных прогонах исследователя. Примерно через 2,5 часа игрок на проверке у судьи набирал в среднем 174 тыс. очков и за 20 минут игры доходил до раундов 14–19. Интереснее не цифры, а то, как исследователь работал.
Как работал исследователь
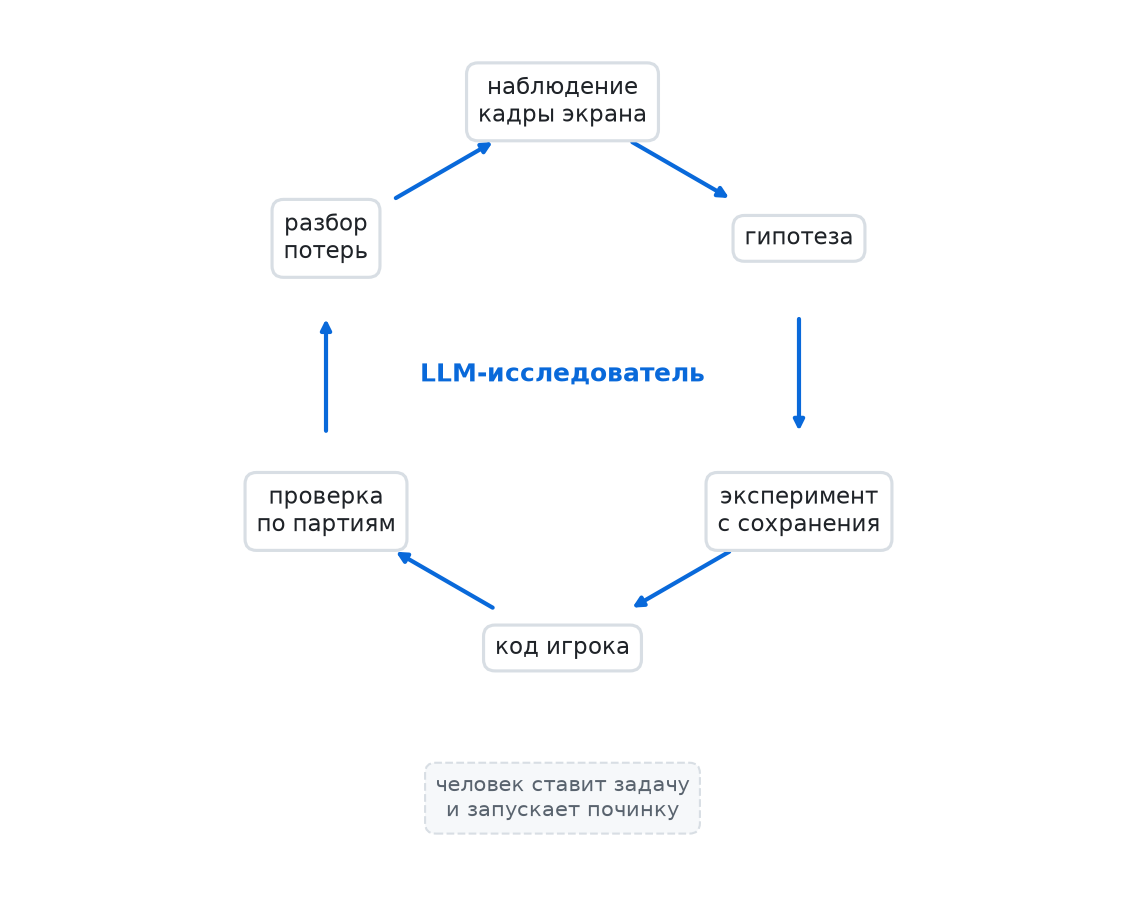
История первая: угол отскока. Чтобы целиться, исследователь проверил, от чего зависит отскок. Взял из сохранения один и тот же момент, когда мяч падает вниз. Ставил ракетку с разным смещением относительно мяча и мерил, как мяч отлетает. Получилось шесть зон в пределах ±12 пикселей: от пологого отскока влево до пологого вправо. Повторил опыт на другом моменте, вышло то же самое. В обоих опытах угол подлёта ничего не менял. После этого игрок на каждом подлёте просчитывал полёт мяча для каждой зоны и выбирал ту, что быстрее разобьёт кирпич.
Здесь я удивился больше всего за весь проект. Я не ожидал, что LLM поймёт, что дело в физике, и сама догадается измерить смещение ракетки, скорость мяча и угол отскока. Знала ли она про отскок в Арканоиде заранее, неизвестно, но замер она придумала и провела сама. Это был уже не помощник, который пишет код по моей подсказке, а исследователь, который ставит опыт.
Потом начались проверки и исправления. Игрок потерял мяч на пологом ударе. Исследователь стал записывать последние кадры перед каждой потерей и увидел, что ракетка дрожит на пару пикселей и мяч проскакивает мимо края. Попробовал целиться ближе к центру, и стало хуже: 30 350 очков вместо 95 130. Тогда он вывел правило, до которого я бы сам не додумался. Ошибка в сторону центра ракетки безопасна, она меняет только угол. Ошибка к краю смертельна. Крайние зоны он убрал совсем, и потери почти исчезли.
В журнале записаны и неудачи: «не ловить замедляющую капсулу: хуже», «выбор точки подачи: в пределах шума», «поиск на два отскока: не лучше». Журнал читается как лабораторная тетрадь, а не как отчёт об успехах.
Когда мы обучали нейросеть, про отскок подсказал я. Здесь подсказки не было. Что модель знала об Арканоиде из своего обучения, мы проверить не можем. Но опыт она поставила сама и зоны измерила сама, причём в первый же час работы.
История вторая: починка. Без лимита времени игрок доходил до последнего, 33-го раунда, и там проигрывал примерно за 36 секунд. В этом раунде нет кирпичей. Есть босс DOH, каменная голова, которая стреляет. Раньше в ракетку никто не стрелял, исследователь такого не видел, и игрок не умел уворачиваться. Я заметил это, когда запустил длинные партии.
Я поставил новую задачу: «дойди до раунда 33 и победи DOH», без подсказок, как. Исследователь разобрал кадры проигрыша, нашёл снаряды и научил игрока заранее считать, где они пересекут линию ракетки, чтобы там не стоять.
Потом судья нашёл новую беду: в одной партии мяч зациклился в раунде 25, и раунд никак не кончался. Исследователь поправил правило, по которому игрок замечает, что мяч ходит по кругу. Официальный зачёт поймал застревание ещё раз, в другой партии. Во второй раз исследователь копнул глубже: 24 раза переиграл раунд 25 с двух сохранённых моментов, каждый раз чуть сдвигая старт, и нашёл 4 случая, где мяч застревает. Добавил запасной ход: если застой тянется долго, игрок нарочно пропускает мяч и подаёт заново из выгодной точки.
Карпатый на сцене процитировал чужую фразу: «Думать можно поручить, понимать нельзя». Думал здесь исследователь: ставил опыты и писал код. Понимать оставалось мне: что игрок не видел босса, что зачёт должен вести отдельный судья, что пора ставить новую задачу на починку. А сам игрок остался обычным кодом: быстрым, предсказуемым, его можно прочитать и проверить тестами.
Как проверяли
Здесь до меня дошла ещё одна мысль Карпатого. Обычным компьютерам легко поручить то, что можно описать кодом. А языковым моделям можно поручать задачи, результат которых можно проверить. В игре было удобно проверять догадки: можно вернуться к сохранению, повторить опыт и сразу увидеть результат на экране. Без этого исследователю было бы не на чем ставить опыты.
Но верить замерам самого исследователя я не хотел, поэтому оценку давал независимый судья, отдельная программа в основном репозитории. Он включает игру с самого начала, ждёт случайное число кадров, чтобы партии различались, передаёт управление игроку и читает всё с экрана: счёт, раунд и финальную заставку с кораблём. Судью тоже пришлось дважды чинить.
Финальный зачёт: 10 партий с разными задержками старта, лимит 90 минут игрового времени. Итог: 10 побед над DOH из 10, средний счёт 343 977, от 324 до 370 тыс.
Сколько это стоило? Я работал по подписке, отдельного счёта нет. Если взять расход из журналов сессий и посчитать его по ценам API (там платят за объём текста, который модель прочитала и написала), работа исследователя обошлась бы примерно в $31: игрок с нуля около $12, победа над DOH около $9, две починки около $10. Все обращения к модели за весь проект, вместе с RL, эмулятором, судьёй и обсуждениями, обошлись бы примерно в $136.
От Арканоида к бизнесу
Для меня самое ценное в этом проекте даже не победа над DOH. Раньше разговоры про ИИ-агентов в бизнесе были для меня абстракцией. Теперь у меня есть несколько простых правил, и каждое я увидел своими глазами.
Агенту нужна песочница, где можно ошибаться. Исследователь раз за разом откатывался к сохранению и пробовал снова. В работе это значит: прежде чем пускать агента в живую систему, дайте ему копию, например копию CRM без доступа к настоящим платежам, тестовую базу или эмулятор, где ошибка не повредит рабочим данным.
Сначала решите, как проверять. «10 из 10» что-то значит только потому, что победы считал отдельный судья, а не сам исследователь. В бизнесе судьёй может быть автотест, который сверяет итоговый баланс в учётной системе. Если вы не можете сказать, как узнаете, что агент справился, автоматизировать пока рано.
LLM становится частью системы, а не помощником сбоку. В первой попытке LLM была помощником: писала код, а за систему думал я. Во второй она стала звеном системы: получает задачу, ставит опыты, пишет и чинит игрока. Готовый код быстро выполняет найденное решение, а судья проверяет результат. В бизнесе я бы теперь думал так же: не «дать сотрудникам чат-бота», а встроить LLM в сам процесс там, где нужно разобраться в новой ситуации, а вокруг оставить обычный код и проверки.
Если не получилось, это ещё не приговор. Полгода назад я был уверен, что без долгого обучения нейросети тут не обойтись, и после неудачи отложил эту затею. А в этом проекте одна и та же модель сначала помогала мне с обучением нейросети, а потом в роли исследователя примерно за 2,5 часа написала игрока, который доходил до раундов 14–19. Теперь, если что-то с ИИ не вышло, я не ставлю точку, а через несколько месяцев пробую снова.
Когда вам предлагают «ИИ-решение», я бы теперь спросил:
Как вы проверяете результат независимо от того, кто делал решение?
На каких этапах работает модель, а что выполняет готовая программа, которую можно прочитать и протестировать?
Что будет при новом виде сбоя: кто его заметит и кто поставит задачу на починку?
Вместо вывода
Полгода назад слова Карпатого про Software 3.0 прошли мимо меня. Я их слышал, но ИИ для меня оставался обученной моделью, а LLM удобным помощником, который пишет для неё код. Понял я их не из лекции, а из Арканоида: когда увидел, как мяч летит туда, куда целился игрок, которого написала LLM. А началось всё с одной страницы задания.
Модели за полгода стали сильнее, и честно сравнить «тогда» и «сейчас» я не могу. Но внутри этого проекта модель была одна, а результат разный. Вместо просьбы написать код для обучения я дал ей задачу, доступ к игре и правила проверки.
Если вам, как и мне, слова про новую парадигму кажутся слишком абстрактными, найдите свой Арканоид: простую задачу, где результат видно глазами. Она объяснит лучше лекции.
Код проекта: neuronoid и neuronoid-strategist. Журнал исследователя: LOG.md. Разбор его рассуждений: страница.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.