Microsoftが2.8兆パラメータの基盤モデル「MAI-Base-2」の事前学習完了を発表
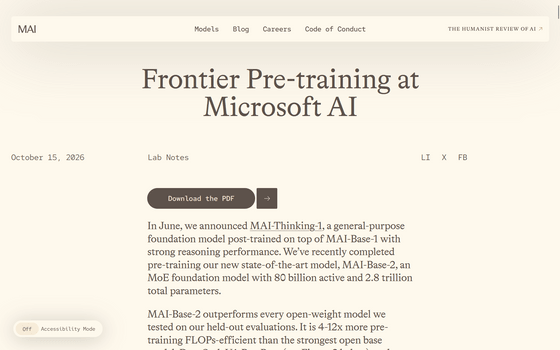
2026年6月、Microsoftは独自開発の推論モデル「MAI-Thinking-1」を発表していました。これのベースとなったモデルが「MAI-Base-1」で、350億のアクティブパラメータと合計1兆のパラメータを持っていました。
そして2026年10月、MAI-Base-1の次の世代のモデルとなるMAI-Base-2の存在が公表されました。MAI-Base-2は800億のアクティブパラメータと合計2.8兆のパラメータを持つMoEモデルです。
MAI-Base-2はMAI-Base-1よりも大規模で、より多くのデータで学習されているのが特徴。2026年8月から9月にかけて、1万6000基のGB200 GPUを使用し、38日間にわたってMAI-Base-2を学習させたそうです。
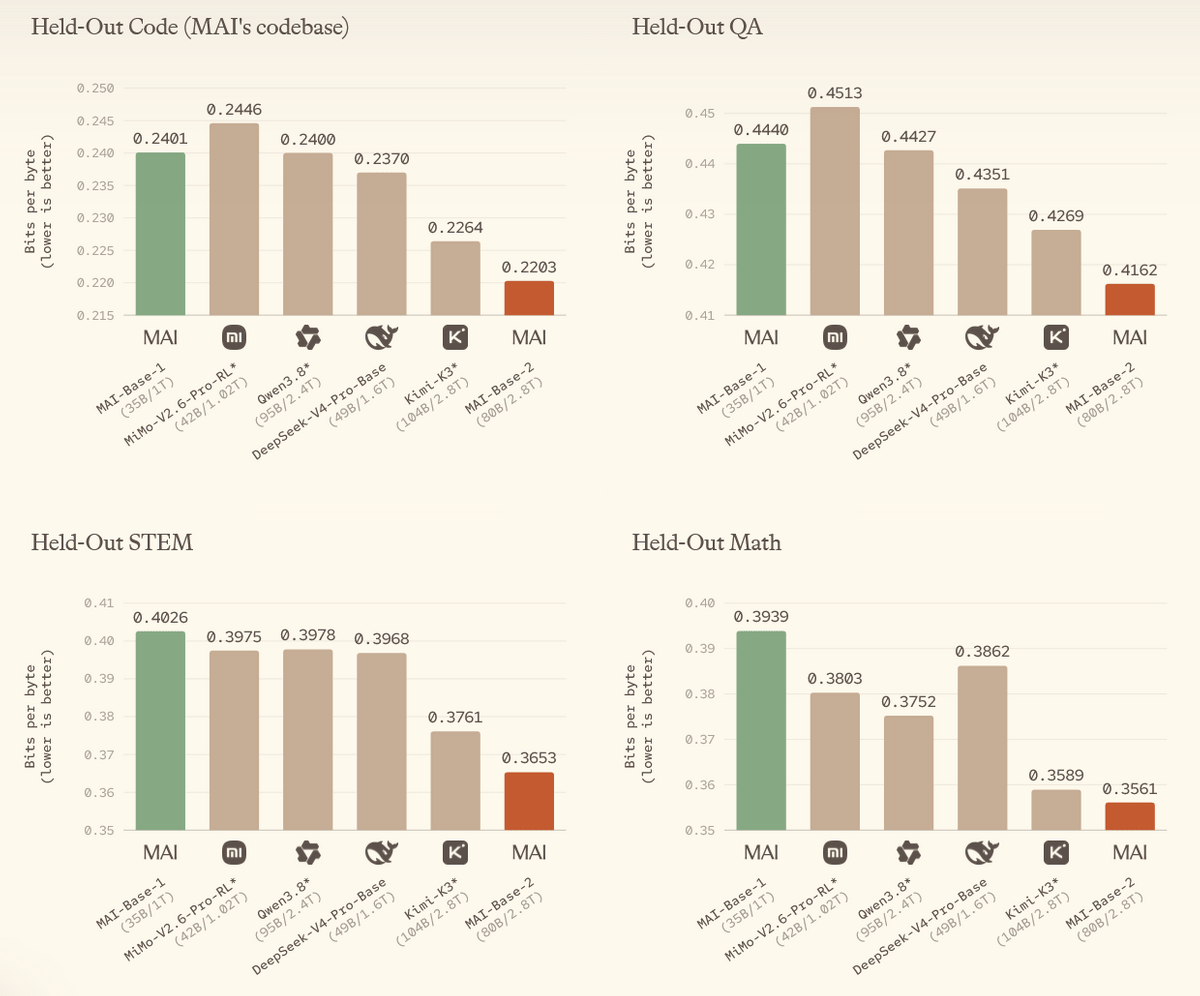
以下は、MAI-Base-2の精度を総パラメータ数が1兆を超えるオープンウェイトモデルと比較したときの図。数値が低いほど優れています。なお、MAI-Base-2がオープンウェイトモデルであるかどうかは明記されていません。MAI-Base-1はクローズドウェイトモデルです。
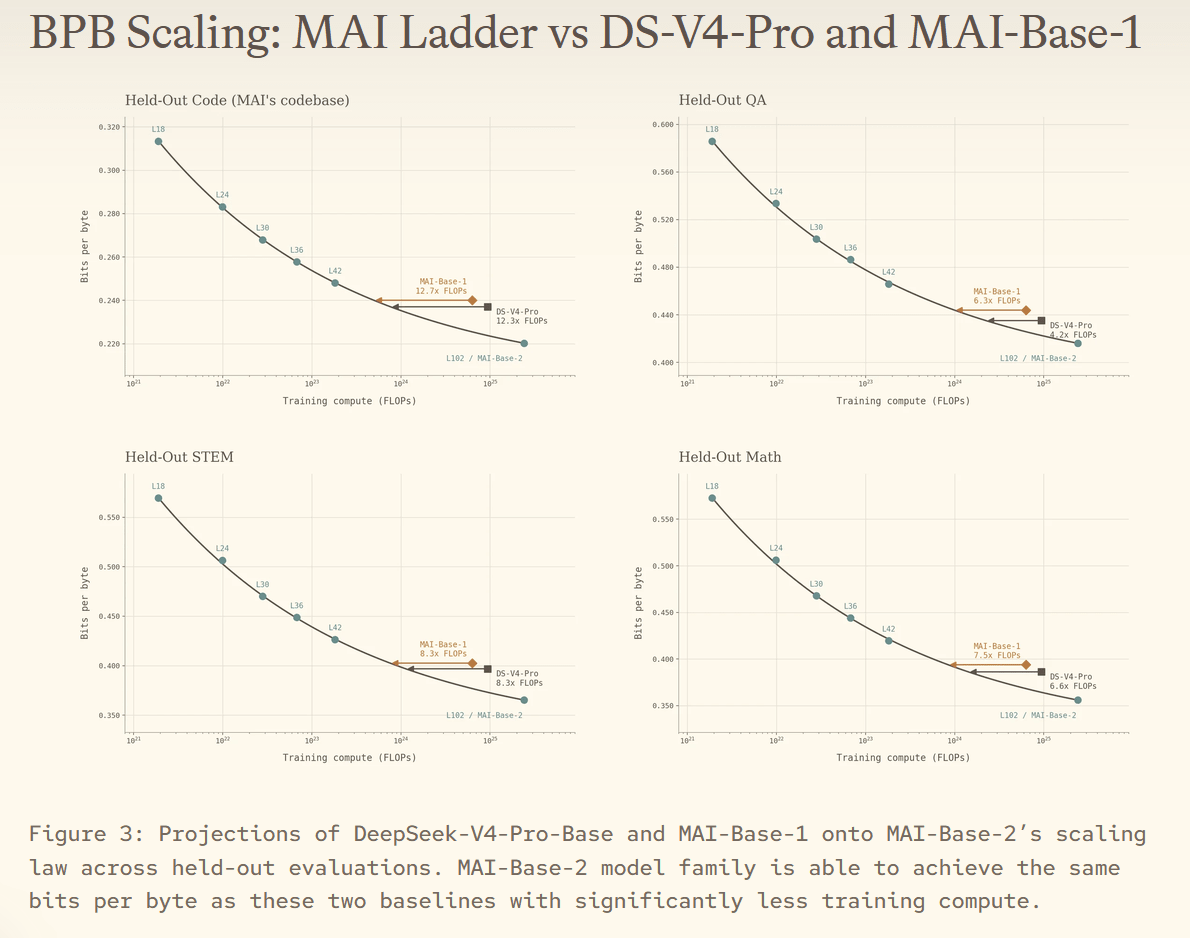
また、事前学習の計算量を12分の1に削減してDeepSeek-V4-Pro-Baseの事前学習スコアに匹敵したとのこと。
MAI-Base-2はMAI-Base-1と同様、他のモデルからの「蒸留」で構築してはいないことがアピールされています。また、基となる学習データから構築後のモデル、モデルを稼働させるインフラまでフルスタックでMicrosoftが所有していることも強みだとされています。
一方でMAI-Base-2はMAI-Base-1と異なり、事前学習の段階から画像データも取り入れたマルチモーダルモデルとして構築されています。画像とテキストの組み合わせなどを含む学習データが用いられ、全50兆トークンの学習データのうち18%を画像関連のデータが占めています。
MicrosoftはMAI-Thinking-1以降、品質分類、ウェブページの解析、重複除去、評価データと学習データの重複排除を改善し、MAI-Base-2では2026年3月までの知識を対象として、より多くのウェブコンテンツを処理できるようにパイプラインを拡張したとのこと。これらの手法によってモデルの性能が大幅に向上したそうです。
MAI-Base-2についてMicrosoftは「次世代モデルの基盤となるもの」と位置づけ、近日中にさらなる情報を発表するとしています。また、MAI-Base-2の事後学習を進める一方で、すでに「MAI-Base-3」の準備にも着手しているとのことです。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.