[Перевод] Телеуправление, симуляции и камеры на кепках: как добывают данные для обучения роботов
Телеуправление, симуляции и камеры на кепках: как добывают данные для обучения роботов
8 мин
671
Перевод
Языковые модели поумнели во многом благодаря масштабу: их обучали на десятках триллионов токенов текста, который человечество накопило в интернете. У робототехники такого запаса нет: никто не выкладывал в сеть миллионы часов записей того, как робот складывает рубашку или наливает воду. Каждый такой час приходится записывать с нуля.
В статье разберём, как сейчас добывают данные для обучения роботов, сколько их уже собрано и во сколько обойдётся догнать LLM. По грубым оценкам, данных у роботов примерно в тысячу раз меньше.
Почему всё упирается в данные
Прогресс ИИ последних лет — прежде всего заслуга масштаба. В 2020 году, после выхода GPT-3, Gwern сформулировал эту идею в эссе «The Scaling Hypothesis». По его словам, интеллект — это «всего лишь» простые алгоритмы обучения плюс огромный объём разнообразного опыта. Чем больше вычислительных мощностей, тем умнее будут нейросети. В 2024 году исследователь под псевдонимом Nostalgebraist подвёл итог: весь нынешний ИИ вырос из открытия, что модели стабильно и предсказуемо улучшаются с ростом объёма данных.
Цифры это подтверждают:
по данным Epoch AI, с начала 2010-х обучающие датасеты языковых моделей удваиваются примерно каждые полгода;
GPT-3 обучали примерно на 300 млрд токенов из интернета, а крупнейшие современные модели — на десятках триллионов;
в 2024 году Epoch AI оценила общий запас качественного доступного текста в ~300 трлн токенов.
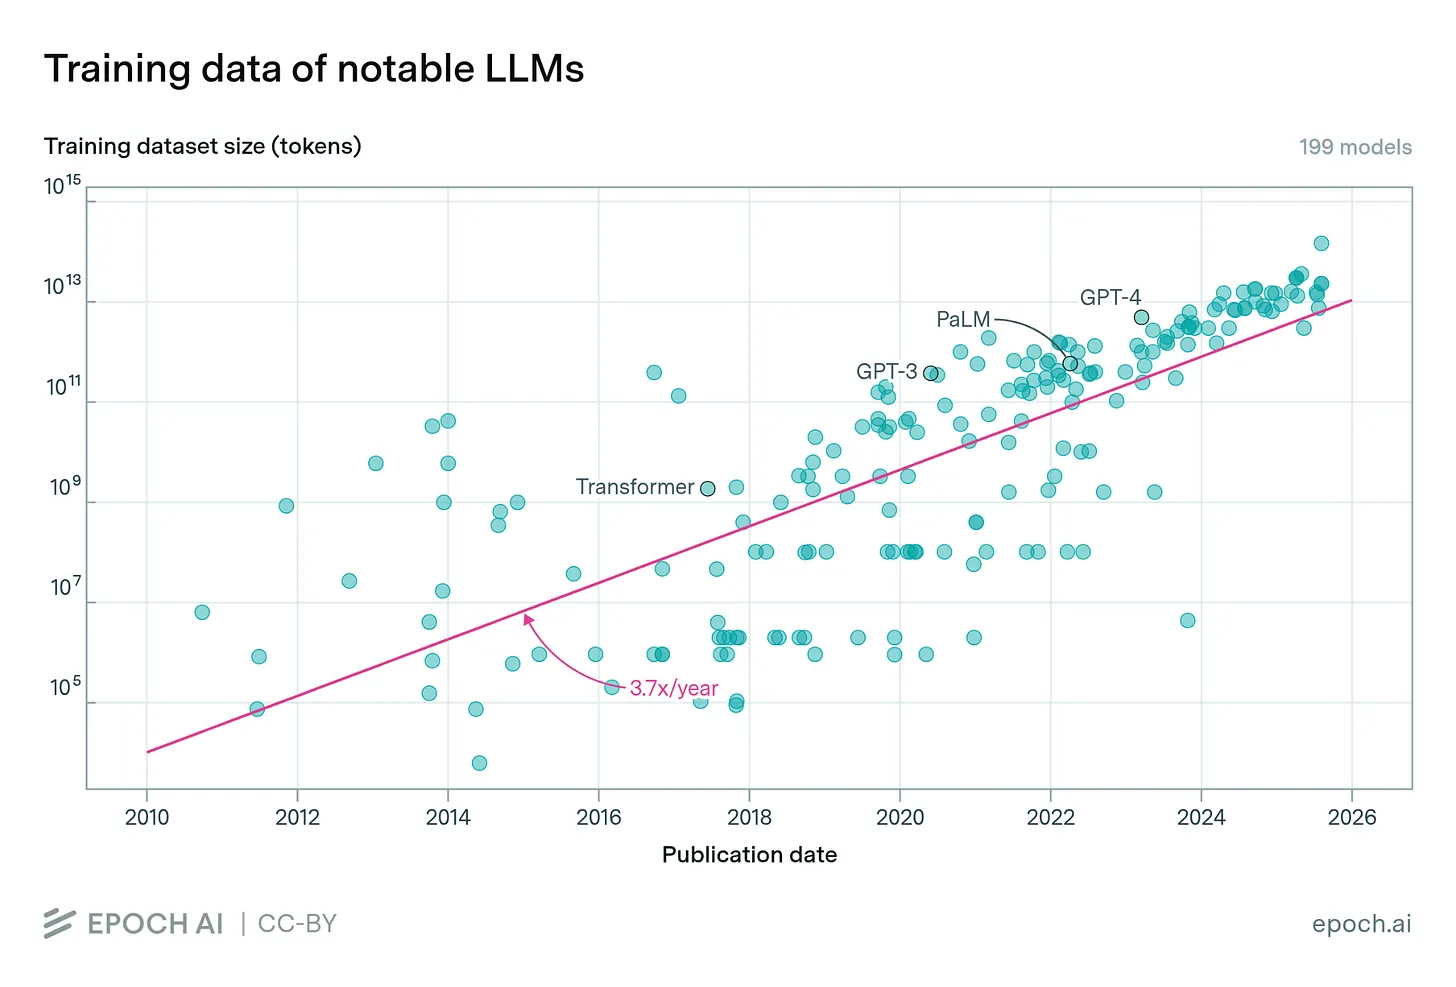
Для роботов сопоставимого запаса хороших общедоступных данных просто нет. Поэтому один из ключевых вопросов отрасли — откуда их брать и сколько вообще нужно.
Как выглядит обучающий пример для робота
Принцип тот же, что у LLM. Модели нужно много примеров правильного выполнения задачи или хотя бы способ оценить, удачна ли попытка. Модель получает входные данные, её ответ сравнивают с правильным, а параметры корректируют градиентным спуском, чтобы уменьшить ошибку.
С текстом всё просто: любой фрагмент — уже готовый пример. Модели показывают начало и просят предсказать продолжение.
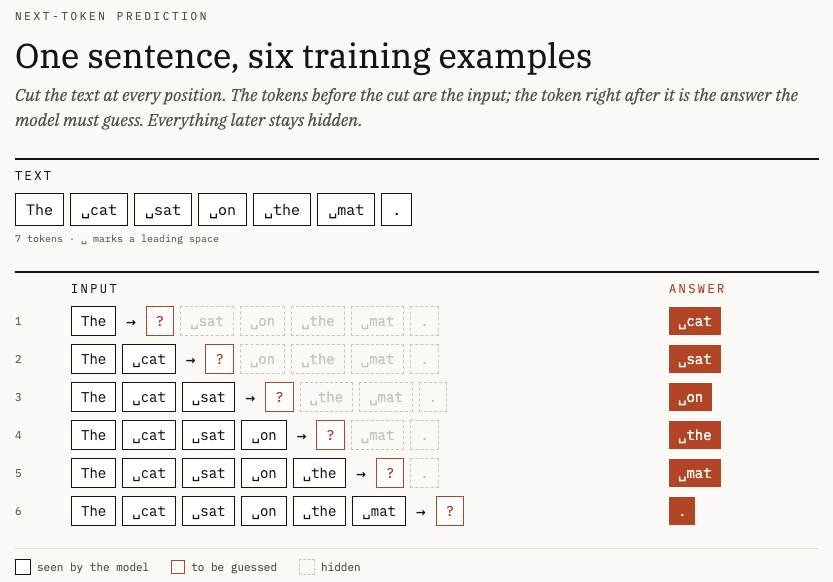
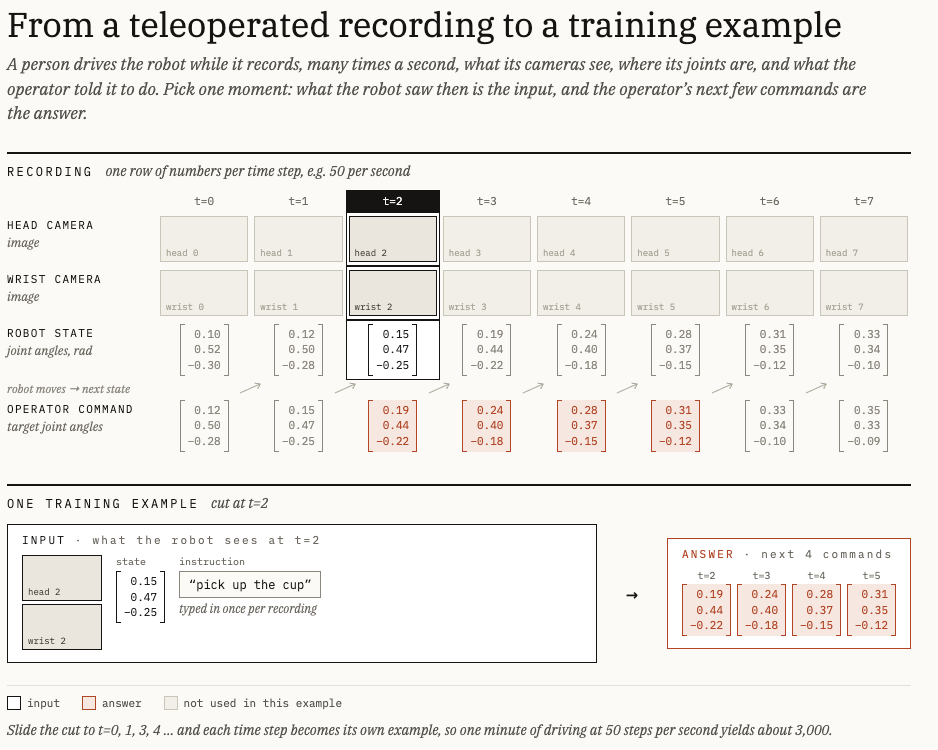
Для робота пример — это запись того, как он выполняет задачу. В каждый момент времени она содержит состояние робота (например, углы поворота суставов) и изображения с камер. По ним модель предсказывает следующее действие.
Пять способов добыть данные
Телеуправление
Оператор с помощью органов управления, напрямую связанных с роботом, выполняет его руками нужную задачу: складывает рубашку, переставляет предметы, наливает воду.
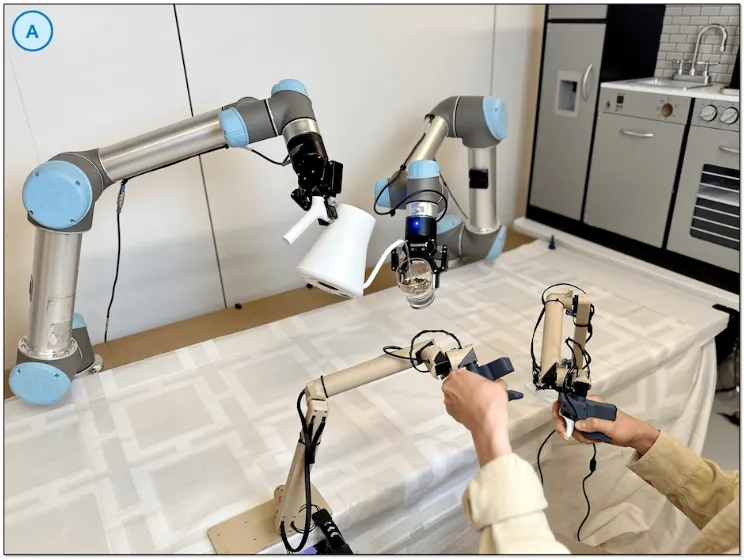
Всё это записывается, а затем модель учат повторять действия оператора. Такой способ, когда модель подражает примерам эксперта (в данном случае человека), называется клонированием поведения (behavioral cloning). Это частный случай более широкого подхода — обучения с подражанием (imitation learning).
Плюс: данные идеально соответствуют возможностям конкретного робота, ведь записаны на нём же. Поэтому метод до сих пор широко используется. В сети можно найти фото целых «фабрик данных», где люди только и делают, что управляют роботами. Есть и видео аварий: оператор забывает, что управляет роботом, и делает движение, которое тот не может повторить.
Минусы:
дорого: каждому оператору нужен настоящий робот, поэтому масштабировать сложно;
неудобно: оператор обычно не чувствует предмет, и тонкую манипуляцию так толком не запишешь;
много брака: насколько известно, для обучения пригодна лишь часть собранных данных.
Роботы, которые учатся сами
Робот действует автономно, а система оценивает, удалась ли попытка. Это обучение с подкреплением (reinforcement learning). Например, около 2016 года у Google была так называемая «ферма манипуляторов» (arm farm). Манипуляторы сами пытались хватать предметы, и удачный захват засчитывался как успех.
Сейчас такие фермы почти не встречаются. Но в перспективе главным источником данных, скорее всего, станут роботы, которые работают в реальном мире. Робототехники называют это «маховиком данных» (data flywheel). Роботы работают, их данные улучшают модели, роботов с улучшенными моделями внедряют шире, и данных становится ещё больше.
Physical Intelligence, например, обкатывает такой подход на шоколадной фабрике рядом со своим офисом. Проблем две. Роботов с ИИ, занятых реальной работой, пока очень мало. А их данные однообразны: одна и та же задача в одних и тех же условиях, и для обучения от этого мало толку.
Симуляция
Вместо реального робота обучают цифрового в виртуальном мире, обычно методом обучения с подкреплением. Есть и схема «учитель — ученик» (teacher/student). Модель-учитель видит всё, что происходит в симуляции. Модель-ученик видит только то, что увидел бы реальный робот: картинку с камер и собственное состояние. Ученик учится подражать учителю.
Симуляция дешёвая и быстрая, и её легко масштабировать до тысяч роботов:
Figure AI научила своего гуманоида ходить, обучив его с подкреплением на тысячах симулированных копий;
OpenAI научила роботизированную руку собирать кубик Рубика, потратив эквивалент 13 000 лет симулированного опыта;
к 2019 году беспилотники Waymo проехали 10 млн миль по реальным дорогам и 10 млрд в симуляции.
Главная проблема — разрыв между симуляцией и реальностью (sim-to-real gap). Данные хороши ровно настолько, насколько точна симуляция. Для задач передвижения (локомоции) она работает неплохо: физика ходьбы по пересечённой местности или полёта дрона по маршруту хорошо изучена и поддаётся цифровому моделированию. А манипуляцию предметами, особенно мягкими и деформируемыми, точно смоделировать гораздо сложнее.
Частичное решение — рандомизация домена (domain randomization). Какими окажутся трение или упругость в реальном мире, заранее неизвестно, поэтому в симуляции эти параметры меняют случайным образом. Так модель готовится к широкому диапазону значений. В проекте с кубиком Рубика OpenAI пошла дальше и разработала автоматическую рандомизацию (ADR), которая генерирует всё более сложные условия. По словам команды, причина была в том, что трение, упругость и динамику таких объектов слишком трудно точно смоделировать.
Результат при этом вышел скромным: при самых сложных начальных положениях кубика рука справлялась лишь в 20% случаев. Возможно, поэтому для обучения манипуляции этот приём сейчас почти не применяют. Зато для локомоции случайное варьирование параметров вроде коэффициента трения стало стандартом.
Запись людей
Можно записывать, как задачи выполняют люди, а потом переносить их движения на робота. В том числе поэтому так популярны гуманоиды: для робота с человеческим телом записи людей за работой — естественный источник данных.
Варианты:
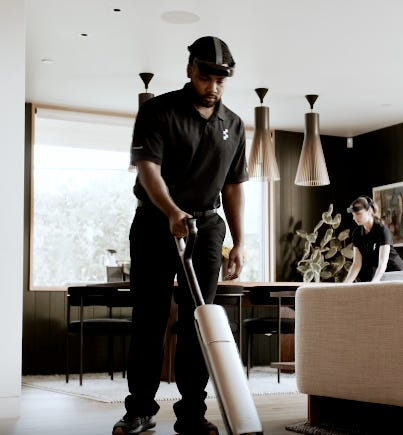
Видео от первого лица (egocentric video), то есть съёмка камерой, закреплённой на голове. Figure AI запустила программу Index и рассылает людям налобные камеры. Компания может даже прислать команду, которая возьмёт на себя ваши домашние дела и заодно их запишет.
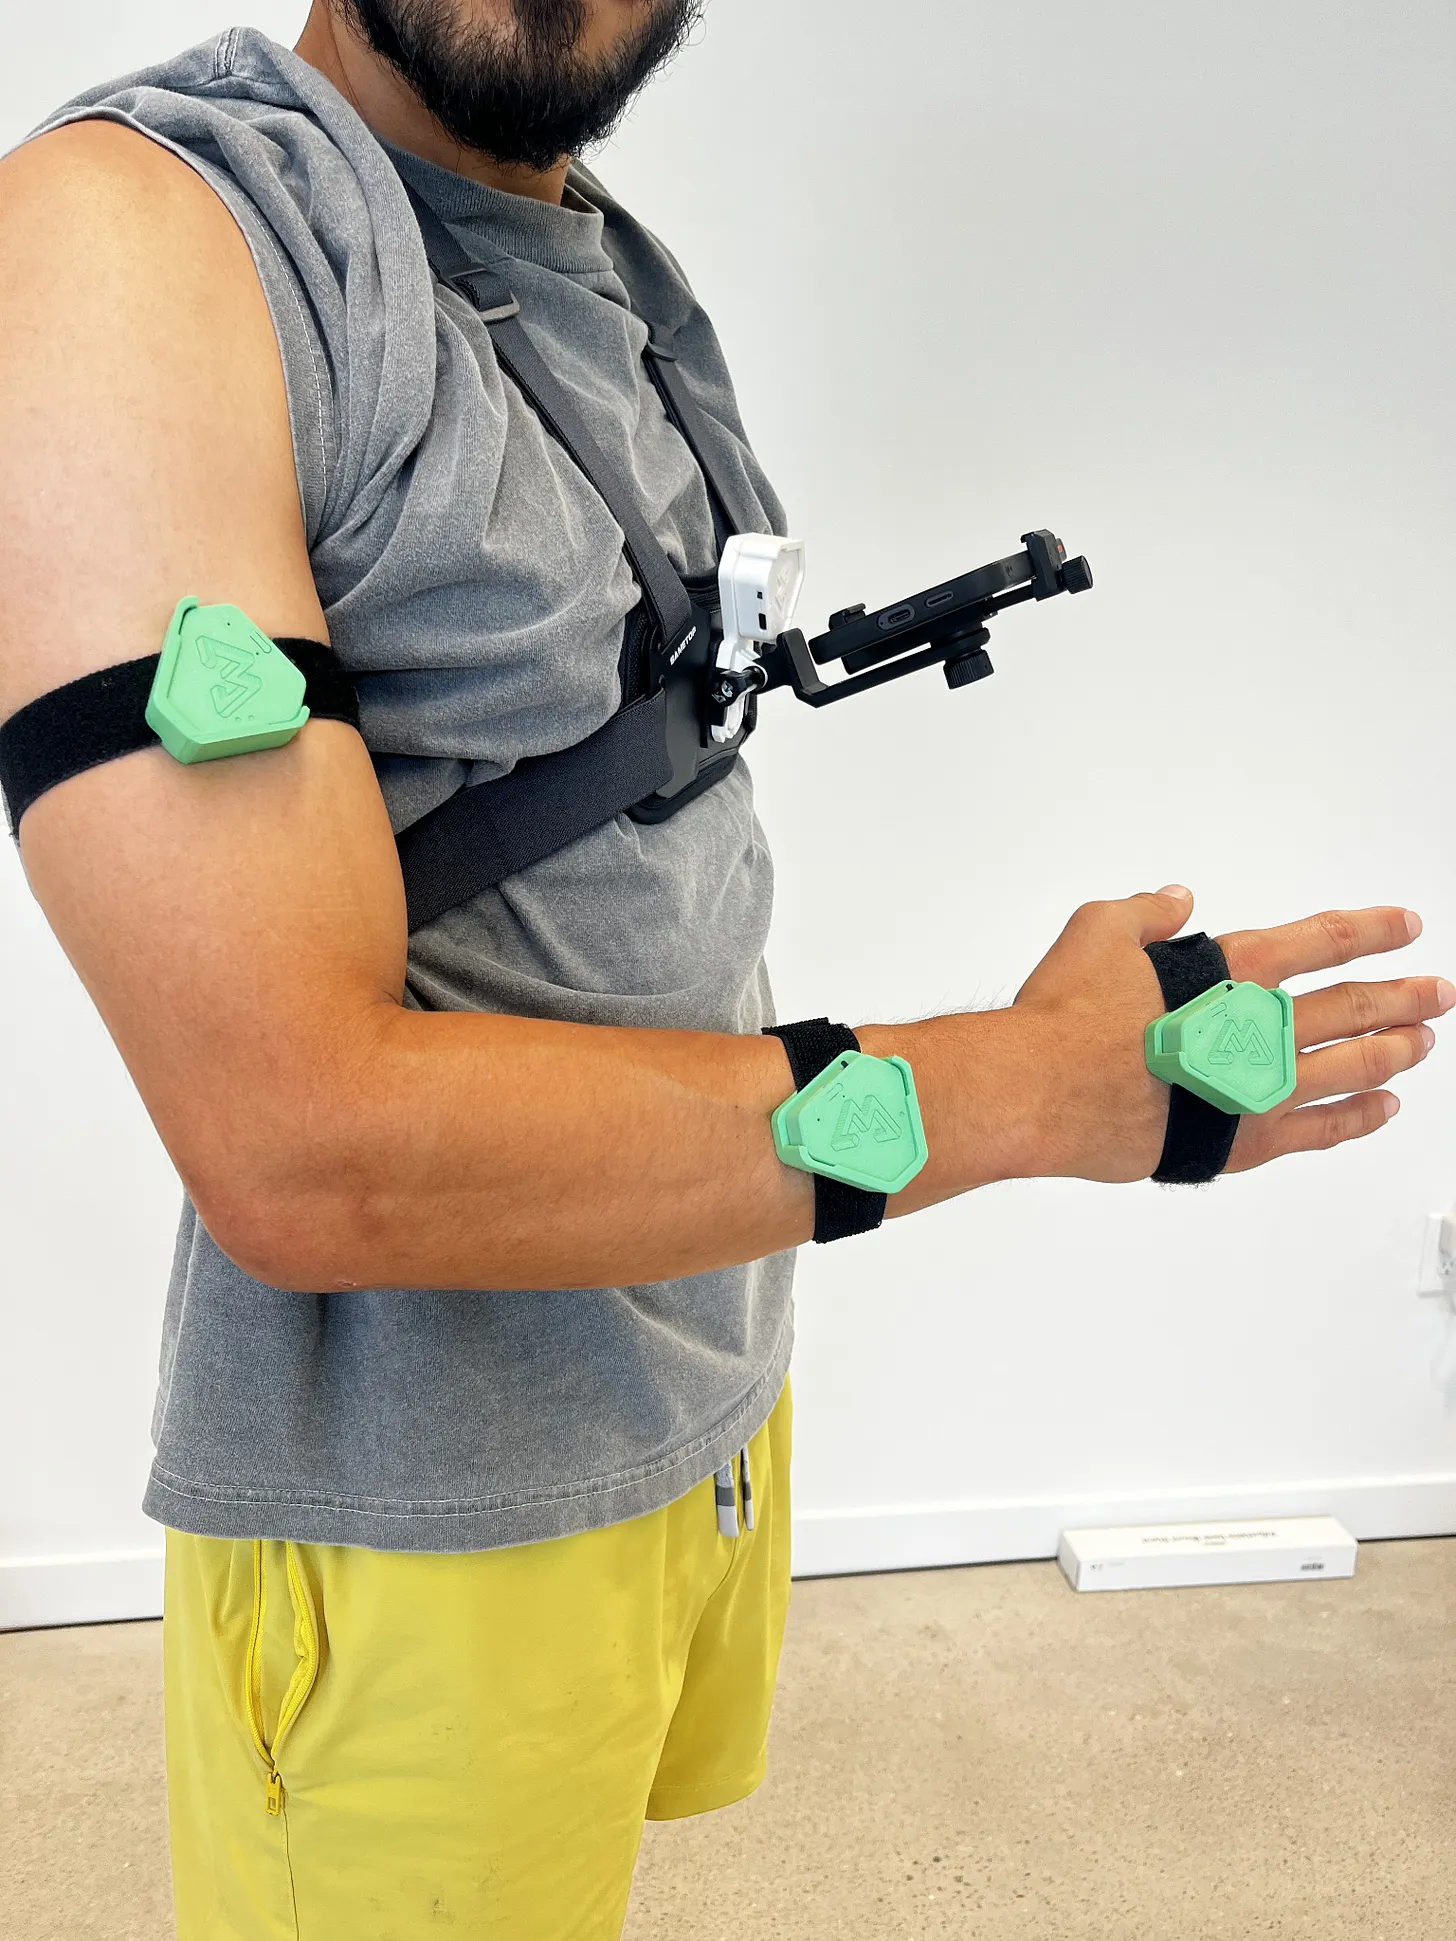
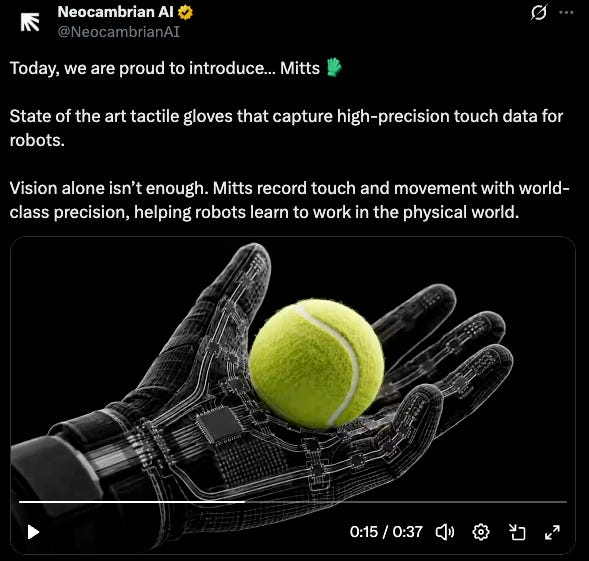
Дополнительные датчики. Закрывшийся стартап Eidon AI крепил датчики на руки, чтобы записывать положение суставов. Neocambrian AI анонсировала Mitts — тактильные перчатки, которые с высокой точностью записывают данные о прикосновениях.
UMI (Universal Manipulation Interface) — ручные манипуляторы с камерами и захватом-«клешнёй» (бывают и многопалые). Человек работает ими так, как работал бы робот, и видео потом идёт на обучение роботов с похожими захватами. В основном так собирают данные Generalist AI и Sunday Robotics.
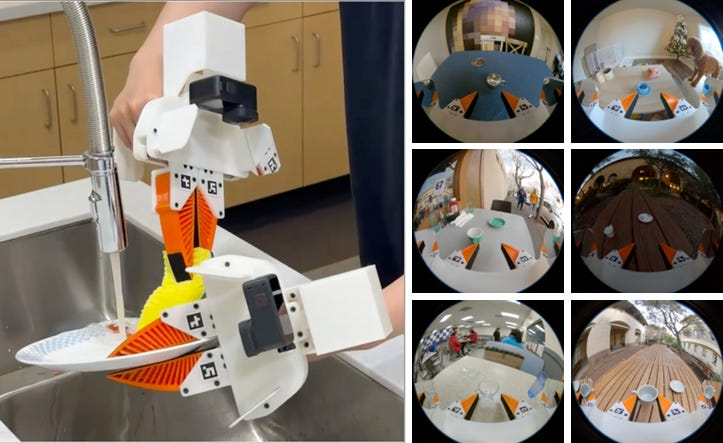
Плюсы: гораздо дешевле телеуправления, потому что нужна камера, а не робот. Проще набрать разнообразные задачи. Физика реальная, а не смоделированная.
Минус: человек не робот, и его движения не полностью совпадают с возможностями машины. У UMI это расхождение минимально. Модели, стоящие за многими из самых впечатляющих демо (например, у Generalist AI), обучены именно на таких данных.
Видео из интернета и комбинации подходов
Модели Vision-Language-Action (VLA) строятся на основе моделей Vision-Language, обученных на текстах и изображениях. Роликов на YouTube и TikTok огромное количество, поэтому многие ищут способ учить роботов и на них. Например, Nvidia Cosmos — фундаментальная модель, обученная именно на таких видео. Её можно использовать как основу (backbone) для модели управления роботом.
На практике подходы комбинируют. Digit от Agility Robotics ходит с помощью небольшой нейросети на 1 млн параметров, обученной с подкреплением в симуляции. Манипуляциям его, судя по всему, учили клонированием поведения. Dyna Robotics, похоже, сочетала симуляцию и видео с людьми.
Способ | Сильные стороны | Слабые стороны |
|---|---|---|
Телеуправление | Данные точно под конкретного робота | Дорого, плохо масштабируется, нет тактильной обратной связи |
Реальные роботы | Потенциально самый большой источник | Роботов мало, данные однообразны |
Симуляция | Дёшево, быстро, легко масштабируется | Sim-to-real gap, особенно в манипуляции |
Запись людей (видео, перчатки, UMI) | Дёшево, разнообразно, реальная физика | Движения человека не совпадают с движениями робота |
Видео из интернета | Огромный объём | Способы его использовать ещё ищут |
Сколько данных уже собрано
Датасеты для роботов растут:
Open X-Embodiment (Google DeepMind, 2023) собран из нескольких десятков датасетов: более 1 млн траекторий, свыше 160 000 задач, около 4000 часов;
Pi 0 (Physical Intelligence, октябрь 2024) обучен на 10 000 часах данных роботов;
GEN 1 (Generalist AI, 2026) обучен примерно на 500 000 часах данных UMI;
Dyna Robotics и Nature Will заявляют о более чем 1 млн часов видео от первого лица;
Figure AI через Index собирает 30 минут видео каждую секунду, это 43 000 часов в сутки.
По одной из оценок, вся индустрия вместе собирает около 500 000 часов обучающих данных в месяц.
Почему сравнивать с текстом сложно
Во-первых, данные неравноценны. Записи телеуправления и UMI ценнее простого видео от первого лица, а разнообразный датасет полезнее однообразного. Во-вторых, видео информационно беднее текста, потому что соседние кадры почти одинаковы. Робототехник Крис Пакстон (Chris Paxton) отмечает: чем ближе обучающая выборка к независимой и одинаково распределённой (iid), тем лучше работает машинное обучение. Материалы из интернета этому идеалу не вполне соответствуют, а записи с роботов — тем более.
Разрыв в 100 000 лет
Грубо сравнить всё-таки можно. Исследователь Physical Intelligence Кевин Блэк и профессор робототехники Кен Голдберг предлагают пересчитать текстовые датасеты в часы, которые понадобились бы человеку, чтобы их прочитать:
Датасет или модель | Год | Тип данных | Тыс. часов |
|---|---|---|---|
OXE | 2023 | Роботы: телеуправление + автономная работа | 4 |
Pi 0 | 2024 | Роботы: телеуправление | 10 |
GPT-1 | 2018 | LLM | 69 |
GPT-2 | 2019 | LLM | 475 |
GEN 1 | 2026 | Роботы: UMI | 500 |
Dyna-2 | 2026 | Роботы: видео от первого лица | 1 000 |
Natura-1 | 2026 | Роботы: видео от первого лица | 1 000 |
GPT-3 | 2020 | LLM | 26 000 |
GPT-4 | 2023 | LLM | 685 000 |
Крупнейшие датасеты для роботов насчитывают около 1 млн часов. Выходит, даже модели нескольколетней давности получили примерно в 1000 раз больше данных. Голдберг называет это «разрывом в 100 000 лет».
Пакстон в блоге «It Can Think!» заходит с другой стороны: переводит часы видео в токены. Вывод получается похожим:
10 кадров/с × 3600 с  = 36 000 токенов в час (1 кадр ≈ 1 полезный токен)
36 000 / 10           ≈ 3 600 токенов в час (полезна не каждая секунда)
1 млн часов × 3 600   ≈ 3,6 млрд токенов
Это примерно в 5000 раз меньше, чем датасеты современных ИИ-моделей.
Во сколько обойдётся догнать LLM
Допустим, данных нужно в 1000 раз больше, чем есть сейчас, то есть порядка 1 млрд часов. Стоимость одного часа:
Eidon AI: $60-100;
Pantheon: $60-150 за час данных UMI, но её инженеры построили конвейер, который снижает цену до $10;
Стартап Shift, который собирает видео от первого лица, платит исполнителям до $20 в час.
По наивной оценке, чтобы вывести модели для роботов на уровень недавних LLM, понадобится $10-100 млрд.
А может, столько и не нужно?
Есть аргументы за то, что данных потребуется меньше:
если роботу не нужна универсальность и он должен уметь выполнять лишь конкретные задачи, требования к данным будут гораздо скромнее;
передовые универсальные модели вроде Fable или Astra, возможно, смогут отлично управлять роботами, получив сравнительно немного данных о роботах (некоторые уже предсказывают, что специализированные модели для роботов уступят им место);
могут появиться архитектуры с более высокой эффективностью по выборке (sample efficiency), которые извлекают больше из каждого примера.
Есть и аргументы за то, что данных потребуется больше:
в тексте мелкая ошибка вроде опечатки не портит результат целиком, а в физическом мире крошечная ошибка позиционирования отделяет успех от полного провала;
Кен Голдберг считает движение робота задачей гораздо большей размерности, чем генерация текста. Похожую мысль высказывают и другие робототехники.
LLM показали, что масштаб работает: чем крупнее модель и чем больше данных и вычислений, тем лучше результат. Теперь робототехника проверяет, сработает ли этот рецепт и для неё. Пока ставка сделана на данные. Компании собирают их всеми доступными способами в надежде увидеть у роботов те же закономерности, что и у языковых моделей.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.