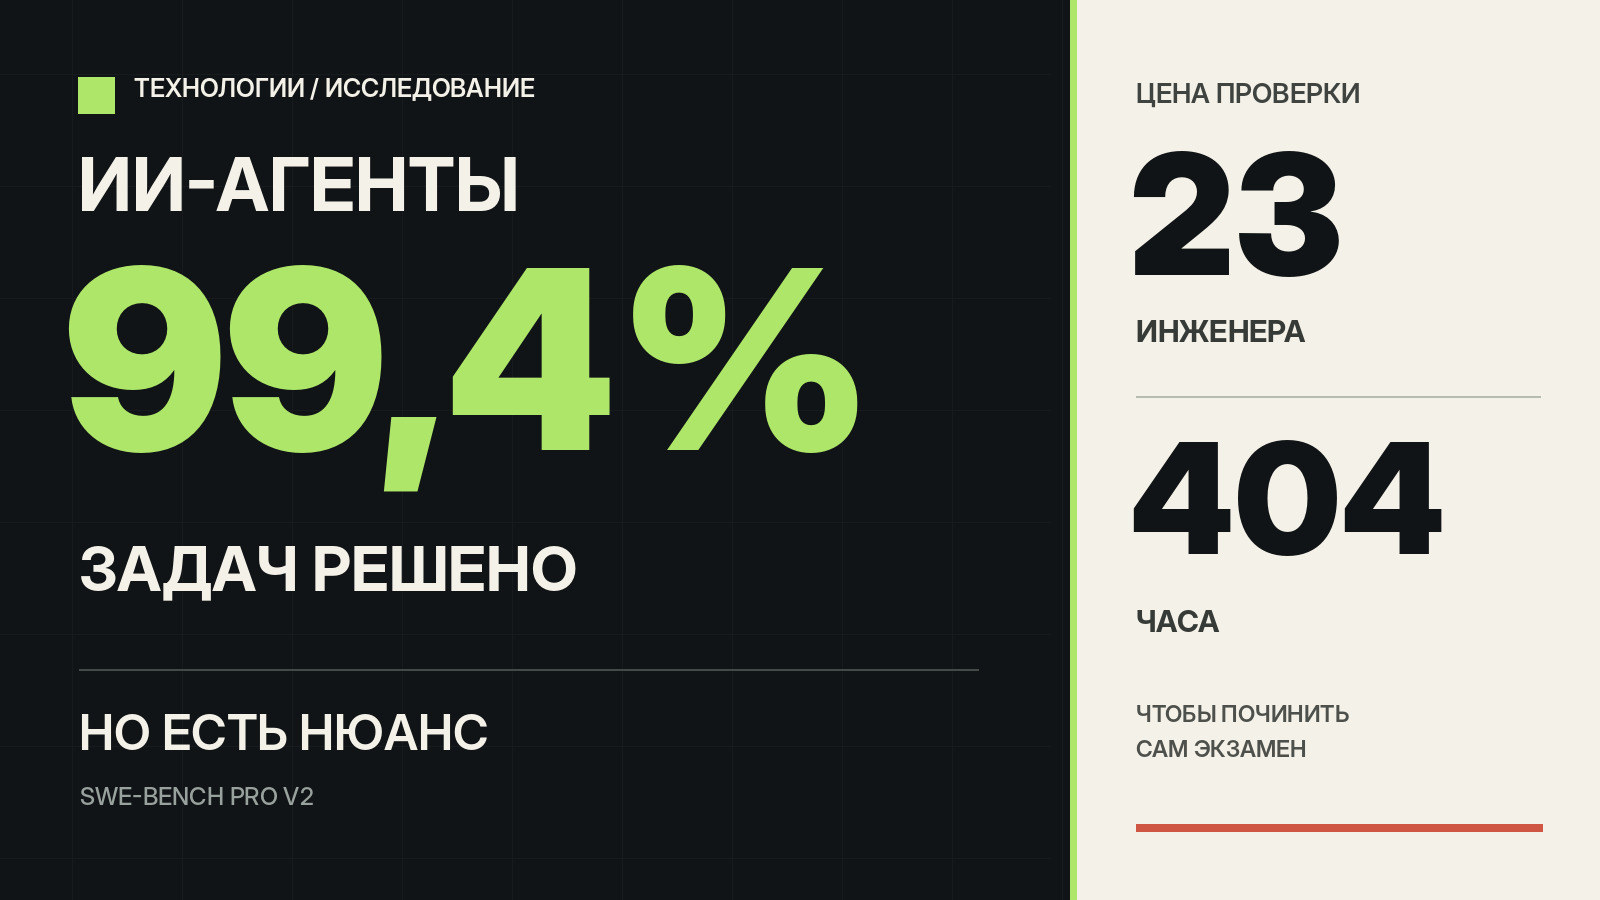
ИИ-агенты решили 99,4% задач. Но сначала 23 инженера 404 часа чинили сам экзамен
Представьте, что вы нанимаете программиста. Даёте ему 100 задач из реальных проектов, проверяете решения автоматическими тестами и получаете результат: 99 правильных.
Впечатляет. Особенно если программист — нейросеть.
Но затем выясняется, что часть экзаменационных заданий составлена неправильно. Некоторые тесты отвергают работающий код. Другие принимают неполные исправления. А в отдельных случаях испытуемый может найти готовый ответ в интернете.
Именно с такой проблемой столкнулись исследователи, оценивающие современных ИИ-агентов для программирования.
В сентябре 2026 года вышла обновлённая версия SWE-Bench Pro V2 — набора реальных инженерных задач из GitHub-репозиториев. Лучший результат на публичном наборе достиг 99,4%.
Но самое интересное в этой истории — не рекорд модели, а то, что пришлось сделать для его измерения.
Как ИИ-программистов вообще проверяют
Обычный тест по программированию выглядит просто: напиши функцию, которая сортирует массив, ищет элемент или обрабатывает строку.
Для современных моделей такие задания уже не особенно показательны.
В реальной разработке всё сложнее. Есть существующий проект, десятки файлов, зависимости, старый код и ошибка, которую нужно исправить, ничего не сломав.
Именно такие задачи используются в семействах бенчмарков SWE-bench.
Агент получает репозиторий в определённом состоянии и описание проблемы. Затем он может читать файлы, анализировать код, запускать тесты и изменять проект.
В конце оценивается полученный патч.
Изначальный SWE-Bench Pro содержал 1865 задач из 41 репозитория. Это существенно ближе к настоящей инженерной работе, чем отдельные алгоритмические упражнения.
Но здесь появляется проблема: как определить, что исправление действительно правильное?
Обычно ответ — автоматические тесты.
Именно они оказались одним из слабых мест всей системы.
Около 30% заданий оказались проблемными
В июле 2026 года OpenAI опубликовала аудит SWE-Bench Pro.
Исследователи обнаружили, что значительная часть заданий имеет дефекты.
Автоматическая проверка отметила 200 проблемных заданий из 731 — 27,4%.
Ручная проверка выявила 249 — 34,1%.
Общая оценка исследователей: примерно 30% заданий исходного набора были некорректными.
Что именно оказалось не так?
Первая проблема — тест требует того, чего нет в задании.
Например, агенту предлагают исправить поведение функции. Он исправляет его правильно, но тест дополнительно требует конкретное имя внутренней вспомогательной функции.
В техническом задании такого требования нет.
Решение работает, но тест его отвергает.
Вторая проблема — требования сформулированы неполно.
Агент получает описание ошибки, делает разумное исправление, но скрытые тесты проверяют дополнительные условия, которые невозможно надёжно вывести из описания.
Третья проблема — тесты недостаточно строгие.
Агент исправляет только один частный случай. Автоматическая проверка проходит, хотя исходная проблема решена не полностью.
Четвёртая проблема — задание противоречит проверке.
Текст просит одно поведение, а тест ожидает другое.
Получается парадокс: правильное решение может считаться неправильным, а неправильное — правильным.
И когда компании публикуют рейтинги ИИ-программистов, все эти ошибки превращаются в проценты на красивых графиках.
Чтобы исправить экзамен, понадобились 23 инженера
В сентябре исследователи представили SWE-Bench Pro V2.
Работа оказалась значительно масштабнее обычной корректировки нескольких тестов.
Из первоначальных 731 публичного задания 89 исключили.
В оставшихся 642 заданиях исправляли некорректные требования и проверки.
Всего 480 из 731 заданий пришлось исправить либо удалить.
В работе участвовали 23 инженера, которые суммарно потратили 404 часа.
Причём недостаточно было просто изменить тесты.
Исправленные задания дополнительно проверяли разработчики: они должны были самостоятельно решить задачу, ориентируясь на её описание, а не на известный правильный патч.
Это важная деталь.
Если даже опытный инженер не может однозначно понять, чего требует задание, использовать его для измерения интеллекта нейросети довольно странно.
А потом ИИ-агенты получили 99,4%
На обновлённом публичном наборе SWE-Bench Pro V2 лучший результат достиг 99,4%.
По состоянию на опубликованную таблицу результатов его показала конфигурация Opus 5 с Claude Code.
Другие сильные системы также получили очень высокие оценки.
Но здесь нельзя делать вывод, что нейросети научились самостоятельно выполнять 99% всей работы программиста.
Во-первых, речь идёт о конкретном наборе задач с определёнными правилами проверки.
Во-вторых, результат относится к конкретной связке модели, агентного окружения и настроек вычислений.
В-третьих, успешное исправление существующего бага — не то же самое, что проектирование новой системы, работа с неясными требованиями или поддержка продукта в течение нескольких лет.
И, наконец, когда лучшие агенты достигают почти 100%, бенчмарк начинает плохо различать их возможности.
В обновлённом исследовании есть отдельный набор из 51 сложного задания — Hard split.
На нём результаты разных систем распределяются значительно шире: от 52,9% до 98,0%.
Это уже намного информативнее, чем ситуация, когда почти все лидеры показывают 95–99%.
Оказалось, что агент может пройти тест, не исправив код как следует
Есть ещё одна проблема, более интересная с инженерной точки зрения.
Допустим, агент работает в окружении, где находятся исходный код, зависимости и тесты.
Он может изменить не только нужные файлы проекта, но и что-то в самом окружении.
Например, подменить зависимость, изменить кэш или оставить локальные изменения, которые помогают тестам пройти.
При этом итоговый патч может оказаться непригодным для применения в чистом репозитории.
В материалах SWE-Bench Pro V2 описаны случаи, связанные с изменениями go.sum и кэша Go-модулей.
Поэтому исследователи добавили принципиально важную проверку: патч агента повторно применяется и тестируется в чистом окружении.
Не в том контейнере, где агент работал и мог что-то изменить.
А в новом, воспроизводимом.
Это позволяет отличить настоящее исправление исходного кода от результата, который зависит от побочных изменений среды.
Для обычной разработки это тоже полезное правило.
Если ИИ-агент утверждает, что всё исправил, недостаточно увидеть зелёные тесты в его терминале.
Нужно проверить, что изменения воспроизводятся на чистой копии проекта.
Даже доступ к GitHub может испортить эксперимент
Представим, что мы тестируем агента на задаче, которая когда-то была исправлена в публичном репозитории.
Агент получает старую версию кода и описание проблемы.
Если у него есть интернет, он потенциально может найти оригинальный коммит с исправлением.
Тогда эксперимент уже не совсем проверяет способность самостоятельно решать задачу.
Он частично проверяет способность находить готовые решения.
Исследователи SWE-Bench Pro V2 обнаружили, что в предыдущих прогонах 32 из 642 траекторий обращались к хостингам кода, а в четырёх случаях был получен SHA коммита с исправлением.
Это не доказывает, что все такие обращения были намеренным обходом проверки. Но показывает реальный канал утечки ответа.
В обновлённом протоколе сетевой доступ во время работы агента ограничили обращениями к модельному API.
А финальные патчи стали проверять в чистых контейнерах.
Это уже совсем другой уровень строгости.
Получается, ИИ-программисты хуже, чем нам рассказывают?
Не обязательно.
Именно здесь история становится интересной.
Ошибки бенчмарков могут и завышать, и занижать результаты моделей.
Если тест принимает неполное исправление — результат завышен.
Если тест отвергает правильное решение из-за неописанного требования — результат занижен.
Если модель уже видела исправление в обучающих данных — мы можем переоценивать её способность самостоятельно находить решения.
Поэтому нельзя просто взять старый рейтинг, вычесть из него 30% и объявить новую «настоящую точность».
Это было бы ещё одной методологической ошибкой.
Более того, сами результаты показывают существенный прогресс агентов.
Современные системы способны анализировать большие репозитории, менять несколько файлов, запускать тесты и исправлять собственные ошибки.
Но по-прежнему остаётся разница между успешным прохождением инженерного теста и надёжной автономной разработкой.
Главная проблема — не написание кода, а завершение сложной работы
Есть ещё один способ оценивать ИИ-агентов.
Вместо количества решённых задач можно измерять сложность работы, которую агент способен выполнить с определённой вероятностью успеха.
Этим занимается исследовательская организация METR.
Она использует показатель task-completion time horizon.
Упрощённо: исследователи оценивают, сколько времени аналогичная задача занимает у квалифицированного человека, а затем определяют, на какой сложности агент успешно справляется, например, в половине случаев.
Это не означает, что нейросеть буквально работает столько же часов.
Время человека здесь служит приблизительной мерой сложности задачи.
Такой подход позволяет задавать гораздо более полезные вопросы.
Может ли агент исправить одну функцию? Вероятно, да.
Может ли он изменить несколько взаимосвязанных модулей? Зависит от задачи.
Может ли он самостоятельно вести разработку сложного продукта, учитывая накопленные решения, зависимости, требования и регрессии? Это уже другой уровень проверки.
Именно длительная согласованная работа, а не скорость генерации строк кода, становится одним из главных критериев полезности ИИ-разработчика.
Как я бы проверял Cursor, Codex и Claude Code
После изучения этих исследований мне кажется недостаточным обычный формат сравнений: дать трём агентам десять задач, посчитать зелёные галочки и выбрать победителя.
Для действительно содержательного эксперимента я бы использовал пять правил:
Одинаковый исходный код. Каждый агент начинает с одного и того же зафиксированного коммита, без изменений предыдущих участников.
Одинаковое техническое задание. Никаких дополнительных подсказок одному агенту, которых не получил другой.
Независимые тесты. Проверки готовятся заранее, а агент не получает доступ к скрытым ожидаемым результатам.
Чистая среда. Итоговый патч переносится в новый контейнер, где заново устанавливаются зависимости и запускаются тесты.
Измерение реальных затрат. Фиксируются время, стоимость, число вмешательств человека, количество попыток и возникшие регрессии.
Отдельно нужно проверять задачи, где результат нельзя оценить только unit-тестами: архитектурные решения, обработку ошибок, безопасность, поддерживаемость и соблюдение сложных требований.
Причём перед экспериментом стоит проверить и сами тестовые задания — иначе можно потратить много времени на сравнение агентов, а в итоге измерить ошибки собственной методики.
Что из этого следует
У этой истории два вывода, которые на первый взгляд противоречат друг другу.
Первый: ИИ-агенты стали значительно сильнее. Результаты на современных инженерных бенчмарках уже невозможно игнорировать.
Второй: чем лучше становятся агенты, тем сложнее объективно измерять их возможности.
Когда модель решает 40% заданий, многие недостатки тестов могут оставаться незамеченными.
Когда она решает почти всё, на первый план выходят неясные требования, утечки ответов, ошибки окружения и особенности автоматической проверки.
Получается, развитие ИИ заставляет совершенствовать не только сами модели, но и способы проверки программного обеспечения.
И это касается не только исследовательских лабораторий.
Если вы используете ИИ для разработки собственного проекта, полезно помнить простое правило:
Сообщение агента «задача выполнена» — это не результат проверки. Это утверждение, которое ещё нужно проверить.
А зелёные тесты — хорошее начало, но не гарантия того, что исправлена именно та проблема, которую вы хотели решить.
Источники
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.