Chaos Engineering для тех, кто в гробу его видал
Всем привет! Я Лев Алимов, техлид платформы хаос-тестирования Storm. Моя работа считается хорошо выполненной, если где-то с моей помощью чей-то production прилег. Эта статья о том, как мы в T-Банке развивали Chaos Engineering, когда в него особо никто не верил.
Расскажу про Chaos Engineering как практику, зачем она нужна, из каких шагов состоит. Приложу ее к разным уровням зрелости команд и компаний, покажу, на каких этапах она действительно нужна. В конце расскажу, как практика Chaos Engineering зарождалась в Т-Банке, что мы делали, чтобы этот маховик раскрутился, какую пользу от этого получаем и какие метрики считаем.
Что такое хаос-инжиниринг
Сам Chaos Engineering — практика, состоящая из четырех шагов.
Шаг 1. Определяем для приложения нормальное операционное состояние и какие значения метрик ему соответствуют.
Шаг 2. Строим гипотезу: предполагаем, что если мы сломаем какой-то элемент окружения приложения, то стабильное состояние или сохранится, или отклонится на ожидаемое значение.
Шаг 3. В контролируемых условиях ломаем окружение в соответствии с гипотезой и смотрим, сошлись ожидания с реальностью или нет.
Шаг 4. Создаем задачку на повышение устойчивости приложения и фиксим, если ожидания не сошлись с реальностью.
Кажется, что это очень похоже на обычную поддержку приложений в проде. Мы изначально предполагаем, что приложение всегда будет работать. Когда оно ломается, мы пишем постмортем и готовим исправления.
Но сервисы живут не в вакууме. Вокруг них — куча различных движущихся частей. Они работают на каких-то кластерах, под кластерами есть какое-то железо. Ноды кластеров общаются по какой-то сети. На уровне приложения есть интеграции, базы данных, кэши.
И, поскольку стопроцентная доступность недостижима, рано или поздно вокруг сервиса сломается буквально все. А Chaos Engineering позволяет получить контроль над тем, что происходит с нашим приложением в момент, когда что-то ломается. Мы заранее собираем всех инженеров, что-то умышленно ломаем и имеем возможность в любой момент прекратить сбой на окружении, если мы сами этот инцидент устроили.
Если происходит органический сбой, мы не можем пойти к интеграции и сказать: «Прекрати, пожалуйста, ломаться, у нас в сервисе что-то не по плану пошло». А через регулярное проведение хаос-экспериментов команды узнают, как приложение ведет себя в условиях внешней нестабильности. И чем больше и чаще мы проводим эти эксперименты, тем меньше команды боятся «дышать» на прод.
Когда в крупной компании с развитой инфраструктурой происходит большой инцидент, собирают созвон на несколько сотен человек. Они сидят, придумывают, что делать, а потом очень-очень долго собираются с духом, чтобы перейти к активным действиям. Потому что мало кто знает, что на самом деле произойдет с соседними сервисами, если один перезапустить. Через Chaos Engineering можно наращивать эти знания и снимать с инженеров боязнь что-то пошатать, потому что после хаос-тестов они точно знают, что будет.
В терминальной стадии развития Chaos Engineering мы можем укоренить в сознании всех причастных к разработке мысль, что все везде постоянно ломается. А значит, строить и писать системы нужно с расчетом на сбои и отказы.
Когда и кому нужен хаос-инжиниринг
При кажущейся пользе Chaos Engineering нужен не всем. Каждая команда, каждая компания проходят через этапы зрелости своих подходов к надежности. Важно отметить, что перечисленные этапы становления команд даны как ориентир. Это не общепринятая классификация.
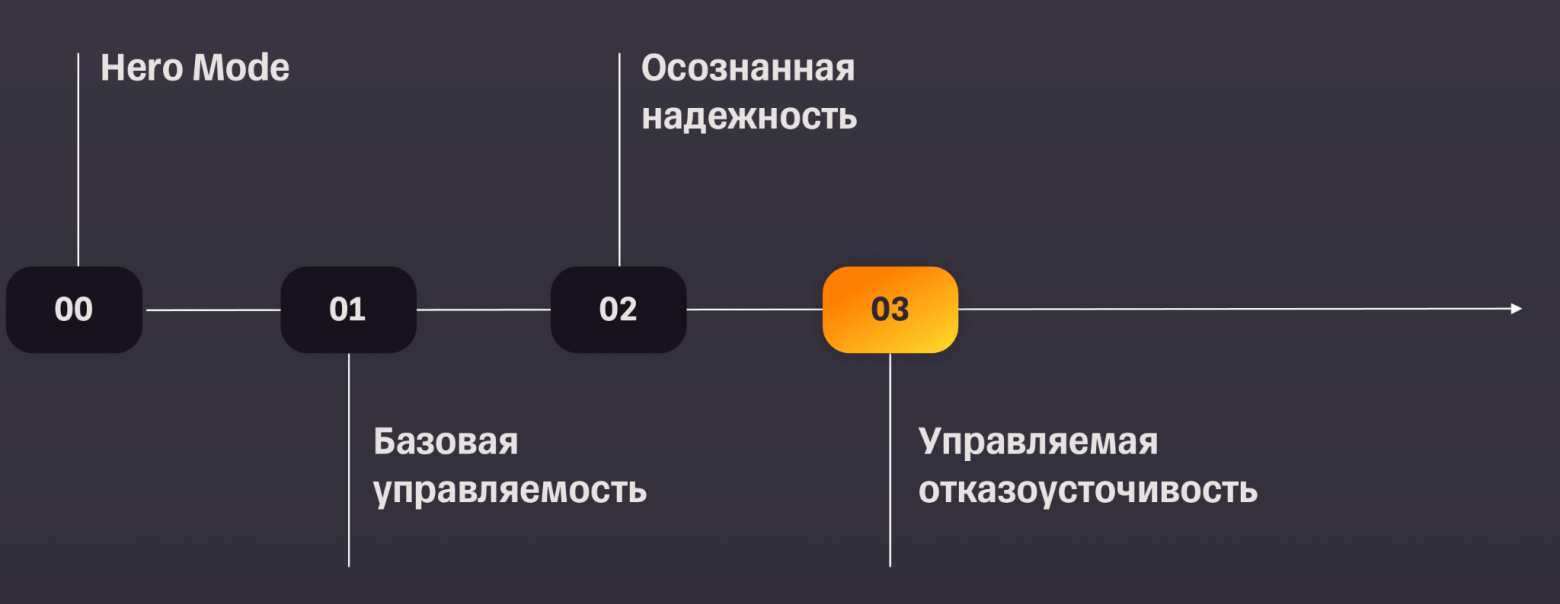
Первый этап — героический режим, когда команда пилит фичи как не в себя и живет в режиме «все в огне». Обычно на этом уровне зрелости доступность держится на одном-двух людях, которые знают, что и где нужно поправить или перезапустить, чтобы все поднялось. Нет показателей и целей по доступности сервиса с точки зрения пользователей — всех этих SLO и SLI.
Мониторинг, как правило, только технический: загрузка CPU, утилизация сети, недостаток оперативной памяти. Этот мониторинг не отвечает на вопросы о том, как пользователь себя чувствует при работе с приложением. Каналы с алертами замьючены, потому что туда валится куча всякого шума, который не имеет отношения к действительно происходящим в production сбоям.
Настоящие алерты приходят через чаты поддержки. Пользователи сообщают, что у них что-то не работает, и команда как-то это чинит. На данном уровне развития подходов к надежности Chaos Engineering не нужен, он сломает и без того хрупкую систему. Получится игра в зрелость вместо разбора реального техдолга. Команда не понимает, как клиенты ощущают себя при работе с приложением, не наблюдает за услугами. Даже если они будут проводить хаос-эксперименты, они не смогут оценить результат. Если пользователя в момент эксперимента не было, кто скажет, что что-то сломалось? А своего мониторинга у проекта еще нет.
Лучше сосредоточиться на том, чтобы чинить то, что сломано — наверняка в бэклоге на данном этапе куча таких задач. И тащить метрики и алерты на пользовательские сценарии, а не на технические показатели.
Второй этап — команда растет, развивается, появляется базовая управляемость. С точки зрения надежности начинается переход от танцев с бубном в сторону инженерных практик. В проекте появляются метрики и борды по критичным операциям пользователей, мониторинг становится ближе к пользовательским сценариям. Появляется классификация по инцидентам. Релизы и откаты больше не ломают прод каждую пятницу. И команда узнает о проблемах раньше пользователей благодаря вменяемым механизмам оповещения и наблюдаемости. В этом случае Chaos Engineering становится уже точечно уместен.
Вероятно, это будут какие-то эксперименты в стейдже, на preprod-окружении. Можно использовать инструменты Chaos Engineering для проведения учений, учить инженеров реагировать на инциденты. Гипотезы, как правило, будут единичные, про отдельные компоненты и отдельные их интеграции. Чаще всего это будут попытки изучить поведение в образовательных целях.
Важная оговорка: если бэклог вопросов к надежности и так переполнен, то некому и некогда влезать в хаос-инжиниринг. Соответственно, и делать это не нужно.
По мере развития команда приходит к третьему этапу — более осознанному подходу к надежности. Заводят индикаторы уровня сервиса, цели по этим индикаторам, показатели доступности, понятие бюджета ошибок. Инциденты начинают разбирать системно: пишут постмортем и создают задачи на исправление, даже иногда доводят до статуса done. На уровне технички и сервисов появляется изоляция некритичных систем.
Понятно, что на этом этапе уже есть инцидент-менеджмент. И здесь Chaos Engineering достаточно сильно помогает увидеть реальную отказоустойчивость сервисов, а не ту, которую архитектор или аналитик пообещал в корпоративной вики.
Можно проверять, насколько хорошо работает резервная логика и плавная деградация. Потому что механики отказоустойчивости пишут люди, а люди иногда ошибаются. И не всегда в production все работает именно так, как было задумано. Тут уже можно оценивать адекватность алертов. Иногда бывают слишком длинные пороги срабатывания для защиты от false positive срабатываний. Иногда — опечатки в самих выражениях для алертов или каналах доставки: алерт вроде бы сработал, но не пришел. Или пришел не туда.
На данном этапе системы разрастаются, появляются микросервисные истории, скрытые зависимости, о которых никто не знал. Замедлилось в одном углу → развалилось в другом. Появляется возможность изучать поведение не только отдельных компонентов, но и комплексных систем, чтобы дать команде знание, как система себя ведет в условиях недоступности.
Важная оговорка. Не стоит инвестировать в Chaos Engineering и тратить ресурсы, если у приложения или системы дешевый даунтайм. Если сервис может полежать спокойно недельку и ничего плохого не произойдет, денег компания не потеряет, то нет смысла тщательно его тестировать. Бывают простые сервисы, у которых либо вообще нет интеграции, либо есть одна-две, и всем предельно очевидно, как именно они сломаются.
В монолитах сложные сценарии дешевле и проще проверить с помощью тестов, а не хаос-практик и умышленных экспериментов с продом. Наконец, если у команды очень мало инженерных ресурсов и есть более выгодные направления с точки зрения доступности, лучше вложиться именно в них, потому что сам по себе Chaos Engineering — это практика недешевая.
Четвертый этап: команда или компания развивает подходы к надежности и приходит к тому, что надежность становится частью инженерной культуры. Она плотно вкручена во все процессы и в головы разработчиков. Бюджет ошибок уже не просто существует, а действительно влияет на принятие решений, на то, как быстро они катят релизы, на приоритизацию задач из техдолга.
Отказы учитываются в архитектуре как нечто нормальное, к чему нужно готовиться и вокруг чего нужно написать код, чтобы системы были устойчивы. Как правило, уже есть достаточно гибкие возможности по балансировке трафика и доступны канареечные релизы.
Исправления из постмортемов не просто появляются в бэклоге, а достаточно быстро попадают в прод, потому что, повторюсь, бюджет ошибок не просто есть, а влияет на приоритизацию. Стоимость даунтайма начинают считать либо глобально, либо на уровне отдельной команды.
Здесь Chaos Engineering становится обязательной практикой, потому что позволяет изучать взаимодействие внутри сложных распределенных систем в условиях отказов. С помощью Chaos Engineering можно контролируемо имитировать редкие и потенциально разрушительные сбои, которые, если бы произошли органически, смогли бы привести к катастрофическим потерям.
Механизмы отказоустойчивости в распределенных системах не действуют на уровне одного компонента, они становятся сквозными, и иногда то, что отлично работает на одном компоненте, укладывает систему. Chaos Engineering помогает наглядно показать командам ту самую разницу между одним конкретным компонентом и всей распределенной системой в комплексе.
В конечном итоге по мере развития Chaos Engineering команда приходит к тому уровню просветления, когда отказоустойчивость становится базовым паттерном в голове всех причастных к разработке и все системы проектируются и пишутся с учетом того, что все вокруг может разваливаться, но пользователи не должны об этом знать.
Хаос в Т-Банке
В момент первых шагов в сторону Chaos Engineering у нас уже были достаточно зрелые подходы к отказоустойчивости. Все клиентские услуги так или иначе инвентаризованы, замониторены, все понятное было обмазано алертами, ранбуками, были метрики и дашборды по пользовательским операциям. Бюджет ошибок у нас не просто был, а действительно влиял на принятие решений. Результаты постмортемов, все решения, которые появлялись в результате разбора инцидентов, очень быстро оказывались в production.
Проблема была в том, что все понятное-то мы обмазали алертами, ранбуками, замониторили, все прекрасно, но инциденты случались вокруг того, о чем мы даже подумать не могли. И каждый следующий постмортем, каждая задача на повышение устойчивости стоила нам потерянных денег. Больших денег.
В то время практики Chaos Engineering в компании не было. Были единичные кейсы в некоторых командах, но глобально мало кто понимал пользу Chaos Engineering и то, как им пользоваться. В общем, в Chaos Engineering мало кто верил.
Мы небольшой группой инициативных людей верили, что Chaos Engineering как минимум поможет нам проверять очевидные вещи. Был достаточно заметный класс проблем: после сбоя провели пост-анализ, что-то решили, готовый патч протестировали на синтетическом трафике, и вроде бы все классно. А при следующем сбое оказывается, что какой-то фактор не продумали, и начинается второй круг допиливания. Мы хотели получить возможность контролировать и лечить хотя бы это.
Мы знали и описали, как работает каждый отдельный компонент, но понять, как они работают в комплексе, оказалось сложнее. И тут очень важно стало изучить поведение комплексных систем при отказах.
Так мы решили, что практику Chaos Engineering надо катить в массы. Чтобы начать, нужно было дать попробовать. Наша гипотеза была в том, что команды попробуют, найдут способы повышения устойчивости для себя, поймут, насколько это контролируемо, безопасно и выгодно в сравнении с органическими сбоями.
Чтобы провести эксперимент, надо было договориться с несколькими командами: «Вот у тебя есть сервис, у тебя есть пара интеграций. Ты идешь в две другие команды, говоришь им, чтобы они отключили. Договариваешься в своей, назначаешь дежурных, чтобы они посмотрели, как это все произойдет».
В общем, пробовать усилиями трех команд достаточно больно и трудоемко. Инструментов автоматизации, опять же, нет. Ресурсов на проведение подобных экспериментов тоже особо нет, потому что у всех команд свои продуктовые планы, бэклоги перегружены. И вкрутить эту трудоемкую активность с синхронизацией было тяжело.
Но мы верили, что если автоматизировать возможность что-нибудь пошатать, то выделять ресурсы станет не так болезненно, и тогда мы сможем вовлечь намного больше людей в Chaos Engineering как таковой.
Автоматизация хаоса
Первое, что мы сделали, — обратились к открытым решениям. Chaos Engineering не мы придумали. Уже есть и комьюнити-тулы, и готовые практики. Естественно, мы надеялись адаптировать под себя один из опенсорс-инструментов. Среди них есть достаточно зрелые, большие штуковины, которые полностью покрывают весь цикл: и построение гипотез, и «пошатать», и постанализ.
Принесли в платформенную команду: «Вот смотрите, у нас Chaos Mesh, Litmus. Давайте это внедрим в наши рантайм-кластеры». Платформенная команда присмотрелась — это что-то непонятное, инвазивное. Эта штука пускает щупальца глубоко в рантайм, требует административных прав. И отказалась: «Мы как команда, отвечающая за устойчивость, не хотим на себя принимать риски по надежности».
Понятно, что система, которая запускает щупальца во всю инфраструктуру, может так или иначе стать единой точкой отказа для всего банка. Это неприемлемый риск по надежности. А есть еще риски информационной безопасности. Потому что мы банк, мы работаем с деньгами и данными клиентов и не можем просто брать и тащить всякие разные штуки из интернета к себе в контур. Надо провести аудит, убедиться, что внедрение не приведет к масштабной недоступности сервиса, утечке или сбою в платежных системах.
На втором кругу обсуждения мы поняли, что нужен более атомарный, не такой инвазивный инструмент. Взяли инструмент под названием ToxiProxy, попробовали настроить вокруг одного приложения и поняли, что уровень автоматизации достаточно слабенький. Чтобы поднять эту проксю и перенаправить на нее трафик приложения, потребовалось восемь часов рабочего времени. Естественно, с такими вводными хаос у нас бы не полетел.
Так мы поняли, что Chaos Engineering надо сделать продуктом внутри компании, предоставить ценность потребителям и максимально его автоматизировать.
Мы хотели дать возможность запускать инструмент без прав администратора инфраструктуры и проводить эксперименты так, чтобы не договариваться с соседями, только на своем сервисе. Конфигурация должна быть минимальной, а онбординг — быстрым, чтобы сократить путь погружения и документацию до минимально необходимого и достаточного. Потребитель не должен руками делать то, что мы можем автоматизировать, даже если на нашей стороне потребуется вложить недели в разработку этой автоматизации.
Так у нас появился первый Proof of Concept. Появился скриптец, который принимал только три обязательных параметра. Потребителю надо было сказать нам, где живет его приложение. Это Cluster, Namespace, Deployment — других обязательных параметров нет.
Дальше скрипт сам авторизовался в кубе, парсил в конфиге приложение, вытаскивал оттуда все, что так или иначе похоже на внешнюю интеграцию. Из этих данных генерировал конфиг для ToxiProxy, запускал саму проксю, перенаправлял трафик с помощью хост-алиасов для приложения, изменял порты в потребительских конфигурациях, потому что не всегда в кластере можно открыть тот же порт, который изначально был на интеграции. В итоге скрипт генерил для потребителя файлик управления аффектами(англ. affects - влияние), чтобы потребителю не приходилось на основании документации самому его крафтить.
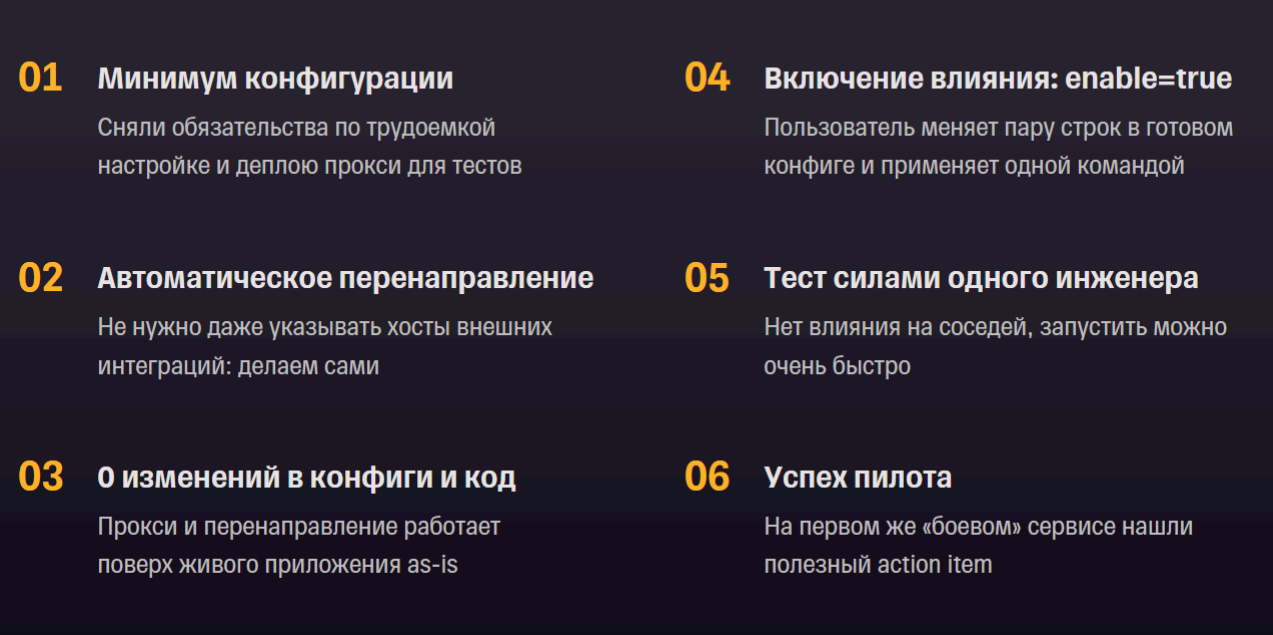
С помощью этого скрипта мы сняли с потребителей обязательства по трудоемкой настройке и деплою прокси в кластеры. Потребителю не нужно было даже говорить, какие именно интеграции он может пошатать в рамках эксперимента. Мы сами выдергивали из конфигов интеграции и готовили инфраструктуру.
Мы запускали проксю поверх приложения как есть. Потребитель не правил конфиги, код приложения, не подключал библиотек. Чтобы включить любой эффект, достаточно в файлике выставить enable в true, и интеграция зашатается. Таким образом, тест можно было провести силами одного инженера, без вовлечения соседних команд.
Первый же пилот на боевом сервисе, который готовился к выходу в прод, помог нам найти точку отказа. Мы замедлили базу на 300 миллисекунд и выяснили, что сервис начинает отвечать на 9 секунд дольше. Пилот был успешен.
Дальше мы написали минимальную документацию из семи простых шагов. Но не стали отбирать у потребителя возможность погрузиться глубже: положили подробную документацию в другие разделы, разложили линки. Кто хотел подробностей — мог получить. Но базово можно разобраться за час. А сам процесс «пошатать», то есть включить latency или timeout, мог занимать 10—15 минут.
Организация процесса
Мы сделали тулзу и написали к ней доку, теперь надо было организационно поддержать это движение. Потребителям нужно было подсказать, как внедрять практику Chaos Engineering, разъяснить все шаги.
Поэтому мы написали большой документ — манифест Chaos Engineering, в котором объяснили, как определять стабильное состояние приложения, где брать идеи для гипотез, какие вопросы нужно задать о приложении, чтобы эти гипотезы нащупать, какие интеграции вокруг приложения не стоит проверять вообще, а какие проверить в первую очередь. В этом же документе написали, как сделать эксперимент контролируемым и безопасным.
Мы активно продвигали хаос-инжиниринг, выступали на внутренних митапах и конференциях, писали статьи о надежности в блоге компании. Нам сильно повезло: в группе инициативных людей, веривших в Chaos Engineering, нашлись коллеги, способные проталкивать задачи на проведение Chaos Engineering прямо в планирование команд. У нас было немножечко админресурса.
Так, постепенно, в T-Банке поверили в Chaos Engineering. Частная инициатива превратилась в полноценную команду разработки. Мы сделали бекэнд, переписали сам скрипт, который запускает обвязку в кубе, на Go-шечку, чтобы унифицировать с бэкэндом, добавили поддержку виртуальных машин. К движению хаос-тестирования подключились QA, попросили библиотечку, и мы сделали либу, которая способна управлять влиянием прямо из кода потребительских тестов.
Чтобы запускать хаос было проще, мы подготовили подключаемые джобы для потребительских пайплайнов. Теперь у нас хаос как сервис, который много чего может. А мы стали платформенной командой.
Промышленное производство хаоса
Сначала, помните, нас в платформу не пустили. Сейчас мы уже сами платформа для проведения хаос-тестирования и заехали в IAM и UI Spirit.
У нас появился платформенный UI — разработчик в централизованном месте, где он управляет своими репозиториями, кодом, может что-нибудь у себя пошатать. Сейчас мы катим механизмы внедрения сбоев (Fault Injection) в платформенные балансировщики, которые управляют балансировкой практически по всему банку. Про платформу Storm знают в каждом уголке банка.
Ставка на Chaos As A Product сыграла. Сейчас про Chaos Engineering рассказываем не только мы, но и те коллеги, которые выполняли задачи Chaos Engineering, в том числе спущенные с помощью админресурса. Они попробовали, поняли, насколько это легко, просто, насколько много инсайтов находится.
Контролируемые эксперименты уже проводятся в production. По нашим метрикам, проведено больше 5000 экспериментов над пятью сотнями уникальных сервисов. За это время нашли больше сотни различных точек отказа, в которых органические сбои обошлись бы намного дороже.
Находки: чуть было не было
Расскажу немного о том, что находят с помощью наших инструментов.
Нередко попадается опциональная интеграция, без которой сервис должен работать и спокойно запускаться. Но при проведении эксперимента оказывается, что это не так.
Часто находят сломанный алерт. Он приходит не туда или срабатывает слишком долго, или какая-то ошибка в выражении. После такой проверки алерты чинят, и мы реагируем на сбои намного лучше.
Иногда находят проблемы в процессах. Например, произошел сбой, после должно произойти действие для устранения последствий, условно — выдать компенсацию клиентам. Эти процессы тоже могут быть сломаны: не доходит информация, что это нужно сделать.
Достаточно часто в тест-кейсах есть неучтенные факторы из production, которые выявляются только во время эксперимента на живом приложении с живым трафиком.
Кейс с межсервисной аутентификацией. Два продуктовых сервиса. Сервисы критичные, между ними есть шифрование и межсервисная аутентификация. Однажды межсервисная аутентификация сбойнула. Тогда подумали, что система критичная, и сделали fallback-логику для этой межсервиски.
Из опыта знаем, что межсервиска может развалиться, иногда чем-то надо пожертвовать для того, чтобы продолжить обрабатывать клиентские операции. Сделали на логику межсервиски feature-toggle. Провели эксперимент и обнаружили, что, если отключить межсервиску, а бэкенды для аутентификации недоступны, сервис отказывается запускаться.
Следующий кейс — тоже продуктовый сервис. У него есть админка, там графики, метрики, можно управлять переключателями фич, но админка на функционал продуктового сервиса не влияет и влиять не должна. У админки есть зависимость в виде LDAP-системы для аутентификации тех, кто в эту админку заходит. В эксперименте отключили LDAP и с удивлением обнаружили, что метрик-то нет.
В результате разбора выяснили, что метрики завязаны на время: записывали время ответа, которое вычислялось в момент обращения к эндпойнту с метриками. Обращаемся → скрейпер приходит за метриками → актуатор — компонент, который эти самые метрики читает и предоставляет, — идет в LDAP. У актуатора тайм-аут на время ответа 30 секунд, а скрейпер уходит через 5. Метрики отдавались, но после того, как ушел скрейпер. При недоступности опциональной интеграции и админки команда в момент инцидента могла остаться и без глаз, и без ушей: и графиков нет, и алерты не пришли.
Кейс про хелсчек и опциональную базюльку. У сервиса есть хелсчек и две базы данных: основная и опциональная. Второй в хелсчеке нет: сервис должен нормально оперировать, если опциональная недоступна. Когда отключили БД, обнаружили, что сервис уходит в CrashLoopBackOff. Почему? Потому что при запуске сервиса в коде инициализируется объект класса для подключения к этой БД. Базы нет, объект не инициализируется, сервис падает с null pointer exception.
Метрики: считаем пользу
Многие команды умеют считать стоимость простоя и считают обычно через diff между органическим сбоем и контролируемым.
В контролируемом сбое у нас все дежурные на месте смотрят метрики сразу. Если что-то пошло не так, сбой можно мгновенно прекратить. Если сбои органические, есть факторы, которые могут нам помочь посчитать потенциальный downtime. Один из этих факторов — время на доставку алерта.
Я уже говорил, что у многих алертов есть защита от ошибочного срабатывания: они срабатывают не сразу, как только по метрикам что-то прострелило, а попозже. Это время можно посчитать. Плюс время, за которое алерты пройдут через сети сотовых операторов, интернет, дойдут до дежурного. Дежурный тоже не сразу увидит: есть какое-то среднее время на доставку алерта.
После того как дежурный получил этот алерт, есть время, которое уйдет на то, чтобы открыть ноутбук, подключиться к созвону, открыть графики, то есть полноценно включиться в разбор инцидента. Это среднее время тоже у многих посчитано, его можно добавить в разницу между контролируемым сбоем и органическим.
Еще есть время восстановления интеграции. Если мы рассчитывали, что интеграция опциональная и сервис должен спокойно работать без нее, а во время эксперимента он почему-то не работает, считаем время на восстановление интеграции. Среднее и максимальное время всегда разнятся, но есть минимальное время, которое складывается из той же доставки алертов и времени реакции дежурного.
Когда мы знаем потенциальное время простоя при органическом сбое, то можем посчитать количество запросов, которые были бы отбиты за это время и посчитать пользу в деньгах. Но мы не видим этих данных о деньгах, поэтому начинали считать метрики с количества пользователей — команд разработки. Но вскоре поняли, что логичнее было бы считать протестированные сервисы. Стали считать дневную, недельную и месячную аудиторию по сервисам. Но эта метрика не отвечает на вопросы о пользе и эффективности платформы.
Куда расти и что дальше
Есть вещи, которые мы хотим считать, но пока не посчитали. Ищем корреляцию между количеством инцидентов по причине внешней интеграции и количеством проведенных хаос-экспериментов. Если эта корреляция есть, то можно ли на нее полагаться для оценки нашей эффективности.
Есть «северная звезда», которая пока недостижима. Мы хотим считать количество неподтвержденных хаос-экспериментом гипотез как метрику, но не можем. Причин несколько.
При постройке платформы мы ошибались: считали, что самое главное — это автоматизировать производство хаоса. Предполагали, что потребители сами смогут строить гипотезы и проводить анализ результатов. Им в этом помогать не нужно — нужно только автоматизировать шаталку.
Но оказалось, что в командах не так много людей с экспертностью по распределенной системе. Мало кто понимает, как их сервис выглядит для потребителей. Единицы могут адекватно составить и подготовить гипотезы. И здесь людям надо бы помогать, но мы пока этого не делаем.
Постанализ предполагает ручной просмотр и анализ дашбордов — с этим тоже хотелось бы помочь на стороне платформы.
Выяснилось, что потребителям очень важно протоколировать, что происходит, вести наблюдения по эксперименту. Например, инженер включил тайм-аут и хочет куда-то записать, что он наблюдает на бордах. Эти протоколы сейчас ведутся в корпоративной вики, а в хаос-платформе инструмента для этого нет.
Сейчас для «северной звезды» — главной метрики пользы — не хватает данных. Но мы знаем, как это решить, и активно движемся в эту сторону.
Вывод
Chaos Engineering — очень полезная штука, но не для всех: что для корпорации хорошо, то для стартапа смерть.
Если вдруг захотелось ввязаться в Chaos Engineering, трезво оценивайте уровень зрелости команды и компании, прежде чем вкладываться в хаос. Если вы узнали себя в третьем или четвертом этапе уровней зрелости и есть бюджет ошибок, то точно пора — делайте.
Не обязательно тащить здоровенный комбайн, который покроет все. Можно начать с концепции и потихонечку ее развивать. Но концепция не вырастет в платформу сама. Понадобятся энтузиасты, которые будут на каждом углу рассказывать: «Chaos Engineering — это круто, он реально помогает качать устойчивость!» Особенно классно будет, если энтузиасты заразят рвением тех, кто способен повлиять на планирование команд.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.