Управляемый DTLS-прокси на Rust: решения, ошибки и цена упрощения
На связи снова Денис из команды EMM в MAGNIT TECH. В первой части я рассказывал, как, почти не зная Rust, взялся за UDP/DTLS-прокси для системы управления 300 тыс. устройств и поручил большую часть реализации ИИ. Тогда я сосредоточился на том, как меняется работа инженера, когда код пишет модель. Теперь — техническая сторона этой истории: почему локальная таблица маршрутов в XDP теряла рукопожатия, как прокси без общего хранилища находит владельца DTLS-сессии и почему 26-байтовый CID с HMAC и подписанный PPv2 уступили более простым решениям. Расскажу, какие компромиссы пришлось принять и какие ошибки удалось обнаружить на испытаниях.
Внутри статьи
Если интересна только производительность — сразу переходите к разделу «Оптимизация UDP».
Словарик
CID (Connection ID) — идентификатор DTLS-сессии (RFC 9146), который позволяет продолжать сессию после смены IP-адреса или порта клиента.
DSR (Direct Server Return) — схема, в которой сервер отвечает клиенту напрямую, минуя балансировщик.
EndpointSlice — объект Kubernetes со списком адресов подов сервиса и их состоянием (ready, serving, terminating).
HMAC — код аутентификации сообщения на основе хеш-функции и общего секрета.
HRW (Rendezvous hashing) — алгоритм выбора узла: для каждого кандидата считается хеш от ключа и узла, побеждает максимальный.
IPIP — инкапсуляция IP-пакета внутрь другого IP-пакета (туннель).
NAT — трансляция сетевых адресов; из-за неё внешний адрес и порт устройства могут меняться.
NLB — сетевой балансировщик нагрузки Yandex Cloud.
PPv2 (PROXY protocol v2) — служебный заголовок, которым прокси передаёт серверу исходный адрес клиента.
SO_REUSEPORT — опция сокета в Linux: несколько сокетов слушают один порт, ядро распределяет между ними пакеты.
StatefulSet и ordinal — объект Kubernetes для подов со стабильными именами; ordinal — порядковый номер пода (ds-0, ds-1, …).
TLV (Type-Length-Value) — формат расширения: тип, длина и значение поля.
XDP (eXpress Data Path) — механизм Linux для обработки пакетов eBPF-программой на раннем этапе, ещё в драйвере сетевой карты.
Коротко о задаче
Коротко о первой части: для нового контура связи с устройствами мы используем протокол LwM2M поверх CoAP и DTLS через UDP. Основной серверный стек команды — Kotlin/JVM: за операции LwM2M отвечает библиотека Eclipse Leshan, а за шифрование и проверку DTLS — Eclipse Scandium. Необходимо горизонтально масштабировать серверы в Kubernetes, сохранять сессии при смене сетевого адреса клиентского устройства и выводить узлы из работы без обрыва связи. При этом хотелось вынести маршрутизацию в единый транспортный инфраструктурный слой перед несколькими службами, оставив криптографию в рамках разрабатываемых сервисов.
На первый взгляд в задаче требуется всего лишь принять UDP-пакет и переслать его одному из серверов, но в контуре с сотнями тысяч устройств ошибка выбора узла означает, что DTLS-рукопожатие продолжится на том сервере, где нет его состояния: пакет дойдёт до узла, а устройство не сможет установить защищённое соединение. Здесь и пришлось разбираться, где заканчивается обычная балансировка и начинается владение сессией.
Как DTLS-сессия потерялась
DTLS-сервер хранит ключи, состояние рукопожатия и номера последовательностей записей. Когда устройство переключается с Wi-Fi на мобильную сеть или NAT закрывает трансляцию по тайм-ауту, внешний IP-адрес или порт клиента может измениться. Для сервера пакет приходит с нового адреса, хотя устройство пытается продолжить прежнее соединение. Если пакет попадёт на другой JVM-экземпляр, у него не окажется нужных ключей.
Внешний балансировщик Yandex Cloud NLB распределяет входящий UDP-трафик между репликами прокси, но не гарантирует, что все пакеты одного потока всегда попадут на одну и ту же цель, в особенности после смены клиентского IP или порта. Именно поэтому решение NLB должно определять только входную реплику прокси, а вот выбрать сервер, владеющий DTLS-сессией, все реплики прокси обязаны одинаково.
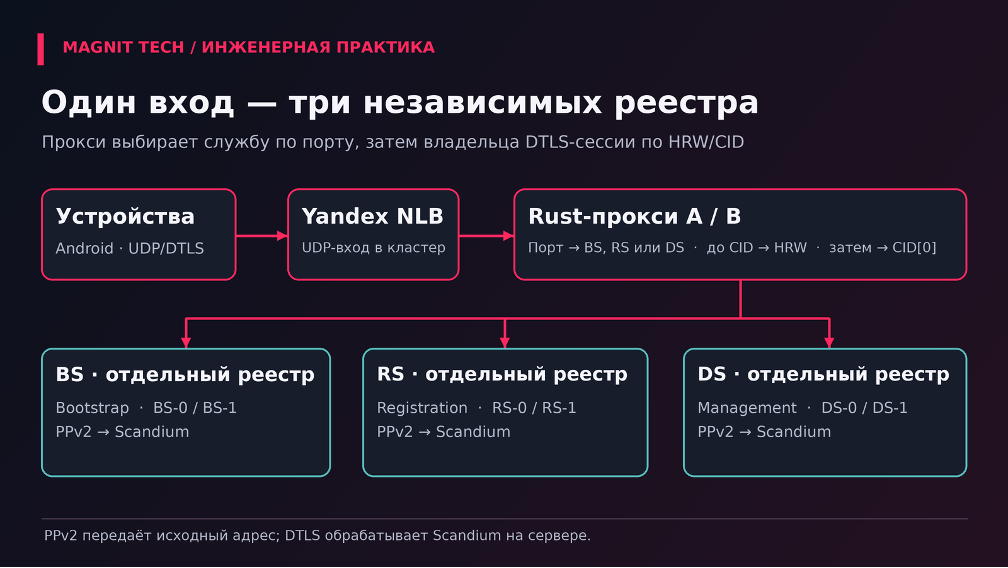
В промышленной схеме общий слой Rust-прокси стоит перед тремя независимыми службами LwM2M: первоначальной настройкой устройств (BS), регистрацией (RS) и управлением (DS). По маппингу входных UDP-портов прокси определяет службу и выбирает конкретный сервер из её собственного динамического реестра, формируемого из конфигурации службы и EndpointSlice Kubernetes. Пока соединение только устанавливается, сервер вычисляется детерминированно по параметрам пакета, а для уже установленной сессии — определяется по идентификатору DTLS 1.2 Connection ID (CID), который не зависит от смены клиентского адреса. Чтобы JVM-сервер за прокси видел настоящий IP и порт устройства, прокси добавляет к пересылаемой датаграмме служебный заголовок PROXY protocol v2 (PPv2), а сам защищённый обмен по-прежнему ведёт Scandium.
Архитектурный взгляд — зачем понадобился прокси?
Самая сильная готовая альтернатива была в нашем JVM-стеке. У Scandium есть DtlsClusterConnector: получив запись, адресованную другому владельцу, он умеет переслать её внутри кластера и обеспечить обратную доставку. Для одного сервиса это вполне могло оказаться проще, чем отдельный прокси, поэтому сравнение решений началось именно с него.
Однако встроенная кластеризация жёстко привязывает маршрутизацию к каждому развёртываемому JVM-приложению: нужно согласованно настраивать идентификаторы узлов, внутренние порты, защиту пересылки и обновления коннекторов. У нас же три службы — BS, RS и DS — масштабируются и выпускаются независимо.
Самостоятельная межсерверная пересылка UDP позволила бы остаться на Kotlin, но потребовала бы реализовать поиск владельца сессии, доверие к служебному пакету и возврат ответа через нужный узел. Так инфраструктурная маршрутизация оказалась бы внутри каждого приложения. Сайдкар сам по себе не устранял проблему: после распределения трафика внешним NLB пакеты всё равно пришлось бы пересылать между подами. JVM-сайдкар дополнительно расходовал бы память каждого пода, а другой стек расширял бы набор поддерживаемых командой технологий. Поэтому для трёх независимо масштабируемых служб я предпочёл общий слой прокси.
Перенос самого DTLS-состояния выглядел ещё дороже: недостаточно передать CID и ключ, надо согласовать номера последовательностей записей, от которых зависит криптографический nonce, окно защиты от повторов и момент смены владельца. По итогу решено отказаться от миграции состояния и сохранить принцип: одна сессия — один сервер, пока он работает.
Рассматривался и вариант с кэшированием, но здесь история оказалась иной. Общее хранилище полезно для регистраций LwM2M и данных приложения, но сохранённая регистрация не заменяет текущие ключи DTLS. Отдельная таблица «CID → сервер» в Redis тоже возможна; она добавляет сетевой запрос и сильную зависимость от кэша к пути каждого пакета. У меня была возможность вычислять выбор для новых соединений и читать готовый номер сервера из CID, поэтому общая таблица маршрутов по итогу не понадобилась.
Завершив сравнение вариантов, я решил вынести маршрутизацию в отдельный транспортный слой перед BS, RS и DS, а на стороне JVM ограничиться переиспользуемым адаптером PPv2, подключаемым через фабрику конечной точки Leshan. Прямой доступ к системным вызовам и предсказуемое управление буферами сделали Rust удобным для этой задачи. Однако прямого сравнительного теста с Kotlin-версией не было, поэтому утверждать, что Rust быстрее именно в нашем сценарии, все еще нельзя.
XDP, IPIP и DSR: быстрый путь с неправильной привязкой
Первая реализация выглядела привлекательно: XDP разбирает пакеты на самом раннем этапе в ядре, инкапсуляция IPIP и схема прямого возврата трафика (Direct Server Return, DSR) позволяют доставлять датаграммы серверу так, чтобы он отвечал клиенту напрямую, а локальная BPF-таблица хранит выбранный сервер. Я рассчитывал получить минимальные накладные расходы без копирования пакетов в пользовательское пространство, но именно локальное запоминание маршрута быстро показало уязвимость всей схемы.
Допустим, прокси A начал DTLS-обмен с клиентом 192.0.2.10:51000 и записал в свою BPF-таблицу выбор сервера 0. В воспроизводимом сценарии я направлял следующий пакет того же рукопожатия, с прежними адресом и портом клиента, через прокси B. Если B не знает о первом решении, он способен направить его серверу 1, у которого нет состояния рукопожатия. Условия рукопожатия не изменились, но A и B приняли независимые решения.
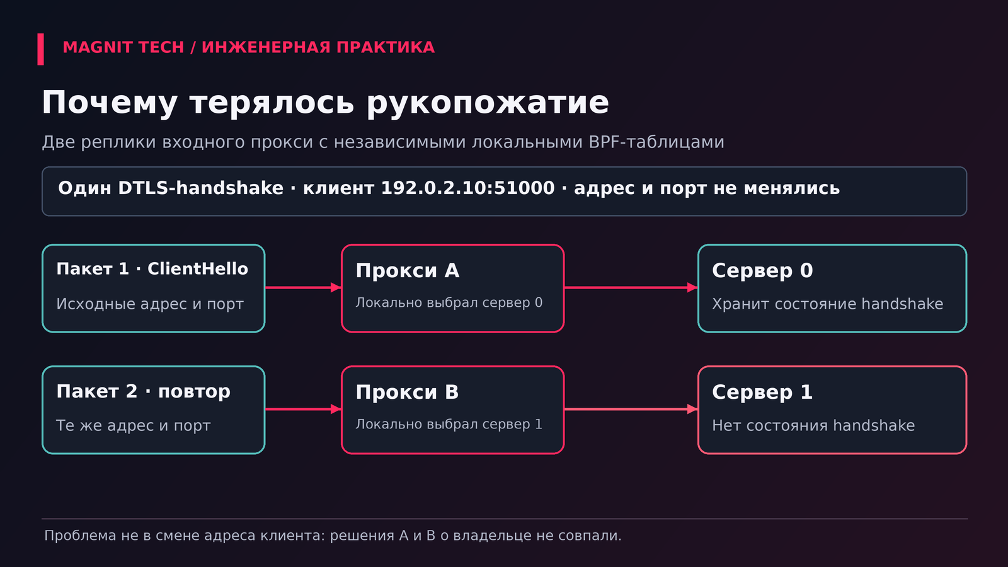
Когда я показал этот сценарий ИИ-модели, она предложила отказаться от локального запоминания маршрута и добиться одинакового выбора сервера на всех репликах. Именно этот эпизод отмечен в первой статье. После этого предложения нужно было разобрать возможные алгоритмы хеширования.
Само по себе это алгоритмическое решение не требовало уходить из ядра: считать хеш для рукопожатия и читать CID можно и внутри eBPF/XDP. Переход к обычным UDP-сокетам в пользовательском пространстве стал отдельным архитектурным шагом. Для запуска на управляемых решениях в облаке необходимо избавиться от IPIP-туннелей и DSR с их жёсткими требованиями к сети Kubernetes, привилегиям контейнеров и асимметричному обратному пути. В пользовательском процессе с явным возвратом пакетов через прокси оказалось намного проще контролировать заголовки, сокеты и метрики. Для нашей инфраструктуры прозрачная диагностика и простота эксплуатации перевесили экономию на системных вызовах.
Алгоритм выбора сервера: кольцо, остаток от деления или HRW
До завершения рукопожатия серверный CID ещё неизвестен, поэтому прокси должен выбрать сервер по доступным сведениям о пакете и сервисе, причём обе реплики обязаны получить одинаковый результат при одинаковых исходных данных и составе серверов. Внешнее общее хранилище для этого не обязательно: достаточно детерминированного алгоритма и согласованных правил его применения.
Остаток hash(key) % N даёт дешёвый выбор, но при изменении числа серверов меняет множество назначений. Кольцо согласованного хеширования уменьшает такие перестановки ценой собственной структуры и виртуальных узлов. Я выбрал HRW (Rendezvous hashing). Как и кольцо, HRW при изменении состава серверов перемещает только клиентов ушедшего или добавленного узла, но реализуется проще: не нужны отдельная структура и виртуальные узлы, а для нашего небольшого числа экземпляров полный перебор кандидатов дешёвый. После появления CID пересчитывать рейтинг уже не нужно.
В hash.rs веса задаются не коэффициентом в формуле, а числом виртуальных кандидатов. Сервер с весом 3 участвует в выборе трижды, а сервер с весом 1 — один раз. Веса нужны для плавного ввода или разгрузки подов; оператор или автоматика меняют их через подписанную управляющую политику. Для каждого кандидата вычисляется xxh3_64_with_seed по одинаково сформированному ключу, куда входят данные клиента, адрес сервиса, номер сервера и индекс виртуального кандидата; выбирается максимальная оценка с фиксированным правилом разрешения равенства. Это решение понятно в коде, но его цена растёт вместе с суммой весов, а не только с числом серверов.
let mut key = Vec::with_capacity(64);
append_socket_addr(&mut key, client);
append_socket_addr(&mut key, service);
let stable_prefix = key.len();

for backend in snapshot.all().iter().filter(|b| b.weight > 0) {
    key.truncate(stable_prefix);
    key.push(backend.id);             // стабильный ordinal, не IP Pod
    let backend_prefix = key.len();
    for replica in 0..backend.weight {
        key.truncate(backend_prefix);
        key.extend_from_slice(&replica.to_be_bytes());
        let score = xxh3_64_with_seed(&key, seed);
        if best.is_none_or(|(old, value, slot)| {
            score > value
                || (score == value
                    && (backend.id, replica) < (old.id, slot))
        }) {
            best = Some((backend, score, replica));
        }
    }
}
Rust-прокси, hash.rs: выбор кандидата (типы и обработка ошибок опущены).
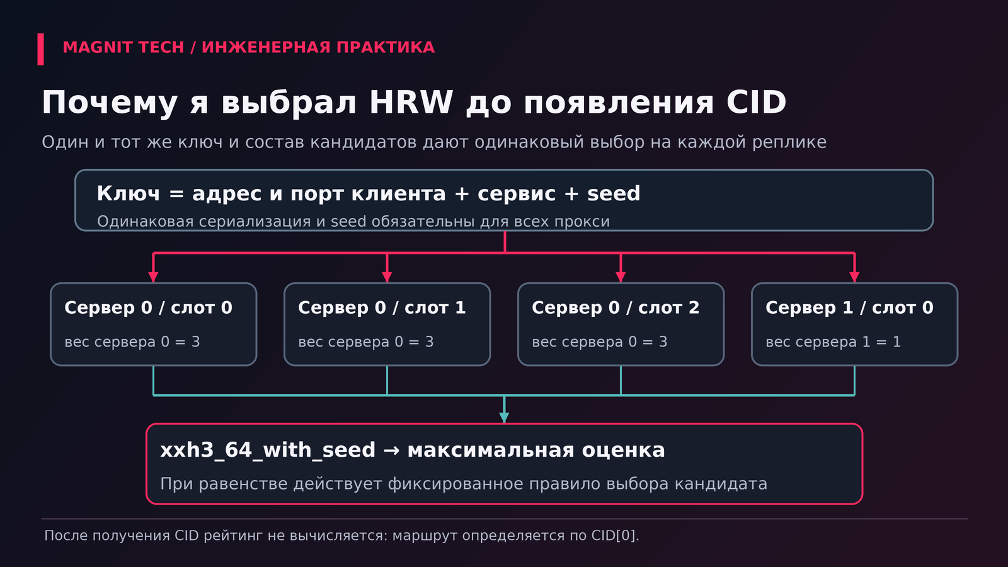
Чтобы две независимые реплики прокси выбрали один и тот же сервер, им мало выполнять одну хеш-функцию — должны побайтово совпадать сериализация ключа и начальное значение хеша (seed). Именно поэтому в качестве идентификатора кандидата в ключ записывается стабильный порядковый номер StatefulSet (ordinal), а не меняющийся при перезапуске IP-адрес Pod. При этом у любого без сохранения состояния выбора по адресу клиента есть естественное ограничение: если внешний IP или порт устройства изменится прямо во время незавершённого рукопожатия (до того, как сервер выдал CID), изменится и хеш-ключ, поэтому такое рукопожатие придётся начать заново.
Кроме того, результат HRW зависит от того, какой набор живых кандидатов и весов видит каждая реплика. Если обновление EndpointSlice из Kubernetes уже дошло до прокси A, но ещё не получено прокси B, их выбор может кратковременно разойтись. Как обновлять этот реестр без внутренних гонок и ограничивать работу по устаревшим данным, я покажу в разделе про Kubernetes.
CID: от дополнительных подписей к восьми байтам
В DTLS 1.2 Connection ID позволяет адресовать запись уже установленной сессии независимо от нового внешнего IP и порта устройства. Принимающий сервер назначает CID, который затем присылает клиент; прокси должен прочитать его, не расшифровывая данные. У записи типа tls12_cid = 25 есть версия, эпоха, шестибайтовый номер последовательности, согласованный CID и длина шифротекста. Отдельного байта с длиной CID в записи нет, поэтому его длина заранее согласуется сторонами.
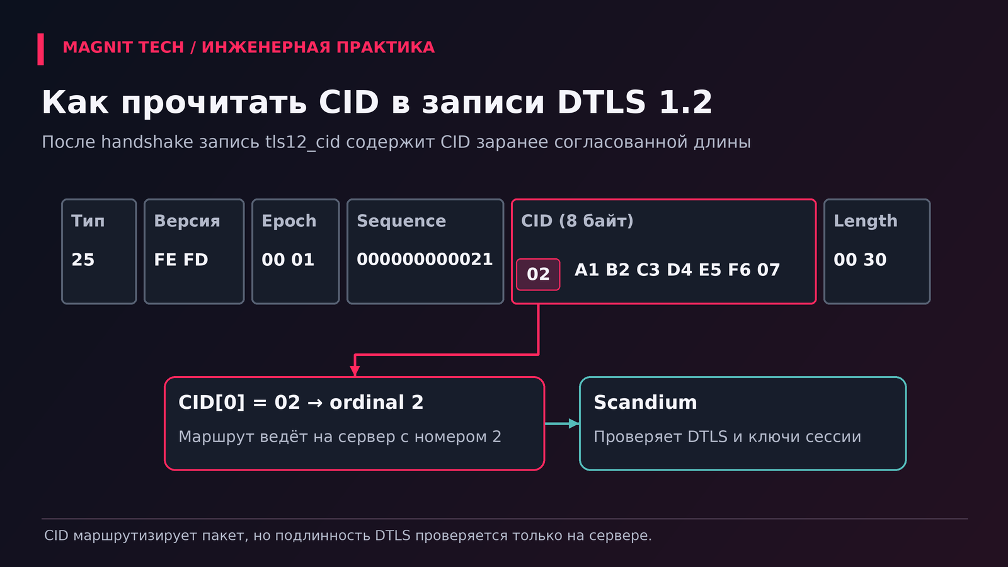
Из UDP-датаграммы нужно отличить обычную запись DTLS от записи с CID и при этом не перепутать повреждённый CID с новым рукопожатием. Именно поэтому в dtls.rs сначала проверяется заголовок. Вызов возвращает Ok(false) для корректной записи без CID, но ошибку — для усечённой или повреждённой записи. Иначе такой пакет мог бы ошибочно попасть в ветку выбора сервера по HRW.
pub const CID_OFFSET: usize = 11;
pub const DTLS_HEADER_WITHOUT_CID: usize = 13;
pub const TLS12_CID_CONTENT_TYPE: u8 = 25;
pub const DTLS12_VERSION: [u8; 2] = [0xfe, 0xfd];

pub fn validate_record(datagram: &[u8], cid_length: usize) -> Result<bool, DtlsError> {
    if datagram.len() < DTLS_HEADER_WITHOUT_CID {
        return Err(DtlsError::TooShort);
    }
    let content_type = datagram[0];
    if !(20..=TLS12_CID_CONTENT_TYPE).contains(&content_type) {
        return Err(DtlsError::UnsupportedContentType(content_type));
    }
    if datagram[1..3] != DTLS12_VERSION {
        return Err(DtlsError::UnsupportedVersion(datagram[1], datagram[2]));
    }

    if content_type != TLS12_CID_CONTENT_TYPE {
        let declared = u16::from_be_bytes([datagram[11], datagram[12]]) as usize;
        if DTLS_HEADER_WITHOUT_CID + declared > datagram.len() {
            return Err(DtlsError::TruncatedRecord);
        }
        return Ok(false);
    }

    if cid_length == 0 || cid_length > u8::MAX as usize {
        return Err(DtlsError::InvalidCidLength);
    }
    let length_offset = CID_OFFSET + cid_length;
    let header_length = length_offset + 2;
    if datagram.len() < header_length {
        return Err(DtlsError::TooShort);
    }
    let declared =
        u16::from_be_bytes([datagram[length_offset], datagram[length_offset + 1]]) as usize;
    if header_length + declared > datagram.len() {
        return Err(DtlsError::TruncatedRecord);
    }
    Ok(true)
}

pub fn classify(datagram: &[u8], cid_length: usize) -> Result<DtlsRoute, DtlsError> {
    if !validate_record(datagram, cid_length)? {
        return Ok(DtlsRoute::HandshakeOrPlaintext);
    }
    let backend_id = datagram[CID_OFFSET];
    if backend_id == u8::MAX {
        return Err(DtlsError::ReservedBackendId);
    }
    Ok(DtlsRoute::ConnectionId { backend_id })
}
Rust-прокси, dtls.rs: проверка заголовка записи и классификация маршрута.
После типа записи, версии, двухбайтовой эпохи DTLS (epoch) и шестибайтового номера последовательности первый байт CID находится по смещению 11. Для записей с типом 25 код проверяет согласованную длину CID и то, что заявленный размер шифротекста не выходит за пределы датаграммы (для обычных записей рукопожатия это отсекает усечённые пакеты, допуская стандартную склейку нескольких DTLS-записей в одном UDP-пакете), а значение 255 не допускает как номер сервера — оно зарезервировано в нашей реализации. Сам прокси не расшифровывает DTLS: подлинность содержимого проверяет сервер, у которого находятся ключи сессии.
Когда серверный CID уже появился, повторно считать HRW не нужно. Прокси берёт номер сервера из первого байта CID и ищет его в реестре соответствующего сервиса; если номер неизвестен, пакет отклоняется, а не направляется как новое рукопожатие. Схематично (без обновления метрик отброшенных пакетов) это разделение в обработчике устроено так:
let backend = match route {
    DtlsRoute::ConnectionId { backend_id } => {
        match snapshot.get_by_ordinal(backend_id) {
            Some(backend) => backend,
            None => return, // неизвестный или недоступный ordinal: пакет отбрасывается
        }
    }
    DtlsRoute::HandshakeOrPlaintext => {
        if !registry.can_accept_new_handshakes_in(snapshot) {
            return;         // реестр устарел: новые рукопожатия временно закрыты
        }
        match select_handshake_backend(snapshot, client, service, seed) {
            Some(backend) => backend,
            None => return,
        }
    }
};
Rust-прокси, worker.rs: ветвление маршрута (счётчики ошибок в ветках отказа опущены).
Чтобы эта маршрутизация работала, сервер и прокси связаны общим контрактом генерации идентификатора: первый байт CID хранит порядковый номер экземпляра JVM (ordinal в StatefulSet, например 2 для пода ds-2), а оставшиеся семь байт различают сессии внутри этого узла. При старте JVM-пода ordinal передаётся в специализированный ConnectionIdGenerator Scandium, записывающий его в CID[0] каждого восьмибайтового идентификатора, а прокси сопоставляет тот же ordinal с актуальным IP-адресом пода через EndpointSlice. Заодно это ограничивает масштаб: в один байт помещается не больше 255 серверов на службу.
У такого открытого кодирования номера сервера есть два очевидных нюанса. Во-первых, злоумышленник может сформировать пакет с произвольным первым байтом CID и принудительно направить мусорный трафик на конкретный сервер (пройти проверку DTLS в Scandium такой пакет не сможет, но ресурсы на приём потратит). Во-вторых, когда Kubernetes пересоздаёт упавший pod с тем же номером StatefulSet, старые CID снова укажут на этот узел, хотя ключей прежних сессий в новом процессе уже нет.
Стремясь закрыть оба вопроса на уровне самого прокси, в одной из первых ревизий я расширил CID до 26 байт: номер сервера (1 байт), номер поколения Pod incarnation (4 байта), идентификатор ключа key_id (1 байт), случайный nonce (8 байт) и усечённая метка HMAC (12 байт). Это позволяло прокси проверять подпись маршрута и отсекать пакеты старой инкарнации пода ещё до обращения к Scandium. Однако взамен пришлось поддерживать хранилище ключей, их плановую ротацию и единый 26-байтовый формат на всех сторонах.
Оценив накладные расходы, стало понятно, что это слишком высокая постоянная цена. Расширенный идентификатор добавлял 18 лишних байт к каждой датаграмме на протяжении всей жизни соединения. При этом обнаружение старого экземпляра пода на прокси всё равно не спасало саму DTLS-сессию: раз старый процесс погиб, его ключи потеряны, и устройству в любом случае придётся пройти новое рукопожатие. Новому процессу Scandium прежние ключи неизвестны, поэтому он не может продолжить старую сессию. Устройство заметит отсутствие ответа при следующем обмене; для подтверждаемых запросов CoAP (CON) время ожидания зависит от ACK_TIMEOUT, случайного коэффициента тайм-аута, числа ретрансляций и логики переподключения клиента. Без замера конкретной конфигурации обещать восстановление «за несколько секунд» было бы некорректно. В наших условиях оказалось выгоднее принять редкое переподключение клиента после перезапуска сервера, чем нести постоянные расходы на 26-байтовый формат и ротацию ключей.
Разница между двумя прошедшими через проект вариантами хорошо видна в прямом сопоставлении:
Поле или свойство | Промежуточный CID26 | Поздний вариант CID8 |
|---|---|---|
Маршрут | ordinal (1 байт) | ordinal (1 байт) |
Остальные байты | incarnation (4), key_id (1), nonce (8), HMAC (12) | 7 байт, определяемых DTLS-сервером для сессии |
Криптографическая проверка CID в прокси | Да, при включённой политике | Нет в облегчённой схеме (криптографическая проверка остаётся на сервере) |
Цена в каждой записи | 26 байт CID | 8 байт CID |
Последствие перезапуска сервера | Можно обнаружить старую инкарнацию до доставки | После гибели процесса требуется новое DTLS-соединение |
При этом сама длина идентификатора и требование проверять HMAC на прокси — два отдельных архитектурных переключателя (на промежуточных этапах у нас сохранялись и конфигурации с обязательным CID-HMAC). В облегчённой восьмибайтовой схеме прокси проверяет только допустимость ordinal по реестру живых серверов, криптографическую проверку записи выполняет Scandium, а защита от перегрузки мусорными пакетами ложится на ограничитель скорости и внешний сетевой периметр.
Интеграция с Kubernetes
Когда прокси уже знает номер сервера, ему нужен именно адрес соответствующего pod, а не произвольный экземпляр за общим ClusterIP. Поэтому я читаю EndpointSlice, сопоставляю стабильный номер StatefulSet с текущим адресом и публикую новый реестр целиком. Чтение опубликованного снимка рабочими потоками реализовано через ArcSwap, без общей блокировки.
Если отдельно менять адрес, вес и статус сервера, обработчик может увидеть несовместимые части двух обновлений. Цельный снимок исключает эту гонку внутри процесса; между двумя прокси снимки по-прежнему могут временно различаться, потому что Kubernetes доставляет изменения не одновременно.
Состояние ready отвечает за возможность принимать новые подключения, а serving и terminating помогают понять, может ли pod, уже начавший завершение работы, обслуживать старые сессии. Я исключаю завершающий работу сервер из выбора для новых рукопожатий, продолжая направлять ему записи уже установленных соединений. Как только он перестаёт обслуживать запросы или исчезает из реестра, отправка данных на него прекращается.
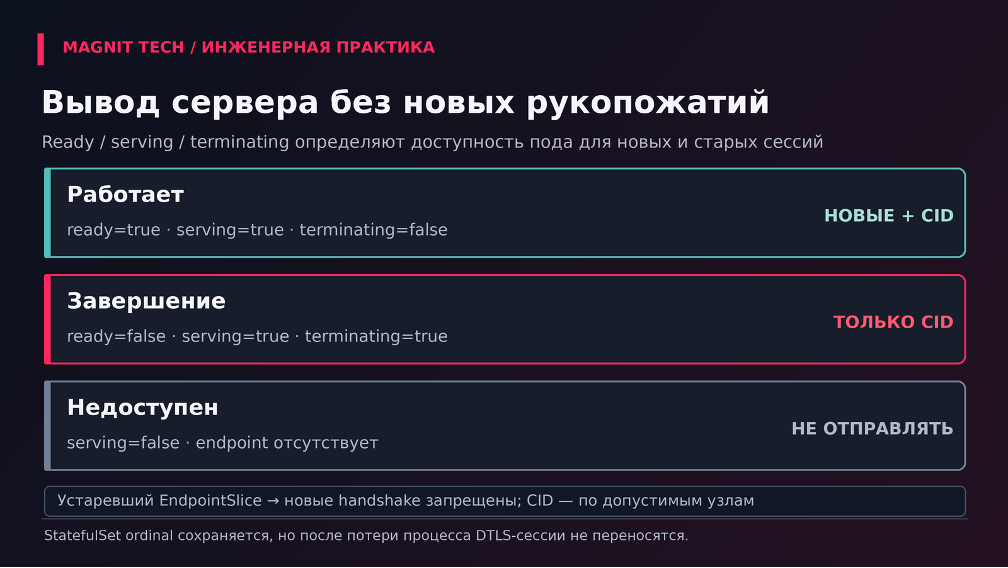
Держать уходящий pod бесконечно нельзя — длительность завершения ограничена жизненным циклом пода и сессий. Отдельно предусмотрен случай, когда сам прокси теряет связь с Kubernetes API и данные EndpointSlice устаревают: по истечении порога свежести приём новых рукопожатий блокируется, чтобы не раздавать соединения по заведомо неактуальной топологии, тогда как существующие CID-маршруты дообслуживаются по правилам допустимости узлов. При этом реестры BS, RS и DS изолированы друг от друга: проблема с обновлением списка серверов Bootstrap не останавливает регистрацию и управление устройствами.
PPv2 и правильный путь ответа
Отказ от DSR поставил практический вопрос: как передать приложению настоящий адрес устройства, если UDP-пакет физически приходит от прокси? Я использовал PROXY protocol v2 для UDP/IPv4: перед исходной DTLS-записью прокси помещает служебный заголовок с адресами и портами клиента и сервиса. На серверной стороне этот заголовок разбирает переиспользуемый Ppv2DtlsConnector — транспортный адаптер перед Scandium, а не отдельная реализация DTLS.
Для Bootstrap подключение выглядит так: я наследую штатную фабрику конечной точки Leshan и заменяем лишь создание транспортного коннектора. Конфигурация DTLS, параметры PSK и построение CoAP-стека остаются в обычном жизненном цикле Leshan.
class Ppv2CoapsBootstrapServerEndpointFactory(
    uri: EndpointUri,
    configuration: Configuration,
    uriHandler: EndPointUriHandler,
    private val logPackets: Boolean = true,
) : CoapsBootstrapServerEndpointFactory(
    uri, "PPv2-CoAP", configuration,
    NO_DTLS_INITIALIZER, NO_COAP_INITIALIZER, uriHandler,
) {
    override fun createConnector(dtlsConfig: DtlsConnectorConfig): Connector =
        Ppv2DtlsConnector(dtlsConfig, logPackets = logPackets)

    private companion object {
        val NO_DTLS_INITIALIZER = Consumer<DtlsConnectorConfig.Builder> { }
        val NO_COAP_INITIALIZER = Consumer<CoapEndpoint.Builder> { }
    }
}
JVM-сервер, Kotlin: фабрика конечной точки Bootstrap с Ppv2DtlsConnector.
Благодаря такой точке расширения вся конфигурация DTLS, ключей PSK и CoAP-стека остаётся стандартной для Leshan, а разбор PPv2 вынесен в единый Ppv2DtlsConnector для всех трёх служб (BS, RS и DS). Задача этого коннектора — извлечь из 28-байтового заголовка реальный адрес клиента, передать чистую DTLS-запись в Scandium и запомнить физический адрес реплики прокси, через которую нужно вернуть ответ. При приёме коннектор проверяет адрес физического отправителя по списку доверенных прокси, удаляет заголовок PPv2, передаёт в Scandium DTLS-запись с логическим InetSocketAddress устройства и сохраняет физический адрес прокси для обратной доставки. Это не переносит DTLS-шифрование из Scandium в адаптер.
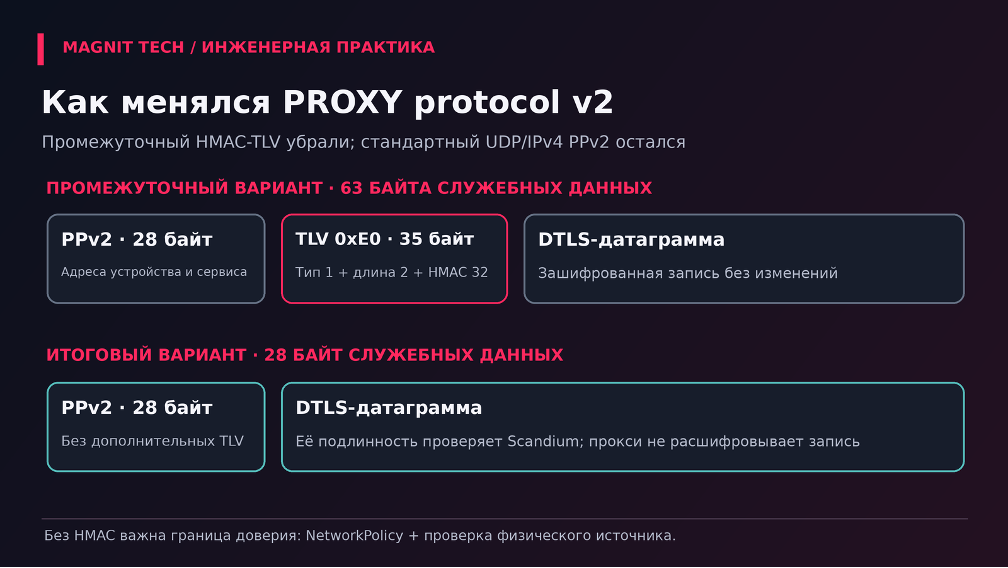
Сам служебный заголовок PPv2 добавляется уже после выбора JVM-сервера и не участвует в балансировке. В формате IPv4/UDP он занимает 28 байт. Оба прошедших через проект варианта показаны на схеме в конце следующего подраздела: промежуточный с собственной подписью и итоговый стандартный.
Почему я сначала подписывал PPv2, а потом убрал HMAC
Вслед за защитой CID похожую эволюцию прошёл и внутренний обмен по PPv2 — но здесь требовалось защитить уже не выбор сервера, а достоверность клиентского адреса, который JVM-сервер читает из служебного заголовка. Сам по себе формат PPv2 не аутентифицирует отправителя: любой узел, получивший сетевой доступ к внутреннему UDP-порту сервера, мог бы прислать пакет с поддельным адресом устройства. Чтобы отсекать такие пакеты ещё на транспортной границе, в промежуточной версии я добавил к стандартному заголовку приватное поле TLV 0xE0 с подписью HMAC-SHA256.
Подпись рассчитывалась по исходному и конечному адресам с портами, длине и содержимому DTLS-записи, а также фиксированной строке контекста udp-dtls-cid-proxy-pp2-v1. Для плавной ротации секретов адаптер проверял метку как текущим, так и предыдущим ключом, а общий размер служебной оболочки вырос с 28 до 63 байт на каждую датаграмму.
Фрагменты кода ниже — из испытательного Rust-адаптера: на стенде он сначала выполнял серверную сторону PPv2. В промышленной схеме ту же логику выполняет Kotlin-адаптер Ppv2DtlsConnector перед Scandium.
В варианте с HMAC проверка стояла перед созданием записи обратного маршрута; на время смены ключа адаптер принимал метку, рассчитанную прежним секретом:
// Проверка подписи перед обработкой маршрута
let parsed = parse_udp4(datagram)?;
if let Some(key) = self.hmac_key.as_deref() {
    verify_udp4_hmac_with_fallback(
        &parsed,
        datagram,
        key,
        self.previous_hmac_key.as_deref(),
    )?;
}
let payload = &datagram[parsed.payload_offset..];
Стенд, Rust-адаптер: проверка подписи PPv2 перед обработкой маршрута.
На обратном направлении тот же адаптер, прежде чем отправить ответ к прокси, выбирал способ формирования заголовка по наличию ключа:
// Формирование ответной датаграммы
let header = if let Some(key) = self.hmac_key.as_deref() {
    encode_udp4_authenticated(entry.service, entry.real_client, payload, key).to_vec()
} else {
    encode_udp4(entry.service, entry.real_client).to_vec()
};
Стенд, Rust-адаптер: формирование ответной датаграммы.
Цена собственного TLV складывалась не только из 35 дополнительных байт. Пришлось поддерживать расширение протокола, согласовывать ключи и их замену между Rust и JVM, обрабатывать несовпадение версий. Эти расходы существовали независимо от того, насколько быстро Scandium проверяет собственную DTLS-запись.
В итоговой схеме я отказался от приватного TLV и вернулся к стандартному PPv2. Доступ к внутренним UDP-портам JVM-сервисов ограничен Kubernetes NetworkPolicy для подов прокси; сам прокси дополнительно сверяет физический источник обратной датаграммы с реестром серверов и проверяет логическое назначение. Это уменьшило расходы на сопровождение секретов, но проверка IP не заменяет криптографическую аутентификацию: при возможности подменить UDP-источник внутри доверенного сегмента нужны дополнительные меры.
В worker.rs проверка выглядит так: ещё до использования логического адреса прокси сверяет физический источник ответа с реестром разрешённых серверов.
// Проверка физического адреса отправителя до чтения PPv2
if !trusted_network || !registry.accepts_reverse_sender(&physical_source) {
    metrics.drop_untrusted_backend.fetch_add(1, Ordering::Relaxed);
    return;
}
let parsed = match parse_udp4(datagram) {
    Ok(parsed) => parsed,
    Err(_) => {
        metrics.drop_invalid_proxy_v2.fetch_add(1, Ordering::Relaxed);
        return;
    }
};
if parsed.source != config.public_destination
    || !valid_client_destination(parsed.destination)
{
    metrics.drop_invalid_proxy_v2.fetch_add(1, Ordering::Relaxed);
    return;
}
Rust-прокси, worker.rs: проверка физического отправителя до чтения PPv2.
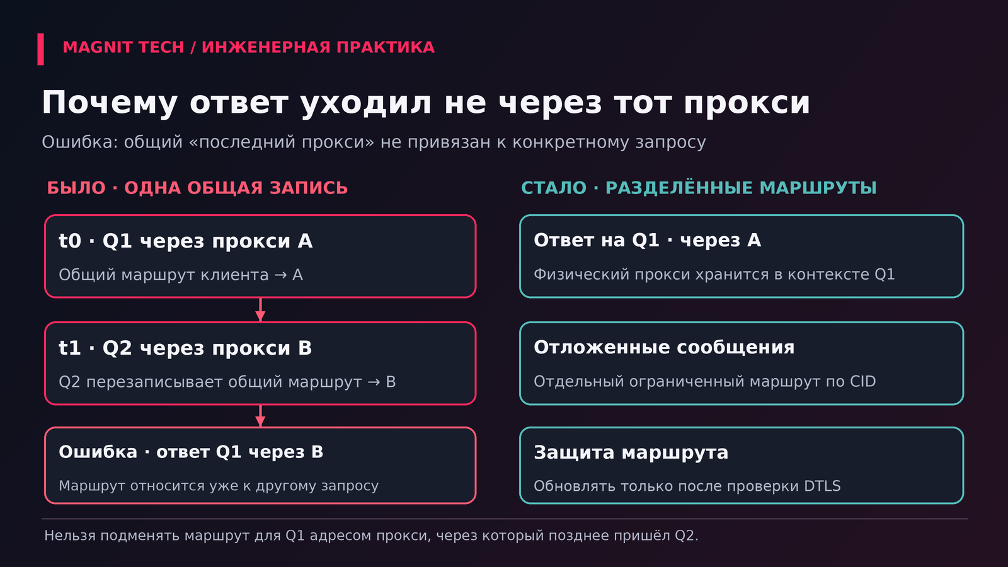
Прямой маршрут работал, но ответы обнаружили другую ошибку. Пусть запрос Q1 пришёл через прокси A, а пока сервер его обрабатывает, следом поступил Q2 через B. Если сервер хранит одну общую запись «этот клиент → последний прокси», второй запрос успеет заменить A на B. В результате ответ на Q1 уйдёт через реплику B по чужому сетевому пути, хотя клиент всё ещё ждёт его через A.
Для ответа, который формируется сразу на конкретный запрос, нужно помнить физический прокси именно этого запроса. Для позднего сообщения серверу потребуется уже ограниченная таблица маршрутов: до появления CID её ключ связан с логическим адресом клиента, затем — с полным идентификатором сессии. Разделение устраняет гонку, при которой Q2 перезаписывает маршрут ещё не завершённого Q1.
// Ключ маршрута для ответа, который придёт позднее
let route_key = if cid_length > 0 {
    match connection_id(payload, cid_length).map_err(|_| RouteError::InvalidDtls)? {
        Some(cid) => RouteKey::ConnectionId(cid.to_vec()),
        None => RouteKey::Client(parsed.source),
    }
} else {
    RouteKey::Client(parsed.source)
};
let route_update = RouteUpdate {
    proxy: physical_proxy,
    service: parsed.destination,
    real_client: parsed.source,
    last_seen: Instant::now(),
};
Стенд, Rust-адаптер: ключ маршрута для ответа, который придёт позднее.
Для поздних ответов в испытательном Rust-адаптере формируется RouteUpdate с адресами физического прокси, сервиса и устройства. Отдельная публикация нужна потому, что увидеть CID недостаточно для признания записи действительной сессией: обновление маршрута допустимо только после проверки DTLS.
// Публикация маршрута после проверки DTLS
self.upsert_route(route_key.clone(), route_update)?;
if matches!(route_key, RouteKey::ConnectionId(_)) {
    self.remove_route(&RouteKey::Client(real_client));
}
Стенд, Rust-адаптер: публикация маршрута после проверки DTLS.
Немедленный ответ использует адрес исходного прокси Q1, тогда как таблица хранит путь для самостоятельных последующих сообщений сервера; смешивать эти два случая в одной изменяемой записи было причиной гонки.
Самая опасная ошибка здесь — обновить таблицу после одного лишь чтения CID: пакет с чужим идентификатором мог бы заменить адрес, куда сервер пошлёт поздний ответ. В стенде я разделил предварительный разбор и подтверждение маршрута; между ними обязательно должна быть проверка криптографического состояния DTLS.
// Упрощённый фрагмент стенда: предварительный разбор и публикация разделены
let decoded = table.inspect_with_cid(physical_proxy, datagram, cid_length)?;
// Между этими вызовами требуется подтверждение записи DTLS.
table.commit_route(&decoded.route_key, decoded.route_update.clone())?;
Стенд, Rust-адаптер: предварительный разбор и публикация маршрута разделены.
На испытательном стенде это двухфазное правило проверялось в Rust-адаптере через пару методов inspect_with_cid и commit_route, а в промышленной системе аналогичный контракт должен соблюдаться Ppv2DtlsConnector в связке со Scandium: маршрут действующей сессии обновляется только после того, как DTLS-движок подтвердил подлинность пакета.
Оптимизация UDP: вызовы ядра, память и обратный трафик
После исправления маршрутов я наконец смог заняться ценой пересылки. Первый замер — примерно 670 полученных и 670 отправленных пакетов в секунду при небольшой загрузке CPU — давал соблазнительный, но бесполезный прогноз производительности на высоких скоростях. Процессор мог простаивать между пакетами; по такой точке нельзя судить, насколько дорого обойдутся системные вызовы и копирование при заполненных очередях.
Меньше системных вызовов и работы на каждый пакет
Сначала я работал с recv_from и send_to, но на возрастающей частоте пакетов их стоимость становилась заметнее. Для Linux перенёс обмен на recvmmsg и sendmmsg, заранее создавая буферы и массивы sockaddr_in, iovec, mmsghdr для повторного использования. Одновременно отключённый ограничитель нагрузки получил действительно короткую ветку: если все лимиты равны нулю, обработчик не должен читать часы и трогать таблицу адресов.
// Поясняющий фрагмент: короткая ветка отключённого ограничителя
if !limits_enabled {
    return RateDecision::Allowed;
}
// Только при включённых лимитах нужны часы и таблица отправителей.
check_global_and_source_limits(source, datagram_len, now)
Rust-прокси: короткая ветка отключённого ограничителя.
Именно расположение проверки определяет экономию: когда часы и поиск отправителя выполняются до проверки нулевых лимитов, ограничитель формально отключён, но продолжает расходовать процессорное время на каждый пакет.
Linux-приём показателен тем, что выделенные структуры переиспользуются между вызовами:
#[cfg(target_os = "linux")]
fn try_receive_linux(&mut self, socket: &UdpSocket) -> io::Result<usize> {
    for message in &mut self.messages {
        message.msg_hdr.msg_namelen =
            std::mem::size_of::<libc::sockaddr_in>() as libc::socklen_t;
        message.msg_len = 0;
    }
    let result = unsafe {
        libc::recvmmsg(
            socket.as_raw_fd(), self.messages.as_mut_ptr(),
            self.messages.len().try_into().unwrap_or(u32::MAX),
            libc::MSG_DONTWAIT, std::ptr::null_mut(),
        )
    };
    if result < 0 { return Err(io::Error::last_os_error()); }
    Ok(result as usize)
}
Rust-прокси: приём через recvmmsg с переиспользованием структур.
Работа с сырыми указателями внутри mmsghdr и iovec требует жёсткой дисциплины памяти: после инициализации буферы не должны реаллоцироваться или менять ёмкость, иначе ядро получит недействительные адреса, а перед каждым новым вызовом recvmmsg необходимо сбрасывать поля длины, изменённые ядром на прошлом шаге.
На отправке через sendmmsg нужно учитывать ещё одну особенность: системный вызов может передать только часть подготовленной пачки. Поэтому цикл отправки сдвигает срез на число реально ушедших датаграмм, чтобы не порождать дубликаты, и перед повторной попыткой обязательно дожидается готовности сокета к записи — иначе при WouldBlock поток сорвётся в холостое сжигание CPU:
// Существенные строки send_linux из socket.rs
let mut sent = 0;
while sent < datagrams.len() {
    socket.writable().await?;
    let remaining = &datagrams[sent..];
    self.prepare_linux_headers(remaining);
    let result = socket.try_io(Interest::WRITABLE, || {
        let count = unsafe {
            libc::sendmmsg(
                socket.as_raw_fd(), self.messages.as_mut_ptr(),
                remaining.len().try_into().unwrap_or(u32::MAX),
                libc::MSG_DONTWAIT,
            )
        };
        if count < 0 { Err(io::Error::last_os_error()) }
        else if count == 0 { Err(io::Error::from(io::ErrorKind::WriteZero)) }
        else { Ok(count as usize) }
    });
    match result {
        Ok(count) => sent += count,
        Err(error) if error.kind() == io::ErrorKind::WouldBlock => continue,
        Err(error) => return Err(error),
    }
}
Rust-прокси, socket.rs: существенные строки send_linux.
Для передачи PPv2 и исходной DTLS-записи я использую два элемента iovec одной UDP-датаграммы, не собирая временный объединённый буфер. Это избавляет от копирования между двумя пользовательскими массивами, но не означает, что ядро или сетевой адаптер работают без копирования.
Оценивать оптимизацию пришлось по разным профилям: низкая частота не показывает стоимость системных вызовов, а синтетическая нагрузка без полного CoAP-обмена не отражает работу Leshan и обратных очередей.
Этап | Что происходило | Что удалось выяснить |
|---|---|---|
Первый малонагруженный прогон | Около 670 пакетов/с в каждом направлении | На такой нагрузке расходы на системные вызовы почти незаметны |
Локальный синтетический профиль | Проверены пачки 32/64/128 на синтетической нагрузке | Подтверждена точка 100 тыс. пакетов/с без потерь; пачка 32 дала лучший результат среди проверенных |
Попытки увеличить скорость | Нагрузка до 400 тыс. пакетов/с | Стали проявляться ошибки и ограничения сокетных буферов |
Двунаправленный обмен с Leshan | Около 14 тыс. пакетов/с суммарно | Потребовалось отдельно разбирать обратный поток и работу приложения |
Отдельные прогоны выполнялись на разных версиях протокольной оболочки и с разным характером запросов, поэтому я не складываю их в единую кривую ускорения. Они помогали по очереди найти дорогую операцию в обработчике, подобрать размер пачки и проверить поведение за облачным NLB.
Почему скорость синтетического UDP не повторилась с Leshan
В синтетическом профиле удавалось получить около 70–80 тысяч пакетов в секунду на ядро. При двунаправленном прогоне с Leshan, примерно тремя тысячами эмулируемых устройств и подтверждаемыми CoAP-операциями суммарная скорость составила около 14 тысяч пакетов в секунду. Сравнивать эти значения как ускорение или замедление нельзя: первое характеризует одно ядро в синтетике, второе — полный обмен с прикладным стеком и подтверждениями. Число задействованных ядер и профиль нагрузки для корректного сравнения нужно фиксировать отдельно.
Я начал с обратной стороны: несколько серверов Leshan создавали гораздо меньше разных сочетаний адресов и портов, чем тысячи устройств на входе. При SO_REUSEPORT это могло приводить к неравномерному распределению по сокетам — один обработчик собирал короткие пачки и задерживал ответы, пока другой работал свободнее. Поэтому показатели размера пачек и загрузки потоков стали важнее красивой общей цифры PPS.
Чтобы выровнять нагрузку, я наметил несколько шагов: выделить отдельные порты обратного пути для каждого рабочего потока, ограничить число пакетов за один проход цикла и дочистить оставшиеся мелкие аллокации на пачку. Но внедрять это вслепую не стал: сначала нужно по счётчикам отделить вклад SO_REUSEPORT от времени работы самого Scandium и сетевого стека Kubernetes, чтобы не усложнять код на участке, который не является главным узким местом.
Что показали измерения за облачным балансировщиком
Облачный стенд проверял маршрутизацию UDP-датаграмм через цепочку NLB → прокси → сервер в режимах генератора handshake и cid. На ступени с заданными 200 тысячами пакетов в секунду счётчики прокси показывали в среднем 184 405 принятых и 184 404 пересланных пакета в секунду; в части повторов сам генератор регистрировал SndbufErrors. Эти числа описывают конкретный путь пересылки, а не время завершения CoAP-запроса.
На более высоких ступенях генератор выдавал меньше заданного — порядка 265–272 тысяч вместо 275 тысяч пакетов в секунду. Поэтому я остановил повышение нагрузки и не стал приписывать наблюдаемую границу прокси: сначала надо было устранить ограничение источника нагрузки.
В самом прокси остались пакетные системные вызовы, заранее выделенные буферы и ограниченные таблицы маршрутов. Перестройку обратных очередей я пока не внедрял без профиля реального трафика: дополнительная сложность в этой части может просто переместить узкое место.
Как теперь это решение сопровождать в команде?
Чтобы управлять такой разработкой с ИИ, я сформулировал базу знаний и единый инженерный контракт: кто владеет сессией, как выбирается сервер, где проходит граница доверия и какие ошибки должны приводить к отказу в обработке пакета. OpenCode помогал писать Rust, готовить конфигурации и прогонять локальные сценарии в Podman, а я возвращался к альтернативам, когда исполнение обнаруживало новый недостаток архитектуры. Ничего не мешает продолжить дальше использовать аналогичный подход.
Важно заметить, что теперь сопровождать нужно две стороны одного контракта: Rust-прокси обязан одинаково маршрутизировать пакеты к сервисам BS, RS и DS, а общий JVM-адаптер — правильно обрабатывать PPv2 перед Scandium и сохранять обратный путь.
На мой взгляд, ближайшая серьёзная проверка этой архитектуры придёт не с новым рекордом PPS, а с обновлениями Scandium, изменениями состава Kubernetes и восстановлением связи с устройствами после перезапуска серверов.
Если хочется разобрать протокол глубже
RFC 9146 — Connection Identifier for DTLS 1.2 и RFC 6347 — DTLS 1.2: формат записи, адресация, аутентификация.
Scandium DtlsClusterConnector и Leshan Cluster Usage: встроенная JVM-альтернатива и границы разделения состояния.
Kubernetes EndpointSlice и Pod termination: ready, serving, terminating.
PROXY protocol v2: стандартные поля адреса и служебные расширения.
Linux recvmmsg(2) и sendmmsg(2): пакетный UDP I/O и частичный успех.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.