«Don't fear the REAPer» или как DS себе локальную LLM выбирал
За последние месяцы я протестировал кучу локальных LLM, которые может потянуть моя техника и пришёл к выводу, который для многих уже очевиден: для задач на кодинг альтернатив моделям Qwen особо нет. Поэтому я решил удалить с диска все лишние модели, чтобы оставить только "рабочих лошадок".
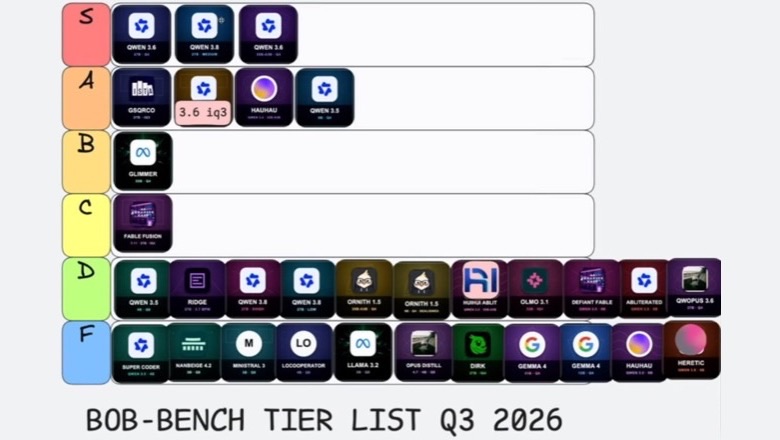
В этот момент мне на глаза попалось видео c tier-list, в котором я узнал много знакомых моделей.
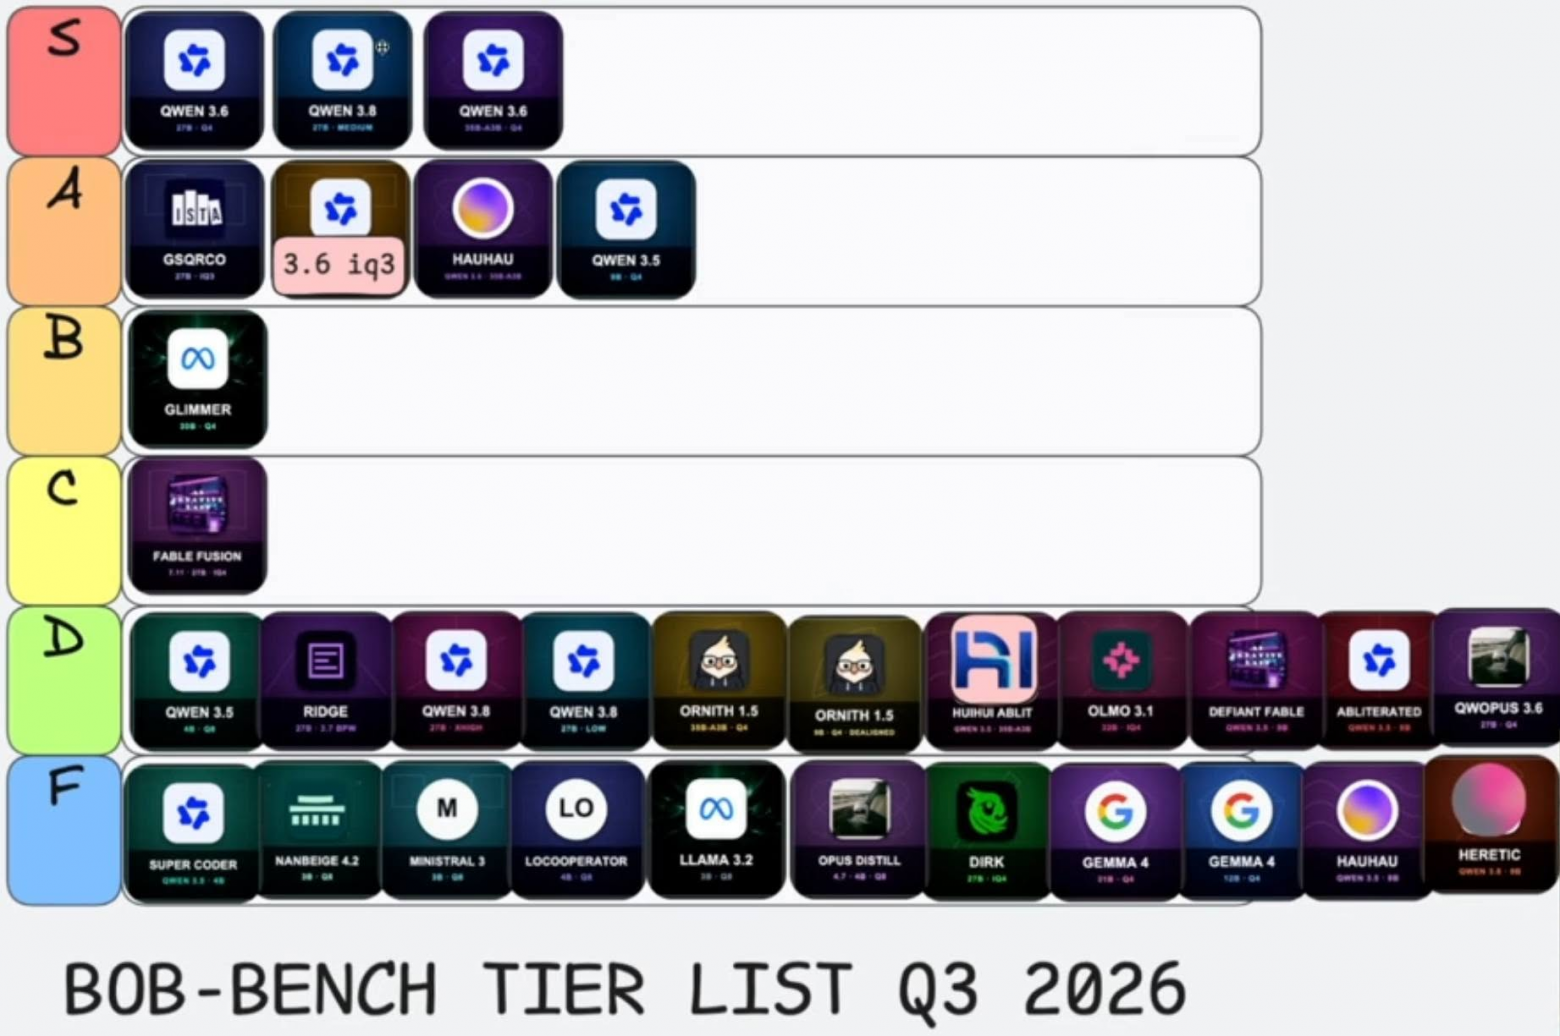
Но один момент меня удивил: RIDGE версия Qwen3.8-27B была записана в D-tier, а GSQ-RCO — в A-list, хотя мой субъективный опыт был диаметрально противоположным. RIDGE у меня была даже отмечена как "favorite model" для линейки Qwen3.8, в то время, как от GSQ-RCO мне не удалось с первой попытки добиться результата в стандартных тестах.
И тут я понял, что пришла пора эти тесты заменить.
Всё это время я тестировал модели двумя промптами от Ютубера: симулятор песка и dungeon-crawler. Оба они проверяют алгоритмические навыки LLM, занимают ~10-15 минут на генерацию и меньше минуты на "прокликивание" для проверки выполнения всех пунктов ТЗ.
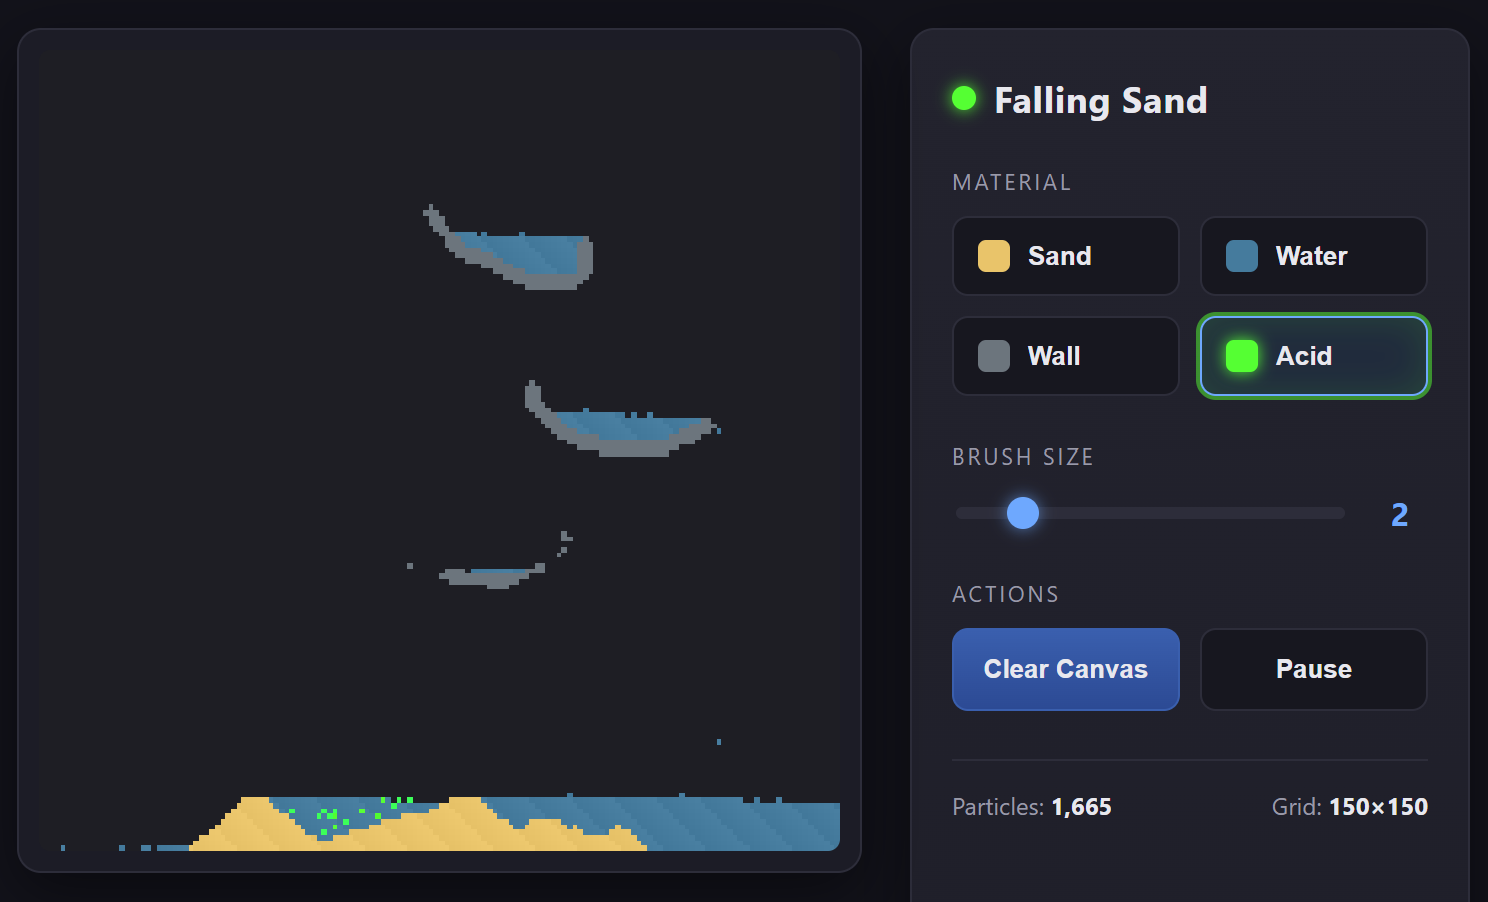
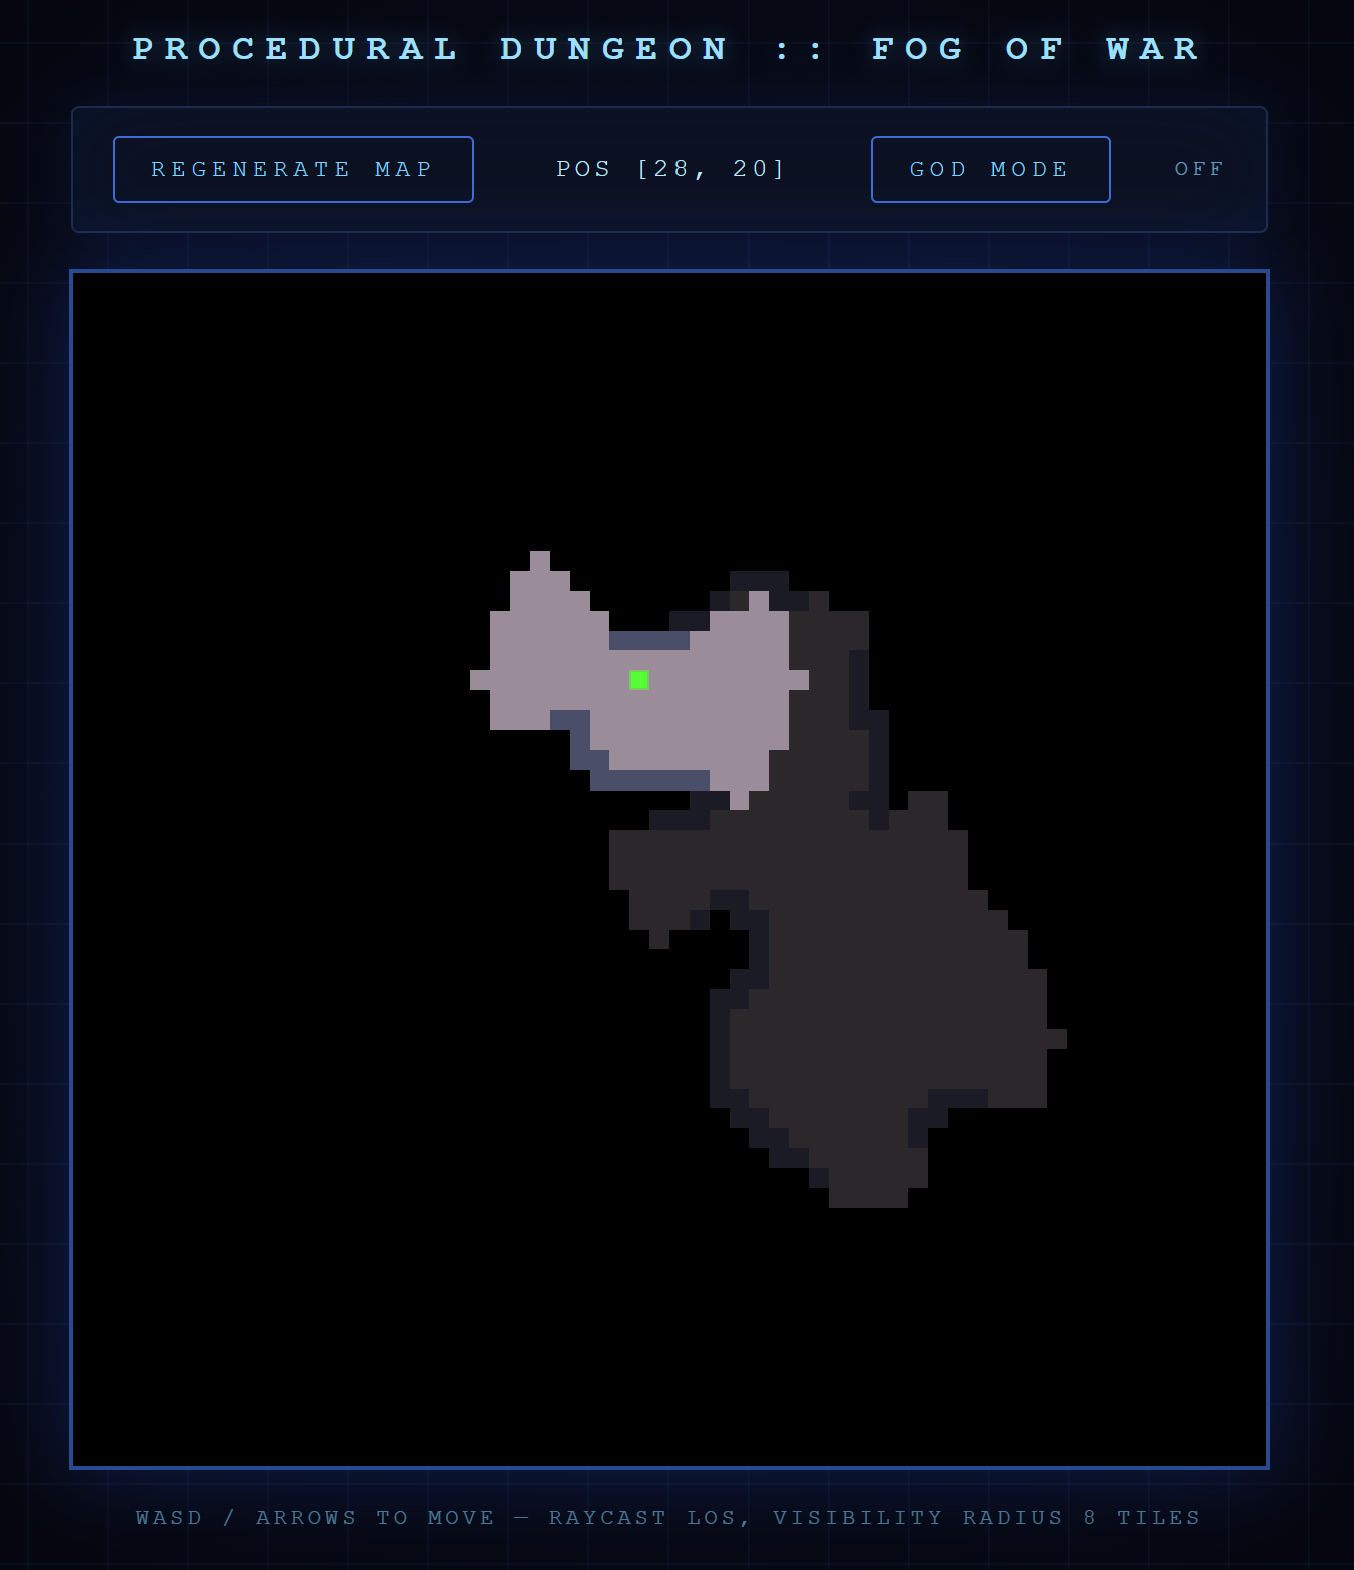
В общем, для знакомства с моделями они подходят хорошо, но на этапе систематического тестирования нужно что-то, не требующее моего ручного вмешательства. Плюс большинство ютуберских тестов, что я видел, заточены под front-end, game-dev и работу с MCP, в то время, как моя предметная область — анализ данных, машинное обучение и прочий Data Science.
Поэтому мой выбор пал на DS1000 — бенчмарк, представленный на ICML 2023, и покрывающий ровно эти задачи.
DS1000: а судьи кто?
Датасет для бенчмарка собран из вопросов на StackOverflow по 7 библиотекам, связанным с DS (+ кол-во задач в датасете):
Pandas - 291
NumPy - 220
SciPy - 106
Sklearn - 115
Matplotlib - 155
PyTorch - 68
Tensorflow - 45
Для борьбы с "зубрёжкой", помимо оригинальных задач авторы добавили аугментации (назвав их perturbations), полученные следующими способами:
Surface — изменение формулировки без изменения кода ответа. Например, простой пересказ вопроса другими словами.
Semantic — изменение задачи, которую нужно решить. Например, в задаче на добавление колонки в pandas, попросить экспонировать значение исходной колонки, вместо инвертирования.
Difficult Rewrite — усложнение задачи. Например, объединив предыдущие две аугментации или задав дополнительный вопрос к уже имеющемуся.
Т.е. из 291 задачи на pandas из SO были взяты только 100, а остальные получены аугментацией. Из всех трёх её способов, Difficult Rewrite сильнее всего просаживал % правильных ответов: Codex002 из статьи потерял 33 п.п. (47,8% -> 14,8%) по сравнении с оригинальным вопросом с SO.
Модель оценивалась просто: сгенерированный ею код подставлялся в шаблон и выполнялся, а результат сравнивался с эталонным. С остальными деталями бенчмарка можно ознакомиться на его странице.
Сетап
Агентские задачи на кодинг я решаю но своём ПеКа с RTX 4070 Ti Super (16 Gb VRAM) + 32 Gb DDR5 RAM. Рантайм в llama.cpp.
Для контекстного окна я выбрал 64k. Во-первых, в Data Science кода не так много, как в классическом software development. Во-вторых, по словам Matt Pocock контекст начинает протухать уже после ~ 140k, поэтому больше 124k я в принципе не рассматриваю. В-третьих, я пока не определился с режимом для использования локальной LLM (агентский vs Ralph loops), поэтому хотелось иметь небольшой запас для первого, но быть готовым к режиму экономии токенов для второго. Особенно с учётом того, что в моих дальнейших планах работа с локальными LLM с диапазоном весов 2-7B.
Над процедурой первого прогона я задумываться не стал: просто закинул в агента ссылку на репозиторий бенчмарка с промптом "прогони это локально на модели %LLM-NAME%. Весь процесс у меня занял 11,7 GPU-часов. По-хорошему, его можно было бы значительно сократить, убрав из теста библиотеки, которыми я не пользуюсь (Pandas, Tensorflow, Matplotlib), т.к. тот же Pandas занял 36,1% всего времени. Но привычка сначала запустить и случае успеха разбираться, никуда не делась. Тем более, что библиотеки эти весьма популярные, поэтому для первого подхода к снаряду решил их оставить.
Результаты
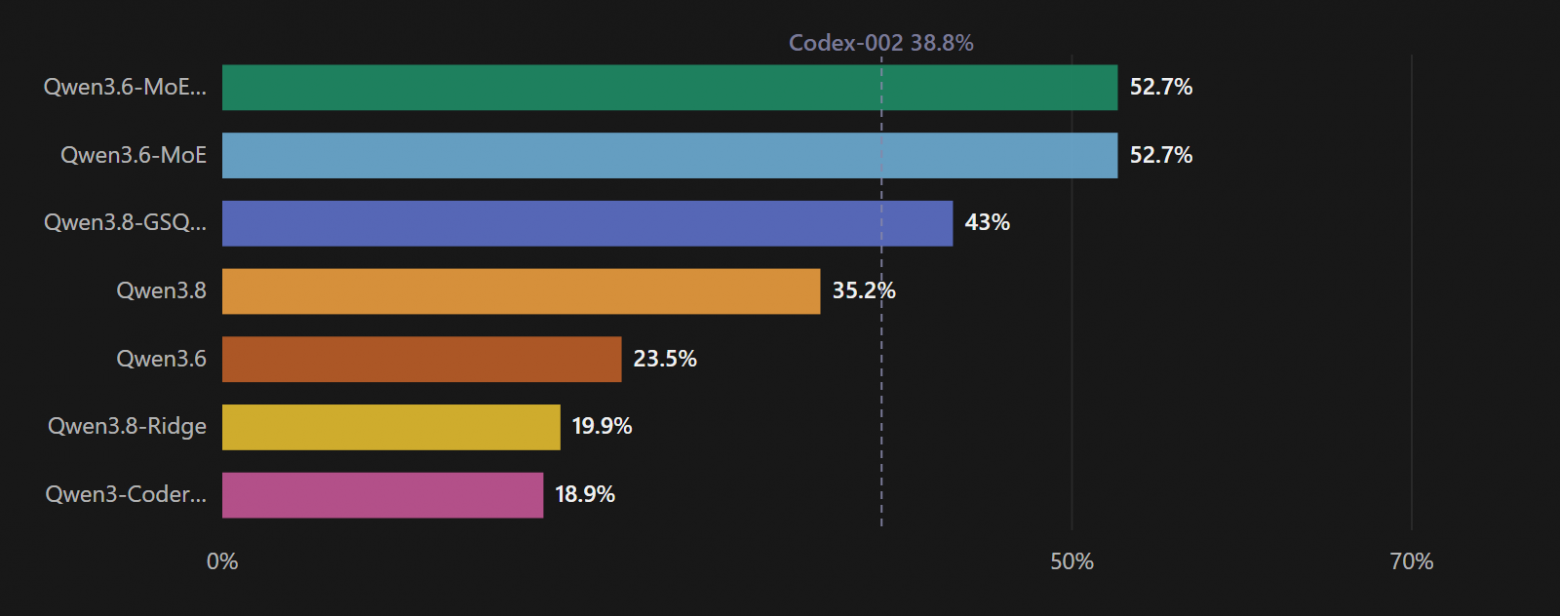
По количеству решённых задач первое место разделили REAP20-28B и 35B-A3B. Этот результат можно считать с одной стороны закономерным, т.к. технология REAP (Router-weighted Expert Activation Pruning, arxiv) как раз и подразумевает сохранение способностей модели при сокращении весов, а с другой стороны — удивительным, т.к. в кои-то веки подобная магия из теория совпадала с практикой? Цифра 20 в названии модели указывает на то, что в ней были удалены 20% весов.
Третьей моделью, обошедшей бенчмарк Codex-002 в 38.8% оказалась та самая GSQ-RCO, с которой мне тяжело было найти общий язык. Т.е. tier-list, с которого всё началось, оказался адекватным.
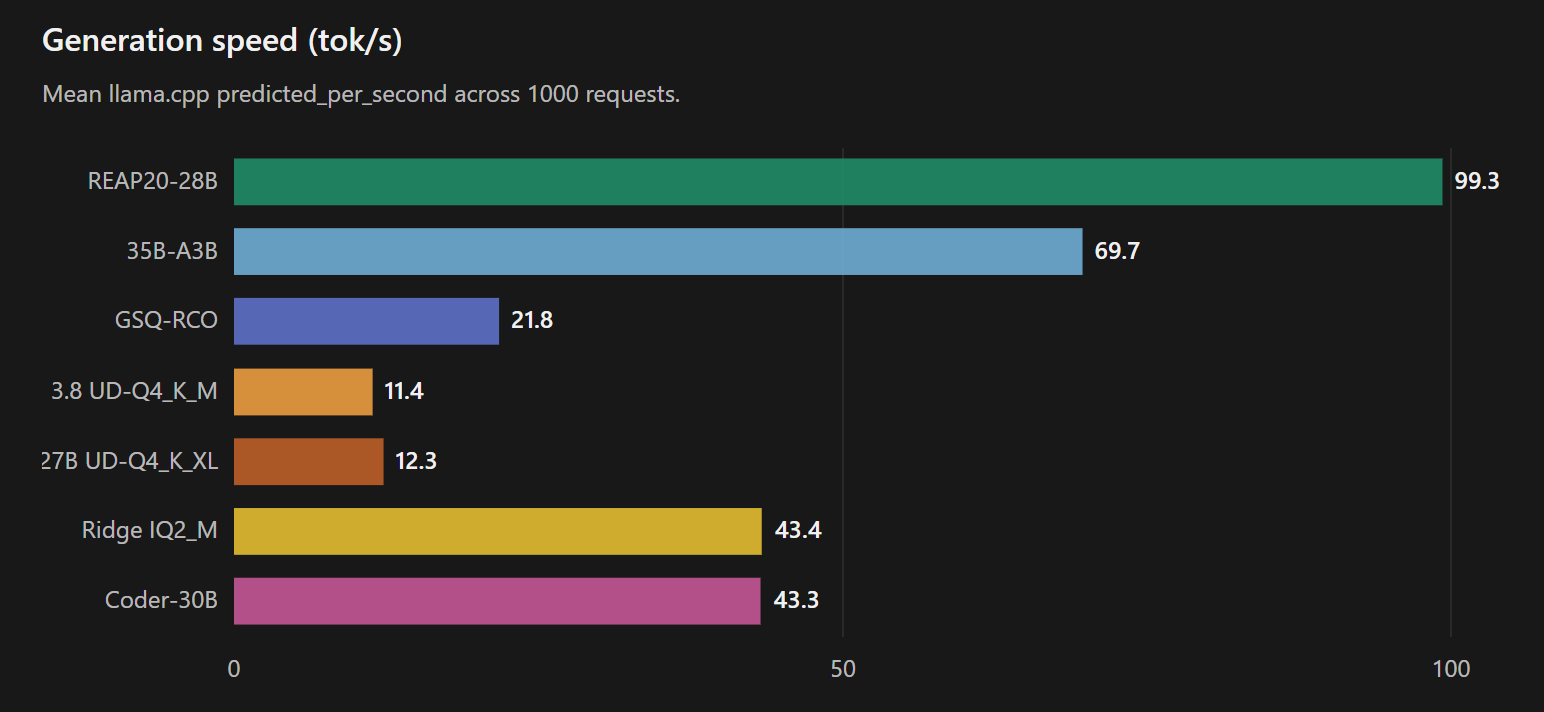
Результаты скорости генерации тоже подтвердили теоретические предпосылки технологии REAP: при идентичной точности, укороченная версия оказалась на 42% быстрее исходной модели (при том, что из неё удалено 20% весов).
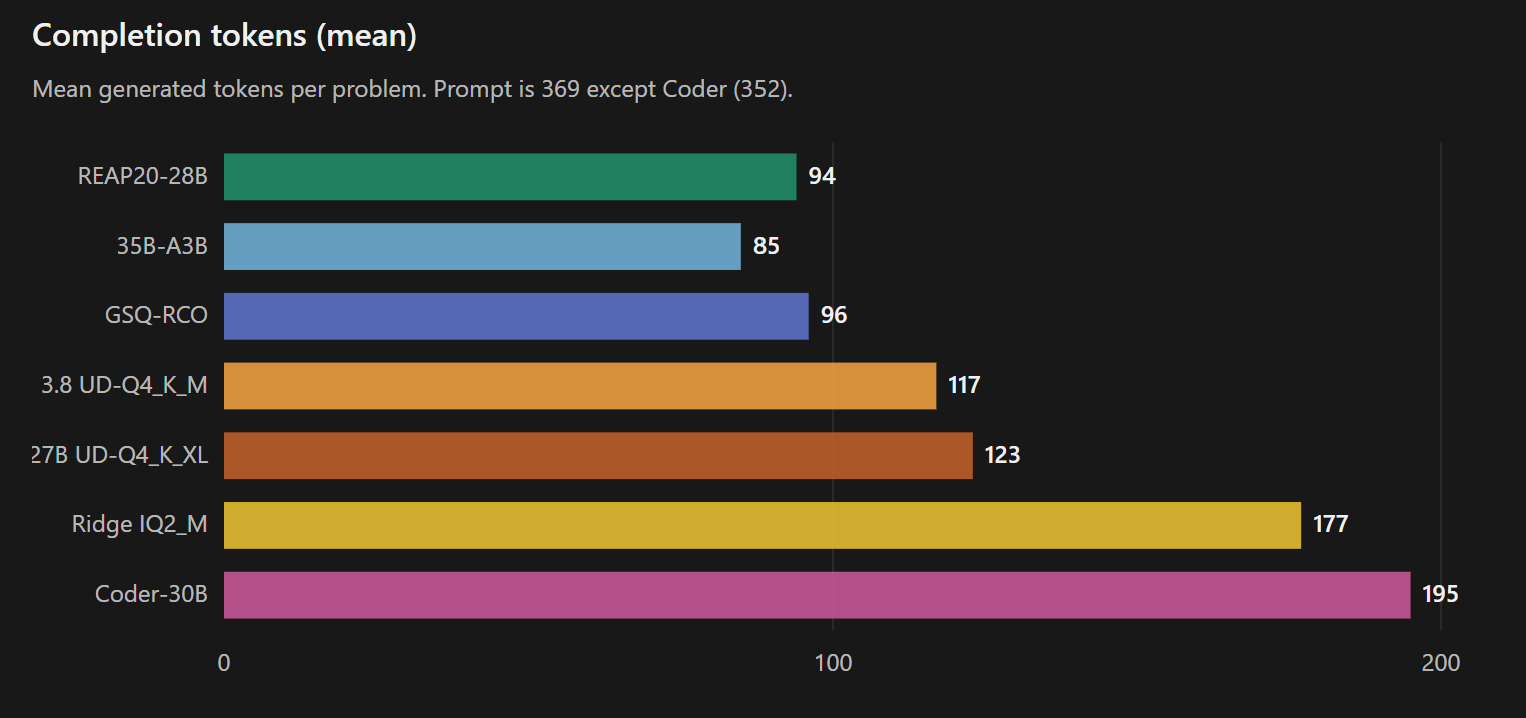
Среднее количество потраченных токенов для меня не принципиально, т.к. они для меня практически бесплатны. Поэтому график добавляю в основном для того, чтобы показать, ~Х2 разницы по этому показателю между лидерами и аутсайдерами.
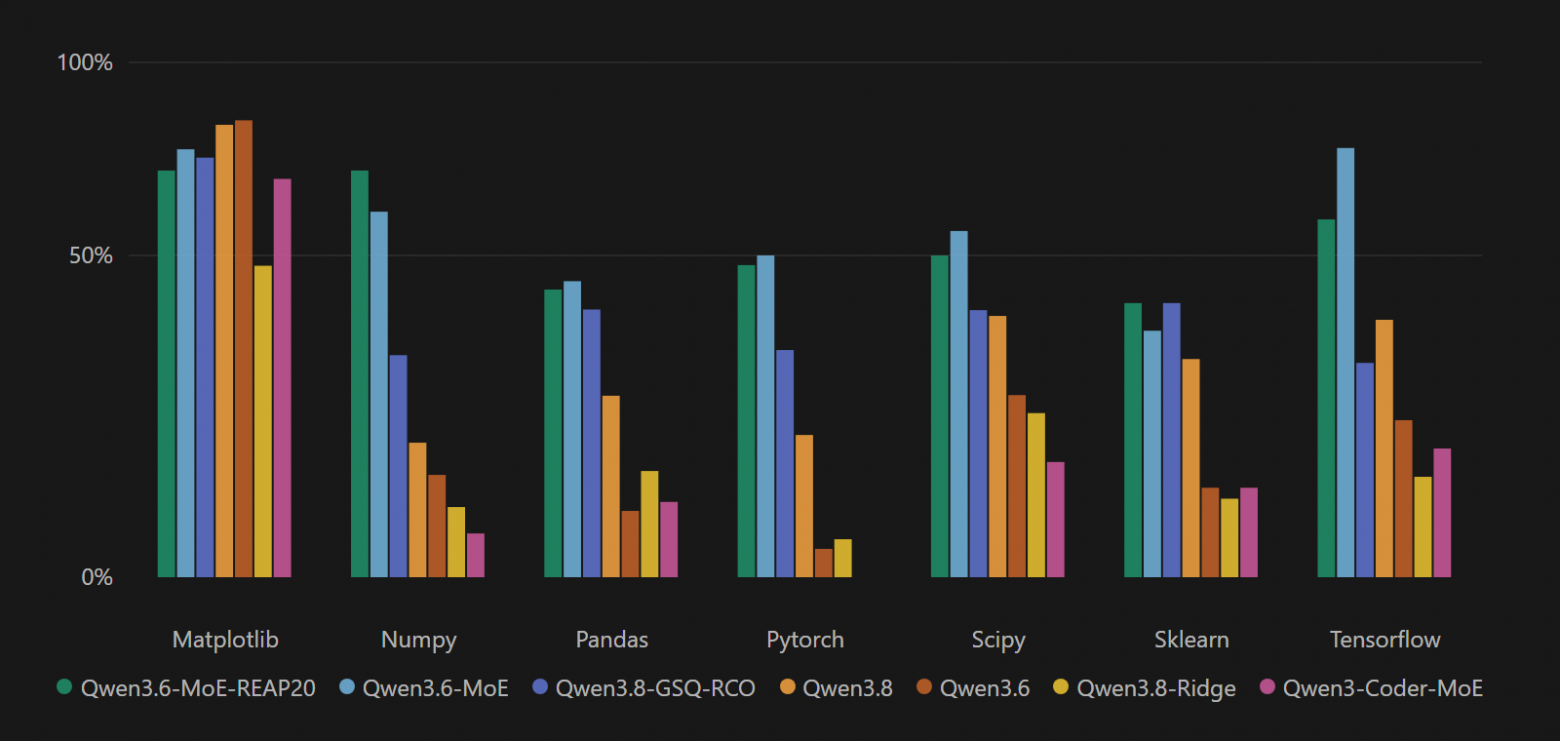
На следующем графике можно посмотреть разбивку % решённых задач по библиотекам. Наиболее простым почти для всех моделей оказался бесполезный для меня Matplotlib, в то время как в самой ходовой библиотеке — Sklearn — даже лидирующие модели не смогли решить половины задач. Чем это можно объяснить с учётом даты выхода бенчмарка — я не знаю. Видимо нужно будет плотно заняться этим вопросом, погоняв другие бенчмарки и посмотрев на корреляцию результатов.
Основной инсайт первого подхода для меня заключался в том, что LLM может работать в 2 смены (а я — нет):
В "дневную смену", когда я тоже работаю вместе с моделью, мне приоритетнее скорость, т.к. задачи в Data Science весьма итеративные и чем быстрее получаешь результаты экспериментов, тем лучше.
В "ночную смену", когда я сплю, мне приоритетно лишь количество и качество сна. Поэтому LLM может неспешно и вдумчиво выполнять что-то, не требующее моей постоянной вовлечённости, например code review. Т.е. для этого режима работы точность модели берёт приоритет над скоростью.
Данная схема неплохо ложится на другое вид разделения LLM:
Dense models — базовая полносвязная модель. При 27B параметров в 16Gb VRAM влезает редко и с трудом.
Mixture of Experts (MoE) — модификация, позволяющая разделить веса между VRAM и RAM, значительно ускорив процесс инференса.
Т.е. для совместной работы в дневную смену можно использовать MoE, а на ночь ставить dense модели. В идеале — из разных "семейств", дабы избежать непотизма и кумовства на code review. Это не шутка.
С учётом того, что в важных для меня библиотеках (Numpy и Sklearn) "урезанная версия" MoE Qwen3.6 превосходит, а в Scipy и Pytorch незначительно отстаёт, то кандидатом №1 в "дневную смену" меня оказалась REAP20-28B. Хитроумное же квантование Qwen3.8-27B, занявшее везде почётное третье место, имеет смысл погонять в "ночную смену". Ridge IQ2_M и Qwen3-Coder-30B по итогам данного тестирования я удалил, т.к. SSD у меня не резиновый и данный исход был одной из целей эксперимента.
Вот на этом я и планировал закончить данный текст.
Но один момент мне никак не давал покоя. А именно: превосходство Qwen3.6 над Qwen3.8 в точности. Результаты для Numpy, Sklearn и Pytorch смотрятся совсем жалко. Особенно с учётом того, что бенчмарк не первой свежести и имел все шансы просочиться в обучающие данные для последних моделей. В общем, если бы мне подобные результаты предъявил незнакомец из интернетов, поверить им было бы сложновато. Поэтому я решил немножко углубиться в вопрос.
А если подумать?
Самым очевидным параметром для изменения было включение 'thinking' mode. В первом эксперименте он был выключен, т.к. там хотелось "просто посмотреть" на результаты, причём поскорее. После их получения данное изменение было очевидным no brainer.
У REAP, 35B-A3B и 3.6-27B этот выбор является бинарным (on/off), для остальных моделей, поддерживающих градации усилий, был выбран 'medium', т.к. задачки в бенчмарке ходовые, а не олимпиадные, поэтому должны решаться моделью в "штатном" режиме.
Т.к. размышления очевидным образом удлиняют время ответа (что критично для "дневной смены"), решил немного скомпенсировать этот момент включением MTP для всех моделей, которые этот режим поддерживают и имели соответствующие "головы". У обеих MoE версий Qwen3.6 их не оказалось, но с ними мне всё было и так понятно, поэтому решил не заморачиваться и запустил их без спекулятивного декодинга.
Ещё одним способом сэкономить время было ограничение на выбор библиотек для прогона тестирования. Т.к. для моих задач критически важными являются Numpy, Scipy, Sklearn и Pytorch, то я оставил только их, сократив число задач почти в 2 раза (с 1000 до 509).
Параметром, над которым я напрасно поленился подумать, оказался лимит токенов на рассуждения. Посмотрев на среднее количество токенов на задачу я решил, что в 4096 токенах достаточно места для рассуждений. Это, как видно из результатов, оказалось большой ошибкой.
Результаты
Первый шок-контент я обнаружил на этом графике. Разрешение подумать действительно значительно улучшило результаты...
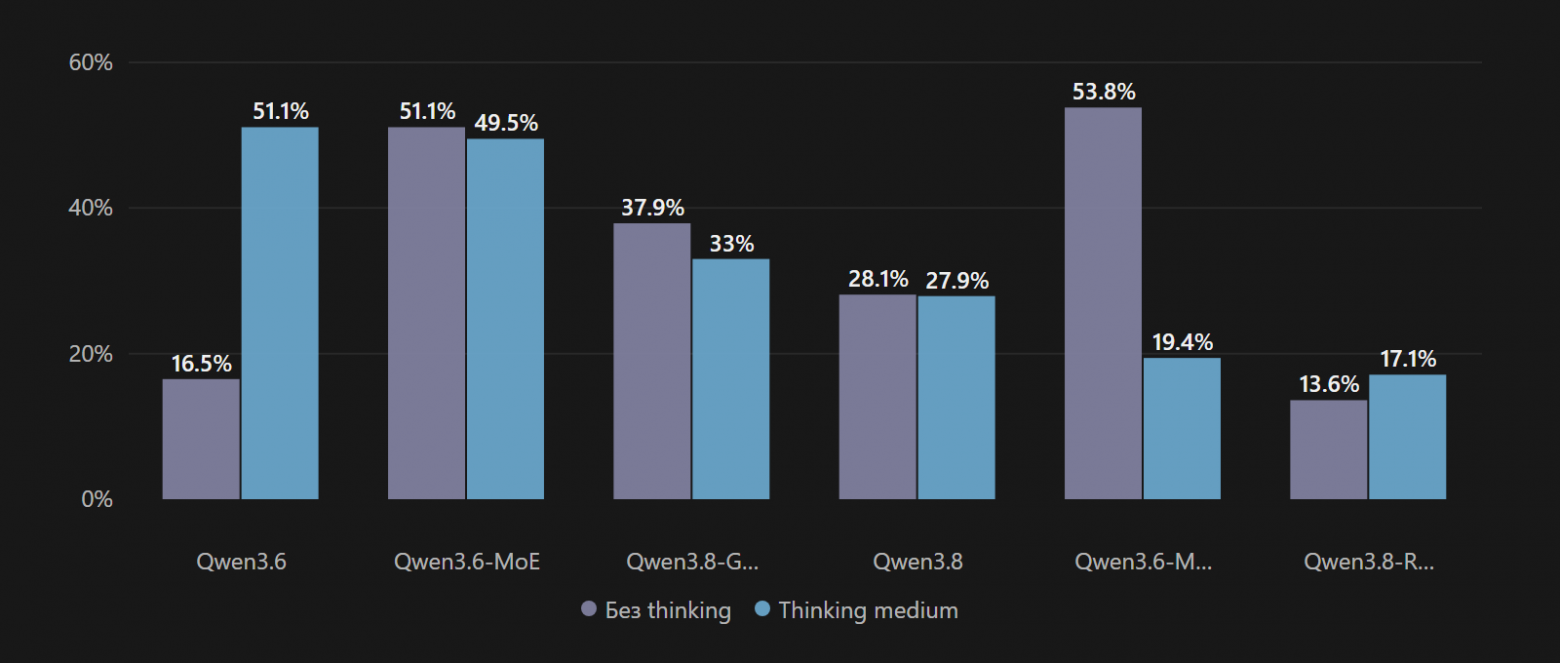
... только для dense версии Qwen3.6. Скачок на 35 п.п. — это очень приятно. Но для меня бесполезно, т.к. даже MoE версия той же модели решила столько же задач вообще без размышлений и намного быстрее. Не говоря уже о результатах REAP20.
Если же говорить о них, то следующий шок — просадка REAP версии MoE Qwen3.6 более, чем в 2 раза. В то время как полная версия просела меньше, чем на 2 п.п. Ну и виновница торжества, Qwen3.8-27B, потеряла значительно меньше процентных пунктов, но это не повод для радости, т.к. данный прогон был затеян в первую очередь исходя из предположения об улучшении её результатов.
Что же привело к таким странным результатам?
Судя по всему, комбо из лени и жадности. Гуглить о том, как сильно "размышления" раздувают контекст и подумать над результатами я поленился, а повысить размер лимита на размышления до максимума — пожадничал.
В итоге, как мы видим на следующем графике, REAP в 2/3 случаев тупо отвалился из-за достижения лимита на длину рассуждений. Т.е. 19% правильных решений вызваны тем, что модели просто не дали додумать мысль до конца. Более того, там, где ей удалось это сделать, она решила 26 задач, которые не осилила в первом эксперименте. Что, в общем-то, не дисквалифицирует её с позиции основного кандидата в "дневную смену".
Доля finish_reason=length. Для 3.8 xhigh это первый прогон итерации 3, до продолжений.
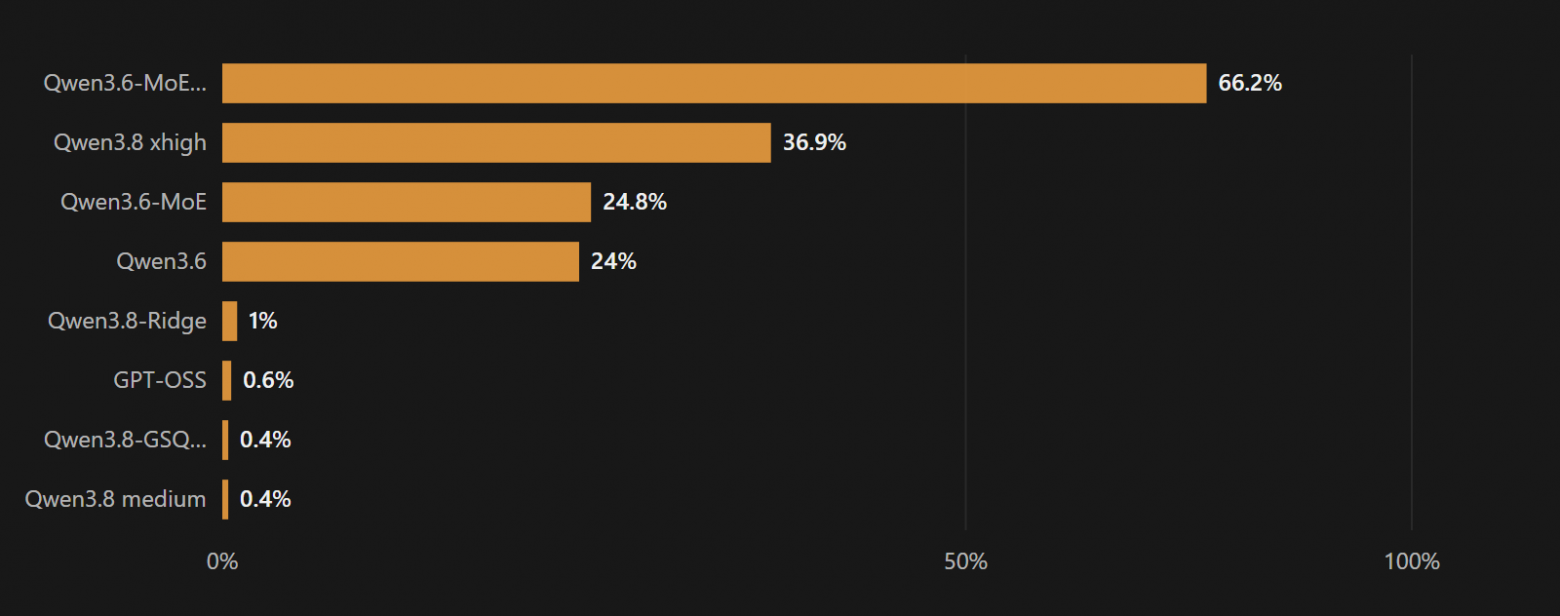
Что касается "ночной смены", то по итогам этой итерации в лидеры выбился Qwen3.6-27B thinking=medium с 51% правильных ответов. Из семейства Qwen3.8 наилучший результат показала версия от GSQ-RCO с 37,9%. Базовая модель с thinking=medium оказалась ниже, но скорее по моей вине: из-за того, что я пожадничал с лимитом на размышления (max_tokens=4096 токенов), она не успела "дорешать" 36,9% задач.
Поэтому мне показалось справедливым исправить этот косяк и подойти к снаряду в 3-й раз, оставив только Qwen3.8-27B в режиме thinking='xhigh' c увеличенным контекстом на рассуждения. По слухам именно в этом режиме данная модель "раскрывается", как молочный улун при проливах в прогретой посуде с температурой воды 80–85°C.
А если хорошо подумать?
Хотите верьте, хотите нет, но в этой попытке исправить свою ошибку, вызванную ленью подумать и жадностью на токены, я ещё больше усугубил проблему. Задним умом теперь я понимаю, что стоило поступить согласно пословице "семь раз отмерь, один отрежь" и выставить лимит на рассуждения в 7/8 от контекстного окна. Но я почему-то решил поступить иначе, итеративно увеличивая лимит токенов на размышление.
То, что второй прогон с включённым thinking занял почти в 10 раз больше времени (107 часов против 12), меня ничему не научило. Поэтому манёвр, предпринятый в третьем прогоне обошёлся мне ещё дороже: в 153 часа. И это ещё с учётом того, что llama.cpp позволяла продолжать рассуждения в ответах, упёршихся в лимит на рассуждения, прямо с того же момента, не генерируя ответ заново. Без данной фукнции мой кривой дизайн считался бы неделями.
Конечно, можно было бы не позориться и умолчать об этом, но что сделано, то сделано и остаётся лишь извлечь из этого какой-нибудь урок.
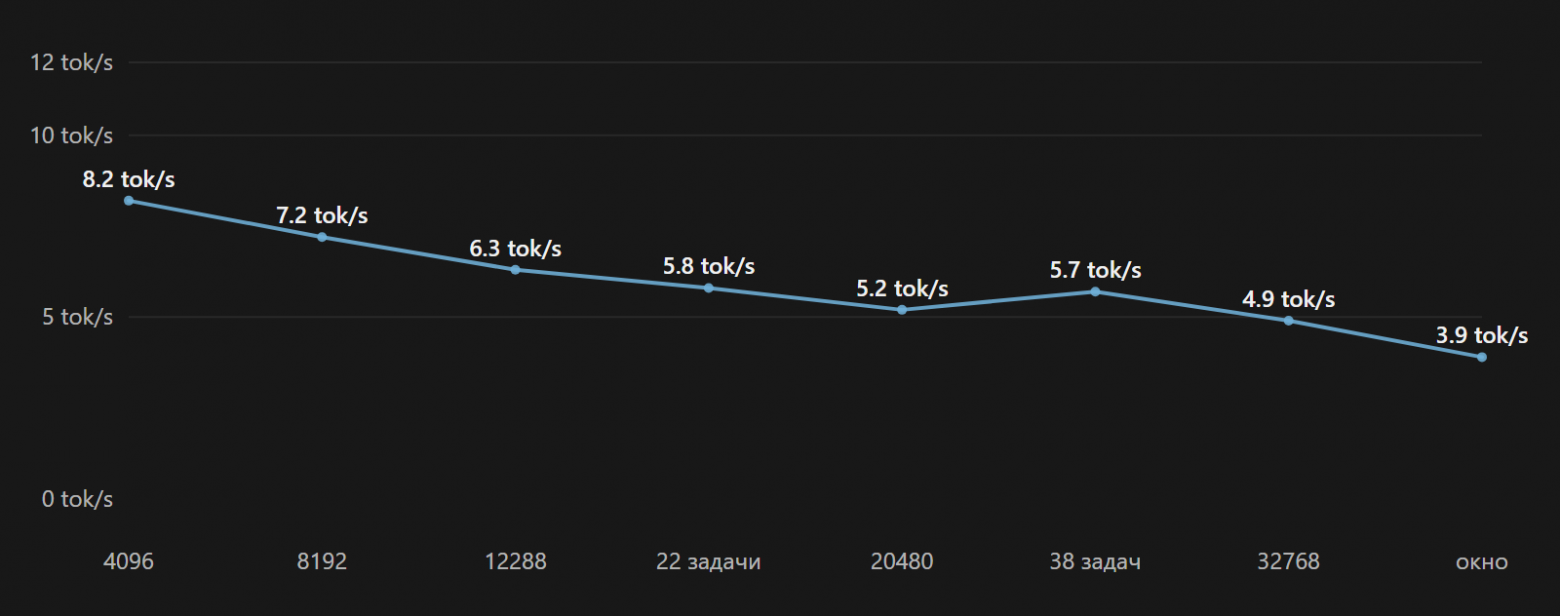
Первый прогон с потолком 4096 дал 173/509 правильных ответах при 188 упёршихся в лимит размышлений. Дальше я итеративно поднимал этот порог удваиванием. На графике ниже присутствуют 2 странные подписи: "22 задачи" и "38 задач". Они означают, что в какой-то момент мне надоело и вместо очередного увеличения лимита я попросил модель сначала взяться за 22 задачи, которые не смогла решить ни одна модель. Из них была решена лишь одна (Numpy 325). "38 задач" — это очередной сабсет из задач, не решённых на предыдущих шагах.
Счёт на всех 509 после каждого шага можно увидеть на графике.
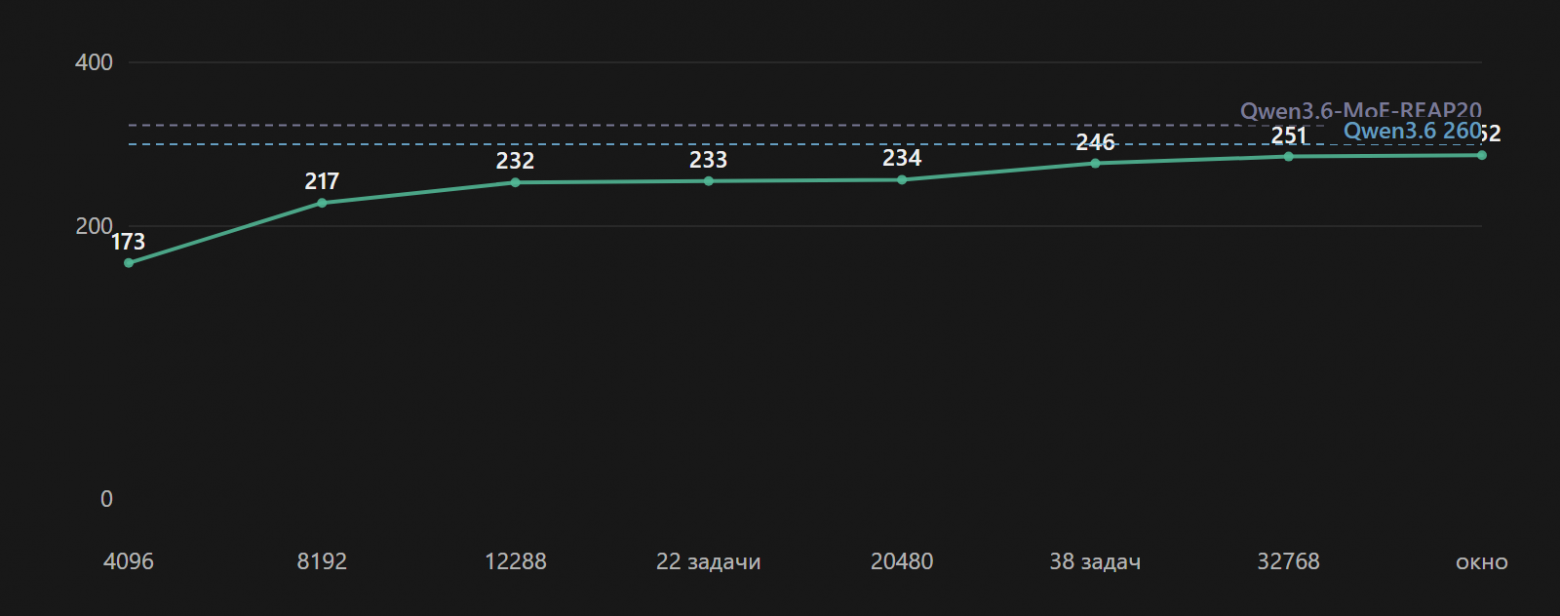
Чистый прирост от 173 к 252, т.е. 79 задач. Две отметки, 233 и 252, сдвигаются на единицу туда-сюда из-за задачу Numpy №325: один и тот же код в 133 символа то проходил тест, то нет. Новых решений в этих двух шагах не было.
Ещё одним уроком для меня стало двухкратное падение скорости по мере роста лимита на размышления. Судя по всему это объясняется ростом префилла но тут уже я вникать не стал, т.к. в будущем подобное повторять не планирую.
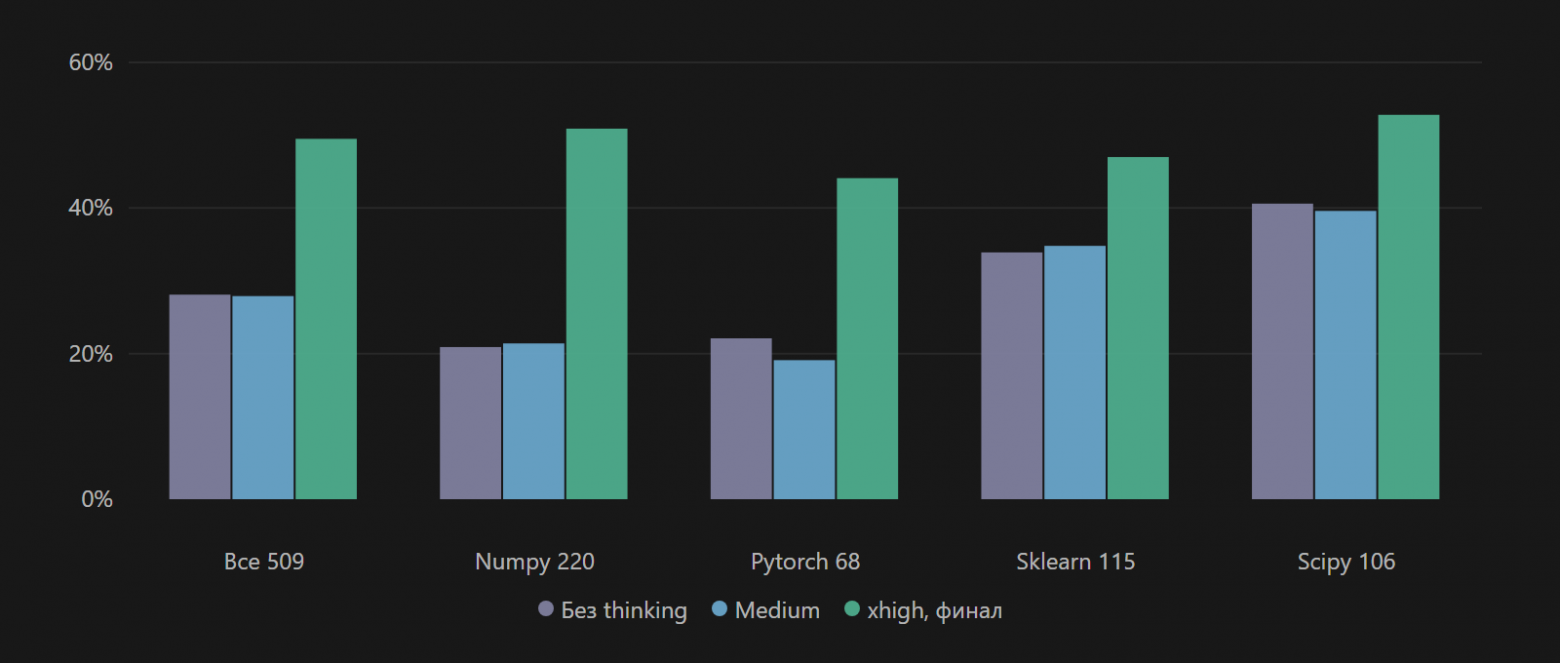
Если посмотреть прирост правильных ответов в разбивке по библиотекам, то видно, что thinking=medium практически идентичен thinking=off и весь прирост получен только за счёт максимально интенсивных рассуждений.
Стоило ли оно того?
Задним умом могу ответить твёрдо и чётко: нет. 150 часов ради того, чтобы получить точность на уровне Qwen3.6-MoE без thinking. Про разницу во времени и говорить нечего.
В общем, данная итерация отбила у меня всякое желание продолжать защиту чести семейства Qwen3.8 и я попросил знакомого запустить DS1000 целиком у себя на Nvidia RTX 6000 Pro с моделью Qwen3.8-Flash-Next-NVFP4.
Результат: 58,1% за 8,5 минут, т.е. уверенное первое место по точности и скорости. Что и требовалось доказать. Можно оправиться и разойтись.
Если бы к этому моменту я уже знал про Strata, то очевидным следующим шагом было бы переключиться на неё, т.к. она позволяет запустить ту самую модель Qwen3.8 в том числе и на игровых GPU.
Но про неё я узнал лишь пару недель назад, поэтому оставшееся время я прокрастинировал написание этого текста, подкидывая всё тот же сабсет из 509 задач в разные модели. Это занятие принесло мне ещё один любопытный результат.
"Размер имеет значение" (c), но "всё не так однозначно" (c).
Когда мне на глаза попалось семейство моделей Flint, я решил оптимизировать порядок тестирования. Я исходил из предположения о том, что увеличение кванта и включение режима размышлений должно приводить к улучшению результатов и поэтому после первого прогона с thinking=off решил для итерации с включённым мышлением отдавать не весь список задач, а только те, которые модель не смогла решить без размышлений.
Начал я с 2-битного кванта, т.к. он влезал целиком. Результат вышел средний (~39%), но скорость в ~130 ток/с приятно удивила, поэтому я решил продолжить тестировать разные кванты. В итоге я прогнал ещё один вариант Q2, а также Q3 и Q6. Результаты от этого улучшились (вплоть до 47% у Q6), но и скорость просела (до 80 ток/с у Q3 и 50 ток/с у Q6). Но удивило меня не это.
Моя предпосылка предполагала, что правильные ответы от кванта Q6 станут супермножеством для правильных ответов всех остальных квантов. Как минимум потому, что он в 2-3 раза больше их. Но не тут-то было:
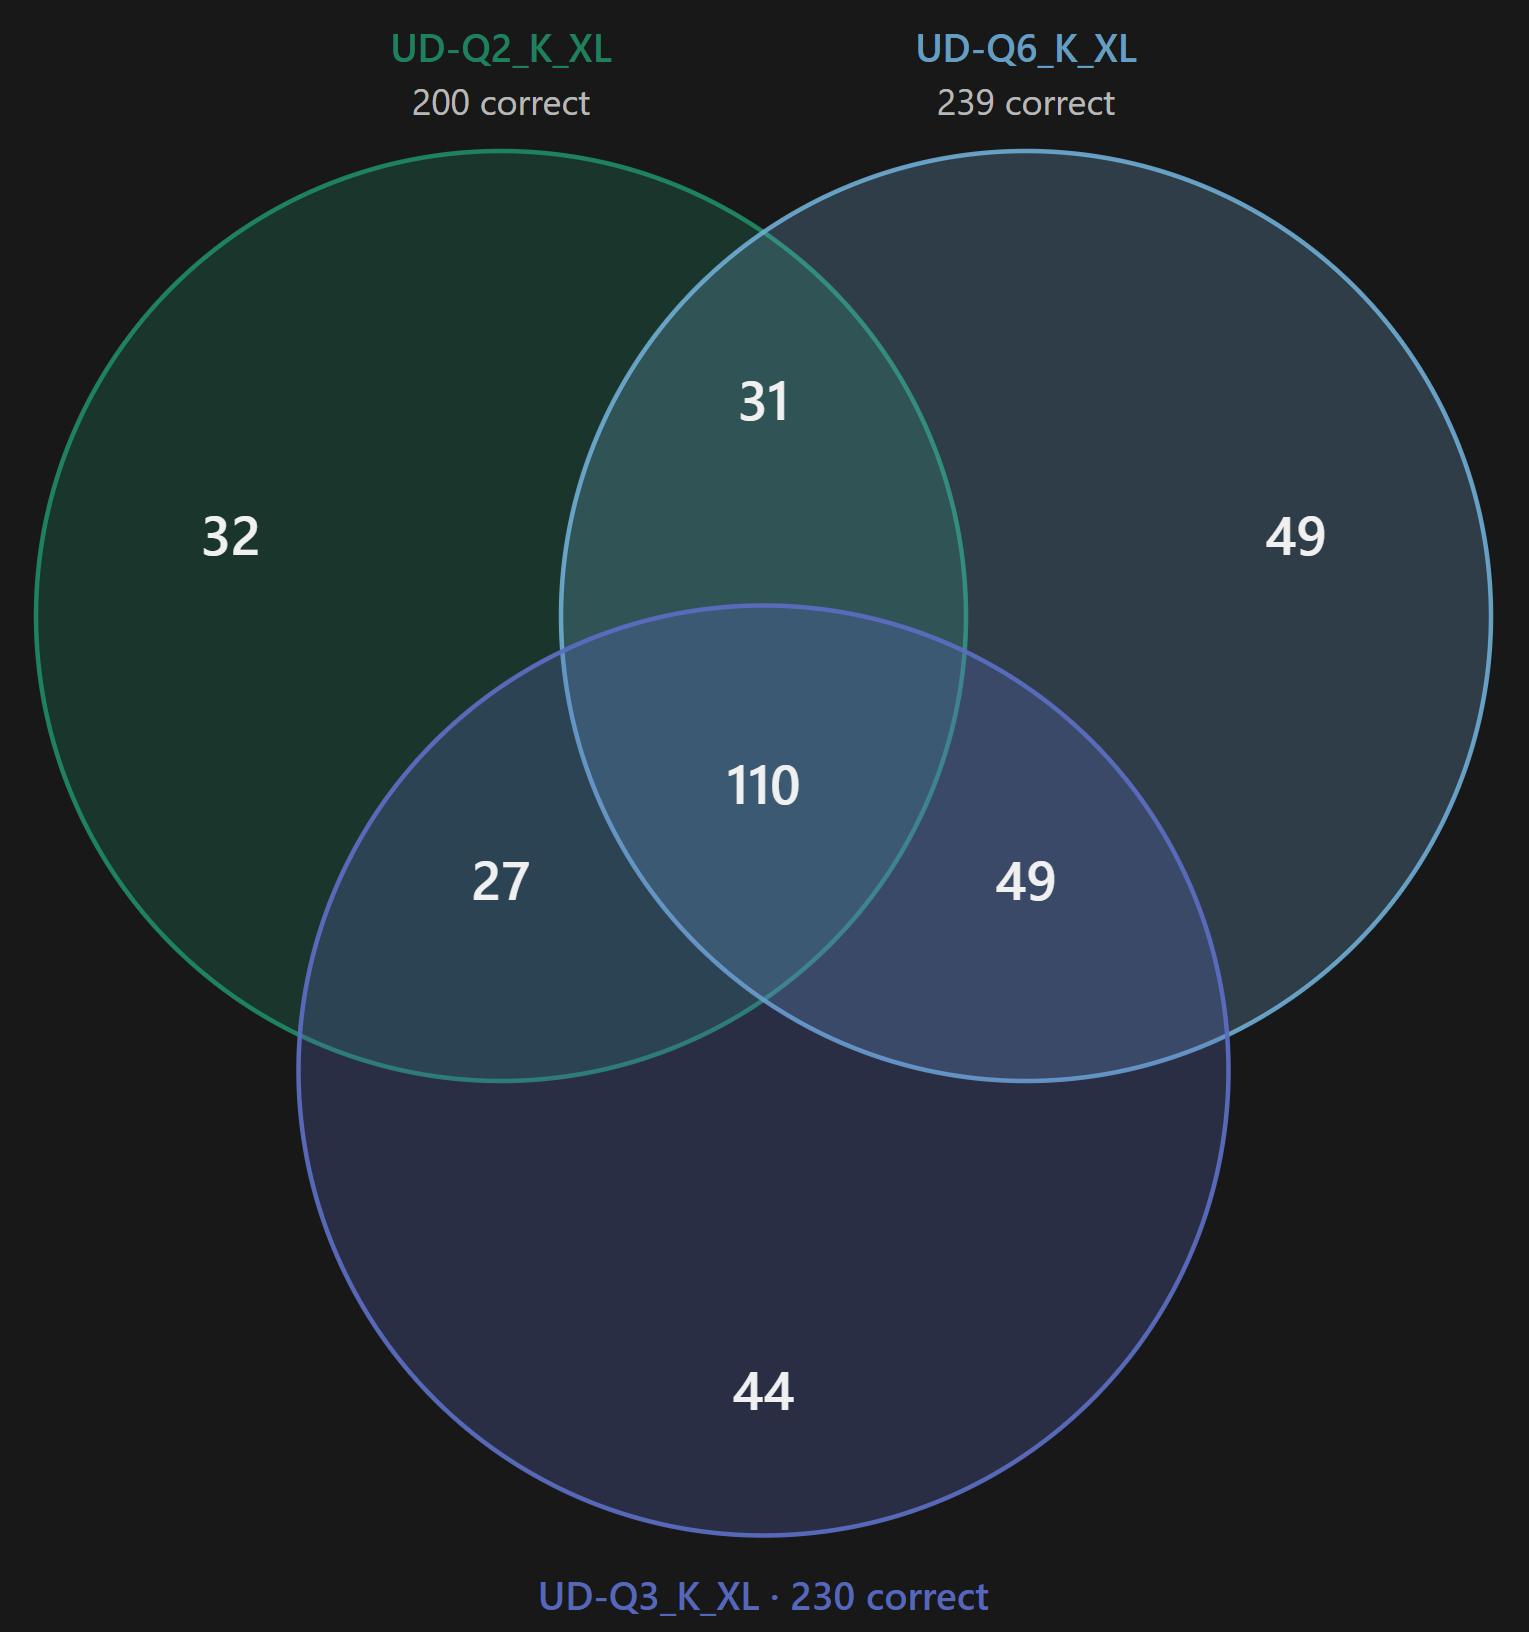
Т.е. мы видим, что даже у Q2 есть в активе 32 задачи, которые не смогла осилить модель Q6. Не самые приятные результаты для тех, кому хочется сократить когнитивные затраты на выбор модели. Вооружившись этим знанием, остальные модели я стал "тупо" прогонять дважды на всём сабсете задач: сначала с thinking=off, а потом с thinking=on.
В результате появился следующий график:
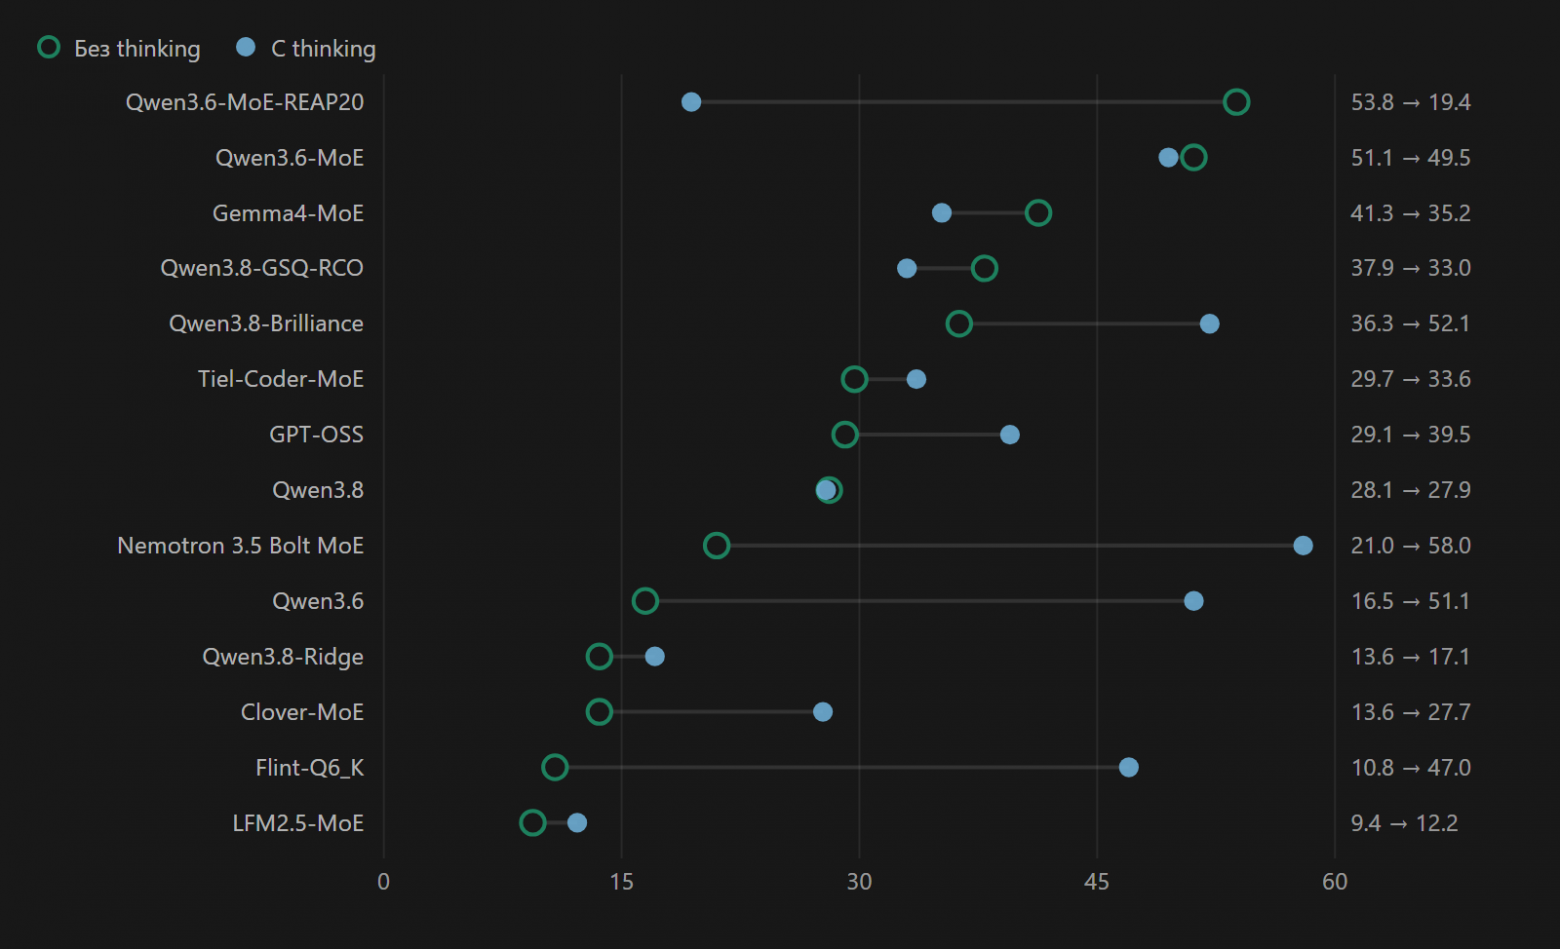
~ 20% моделей ухудшили свои результаты после включения режима рассуждений. Пример Qwen3.6-MoE-REAP20 показал, что это может быть связано не с самим режимом, а с тем, что я пожадничал на лимиты для рассуждений. Но т.к. средний прирост точности от данного режима налицо, закапываться в причинах таких результатов я не стал.
GPT-OSS-20B
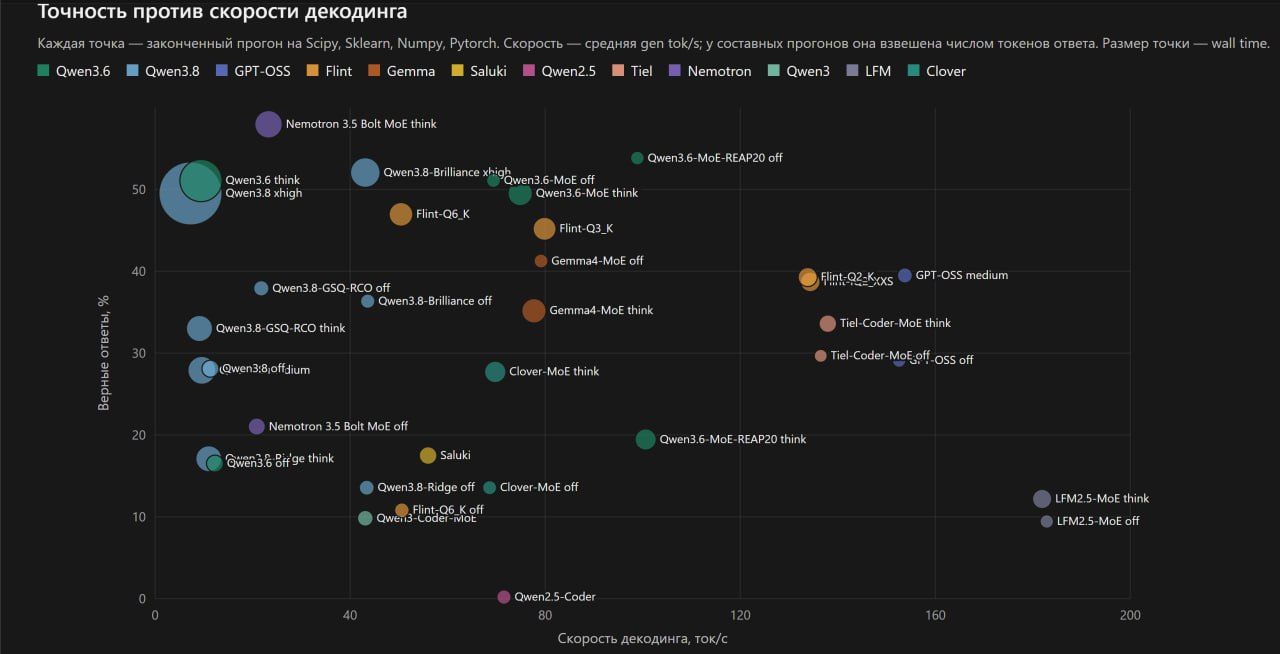
Эту "старушку" многие давно списали со счетов, включая сотрудников OpenAI. По крайней мере мой знакомый оттуда, не рекомендовал её мне для эксперимента, описанного в прошлом посте. Я её держу по одной простой причине: скорость. Что она и продемонстрировала в очередной раз в этом тесте: второе место по скорости и на 1 п.п. выше бездумного Qwen3.8-27B по точности.
Gemma MoE
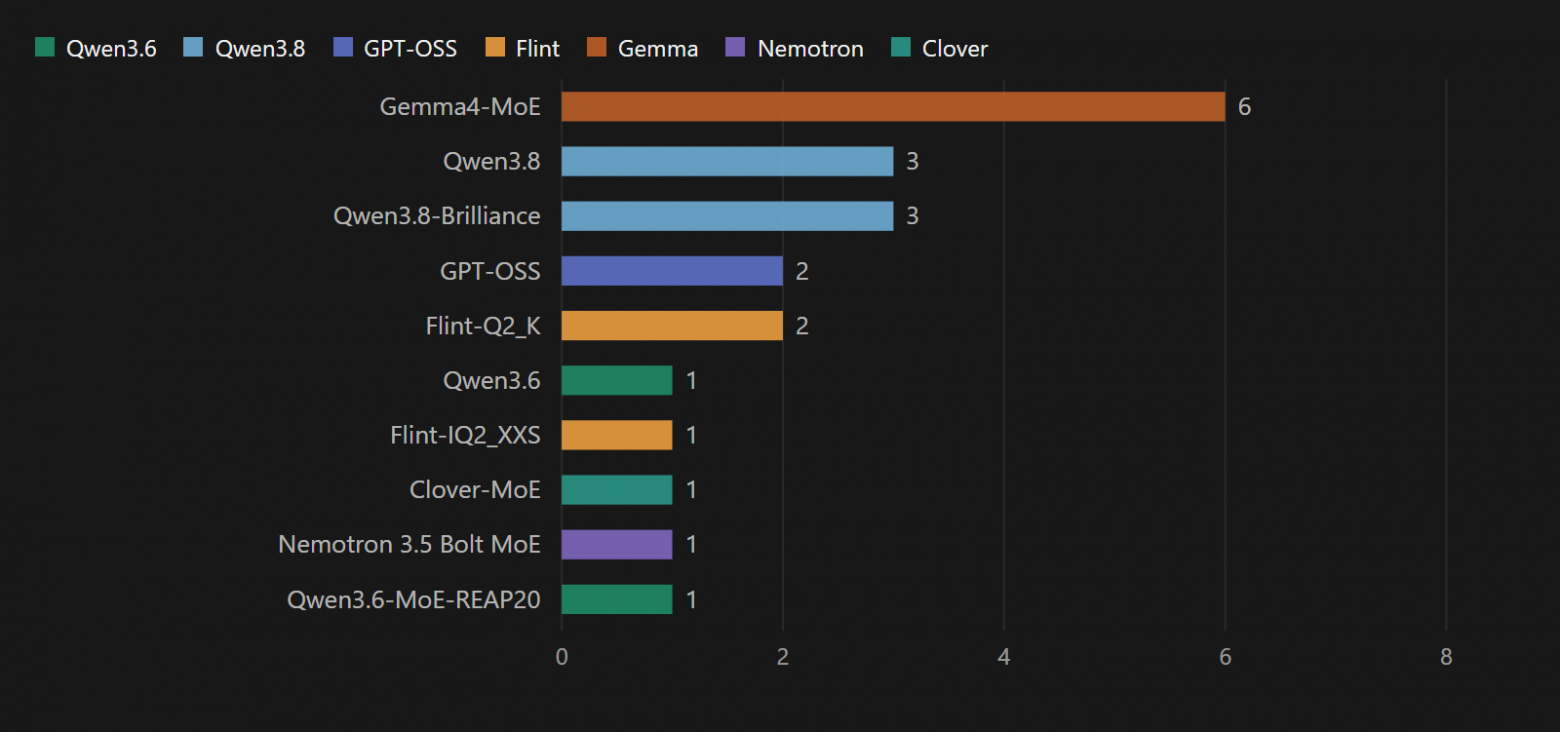
Семейство моделей Gemma4 меня очень сильно разочаровало, когда я пытался найти ему применение на Macbook Air M2 24Gb. Главным образом по скорости генерации токенов, которую никак не удавалось поднять больше ~15 ток/с. Поэтому их версию MoE я запускал без особых ожиданий, просто для статистики. И оказался приятно удивлён соотношением скорости к точности. Также стоит отметить, что эта модель — "рекордсмен" по числу уникальных решённых задач, т.е. тех, что не смогла решить ни одна другая модель.
Nemotron 3.5 Bolt MoE
Главный сюрприз произошёл в самом конце, т.к. эту модель я запустил предпоследней. До этого с моделями от Nvidia сталкивался, но ничем примечательным они себя не проявили. А тут — MoE, поэтому решил попробовать. И не пожалел, т.к. до Qwen3.8-Flash-Next эта модель не дотянула всего 0.1 п.п. Скорость на моём железе, конечно, не блещет, но для "ночной смены" сойдёт. Тем более, что семейство отличается от дневного Qwen3.6-MoE-REAP20.
Qwen3.8-Brilliance xhigh
Последняя модель, которую я прогнал. Делать этого особо не планировал, но переобулся, когда увидел, что там есть вариант, основанный на GSQ-RCO. В дальнейших поисках наиболее быстрой версии Qwen3.8-27B я как раз планировал поближе рассмотреть эти модели, т.к. они успели неплохо показать себя в самом первом прогоне, а тут как раз зверь прибежал к ловцу. Поэтому третьему месту в общем зачёте по точности вкупе с более чем рабочей для "ночной смены" скоростью (~43 ток/с) я удивлён не был и со спокойной душой закончил эксперименты.
Итог
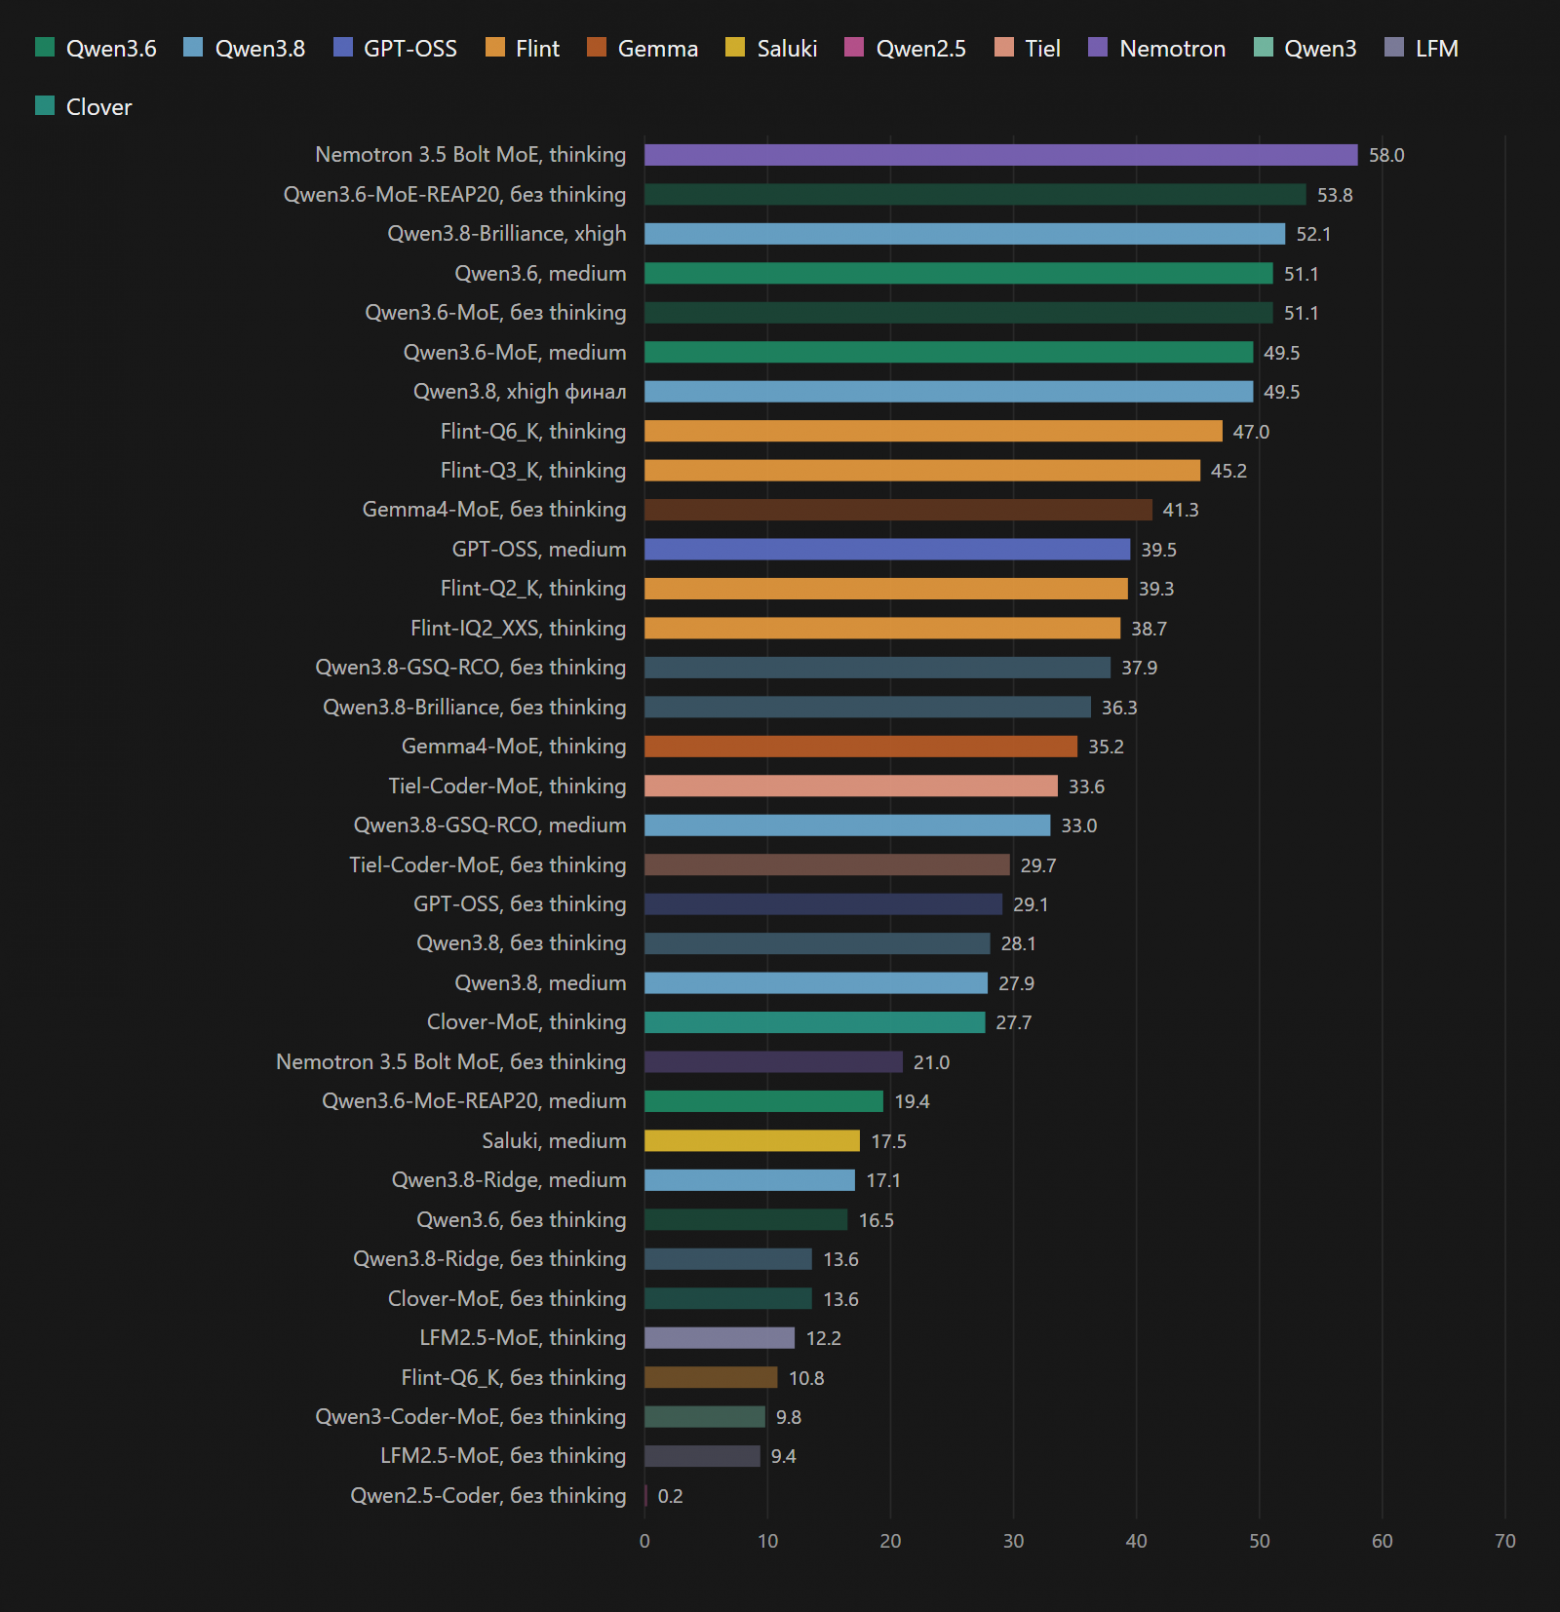
Финальные результаты всех моделей на сабсете из 509 задач можно посмотреть на графиках ниже. Мне к ним больше добавить особо нечего, т.к. прочие детали, включая ссылки на модели, можно посмотреть в моём репозитории.
Сокращённое имя модели | Имя модели на диске | % решённых задач thinking = off | % решённых задач thinking = on | средняя скорость tok/s | wall time thinking = off | wall time thinking = on |
|---|---|---|---|---|---|---|
Qwen3.6-MoE-REAP20 | Qwen3.6-28B-REAP20-A3B-Q4_K_M.gguf | 53.8% | 19.4% | 99.8 | 12 мин | 5.1 ч |
Qwen3.6-MoE | Qwen3.6-35B-A3B-UD-Q4_K_M.gguf | 51.1% | 49.5% | 72.1 | 15 мин | 9.3 ч |
Qwen3.8-GSQ-RCO | Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp.gguf | 37.9% | 33.0% | 15.4 | 43 мин | 12.1 ч |
Qwen3.8 | Qwen3.8-27B-UD-Q4_K_M.gguf | 28.1% | 27.9% | 10.5 | 1.6 ч | 15.1 ч |
Qwen3.8-xhigh | Qwen3.8-27B-UD-Q4_K_M.gguf | 28.1% | 49.5% | 9.3 | 1.6 ч | 152.6 ч |
Qwen3.6 | Qwen3.6-27B-UD-Q4_K_XL.gguf | 16.5% | 51.1% | 10.8 | 1.6 ч | 53.7 ч |
Qwen3.8-Ridge | Qwen3.8-27B-Ridge-3.7bpw.gguf | 13.6% | 17.1% | 27.2 | 36 мин | 11.7 ч |
Qwen3.8-Brilliance | Qwen3.8-27B-Turbo-Brilliance-50X-RI-GSQ-RCO-IQ3_S-mtp.gguf | 36.3% | 52.1% | 43.4 | 23 мин | 18.5 ч |
Qwen3-Coder-MoE | Qwen3-Coder-30B-A3B-Instruct-Q4_K_M.gguf | 9.8% | — | 43.1 | 53 мин | — |
GPT-OSS | gpt-oss-20b-Q8_0.gguf | 29.1% | 39.5% | 153.2 | 9 мин | 38 мин |
Flint-IQ2_XXS | flint-UD-IQ2_XXS.gguf | — | 38.7% | 134.4 | — | 3.6 ч |
Flint-Q2_K | flint-UD-Q2_K_XL.gguf | — | 39.3% | 133.8 | — | 3.1 ч |
Flint-Q3_K | flint-UD-Q3_K_XL.gguf | — | 45.2% | 79.9 | — | 7.3 ч |
Flint-Q6_K | flint-UD-Q6_K_XL.gguf | 10.8% | 47.0% | 50.5 | 28 мин | 8.2 ч |
Gemma4-MoE | gemma-4-26B-A4B-it-UD-Q4_K_M.gguf | 41.3% | 35.2% | 78.4 | 17 мин | 9.2 ч |
Saluki | Underdog-Saluki-27B-1.0-IQ2-mix.gguf | — | 17.5% | 56.0 | — | 2.0 ч |
Tiel-Coder-MoE | Tiel-Coder-35B-A3B-MTP-UD-IQ3_S.gguf | 29.7% | 33.6% | 137.2 | 6 мин | 1.9 ч |
Nemotron 3.5 Bolt MoE | NVIDIA-Nemotron-3.5-Bolt-74B-A9B-UD-Q3_K_XL.gguf | 21.0% | 58.0% | 22.1 | 1.7 ч | 14.4 ч |
LFM2.5-MoE | LFM2.5-24B-A2B-UD-Q4_K_XL.gguf | 9.4% | 12.2% | 182.4 | 10 мин | 3.3 ч |
Clover-MoE | Diffuspace-Clover-35B-A3B-Preview-Q4_K_M.gguf | 13.6% | 27.7% | 69.2 | 19 мин | 5.4 ч |
Qwen2.5-Coder | Qwen2.5-Coder-7B-Instruct-Q8_0.gguf | 0.2% | — | 71.5 | 23 мин | — |
Выводы
Главное, что я для себя вынес из этих экспериментов, это неоднозначность влияния размера квантов и режима рассуждений на результаты. С чем это связано, я пока не знаю и не уверен, что готов разбираться.
В практическом плане для собственной работы с LLM я попробую работать в "дневную смену" с выключенным thinking (у модели, не у меня), включая его на ночь, чтобы модель Code-Reviewer, могла сравнивать написанный код со спекой и тикетами, неспешно размышляя над увиденным.
С точки зрения конкретных моделей план пока такой:
"Дневная смена": Qwen3.6 MoE REAP20.
"Ночная смена": Nemotron
Если будут интересные результаты — отпишусь.
P.S. На вопрос "А не проще ли заплатить $ХХ за Cursor/Claude etc." отвечу парафразом Ольги Игоревны Бузовой: "Зачем платить, если можно не платить?"
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.