Как научить BERT «понимать» науку: гибридная классификация научно‑технических текстов с графами знаний
Способ обогатить языковую модель фактологией без модификации механизма внимания, потери глобального контекста и квадратичной сложности инференса
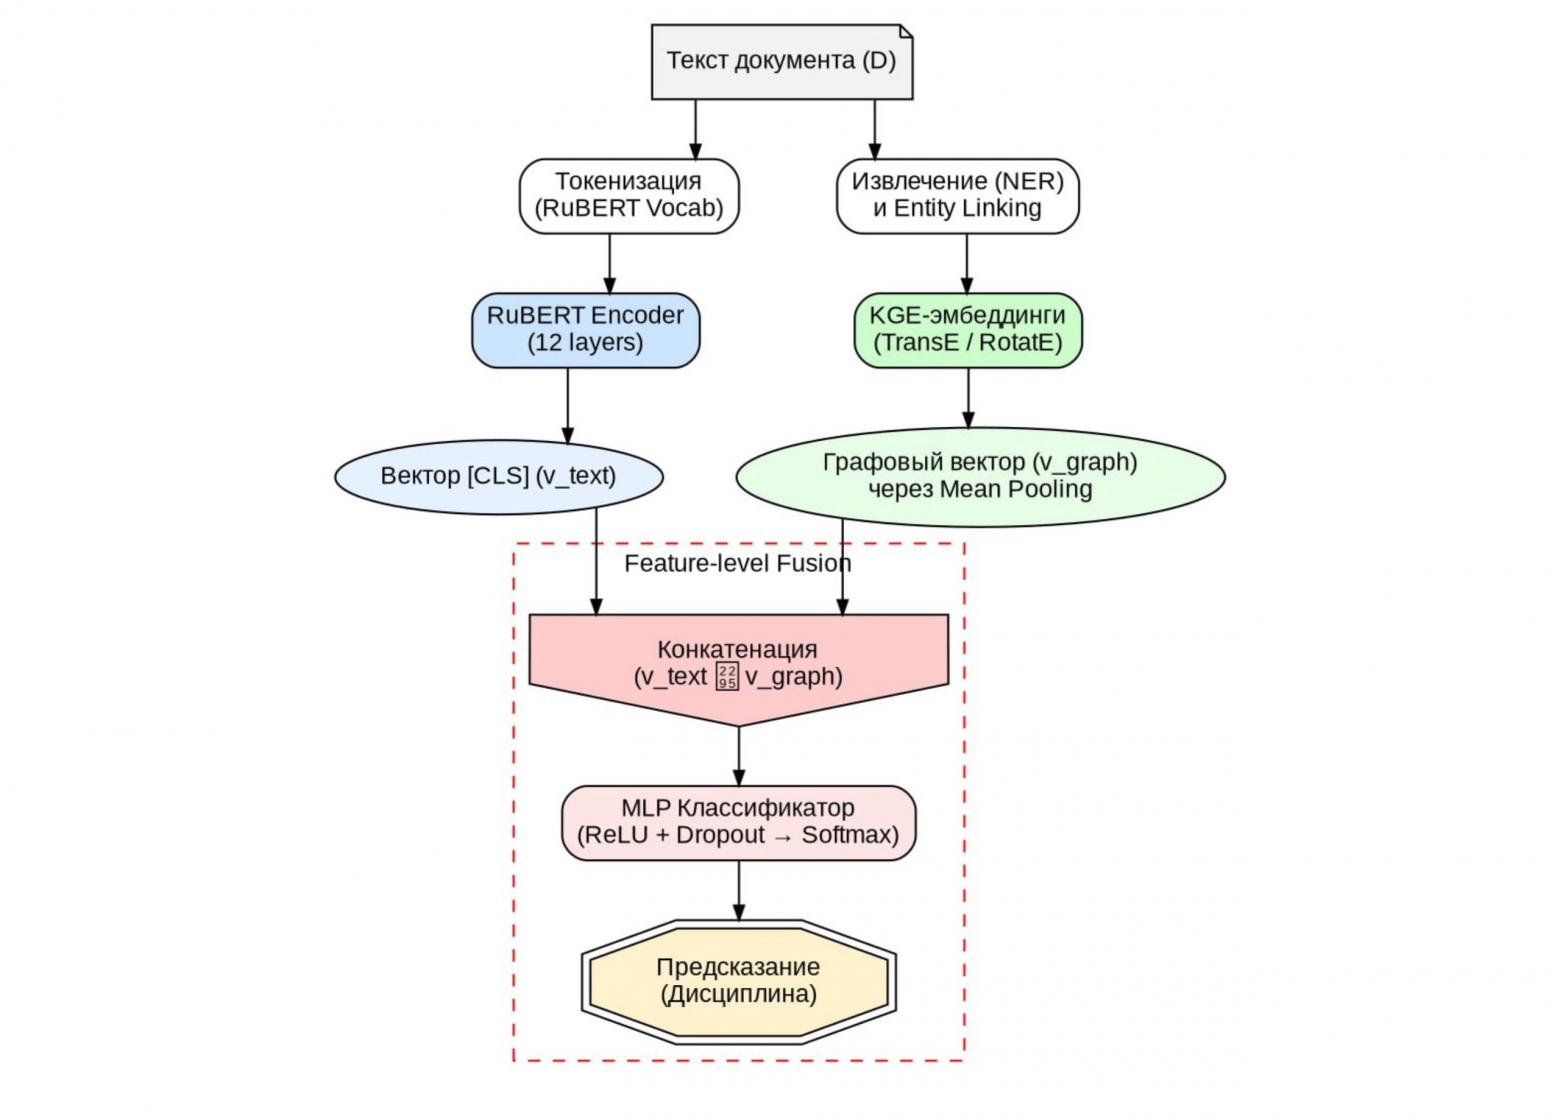
Трансформеры отлично улавливают контекст, но не обладают фактологическими знаниями: они не знают явно, что «метод опорных векторов» — это алгоритм классификации. Существующие способы прямой интеграции графа знаний в механизм внимания трансформера (такие как K‑BERT или ERNIE) требуют значительных вычислительных ресурсов со сложностью  , вносят семантический шум и жестко упираются в лимит в 512 токенов, что критично для объемных научных статей. В данном материале предлагается альтернативный, вычислительно эффективный путь. Идея состоит в том, чтобы заранее вычислить эмбеддинги узлов графа с помощью алгоритмов вроде TransE, RotatE или node2vec, а на этапе инференса извлекать их по ключу за время
 и объединять с вектором RuBERT перед итоговым классификатором. Ниже мы разберем специфику предметной области, сравним существующие архитектуры и опишем математику гибридного метода слияния модальностей.
Зачем всё это
Научных публикаций становится экспоненциально больше. Вручную рубрицировать и индексировать их уже невозможно, поэтому острая потребность в автоматической классификации очевидна. Казалось бы, можно взять классический BERT, дообучить его на размеченных статьях и получить отличный результат. Для текстов общей тематики так и есть. Но научно‑технические тексты устроены иначе: они содержат узкоспециализированную терминологию, редкие сущности и сложные концептуальные связи, которые слабо отражаются в базовой статистике совместной встречаемости слов.
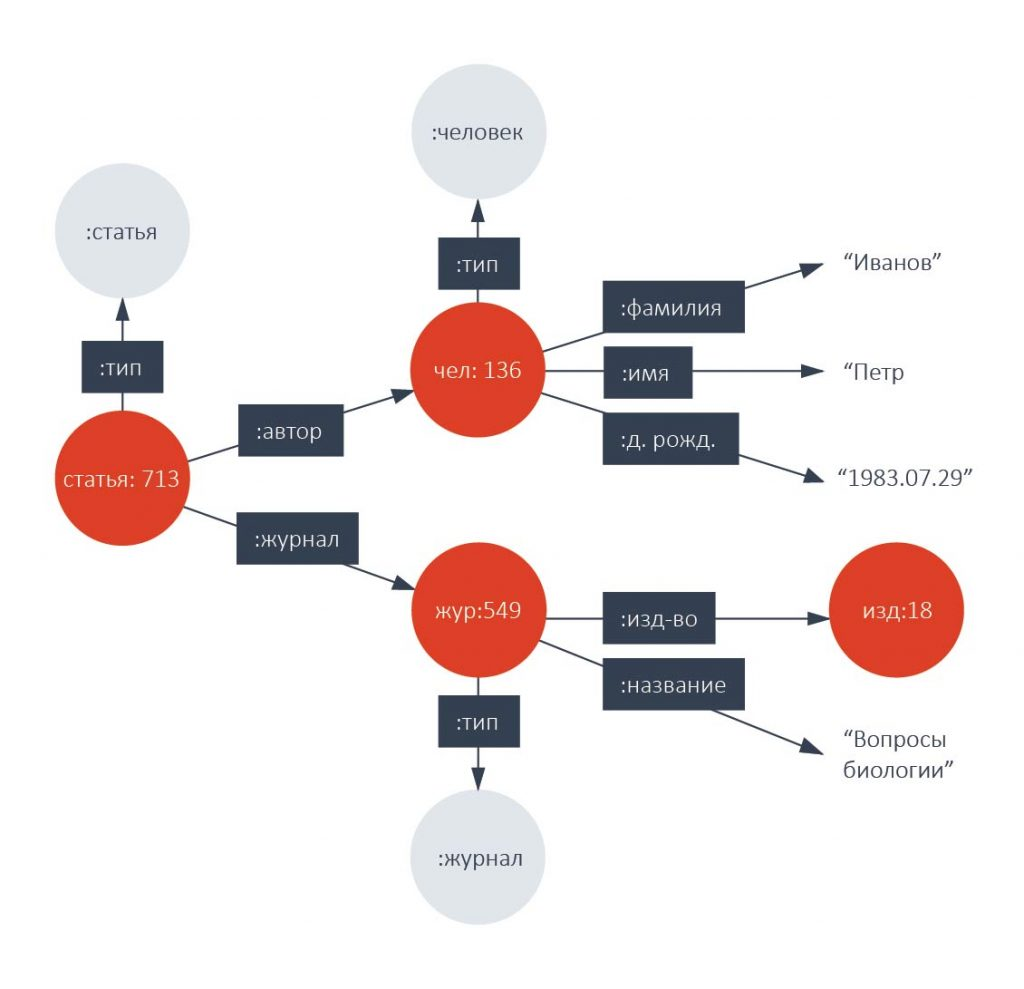
Трансформер учится на распределении токенов. Он может «знать», что «градиентный спуск» и «оптимизация» часто стоят рядом, но явного понимания того, что первое является разновидностью второго, у него нет. При столкновении с междисциплинарными терминами или текстами с дефицитом контекста одних статистических паттернов не хватает. Граф знаний, напротив, хранит такие связи явно в виде семантических триплетов, состоящих из субъекта, отношения и объекта. Интеграция этой верифицируемой онтологии в процесс дообучения языковых моделей позволяет преодолеть слепоту трансформеров к фактам. Вопрос заключается лишь в том, как передать эти знания модели, не потеряв скорость инференса и не обрезав половину статьи из‑за лимитов памяти.
Часть 1. Что уже есть (и почему это не подходит)
1.1. SciBERT и проблема сдвига предметной области
Оригинальный BERT обучался на Википедии и BookCorpus, что охватывает преимущественно общую лексику. Попытка применить его к науке вызывает так называемый сдвиг предметной области (domain shift). Стандартный алгоритм токенизации WordPiece разбивает сложные термины на бессмысленные фрагменты, теряя их семантику. В качестве решения был предложен SciBERT, предобученный на 1,14 млн полных текстов научных статей. Его главное отличие — специализированный словарь SciVocab, построенный с нуля на научном корпусе. Он сохраняет целостность терминов, давая заметный прирост метрик в научных задачах.
Однако у SciBERT есть существенные ограничения. Во‑первых, это проблема языка и морфологии: для русскоязычных научно‑технических текстов эффективнее использовать RuBERT, который заметно превосходит мультиязычные аналоги на локальных задачах. Во‑вторых, сохраняется проблема отсутствия фактологии. Модель по‑прежнему опирается только на контекстную статистику и не имеет доступа к структурированным онтологиям.
1.2. K‑BERT: знания прямо в механизм внимания
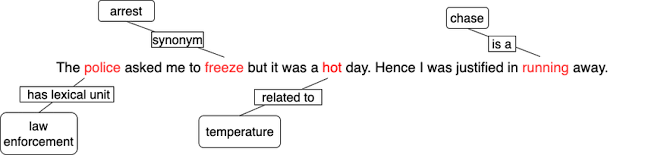
Архитектура K‑BERT осуществляет инжекцию знаний непосредственно в процесс обработки последовательности. Алгоритм находит в тексте сущности, извлекает их триплеты из графа и подшивает к предложению, превращая его в дерево. Это достигается за счет внедрения soft‑position embedding, где токены знаний получают позиционные индексы, продолжающие индекс базового слова, и матрицы видимости (visible matrix), которая ограничивает вычисление весов внимания только рамками своего предложения и своей ветви знаний, предотвращая семантический шум.
Несмотря на элегантность, для длинных научных текстов этот подход скрывает критические минусы. Рост последовательности за счет триплетов делает квадратичную сложность self‑attention неподъемной. Стандартный лимит в 512 токенов исчерпывается мгновенно, вынуждая обрезать глобальный контекст статьи. Кроме того, возникает проблема Entity Linking: если составной термин привязывается к неверному узлу графа, эта ошибка через механизм внимания напрямую отравляет векторное представление всего текста.
1.3. ERNIE: знания на этапе предобучения
Модель ERNIE интегрирует знания иначе. Вместо случайного маскирования отдельных токенов применяется многогранное маскирование целых именованных сущностей. Для их восстановления модель обращается к текстовым описаниям из базы знаний, выравнивая текстовое пространство и пространство сущностей.
Главный минус такого подхода для нашей задачи — игнорирование топологии графа. Сущности служат лишь источником текстов, тогда как иерархия и типы связей (например, наследование или модификация методов) модели остаются невидимыми. К тому же в узких научных доменах у многих специфических терминов попросту нет подробных энциклопедических описаний для маскирования.
Из краткого обзора становится ясно, что интеграция графов напрямую внутрь трансформера — процесс дорогой и хрупкий. Гораздо целесообразнее использовать двухпоточную архитектуру: оставить внутренности языковой модели в покое и обогащать ее выход уже готовыми графовыми эмбеддингами.
Часть 2. Как векторизовать граф знаний (KGE)
Идея заключается в том, чтобы заранее обучить эмбеддинги узлов графа. На этапе инференса останется лишь операция поиска вектора по ключу (lookup), что дает сложность на сущность без необходимости запускать тяжелые графовые нейронные сети (GNN) в реальном времени.
2.1. TransE
Алгоритм TransE интерпретирует отношения как трансляцию (сдвиг) в латентном векторном пространстве. Для триплета  модель обучается таким образом, чтобы выполнялось условие
 . Обучение идет через ранжирование с зазором (margin‑based ranking), минимизируя следующую функцию потерь:
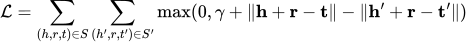
где  — это margin (зазор), а
 — норма (обычно
 или
 ).
2.2. RotatE
Подход RotatE переносит векторы в комплексное пространство  . Отношение в этом случае становится вращением вектора головы с использованием поэлементного произведения Адамара:

На компоненты вектора отношения накладывается строгое ограничение  . Это позволяет параметризовать их через фазовые углы как
 . Такой подход позволяет модели корректно отражать симметричные (поворот на
 ), антисимметричные, обратные отношения и логические цепочки, что для построения научных иерархий и онтологий имеет критическое значение.
2.3. node2vec
В отличие от трансляционных моделей, алгоритм node2vec отталкивается от топологической близости. Он генерирует последовательности узлов через управляемые случайные блуждания и применяет Skip‑gram для получения плотных эмбеддингов. Поведение алгоритма балансируется между поиском в ширину (BFS) и глубину (DFS) с помощью параметра возврата  , который контролирует вероятность немедленного возврата в предыдущий узел, и параметра
 , определяющего вероятность исследования новых удаленных областей. Этот метод не требует явного задания типов отношений, поэтому он отлично подходит для выявления структурных кластеров тесно связанных концептов в графах со слабой разметкой.
Часть 3. Как склеивать модальности
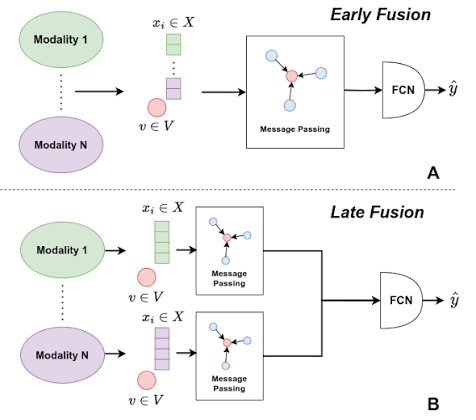
Разработка гибридного классификатора требует обращения к таксономии мультимодального машинного обучения. Исторически сложились три подхода к слиянию (fusion). Раннее слияние подразумевает объединение сырых данных, что часто ломает внутреннюю геометрию предобученных пространств. Позднее слияние предполагает независимую обработку моделей с ансамблированием их финальных решений, из‑за чего модальности лишены возможности взаимодействовать на этапе извлечения признаков.
Для нашей задачи наиболее оптимальным является слияние на уровне признаков (feature‑level fusion). При таком подходе предобученные пространства остаются нетронутыми, а промежуточные векторные представления объединяются перед финальным многослойным перцептроном (MLP). Это позволяет классификатору выучить нелинейные взаимодействия между текстовым контекстом документа и топологической структурой графа. Эмпирические исследования подтверждают, что обогащение токена [CLS] предобученными эмбеддингами существенно повышает точность без затрагивания механизма внимания.
Часть 4. Математика и архитектура метода
4.1. Общая постановка
Наша цель — построить отображение, где  — множество документов, а
 — множество целевых научных дисциплин. Предлагаемая архитектура разделена на текстовый и графовый потоки.
4.2. Текстовый поток
Каждый документ токенизируется словарем RuBERT с добавлением служебных токенов, формируя последовательность 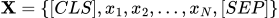 , где
 — длина последовательности. Модель выдает матрицу скрытых состояний
 . Единое контекстное представление текста извлекается из токена
[CLS]:
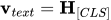
Параллельно модуль NER извлекает из текста множество научных концептов 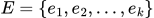 .
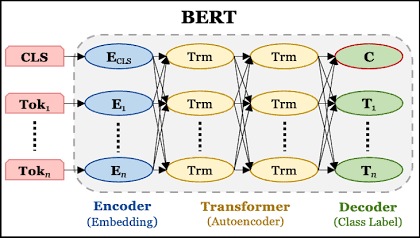
Архитектура RuBERT полностью наследует структуру классического BERT (двунаправленный энкодер). Ключевое отличие заключается в русскоязычном словаре токенизатора и весах, дообученных командой DeepPavlov. Токен [CLS], проходя через слои внимания, агрегирует глобальный контекст документа — именно его вектор мы будем извлекать для слияния с графом.
4.3. Графовый поток
Граф знаний  заранее векторизован функцией вложения
 . Для каждой найденной в тексте сущности
 производится связывание с узлом графа (Entity Linking). Из связанных сущностей формируется единый графовый вектор путем усреднения (mean pooling):
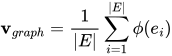
Если сущностей в тексте не найдено, вектор  инициализируется нулевым вектором
 , и классификатор гибко опирается только на текстовые данные. Операция усреднения делает агрегацию независимой от порядка упоминаний терминов в статье.
4.4. Слияние и классификация
Полученные векторы конкатенируются ( ) в единое совместное представление:
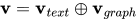
Далее объединенный вектор проходит через MLP со скрытым слоем (функция активации ReLU и слоем Dropout) и выходным слоем Softmax:
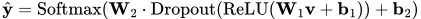
Оптимизация параметров итоговой модели осуществляется минимизацией кросс‑энтропии с помощью алгоритма AdamW.
4.5 изации на PyTorch
Для наглядности приведем базовый архитектурный набросок модели:
import torch
import torch.nn as nn
from transformers import AutoModel

class HybridClassifier(nn.Module):
    def __init__(self, kg_embeddings: torch.Tensor, num_classes: int,
                 hidden: int = 256, p: float = 0.3,
                 bert_name: str = "DeepPavlov/rubert-base-cased"):
        super().__init__()
        self.bert = AutoModel.from_pretrained(bert_name)

        # Предвычисленные эмбеддинги узлов графа: заморожены, O(1) lookup
        self.kg = nn.Embedding.from_pretrained(kg_embeddings, freeze=True, padding_idx=0)
        d_kg = kg_embeddings.size(1)

        self.fc1 = nn.Linear(768 + d_kg, hidden)
        self.drop = nn.Dropout(p)
        self.fc2 = nn.Linear(hidden, num_classes)

    def forward(self, input_ids, attention_mask, entity_ids, entity_mask):
        # Текстовый поток: вектор токена [CLS]
        v_text = self.bert(input_ids=input_ids,
                           attention_mask=attention_mask).last_hidden_state[:, 0]

        # Графовый поток: lookup + mean pooling
        emb = self.kg(entity_ids)                       # [B, K, d_kg]
        mask = entity_mask.unsqueeze(-1).float()        # [B, K, 1]
        summed = (emb * mask).sum(dim=1)
        count = mask.sum(dim=1).clamp(min=1.0)
        v_graph = summed / count                        # Нули, если сущностей нет

        # Feature-level fusion и классификация
        v = torch.cat([v_text, v_graph], dim=-1)
        h = torch.relu(self.fc1(v))
        return self.fc2(self.drop(h))
Часть 5. Преимущества, ограничения и план экспериментов
Предложенный метод имеет ряд архитектурных преимуществ. Во‑первых, это скорость: вычислительная сложность графового потока составляет  на сущность. Архитектура избавляет от необходимости модифицировать тяжелый механизм внимания или запускать GNN на этапе инференса. Во‑вторых, метод эффективно инкапсулирует сложные структурные паттерны науки прямо в плотный вектор. В‑третьих, он обеспечивает высокую устойчивость к ошибкам. Неточность в модуле Entity Linking для отдельной сущности просто усредняется с остальными векторами, а не ломает глобальный контекст предложения, как это происходит в моделях с прямой инжекцией триплетов.
Так как научные датасеты зачастую сильно несбалансированы, в качестве целевой метрики в экспериментах будет использоваться Macro F1-score, которая чувствительна к миноритарным классам. Дополнительно будут отслеживаться Micro F1, Accuracy и скорость инференса (в миллисекундах на документ). В качестве базлайнов для сравнения выступят классические методы (TF‑IDF в связке с Logistic Regression или SVM), базовая модель RuBERT (для оценки чистого вклада графа), а также K‑BERT и ERNIE (для анализа баланса между качеством классификации и скоростью инференса). Главным критерием успеха станет прирост Macro F1 по сравнению с базовым RuBERT при сохранении времени инференса, превосходящем тяжелые гибридные архитектуры.
Выводы
Классификация научно‑технических текстов требует глубокого понимания предметной области, фактологии и терминологической иерархии, чего лишены обычные статистические языковые модели. Базовые трансформеры, даже после узкоспециализированного дообучения, остаются слепы к строгим онтологическим связям. Попытки же интегрировать эти связи напрямую через модификацию механизма внимания оборачиваются катастрофическим ростом вычислительной сложности и несовместимы с объемными статьями.
Рассмотренная гибридная архитектура предлагает аккуратный и легковесный компромисс. Она базируется на строгом разделении труда: трансформер извлекает глубокий семантический контекст документа, а граф знаний снабжает систему дешевой фактологией за счет предвычисленных KGE‑эмбеддингов. Слияние на уровне признаков позволяет безопасно объединить эти модальности перед итоговой классификацией без перегрузки self‑attention. В теории такой подход дает лучшее от обоих: гибкость нейросетей и верифицируемую строгость онтологий. Архитектура обещает быть точной и достаточно быстрой для внедрения в высоконагруженные системы агрегаторов научных библиотек. Остается лишь проверить, насколько эта математическая теория совпадет с практическими результатами.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.