Le roman phénomène de la rentrée littéraire est accusé d’être généré par IA : pourquoi on ne pourra jamais savoir ?
C’était ça ou mourir, le roman de Thélyson Orélien, est accusé d’avoir été rédigé par IA. En cause : plusieurs passages classés « 100% IA » par le détecteur Pangram.
Les LLM sont des technologies probabilistes et c’est tout le problème de la polémique littéraire du moment.
Depuis sa sortie, C’était ça ou mourir connaît un véritable engouement de la part des critiques. Prix Fnac, prix Méduse, prix Première Plume, fortement pressenti pour le Renaudot, en lice pour le Goncourt, le roman de Thélyson Orélien, qui s’apprête à être traduit dans plusieurs langues, est l’un des incontournables de la rentrée.
Sauf que, sur X, l’ambiance est tout autre. Notamment depuis le 21 septembre et la publication du compte Balance ton Claude, qui accuse le manuscrit d’avoir été « presque intégralement » écrit par une intelligence artificielle.
La preuve, présentée comme quasi irréfutable, repose sur le score obtenu par certains passages soumis à Pangram, un détecteur de textes générés par IA. L’entreprise qui édite l’outil revendique un taux de faux positifs extrêmement bas, avec environ un texte humain mal classé sur 24 400.
Avez-vous entendu parler de ce roman ? C’est le « phénomène de la rentrée littéraire ». Il est lauréat du Prix Fnac, du Prix Méduse, du Prix Première Plume, fortement pressenti pour le Prix Renaudot, et il est en lice pour les prix Goncourt, Femina, Médicis et Décembre. Ah oui,… pic.twitter.com/9evcXrPyFD
— Balance ton Claude (@Pangramed) September 21, 2026
Ce contenu est bloqué car vous n’avez pas accepté les cookies et autres traceurs. Ce contenu est fourni par Twitter.
Pour pouvoir le visualiser, vous devez accepter l’usage étant opéré par Twitter avec vos données qui pourront être utilisées pour les finalités suivantes : vous permettre de visualiser et de partager des contenus avec des médias sociaux, favoriser le développement et l’amélioration des produits d’Humanoid et de ses partenaires, vous afficher des publicités personnalisées par rapport à votre profil et activité, vous définir un profil publicitaire personnalisé, mesurer la performance des publicités et du contenu de ce site et mesurer l’audience de ce site (en savoir plus)
En cliquant sur « J’accepte tout », vous consentez aux finalités susmentionnées pour l’ensemble des cookies et autres traceurs déposés par Humanoid et .
Vous gardez la possibilité de retirer votre consentement à tout moment. Pour plus d’informations, nous vous invitons à prendre connaissance de notre Politique cookies.
Un détecteur et beaucoup de doutes
Vu des millions de fois, le message est devenu le centre de débats passionnés sur X. De nombreux utilisateurs ont relevé dans le roman des structures devenues des signes ostensibles d’écriture générée par IA, notamment les fameuses constructions du type « ce n’est pas… c’est… ».
D’autres se sont lancés dans des calculs de probabilités bancals, en multipliant par exemple le taux de faux positifs de 0,0041% par vingt occurrences. Le résultat vertigineux était alors présenté comme une preuve quasi mathématique que le roman avait été généré par une IA.
Sauf que ce calcul est faux et les défenseurs de l’auteur se sont empressés de le souligner. Les tests ne sont pas indépendants, les passages appartiennent au même livre et ont été écrits par le même auteur et peuvent donc partager les mêmes caractéristiques stylistiques. Si Pangram est sensible à une tournure, ou un type de vocabulaire particulier employé par Thélyson Orélien, il est logique qu’il produise des résultats similaires sur plusieurs extraits.
Mais le fait que ce calcul soit faux ne signifie pas que les vingt signalements ne valent rien. Des observations corrélées peuvent rester informatives. Elles indiquent au minimum que le texte présente des caractéristiques que Pangram associe fortement à une rédaction par IA.
Comment fonctionne Pangram ?
Mais alors, comment fonctionne Pangram ? Et comment peut-il estimer si un texte a été écrit par une IA ou par un humain ? La réalité, c’est qu’il ne peut pas le savoir à 100%. Pangram fournit une estimation statistique fondée sur les propriétés du texte qui lui est soumis.
L’entreprise explique utiliser une méthode appelée « synthetic mirroring ». Le système part de textes humains, demande à des LLM de produire des textes proches, puis entraîne un classificateur à distinguer les deux catégories. L’entreprise utilise également le « hard negative mining » : elle réintroduit dans son entraînement des textes humains précédemment mal classés afin de réduire les faux positifs.
En d’autres termes, Pangram permet uniquement d’estimer qu’un texte ressemble davantage à des productions générées par des modèles qu’à des textes humains présents dans son corpus de référence.
Une technologie elle même probabiliste donc, qui relève de plusieurs limites. Dans une interview accordée début septembre à Wired, le CEO de l’entreprise reconnaissait par ailleurs que son outil était moins performant sur les textes courts, notamment ceux de moins de 100 mots. Elle indiquait également qu’un même passage pouvait recevoir des résultats différents selon qu’il était analysé seul ou dans un contexte plus large.
Autant de subtilités qui jettent comme un doute. Une étude menée par des chercheurs de Stanford a également montré que plusieurs détecteurs identifiaient plus souvent comme générés par IA des textes écrits par des auteurs non anglophones. Pangram affirme, de son côté, avoir entraîné sa dernière version sur plusieurs langues et sur différents types de textes, notamment des livres et de la littérature. Mais le contenu exact du corpus d’entraînement n’est pas public.
Pangram considère-t-il le style « créolisé » de Thélyson Orélien comme une éventuelle utilisation de l’IA ? Encore une fois, ce point soulevé par certains internautes relève de l’hypothèse.
Le précédent Shy Girl
En réalité, ce n’est pas la première fois que Pangram est au coeur d’un tumulte chez les maisons d’édition. Aux États-Unis, l’affaire Shy Girl a largement contribué à faire connaître l’outil au grand public. Ce roman d’horreur, d’abord publié en autoédition, avait été repris par Hachette avant que des soupçons apparus en ligne ne poussent la maison à annuler sa sortie américaine et à interrompre son édition britannique, malgré les dénégations de l’autrice.
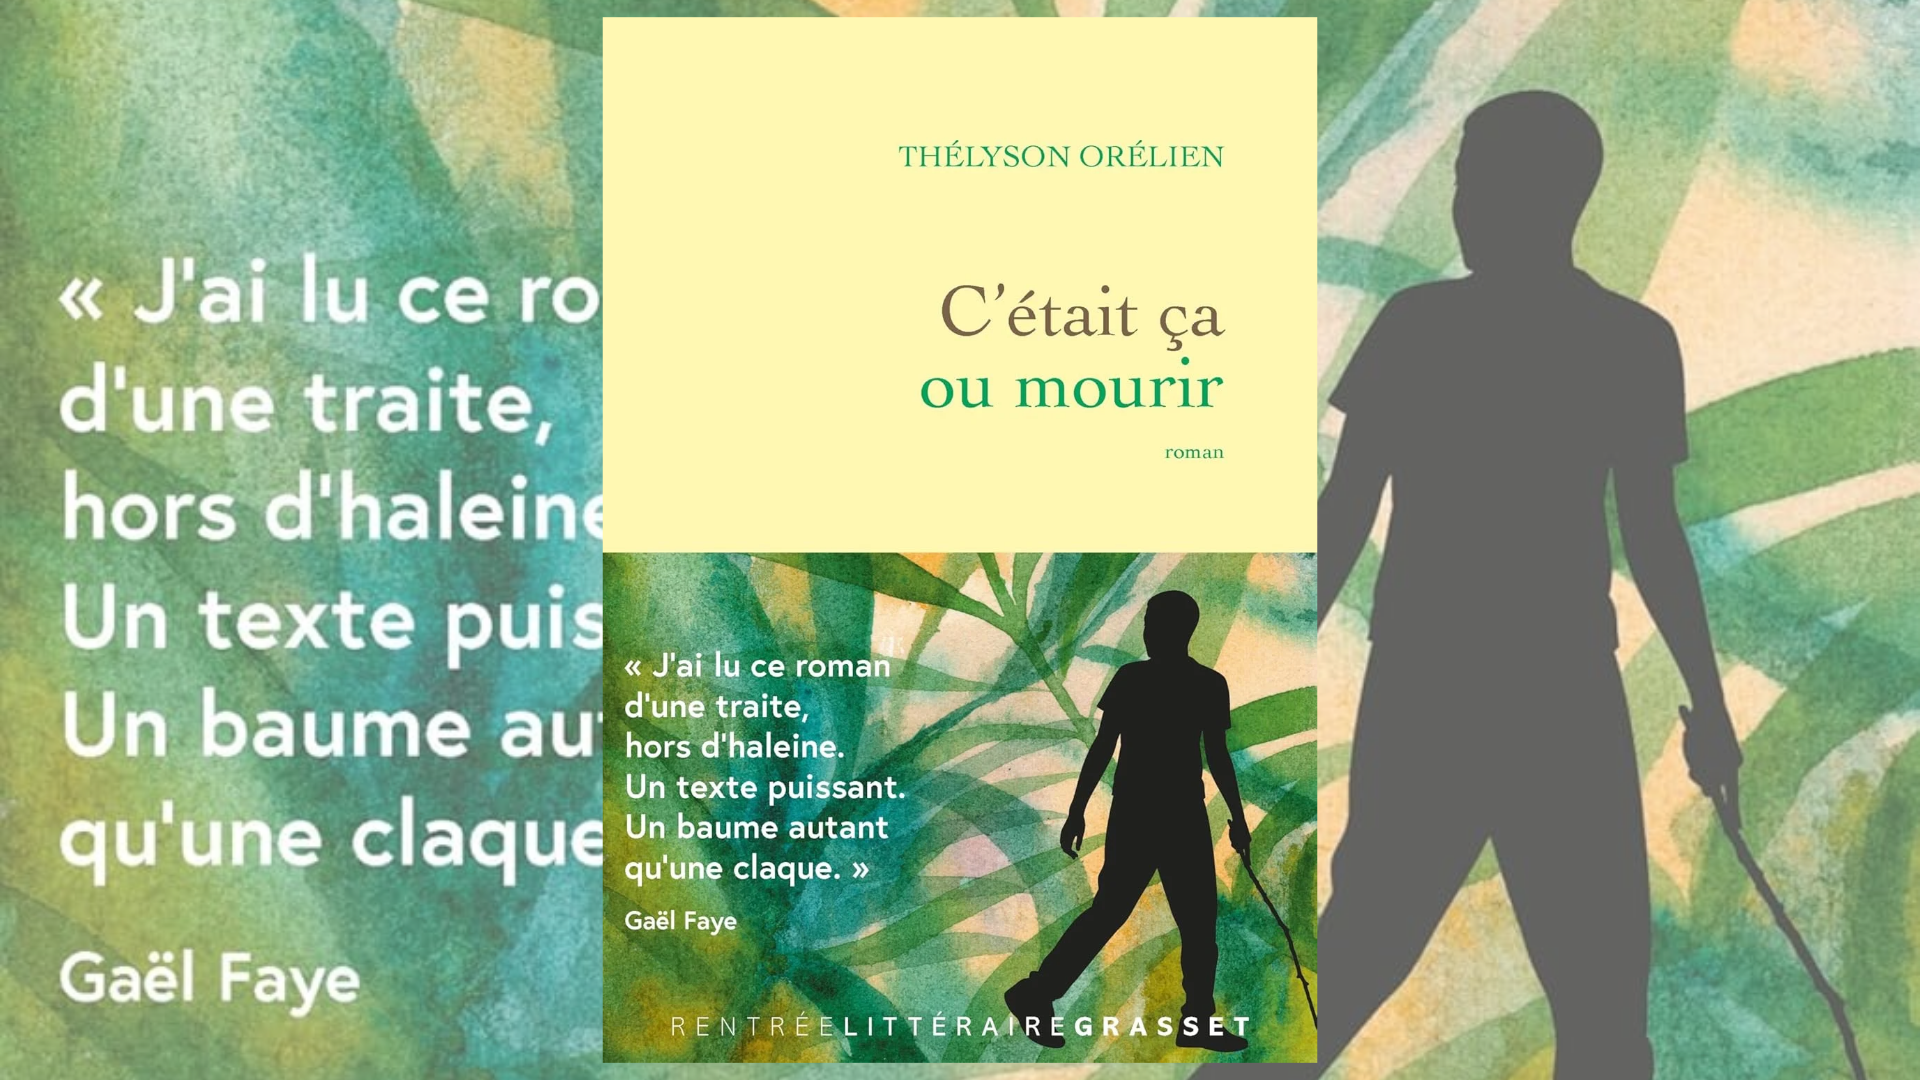
En France, il sera sans doute impossible de trancher le cas de C’était ça ou mourir. Toute accusation, aussi appuyée soit-elle, relèvera toujours de la possibilité. C’est l’essence même des LLM utilisés pour générer du texte, tout comme des solutions chargés d’estimer si un texte a été généré par une IA.
Sommes-nous condamnés à toujours avoir un doute, peu importe à quel point la lecture nous a été agréable ? Faudra-t-il voir des écrivains streamer leurs session d’écriture pour prouver l’absence d’IA ? Une chose est sûre, qu’il soit généré en partie, totalement ou pas du tout par une IA, le roman de Thélyson Orélien (et/ou de son assistant virtuel ?) a plu à des critiques éminentes de notre pays. Il vous plaira peut-être aussi.
Toute l'actu tech en un clin d'œil
Ajoutez Numerama à votre écran d'accueil et restez connectés au futur !
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.